何恺明和字节Seed跳到同一条河流:连续扩散语言模型的范式转移
文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。
文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。
文章介绍了50个结构化、工程化的 Claude 提示词,涵盖内容创作和商业策略等领域。通过设定角色、背景、格式和约束条件,这些提示词能让 AI 的输出达到专业团队的水准,大幅提升工作效率。
文章介绍了一种基于 LLM 的新型 Wiki 知识管理范式,旨在解决传统知识库维护成本高的问题。作者详细阐述了 raw/wiki/schema 三层架构,以及 Ingest、Query、Lint 三大核心操作,并开源了相应的 Claude Code Skill。文章以 x-algorithm-wiki 为例,提供了五步实战教程,展示了如何让 LLM 增量维护可追溯、可信的项目架构文档,并探讨了该方法的边界与适用场景。
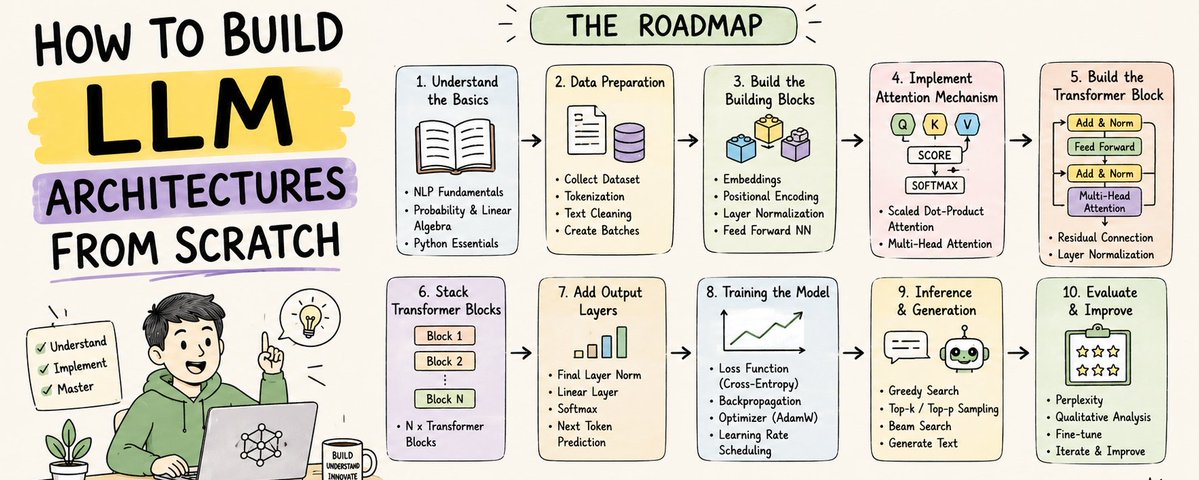
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
本文深入探讨了当前 AI 行业被忽视的“痛点”:AI 缺乏长期记忆。作者认为,比单纯追求更聪明的大模型或自主 Agent 更重要的是构建“持久认知层”。文章以 GBrain 为例,阐述了它如何超越传统的检索生成(RAG),通过自建知识图谱和“梦境周期”维护,实现对信息的真正理解与关系连接。这种能积累上下文、提供确定性智能的“记忆基础设施”,将成为未来 AI 的真正护城河。
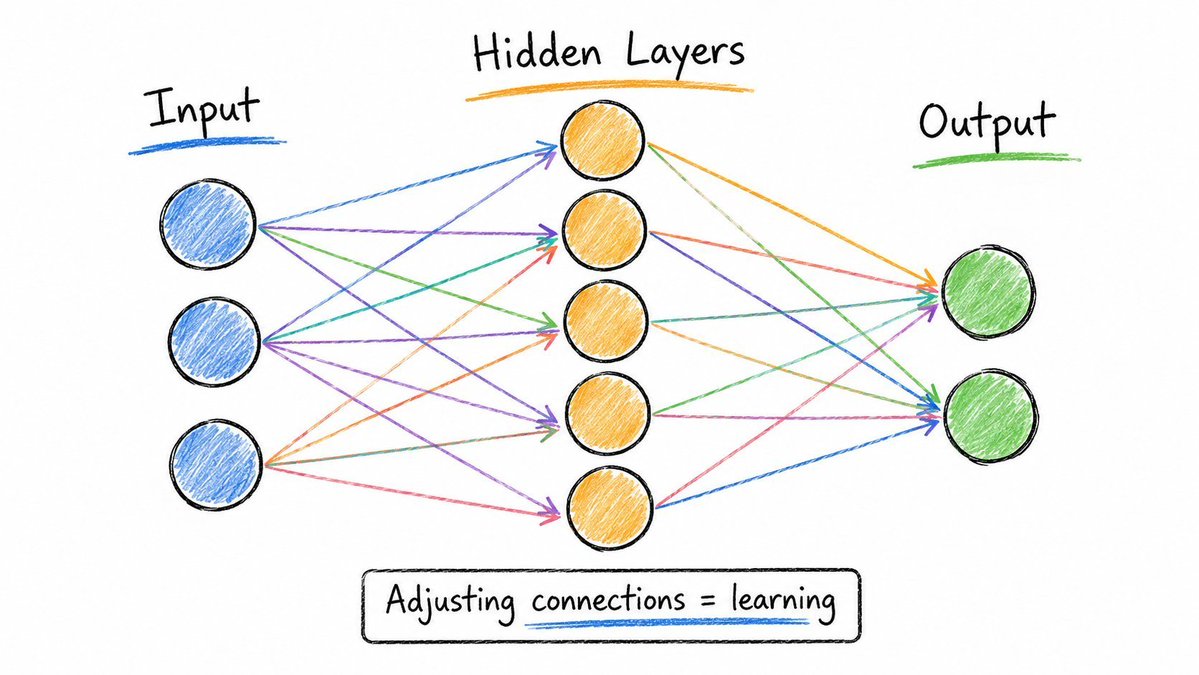
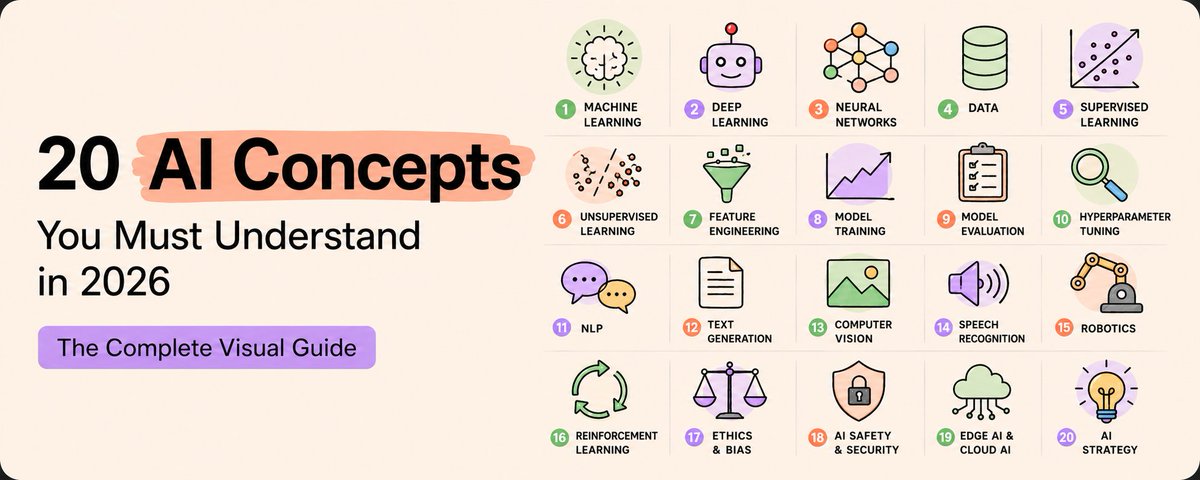
本文翻译整理了一组在 X 上广为流传的 AI 科普手绘图,涵盖从神经网络、Transformer 架构到大语言模型(LLM)的 20 个核心概念。作者不仅解释了 AI 底层运作原理(如分词、注意力机制),还介绍了模型优化手段(如微调、RLHF)及前沿应用架构(如 RAG、Agent、思维链),是一份简洁全面的 AI 技术入门指南。
本文深入分析了 DeepSeek 如何通过 MLA、MoE、mHC 等一系列底层技术创新,极大幅度降低大模型对 HBM(高带宽内存)和先进 GPU 制程的依赖。文章指出,DeepSeek 的战略并非局限于软件订阅,而是旨在通过算法优化盘活中国产能充足的 NAND 闪存和 LPDDR 产业,以此构建一套独立于西方之外的 AI 硬件生态,最终撬动价值 10 万亿美元的产业巨兽。
文章指出大多数用户仅发挥了 Claude 10% 的潜力,并分享了博主 @cyrilXBT 提出的 18 步框架,旨在将 Claude 从简单的聊天界面转化为强大的智能推理引擎。该框架涵盖四个阶段:基础层(上下文配置、CLAUDE.md)、质量层(角色分配、提示词链)、系统层(Skill 文件、MCP Server)和智能层(复利心态)。通过构建上下文、记忆、工具和约束系统,用户可以最大化释放大模型的能力。
文章通俗易懂地解释了现代AI的基础原理,涵盖神经网络、Token化、Embeddings、注意力机制及Transformers架构。深入探讨了LLM的工作原理,如上下文窗口、温度控制和幻觉问题,并讲解了提示词工程技巧。
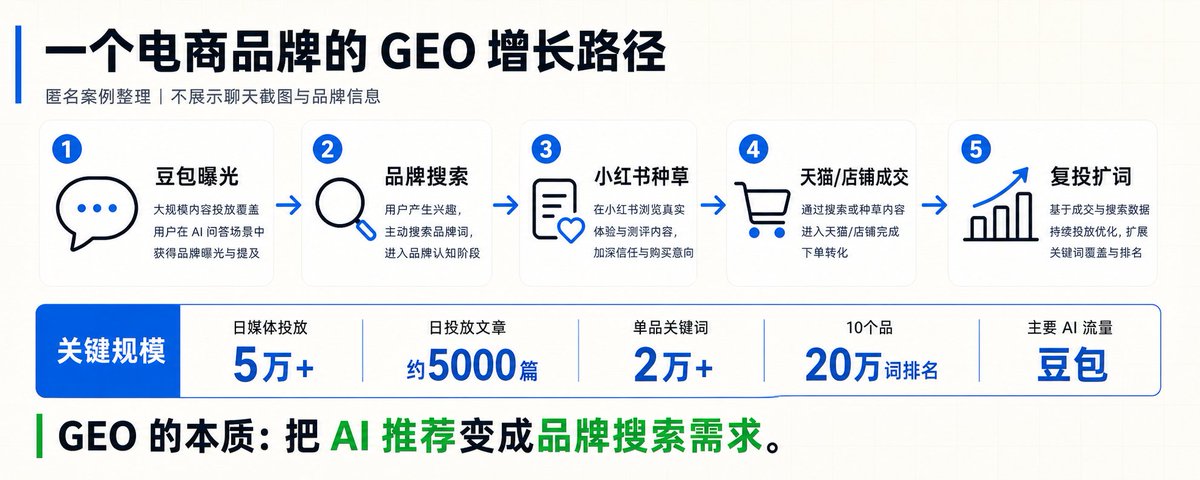
文章讲述了一位电商从业者通过专注于豆包平台的生成式引擎优化(GEO),实现从零起步到自建工厂的商业案例。该案例通过日投放5万元媒体资源和5000篇文章,围绕单品类布局2万个关键词,成功将AI推荐流量转化为品牌搜索。作者指出GEO的本质是将AI推荐变为品牌搜索需求,并分析了多数企业失败的原因在于不舍得投入、缺乏对流量公式的理解以及缺乏专业团队长期运营。
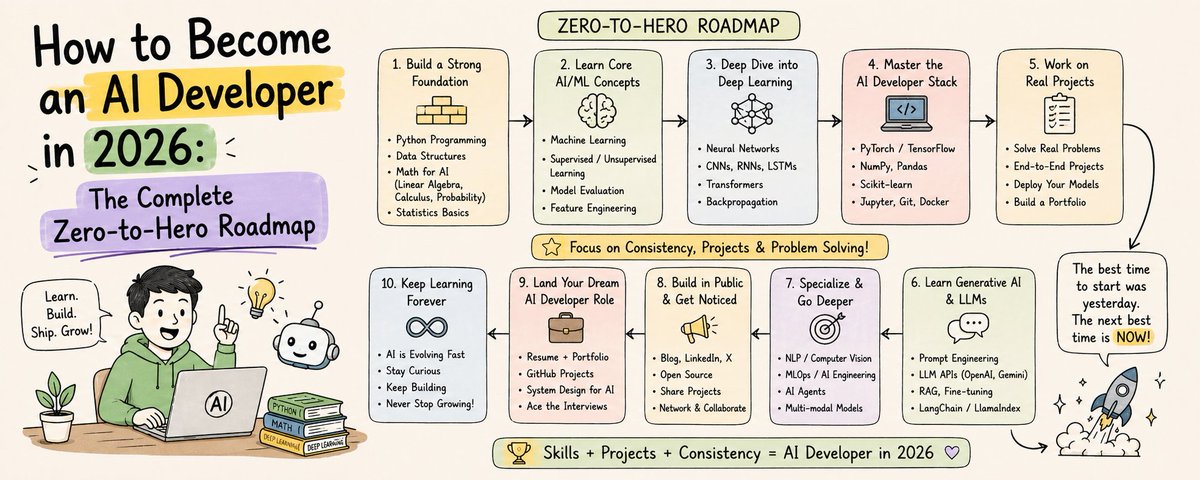
这是一份针对2026年AI开发者的完整学习指南。文章指出,成为AI开发者不再需要计算机学位,通过正确的路线图,个人即可构建AI应用和SaaS产品。指南分为十个阶段:首先理解AI生态系统的基本概念(AI、ML、LLM、Agent等);接着掌握Python基础、API调用及Git工具;然后通过现有AI工具(如OpenAI API、LangChain)快速动手实践;最后深入学习前端技术、提示工程、LLM原理(RAG、微调)及应用部署。文章强调“学习-构建-分享”的循环策略,并指出AI智能体、自动化及RAG系统是当前的高价值技能。
这是一份关于大语言模型(LLM)的实践指南。文章从基础循环机制出发,详细解释了文本如何转化为 Token,以及 Transformer、注意力机制、KV Cache 和 RoPE 等核心概念的工作原理。作者强调理解模型内部的推理机制(如 Prefill 和 Decode 阶段)对于硬件选型、显存估算和本地部署的重要性。文章涵盖了 Token 化、上下文窗口、量化、模型服务及本地 AI 硬件数学计算等关键主题,旨在为深入理解 LLM 提供直观的基础。
文章介绍了一种利用AI生成寓言故事来理解和学习抽象概念的方法。作者基于Anthropic专家Amanda Askell的思路,优化了一套Prompt,通过让AI编写不带术语的“暗语”故事,帮助读者直观掌握陌生化等复杂概念的本质。该方法不仅提升了学习乐趣,还通过隐喻加深记忆,适用于Claude、GPT等多种大模型,被视为一种回归人性的高效学习路径。
本文通过拆解100条AI爆款内容,指出内容的传播核心并非复杂的技术展示,而是情绪的触发。作者分析了视觉震撼、情绪共鸣、身份认同等六大爆款类型,强调AI只是外壳,好奇心、焦虑、共鸣等情绪才是传播的发动机。普通人做内容应先确定情绪钩子,再寻找技术实现。
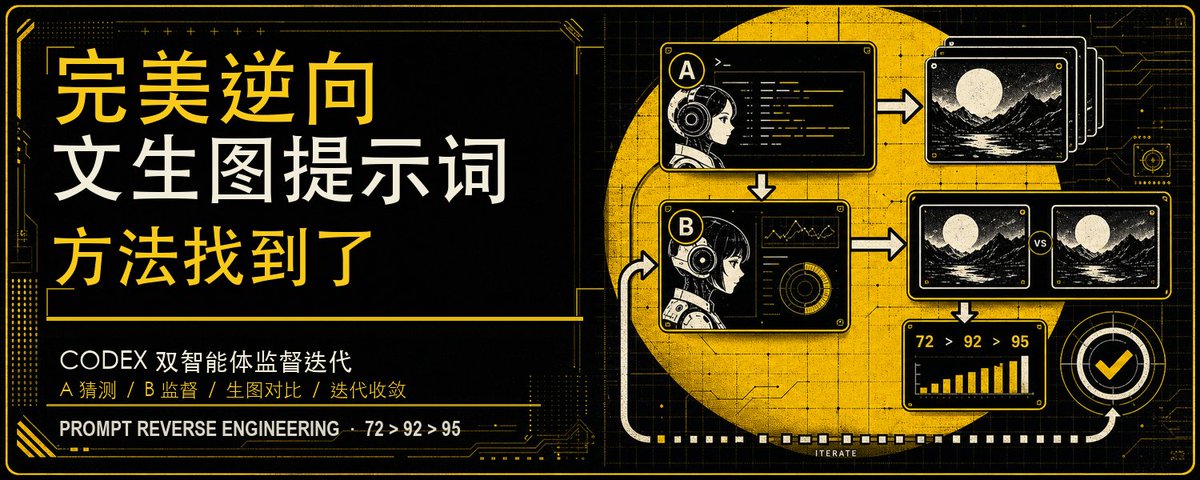
文章介绍了一种利用 Codex 创建两个子智能体(逆向提示词智能体 A 和监督智能体 B)的方法,通过 A 生成提示词、B 生图并对比找差异的循环迭代机制,将任意图片精准逆向为可复用的文生图提示词。实验表明,通过 3 轮迭代,成功将风格描述升级为版式锁定和视觉重心的精确约束,实现了 95 分的高保真复刻。
文章描述了OpenAI内部模型在离散几何领域取得重大突破,解决了困扰数学界80年的“单位距离问题”猜想。AI否定了埃尔德什关于“网格是最优解”的猜想,通过结合代数数论(如类域论和Golod-Shafarevich塔)构建出新的解,证明了存在更优的点配置。这展示了AI掌握全领域知识并进行复杂推理的能力。
文章阐述了选择 LLM 推理引擎的正确逻辑:先确定硬件策略、负载形态和服务模式,再选引擎。文章解析了推理引擎的核心功能(调度、内存管理、批处理)及性能瓶颈(显存带宽、KV Cache、互联),并详细对比了 llama.cpp、MLX、ExLlama、vLLM、TensorRT-LLM 等主流引擎的适用场景与优缺点。
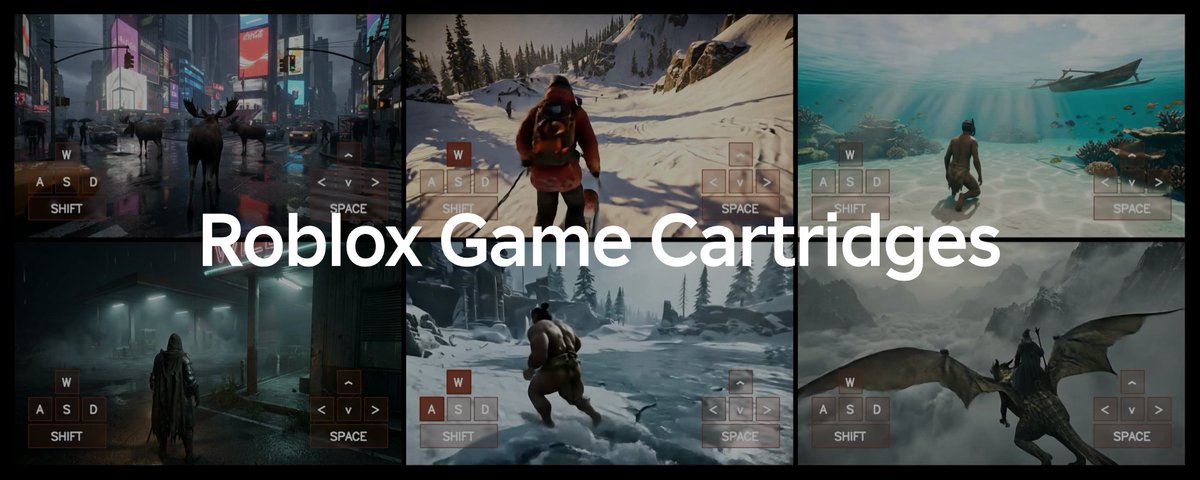
文章探讨了视频世界模型在游戏开发中的应用与挑战。Roblox 团队通过引入 14B 参数的动作条件 Text-Image-to-Video 模型,并设计了名为“Game Cartridge”的轻量级控制框架,结合实时视觉语言模型(VLM)作为感知组件,成功将视频生成模型与传统游戏引擎耦合。该方案解决了世界模型缺乏抽象状态管理和游戏进程推进的问题,使开发者能够利用 AI 生成高保真且具备复杂交互的可玩游戏体验。
文章详细总结了 Google I/O 2026 大会的核心发布。技术层面推出了 Gemini 3.5 Flash 和 Omni Flash 模型,并升级了 Antigravity 2.0 Agent 系统。产品端发布了 Gemini Spark 个人 Agent 和 Android Halo。同时,Google 搜索整合 Agent Coding 并升级 AI Mode,视觉生成领域推出 Pics 和 Stitch。全场强调 AI Agent 的落地应用与生态整合。
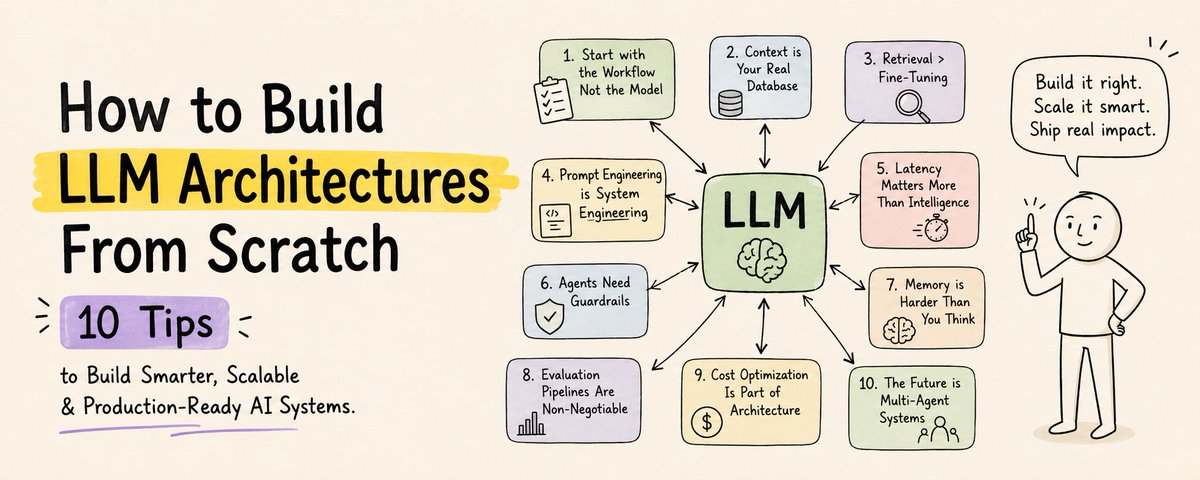
本文指出构建 AI 产品的核心不在于选择模型,而在于架构设计。作者分享了 10 个实用经验,强调从工作流而非模型入手、重视检索优于微调、将提示工程视为系统工程、关注延迟优化、为智能体设置护栏、妥善处理记忆、建立评估管道以及优化成本。最终,多智能体系统将是未来趋势。
文章阐述了 AI 工程闭环中评估环节的重要性,详细介绍了手动评估、基于代码的确定性评估以及 LLM-as-a-judge 三种主要方法。作者建议从手动审查开始建立直觉,逐步定义并自动化具体的失败模式。文章还探讨了基于参考与无参考评估的区别,并强调应结合多种方法,优先使用二值评分以确保评估的清晰性与可靠性。
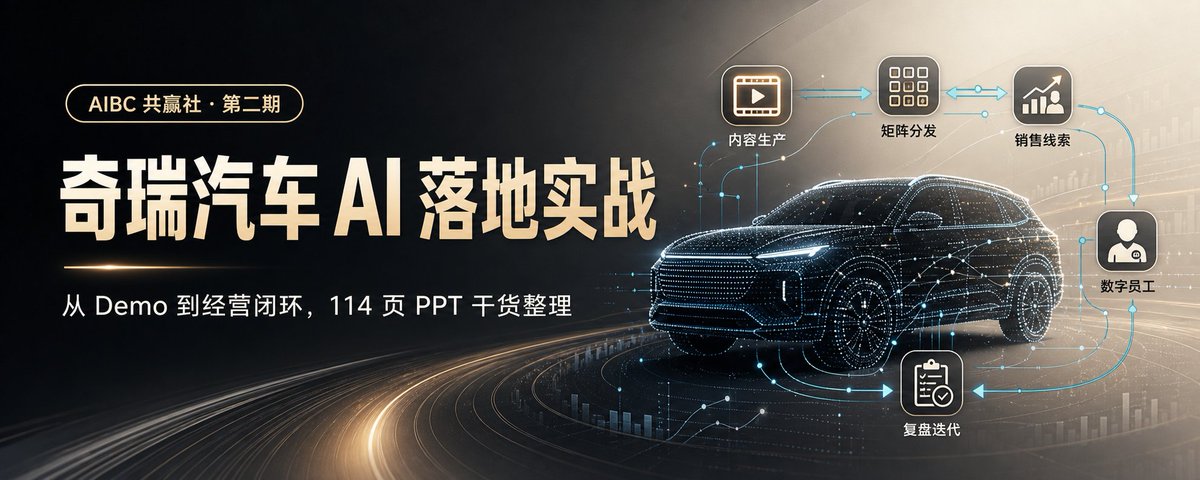
本文记录了黄铭关于奇瑞汽车AI落地实战的深度分享。核心观点是企业AI落地不仅是技术动作,更是经营动作。文章详细拆解了奇瑞如何以营销为切入点,通过六条业务线实现从内容生产到线索转化的闭环。文中总结了优质AI项目的四个标准(能量化、能示范、能复用、风险可控),并探讨了ToB服务商在交付、验收及Know-how积累方面的实战经验与避坑指南。
文章探讨了在 GPT2 等新工具出现后,小红书卡片制作逻辑的革新。作者对比了传统的 Figma、PPT 手搓与 HTML 代码的笨重,认为借助 AI 的视觉生成能力(如特定的风格提示词),可以高效生成高质量、风格统一的视觉卡片。文中包含详细的提示词示例和生成的卡片展示。
本文作者分享了利用 AI 设计中文字体的经验,指出笼统的提示词(如“好看”)难以生成有设计感的作品,并提出了具体的提示词公式。文章主要提供了 60 个涵盖时尚、极简、手写、涂鸦、像素、复古等多种风格的中文字体设计方案,旨在帮助用户通过精准描述生成高质量的封面标题或视觉文字。
本文翻译自 Anthropic 2026 年发布的《The Founder's Playbook》,阐述了 AI 如何重塑创业流程。文章指出,Agent 编程使得单人即可完成过去团队的工作,降低了创业门槛。手册详细拆解了从想法、MVP、发布到规模化四个阶段,特别强调了在 AI 时代容易陷入的“将建造误认为验证”等新风险,并指导如何利用 Claude 进行严谨的市场调研和假设验证。
本期 Indigo Talk 邀请 Bill Sun 探讨 AI 对投资、组织形态及人类存在的深刻影响。Bill 拥有 Google Brain 与量化对冲基金的双重背景,他指出 GPT-3.5 曾让其 20 人团队的工作被 AI 替代。对谈核心观点认为 AI 是“极端放大器”,而非平等工具,它会让顶级人才效能倍增,同时加速组织“U 型坍塌”——中部消失,分化为超级资源体与“一人公司”。此外,文章还深入探讨了如何造出像索罗斯一样思考的 AI,以及在 AI 时代人类如何寻找存在意义。
文章基于作者的Token消费经验,推荐了三个免费开源项目(Easy-Vibe、vibe-coding-cn、awesome-vibe-coding)作为学习Vibe Coding的替代方案,无需购买昂贵的课程。文章详细介绍了各项目的特点,提供了从入门到接单的详细学习路径,并分析了开源学习在更新速度、内容深度和社区支持上的优势。
文章介绍了一个用于生成高密度信息图的“仙品”提示词。该提示词旨在让 AI 生成的画面兼具建筑方案板的秩序与奢华产品手册的质感,强调冷静、精密与可信的视觉风格。提示词详细描述了版面布局、色彩逻辑、光影处理及排版要求,适用于将各类主题转化为具有博物馆级说明牌秩序的视觉作品,如 PPT 关键页、研究报告或海报。
本文为 AI 初学者提供了一份为期 14 周的实战路线图,旨在通过免费资源将新手培养成具备构建生产级 AI 系统能力的工程师。路线图包含六个阶段:环境搭建、AI 基础、机器学习基础、深度学习、现代 LLM 工程以及 Agent 与部署。文章强调动手实践,推荐了 OpenAI、Anthropic 官方教程及 GitHub 优质开源仓库,帮助学习者避开盲目刷证书的误区,真正掌握 AI 开发技能。
文章探讨了 AI 在长篇小说创作中的应用现状与实战案例。虽然直接使用 ChatGPT/Claude 往往导致长篇烂尾,但通过 Sudowrite、NovelCrafter 等垂直工具,结合 Muse 模型和 Codex 知识库,海外作家已实现高效产出。文中详细拆解了多位作家将写作周期从数年压缩至数周的工作流,并分析了“Shy Girl”AI 生成小说遭出版社撤稿等争议事件,指出 AI 辅助创作已成为不可忽视的趋势。