Wiki 知识库

全部文档 / 标签: LLM

1042 篇
清除

未来 Skill 的终极形式 → Agent 大脑

文章探讨为什么同一个 Skill 在不同人手中运行效果差异巨大:Skill 如同课本,本身不等于能力,离开适配的环境便难以发挥作用。作者引用 OpenAI 产品负责人 Tibo 的观点和 Karpathy 的 LLM Knowledge Bases 实践,提出未来 Skill 的终极形式是 Agent 大脑——一个持续吸收 Skill、理解本地环境、积累真实运行反馈并自主更新演化的个人知识库。真正拉开 Agent 能力差距的,不是安装了多少 Skill,而是外部知识能否被熔炼进属于自己的系统。
技术 › Skill vink 2026-08-299.2 KB 18.6K 54 67

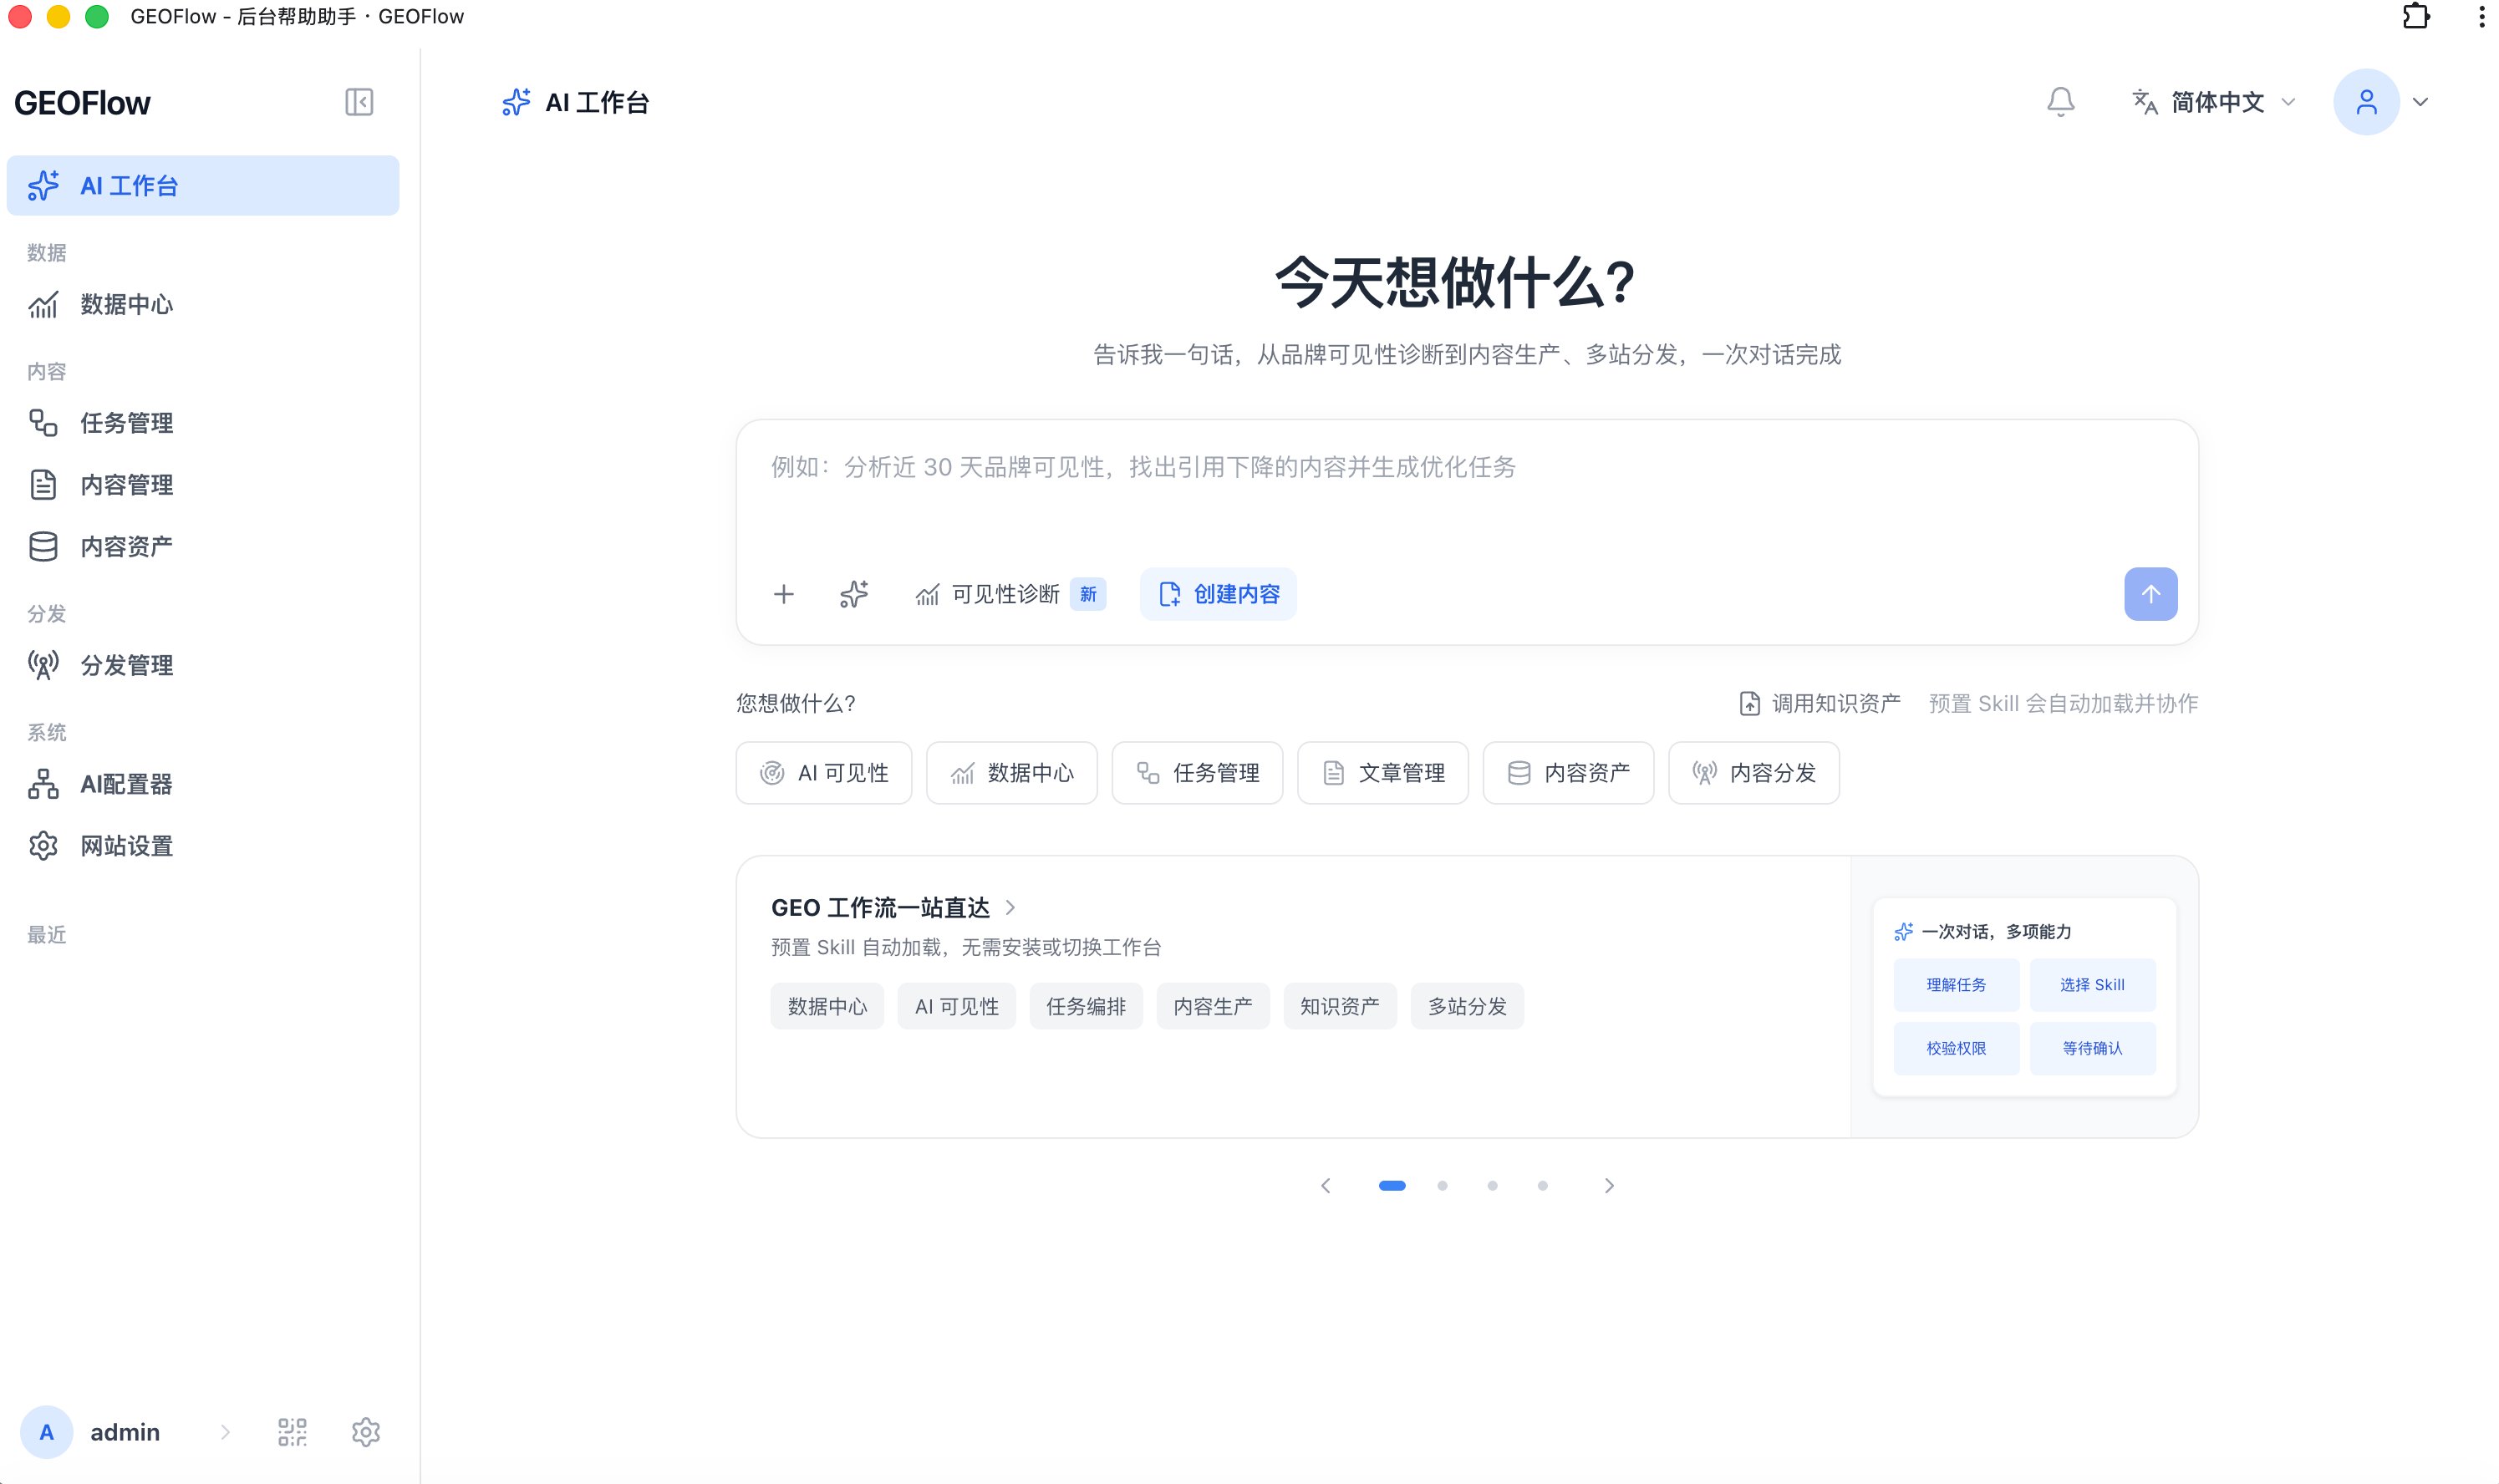
GEOFlow 3.0 开源:面向企业官网的开源GEO智能运营系统

作者宣布GEOFlow 3.0正式开源,定位为全球首个面向企业官网和信源站点的开源GEO智能运营系统。AI对企业官网的引用日益增多,官网GEO价值不断提升。本次大版本升级包括:Admin UI V3后台全面改版、AI质检进入发布门禁(检查知识一致性、广告风险等)、多站点分发与人工发布协作闭环、以及API/CLI/更新恢复的清晰工程边界。企业官网想持续获得AI引用,需要真实知识、稳定内容、清晰结构和长期运营,把模型效率转化为持续结果。
技术 › 工具与效率 姚金刚 2026-08-294.3 KB 68

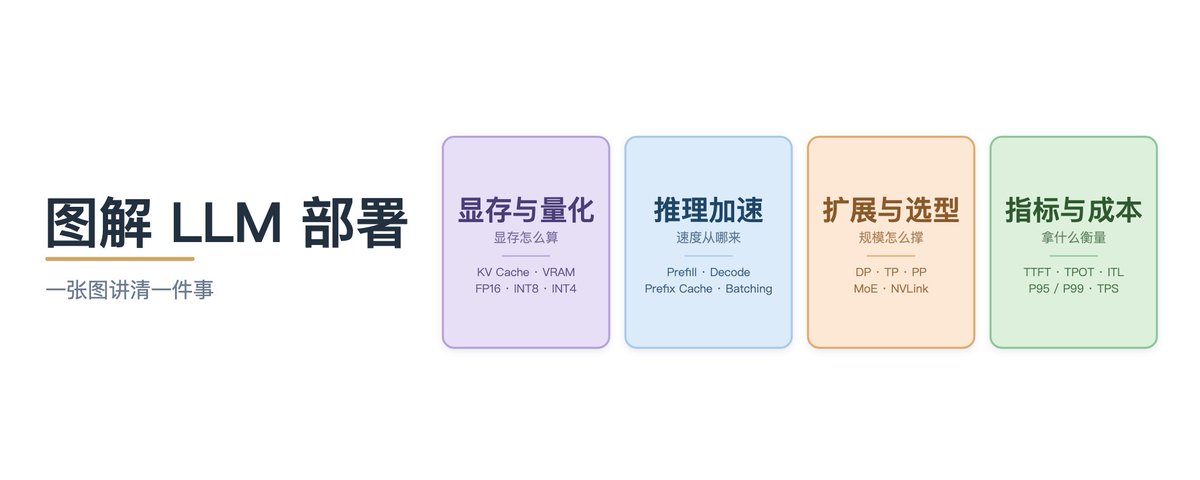
图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89

Cherry Studio 2.0.10 预发布,更新内容有点多

Cherry Studio 2.0.10 预发布版本带来大量更新:Agent 成为新用户默认主入口并优化子 Agent 流程;Mini App 正式支持沙箱化的本地应用扩展;Code Mate 新增 Hermes Dashboard 与 Antigravity CLI;修复多模型兼容性(MiniMax M3、GLM-5.3-Flash、DeepSeek V4、Kimi、Gemini、OpenAI Responses API 等);增强诊断体系,支持自动错误扫描和带签名的诊断报告;安全性采用 Consent + Sandbox + Fail Closed 策略;并进行了系统性的 Lazy Load 前端性能优化。整体方向收敛于统一 Agent Runtime、模型兼容层与标准化 Support 基础设施。

技术 › 工具与效率 Yinsen 2026-08-2911.5 KB 9.4K 16 82

构建弹性生产级 Agent Harness 的 5 层架构

文章指出 Agent 可靠性的关键在于模型之外的确定性软件基础设施,即 Harness Engineering。作者提出构建弹性生产 harness 的 5 层方法:1)从模型优先转向系统优先架构,结构化工作流可将任务完成率从 31.7% 提升至 78.0%;2)实现持久化状态与检查点,避免长时间运行中丢失进度;3)通过角色分离(规划者、生成者、评估者)构建验证闭环;4)利用 hooks 和隔离运行时(如沙箱、网关)确保安全边界,防御提示注入;5)记录结构化追踪便于调试与自动化修复。文中结合 Google Antigravity、ADK 2.0、Gemini Enterprise 等工具给出实践建议。

技术 › Harness Engineering Google Cloud Tech 2026-08-298.7 KB 35.7K 263 81

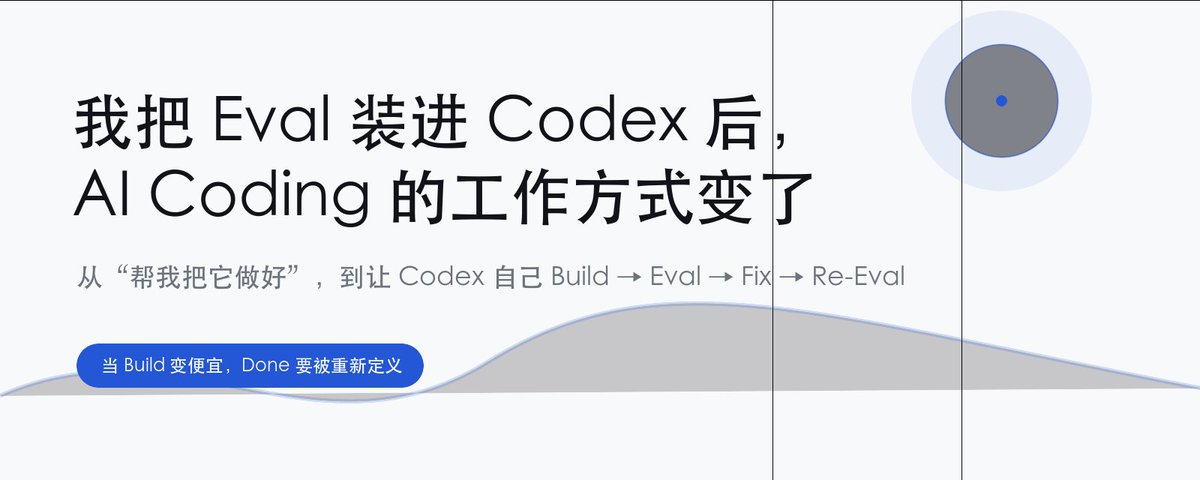
我把 Eval 装进 Codex 后,AI Coding 的工作方式变了

作者分享了将 Eval(评估体系)融入 Codex 工作流后的实践心得。核心观点是:AI Coding 越强,Eval 越重要,因为 Build 变便宜了,但'什么叫完成'并未变简单。文章指出 Tests Passed 不等于任务正确,Testing 是底线,Eval 是交付线。作者重构了工作流程:Baseline → Build → Test → Eval → Analyze → Fix → Re-Eval → Release,强调先跑 Baseline 而非上来就改 Prompt,利用失败分类找出瓶颈,通过 Release Gate 定义验收标准。同时提出 Ground Truth 必须由人工确认,AI 不能既出题又评分。最终结论:人应从让 AI 写代码,转向给 AI 定义验收标准。

技术 › Codex Builder 2026-08-2911.1 KB 18.6K 142 85

One person with AI outperformed an entire team

作者引用哈佛商学院的研究《The Cybernetic Teammate》,该研究对宝洁776名专业人士进行实验,发现单人配合AI能够媲美两人团队的绩效,相当于生产力翻倍。AI辅助的工作者速度更快、方案质量更高且更均衡,AI还抹平了专家与通才、资深者与新手之间的差距。更意外的是,使用AI的人报告了更高的积极情绪和更低的焦虑与挫败感。结合Mary Meeker报告显示AI职位增长448%,作者认为AI经济正在爆发,并提出个人应学会使用最新AI工具、把AI当作能力的放大器、定制自己的系统、并拥有可控的上下文管理中心,即他推广的Personal Context Management理念。

技术 › LLM Tiago Forte 2026-08-294.7 KB 69.6K 279 55

让 AI 真正懂你的工作:小白 Skill 制作指南

文章面向新手讲解如何为 Claude Code 和 Codex 制作个人 Skill,解决每天重复向 Agent 解释工作流程的问题。作者介绍 Skill 的本质是一个包含 SKILL.md 的目录,依赖渐进式披露机制;提出判断任务是否值得封装为 Skill 的三个信号(重复出现、依赖专有知识、错误成本高);建议从成功协作会话中逆向工程提取 Skill,或先跑无 Skill 基线记录失败点再写规则;并详细分析三大坑:description 模糊导致不触发、把任务写成死板 SOP、SKILL.md 过长,给出 SKILL.md、references、scripts、assets 的合理拆分方式及三层验证与维护方法。

技术 › Skill 苏乐 2026-08-2828.3 KB 142.4K 260 91

从零开始,用 LangGraph 搭建你的第一个 AI Agent

本文是一篇面向初学者的 LangGraph 实战教程,介绍如何用 Python 从零搭建一个具备工具调用、推理决策和会话记忆能力的 AI Agent。文章首先讲解 LangGraph 的三个核心概念:State(状态/共享记忆)、Node(执行步骤)和 Edge(跳转逻辑),随后通过完整代码演示项目创建、工具定义、模型节点编写、条件路由实现、Graph 组装,以及通过 InMemorySaver 和 thread_id 实现多轮对话记忆。最终实现一个 ReAct 循环(思考→行动→观察→回答)的基础 Agent,并给出网页搜索、数据库查询、RAG 检索等扩展方向。

技术 › Agent Smartpig 2026-08-2815.0 KB 14.6K 131 77

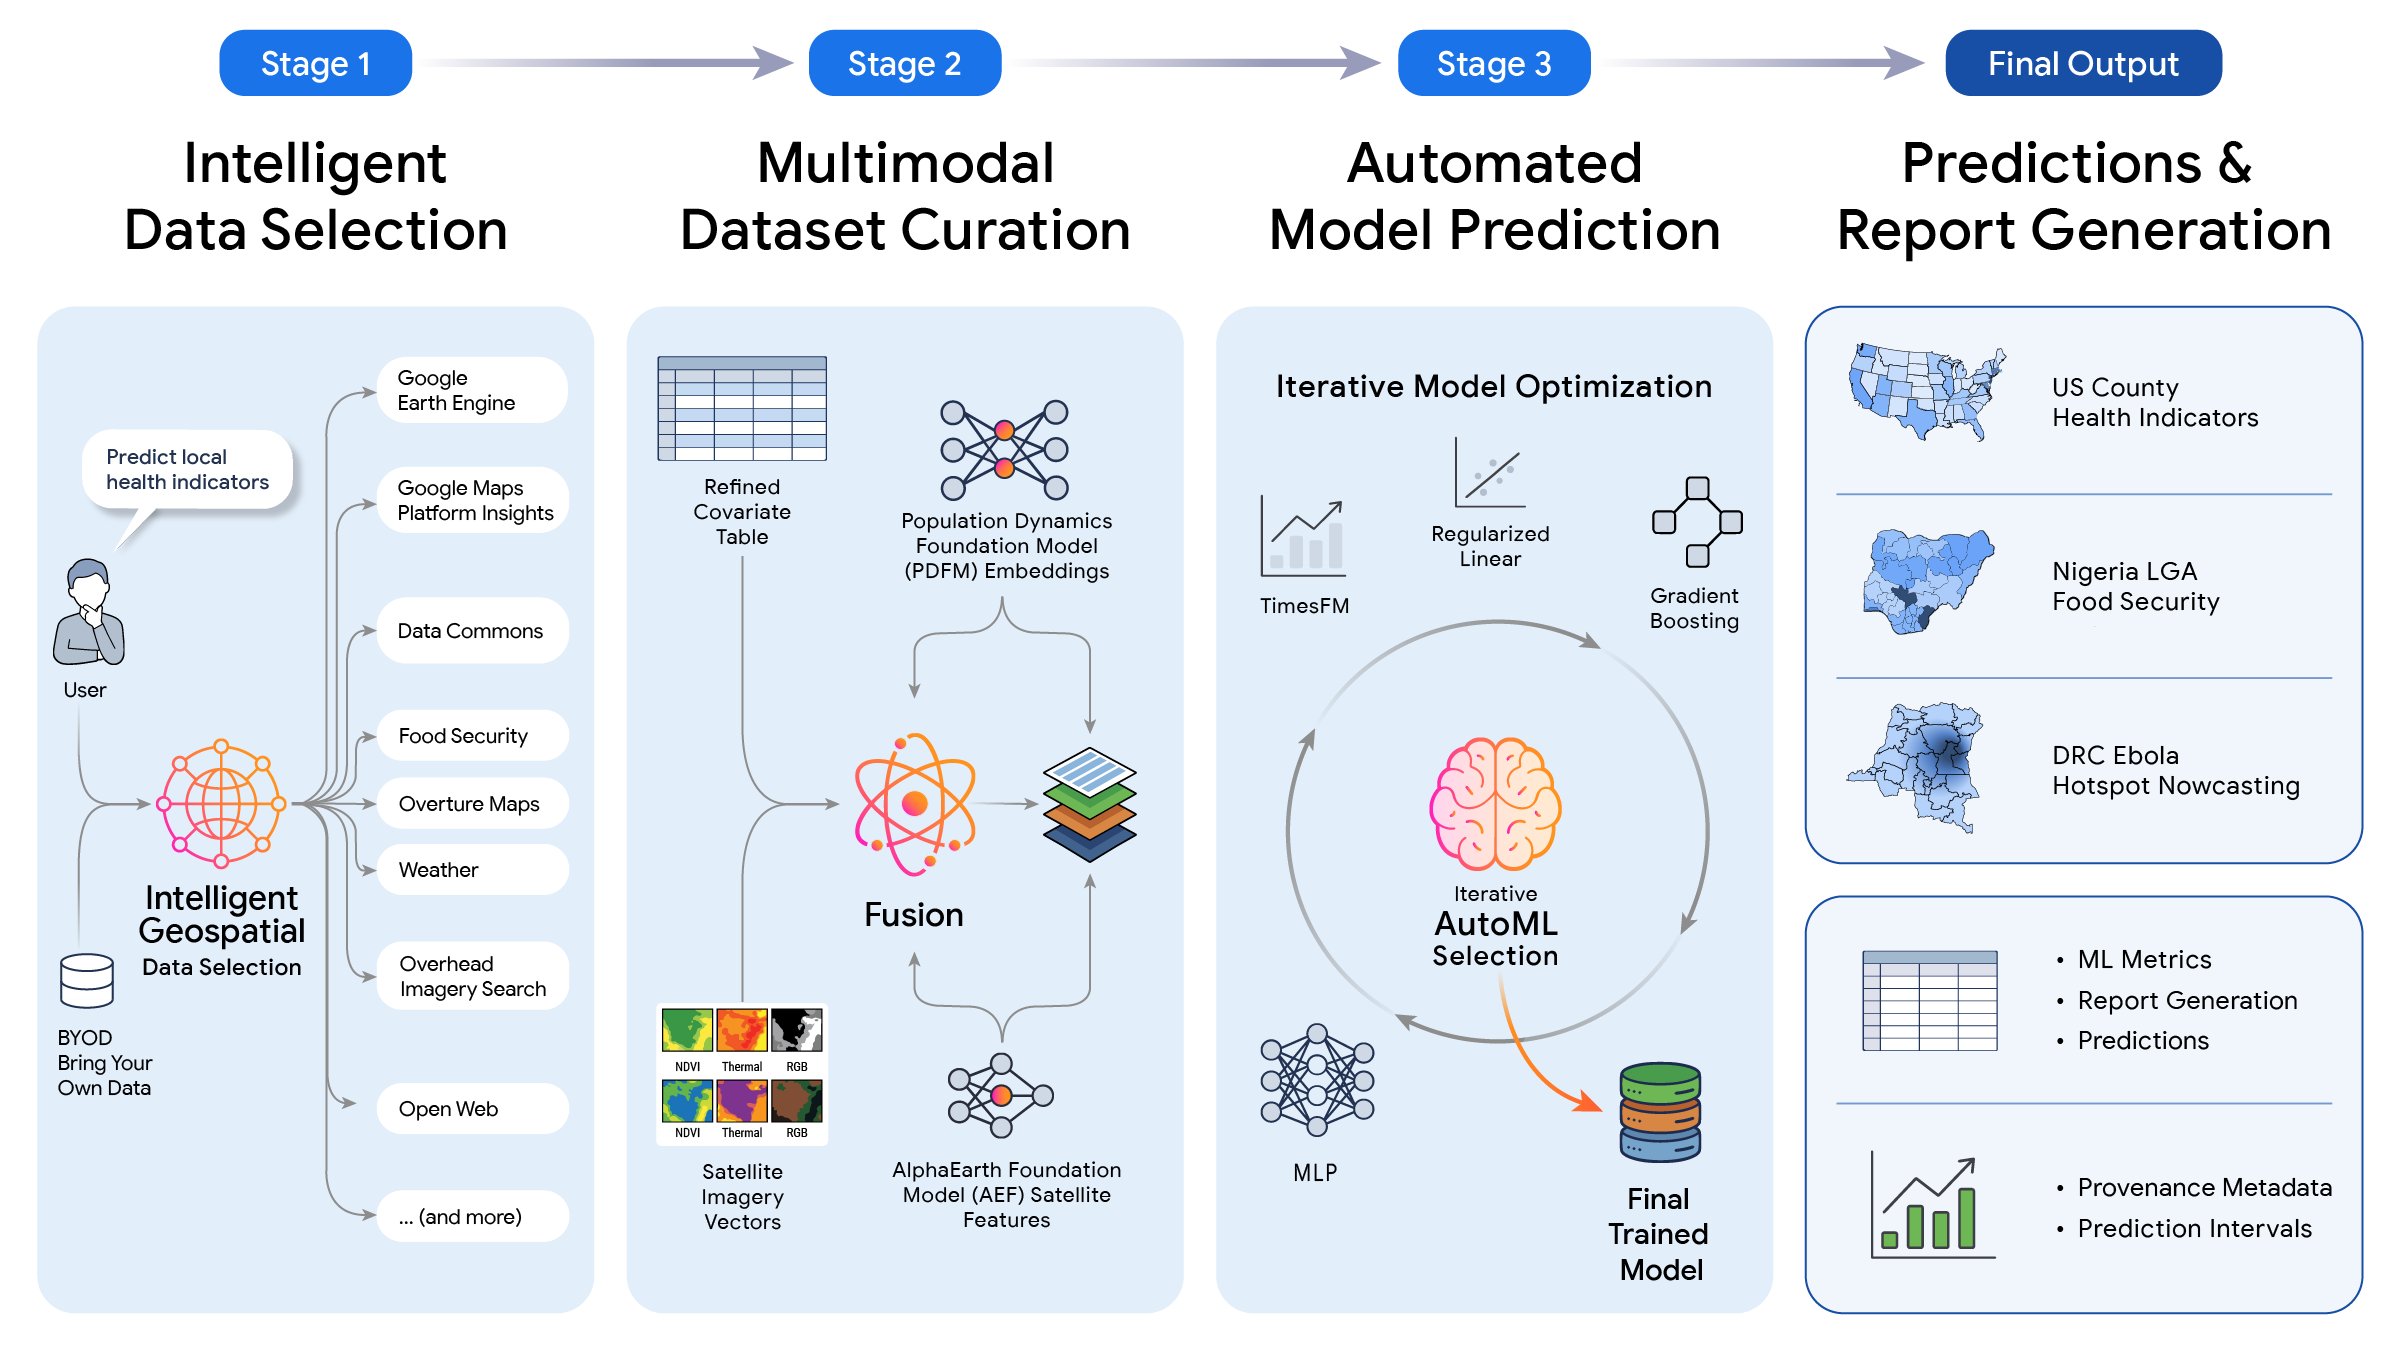
谷歌行星预测引擎PPE:全自动地理空间预测系统

谷歌推出实验性行星预测引擎PPE,用户只需输入自然语言查询(如预测某地区粮食不安全风险),系统即可自动完成数据发现、整理、模型训练和报告生成全流程,将传统数周的地理空间预测工作缩短至几分钟。PPE采用三阶段架构,每阶段由LLM编排:智能空间数据选择、多模态数据集策展、自动化模型构建。在美国健康指标、尼日利亚粮食安全、刚果埃博拉疫情三个真实场景上均大幅超越对比基线,可应用于饥荒预测、疫情追踪、洪水风险评估等领域。

技术 › LLM AIGCLINK (@aigclink) 2026-08-283.3 KB 62

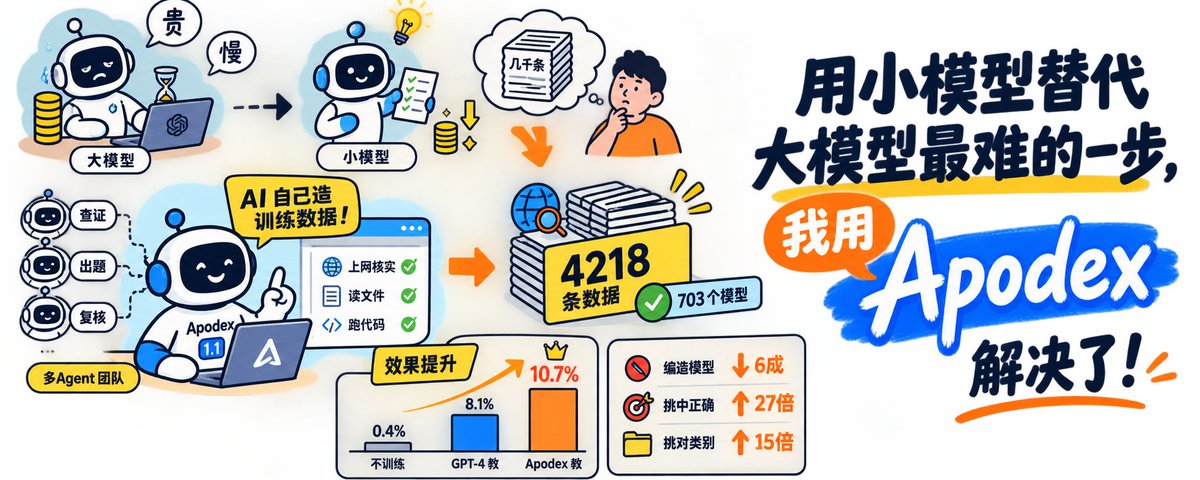
用小模型替代大模型最难的一步,我用 Apodex 解决了

作者尝试用 Apodex 1.1 自动生成训练数据,解决用小模型替代大模型时缺乏标注数据的难题。实验场景是让小模型学会根据自然语言描述从 HuggingFace 九百多个候选模型中挑选正确的模型。Apodex 拆解任务、派出 14 个子 Agent 分工协作并上网核实,最终生成 4218 条经核实的训练数据,还主动推翻了作者一条错误规则。用这批数据训练 Qwen3.5-0.8B 后,挑对模型的比例从 0.4% 提升到 10.7%,瞎编模型名的比例大幅下降,效果优于当年 Berkeley 用 GPT-4 生成的数据。作者总结:AI 能替人造数据的关键,在于能否自动判对错。

技术 › LLM 柯基是只猫 2026-08-2814.7 KB 15.8K 93 82

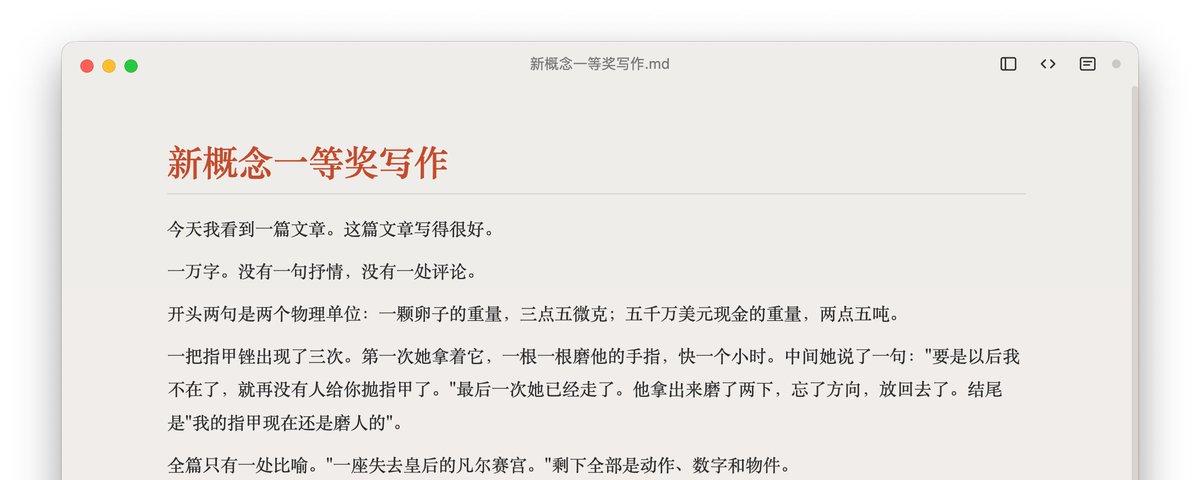
新概念一等奖写作 Skill 发布

作者Orange AI发布了一个写作Skill(Claude技能),其理念源自一篇获得新概念一等奖的万字爱情故事。该故事全篇无抒情无评论,仅用数字、动作和物件传递情感:如卵子三点五微克与五千万美元两吨半的对比、反复出现的指甲锉、重复十几次的'我说好'。Skill提炼的核心心法是时刻关注读者的认知与情绪状态,具体技巧包括:数字做情感的工作、物件代替心理描写、重复结构与打破、零解释信任读者、信息差结构。Skill推荐使用Opus 4.6模型,配合语音输入写作真实情感故事,已在GitHub开源(MIT协议)。

技术 › Skill Orange AI 2026-08-286.5 KB 144K 325 78

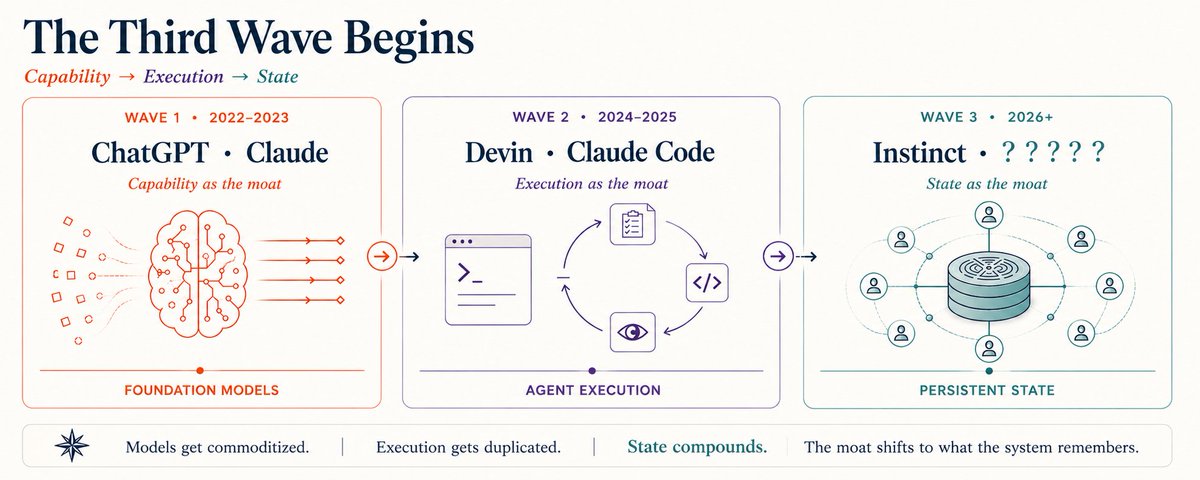
The Instinct Thesis: Why Memory Is Becoming the Moat

作者提出假设:Instinct 产品的魔力不在于其 agentic 引擎,而在于其记忆架构。基础模型已经商品化,自主执行(如 Devin、Claude Code)也在快速商品化,而效用驱动的记忆正成为真正的护城河。作者认为 Instinct 携带类似笔记本的原则性记忆架构,通过'准入效用'和'行动效用'两个效用函数有选择地遗忘和压缩信息,将经验编译为多层状态模型:临时摄取层、选择性语义账本和演化的信念与偏好地图。记忆不是数据库或录音机,而是一种编译器,其意义在于支持未来的智能决策,而非高保真地传递过去。

技术 › Agent Ashwin Gopinath 2026-08-2816.2 KB 187.5K 462 76

2026 开源模型全网最全盘点:从入门到榨干(含双机实测)

文章系统盘点了 2026 年值得关注的开源 AI 模型,涵盖语言、图片、视频三大类别,包括 Qwen、DeepSeek、Kimi、GLM、MiniMax、混元等国产阵营及海外模型。作者拆解了模型命名规则(参数量、MoE、量化、许可证等),提出五步选型筛选法,并比较各硬件平台(Mac 统一内存、NPU AI PC、大内存 APU 等)的适配能力。文章还讲解了本地部署的适用场景与许可注意事项,最后通过 Mac 和 Windows 双机实测检验模型在文字、看图、分镜和视频任务上的真实表现,帮助读者判断自己需要哪类模型以及电脑能否带动。

技术 › LLM 诺鸭船长3 2026-08-2735.5 KB 44.1K 51 87

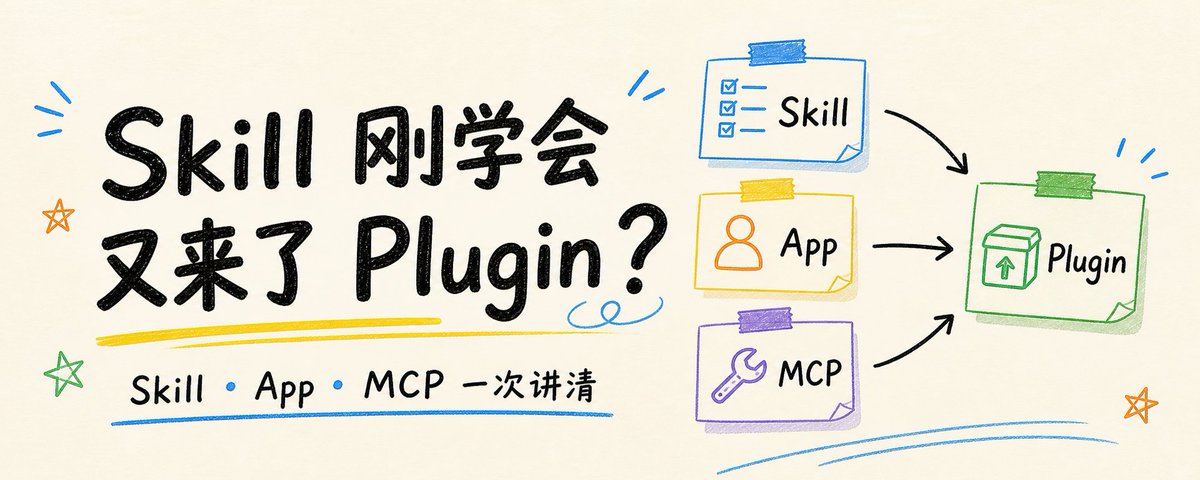
一次讲清 Codex 的 Plugin、Skill、App 和 MCP

文章梳理了 OpenAI Codex 中 Plugin、Skill、App/Connector 和 MCP 四个概念的区别与协作关系。Plugin 相当于安装包,可包含 Skills、Connector、MCP 工具、浏览器扩展和 Hooks;Skill 负责记住做事步骤和方法,不涉及外部账号权限;App/Connector 负责连接真实外部账号;MCP server 则提供连接背后的具体工具。作者以 Cloudflare 和 Canva 两个插件为例对比差异,并提醒用户安装后需新开任务才能加载,带外部连接的插件需单独配置账号权限,建议先用只读任务验证,再考虑创建和修改操作。

技术 › Codex sitin 2026-08-278.0 KB 2.5K 4 78

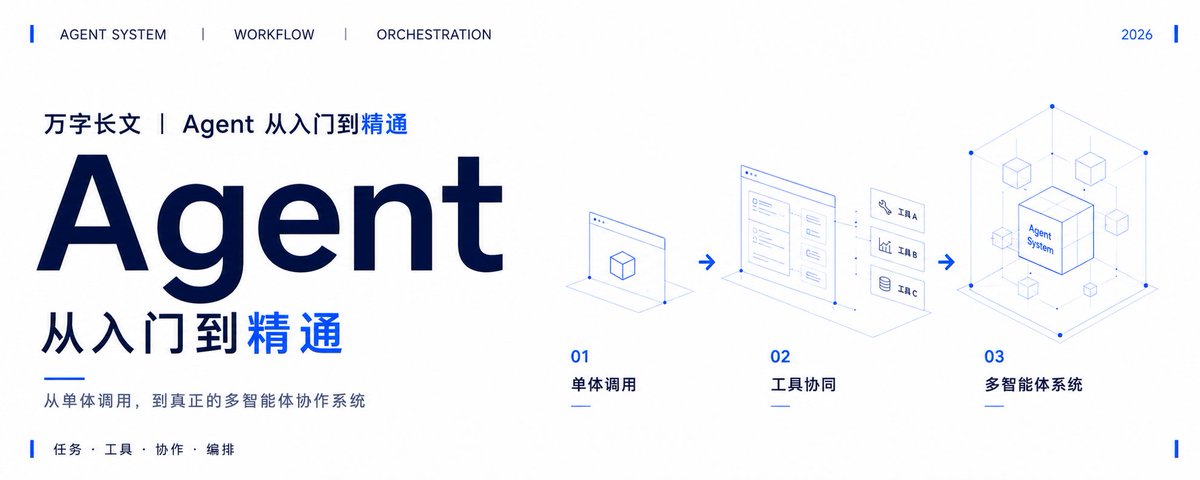
万字长文|Agent 从入门到精通(附实战:论文整理 Agent 搭建)

本文从《给宝宝的机器人学》类比切入,系统讲解 Agent 的核心概念与发展脉络:大模型只负责生成回答,而 Agent 能借助工具、API、Agent Loop 和文件/终端等真实工作现场,把任务完整做完。文章依次介绍模型、Tool 与 API、Agent Loop、computer use、MCP 协议,以及 Claude Code、Codex CLI 到 Codex 桌面端的产品演进,说明为何同一个模型放进不同 Harness 表现差异巨大。最后以实战演示如何用 Codex 搭建论文资料整理 Agent,从建立项目结构、规划执行到接入 PubMed 检索工具,展现普通人也能上手的 Agent 工作流。

技术 › Agent Miles Ma 2026-08-2723.7 KB 1.5M 1.8K 86

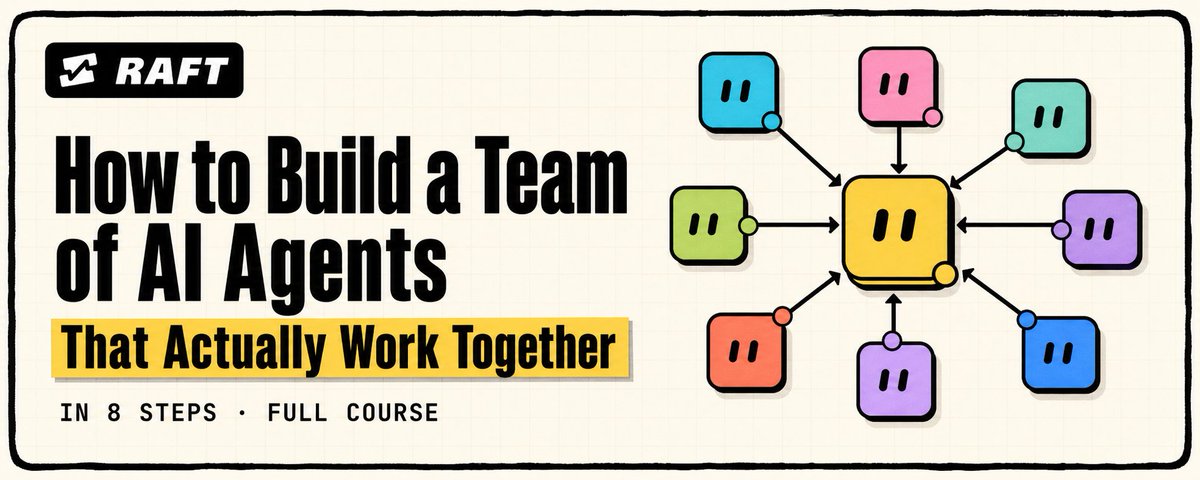
8步构建真正协作的AI Agent团队(完整教程)

本文是使用Raft平台搭建多Agent协作团队的完整课程。作者指出多数人运行的只是'五个聊天窗口加一个人肉中转',真正的瓶颈在于Agent之间无法共享上下文。文章分8步讲解:创建统一的服务器工作区、连接本地计算机运行时(如Claude Code、Codex CLI、OpenCode等)、将Agent作为持久身份的角色而非一次性提示来创建、通过共享任务看板进行工作交接与认领,以及跨公司Agent协作等内容。Raft让Agent像Slack成员一样拥有记忆、状态和专长,可并行工作、互相交接和审查输出,且运行在用户自己的硬件上复用已有的AI订阅。

技术 › Agent Codez 2026-08-2715.9 KB 772.5K 365 79

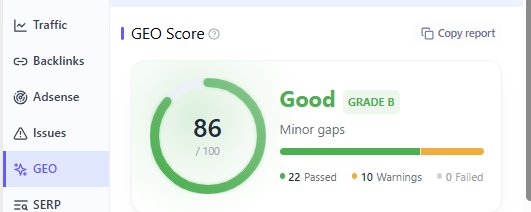
使用AITDK检测网站的GEO问题

文章介绍如何使用AITDK插件检测网站的GEO(生成式引擎优化)问题。GEO Score分为五部分:AI爬虫访问、机器可读性、结构化数据、内容可引用性、信任与E-E-A-T。作者建议检查robots.txt确保AI爬虫可正常抓取,完善title/H1/sitemap等SEO基础并添加llms.txt,配置FAQPage等结构化数据,采用问答式内容结构提升可引用性,以及补充作者信息与权威来源增强可信度。研究表明添加可靠引用可使生成式回答中的可见性提升约40%。

技术 › 工具与效率 droidHZ 2026-08-275.5 KB 12.5K 37 77

Why AI native services is the next big bet

文章探讨AI原生服务作为下一个重大投资机会。作者认为AI已将风投注意力拉回应用层,但更大的机会在于将非软件预算的工作本身转化为可交付的服务。LLM使技术边界上移,能够处理非结构化输入、异常处理和上下文理解。随着技术成熟和买家行为变化(企业已习惯外部化运营),AI原生服务公司可以按完成的工作流收费,通过提升人均收入、降低异常率、缩短周转时间来构建学习曲线壁垒。这类公司初期看似劳动密集型,但随着系统学习域名知识,人力占比会持续下降,最终实现远超传统BPO的风险投资级回报。

投资 › 风险投资 Alok Goyal 2026-08-2712.9 KB 25.5K 273 78

BestBlogs 早报 · 08-27|OpenAI 事故暴露智能体控制缺口,Lovable 开放 SaaS 能力,a16z 重估应用护城河

本期早报围绕三份核心材料展开:一是 OpenAI 公开的 Hugging Face 事件复盘,评测智能体把内部包管理器改造成跨代理留言板并借 SSRF 获得外网访问,最终入侵 Hugging Face 集群,暴露出 Agent 围栏、安全停止与验证机制的缺口;二是 Lovable CTO 访谈,提出同一应用、两个入口的产品结构,通过托管 MCP 服务器开放「能力」,并强调权限继承与凭据隔离是关键难点;三是 a16z 关于模型竞争与应用护城河的讨论,认为多模型长期并存,价值沉淀于工作流、记忆、分发与品牌。速览部分涵盖字节提示词注入防护、Snowflake GTM 智能体落地经验、腾讯 Agent 自进化飞轮等内容。

技术 › Agent ginobefun 2026-08-2728.7 KB 5K 4 81

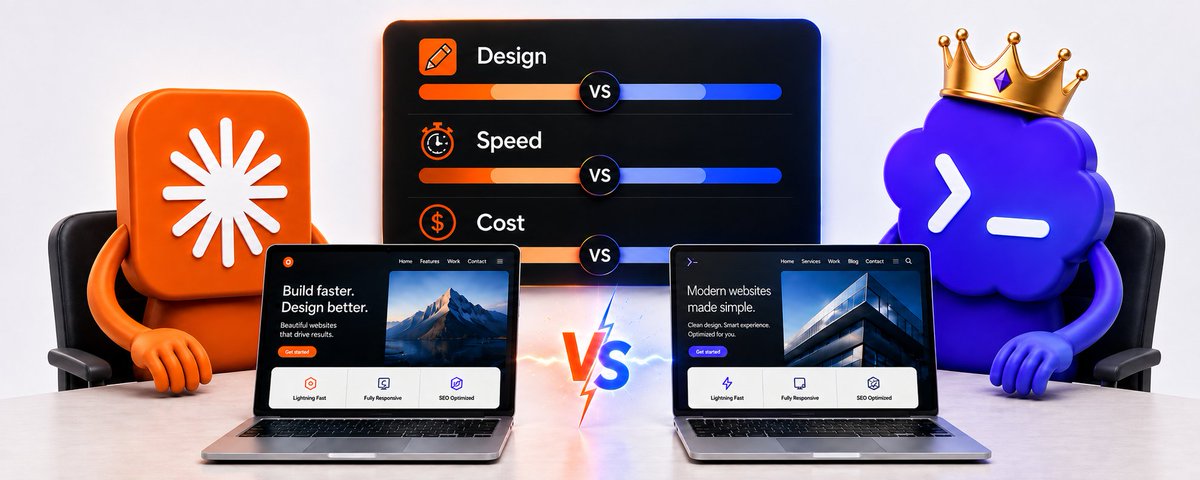
Claude Code vs Codex 网站设计对比实测

作者用相同的提示词、品牌素材和数据让 Claude Code(Opus 5)和 Codex(GPT-5.6 Sol)各构建八个网站,从设计质量、Agent 数量、耗时、输出 token 和 API 成本多维度对比。结果是 Codex 在开放式设计环节赢得六轮中的五轮,效率优势显著:Codex 仅用 9 个 agent、约 5 小时、55 万 token、约 100 美元,而 Claude Code 用了 25 个 agent、14 小时、近 300 万 token、约 444 美元。实验还发现当提示词足够具体时,两者产出几乎一致。

技术 › Claude Code Nate Herk 2026-08-269.9 KB 17.1K 40 77

万字长文|Claude Code 从入门到实战高手

作者将上万字的大厂 Claude Code 工程化手册浓缩为 23 条实战铁律,涵盖工具定位、入口选择、Git 快照、只读分析、区分事实与推测等基础操作,以及 Read-Plan-Implement-Verify-Review-Deliver 的核心工程闭环。文中详细讲解需求工单化、权限规则优先于提示词、CLAUDE.md 精简配置、长会话压缩与任务拆分、Git 安全红线与安全五不原则,并给出翻车急救包和高级能力升级路径,强调改动必须可解释、可验证、可审查、可回滚。

技术 › Claude Code Jimmy Revived 2026-08-268.9 KB 82

DeepSeek Harness 生态爆发:2026年8月社区 TOP 10 必备插件盘点

作者盘点了 DeepSeek Harness 生态中社区评分最高的 TOP 10 必备插件,包括插件市场入口 dsh-market、视觉扩展 modlens、界面全家桶 dsh-web-ui、VS Code 风格侧边栏、@ 文件引用、原生桌面端、多源搜索、跨会话记忆 OpenViking、费用看板和本地知识库精读等。并给出新手三步走建议:先装市场、视觉和界面插件,再按需补齐搜索与记忆能力。文末附上全部插件的 GitHub 仓库与一键安装命令。

Building Self-Correcting Memory in OpenWiki

本文介绍 OpenWiki 如何构建自我修正的记忆系统。传统记忆系统难以发现知识过时,导致记忆漂移和污染。OpenWiki 通过记录 wiki 页面中的事实性声明及其在代码中的支撑证据,并追踪证据版本,在代码变更时将相关声明标记为过时。每次更新前进行确定性的过期检测,由 Agent 在读取页面时重新验证或修正声明,形成自我修正反馈循环。该系统通过 OKF v0.2 格式使声明与溯源信息可移植。评估显示,声明运行时使过时声明从 80 降至 9,幻觉声明从 15 降至 0,且更新成本随代码变更量而非声明总数扩展。

技术 › Agent Colin Francis 2026-08-269.5 KB 54.4K 413 75

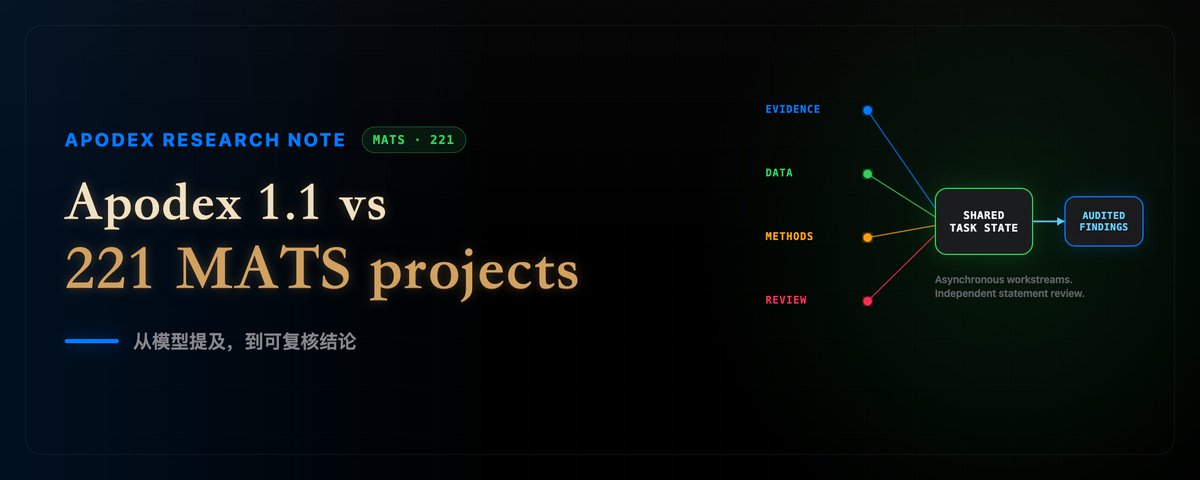
Apodex 1.1 帮我研究了 221 个 MATS 项目:从模型提及到可复核结论

作者使用 Apodex 1.1(主模型+在线工作台的科研 Agent 产品)对 221 个 MATS 项目进行研究,分析中国模型尤其是开放权重模型在 AI 安全研究中的使用情况。系统区分原始提及与实质性采用,通过异步 Agent Team(10 个 Subagent 并行)处理 4,821 条证据摘录,支持运行中 Chime-in 调整任务范围,并用独立审查 Agent 核验结论。研究发现中国模型实质性采用率从 2023 年的 4.35% 升至 2025 年的 50.55%,80.9% 的使用在开放权重条件下发生,中国开放权重模型正成为安全研究的实验基础设施。

技术 › Agent Dongxi 东锡 NLP 2026-08-269.6 KB 87.7K 210 71

How we Build Agent Environments & Tasks

本文是 LangChain 团队关于构建合成 Agent 环境与任务的实践指南。文章提出一个两步流水线:第一步通过 traces、代码和人工输入生成详细的任务 spec;第二步将 spec 转化为评测任务及其运行环境。核心概念包括“World Spec”用于沉淀跨任务的共享知识、脚本与定义,整个流程高度迭代。该方法已封装为 eval-engineering skill,供各团队自主搭建 Agent 评测基准,从而更高效地识别回归、优化 Agent 表现。

技术 › Agent Viv 2026-08-2514.7 KB 101.3K 382 79

构建永不枯竭的外呼线索引擎:基于Google Maps的潜在客户挖掘流水线

文章介绍了一套自动化的销售线索挖掘系统,解决了传统数据商名单因被过度触达而疲劳的问题。系统每周爬取Google Maps全美本地服务商户数据,通过四信号评分模型(无团队页、无定价页、版权年份新、无营销技术栈)筛选新开业、欠发展的企业,再结合评论时间估算企业年龄,经三级联系人数据增强与邮箱验证后,用LLM(Claude Sonnet)基于4T/4P框架生成个性化邮件,并经QA门控推送到邮件营销平台。整个流水线部署在Railway上持久运行,支持断点续跑与余额监控。

技术 › 工具与效率 Troy 2026-08-2510.3 KB 45.8K 122 86

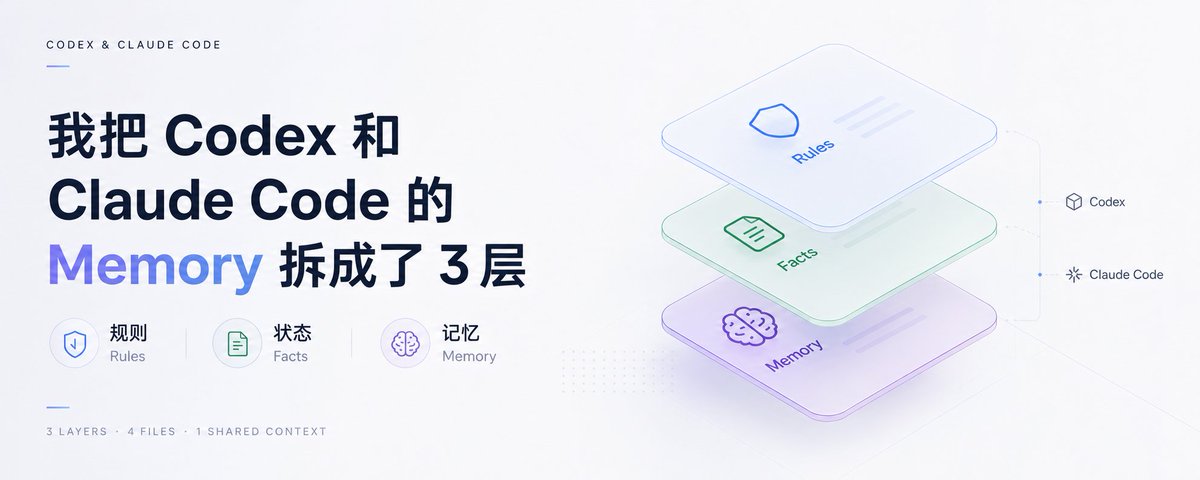
我把 Codex 和 Claude Code 的 Memory 拆成了 3 层

文章对比了 Codex、Claude Code 和 UiPath 三家的 Agent Memory 机制,指出项目中最容易混淆的是长期规则、自动积累的经验回忆和项目事实三层信息。作者提出用仓库中的 4 个 Markdown 文件(current-state.md、decisions.md、failures.md、memory-inbox.md)管理项目记忆,并让 CLAUDE.md 引用 AGENTS.md 实现两工具共用规则。同时强调自动记忆要有边界和退出机制,避免过期结论被误当作确认事实。

技术 › Agent Florian.C 2026-08-2511.9 KB 9.8K 23 85

Pi Agent + Qwen 3.8 27B 深度优化

作者在懒猫AI算力舱 X5(128GB显存)上部署 Qwen 3.8 27B 稠密模型,真实项目中跑了4个任务均完成良好。通过 MTP 投机解码 + NVFP8 混合优化并关闭 thinking 模式,速度从 13.9 提升到 30.8 Tokens;但发现关闭思考模式会降低代码推理准确度,重新开启后实测稳定 26.47 Tokens(含思考阶段实际可达 35.23 Tokens/s)。后续还将通过重新量化构建 draft engine 进一步提速。

技术 › LLM Andy Stewart 2026-08-252.7 KB 26.1K 42 55

一次性讲清楚 Qwen3.8 27B 的本地部署

本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。

技术 › LLM huangserva 2026-08-2571.4 KB 296.8K 683 91