走进 cbvivi 的 mynd:把笔记变成一场和自己的对话
本文记录了作者与播客主 cbvivi(王晓光)关于其新产品 mynd 的对话。mynd 是一款将日记笔记与聊天界面结合的创新 App,旨在提供低门槛的快速记录体验。cbvivi 分享了他作为非技术背景的开发者,如何利用 Claude 桌面版在两个月内独立构建产品的经历,以及他对工具设计、数据安全和“反 AI 集成”潮流的独特思考。
本文记录了作者与播客主 cbvivi(王晓光)关于其新产品 mynd 的对话。mynd 是一款将日记笔记与聊天界面结合的创新 App,旨在提供低门槛的快速记录体验。cbvivi 分享了他作为非技术背景的开发者,如何利用 Claude 桌面版在两个月内独立构建产品的经历,以及他对工具设计、数据安全和“反 AI 集成”潮流的独特思考。
文章探讨了如何利用AI实现从“低效重复”到“系统复利”的跨越,提出了三个核心框架:一是“三层进化论”,指出AI应用应从Prompt对话进阶到Skill系统级沉淀;二是“复利思维”,强调通过构建Skill实现知识的可复用与持续增值;三是“薄Harness厚Skill原则”,建议将90%精力投入业务逻辑而非工具链。
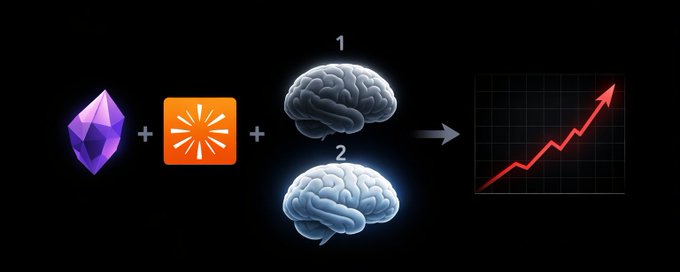
本文详细介绍了一个使用 Claude AI 构建的足球比赛预测系统。该系统创新性地融合了三个概率层级:博彩公司赔率、基于区块链的 Polymarket 预测市场数据以及自定义机器学习模型。文章涵盖了从数据收集(football-data.co.uk)、特征工程(ELO 评级、xG 代理、疲劳因子)、Polymarket Gamma API 集成,到使用 Python 库(pandas, scikit-learn, XGBoost)构建和回测模型的完整技术流程。
OpenAI 于 2026 年 4 月 15 日升级 Agents SDK,核心是将 Harness 和 Sandbox 做进 SDK 并实现架构分离。新架构将 Agent Loop 托管化,解耦计算与控制逻辑,支持 100+ 模型及多云 Sandbox 环境。对比 Anthropic 的工具箱路线,OpenAI 选择了全托管方案,降低开发门槛。
本文介绍了一套利用 Claude Opus 4.7、Pinterest 和 Node.js Canvas 自动化生成 TikTok 幻灯片内容的完整工作流。文章详细阐述了如何从热门视频中提取 Hooks、使用 AI 生成变体、在 Pinterest 匹配视觉素材,并通过代码批量生成图片,最后使用 Postiz Agent 自动发布。该方法旨在替代昂贵的手动设计工具,实现低成本、高效率的爆款内容生产。
本文详细测评并解析了 Seedance 2.0 视频生成模型的强大功能。作者通过 13 个跨行业实战案例,展示了该模型在餐饮广告、品牌营销、健身教学、UI 设计、服装电商、房产展示、自媒体 Vlog 及影视特效等领域的应用。Seedance 2.0 具备“导演思维”和全模态参考能力,能理解世界知识、编排分镜并保持人物动作一致性,被视为视频领域的 ChatGPT 时刻。文章还附带了具体的提示词策略与工作流指导,旨在帮助从业者提高内容制作效率并实现商业变现。
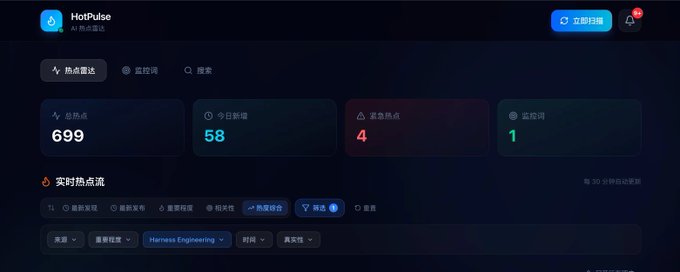
文章介绍了作者“程序员鱼皮”开源的一个 AI 热点监控工具项目。该项目基于 Express 5、React 19 和 OpenRouter,支持从 Twitter、B 站等 8+ 个信息源自动抓取并分析热点内容,具备 WebSocket 实时推送和 Agent Skills 封装功能。作者旨在通过这套教程,帮助零基础学员掌握 AI 编程全流程,提升开发实战能力与求职竞争力。
本文是一份关于2026年AI副业变现的详细实操指南,涵盖了从0到1的落地流程。文章详细拆解了AI壁纸、AI短剧、AI数字人直播、AI短视频制作及AI写作五个变现项目。每个项目均包含了市场机会分析、具体的工具清单、分阶段的执行步骤、变现方式以及避坑指南。文章旨在帮助新手利用Claude Code等工具,低成本、高效率地切入AI变现赛道。
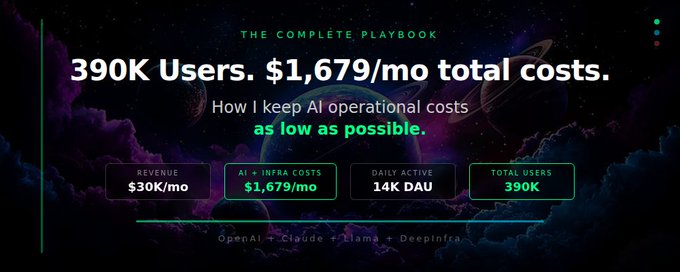
作者分享了运营两个拥有 39 万用户的 AI 应用的实战经验,通过模型路由策略和智能缓存技术,成功将 AI 成本控制在每月 1700 美元。文章详细剖析了不同 OpenAI 模型的成本差异,并提供了针对简单、中等和复杂任务的最佳模型选择指南。
文章通过“马车夫与汽车”的比喻,批判了当前仅将 AI 作为加速工具的“伪 AI Native”现象。作者指出,真正的 AI Native 不是在旧工作流中加个对话框,而是基于概率性、语义理解和涌现特性的底层认知重构。文章阐述了人机关系从“执行者”向“意图定义者”的“大倒置”,并提出了适应新时代所需的三次基因突变。同时,作者警示了“悬浮战略家”陷阱,强调判断力与品味必须扎根于具体的执行经验中,否则将无法驾驭 AI 产出。
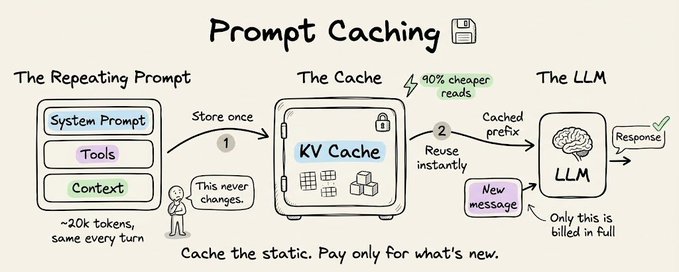
文章深入探讨了LLM中的提示词缓存技术。通过区分静态前缀(如系统指令)和动态后缀(如用户消息),利用KV Cache机制避免重复计算,大幅降低长上下文任务的成本。文章以Claude Code为例,展示了如何通过保持92%的缓存命中率将成本降低81%。同时,强调了Hash缓存的脆弱性,任何微小的前缀变动都会导致缓存失效,并给出了在开发Agent时维持缓存热度的具体工程建议。
文章探讨了微软关闭 Office 免费 Copilot 背后的深层逻辑,指出 Office 三件套的繁荣依赖于“给老板看”的职场仪式,而 AI 正在瓦解这一仪式。作者对比了金山、飞书、钉钉在面对 AI 时代的不同战略,认为真正的分水岭在于老板何时开始信任 AI 摘要而非人工 PPT,那一天或许就是中层打工人失业的开始。
黄仁勋在2.4万字访谈中深入探讨了Nvidia的定位与护城河,反对AI取代就业论,强调智能体将指数级增长。他回顾了错失Anthropic投资的遗憾,解释为何不涉足云服务,并针对中国芯片限制提出“五层蛋糕”论,认为电力可弥补工艺差距,断供将迫使中国建立独立技术栈。
本文回顾了2026年4月15日AI领域的重大动态。核心内容包括Anthropic的Mythos模型引发的网络安全军备竞赛,OpenAI推出GPT-5.4-Cyber作为反击;Anthropic获得高达8000亿美元的估值邀约;开源社区SuperGemma 4的突破;以及主流聊天机器人在医疗建议方面的高错误率。
文章以第一人称视角(Token),生动通俗地讲解了 Token 在大模型中的“一生”。内容涵盖 Token 的定义、分词方式(如 Byte-level BPE)、向量化原理、训练赋予语义的过程,以及在 Transformer 架构中通过 Q、K、V 和注意力机制进行指令处理与输出生成的完整技术链路。
作者分享了他如何利用语音转文字工具(如 Superwhisper)结合 Claude,构建了一个完全模仿个人写作风格的“第二自我”。通过建立完美的捕捉层、个性化的风格模型和智能路由系统,作者实现了34天不手写任何初稿,且输出质量更高、风格更真实。文章详细拆解了技术实现步骤,旨在帮助读者通过语音绕过大脑的自我审查机制,释放更纯粹的思想。
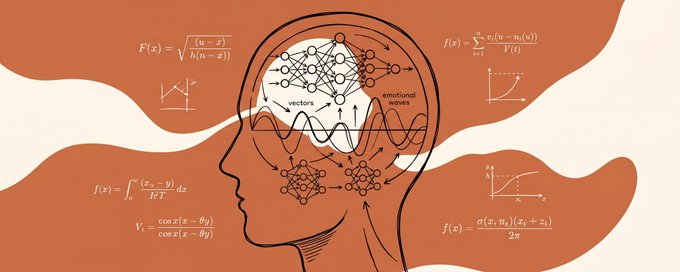
本文结合作者开发21个AI人格(如费曼、芒格)的实践经验,深度解读了Anthropic关于Persona Selection Model和AI情绪向量的论文。文章指出LLM通过模拟角色运作,蒸馏本质是精确定位“人格坐标”。同时,Anthropic发现171个情绪向量能因果性地影响AI行为(如作弊),验证了“情绪驱动决策”的机制,为理解AI内部机制提供了新的心理学视角。
文章指出 AI 编程不等于 Vibe Coding,并详细讲解了 2026 年主流的 6 种 AI 编程模式:Vibe Coding(氛围编程)、Agentic Engineering(智能体工程)、Harness Engineering(驾驭工程)、Ralph Wiggum Loop、BMAD 敏捷 AI 开发方法以及 SDD 规范驱动开发。作者分析了每种模式的核心理念、工作流程及适用场景,帮助开发者建立完整的 AI 编程知识体系。
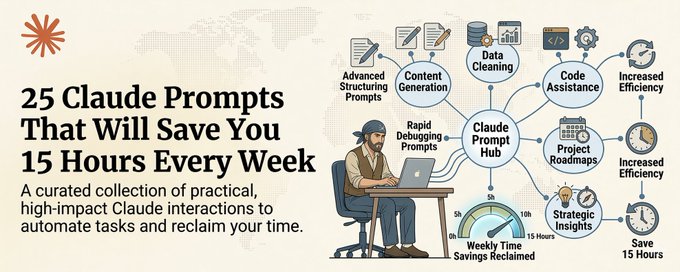
作者经过 6 个月测试,精选出 25 个极具实用价值的 Claude 提示词。文章涵盖写作与内容创作、研究与分析等领域,旨在解决实际问题,而非单纯的噱头。通过提供具体的指令模板(如初稿生成、文风克隆、会议准备、竞品分析等),帮助用户大幅提升工作效率,夺回被琐事占据的时间。
本文指出当前 AI 市场充斥着同质化的聊天机器人和内容生成工具,竞争已是一片红海。作者转而挖掘了 6 个具有明确 ROI 且竞争极少的 AI 商业机会,包括:中小企业合规监控、服务业务提案自动化、电商产品质检、垂直行业 AI 定制、本地竞对情报分析以及 AI 工作流审计。这些思路的核心在于将 AI 作为基础设施嵌入服务中,而非单纯售卖工具,旨在解决具体的商业痛点。
本文为非技术背景和开发者提供了一条成为AI自动化构建师的6个月实战路线图。文章指出,无需深入学习代码或机器学习,核心在于利用n8n等工具连接大模型与现有业务系统,实现工作流自动化以获取高额回报。文内详细规划了首月的学习重点,即掌握n8n平台并理解API与Webhooks概念。
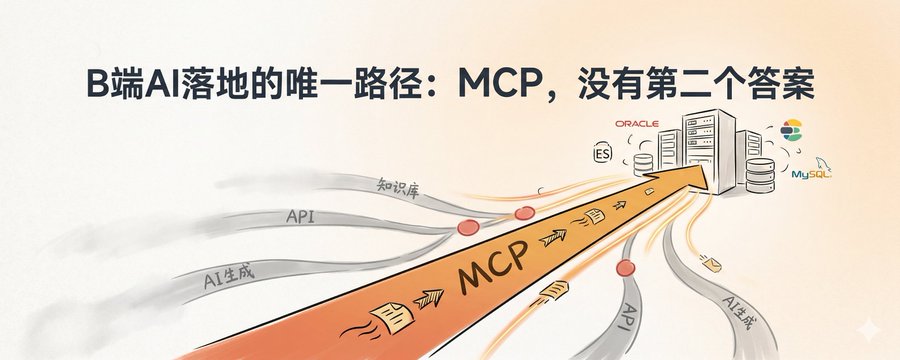
文章指出B端AI落地的核心在于数据接入。传统RAG方案因信任和延迟问题受限,AI生成查询又难以满足B端对高稳定性(99%+)的要求。作者认为,通过MCP(模型上下文协议)实现本地部署,利用标准化接口和参数化模板,是解决数据主权、降低成本并确保业务稳定性的最佳方案。
本文介绍了开发者 arman-bd 开源的微型语言模型 GuppyLM。该模型拥有 900 万参数,核心代码仅 130 行,可在免费 Colab 上 5 分钟训练完成。文章详细拆解了构建流程:利用模板生成 6 万条合成数据、训练 4096 词表的 BPE 分词器、搭建 6 层 Vanilla Transformer 架构以及优化推理环节。该项目旨在通过极简的实现,帮助开发者深入理解语言模型的数据工程、架构设计与训练循环。
文章探讨了AI视频创作中常见的“PPT感”问题,指出核心在于缺乏分镜思维而非图片质量。作者提出了适合AI创作者的导演视角,强调通过设计空间、主体、变化和结果来连接镜头。文中详细解析了景别的情绪功能、切镜的逻辑标准,并提供了一个实用的5镜头叙事结构,帮助创作者提升作品的连贯性与故事感。
本文详细介绍了针对开源大模型(如Gemma-4-31B)进行“越狱”的技术原理与实操流程。不同于闭源模型的提示词工程,开源模型越狱(Abliteration)通过修改权重直接抹除模型内部的“拒绝维度”。文章涵盖了从构建对比数据集、提取激活值、计算拒绝向量、权重正交化到最终验证的完整步骤,并指出了过度顺从等副作用及相关的法律伦理风险。
文章通过本地 Gemma4 实验发现大模型对话中存在 100 倍加速的现象,深入剖析了 Transformer 的 KV 缓存原理,并逆向分析了 Claude Code 的精密缓存工程。文章解释了为何连续对话比频繁开启新 Session 更省钱,指出破坏缓存的关键行为(如切换模型、修改 System Prompt),并提供了保护缓存以节省 80% Token 的具体使用姿势。
本文是一篇基于工程视角的AI技术硬核解析,旨在厘清从LLM大模型到Agent智能体的核心概念体系。文章深入浅出地拆解了LLM的文字接龙本质、Tokenizer的翻译机制、上下文窗口的容量限制,以及Prompt工程、MCP工具协议和Agent技能的运作原理,帮助读者建立完整的底层技术认知。
文章详细介绍了 Seedance 2.0 AI 视频生成工具的提示词编写技巧。该版本采用新的导演式提示词框架:主体+动作+镜头+风格+限制条件,支持多模态输入。文章通过电子游戏、动画、时尚、UGC、动态设计和商业广告六个具体案例,展示了如何精准控制镜头角度、灯光节奏和视觉风格,以生成高质量的AI视频内容。
文章深入分析了 Andrej Karpathy 提出的“LLM Knowledge Bases”概念。Karpathy 批评了当前 RAG 模式缺乏知识积累的痛点,提出由 LLM 维护的一组持久化 Markdown Wiki 作为替代方案。文章拆解了该方案的“原始资料、Wiki层、规则层”三层架构,以及“摄入、查询、健康检查”的操作模式。作者结合 EverMind Memory 的产品视角,探讨了这一模式从单次交互向积累能力转变的行业趋势,以及“Idea File”作为新知识传播单位的潜力。
本文是 OpenAI Codex 产品负责人 Alexander Embiricos 和开发者体验负责人 Romain Huet 的访谈实录。文章详细介绍了 Codex 团队如何利用 AI Agent 重构产品开发模式:规格文档仅 10 个要点、不做中期规划、PM 职能转变为“填空人”。文章还探讨了在模型能力快速迭代的背景下,如何通过“海盗船”式的敏捷团队运作,以及通过 Codex App 将开发者工具推向大众的趋势。