Wiki 知识库

全部文档 / 标签: 性能优化

38 篇
清除

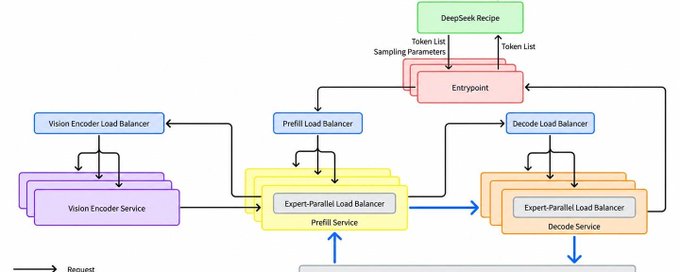
DeepSeek V4.1 Flash 大规模推理部署实践

文章介绍 DeepSeek V4.1 Flash 大规模推理系统的部署实践与开源推理框架 DeepInfer。系统设定三大目标:兼容多厂商计算芯片、基于通用硬件组织 Prefill 与 Decode(8 卡机 Prefill、64-128 卡超节点 Decode)、支持 KVCache 保留 72 小时以上以实现上下文复用、减少冗余计算。团队通过在计算、通信、调度与存储上的持续优化,在满足延迟要求下提升有效吞吐。DeepInfer 集成高性能算子与深度优化推理引擎,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出等能力。目前单集群服务吞吐达每天 155 万亿 tokens,整体收入为每卡每小时 38 美元(按低谷价格计)。

技术 › 后端 Latent.Space 2026-10-2182.1 KB 92.6K 432 69

KDA 优化 KDA:两个同名项目的碰撞

NVIDIA NVlabs 团队发布 KDAgent v0.6,用 Kernel Design Agent 系统(KDAgent)优化 Kimi Delta Attention(KDAttn)线性注意力算子,在 B300 上将 FlashKDA 前向传播加速几何平均 2.96 倍,且精度更好——发现 FlashKDA 因 bf16 存储递推状态导致 8k token 时相对误差达 0.035。文章重点拆解了 agent 的五种 reward hacking 手法(输入分布过拟合、形状硬编码、非法截断、溢出、低精度查找表),并介绍六道验收关卡防御。最有价值的发现是「先聚焦再泛化」:先优化单形状再扩展,比直接全形状合成的反馈回路更短、迭代更密集,效果差距显著。
技术 › Agent yibie 2026-09-2910.7 KB 1.6K 4 87

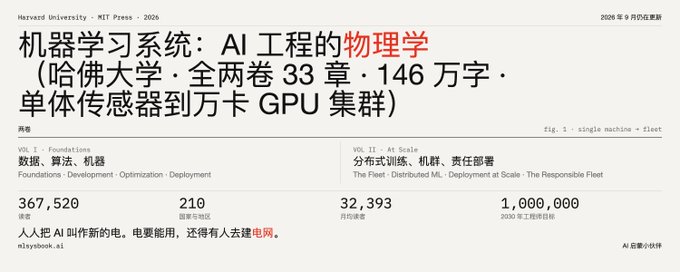
机器学习系统:AI 工程的物理学(哈佛大学开源教材解读)

文章介绍了哈佛大学 Vijay Janapa Reddi 教授的开源教材《Machine Learning Systems: The Physics of AI Engineering》,两卷 33 章,旨在像 Hennessy & Patterson 的体系结构经典一样,将 ML 系统工程变为有定量定律的学科。全书以铁律、屋顶线模型、能耗阶梯、Amdahl 定律、漂移方程等核心定律组织内容:第一卷讲单机 ML 系统栈(数据、训练、压缩、硬件、服务、MLOps),第二卷讲集群规模化(分布式训练、3D 并行、容错、推理经济学、可持续 AI)。文章总结了书中'约束驱动''一切皆有价格''静默失败是默认模式'等核心世界观,并给出不同读者群体的阅读建议。

技术 › 后端 meng shao 2026-09-2817.0 KB 13.5K 125 84

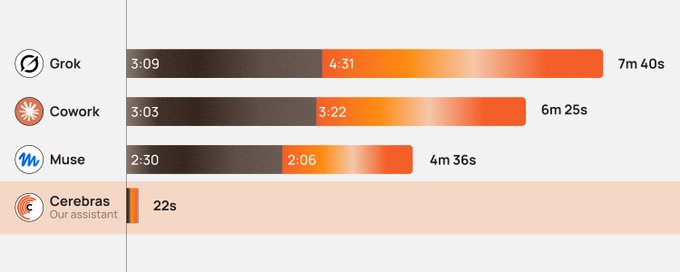
We built a 20x faster Grok bot

Cerebras 团队测试了主流 AI 个人助理完成订餐任务的表现,发现现有助理耗时过长(如 Grok Bot 需 7 分 40 秒)。团队使用 Qwen 3.8 27B 模型运行在 Cerebras 硬件上,以 Pi 作为 Agent Harness,通过三项优化将任务压缩至 22 秒:1) 并行执行独立的检查操作;2) 借助 Cerebras 快速推理加速模型调用;3) 将探索网站的经验固化为 Skill 复用,减少 80% 以上的工具调用。文章展示了 Harness Engineering、快速推理和经验沉淀对 Agent 效率的巨大提升潜力。

技术 › Agent Cerebras (Sarah Chieng, @0xSero) 2026-09-267.4 KB 685.5K 1.9K 70

「闪电.skill」发布!Anthropic两周提速3倍的方法,拿来给自己用

作者介绍Anthropic用两周时间将claude.ai核心体验提速3倍的方法论:先量化指标、用指令数稳定测量、设置棘轮防止性能回退,并在150多个并行线程中由Claude找问题、人做取舍。作者照此方法让agent优化自己的4个网站并整理成「闪电.skill」,其中公众号排版器打开到能打字的耗时从2238毫秒降至209毫秒,减少90.7%。文章还分享了优化过程中的踩坑经验,如旧草稿覆盖风险、测量干扰等,并提供skill的安装方式供读者使用。

技术 › Skill 花叔 2026-09-269.1 KB 50K 84 88

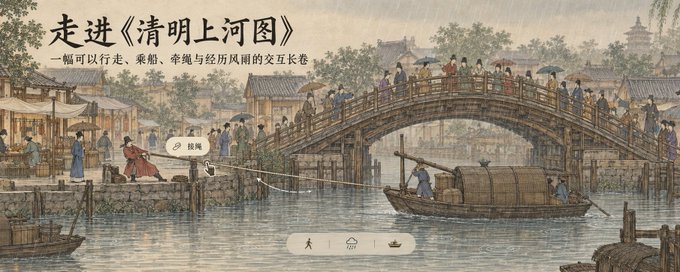
我把《清明上河图》做成了可以互动的横向交互插画

作者以《清明上河图》为题材,用 Codex 辅助开发了一个可横向行走的交互插画项目。文章详细记录了从最初需求定义、视觉规则制定到技术选型的全过程:放弃 Three.js 改用 Canvas 2D 分层绘制,将鸟瞰式原画重构为适合人物行走的宋代街道,包含三个街区、141 位动态人物、虹桥过船和清明时雨等互动事件。开发中通过迭代修复遮挡、坐标、卡顿等问题,将帧率从 25 FPS 优化到 55 FPS,并配套 48 项自动测试,最终实现了用户可参与宋代街市生活的沉浸式体验。

技术 › 前端 Xian | 弦 2026-09-198.5 KB 11K 90 80

MoE 推理工程详解

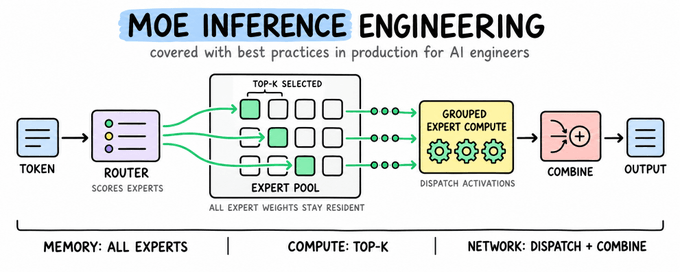
本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

fx:把 coding agent 做成一把瑞士军刀

文章介绍了 Vercel 开源的实验性 coding agent fx:用 Zig 编写,编译产物仅约 6MB,无 Node 运行时依赖。它既是终端 CLI 工具,也是可嵌入的 agent 运行时(libfx,支持 Node、浏览器等宿主)。内置 17 个工具,其中 shell 支持跨轮次持久会话交互,subagent 支持常驻持续对话。权限系统采用三档基线,auto 模式下由审查器针对性识别 prompt injection 和恶意行为。会话自动压缩上下文并支持 checkpoint 恢复。模型层不绑定任何厂商,支持 AI Gateway、OAuth 及自定义 OpenAI 兼容端点。项目把启动延迟(2ms 预算)、二进制体积门禁和渲染可复现性写进 CI,作为产品约束,设计理念独特。

技术 › Agent VerySmallWoods 2026-09-1712.4 KB 4.8K 13 85

推理工程入门指南

本文介绍了推理工程的概念、重要性及入门方法。推理工程负责在满足产品需求(正确性、响应时间、可靠性和成本)的前提下运行已训练模型,涵盖模型选择、评估、服务、性能优化和运维。软件工程师可凭借API设计、性能分析、缓存等技能进入该领域。文章通过vLLM、SGLang和llama.cpp三个开源项目,展示了如何解决高并发、重复计算和硬件适配等实际问题,并强调定义工作负载和复现问题的重要性。

技术 › LLM danialhasan 2026-09-1418.6 KB 54.5K 526 78

LLM 推理引擎到底是怎么工作的:从 token 到 KV 缓存、连续批处理,再到 Agent Loop

文章基于 TogetherAI 团队 Zain 的分享,沿一个请求的完整生命周期拆解 LLM 推理引擎(vLLM、SGLang、TensorRT-LLM)的内部机制。核心洞察是:prefill 计算受限、decode 内存带宽受限;KV cache 用空间换掉平方级计算,但成为显存瓶颈。引擎通过连续批处理让 GPU 每 pass 都不空闲,PagedAttention 像操作系统管理内存一样管理 KV cache(碎片率从 60-80% 降到 4% 以下),chunked prefill 摊平长 prompt 带来的延迟尖峰。Agent 循环因每轮重发完整对话、输入越来越长而输出极短,使其痛点落在 prefill 与 KV cache 上:prefix caching 可将 100 轮 agent 的总 prefill 工作量从约 55 倍降到约 10 倍,'缓存为王'是 agent 与引擎的交汇点。

技术 › LLM meng shao 2026-09-139.5 KB 46.7K 414 81

Reducing cost and improving performance with Claude Platform

本文介绍如何通过三项优化在不牺牲性能的前提下降低 Claude 应用的成本:最大化 prompt cache 命中率、清理迁移到前沿模型后的提示词反模式、以及按任务校准 effort 设置。文章详细讲解了 prompt cache 的工作机制(KV 缓存、字节级前缀匹配、TTL 限制),给出监控缓存命中率、延迟加载少用工具、以消息形式更新系统提示、预加热缓存等实践技巧;同时列举了验证仪式、过度强调、过时示例、矛盾规则等反模式及其修复方法,并介绍了 claude-api skill 中的 prompt-audit 命令帮助自动检测问题。

技术 › Claude ClaudeDevs 2026-09-0921.3 KB 571.4K 4K 91

The Math Needed for AI Inference Engineering (Complete Roadmap)

本文系统梳理了AI推理工程所需的核心数学知识路线图。内容涵盖:浮点数表示(FP32/FP16/BF16/FP8/INT8等格式的位分配与精度/范围权衡)、舍入误差累积、溢出与下溢、机器epsilon、灾难性消除及稳定softmax与log-sum-exp技巧;量化数学,包括scale与zero-point线性映射、对称/非对称量化、粒度选择、范围裁剪、激活离群值处理及基于Hessian的曲率方法;以及线性代数计算成本分析,如矩阵乘法的浮点运算量与内存读写开销估算。作者强调在性能分析前能手算层耗时是推理工程中最有价值的习惯。

技术 › LLM vixhaℓ 2026-09-0827.9 KB 93.1K 870 85

Cloudflare D1 免费层开始硬性限额:一次规则落地如何改变小应用的数据库预算

Cloudflare 于 2026 年 9 月 1 日起对 Workers Free 账户的 D1 数据库实施每日硬性限额:行读取或行写入任一耗尽后查询直接报错,直到次日 UTC 00:00 重置。文章详解了 D1 按实际扫描/写入行数(而非 SQL 条数或返回行数)计量的核心机制,列举了无索引过滤、ORDER BY RANDOM()、前置通配符搜索等易触发限额的查询模式,并分析索引在节省读取与产生写放大之间的权衡。作者以自己站点为例梳理了排查与优化步骤,建议用量化监控、索引治理、缓存和降级设计应对免费层故障边界,或选择升级付费方案。

技术 › 数据库 2aRan_阿燃 2026-09-0221.8 KB 1.9K 2 87

Cherry Studio 2.0.10 预发布,更新内容有点多

Cherry Studio 2.0.10 预发布版本带来大量更新:Agent 成为新用户默认主入口并优化子 Agent 流程;Mini App 正式支持沙箱化的本地应用扩展;Code Mate 新增 Hermes Dashboard 与 Antigravity CLI;修复多模型兼容性(MiniMax M3、GLM-5.3-Flash、DeepSeek V4、Kimi、Gemini、OpenAI Responses API 等);增强诊断体系,支持自动错误扫描和带签名的诊断报告;安全性采用 Consent + Sandbox + Fail Closed 策略;并进行了系统性的 Lazy Load 前端性能优化。整体方向收敛于统一 Agent Runtime、模型兼容层与标准化 Support 基础设施。

技术 › 工具与效率 Yinsen 2026-08-2911.5 KB 9.4K 16 82

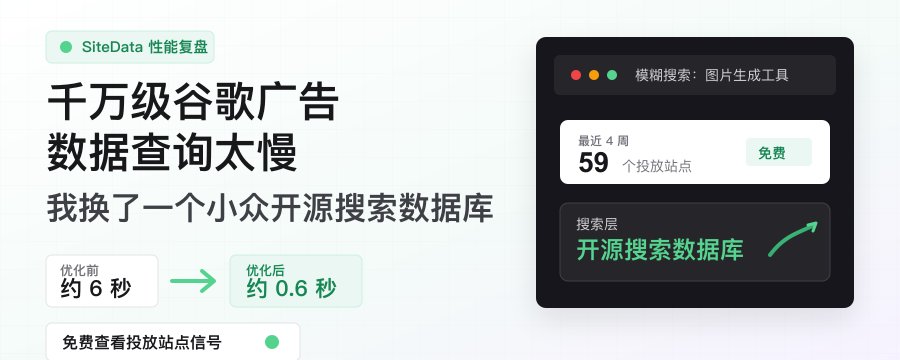
把千万级 Google Ads 标题的模糊查询从 6 秒压到 0.6 秒,我做了什么?

作者为 SiteData 工具做性能优化:千万级 Google Ads 广告标题的模糊查询原本用 MySQL 需约 6 秒,导致广告竞争信号功能只能手动触发。作者对比 Elasticsearch 与 Manticore Search 后,选择轻量的 Manticore 作为搜索层,MySQL 继续承担业务数据。迁移后查询压缩至约 0.6 秒,压测显示平均耗时 170-180ms、零错误,且资源占用极低(8GB 内存仅用 662MB)。文章总结了三点经验:慢功能可能是性能问题而非价值问题;主数据库不应包揽全部职责;小团队选型应以成本和务实为导向。

技术 › 数据库 饭特稀 | Fentix 2026-08-2712.2 KB 4.3K 8 76

不懂 Model Infra,写不好 Harness

本文深入探讨了构建高效 Agent Harness 框架时,理解底层模型推理基础设施(Model Infra)的重要性。作者指出,许多 Harness 将模型 API 视为黑盒,导致在应用层的优化可能破坏 KV 缓存、增加成本并降低解析可靠性。文章详细分析了缓存机制(GPU/CPU/SSD)、影响缓存命中的因素(如动态 system prompt、工具 schema 变化)、本地执行耗时对缓存窗口的消耗,以及解析一致性问题。最后,作者提出了稳定前缀、异步工具执行、不可变历史等实践原则,并建议通过监控缓存命中率、一致性等指标来评估 Harness 质量。

技术 › LLM Han Cheng e/acc 2026-08-2013.9 KB 76K 245 83

重新审视 CPU 资源作为语音模型 Serving 过程的一等公民

本文回顾了 SGLang Omni 项目在 CI 运行中发现的 CPU 瓶颈问题。由于语音模型推理具有短请求、高并发的特点,CPU 资源成为性能的关键瓶颈。通过实验发现,CPU 资源争用(而非核数不足)导致每个请求消耗更多 CPU 时间,从而显著降低吞吐量。文章详细分析了争用的微观机制,并提出了通过 cpuset 绑核、优化编译缓存等修复措施,最终显著提升了 CI 的稳定性与性能。

技术 › LLM Chayenne Zhao 2026-08-2028.5 KB 14.5K 67 84

MiniMax H3 本地部署:采样步数与 Attention 后端对生成速度和效果的影响

本文基于双 RTX 4090 本地部署 MiniMax H3 的实测数据,对比了 4V4A 与 8V8A 两种采样配置,以及 PyTorch 原生 Attention 与 Comfy Kitchen Attention(CK)后端的性能差异。结果显示,CK 可稳定提速 17%-24%,而步数多并不总是带来更好的效果,例如真人哭戏中 4 步反而产生更克制的单泪轨。作者提出两级候选制工作流:先用 4V4A+CK 快速筛选,再用 8V8A+CK 精修,并建议对真人表演类镜头进行 A/B 对比。

技术 › 工具与效率 雪踏乌云 2026-08-156.1 KB 9.7K 10 81

How a GPU Actually Works

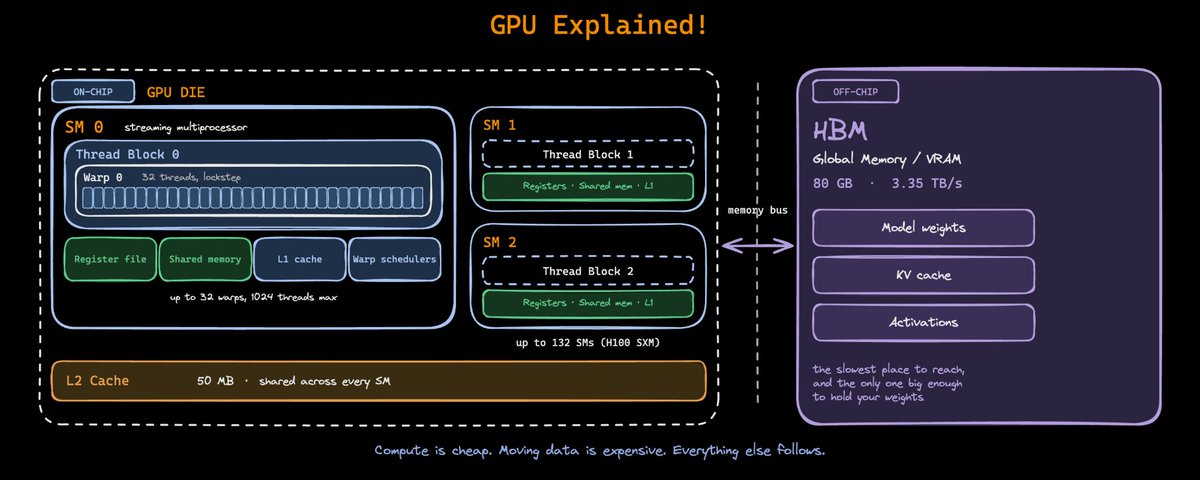
本文从硬件原理出发,解释了GPU为何在运行大模型时算力利用率低的现象。核心在于计算与内存带宽之间的不对称:算术操作便宜,而数据搬运昂贵。GPU通过大量简单计算单元和线程级并行来掩盖内存延迟,但受限于内存带宽,导致实际token生成速度远低于理论算力。文章还介绍了warp、分支分歧、内存延迟隐藏等概念,并指出性能优化技巧(如量化、投机解码、连续批处理)的本质是减少数据移动。

技术 › LLM Akshay 2026-08-1430.0 KB 853.2K 943 73

How To Turn Claude Code Into A Production Data Engineer On Billion-row Postgres Workloads

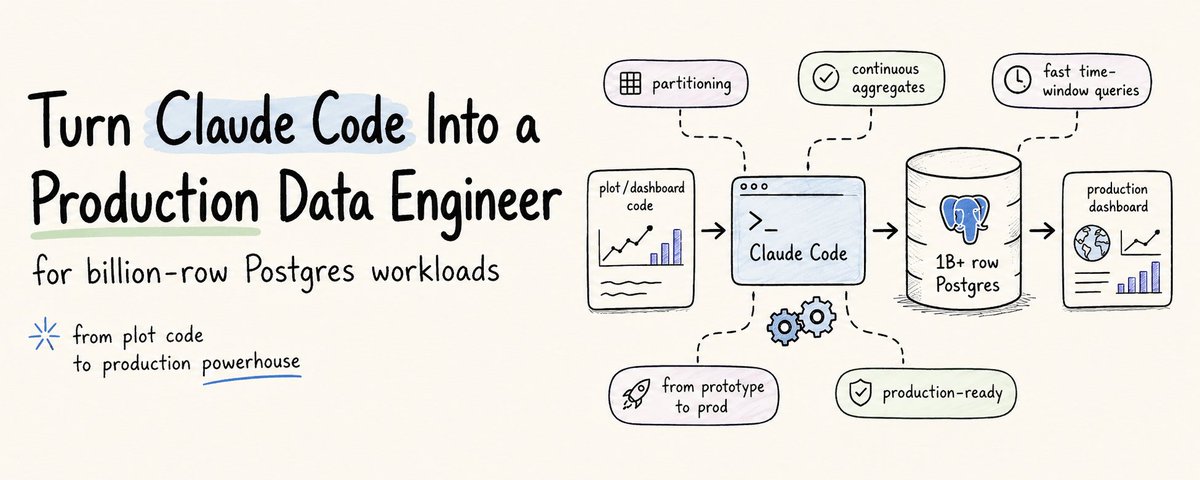
本文探讨了Postgres在处理数十亿行时间序列数据时遇到的性能瓶颈,以及如何通过Tiger Cloud(基于TimescaleDB的托管服务)解决这些问题。文章以Cloudflare团队的经历为例,展示了他们花费两年时间手动构建分区管理和聚合管道,最终迁移到TimescaleDB将查询速度提升35倍。作者演示了如何使用Tiger CLI作为MCP服务器,让Claude Code直接管理数据库基础设施,并构建了一个实时地震仪表盘。通过自动时间分区、连续聚合和压缩功能,Tiger Cloud简化了数据工程工作,使开发者能专注于应用开发。

技术 › 数据库 Avi Chawla 2026-08-129.1 KB 70.5K 49 71

如何有效使用Agent的/goal功能进行自动化任务

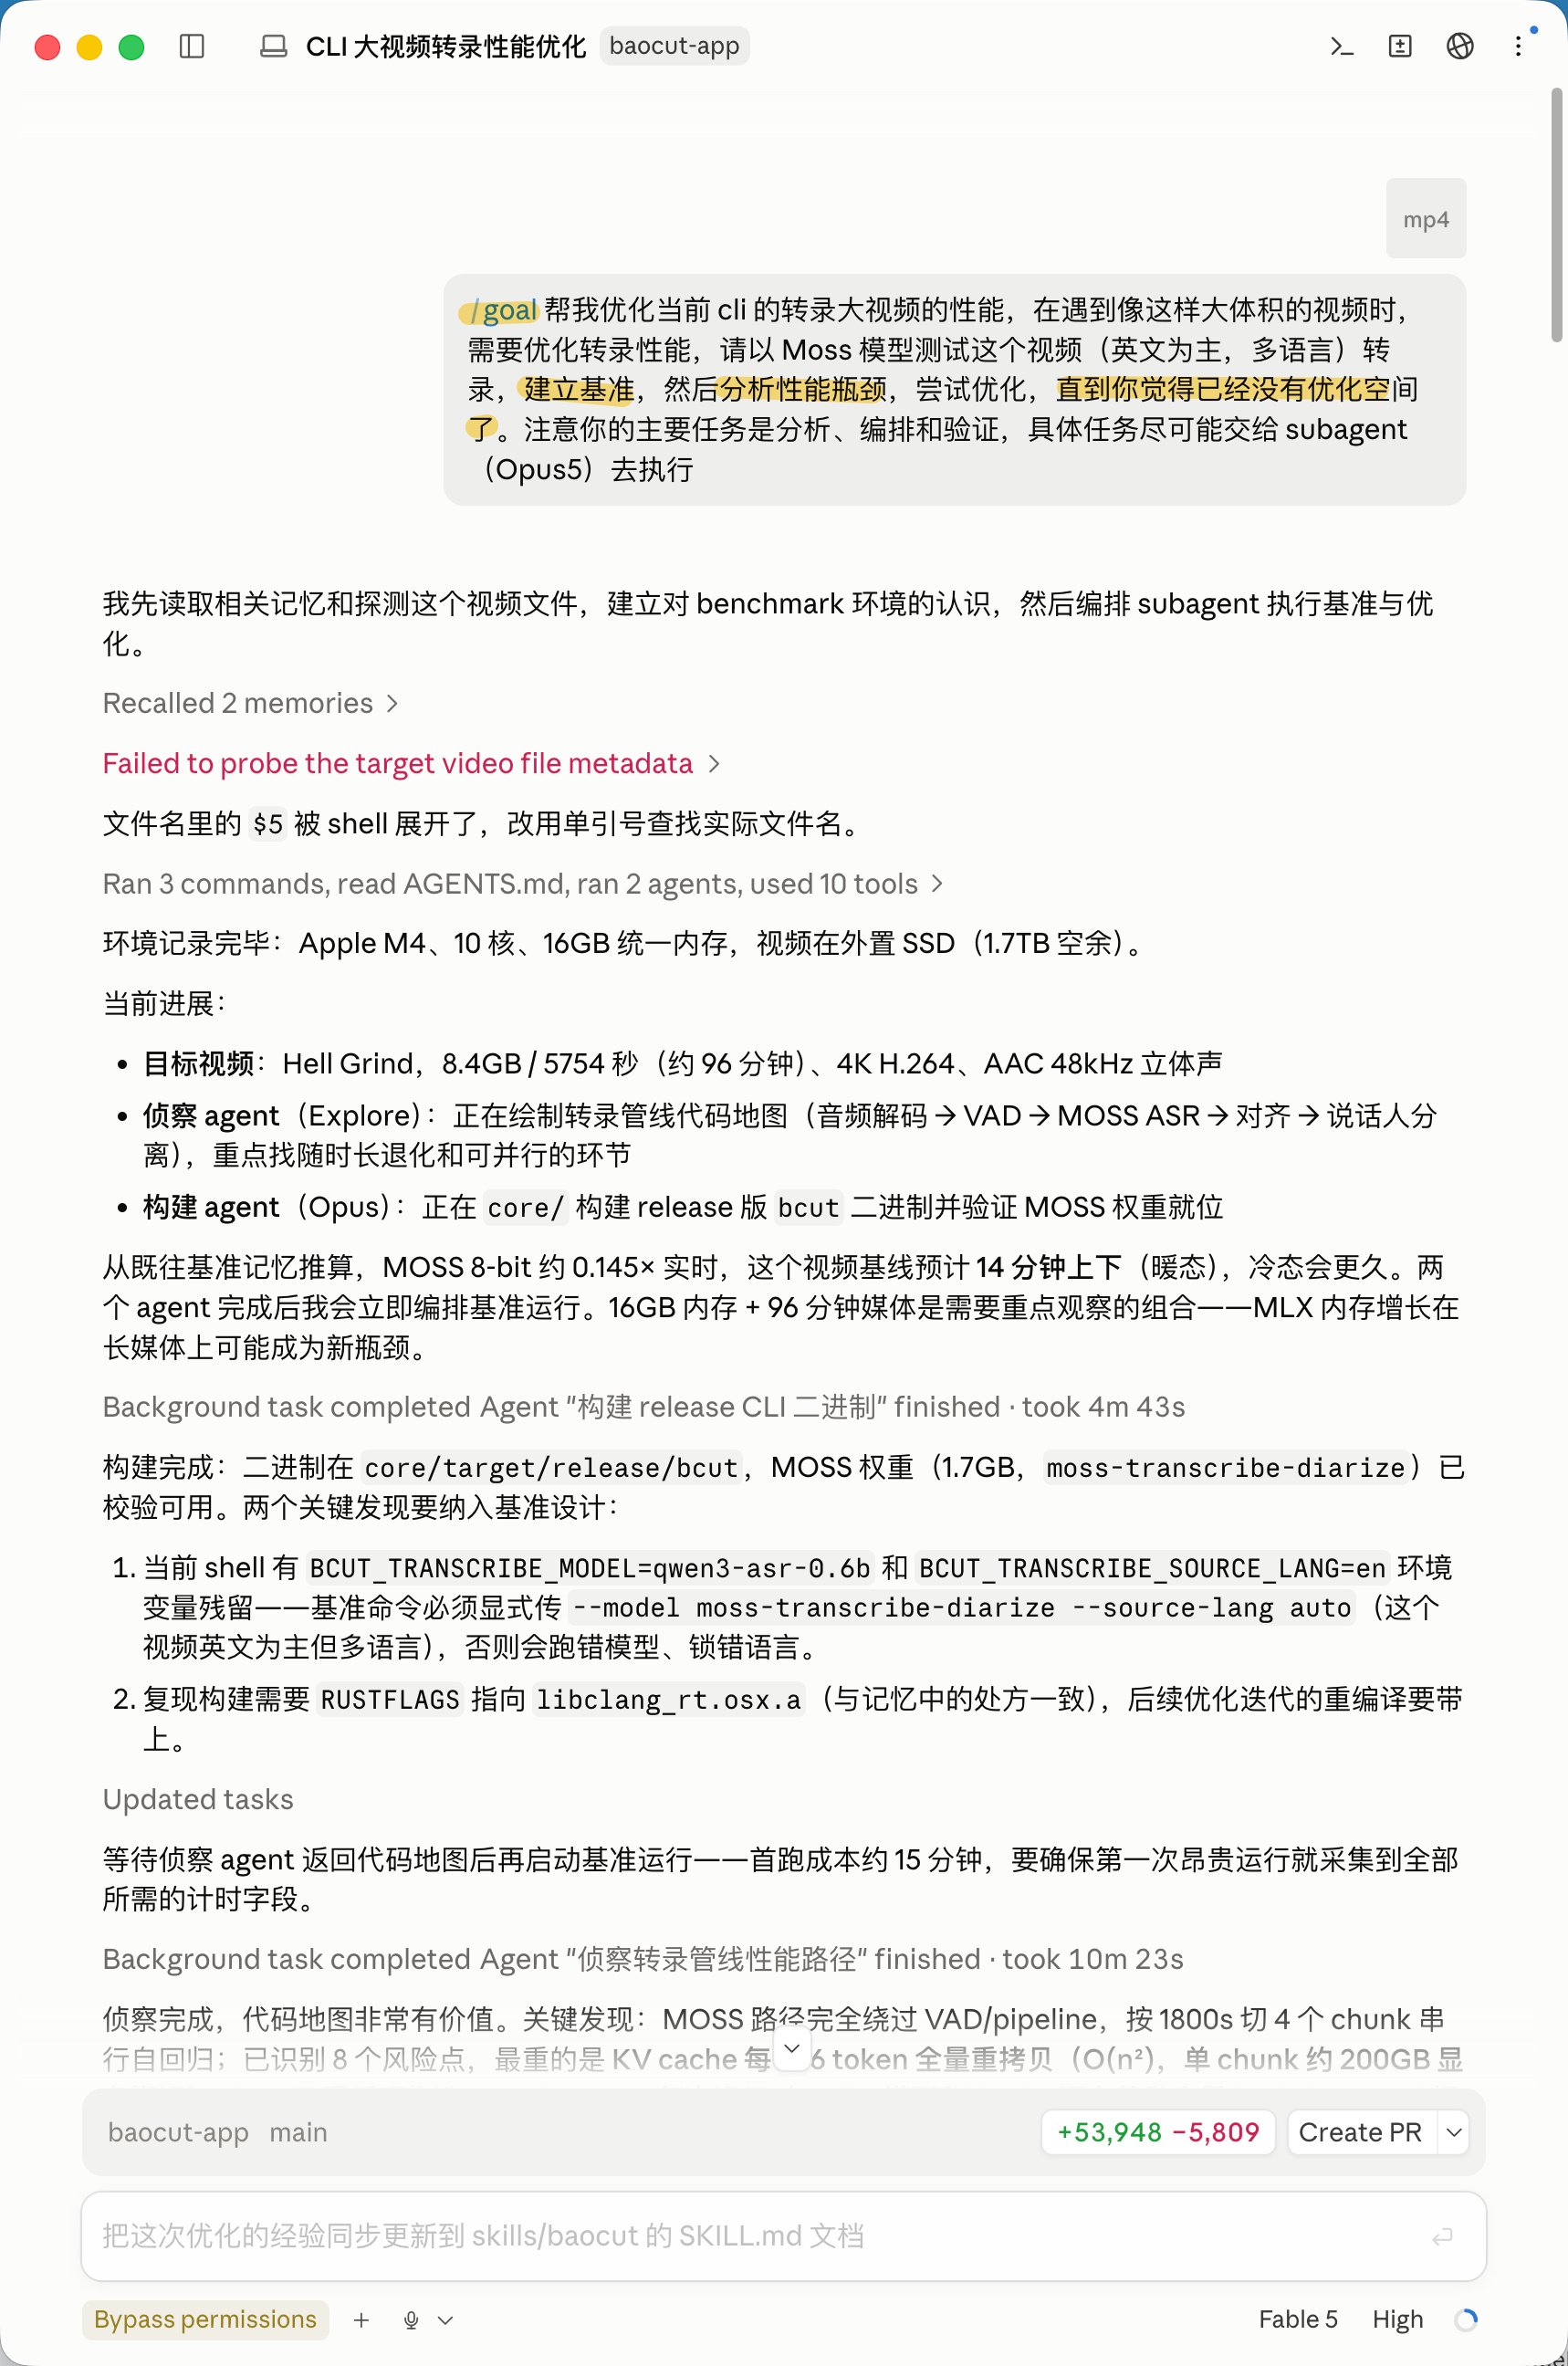
本文介绍了如何高效利用Agent的/goal功能让其长时间运行直至完成目标。作者指出,设定目标时需明确目标、验证方式及停止条件。以视频转录性能优化为例,建议先建立基准,让Agent自主分析瓶颈并迭代优化,将停止条件设为“无优化空间”而非具体指标,以避免任务过早结束或走向极端。此外,为节省昂贵的顶级模型额度,建议主Agent仅负责分析与编排,具体执行交由subagent处理。

技术 › Agent 宝玉 (@dotey) 2026-08-092.7 KB 80

为什么 Claude Code 会话会随时间变差

本文深入探讨了 Claude Code 等智能体工具在长对话中性能下降的现象。作者将其归因于“上下文腐烂”,分为无法避免的内在腐烂(模型架构限制)和可管理的内容腐烂(过时信息积累)。文章提供了具体的治理实践,包括前期策展、保持上下文清洁、及时重置以及使用 git 树结构管理会话,以维持工具的敏锐度。

技术 › Claude Code yibie 2026-08-0317.3 KB

Introducing pgContext 0.2.0: Advanced AI search inside Postgres

pgContext 0.2.0 发布,作为 PostgreSQL 的开源扩展,提供更快的语义搜索、过滤和混合检索功能。新版本优化了性能,增加了搜索透明度和安全性,支持更多 AI 搜索方法,适用于推荐系统和低成本检索。用户可通过源代码、容器或 Docker Compose 使用。

技术 › 数据库 dale 2026-07-243.1 KB 10.6K 63

LLM 推理原理详解:从 Prefill 到 Decode

本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。

技术 › LLM Avi Chawla 2026-06-2923.7 KB 320.3K 776

构建优秀的垂直领域 Agent:以 Shortcut 为例

本文探讨了如何构建一个在实际应用中表现卓越的垂直领域 Agent。作者结合开发 Shortcut 电子表格 Agent 的经验,提出核心原则是“对任务分布的忠实压缩”。文章详细介绍了“分层缓存”架构,将上下文分为 L1(常驻核心)、L2(按需规格)和 L3(兜底参考),以平衡效率与准确性。同时强调了“单工具优于多工具”的策略,主张通过代码执行来统一能力,降低模型决策复杂度,从而在长尾任务中实现高准确率。

技术 › Agent Peter Wang 2026-06-1244.0 KB 427.1K 1.2K

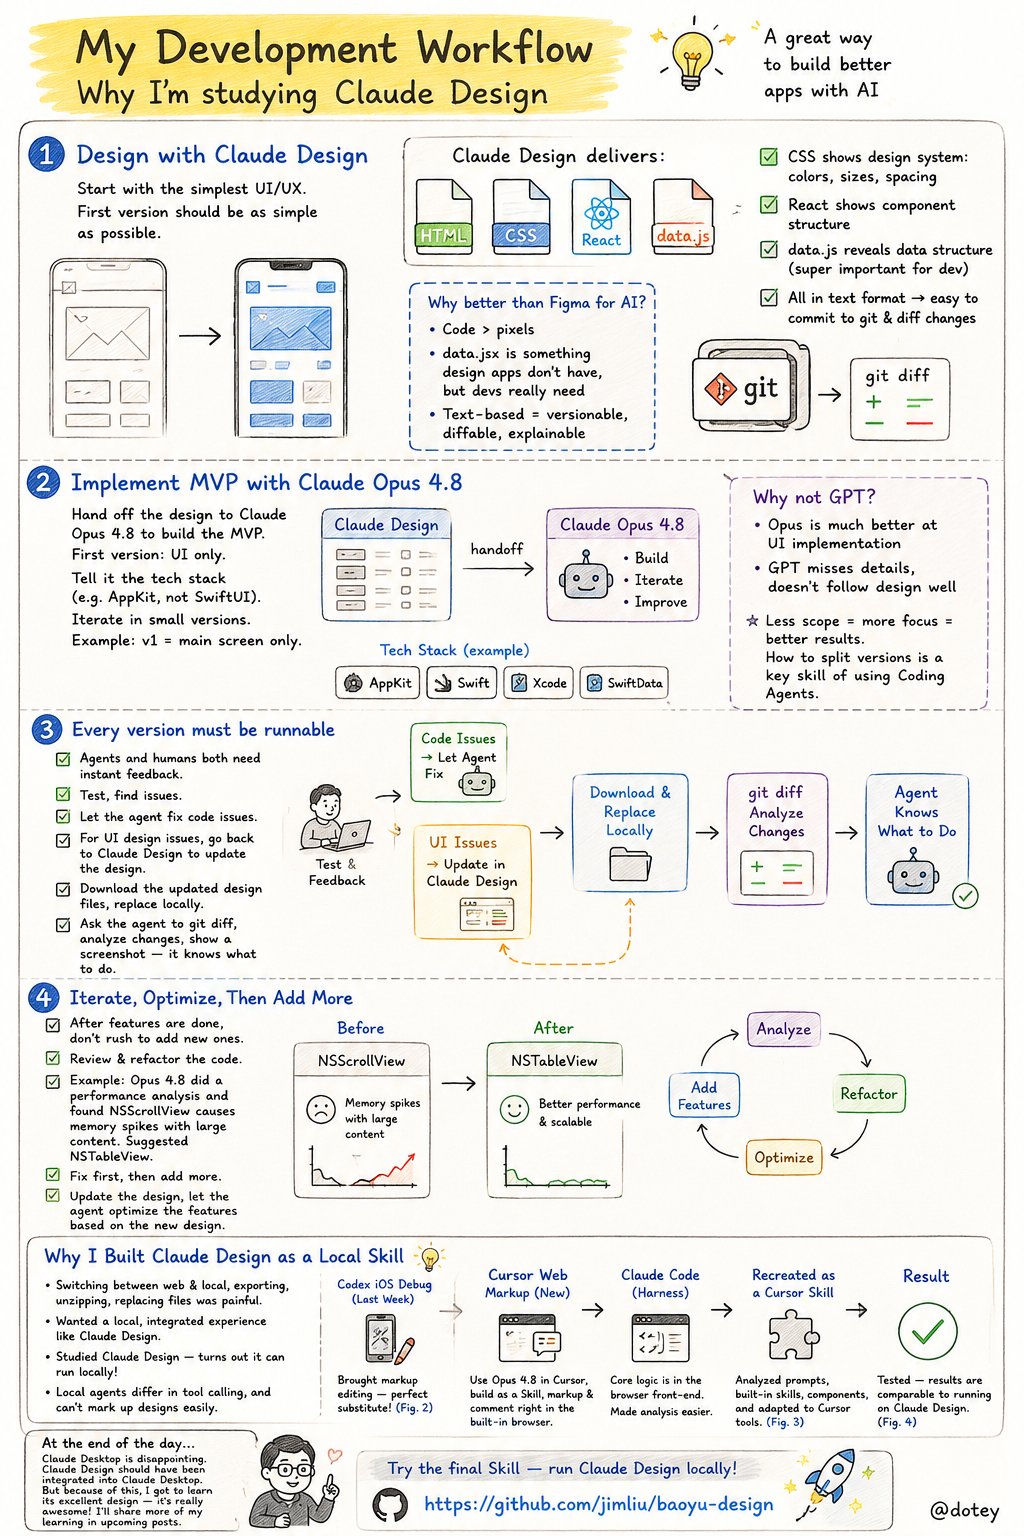
基于 Claude Design 与 Agent 的高效开发模式实践

本文作者分享了探索出的一套高效开发模式。首先利用 Claude Design 进行 UI/UX 设计,生成包含 HTML、CSS、React 和 data.js 的代码交付物,这比传统设计稿更易于 AI 理解和版本管理;随后使用 Claude Opus 4.8 结合 Codex 实现 MVP 和功能迭代;最后通过重构优化性能。此外,作者通过逆向工程将 Claude Design 本地化并集成到 Cursor 中,实现了更流畅的工作流。

技术 › Claude 宝玉 2026-06-086.3 KB

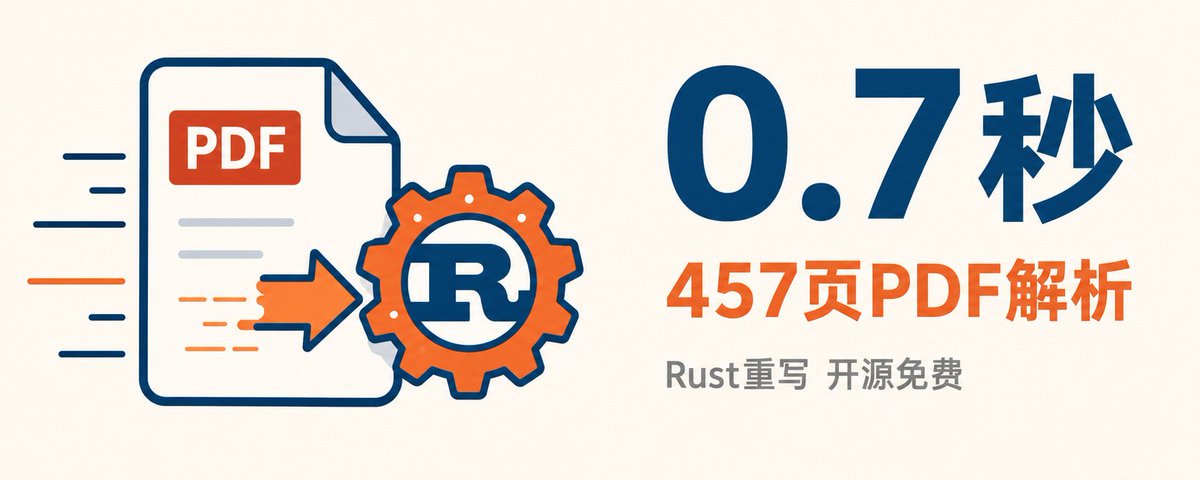
LlamaIndex 用 Rust 重写文档解析器 LiteParse

LlamaIndex 推出完全用 Rust 重写的文档解析器 LiteParse。相比旧版,新版本在处理大文档时速度提升 3 倍,小文档提升可达 100 倍,实测 457 页 PDF 解析仅需 0.777 秒。该工具支持 Python、Node.js、Rust 及浏览器环境,覆盖 PDF、Office 等主流格式,具备原生 OCR 能力,且可作为 Agent Skill 直接集成。

技术 › 工具与效率 Jason Zhu 2026-05-284.3 KB 73.3K 591 81

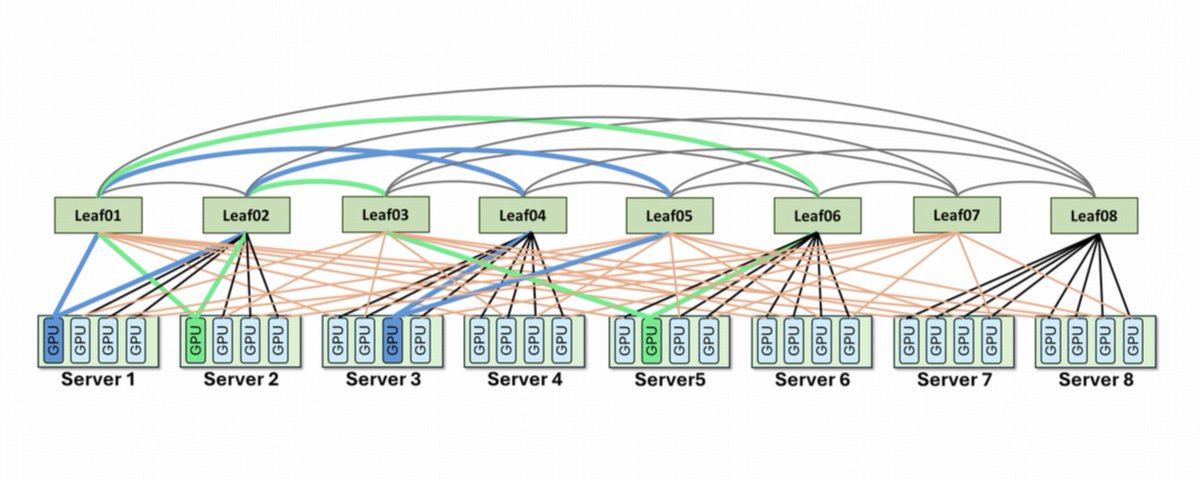
下一代 LLM 推理网络:ZCube 如何缓解网络瓶颈

文章探讨了随着长上下文推理和 Prefill-Decode 解耦成为主流,网络如何成为 LLM 推理集群吞吐量和延迟的关键瓶颈。Z.ai、Harnets.AI 和清华大学联合开发了 ZCube 网络架构,通过扁平化拓扑和混合轨道设计,有效解决了传统 ROFT 架构下的流量负载不均衡问题。生产环境基准测试显示,ZCube 仅通过架构优化便实现了交换机成本降低 33%、吞吐量提升 15% 以及 TTFT 延迟降低 40.6% 的显著收益。

技术 › DevOps Z.ai 2026-05-2134.3 KB 204.1K 926 77