Wiki 知识库

全部文档 / 标签: 机器学习

57 篇
清除

指令微调:理解 Instruction Tuning

本文是后训练系列第二篇,介绍指令微调(SFT)。以斯坦福 Alpaca 用 52,000 条自动生成的数据微调 LLaMA 7B 为例,说明指令微调与预训练使用相同的下一个 token 预测损失,但数据和任务不同。文章详细讲解训练五步骤:收集、格式化、掩码、训练、评测,并通过 LIMA 和 FLAN 研究说明指令微调主要改变模型行为方式而非增加知识,少量数据即可泛化到新任务。还介绍了损失掩码原理、位置错开的实现细节、指令数据的三种来源及其局限:无法补充知识、比较回答优劣或检验正确性。

技术 › LLM Dongxi 东锡 NLP 2026-10-2312.4 KB 8.9K 59 83

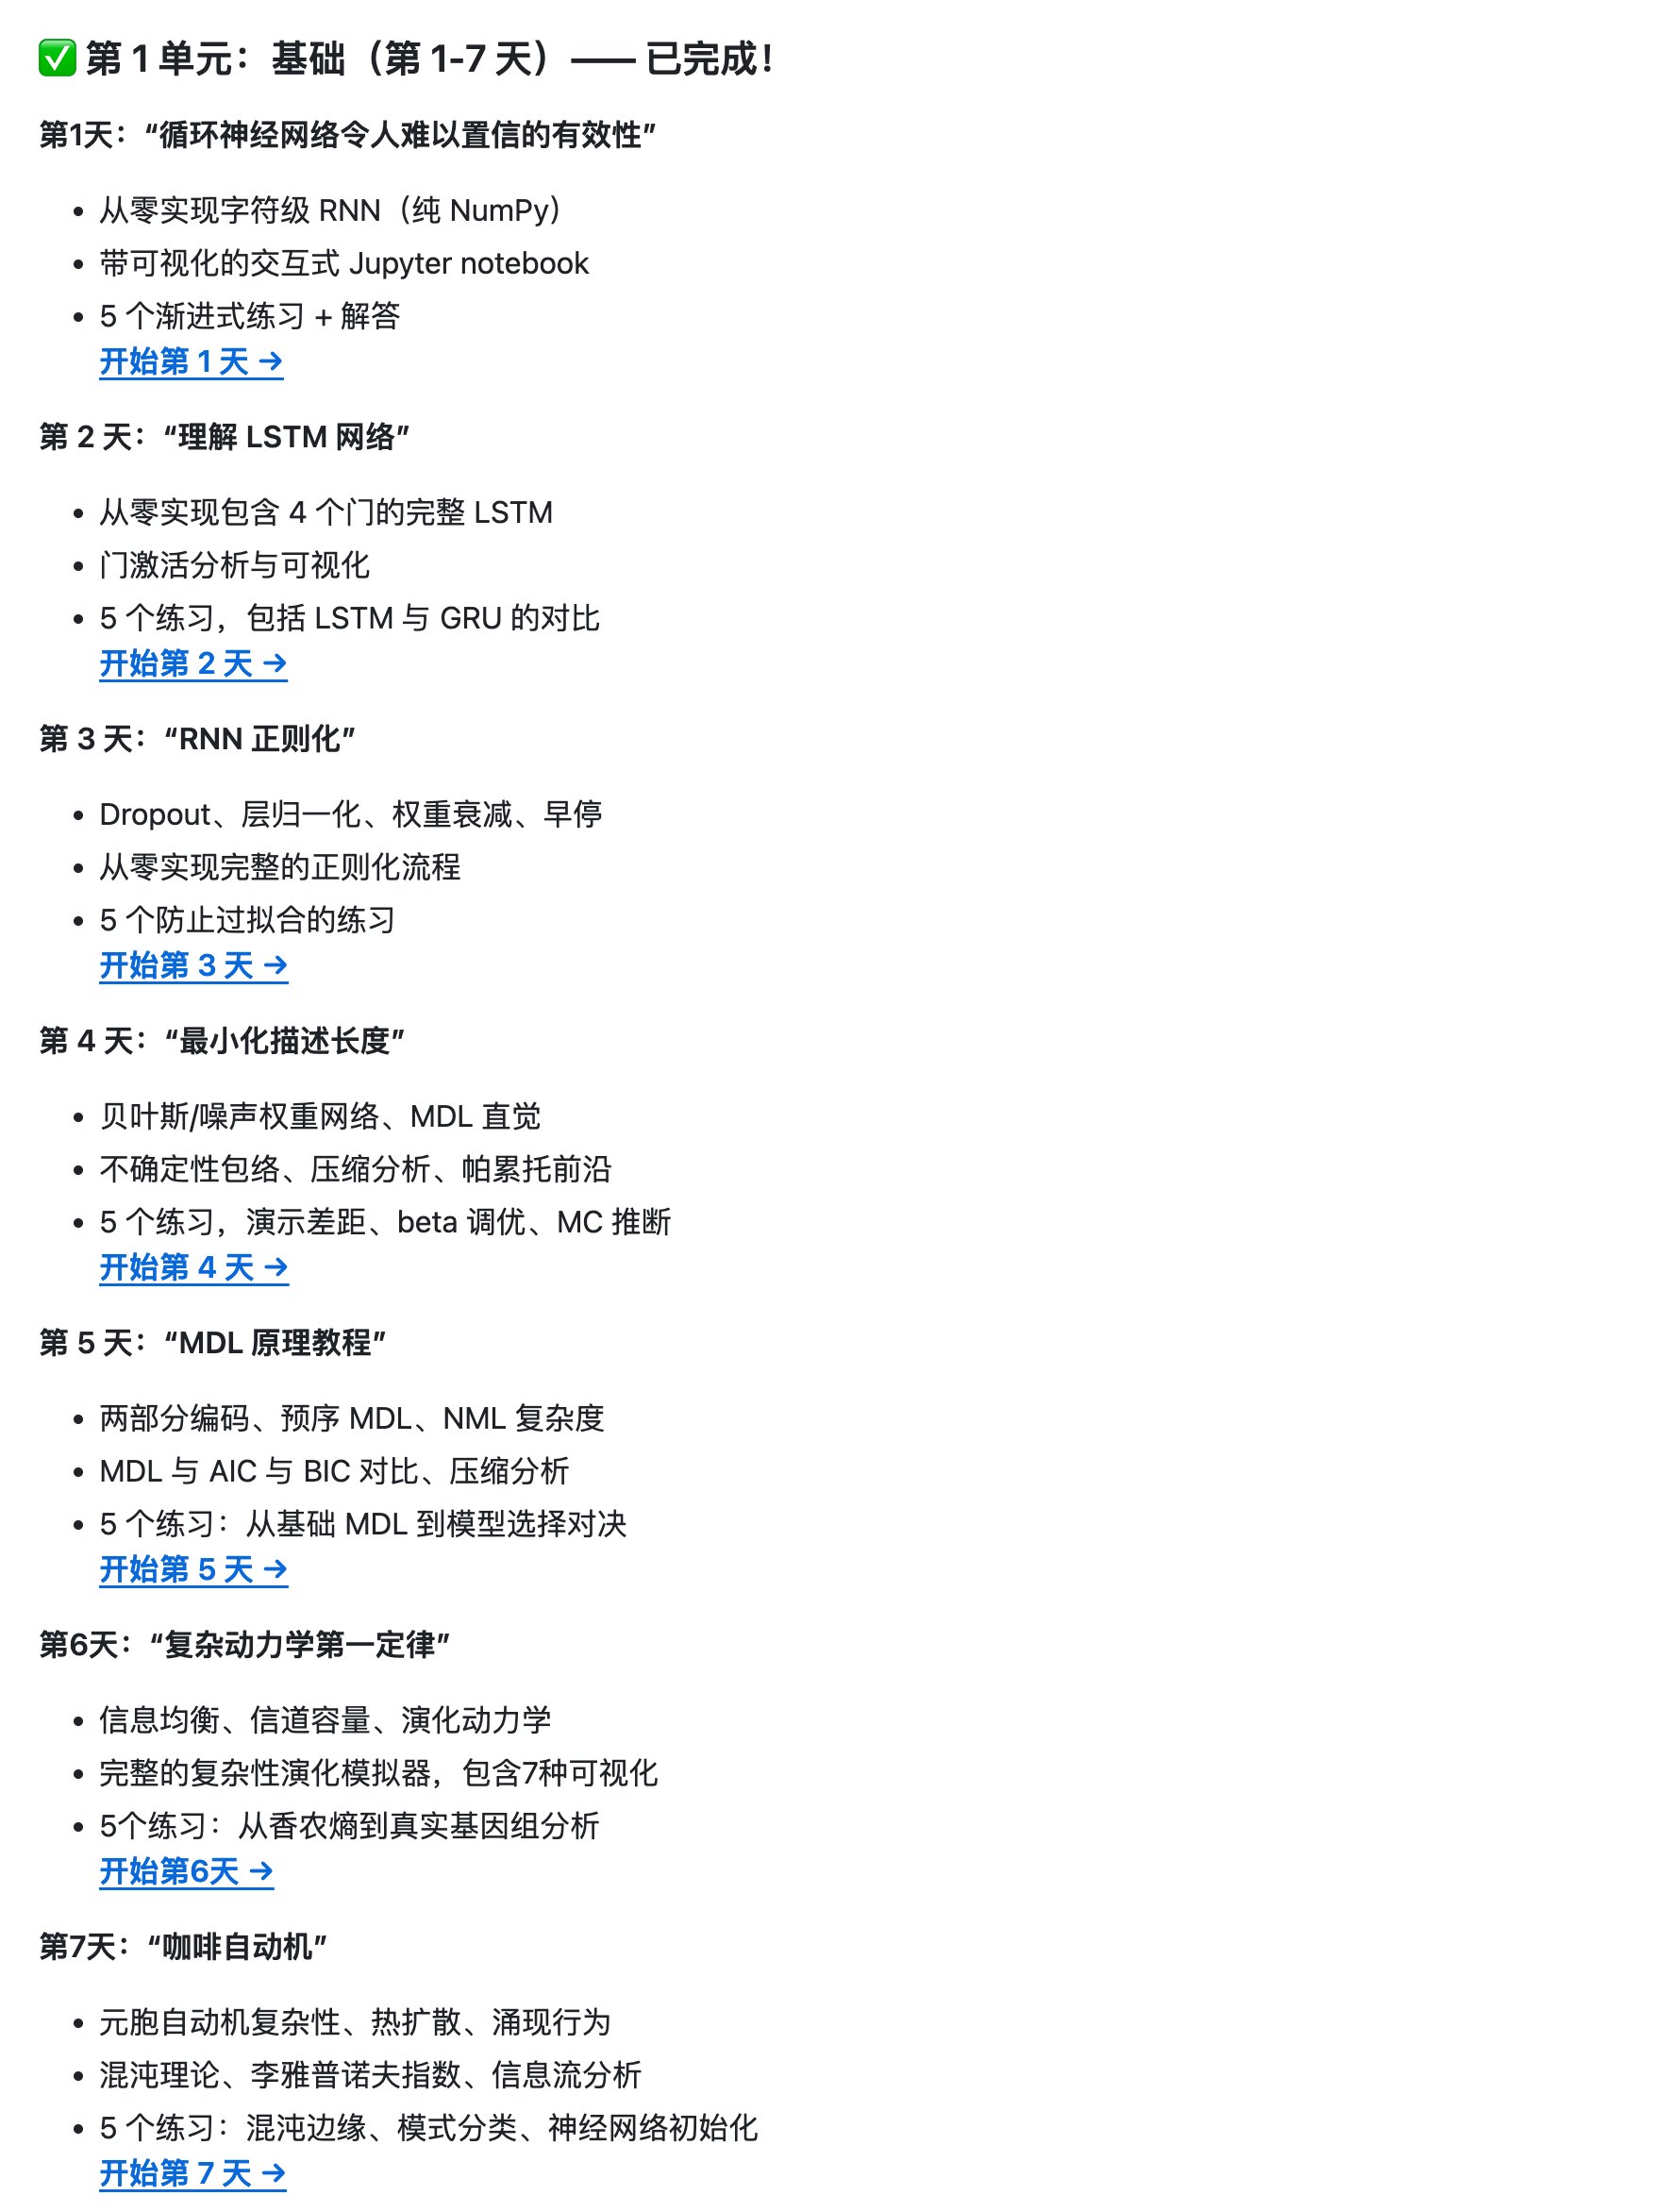
Ilya 推荐的 30 篇 AI 论文清单:30u30 拆解学习项目

Ilya 曾推荐一份包含 30 篇论文的 AI 学习清单,称读懂即可掌握当下 AI 90% 的要点。30u30 项目将这份清单拆成 30 天课程,一天一篇,从 RNN、LSTM 学到 Transformer,最终到 ChatGPT 背后的 RLHF。每篇配有大白话讲解、'讲给 5 岁小孩听'的速览、从零实现的代码及配图,每天还附 5 道练习题。代码可在普通电脑 CPU 上运行,适合想转 AI 方向的学生或想理解 ChatGPT 原理的用户跟随学习。

技术 › LLM GitHubDaily (@GitHub_Daily) 2026-10-211.4 KB 64

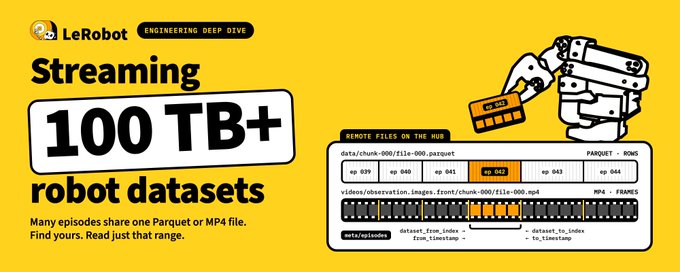
Streaming 100 TB+ Robot Datasets

LeRobot 推出了面向 100 TB 及以上规模机器人数据集的新型 episode 级流式数据加载器,可直接从 Hugging Face 数据集或 Bucket 读取选定的 episode 并准备训练样本,无需完整下载本地视频副本。文章阐述了流式加载器的四大需求:保持 GPU 繁忙、混合 episode、覆盖全部数据、控制内存使用。通过 Parquet 统计信息定位表格数据、MP4 sidecar 索引定位视频帧、在 RAM 中维护压缩视频字节池,并采用锚点采样与预取机制,实现数据集持续增长下的高效训练。

技术 › 工具与效率 LeRobot 2026-10-1013.2 KB 12.4K 145 84

Meta AI 面试 2026:新增 "Coding with AI" 轮

Meta 在 2026 年对 AI 工程师面试流程进行了重大调整,业内首个主流化的 AI 辅助编程轮 "Coding with AI" 正式上线。文章详细介绍了 MLE 与 Research Scientist 岗位的完整面试流程,包括传统 coding 轮、ML system design、ML theory、behavioral 等各轮考察重点,并重点解析了 AI 轮的三阶段考核:修 bug、实现功能、优化扩展,强调面试者需证明自己会验证和纠正 AI 输出。文末还给出 follow-up 问题预测和六条备考清单。

职场 › 面试 山景城小路 2026-10-072.5 KB 8.3K 75 78

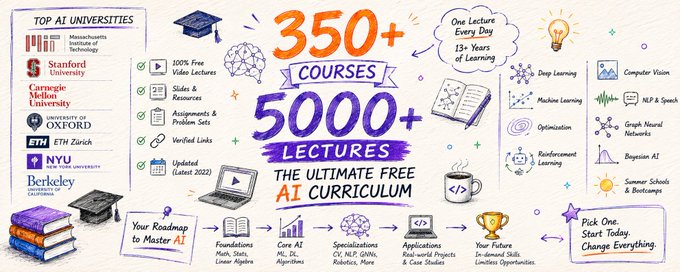
免费的AI课程全指南:350+课程、5000+讲座替代你的学位

作者因厌倦在YouTube、Google和大学网站间费力搜寻AI学习资源,整理了一份完全免费的AI课程大全,涵盖350多门课程和5000多个讲座。内容按主题分类,包括深度学习、机器学习基础、优化、强化学习、概率图模型、贝叶斯深度学习、医学影像、图神经网络、NLP、语音识别、计算机视觉等14个方向。课程来源包括Geoffrey Hinton、Andrew Ng、Andrej Karpathy、Richard Socher等名师在多伦多大学、斯坦福、牛津、MIT、CMU、DeepMind等机构的经典课程,并附有课件和视频链接。

技术 › LLM shikamaru 2026-10-06191.8 KB 333.9K 340 65

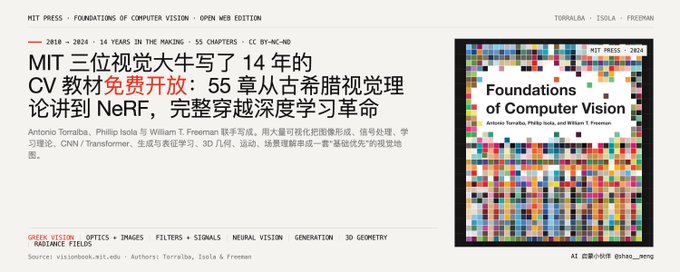
MIT 三巨头写了14年的计算机视觉教材免费开放:从古希腊视觉理论讲到 NeRF

MIT 三位教授 Torralba、Isola 和 Freeman 合著的《计算机视觉基础》开放免费在线阅读,全书 55 章历时 14 年写成,完整穿越深度学习革命。本书刻意不追踪 SOTA,而是强调当代方法深植于视觉与 AI 的历史脉络,从古希腊视觉理论一直讲到 NeRF。全书按问题背景、数学与信号处理、神经架构与统计建模、几何与运动、应用与研究素养五条主线编排,统一了经典视觉方法与深度学习,还包含研究方法论与社会伦理内容。作者认为它有望成为下一代 CV 标准入门教材,但不覆盖扩散模型与多模态大模型最新进展。

读书 › 书评 meng shao 2026-10-067.1 KB 7.3K 96 77

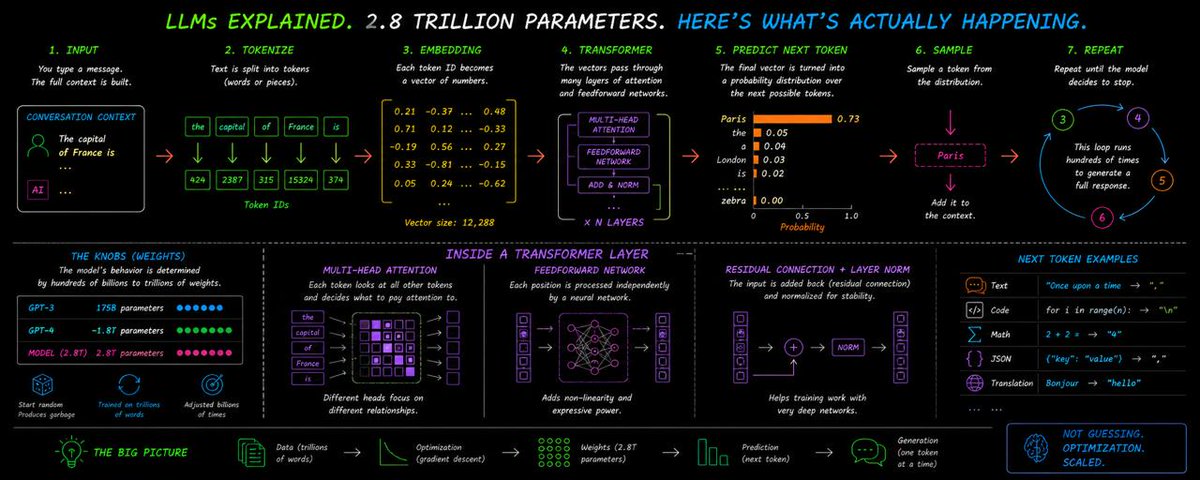
LLMs do not guess. They optimize. Here is the difference and the math behind it

文章阐述LLM的输出并非猜测,而是优化的结果。作者从基础数学概念讲起,介绍了优化问题的本质:找到使函数最大化或最小化的输入。文章系统梳理了几个关键优化方法:牛顿法(通过切线逼近快速求零点和极值,是现代训练算法的祖先)、黄金分割搜索(无需导数、利用黄金比例实现指数级收敛,用于超参数调优)、单纯形法(1947年Dantzig发明,通过沿多面体顶点移动求解线性规划问题)。文章解释了梯度下降作为简化版牛顿法如何训练拥有数万亿参数的语言模型,并对比了单纯形法与内点法在理论与实践性能上的差异。

技术 › LLM Deliriumm 2026-10-0415.0 KB 716.1K 379 65

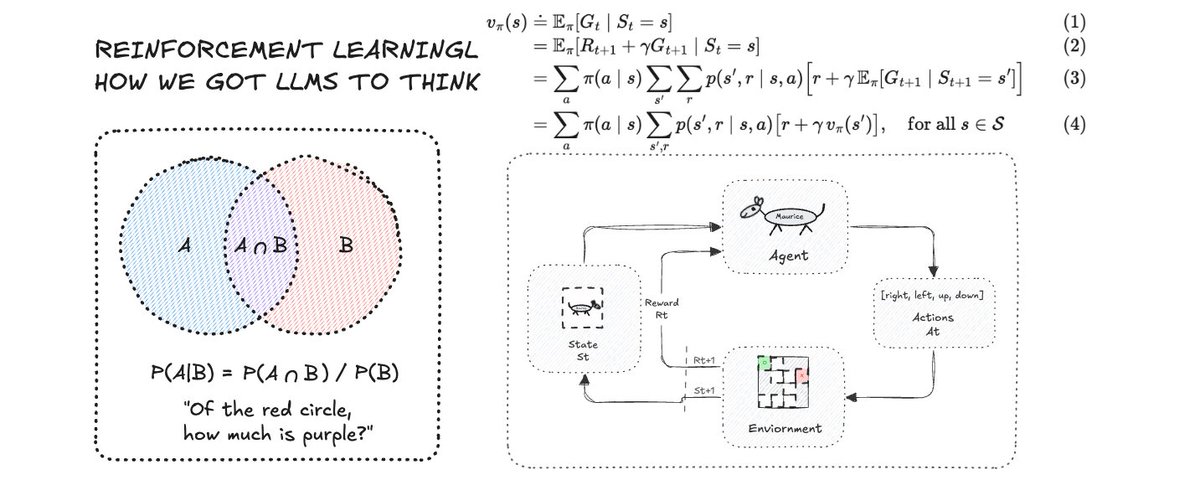
Reinforcement Learning from scratch #1

本文是强化学习从零开始系列的第一篇,作者通过赌场老虎机的故事引入多臂老虎机问题。文章以通俗易懂的方式讲解了期望值、条件概率、贝叶斯定理、大数定律等基础概率统计概念,并推导出增量式价值估计 Q 的更新公式,为后续学习强化学习算法奠定基础。作者强调从最简单的问题出发、逐步增加复杂度的学习方式。

技术 › 编程语言 Pramod Goyal 2026-10-0356.3 KB 97.5K 956 55

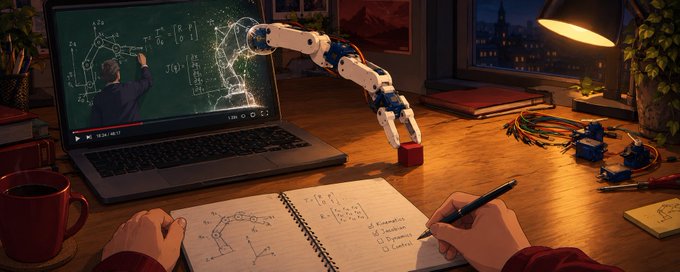
斯坦福机器人学免费课程:6个月成为机器人学习工程师的学习路径

作者整理了一份利用斯坦福免费公开课程资源、历时6个月成为机器人学习工程师的自学路径。斯坦福将大量机器人学课程发布在YouTube上,讲师包括NVIDIA自动驾驶研究高级总监、Physical Intelligence联合创始人及Tesla Optimus AI负责人。该路径包含7门课程共119讲、约95小时视频、2本免费教材、6个可在家用笔记本上完成的练习项目,以及可选的122美元机械臂。学习顺序遵循斯坦福正式课程体系:先数学基础(线性代数),再机器人物理结构、感知、规划,最后是学习方法,避免了自学时无序观看导致的低效问题。

技术 › 编程语言 Martin 2026-09-2633.6 KB 190.3K 650 82

AI 眼里根本没有猫,那它到底是怎么认出猫的?|从 0 开始理解大模型底层

本文从最简单的线性模型 y=wx+b 出发,逐步拆解神经网络识别图片的原理。作者解释了为何单层线性计算表达能力不足,堆叠多层也仍会退化为一次线性变换,因此需要 ReLU 等激活函数引入非线性。随后说明图像如何从原始像素经多层计算被加工成适合任务的内部表示,并澄清了'第一层看线条、第二层看耳朵'的常见误解。文章还介绍了万能逼近定理的含义与局限、CNN 与 Transformer 的关系,以及模型为何是黑箱与机制可解释性,最后引出过拟合问题,为下一篇泛化主题做铺垫。

技术 › LLM joy 2026-09-2614.8 KB 6.5K 18 63

MIT 公开课 6.S950 Agency with AI:Spec 先于 Prompt,验证先于信任

文章全景解读 MIT EECS 2026 秋季新课程 6.S950《Agency with AI》。课程不教工具使用,而教 AI 时代的工程判断力:什么该委托给 AI、什么该验证、什么该留给自己。方法论核心是四问法(解决什么问题/方案/老思想/新在哪)与增量思维。12 讲沿真实 ML 项目生命周期展开,涵盖文献阅读、spec 驱动开发、版本控制、抽象阶梯、数据审查、LLM 机制、评测设计与审计等主题。Lab 设计精妙地控制 AI 在场与否,考核要求任何无法说明理由的工作不得分,强调决策的可辩护性与人类作者性的保留。

技术 › LLM meng shao 2026-09-2616.8 KB 17.9K 115 80

AI 到底是怎么学会东西的?我把机器学习的训练过程拆开看了一遍

文章以通俗易懂的方式拆解机器学习的训练原理。作者从传统编程与机器学习的思维差异切入,说明机器学习是让计算机从数据中自行寻找规律。随后讲解核心概念:X→Y 的映射、特征与标签、向量/矩阵/张量的数据表示、Embedding 的意义;再解释模型本质是带大量可调参数的函数,训练通过损失函数衡量错误,借助导数与梯度判断参数调整方向,梯度下降如蒙眼下山的比喻直观呈现了这一过程。文章还涵盖局部最优与鞍点、泛化能力、Batch/SGD/Mini-batch 的取舍以及 Adam 优化器的改进思路,帮助初学者建立机器学习的整体认知框架。

技术 › 编程语言 joy 2026-09-2228.1 KB 2.2K 25 69

别人看发布会我跑数据:六组实验五个开源仓库,Jev 的真实边界全在这

作者通过六组实验和五个开源仓库实测 TypeSafe 发布的 Jev 模型的真实能力边界。Jev 是只回答封闭问题、一次前向返回概率分布的模型。核心结论:Jev 适用于信号在语义中的场景(如泰坦尼克 0.83 AUC),对纯统计信号数据(如哈希 CTR 数据)无效;零样本表现相当于 150-500 条标注数据;最佳用法是作为特征融入已有模型而非单独使用,五个项目均获显著提升。作者还总结了问法即超参数、汇总预警取决于时间尺度、情绪分析无用等六条经验,以及评审循环偏差、真值精度等评测教训。

技术 › LLM Jason Zhu 2026-09-1917.6 KB 7.8K 51 86

How To Fine-Tune a Small LLM on Your Own Data (Full Guide)

这是一篇关于微调小型LLM的完整实战指南。作者指出不需要70B大模型或昂贵算力,1.5B参数模型在200-500个优质样本上微调后,可在特定任务上超越通用提示的前沿模型。文章以商业融资文案生成为例,详细讲解了微调的实际目标、建立基线(纯提示、RAG、微调)的先后顺序,并分步骤介绍了小型基座模型选择(如Qwen2.5-1.5B)、数据权利合规、可复现数据下载、PDF文本提取与OCR、文本清洗、训练数据集构建、QLoRA训练、评估与部署,每一步均附完整代码。

技术 › LLM Rahul 2026-09-1926.1 KB 2.5M 2.7K 86

How robot arms are controlled

本文面向进入机器人学习领域的机器学习从业者,系统讲解 SO-100 机械臂的控制原理。内容涵盖机械臂的组成(六连杆五关节的伺服电机结构)、通过主从臂遥操作采集演示数据的方法、PID 控制器的工作机制(弹簧-阻尼模型与临界阻尼的推导)、力矩限制带来的非线性行为,以及关节空间与任务空间的表示方法、正运动学(FK)与逆运动学(IK)的原理与挑战。文章也解释了一个反直觉现象:机械臂在臂长范围内无法精确到达 0% 的夹爪位姿。

技术 › 机器人 Jacob H. Rothschild 2026-09-1811.7 KB 336.9K 982 77

Hamel 的 AI 产品工程笔记:Evals、Context、Systems 的优化全序

本文整理了 Hamel Husain 的 Maven 课程「AI Product Engineering」13 场讲座(共 9.5 小时)的笔记精华,按 Evals、Context、Systems 三大主题组织。核心结论是 AI 产品优化的顺序:先优化检索与上下文(投入产出比最高),再改进系统与执行框架,最后才考虑 post-training。Evals 贯穿一切改进,是判断优化效果的前提。文章涵盖数据 Agent 评测、模型级联降本、自动化错误分析、多向量检索、嵌入模型优化、OCR 选型、推理延迟调试、开源模型经济学等具体实践,强调评测环境应反映生产环境的真实脏乱,模型推理能力往往远超其所得的检索质量。

技术 › LLM meng shao 2026-09-1722.2 KB 27.6K 144 87

MLOps 可视化详解:完整生命周期指南

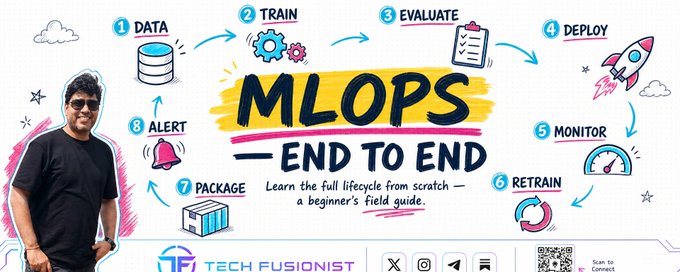
本文以图解方式系统讲解 MLOps(机器学习运维)的完整生命周期,解决模型从 Notebook 到生产环境的落地难题。内容涵盖六大阶段:数据管理与版本化(Airflow、DVC)、实验追踪(MLflow、W&B)、模型注册与验证、部署与服务(Docker、Kubernetes、CI/CD)、生产监控(数据漂移、性能衰减检测)以及自动化重训练。文章还介绍了 MLOps 成熟度模型,从手工操作到全自动 CI/CD/CT 的演进路径,强调 MLOps 是一个持续循环而非一次性部署。

技术 › DevOps Tech Fusionist | Kushal Gangil 2026-09-1210.5 KB 14.3K 172 74

AI 的演进:从规则执行到自主行动

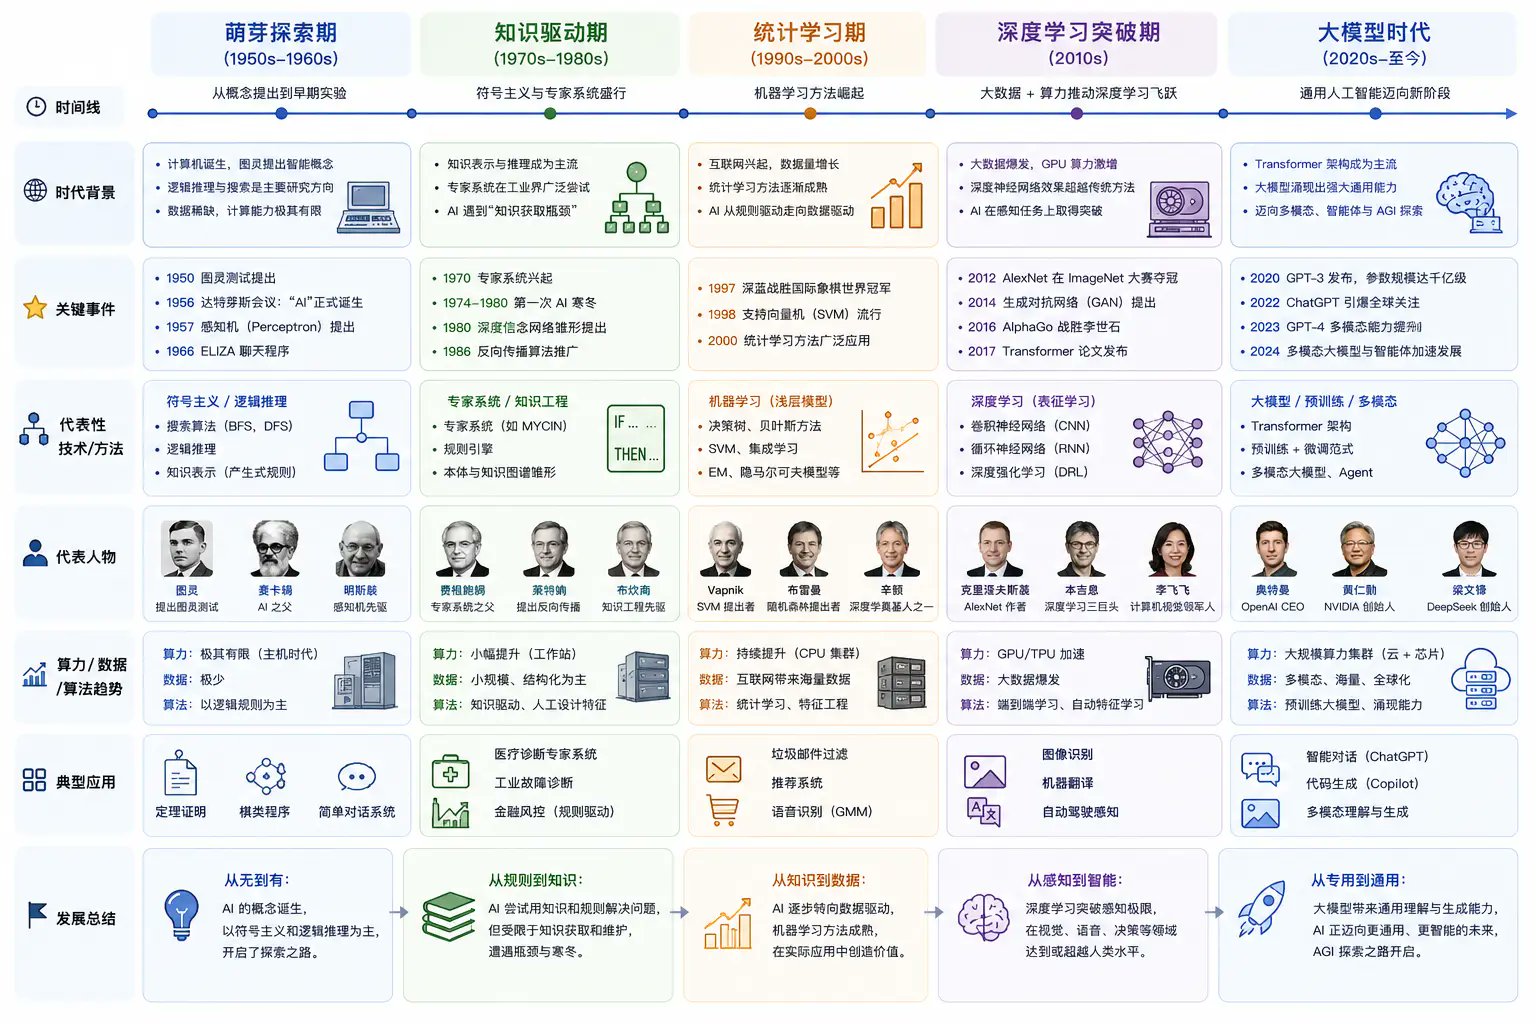
文章系统梳理了人工智能从1950年代至今的发展历程:萌芽探索期(图灵之问与达特茅斯会议)、知识驱动期(符号主义与专家系统)、统计学习期(机器学习与特征工程)、深度学习突破期(AlexNet与神经网络)、大模型时代(Transformer、GPT-3、ChatGPT与多模态)。作者指出AI处理信息的方式从人类编写规则,到机器从数据中学习,再到模型理解目标并自主完成任务。未来AI将从大模型走向智能体(Agent),能够拆解任务、制定计划、调用工具,实现从被动响应到自主行动的转变。

技术 › LLM Kelvin (@ai_Goge) 2026-09-024.7 KB 50

Vibe coding时代,软件护城河到底是什么?【上】

作者通过其自主研发的铁路钢轨伤损自动识别系统,阐述AI时代软件的护城河在于对所构建系统的深刻理解,而不仅是功能复制。其系统采用116维支持向量机,每个维度都有真实物理含义,第三方盲测准确率高达99.985%,远超中车、铁科院及Sperry Rail等竞争对手。文章以x−y方差这一维度为例,详细解释了超声波探伤中波长、角度与单位换算背后的物理原理,说明即使拿到源码,对手也无法理解参数背后的含义。作者指出,正是数十年深入现场的独家研究构成了无法被AI抄袭的核心壁垒。

技术 › 杂谈 快乐永远 (@syeerzy) 2026-08-305.9 KB 74

零基础到可就业的 AI 工程师学习路线图

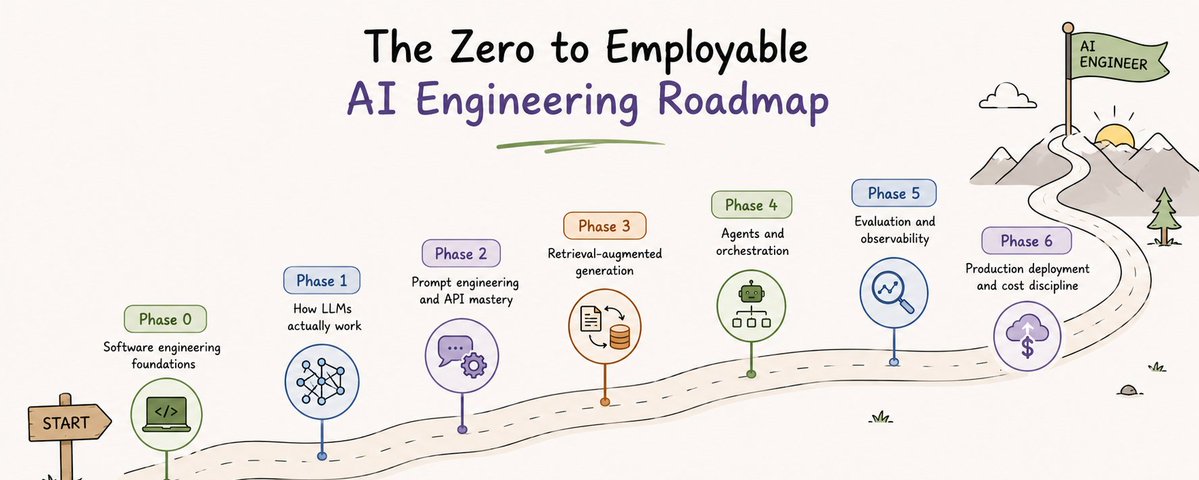
本文提供了一份从零到可就业的 AI 工程师分阶段学习路线图,区别于单纯的技能清单,每个阶段都附带经过验证的优质课程、文档和书籍。路线涵盖六个阶段:软件工程基础(Python、API、Git)、LLM 工作原理(Karpathy 课程、3Blue1Brown)、提示工程与 API 掌握、RAG 检索增强生成(最具就业价值的技能)、Agent 与编排(LangGraph、MCP)、以及评估与生产部署。作者建议用 8-12 个月完成学习,并强调构建真实项目组合和公开写作是获得雇佣的关键。

技术 › LLM Jaydeep 2026-08-248.6 KB 33K 567 75

AI 工程技能图谱:构建与部署 AI 应用

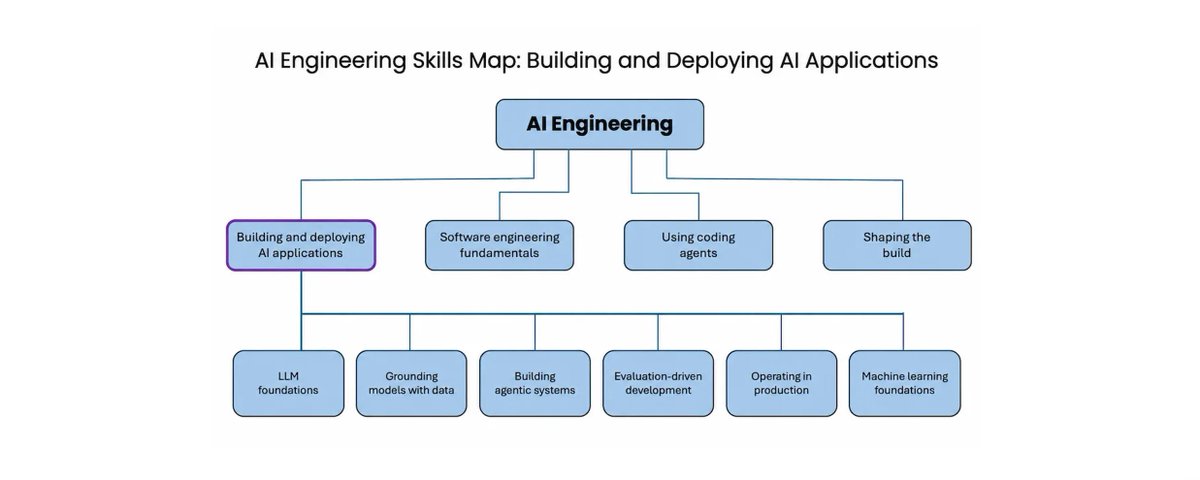
吴恩达详细阐述了 AI 工程技能图谱中的核心技能——构建与部署 AI 应用,包含六大方面:LLM 基础(分词、上下文窗口、工具调用等)、用数据为模型提供基础(RAG、向量索引、知识图谱)、构建 Agentic 系统(工作流、Agent harness、多智能体编排)、评估驱动开发(evals 与错误分析循环)、生产环境运营(可观测性、回归测试、成本与延迟优化)以及机器学习基础。该技能图谱基于大量招聘信息、专家访谈和调研形成,强调 AI 系统因输出不可预测而比传统软件开发更具迭代性。
技术 › LLM Andrew Ng 2026-08-227.9 KB 2.1M 12.1K 73

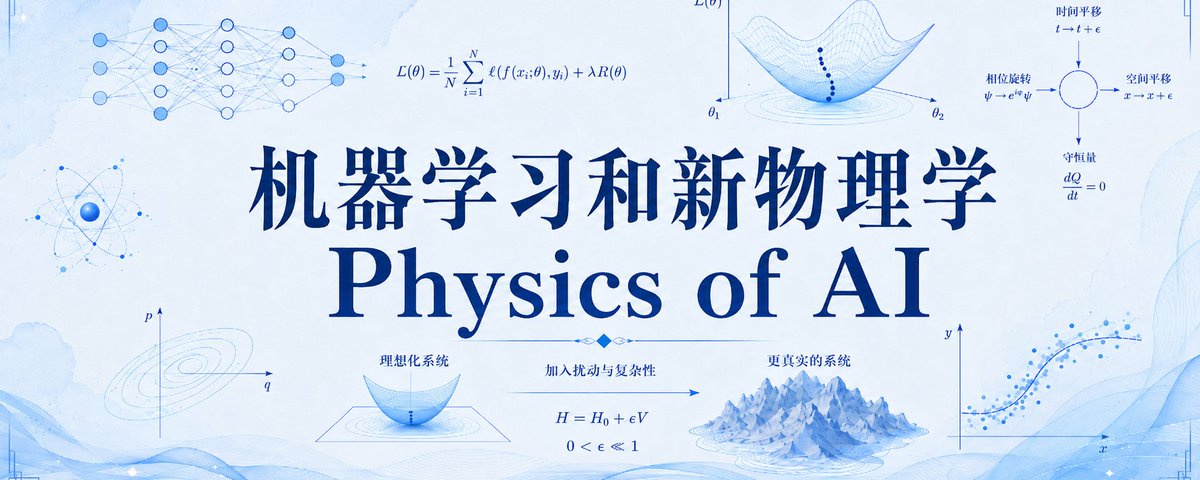
机器学习和新物理学:Physics of AI

本文尝试将机器学习视为一个复杂世界,借鉴物理学的研究方法,为其构建一套“新物理学”。文章首先论证守恒量和对称性比微观方程更根本,通过解析力学、热力学和量子场论的历史案例说明这一点。随后探讨真实世界中对称性破缺的层级,类比非惯性系中的守恒量变化,为后续将机器学习中的训练过程映射为对称性破缺和守恒量变化奠定基础。

技术 › LLM snowboat 2026-08-2078.9 KB 7.2K 24 69

Advancing Scientific Discovery with DeepEarth: 用突破机器实现25倍能力提升

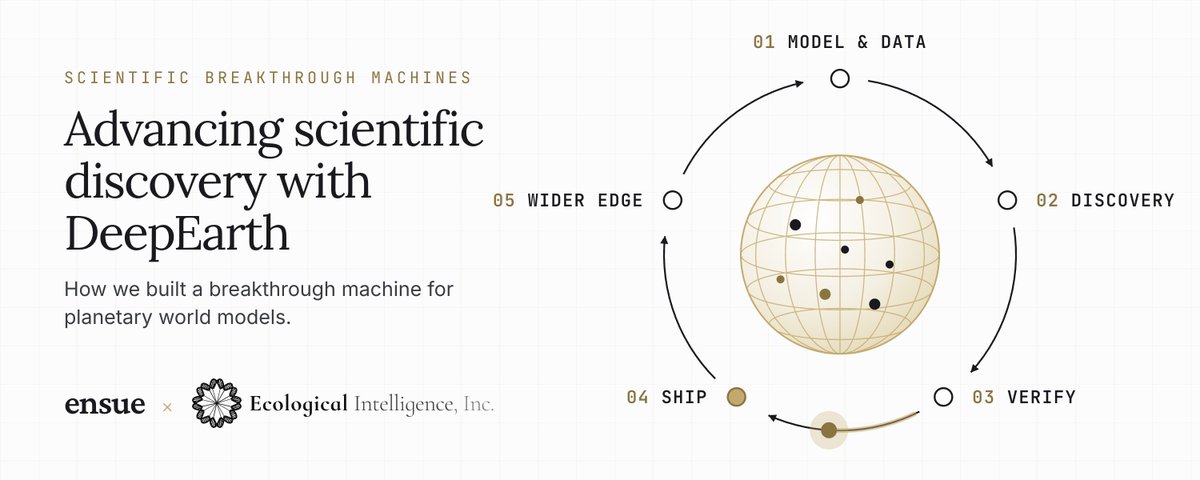
文章提出'科学突破机器'概念:无需先实现AGI,通过范围受限的自我改进循环(sub-RSI loop)即可在特定问题上模拟ASI效果。作者团队将其应用于DeepEarth——一个多模态时空世界模型,用于全球环境智能。系统通过共享记忆、快速筛选实验预算、基于不变量的验证与计分卡机制,让智能体集群自主进行假设、实验与迭代。最终将模型调和均值从0.016提升至0.407,实现约25倍的能力提升,并发现单一编码器的改进未必带来融合能力的提升,环境信号(如AlphaEarth卫星嵌入)是最大杠杆。

技术 › Agent Sai Vegasena 2026-08-1911.3 KB 279.3K 42 72

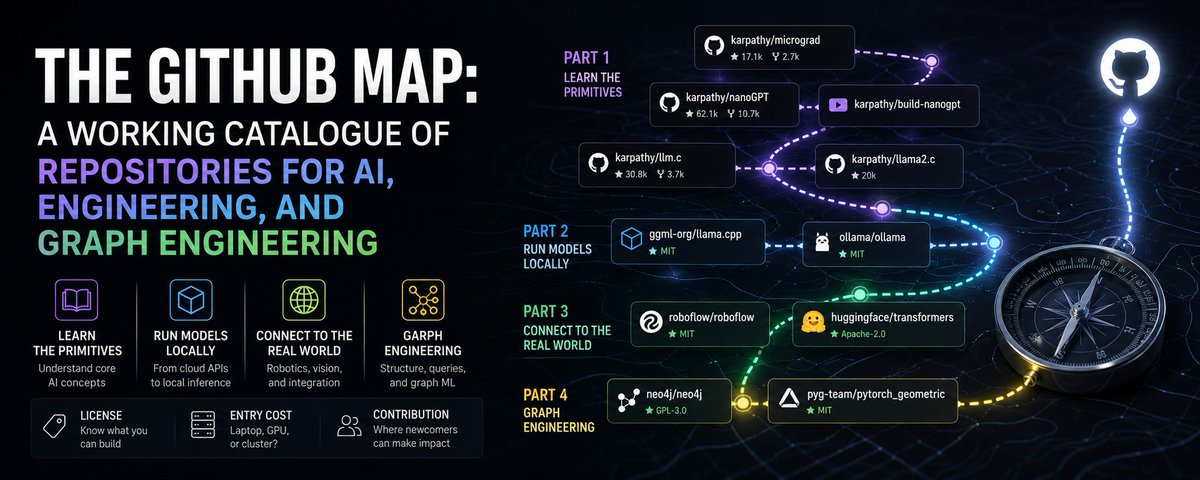
The GitHub Map: A Working Catalogue of Repositories for AI, Engineering, and Graph Engineering

本文旨在解决GitHub上海量AI仓库的导航难题,为AI工程师提供一份经过验证的仓库地图。文章按实际工作流程组织,从基础原理学习(如micrograd、nanoGPT)、本地模型运行(llama.cpp、ollama、vLLM)到图工程等专业领域,逐一介绍关键仓库,并强调许可证、入门成本和贡献机会等实用信息。

技术 › 工具与效率 Yumzlef 2026-08-1533.6 KB 77.9K 32 84

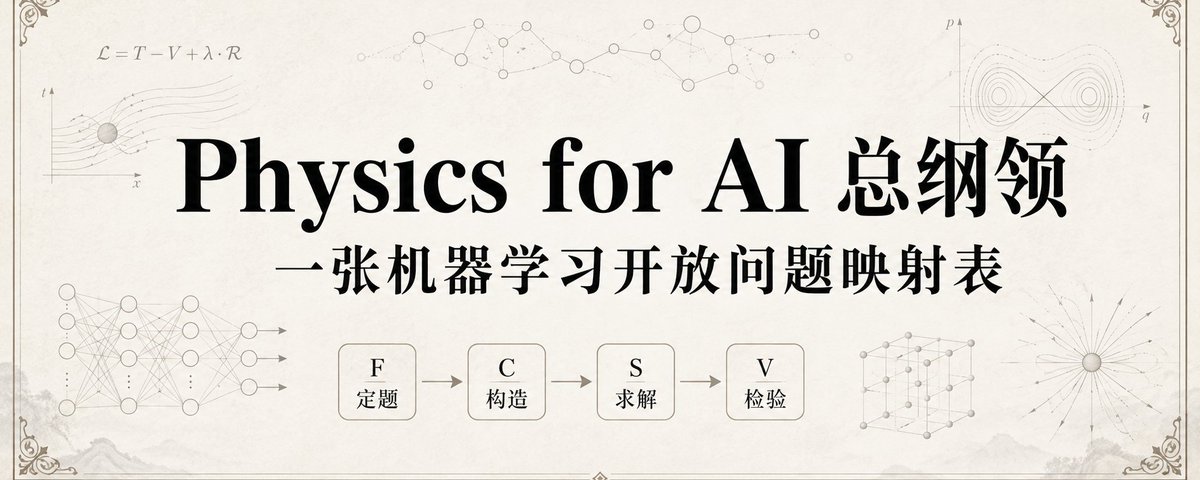
Physics for AI 总纲领

本文系统梳理了物理对机器学习79个开放问题的贡献,按定题、构造块、学习、实验四块逐一分析。作者提出物理介入ML的三条路径:分析方法、模型来源、科研制度,并指出现有综述缺乏按具体问题组织的映射。文中详细评估了每条问题物理能否解决,标注为能、部分或不能,并给出对应的物理方向。最终统计显示,物理在构造块(模型来源)贡献最大,在定题块(语义与目标)几乎无能为力。文章强调物理的价值在于提供分析工具、模型灵感和科研规范,而非万能解药。

技术 › LLM snowboat 2026-08-1596.2 KB 23.4K 34 80

机器学习的开放问题总论

本文系统梳理了机器学习领域的开放问题,将其归纳为两个主干:缺乏有效状态变量和缺乏低成本可重复的因果实验制度。作者提出了一套筛选标准,强调问题应具有可操作性和可证伪性。文章详细分析了状态变量应满足的五条性质,以及因果实验制度面临的样本量、可复现性和归因三大短板。此外,还讨论了裁判质量作为横切轴的重要性,并区分了噪声与偏差的成本差异。

技术 › LLM snowboat 2026-08-1482.2 KB 22.4K 25 80

机器学习的方法论总论

本文提出了一套机器学习方法论的统一框架,将学习算法拆解为十八个节点、四大块,以回答PCA、Transformer等不同方法在方法论上的异同。作者指出传统教科书定义、CRISP-DM流程和Domingos三元组的不足,特别是将“优化”作为第三列命名的问题,并引入闭式解、特征分解、积分等七种参数确定方式。文章详细阐述了定题与构造的前九个节点,包括三层代理(W/M/L)、目标与数据顺序、函数族、归纳偏置、参数化形态等,强调组合视角和归纳偏置的重要性。

技术 › LLM snowboat 2026-08-1386.0 KB 36.9K 60 80

AI for Physics 全景图

文章探讨了AI在物理学领域的应用现状与瓶颈。作者将物理学研究分为解析求解、数值模拟、有效理论构造等五条路线,指出AI在受限于计算能力的领域(如分子模拟、引力波参数估计)取得了显著的“化解”与“新能力”突破;但在依赖概念创新和理论构造的领域,AI仍进展甚微。文章通过重新梳理物理学家的工作方式,提供了一个评估AI实际价值的新视角。

技术 › 方法论 snowboat 2026-08-08131.5 KB 73.4K 124 92