AI 记忆分数超过人类参考,这条新路线创业公司也能走
本文介绍了AI长期记忆领域的最新进展,重点分析了Alloomi公司在LongMemEval-S等评测中取得超过人类参考分的成绩。文章详细解读了其背后的技术路线——基于开源模型的自进化后训练流程,包括数据收集、质量筛选、专家锚定、后训练、评测准入和版本回滚等步骤。作者认为,这条路线降低了创业公司的门槛,将竞争焦点从算力转向数据和流程,为行业模型的发展提供了新思路。
本文介绍了AI长期记忆领域的最新进展,重点分析了Alloomi公司在LongMemEval-S等评测中取得超过人类参考分的成绩。文章详细解读了其背后的技术路线——基于开源模型的自进化后训练流程,包括数据收集、质量筛选、专家锚定、后训练、评测准入和版本回滚等步骤。作者认为,这条路线降低了创业公司的门槛,将竞争焦点从算力转向数据和流程,为行业模型的发展提供了新思路。
本文记录了一位非计算机出身的普通用户,借助 AI 助手,成功在双节点 NVIDIA DGX Spark 上部署蚂蚁百灵 124B 参数的 Ling-3.0-flash 模型,并完成单机 FP4 与双机 FP8 的对比评测。文章详细介绍了从模型下载、SGLang 编译、单机部署到双机配置、公网 API 开放的全过程,并提供了性能数据、踩坑清单和 AI 协作方法论。核心结论是:双机在长输入预填充上优势明显(2.2倍),但解码速度提升有限;上下文长度是硬约束,单机 FP4 适合日常任务,双机 FP8 适合长文档处理。
红杉资本团队撰文探讨企业是否应自建 AI 能力而非依赖前沿实验室。开源模型(如 Kimi K3、GLM 5.2)性能逼近前沿,后训练技术栈日益成熟,成本、速度、专有数据与自主掌控成为自建的核心动因。文章给出实践路线图:组建专职团队、公开研究成果,并系统介绍了评估(Evals)、Harness 与上下文工程、后训练(SFT/偏好调优/RL/蒸馏)以及在线学习四个技术步骤,帮助企业在特定领域超越通用前沿模型。
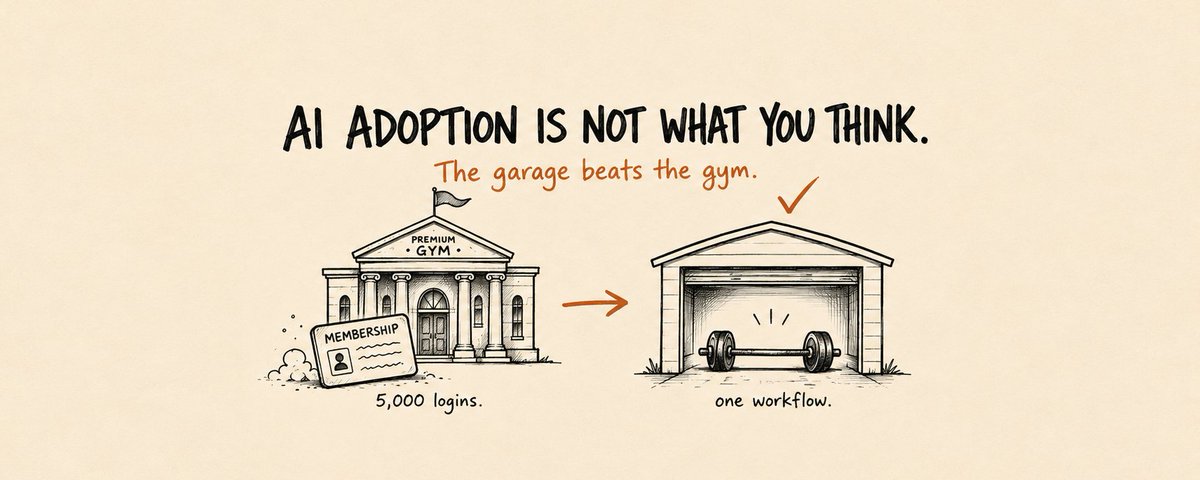
文章指出企业已投入300-400亿美元于AI,但MIT报告显示95%的试点无可衡量的利润影响,而90%以上公司的员工已自发使用AI。作者提出'工作流级采用'概念:采用=模型+个人上下文+一个重复性工作流。借助Ollama、LM Studio在本地运行开源小模型,个人可绕过许可、成本与隐私障碍,通过积累定制上下文让模型深度融入日常工作。相比企业冗长的审批链,个人采用从决定到落地只需一个下午,更具现实性。
本文是一篇面向新手的本地大模型部署教程。作者在 NVIDIA DGX Spark(GB10 芯片、121.6GB 统一内存)上,使用官方适配的 vLLM 分支部署了蚂蚁百灵开源的 124B MoE 模型 Ling-3.0-flash INT4 版本。文章先科普了模型精度、Dense 与 MoE、推理引擎等概念,再详解下载权重、环境准备、启动服务与验证的完整流程,并开启 MTP 投机解码。性能测试显示 8 并发聚合吞吐达 141.38 tok/s,远超本机 Qwen3.8-27B;随后通过逻辑推理、安全边界、长文本三方向测试验证真实能力,最后介绍用 Python 脚本搭建终端 TUI 聊天界面,逐步走向 Agent 工作流与 Token 自由。
本文实测了最新开源的Qwen3.8-27B模型,该模型基于Qwen3.5架构训练,量化后可在24G消费级显卡上运行,性能媲美Qwen3.7-Plus。作者详细介绍了通过Unsloth在Mac和4090上的本地部署流程,并演示了接入桌面Agent后的工具调用、Skill使用、发票整理、图片翻译、PPT生成等场景。实测表明,该模型在复杂办公、长文档和多轮Agent任务中表现出色,是本地部署的极佳选择。
本文通过采访一位硅谷AI创业公司创始人,探讨了闭源与开源模型竞争、中美模型竞争以及Anthropic与OpenAI的竞争格局。受访者认为,闭源模型的壁垒在于数据、上下文和个性化带来的数据飞轮,而开源模型更适合低上下文、低记忆、价格敏感的场景。在高价值场景中,模型智能差异比价格更重要。开源模型目前主要靠蒸馏闭源模型,天花板受限,反超可能性较低。未来竞争的关键在于人才密度、资金和市场,以及是否出现范式突破。
Microsoft 开源了一个名为 TRELLIS.2 的 4B 模型,能在 3 秒内将任意图像转换为生产级 3D 资产。该模型支持完整 PBR 纹理、处理复杂几何结构,并可直接导出 .glb 格式用于 Unity/Unreal/Blender。完全开源,支持本地运行和自定义微调。
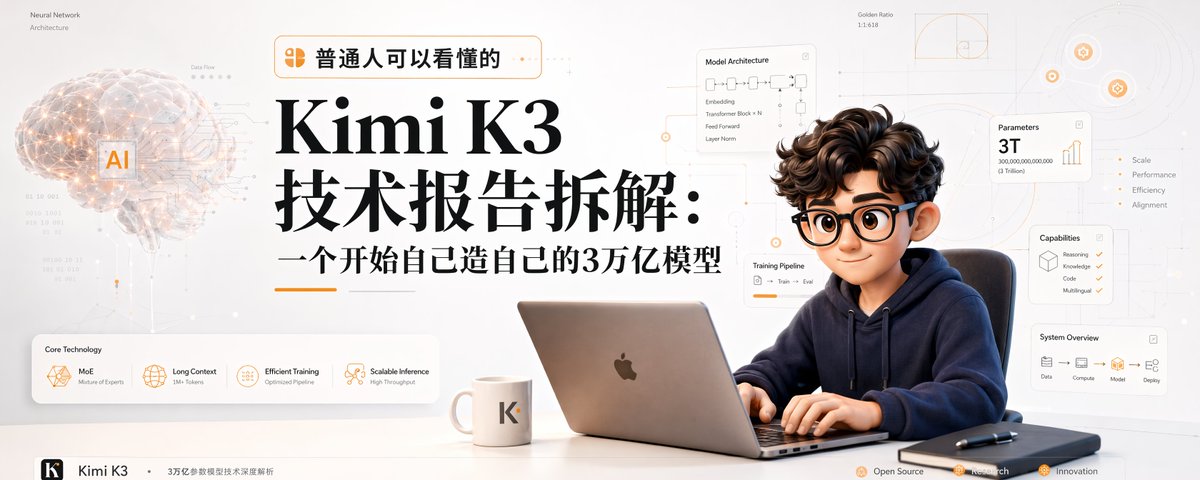
本文拆解了 Kimi K3 的技术报告,这是一个全球首个开源的 2.8 万亿参数模型。文章详细解析了其混合注意力架构、注意力残差机制、MoE 设计以及在长文本训练和推理优化上的创新。报告指出 K3 性能虽略逊于顶级闭源模型,但在多项任务中表现优异,且具有极高的成本效率,甚至已能辅助团队进行内核优化和芯片设计。
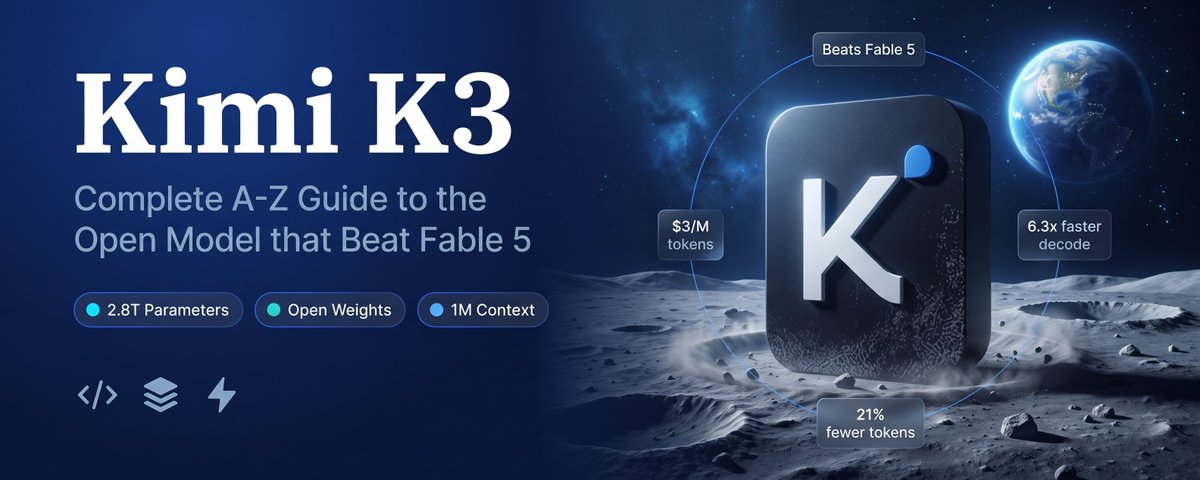
本文详细介绍了月之暗面发布的 Kimi K3 模型。该模型拥有 2.8 万亿参数和 100 万 token 上下文,性能超越 Claude Opus 4.8 和 GPT-5.6 Sol,对标 Fable 5。文章分析了其定价策略、架构创新以及模型自主优化架构的能力,展示了其在长程编码和 3D 前端开发方面的强大实力。
杨植麟在 GTC 2026 演讲中,详细阐述了月之暗面如何通过重构优化器、注意力机制和残差连接这三大基础组件来提升模型性能。他提出了 MuonClip、Kimi Linear 和 Agent Swarm 等技术方案,旨在让 Token 更值钱、长上下文更有效,并实现多 Agent 协作,从而推动开源模型逼近闭源前沿。
文章介绍了如何利用 Ollama v0.24+ 在本地免费运行 OpenAI Codex。通过集成 Gemma 4、Qwen 3.6 等开源模型,用户可以实现零成本、无限制且隐私安全的代码编写体验。文中详细讲解了 Codex Desktop App 和 CLI 的配置方法,并推荐了适配不同硬件的模型。
文章是一份针对 Claude Code 用户的 Pi Coding Agent 迁移与使用指南。作者对比了 Pi 与 Claude Code 的设计理念,指出 Pi 是一个更透明、可控且高度可配置的 Agent 底座。文章详细介绍了如何配置开源模型 Ring-2.6-1T,推荐了最小可用组件栈,列出了常见的配置陷阱,并通过构建现货-永续监控台的真实案例,阐述了在 Pi 环境下实施 plan-first + skill 工作流的重要性。
文章介绍了一种利用免费开源大模型(蚂蚁百灵 Ring-2.6-1T)生成交互式物理教学 Demo 的方法。通过编写特定的 Prompt,让 AI 一键生成包含弹簧振子、单摆、布朗运动等场景的单文件 HTML 代码,帮助学生直观理解晦涩的物理概念和函数图像。这种方法不仅免费、无需编程基础,还能为学生、家长和老师提供量身定制的可视化教具,比传统死记硬背更高效。
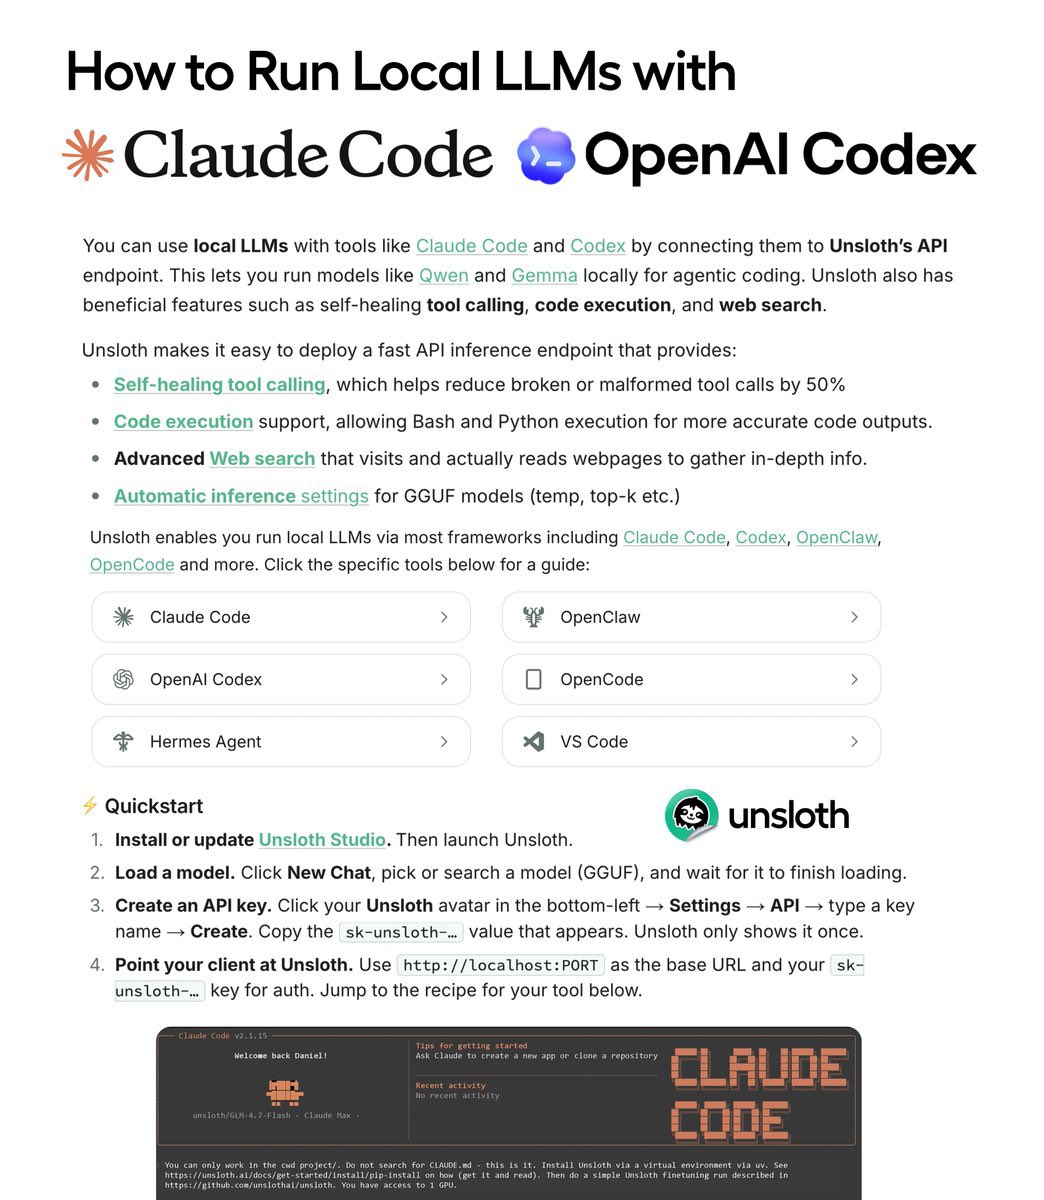
文章介绍了两项针对开发者的重磅AI工具更新。首先是Unsloth发布了指南,允许使用Gemma 4和Qwen3.6等开源模型,在24GB显存的本地机器上运行Claude Code的Agentic Coding工作流,实现了隐私、成本与交互体验的兼顾。其次是Google推出了Code Wiki,利用Gemini自动扫描GitHub仓库生成实时更新的智能Wiki,支持架构图生成和代码溯源,旨在解决软件开发中“读代码”的昂贵瓶颈。
文章记录了作者利用中国开源模型 MiniMax M2.5(仅 10B 激活参数),通过行为工程和 Goose 运行时的优化,在 Databricks OfficeQA 基准测试中以 71.5% 的准确率击败了 Claude Opus 4.5 的实战经历。文章指出,企业级 AI 的竞争已从单纯的模型参数量转向行为工程与驾驭层能力,并揭示了中美 AI 生态(中国执行引擎+美国编排方法论)结合所产生的高效低成本优势。
文章类比2000年互联网泡沫,深入剖析了当前AI市场的现状。虽然四大云厂商巨额的资本支出与AI变现速度之间存在错配,且开源模型正在通过压低价格摧毁商业护城河,但作者认为这并不意味着AI是骗局。泡沫破裂会清洗掉投机者,留下的廉价算力基础设施将为未来真正改变世界的伟大公司铺平道路,恰如当年的亚马逊。
本文深入探讨了 Moonshot AI 的开源模型 Kimi K2.6,强调其独特的“群体智能”架构,能协调 300 个子代理并行处理复杂任务。文章对比了 Kimi 与 Claude 的优劣,展示了 Kimi 在数据抓取、代码优化和网页生成方面的实战能力,并详细介绍了如何利用 Cloudflare Workers AI 和 Open Code 免费部署该模型。
本文是一份 DeepSeek V4 的使用指南。文章指出大多数人未解锁 V4 的真正潜力,介绍了快速与专家两种模式的区别,重点解读了 100 万 token 上下文窗口的价值。作者提供了工作汇报、学习概念、辅助决策的提示词模板,并深度解析了“深度思考”与“智能搜索”的开启场景。此外,文章还对比了 API 型号与成本,强调了 V4-Pro 在 Agent 自动化领域的开源领先地位及其性价比优势。
NVIDIA 发布了开源多模态大模型 Nemotron 3 Nano Omni。该模型集成了视觉、语音和语言能力,旨在解决 AI 智能体在处理不同模态数据时面临的延迟和上下文碎片化问题。凭借 30B-A3B 混合专家架构,其在开放模型中实现了领先的准确吞吐比(9倍于同类),可广泛用于计算机控制、文档智能及音视频理解等企业级场景。
文章通过对比航空史,深入分析了AI产业在监管、能源及商业模式上的结构性差异。作者指出,AI缺乏“事故驱动立法”机制,且监管套利与开源模型加剧了内卷。文中强调,AI并非盈利的根本原因,企业需通过数据与流程壁垒构建“不对称性”才能生存,否则仅在为延迟出局付费。同时探讨了中国市场特有的数据主权、蒸馏风险及政府角色带来的额外复杂性。
文章分析了 DeepSeek V4 的发布及其对美国 AI 主导地位的挑战。作为一款性能逼近 GPT-5.5 和 Opus 4.7 但价格极低的 MoE 开源模型,它打破了现有的商业逻辑。作者认为,虽然该模型并非完全超越前沿水平,但其极致性价比可能导致美国企业大规模转向采用,从而引发严重的地缘政治安全风险。同时,文章讨论了出口管制、蒸馏指控及文化叙事控制等深层影响,呼吁美国加强开源策略并降低模型成本。
作者分享了一个下午零成本搭建 TinyPA 应用的实战经验。文章详细列出了构建 AI 应用所需的“七件套”免费资源:Vercel 托管、Neon 数据库、Auth.js 身份认证、Resend 邮件、NVIDIA NIM(Llama 3.3 70B)大模型以及 Cron 定时任务。这份“购物清单”证明了在项目初期,完全可以利用免费额度实现包含前后端、数据库和域名功能的完整 AI 应用,且给出了何时需要付费的明确界限。
本文探讨了超级智能已至的背景下,AI 发展的加速及其带来的挑战与机遇。作者指出 AI 将重塑高 prestige 的白领行业,同时也面临持续学习、安全和验证等难题。文章建议通过自动化低垂果实、拥抱开源权重模型、利用隐性知识及建立安全基线来应对。
本文回顾了2026年4月15日AI领域的重大动态。核心内容包括Anthropic的Mythos模型引发的网络安全军备竞赛,OpenAI推出GPT-5.4-Cyber作为反击;Anthropic获得高达8000亿美元的估值邀约;开源社区SuperGemma 4的突破;以及主流聊天机器人在医疗建议方面的高错误率。
本文详细介绍了针对开源大模型(如Gemma-4-31B)进行“越狱”的技术原理与实操流程。不同于闭源模型的提示词工程,开源模型越狱(Abliteration)通过修改权重直接抹除模型内部的“拒绝维度”。文章涵盖了从构建对比数据集、提取激活值、计算拒绝向量、权重正交化到最终验证的完整步骤,并指出了过度顺从等副作用及相关的法律伦理风险。
本文记录了 Andrej Karpathy 与 Sarah Guo 的播客对话。Karpathy 指出自 2024 年底起,其工作模式已彻底转变为“指挥 Agent 干活”,通过 AutoResearch 实现递归自我改进。他讨论了 AI Agent 在编程与生活中的应用、开源与闭源模型的收敛,并指出了当前 AI 在可验证领域(代码)飞速进步,但在非可验证领域(如幽默)仍面临“参差不齐”的瓶颈。