Wiki 知识库

全部文档 / 作者: Akshay / 标签: Agent

17 篇
清除

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。

技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

Jev Clearly Explained

文章介绍了 TypeSafe 于 2026 年 9 月发布的 Jev 模型——一个专注于快速、低成本语义决策的"系统一"模型。传统 LLM 在智能体循环中处理大量小型判断(如工单分类、命令风险评估)时逐 token 生成,速度慢且成本高。Jev 通过三种原语(Choice、Score、Noul)接受非结构化输入,返回带概率的类型化答案,端到端延迟 70-500 毫秒,输入价格仅为 LLM 的一小部分。文章分析了概率置信度在自动决策中的作用、RLCD 校准训练方法,并澄清"无法幻觉"的说法:Jev 不会打破输出 schema,但仍可能自信地选错选项,适合与 LLM 配合而非替代。

技术 › LLM Akshay 2026-09-1916.0 KB 2.4M 5.6K 79

LLM 路由可能比不路由成本更高

文章探讨 LLM 路由(LLM Routing)的成本悖论:理论上将简单任务分配给廉价模型可节省大量成本(如 RouteLLM 实现约 85% 降本),Uber 因给 5000 名工程师统一部署 Claude Code 导致年度 AI 预算提前耗尽的案例也说明单一模型定价的问题。但传统路由方案在生产中会因四大失败模式而失效:分类调用额外计费、通用模型意图识别能力差、路由逻辑缺乏评估易腐化、以及模型切换破坏 KV 缓存导致全价重算。文章随后介绍 DigitalOcean 基于开源代理 Plano 的基础设施级路由方案:使用 1.5B 参数的专用路由模型(Arch-Router / Plano-Orchestrator)在代理内完成意图解析,准确率超越前沿大模型且更快,再结合成本与延迟数据对候选模型池按策略排序,实现成本与质量兼顾的动态路由。

技术 › LLM Akshay 2026-09-0715.7 KB 49.9K 475 75

用 Grok Bot 搭建一支 AI 工程团队

文章介绍如何用四个专业化 Agent(项目经理 Piper、后端 Bay、前端 Fin、测试 Tess)组成一个多智能体工程团队,解决多 Agent 协作中交接时上下文丢失的经典问题。Grok Bot 的优势在于所有 Bot 共享同一台持久化云计算机器,状态以文件形式保存在磁盘上,消息只传递路径,使接手的 Bot 能完整继承前一 Bot 的知识。作者通过磁盘任务板 board.md、五个强制交接纪律的 Skill 以及 InsForge 后端平台实现全自动功能交付流水线。

技术 › Agent Akshay 2026-08-2732.7 KB 21.6K 161 76

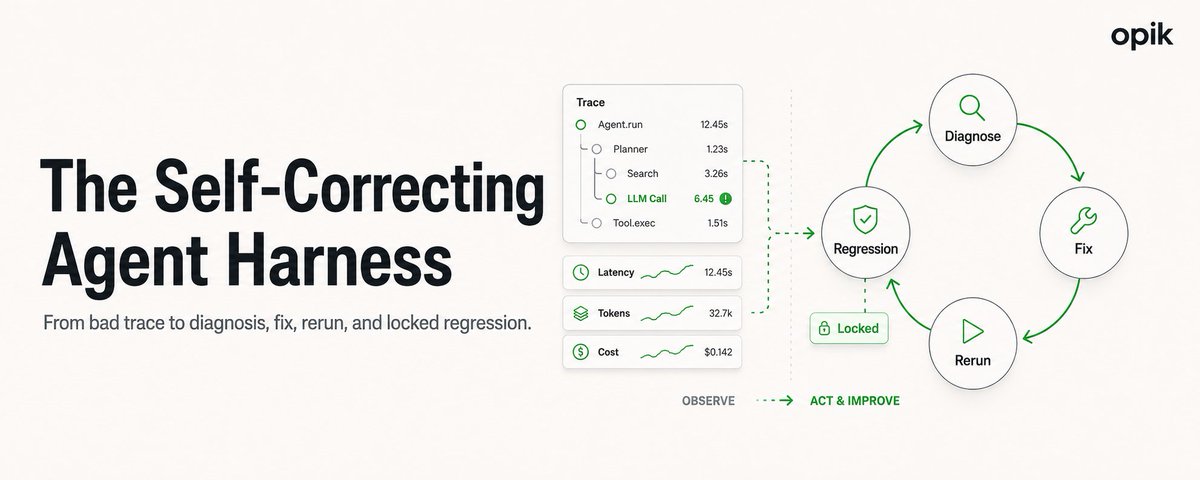
你的 Agent 框架应该能够自我修复

文章探讨了AI Agent在生产环境中失败时,传统可观测性工具仅能提供追踪数据,而无法自动解决修复问题的瓶颈。作者介绍了开源平台Opik,它通过四层架构(Tracing追踪、Ollie诊断与修复、Test Suites测试集、Agent Sandbox沙盒)形成闭环。该平台能自动诊断错误链路,内置代码代理提出修复方案,并将真实失败转化为回归测试,从而实现Agent框架的自我修复与持续优化。

技术 › Agent Akshay 2026-08-099.9 KB 1.8M 1.6K 84

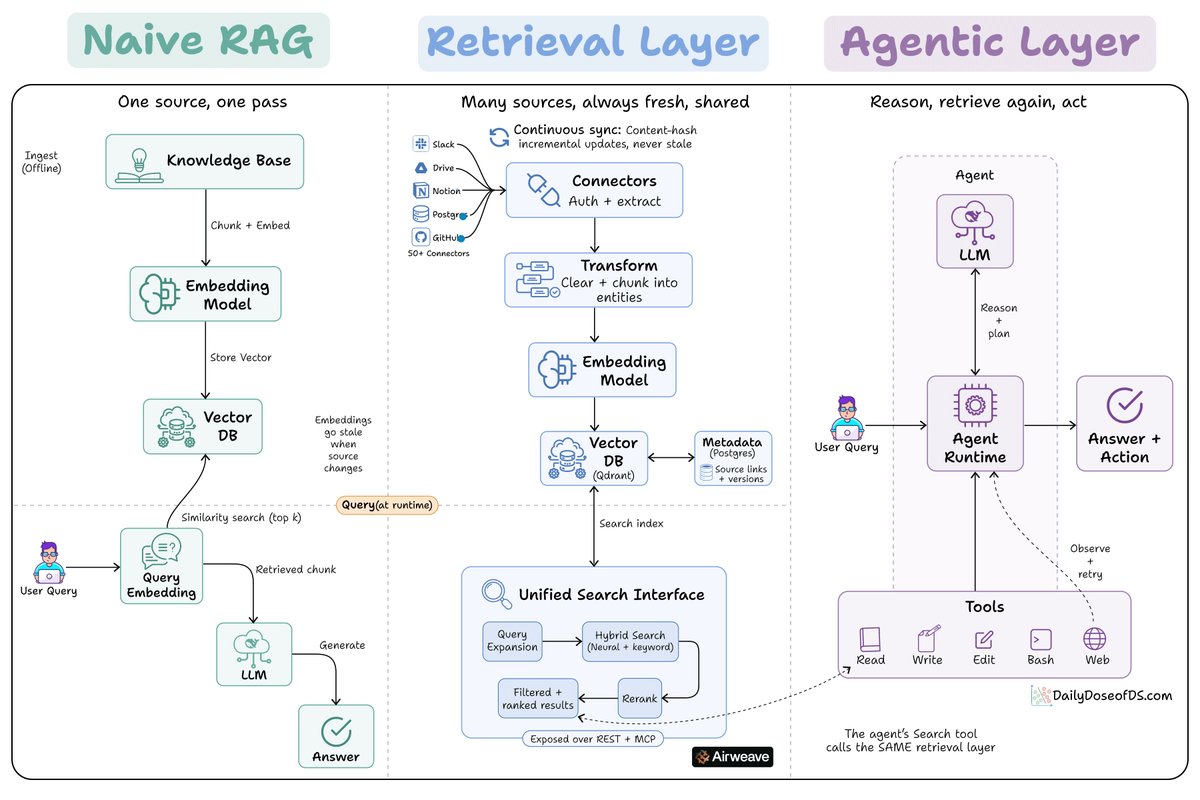
Google和Anthropic对检索的共识:从单一应用到独立服务

文章讨论了Google和Anthropic将检索从单一应用中移出,转变为独立服务的新趋势。这种分离解决了旧RAG设置中的过时嵌入和基础设施耦合问题。通过将摄取与查询分离,并使用结构化单元代替原始文本块,可以显著减少语料库大小并提高向量相关性。

技术 › LLM Akshay 2026-08-022.9 KB

Agents Need a New Kind of Web Search

文章探讨了当前 AI Agent 在使用传统网页搜索时面临的“检索税”问题。传统搜索 API 仅返回链接和摘要,迫使 Agent 耗费大量 Token 去抓取和清洗内容。作者通过对比实验指出,使用预先爬取并结构化处理的索引(如 Seltz)能显著降低成本并提升效率,这种返回完整文档而非指针的方式是 Agent 搜索的未来。

技术 › Agent Akshay 2026-07-179.7 KB 72.1K 152

Let's build Claude Code's harness (step-by-step)

本文深入解析了Claude Code的“harness”架构,解释了为何简单的模型调用不足以构建可靠的代码代理。作者通过CrewAI框架逐步重建了包括核心循环、工具管理、规划机制在内的关键组件,揭示了通过工程化手段弥补模型差距的方法。

技术 › Claude Code Akshay 2026-07-1641.0 KB 306.3K 899

Hermes Agent 进阶指南:从架构原理到构建自进化的多智能体系统

本文深入介绍了 Nous Research 开源项目 Hermes Agent。文章详细解析了其独特的“学习闭环”架构,该架构结合了三层持久化内存、自进化技能系统以及 GEPA 优化引擎,解决了传统 Agent 随会话结束而遗忘的问题。文中还将 Hermes 与 OpenClaw 进行了对比,并提供了从零开始配置多个个性化 Agent(程序员、研究员、设计师)的实战教程,旨在帮助开发者打造能够 24/7 运行且持续学习的个人 AI 队伍。

技术 › Hermes Akshay 2026-05-2856.5 KB 5.8M 6.5K 88

Pydantic fixed my Agent's Memory

文章探讨了如何解决 AI Agent 记忆系统的多跳推理问题。传统的向量数据库在处理跨块事实连接时失效,而通用知识图谱常因缺乏结构导致查询噪音。作者提出的解决方案是使用 Pydantic 提前定义本体(Schema),明确实体类型、关系和属性。通过 Zep 框架强制执行这些约束,可以显著提升提取的准确性和数据的可查询性,从而实现有效的多跳推理。

技术 › Agent Akshay 2026-05-2612.5 KB 312.9K 567 80

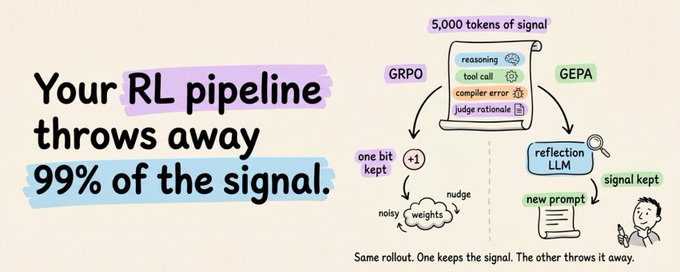
无需更新权重的 GRPO 替代方案:GEPA 算法解析

文章介绍了 Berkeley 团队提出的 GEPA 算法,该算法作为 GRPO 的替代方案,无需更新模型权重或进行 GPU 训练,仅通过优化提示词(Prompt)即可在 HotpotQA 等基准测试中取得更优成绩。GEPA 的核心在于利用 LLM 读取完整的推理轨迹,通过自然语言反思来迭代优化多模块系统中的每个提示词,从而避免了强化学习中将丰富信息压缩为单一标量信号的信息损耗问题。

技术 › LLM Akshay 2026-05-0113.7 KB 272.4K 371 83

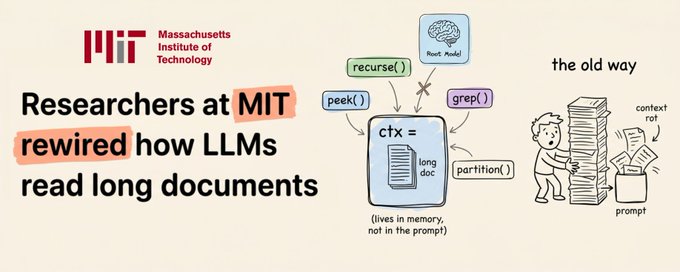
Recursive Language Models (RLMs) 清晰解释:解决大模型长上下文推理难题

文章介绍了一种称为递归语言模型(RLMs)的新方案,旨在解决大语言模型在处理超长上下文时出现的“上下文腐烂”问题。RLMs 不再将上下文限制在单一 Prompt 中,而是将其视为外部数据,通过赋予模型窥探、正则匹配、分区和递归调用等工具,让模型自主决定如何分解和处理任务。这种方法不仅消除了上下文长度对推理能力的影响,还提高了准确性和成本效率。

技术 › LLM Akshay 2026-04-2812.6 KB 131.6K 441 68

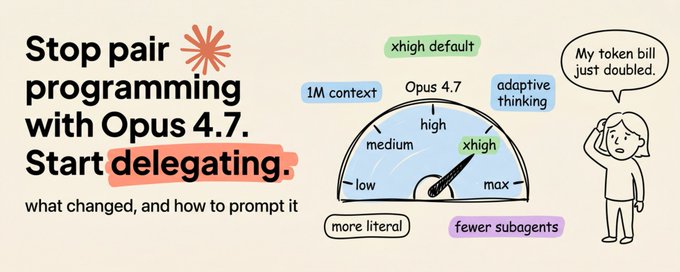
Claude Opus 4.7 迁移指南:从 4.6 平滑升级的最佳实践

本文详细分析了 Claude Opus 4.7 与 4.6 的关键差异。新版模型采用了自适应思考机制、更严格的指令遵循以及 xhigh 默认算力等级。文章指出了升级后成本增加和召回率下降的原因,并提供了具体建议:采用“委托思维”而非“结对编程”模式,在首轮交互中明确任务意图,批量提问以减少推理开销,并针对 4.7 的字面义理解特性调整 Prompt 风格。

技术 › LLM Akshay 2026-04-2033.4 KB 49.6K 357 92

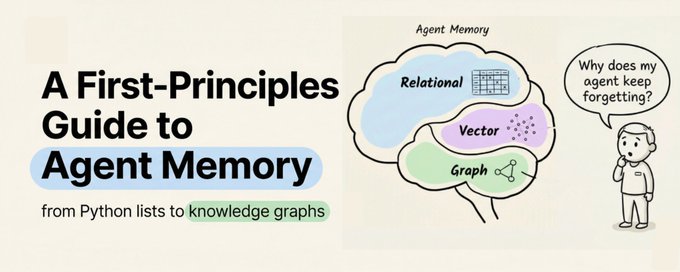
构建永不遗忘的 Agent:从原理到 Graph-Vector 混合架构

文章从第一性原理出发,深入探讨了 Agent 记忆机制的演变。作者指出单纯依赖 Context Window 会遭遇“中间迷失”效应,并借鉴认知科学将记忆分为感觉记忆、工作记忆和长时记忆。文章通过对比 Python 列表、Markdown 文件和向量搜索等不同技术层级的优劣,揭示了传统方案在持久性、语义理解和关联推理上的局限性,最终提出了结合图数据库和向量搜索的 Graph-Vector 混合解决方案。

技术 › Agent Akshay 2026-04-1628.0 KB 631.8K 1.9K 83

构建永不遗忘的智能体:从基础到向量与图谱混合记忆方案

文章深入探讨了LLM智能体的“记忆”难题,指出单纯增加上下文窗口无法解决“迷失在中间”效应及会话遗忘问题。作者基于认知科学框架,分析了从Python列表、Markdown文件到向量检索各阶段的局限性,强调构建兼具持久化、语义理解和关系推理能力的记忆层至关重要,最终引入了一个能够整合向量、图谱和关系存储的开源解决方案。

技术 › Agent Akshay 2026-04-1427.9 KB 83

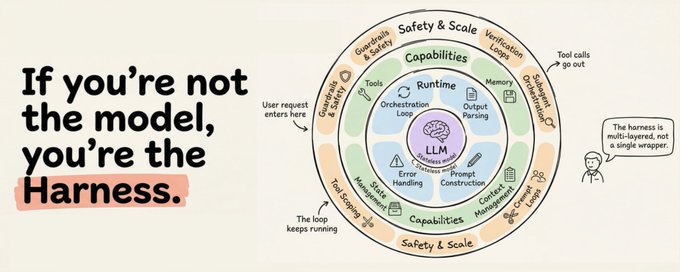
代理工具的解剖结构

文章深入剖析了将无状态 LLM 转变为功能强大的智能体所需的“代理框架”基础设施。内容涵盖编排循环、工具工程、内存、上下文管理、安全护栏及子代理编排等 12 个核心组件。文章对比了 Anthropic、OpenAI 和 LangChain 的实现策略,指出生产级应用的关键在于模型周围的工程架构,而非模型本身。

技术 › Agent Akshay 2026-04-0719.7 KB 2.7M 3.5K 92

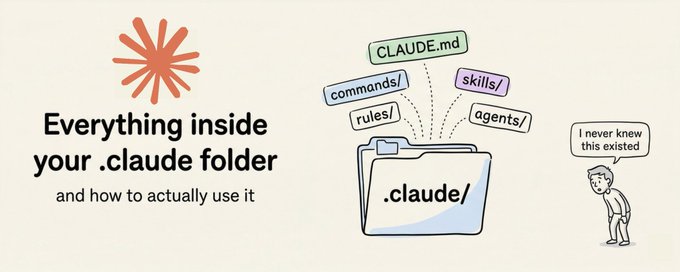
揭秘 Claude Code 核心:.claude 文件夹完全指南

本文深入解析了 Claude Code 中 .claude 文件夹的结构与功能。作为 Claude 运行的控制中心,该文件夹存储了指令、自定义命令、权限规则及会话记忆。文章详细介绍了项目级与全局配置的区别,阐述了 CLAUDE.md、rules/、commands/、skills/、agents/ 及 settings.json 的具体用法与最佳实践,帮助开发者配置专属的 AI 编程助手,提升团队协作效率。

技术 › Claude Akshay 2026-03-2213.4 KB 12.3M 11.5K 92