Wiki 知识库

技术 / LLM

1284 篇
清除

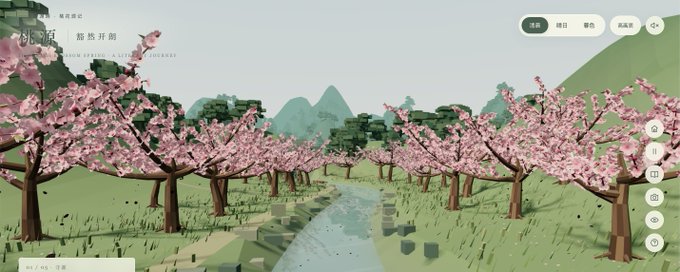
我用 GPT 6 Astra 做了一个 3D 版的《桃花源记》(文中含提示词)

作者宝玉分享用 ChatGPT Pro 的 GPT 6 Astra 制作 3D 版《桃花源记》网页的完整过程。通过一套详细的提示词,让 AI 将课文拆成 20 幕,实现可拖动视角、跟随原文叙事的'循文入境'体验。针对 TTS 朗诵不佳的问题,改用央视李立宏的真人朗诵并配以 SRT 时间戳同步;再由 Codex 做工程化优化,将音频独立、更换真实环境音,文件从 5.6MB 缩至约 777KB。文章总结了几点体会:明确审美与验收标准比堆形容词更重要,声音是交互的一部分,不同 AI 工具分工协作。文末附有可复用的完整提示词模板,可套用于其他古文场景制作。

技术 › LLM 宝玉 2026-09-2020.5 KB 83.8K 193 84

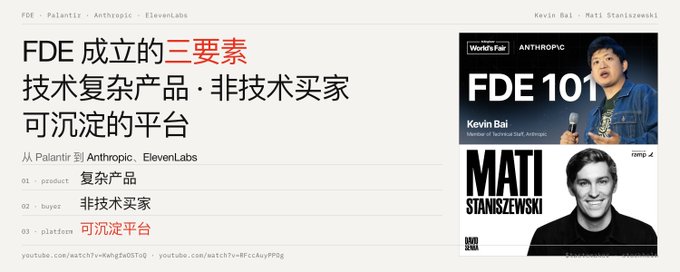
FDE 成立的三要素:技术复杂的产品、非技术的买家、可沉淀的平台,从 Palantir 到 Anthropic、ElevenLabs

文章基于 Anthropic FDE Kevin Bai 的演讲与 ElevenLabs CEO Mati Staniszewski 的访谈,系统阐述 Forward Deployed Engineer(前置部署工程师)模式:FDE 是派出工程师深入客户业务、基于自有平台构建定制方案、按结果交付的模式,区别于外包。其适用判据是'高复杂度产品 × 非技术买家'。AI 时代几乎所有平台都可被 Agent 深度定制,推动各公司进入该场景。组织上 FDE 应隶属产品团队,关键在于知识回流平台,否则退化为服务业;文章总结 FDE 为'平台杠杆 × 知识回流杠杆'的双向结构,并以 Deutsche Bank 语音 Agent 案例展示交付流程。
技术 › LLM meng shao 2026-09-207.1 KB 5.2K 33 76

2026 Mac 跑大模型配置指南|16GB 到 512GB 怎么选

文章针对 Apple 新发布的 M6 Mac mini 与 M5 Mac Studio 系列,系统讲解如何为本地运行大模型选择合适配置。作者提出三笔账:内存容量决定模型能否装下、内存带宽决定生成速度、算力决定提示词处理和训练能力。给出 4 位量化模型内存估算公式和生成速度理论公式,并提供四档选购建议:24-32GB 跑 8B-14B、64GB 跑 32B、128GB 跑 70B、256-512GB 跑 200B 以上或 671B MoE。最后指出数据保密、高频调用、离线需求才是为本地模型购买大内存 Mac 的真正理由。

技术 › LLM 苏乐 2026-09-2019.6 KB 317.2K 453 86

从0到1,搭建起你的个人知识库

文章从AI对话缺乏长期记忆的痛点切入,系统讲解了个人知识库的作用、分类与搭建方法。作者介绍了两大主流方案:以检索为中心的RAG知识库和以持续维护页面为中心的LLM Wiki知识库。RAG部分通过Dify演示了从资料上传、切片、混合检索索引建立到Agent接入的完整流程;LLM Wiki部分则介绍了Karpathy提出的三层结构(raw sources、wiki、schema),强调Markdown页面对AI友好且透明可查。最后作者分享了自己结合两者优势的混合方案,帮助读者根据实际需求选择合适的知识库路线。

技术 › LLM Lab 305 2026-09-2044.8 KB 27K 176 82

当一切皆可批量生成时,如何靠品味致富

文章探讨了AI时代内容创作经济的转变:机器使“制作”变得廉价甚至免费,导致内容泛滥(slop),而真正稀缺的是判断力和品味。作者提出,品味不再是好眼力,而是预先写下的规则文档,用以约束AI输出。文章给出四种将品味变现的路径:做筛选者、让个人品牌成为质量担保、拥有角色与世界观而只租用机器、以及出售自己的规则。最后提供了五步日常实践方法:先写规则再生成、让AI做助手而非作者、统计未修改直接发布的内容占比、维护记忆文件、偶尔否决数据。核心观点是:在内容无限的时代,有人在乎过的东西才有价值。

技术 › LLM Machina 2026-09-209.2 KB 215K 977 78

爆肝30天!魔搭紫皮书开源:系统学习AI的免费指南

袋鼠帝及其AgentWork开源社区耗时30天推出免费开源的《魔搭紫皮书》,一本约40万字、8篇34章的系统学习AI指南。与侧重AI Agent应用的workbuddy蓝皮书和豆包工作蓝皮书不同,紫皮书面向想从零深入AI领域的读者,涵盖开源模型下载、微调(ms-swift)、评测(EvalScope)、应用场景(AI健身教练、智能客服质检、语音助手等)及Agent篇(Claude Code、DeepSeek Harness等)。作者分享了自己7年前报培训班学习编程的经历,强调开源时代AI学习资源免费可得,唯一门槛是执行力。

技术 › LLM 袋鼠帝 2026-09-206.1 KB 32.5K 328 63

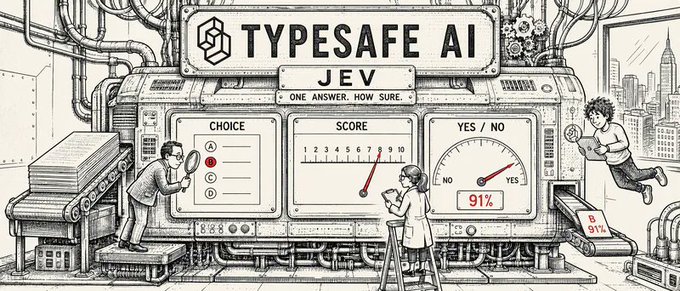
全网刷屏的 Jev 到底怎么用?8 个能直接抄的案例

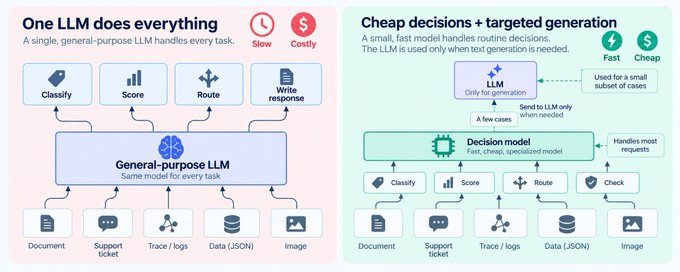
本文介绍了 AI 圈新火的模型 Jev——一个不做文本生成、只返回带概率判断的决策模型。文章讲清了它的三种用法(是非判断、选项选择、打分),提供了四种 30 分钟内可上手的接入方式(官方 Skill、Vercel、OpenRouter、SDK),并整理了 8 个可直接复用的真实案例:7 秒订机票、代码审查、工单分流、简历初筛、语义搜索、AI Agent 路由、RAG 重排、动态 UI 拼装等。还总结了 5 个反直觉要点(不写字、零幻觉指格式而非正确性、不会拒绝等)、官方自曝的雷区(不会算术、不懂日期先后、易被提示词注入),以及不适合使用的场景。

技术 › LLM Leaf Yeah! 2026-09-2016.8 KB 131.8K 279 86

腾讯开源微信端到端文档解析模型 WeVisDoc

腾讯开源了微信团队的端到端文档解析模型 WeVisDoc,提供 2B 和 4B 两个版本。模型可将整页文档图片直接转换为 Markdown,无需分别裁剪标题、正文、表格和公式。它能保留复杂文档结构:正文转 Markdown,公式转 LaTeX,表格转 HTML,并恢复阅读顺序。版面理解、文字识别、公式识别和表格重建均由单一视觉语言模型完成,无需额外部署版面检测器或 OCR 引擎。2B 适合资源有限场景,4B 在拍照、翻拍等退化页面表现更优,在公式和表格解析方面端到端领先。

技术 › LLM 小互 2026-09-201.6 KB 60

AI写自媒体文章不被引用和搜索不到的原因分析与解决方法

文章分析了2026年9月公众号、头条号、小红书加强对AI内容审核后,AI辅助写作文章阅读量下降、不被AI搜索引用的原因。作者基于1200多篇自媒体文章的数据统计指出,平台限制的并非AI本身,而是批量生产的低质内容。表现好的文章AI辅助比例通常控制在25%以内,同质化指数低于30%。作者提出三层人工覆写方法(信息覆盖、加入观点、语气校准),并建议发布前进行五维度检测:AI率、同质化、敏感词、标题合规与冷启动流量预测。核心结论是:AI只能提效,无法替代独立思考,每篇文章应补充100-300字第一手内容。

技术 › LLM 熊叔的茅草屋 2026-09-194.3 KB 1.9K 2 73

AI时代生态位思考:自媒体+线下活动+海外FDE

作者天策记录了与北哥畅聊后对AI时代个人生态位的思考:确立自媒体+线下活动+海外FDE的方向。文章阐述了AI视角下的行业逻辑——skill、agent和AI产品本质上都在为Token打工,关键是扩大应用范围卖出更多Token。作者介绍了合作的AI平台Creao,提供低成本使用顶尖大模型的机会,使其能按想象力开发产品并利用最顶尖大模型套利。作者感叹AI让00后、05后超级个体涌现,一人即一家公司,认为这是最好的时代,鼓励大家顺势而为在AI时代收获财富。后续将专注前端流量,后端承接已稳定。

技术 › LLM 天策 (@Leobai825) 2026-09-193.1 KB 42

别人看发布会我跑数据:六组实验五个开源仓库,Jev 的真实边界全在这

作者通过六组实验和五个开源仓库实测 TypeSafe 发布的 Jev 模型的真实能力边界。Jev 是只回答封闭问题、一次前向返回概率分布的模型。核心结论:Jev 适用于信号在语义中的场景(如泰坦尼克 0.83 AUC),对纯统计信号数据(如哈希 CTR 数据)无效;零样本表现相当于 150-500 条标注数据;最佳用法是作为特征融入已有模型而非单独使用,五个项目均获显著提升。作者还总结了问法即超参数、汇总预警取决于时间尺度、情绪分析无用等六条经验,以及评审循环偏差、真值精度等评测教训。

技术 › LLM Jason Zhu 2026-09-1917.6 KB 7.8K 51 86

Jev 模型从 0 到 1 小白教程

本文介绍了 TypeSafe AI 公司发布的新模型 Jev。Jev 由前 OpenAI 研究员、RLHF 共同发明者 Diogo Almeida 打造,它不会聊天,只做结构化判断,像流水线上的质检员。Jev 通过'填表'方式解决大模型自由文本输出带来的不可控问题,支持单选、评级、判断三种题型,且自带 confidence 置信度,可按把握度决定自动处理、人工确认或转人工。它比同级大模型快约 200 倍、便宜约 400 倍,适合客服分流、内容审核、简历筛选、AI 输出质检和数据清洗等自动化场景。文章还讲解了如何把大问题拆解为具体小问题来使用 Jev。

技术 › LLM 黄小木 2026-09-1913.4 KB 977.9K 1.2K 85

拿到 Jev,然后呢?剔掉虚火之后的一份真实落地清单

TypeSafe AI 于 2026 年 9 月发布的 Jev 是一个只做选择题的 AI 模型(单选、打分、是/否),响应 0.07–0.5 秒、输入价格极低、输出免费。作者梳理了官方数据及 Hacker News 上的质疑,指出“Jev 取代大模型”是伪命题,其合理定位是高频、低价地执行小判断。文章按用途分类整理了已真实跑通的案例:为 AI Agent 当决策器、海量数据分类、高低置信度分流混合架构、实时反应界面和仿真实验,并列举了已接入的商业产品。作者还分享了自己四次失败的集成尝试与两轮实测结论,强调概率校准的重要性。

技术 › LLM huangserva 2026-09-1922.2 KB 552.7K 840 85

Behind Jev: Two Hypotheses About Its Base Model

文章探讨 TypeSafe 公司 Jev 决策 API 背后可能的基础模型架构,提出两种假设:一是 BERT 风格的双向编码器,二是去掉生成循环、直接输出决策概率的因果解码器。作者引用 Archer Hume 基于约一万次 API 调用的逆向分析,认为其可能是带共享状态计算、独立问题分支和直接概率读出的因果 Transformer,甚至可能是 MoE 架构,但其研究无法区分编码器与解码器。文章还通过 OpenJev 等开源项目(基于冻结的 Qwen3.5-4B 权重)证明使用因果模型骨干做直接决策打分在技术上可行,并讨论了因果注意力、前缀缓存等工程优势。作者强调这些都是架构假设,不能确定 Jev 的真实权重来源。

技术 › LLM Roy Chen 2026-09-1911.5 KB 45.6K 123 74

Anthropic 经济情景论文笔记:AI 到 2030 年对 GDP、工资与就业的影响

作者精读 Anthropic 57 页经济学论文,梳理了 2030 年前 AI 大规模进入认知型工作后的经济影响。论文设计了温和、显著、极端三种情景,对应 GDP 增幅 1.6%、8.3% 和 32.4%。关键结论包括:AI 独立完成任务比例越高,收入越流向资本而非劳动者;显著情景下 GDP 增 8.3% 但平均工资仅增 2.1%,资本收入增 18.9%;难以被 AI 替代的工作(建筑、电工等)反而升值;工资弹性决定冲击表现为降薪还是失业;极端情景下经济总收益约为认知工作者损失的三倍,核心问题是财富分配而非财富创造。

技术 › LLM 小盖 (@xiaogaifun) 2026-09-1910.7 KB 73

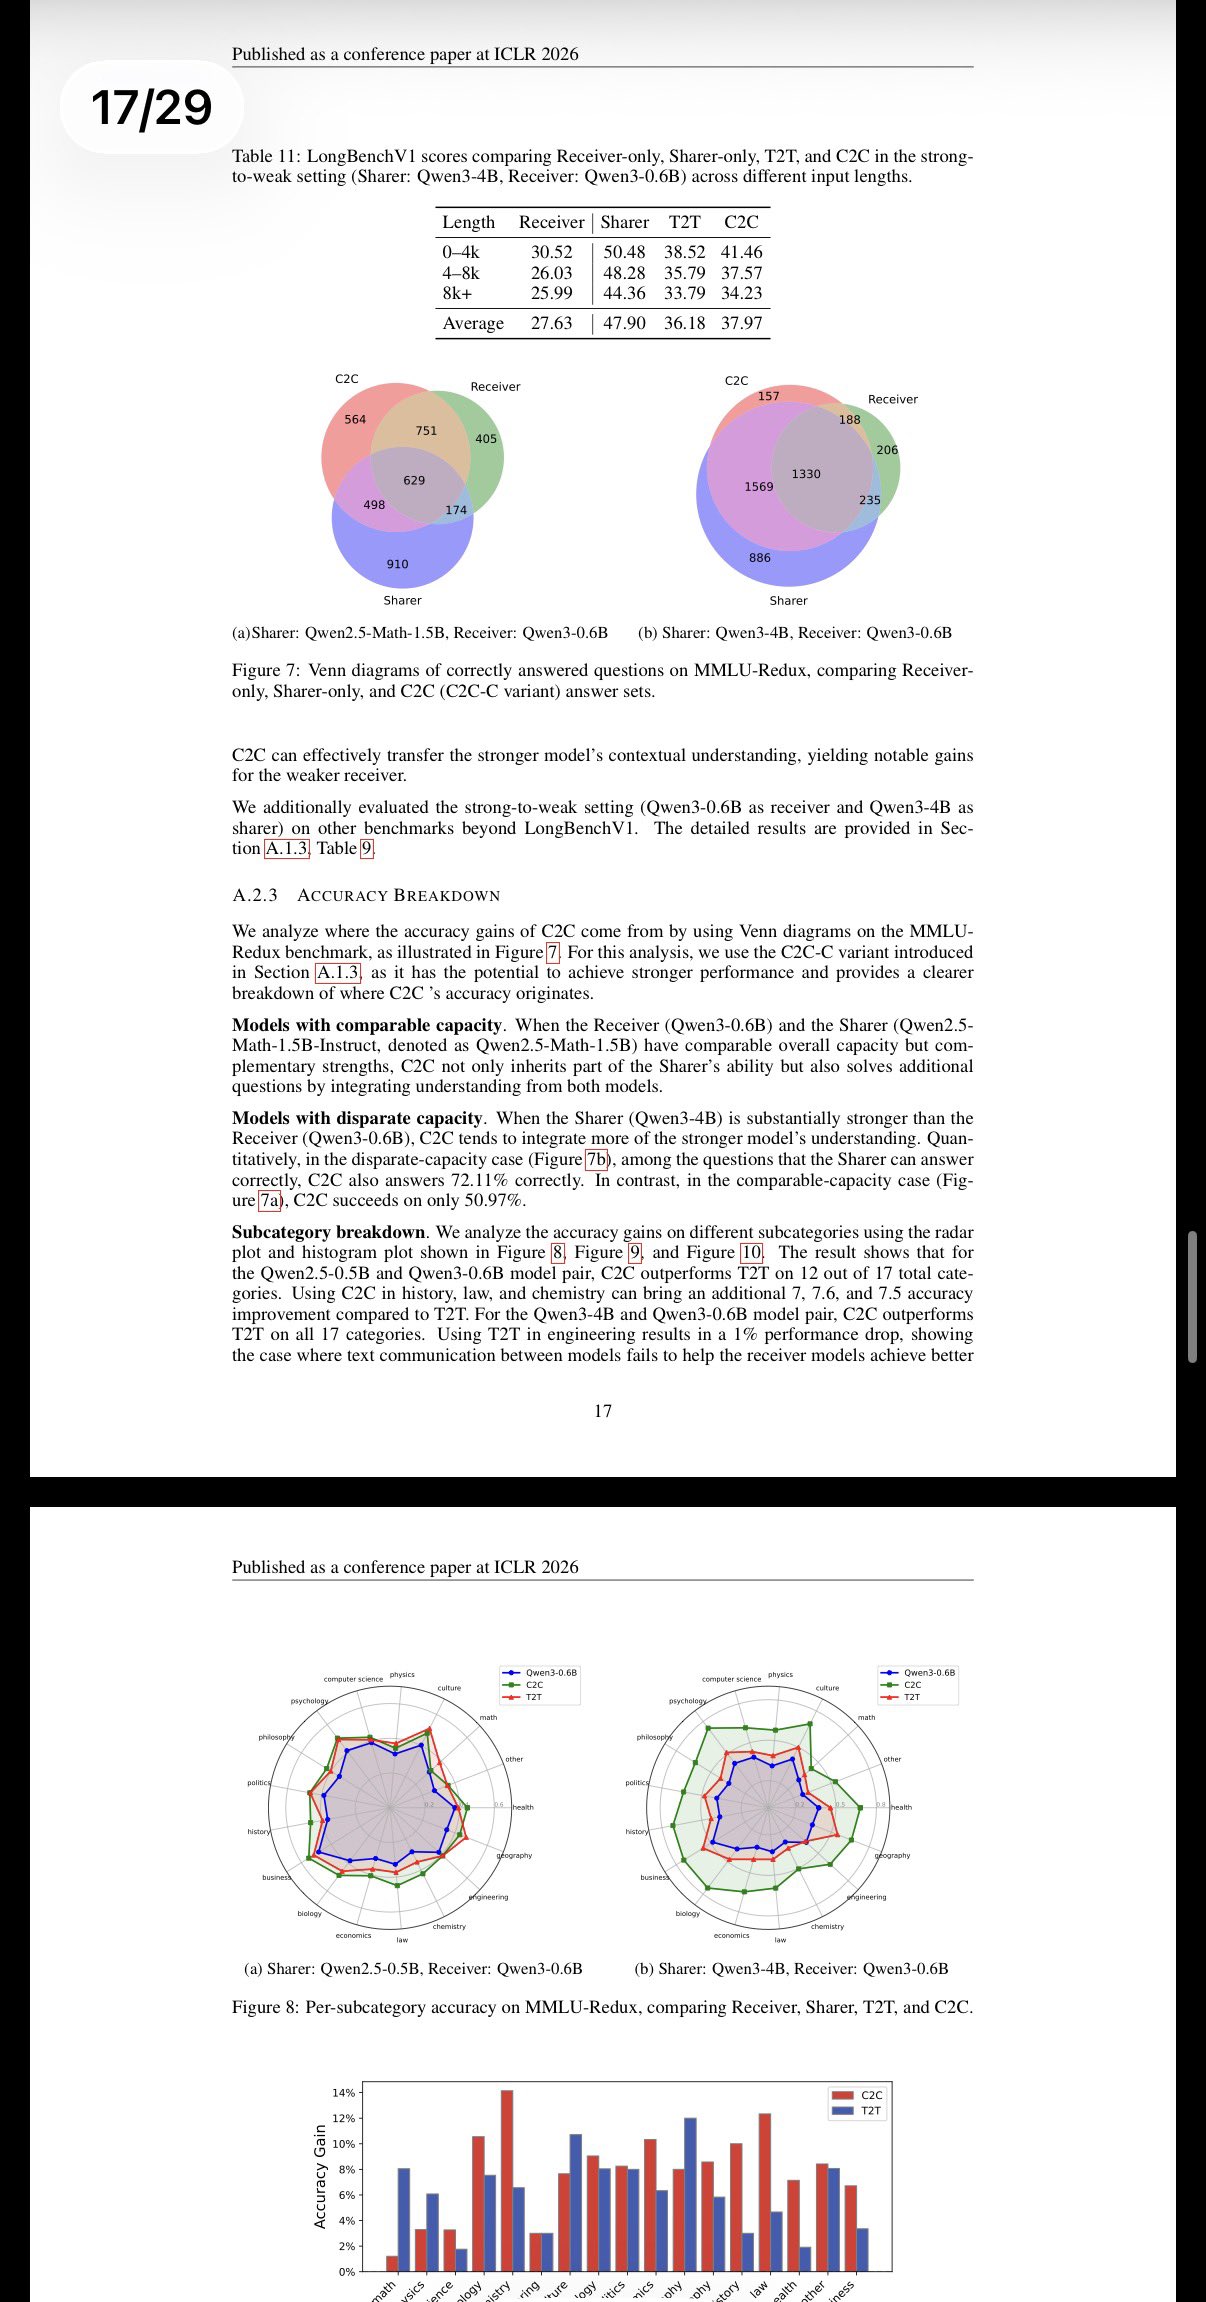
清华团队开源C2C技术:大模型缓存直连,绕过文字交流

清华大学联合无问芯穹、上海AI Lab发布C2C(Cache-to-Cache)技术论文(ICLR 2026),彻底改变多智能体系统通信范式。传统Multi-Agent协作中模型需将高维思考压缩为文本逐字解码再传递,造成延迟、语义丢失和高昂Token成本。C2C通过轻量级神经网络(Neural Fuser)将模型A的KV-Cache直接旋转对齐后融进模型B的KV-Cache,并引入可学习门控机制动态决定各层吸收外部缓存的程度。实测推理速度提升2.0-2.5倍,问答准确率较单模型提升14.2%,比文本通信的Agent团队高5%。代码与论文均已开源,未来有望大幅降低Mixture-of-Agents调用成本。

技术 › LLM AYi (@AYi_AInotes) 2026-09-194.3 KB 71

Jev 模型实测:新闻分类任务上的速度、质量与价格三赢

作者分享了使用新模型 Jev 对《人民日报》新闻进行湖北相关元素分类的实测体验。此前该项目一直使用 Gemini Flash Lite 系列,积累约 2.4 万条数据。通过 OpenRouter 上线 Jev 后用相同提示词对比测试:速度上单篇耗时从 3 秒降至 0.35 秒,提升近 10 倍;质量上与 Flash Lite 仅 15% 判断不一致,且差异多源于人名知识库差异,实际正确率约 95%;价格上处理 5 千条数据 30M Token 仅花费 1 美元。作者认为 Jev 代表的分类器大模型在分类场景下实现了速度/质量/价格的不可能三角,极具前景,并计划连夜用于优化生产项目。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-195.0 KB 75

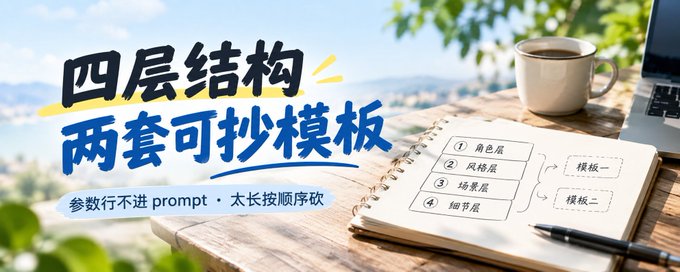
GPT Image 2.5 提示词模板:棚拍人像与户外自然光

文章分享了针对 GPT Image 2.5 的两套可直接使用的人像生成提示词模板:单灯棚拍人像与户外自然光。作者提出提示词应遵循官方四段结构(场景、主体、细节、约束),强调模型听得懂的是具体信息而非情绪词。文中给出通用五层骨架、参数配置,以及提示词过长时的删减顺序——先砍细节色彩,最后才动光线和取景。还解析了模板中关键句子的作用,如光斑不打进眼睛、暗部反光补偿等,帮助用户写出可控、稳定的图像生成提示词。

技术 › LLM 小海豚笔记 (gaoren7716) 2026-09-196.4 KB 2.6K 41 84

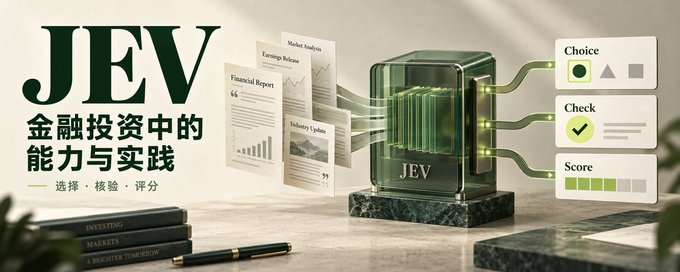
Jev 在金融投资场景中的能力及应用实践

作者围绕新模型 Jev 在金融投资领域的应用做了几千次真实 API 调用测试,估算模型费用约 0.05 美元。文章梳理了推特上多个热门应用案例:交易机器人、价格预测、SEC 公告筛选、期货短线交易、代币风险筛查等,并分析了各自优劣。作者认为 Jev 不适合生成完整研报,更适合作为核验检查步骤:区分预计收入与已实现收入、识别数据口径错误、去重消息、发现交易动作与用户意图冲突等。文章还介绍了 Jev 与主模型配合的流程设计、缓存与成本考量,给出了基于 TypeSafe Playground 的上手实验建议。作者用 104 条合成样本测试,99 条符合预设,提醒速度可试研究辅助但不能承诺交易执行,最后透露正在开发期权策略选择器。

技术 › LLM Z ZW 2026-09-1910.5 KB 81

一文解密 Jev:一个不聊天的模型,为什么突然火了?

TypeSafe AI 于2026年9月发布的 Jev 是一个不做对话和内容生成的专用判断模型,主打低成本、高速度地解决软件中的小型理解判断任务,如工单分类、优先级评分和概率判断,提供 Choice、Score、Noul 三种能力。其极低价格(每百万输入token 0.042美元)和 Vercel、Netlify 的快速接入引发开发者关注。文章分析了其'零幻觉'宣传的真实含义、评测数字的适用边界,并指出 Jev 的价值在于与生成式模型、程序和人分工协作,让软件能以低成本读懂小问题。

技术 › LLM Ray Wang 2026-09-1913.2 KB 19.4K 96 78

火爆全网的Jev到底是什么?

文章介绍了旧金山创业公司 TypeSafe 推出的闭源基础模型 Jev。它不做文本生成,只做判断题、选择题和打分题,输出严格限定在预设选项内,可在约100毫秒内出结果,成本极低。其核心技术是通过 RLCD 强化学习实现概率校准,类似于卡尼曼所说的 System 1 快思考,与传统大模型的慢思考互补。文章展示了社区应用案例,如浏览器 Agent、游戏实时决策、LangChain 工具路由、AI 输出审核等,也指出其在数数、算数、多跳推理和中文上的短板及提示词注入风险,认为 AI 调用正在走向分层架构。

技术 › LLM 泊舟 2026-09-1913.9 KB 134.9K 549 80

Will TypeSafe's Jev change how we build AI applications?

文章分析了 TypeSafe 发布的新模型 Jev——一种只能做分类、评分和路由决策、不能生成文本的'System One'模型。Jev 比通用 LLM 快 40-200 倍、便宜 40-400 倍,通过 RLCD 训练方法实现零样本概率判断。早期独立测试显示其准确率接近 GPT-5.6 等大模型,垃圾邮件分类甚至可媲美有标注训练的分类器。代价是失去了解释能力,无法说明判断理由。作者认为这可能改变 AI 应用架构:用 Jev 做大规模廉价监控评估,用 LLM 判官处理少量样本以获取改进方向信号。

技术 › LLM Aparna Dhinakaran 2026-09-1912.8 KB 15.2K 202 78

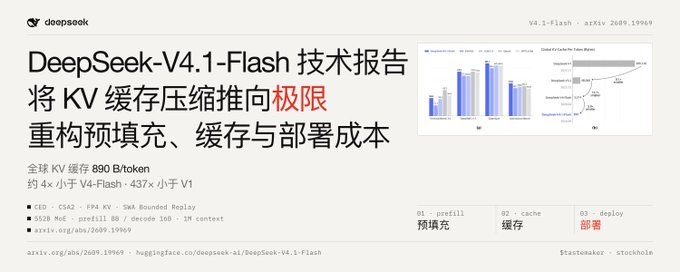
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

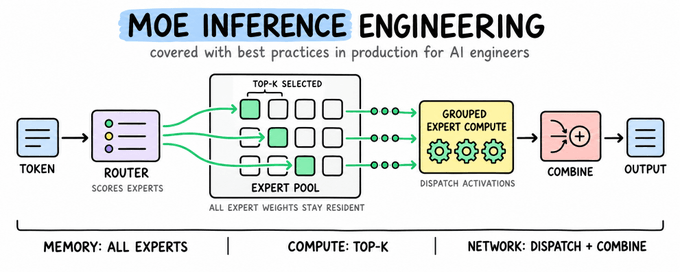
MoE 推理工程详解

本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

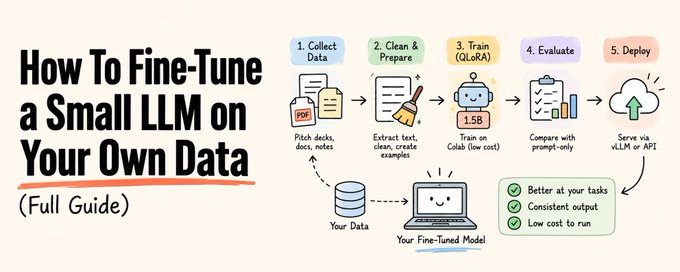
How To Fine-Tune a Small LLM on Your Own Data (Full Guide)

这是一篇关于微调小型LLM的完整实战指南。作者指出不需要70B大模型或昂贵算力,1.5B参数模型在200-500个优质样本上微调后,可在特定任务上超越通用提示的前沿模型。文章以商业融资文案生成为例,详细讲解了微调的实际目标、建立基线(纯提示、RAG、微调)的先后顺序,并分步骤介绍了小型基座模型选择(如Qwen2.5-1.5B)、数据权利合规、可复现数据下载、PDF文本提取与OCR、文本清洗、训练数据集构建、QLoRA训练、评估与部署,每一步均附完整代码。

技术 › LLM Rahul 2026-09-1926.1 KB 2.5M 2.7K 86

Jev Clearly Explained

文章介绍了 TypeSafe 于 2026 年 9 月发布的 Jev 模型——一个专注于快速、低成本语义决策的"系统一"模型。传统 LLM 在智能体循环中处理大量小型判断(如工单分类、命令风险评估)时逐 token 生成,速度慢且成本高。Jev 通过三种原语(Choice、Score、Noul)接受非结构化输入,返回带概率的类型化答案,端到端延迟 70-500 毫秒,输入价格仅为 LLM 的一小部分。文章分析了概率置信度在自动决策中的作用、RLCD 校准训练方法,并澄清"无法幻觉"的说法:Jev 不会打破输出 schema,但仍可能自信地选错选项,适合与 LLM 配合而非替代。

技术 › LLM Akshay 2026-09-1916.0 KB 2.4M 5.6K 79

WTF Is Jev? 9 Things People Are Already Building With It

Jev 是由 ChatGPT 联合创造者、RLHF 联合发明人 Diogo Almeida 在隐身两年后推出的决策型 AI 模型。它不做对话生成,而是为软件提供快速决策:选择题、评分、是/否判断,号称比前沿 LLM 快约 200 倍、便宜 400 倍,响应仅需几十毫秒。文章盘点了社区基于 Jev 构建的 9 个实际应用,包括 7 秒找机票的浏览器代理、上下文即时压缩工具、编码代理安全审查器、模型路由中间件等。其命名源自 19 世纪经济学家 Jevons,暗喻资源越便宜消耗越多的悖论。

技术 › LLM Matt Van Horn 2026-09-1827.1 KB 308.2K 1.3K 86

新决策模型 Jev 深度剖析

文章深度剖析了 TypeSafe 发布的新决策模型 Jev。与 LLM 不同,Jev 不生成文本,而是输出程序可读的决策 JSON,剥离语言能力,专注做软件中的小判断(分类、布尔判断、打分)。开发者通过传入 state 和 questions 进行调用,模型基于 RLCD 训练方法实现概率校准。相比 LLM,Jev 在演示中快 75 倍、便宜 171 倍,且因输出受类型约束可减少幻觉,但仍可能选错。文章介绍了客服、发票、安全告警等场景评测及 Doom 游戏演示,并建议从工单分类等边界清晰的任务开始试用,逐步开放自动处理。

技术 › LLM Skyhigh Feng 2026-09-187.8 KB 11.8K 51 80

这个只会做选择题的Jev,却是今年我看到的最特别的大模型

TypeSafe AI推出的新模型Jev只做高频决策判断,不能聊天或写代码,是一个通用分类器。它由前OpenAI创始人Diogo Almeida打造,采用自研RLCD训练方法(面向校准决策的强化学习),响应仅需380毫秒,速度快20-200倍,成本低40-400倍。文章通过浏览器插件过滤X内容、玩马里奥、操控浏览器等案例展示其能力,并在预筛任务中与GLM、DeepSeek、Qwen对比,Jev在并行判断任务上综合表现最优。其名源自杰文斯悖论,寓意智能判断将因便宜而被大量使用,可能代表Agent时代的重要新方向。

技术 › LLM 数字生命卡兹克 2026-09-1812.4 KB 86.8K 457 80

重读《蒸汽、钢铁与无限心智》:AI是组织的钢铁

作者重读Notion创始人Ivan Zhao被读600万次的名文《蒸汽、钢铁与无限心智》,梳理其核心观点:每个时代由'奇迹材料'塑造,钢铁造就镀金时代,而AI正以'无限心智'形态到来。文章评价:个人层面,10倍工程师通过指挥多个AI智能体成为30-40倍工程师,但'无限心智'受限于人类有限的验证注意力;组织层面,AI如同组织的钢铁,能极大提升效率,但我们仍处于'替换水车'阶段,且概率性材料盖确定性高楼需更深地基;经济层面,知识经济将如城市从佛罗伦萨演进为东京。作者同时警示:脱离一线的监督者会失去质量手感,年轻人的手艺底子可能变空。

技术 › LLM weiguo zhang 2026-09-186.2 KB 59