构建 7-Agent 软件工厂:Claude Code 高效开发指南
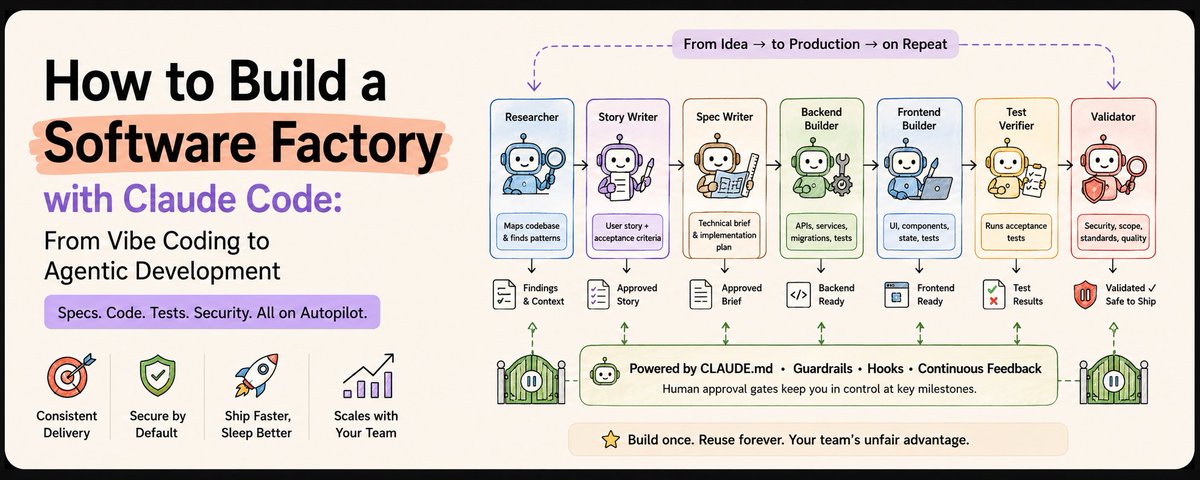
文章指出了当前 AI 辅助编程中“Vibe Coding”的痛点,即单一 AI 会话承担过多角色导致错误累积。作者提出了“软件工厂”的解决方案,通过构建包含代码库研究员、需求撰写者、规格撰写者、后端/前端构建者及测试验证者的 7 个专业化 Agent,将任务拆解并隔离。这种结构化流程利用 Claude Code 实现了自动化且高质量的功能交付,彻底改变了单人监督 AI 的低效模式。
文章指出了当前 AI 辅助编程中“Vibe Coding”的痛点,即单一 AI 会话承担过多角色导致错误累积。作者提出了“软件工厂”的解决方案,通过构建包含代码库研究员、需求撰写者、规格撰写者、后端/前端构建者及测试验证者的 7 个专业化 Agent,将任务拆解并隔离。这种结构化流程利用 Claude Code 实现了自动化且高质量的功能交付,彻底改变了单人监督 AI 的低效模式。
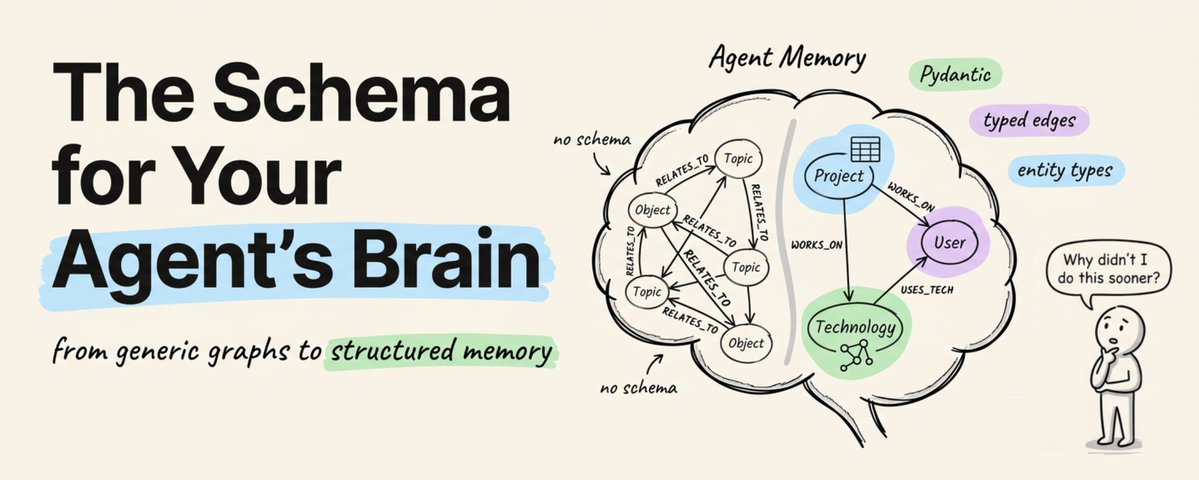
文章探讨了如何解决 AI Agent 记忆系统的多跳推理问题。传统的向量数据库在处理跨块事实连接时失效,而通用知识图谱常因缺乏结构导致查询噪音。作者提出的解决方案是使用 Pydantic 提前定义本体(Schema),明确实体类型、关系和属性。通过 Zep 框架强制执行这些约束,可以显著提升提取的准确性和数据的可查询性,从而实现有效的多跳推理。
GBrain 是 Y Combinator CEO Garry Tan 开源的个人知识管理系统。它突破了传统笔记工具的存取模式,通过集成知识图谱、混合搜索与 LLM 合成能力,实现跨文档的关联理解与自动回答。系统采用 Markdown+Git 存储数据,支持 MCP 集成及 43 种预置技能,目前已在 14 万页规模的生产环境中得到验证。
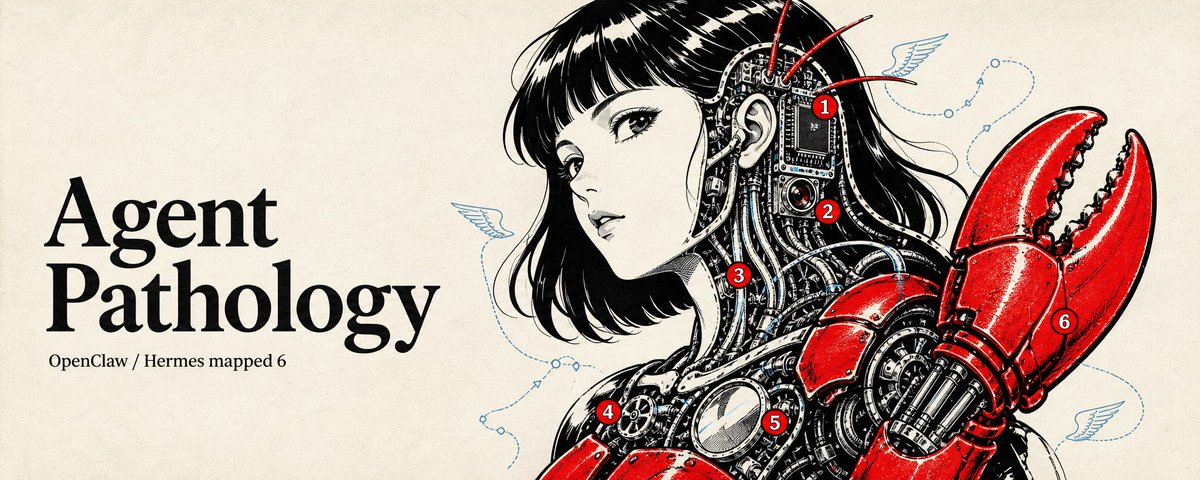
文章提出了一个新的视角来理解和调试 AI Agent:将其错误类比为人类神经系统疾病。作者指出,所谓的“AI 幻觉”在医学上更接近于“虚构症”。文章详细列举了 Agent 运行时中的六种病症,包括“遗忘症”、“幻肢状态”等,并针对每种症状提供了具体的诊断工具(如 gbrain, Mem0)和解决方案,强调通过检查“器官”(记忆、环境、工具链)来优化 Agent 性能。
文章提出了一个基于项目的 2026 年 LLM 工程学习路线图。作者主张通过从零构建系统来掌握技术栈,路径涵盖从基础的 Tokenizer、Embedding、Positional Encoding、Attention 机制,到 Transformer 模块构建、训练循环、KV Cache、MoE、量化、服务部署、RAG 及 Agent 等高级系统。该指南强调“实现、绘制、破坏、解释”的学习闭环,旨在帮助读者深入理解大模型原理并具备工程构建能力。
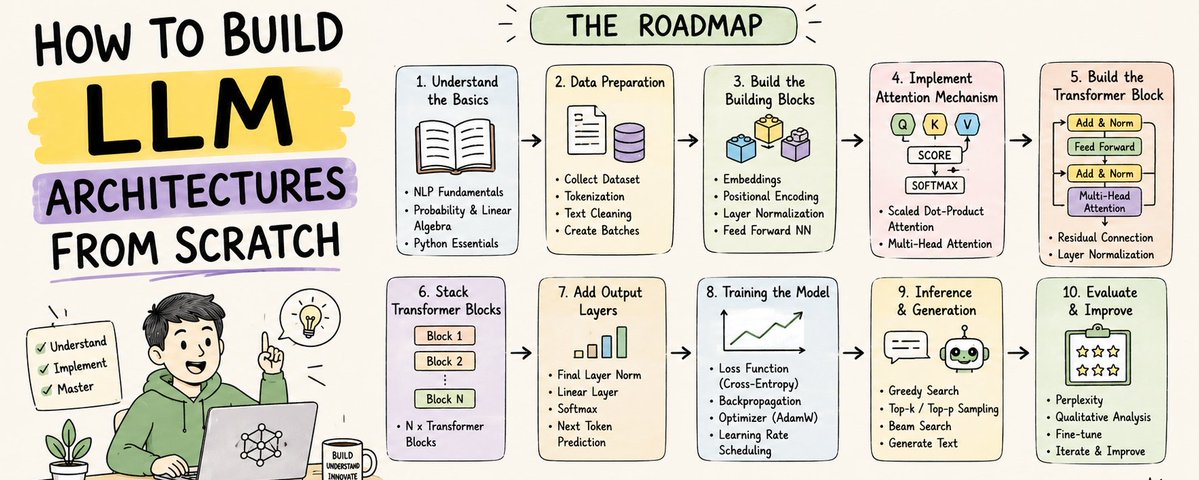
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
本文探讨了Agent项目难以落地的核心原因。作者指出,许多团队忽视了模型与应用之间的基础设施层——Agent Harness。文章通过生理学类比和工程细节分析,阐述了为什么仅靠LLM无法构建高效Agent,并预测AI行业将分化为模型层、Harness平台层和Agent应用层,建议业务团队应专注于业务逻辑而非底层基础设施。
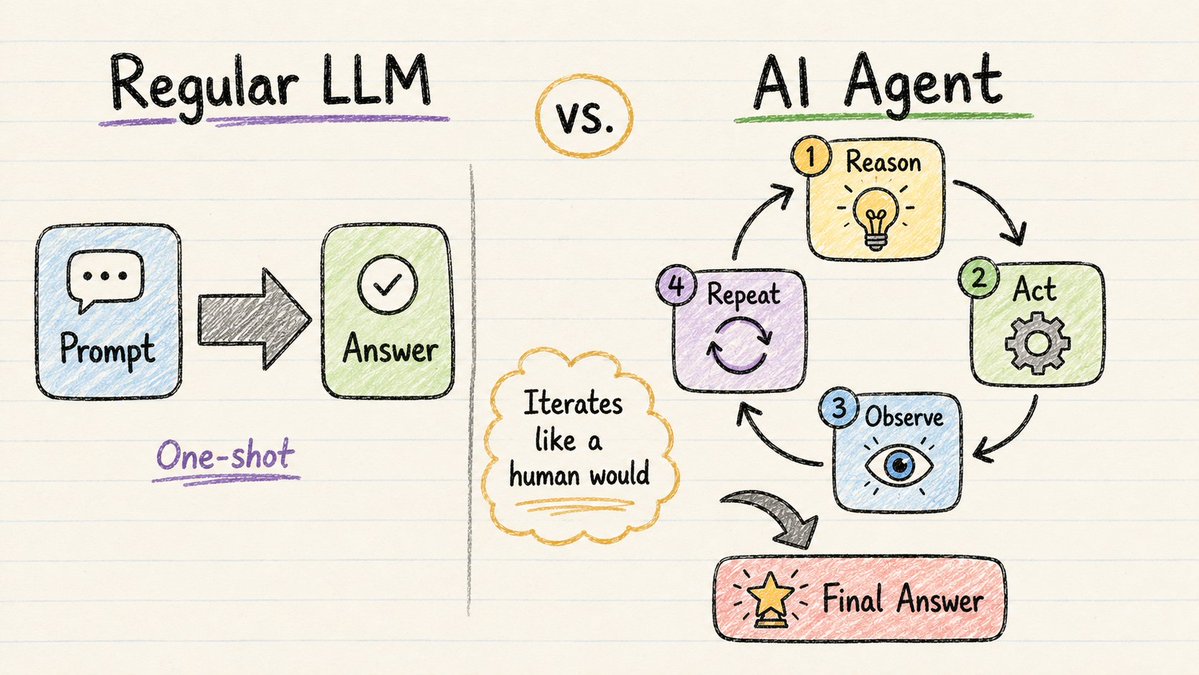
本文是一份关于 AI 智能体的综合指南,涵盖了从基础概念到生产级系统构建的全过程。文章深入解析了 Agent 的核心工作原理,如 ReAct 循环、任务拆解和上下文工程。同时,针对中级开发者,详细介绍了多代理系统的评估体系、记忆与知识管理、安全护栏设计以及四种核心设计模式,旨在帮助读者构建可靠且高效的 AI 应用。
本文深入探讨了当前 AI 行业被忽视的“痛点”:AI 缺乏长期记忆。作者认为,比单纯追求更聪明的大模型或自主 Agent 更重要的是构建“持久认知层”。文章以 GBrain 为例,阐述了它如何超越传统的检索生成(RAG),通过自建知识图谱和“梦境周期”维护,实现对信息的真正理解与关系连接。这种能积累上下文、提供确定性智能的“记忆基础设施”,将成为未来 AI 的真正护城河。
文章介绍了 Codex 新上线的 Goal 模式,通过明确目标、验收标准和边界条件,使 AI 能像“牛马”一样持续执行复杂任务,解决了传统模式下需人工频繁干预的痛点,并提供了 Prompt 编写技巧与原理解析。
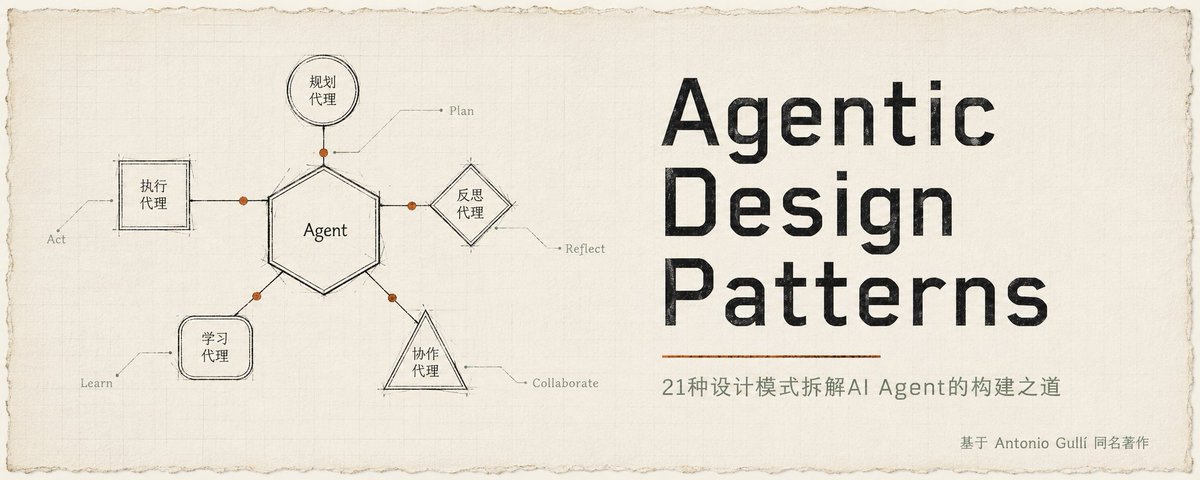
本文是 Antonio Gullí 所著《Agentic Design Patterns》的读书笔记。作者不仅梳理了 AI Agent 从 Level 0(裸 LLM)到 Level 3(多 Agent 协作)的四个等级,还深入解读了 Context Engineering、Reflection(反思)、Memory 分层等核心设计模式。文章指出,大多数人在开发 Agent 时忽视了上下文工程和自我反思机制,并建议开发者先优化单 Agent(Level 2),再考虑多 Agent 协作。
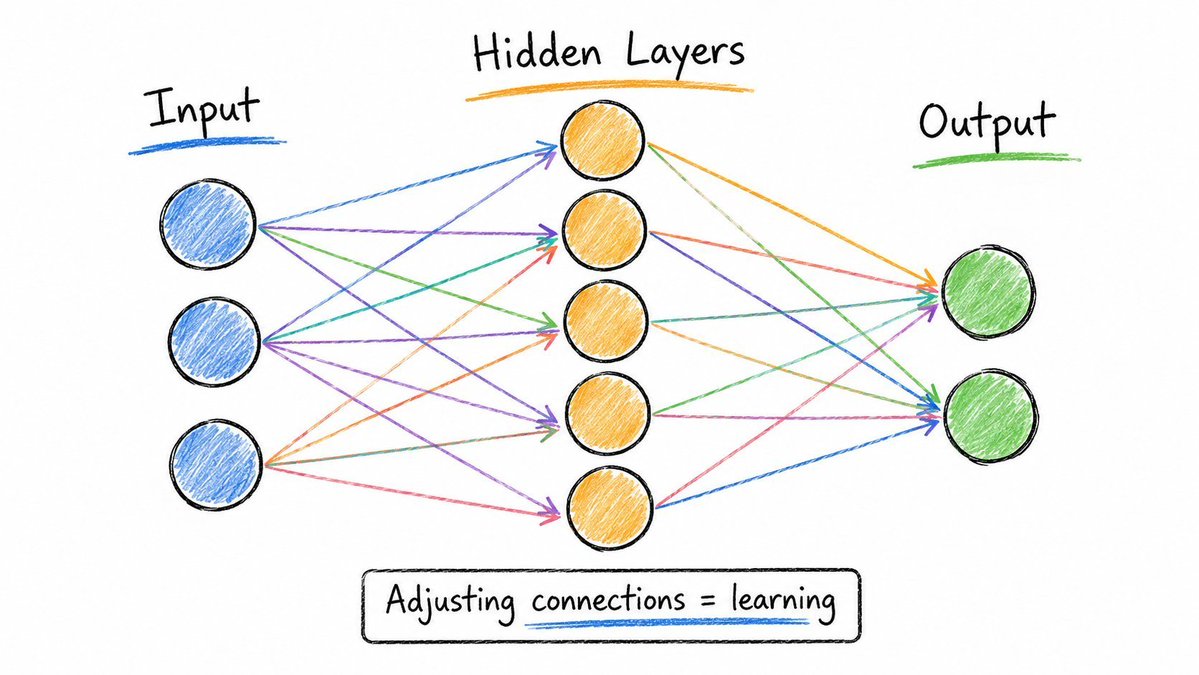
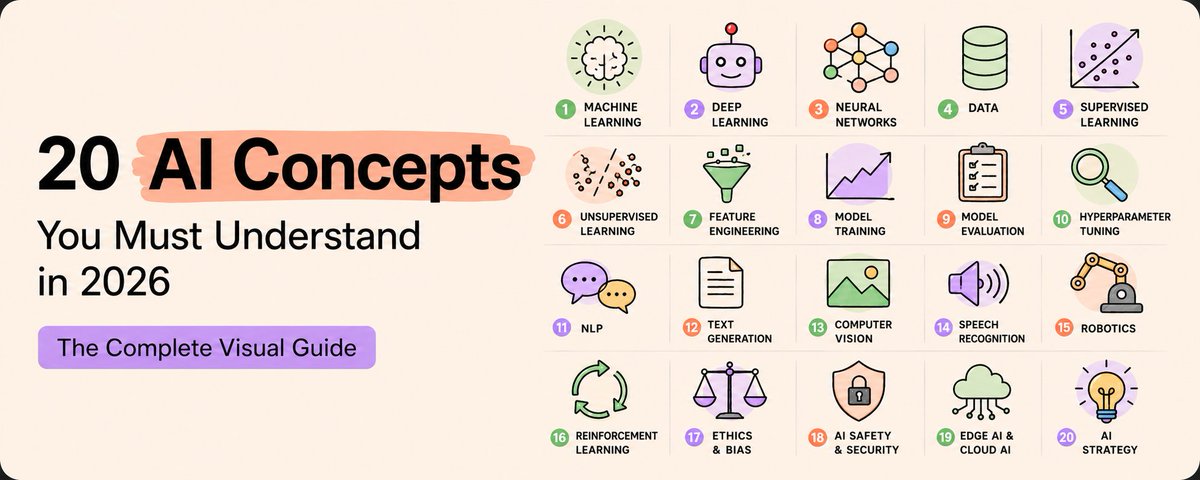
本文翻译整理了一组在 X 上广为流传的 AI 科普手绘图,涵盖从神经网络、Transformer 架构到大语言模型(LLM)的 20 个核心概念。作者不仅解释了 AI 底层运作原理(如分词、注意力机制),还介绍了模型优化手段(如微调、RLHF)及前沿应用架构(如 RAG、Agent、思维链),是一份简洁全面的 AI 技术入门指南。
本文介绍了 holon v0.14.1 版本的更新,重点在于使用 Rust 进行了底层重写,并实现了项目的自举开发(即 Agent 自主完成从需求分析到代码合并的全流程)。文章详细阐述了采用 Rust 重写的原因、关键架构设计(如单 Session 模式、Workitem 机制和事件驱动),并展示了实际的 Dev 工作流及与竞品模型的对比测试数据。
本文深入分析了 DeepSeek 如何通过 MLA、MoE、mHC 等一系列底层技术创新,极大幅度降低大模型对 HBM(高带宽内存)和先进 GPU 制程的依赖。文章指出,DeepSeek 的战略并非局限于软件订阅,而是旨在通过算法优化盘活中国产能充足的 NAND 闪存和 LPDDR 产业,以此构建一套独立于西方之外的 AI 硬件生态,最终撬动价值 10 万亿美元的产业巨兽。
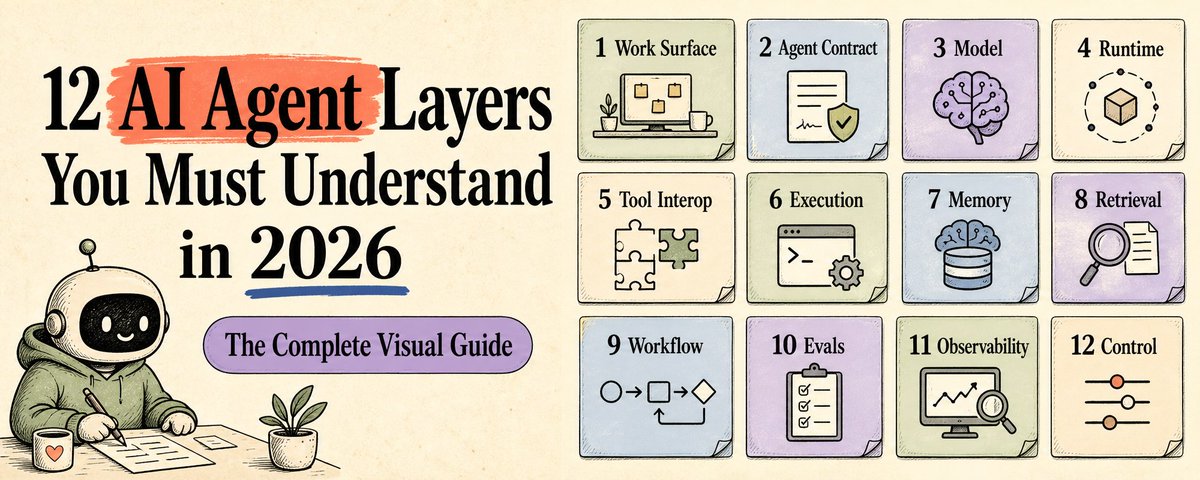
文章提出了AI智能体的12层架构模型,旨在帮助用户理解AI工具的工作原理及失效原因。内容分为三部分:基础层(工作界面、智能体合约/规范、模型)、运行层(运行时状态、工具互操作性、执行表面)以及记忆与知识层。文章强调,只有理解了这些层级(如MCP协议、Agent间协作、多级记忆系统等),才能解决AI输出不稳定、工具选择困难及信任缺失等问题,从而将AI从演示带入实际工作流。
本文详细介绍了 Hermes Agent 的记忆系统架构。作者指出,记忆是 Agent 区别于普通 Chatbot 的核心。Hermes 的记忆栈分为三层:开箱即用的原生层(包含本地数据库和两个 Markdown 文件)、可选的官方插件提供商层、以及社区构建的扩展层。文章深入解析了内存文件的运作机制,如字符上限、自动合并的误区以及 Agent 如何自主管理记忆。
文章分析了 GitHub CLI (gh) 的设计理念,探讨如何构建对 AI Agent 友好的命令行工具。核心观点包括:使用 Resource 层(路径+HTTP方法)解决命令爆炸问题,保留 Command 层处理无法资源化的意图(如 login);利用 --jq 精确裁剪输出以减少 Token 浪费和语义污染;以及在默认输出中采用自然语言而非 JSON,以提升 LLM 的理解效率。
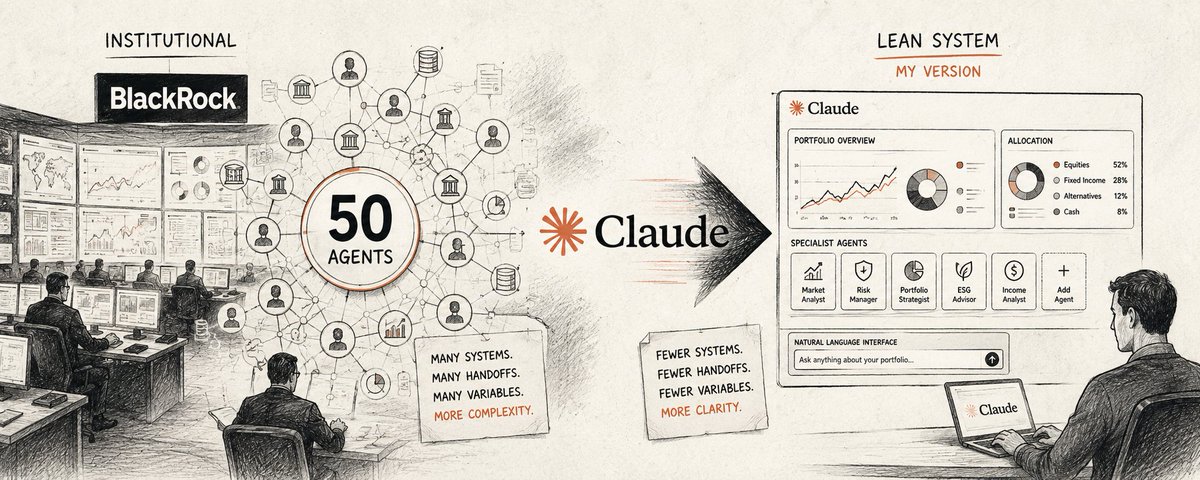
文章介绍了基于贝莱德前高管 Andrew Ang 的论文,作者利用 Claude AI 构建了一个简化版的多智能体投资系统。原系统通过 50 个智能体分五层协作,涵盖宏观分析、资产估值、组合构建及同行评审。作者提取了核心逻辑,构建了包含宏观、资产分析和对抗性挑战者的三智能体版本。测试显示,该架构能有效消除人类偏差,在保持收益的同时显著降低回撤风险。
文章通俗易懂地解释了现代AI的基础原理,涵盖神经网络、Token化、Embeddings、注意力机制及Transformers架构。深入探讨了LLM的工作原理,如上下文窗口、温度控制和幻觉问题,并讲解了提示词工程技巧。
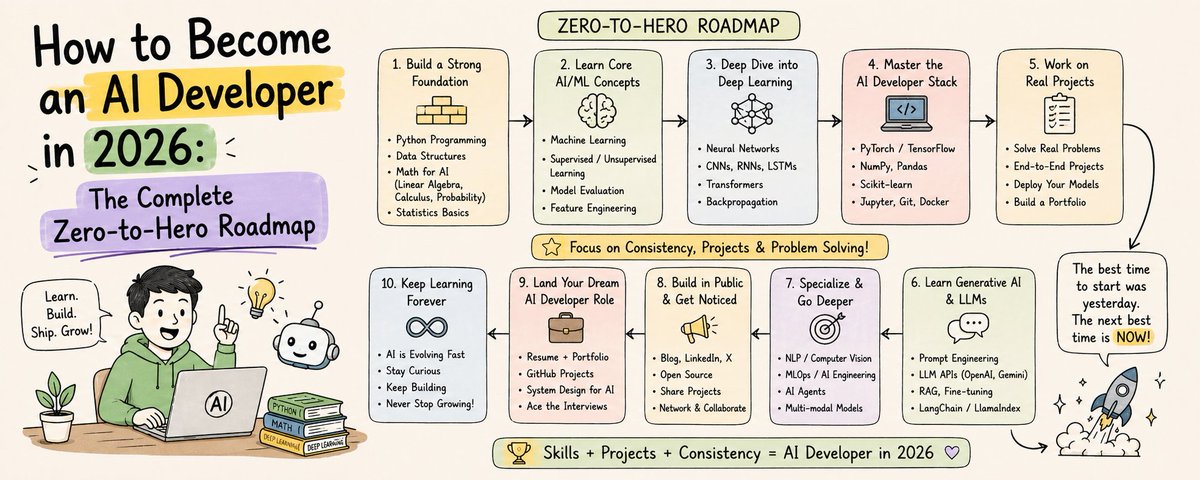
这是一份针对2026年AI开发者的完整学习指南。文章指出,成为AI开发者不再需要计算机学位,通过正确的路线图,个人即可构建AI应用和SaaS产品。指南分为十个阶段:首先理解AI生态系统的基本概念(AI、ML、LLM、Agent等);接着掌握Python基础、API调用及Git工具;然后通过现有AI工具(如OpenAI API、LangChain)快速动手实践;最后深入学习前端技术、提示工程、LLM原理(RAG、微调)及应用部署。文章强调“学习-构建-分享”的循环策略,并指出AI智能体、自动化及RAG系统是当前的高价值技能。
这是一份关于大语言模型(LLM)的实践指南。文章从基础循环机制出发,详细解释了文本如何转化为 Token,以及 Transformer、注意力机制、KV Cache 和 RoPE 等核心概念的工作原理。作者强调理解模型内部的推理机制(如 Prefill 和 Decode 阶段)对于硬件选型、显存估算和本地部署的重要性。文章涵盖了 Token 化、上下文窗口、量化、模型服务及本地 AI 硬件数学计算等关键主题,旨在为深入理解 LLM 提供直观的基础。
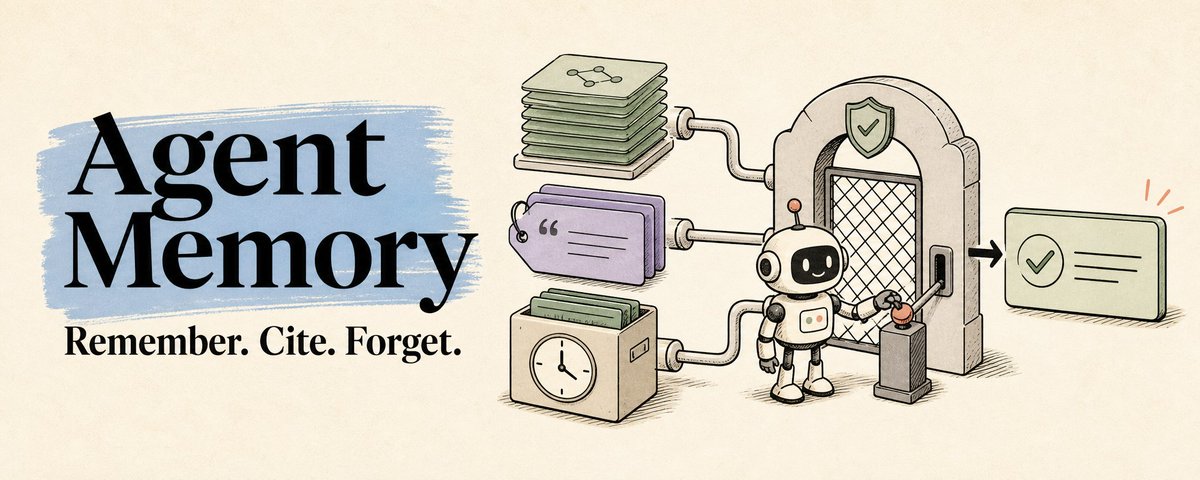
本文提出了一个智能体记忆系统的可靠框架,该框架需同时完成三个核心任务:记住该记的、引用可信的、遗忘过期的。文章详细介绍了记忆的六个层级(如会话状态、项目记忆、索引检索等),阐述了如何通过权威排序解决冲突,并强调了通过硬过期、双时序或软衰减等机制让旧记忆失效的重要性。
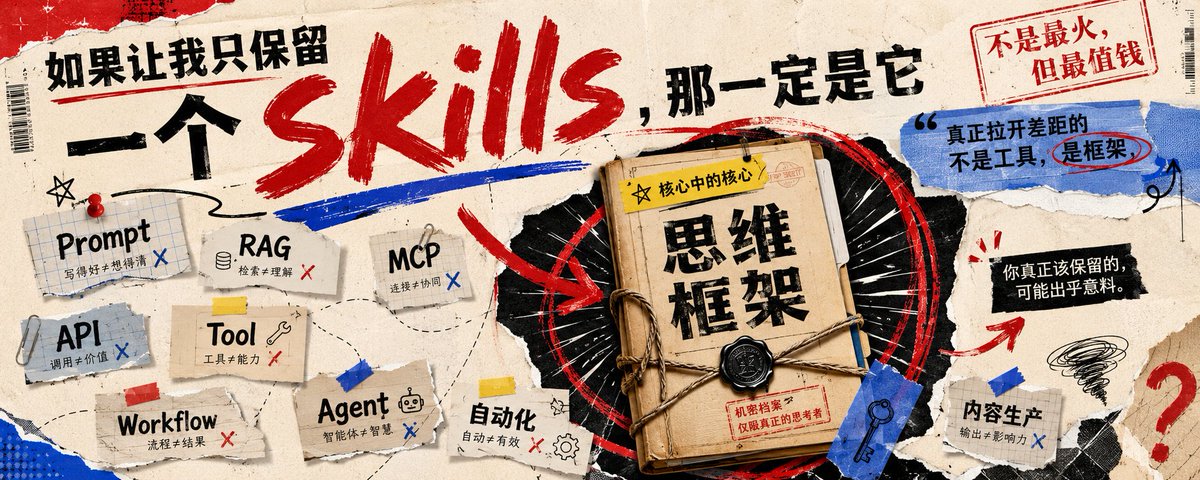
文章介绍了 Claude Code 的开源技能库 Superpowers,它如同 AI 的导航系统,通过头脑风暴、计划拆解、子代理驱动开发和测试驱动四大核心工作流,自动引导用户从构思到上线。该系统有效降低了认知负荷,并通过严格的审查机制确保代码质量,是提升企业 AI 交付效率的利器。
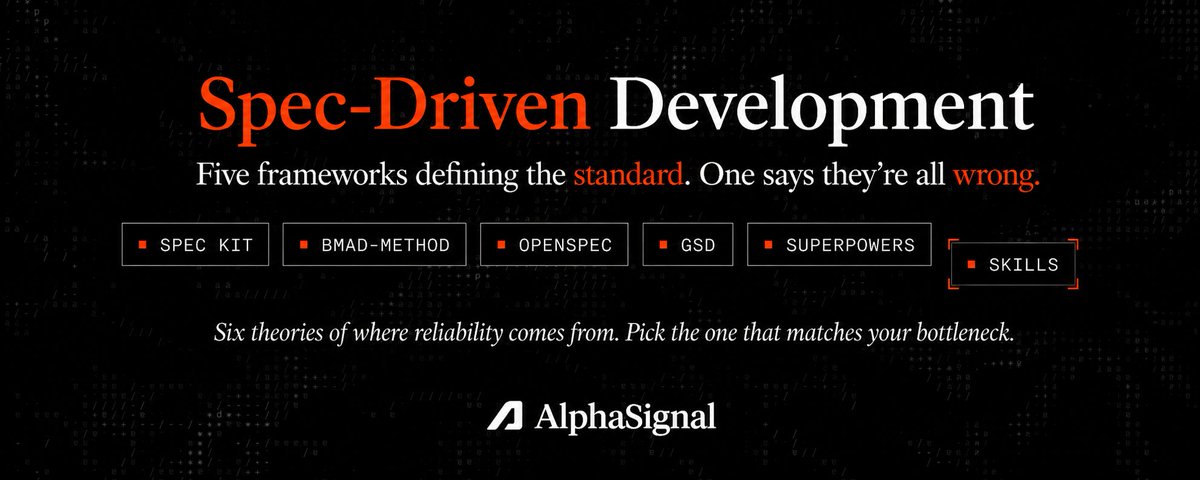
本文探讨了规范驱动开发在过去 12 个月如何成为 AI 编程的默认架构。文章结合 Thoughtworks、GitHub 和 Amazon 等行业巨头的实践,以及多篇学术论文的数据,分析了为何 SDD 是解决 AI 编程带来的“生产力悖论”和系统级稳定性下降的必要手段。文章详细对比了 Spec Kit、BMAD-METHOD 等五大主流 SDD 仓库的实现哲学与治理机制。
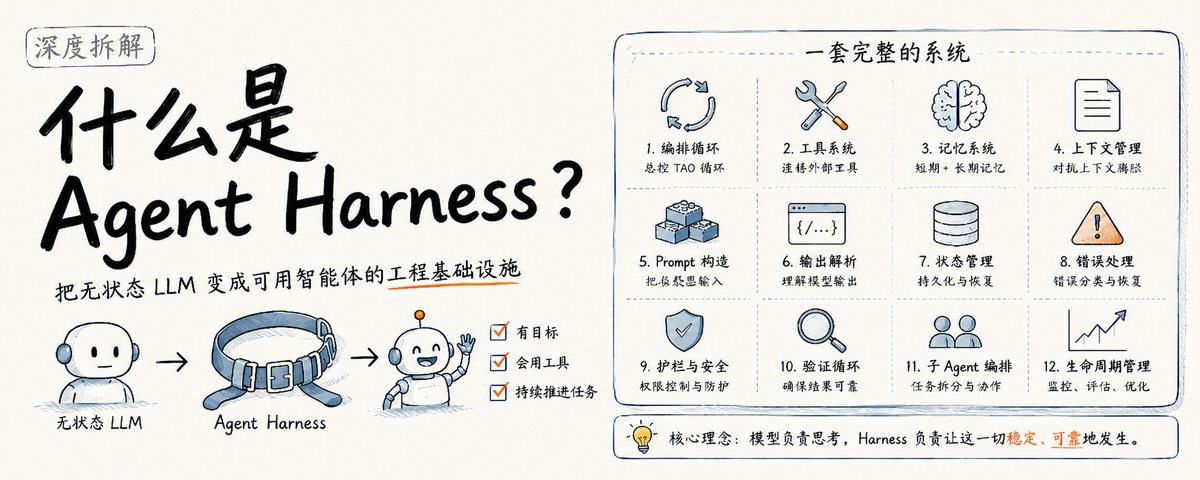
本文深入探讨了 Agent Harness 的概念,即包裹在 LLM 外部、将无状态模型转化为可用智能体的完整软件基础设施。文章引用了 Anthropic、OpenAI 和 LangChain 的实践,详细拆解了生产级 Harness 的 12 个核心组件(如编排循环、记忆系统、上下文管理、验证循环等),并阐述了如何通过优化这层“操作系统”来解决遗忘、工具调用失败和上下文腐烂等工程难题。
本文通过拆解100条AI爆款内容,指出内容的传播核心并非复杂的技术展示,而是情绪的触发。作者分析了视觉震撼、情绪共鸣、身份认同等六大爆款类型,强调AI只是外壳,好奇心、焦虑、共鸣等情绪才是传播的发动机。普通人做内容应先确定情绪钩子,再寻找技术实现。
本文介绍了如何利用 Fireworks Agent 实现 LLM 微调(SFT)的全自动化。文章以 Andrej Karpathy 的“个人 LLM Wiki”理念为引,阐述了将知识注入模型权重比单纯依赖上下文窗口更高效。通过 Fireworks Agent,作者展示了从数据集检查、超参数搜索、模型训练到部署推理的完整闭环,无需人工干预繁琐步骤,仅需少量 GPU 时间和极低成本,即可训练出具有特定输出风格(如 Wiki 摘要风格)的模型,为构建自我进化的 Agent 铺平了道路。
文章阐述了选择 LLM 推理引擎的正确逻辑:先确定硬件策略、负载形态和服务模式,再选引擎。文章解析了推理引擎的核心功能(调度、内存管理、批处理)及性能瓶颈(显存带宽、KV Cache、互联),并详细对比了 llama.cpp、MLX、ExLlama、vLLM、TensorRT-LLM 等主流引擎的适用场景与优缺点。
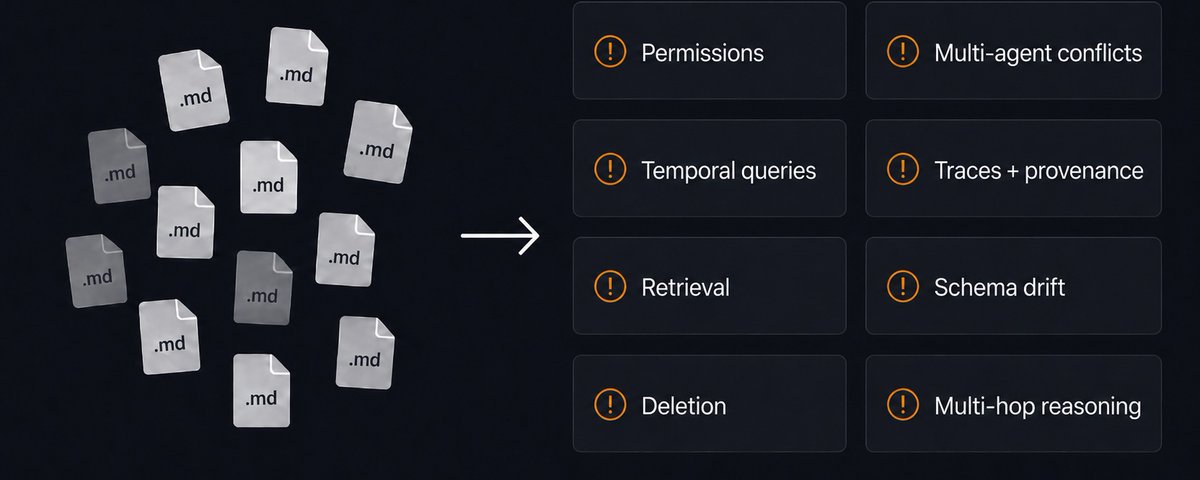
文章以一个垂直 Agent 创业公司因使用 Markdown 文件管理内存而导致架构崩溃的真实案例为引子,深入探讨了在构建生产级、多用户、多 Agent 系统时,简单文件存储无法解决的五大核心难题:细粒度权限控制、并发写入冲突、时态查询准确性、可追溯的自我改进机制,以及海量数据的检索效率。作者指出,虽然 MD 文件适合早期原型,但一旦系统规模扩大,开发者往往会不自觉地重新发明数据库,这实际上是倒退。
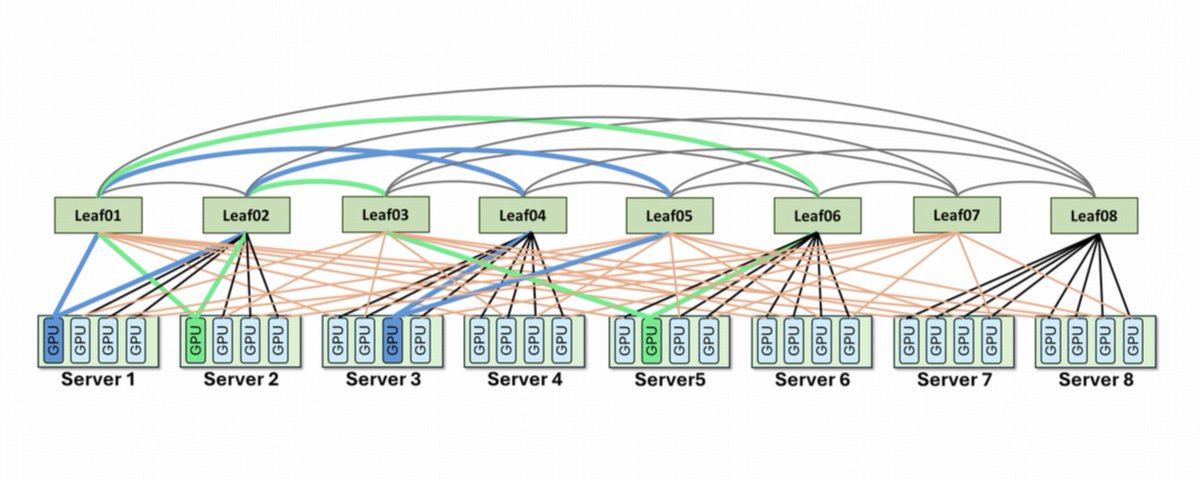
文章探讨了随着长上下文推理和 Prefill-Decode 解耦成为主流,网络如何成为 LLM 推理集群吞吐量和延迟的关键瓶颈。Z.ai、Harnets.AI 和清华大学联合开发了 ZCube 网络架构,通过扁平化拓扑和混合轨道设计,有效解决了传统 ROFT 架构下的流量负载不均衡问题。生产环境基准测试显示,ZCube 仅通过架构优化便实现了交换机成本降低 33%、吞吐量提升 15% 以及 TTFT 延迟降低 40.6% 的显著收益。