聊聊分镜这件事:4张图怎么变成一段故事
文章探讨了AI视频创作中常见的“PPT感”问题,指出核心在于缺乏分镜思维而非图片质量。作者提出了适合AI创作者的导演视角,强调通过设计空间、主体、变化和结果来连接镜头。文中详细解析了景别的情绪功能、切镜的逻辑标准,并提供了一个实用的5镜头叙事结构,帮助创作者提升作品的连贯性与故事感。
文章探讨了AI视频创作中常见的“PPT感”问题,指出核心在于缺乏分镜思维而非图片质量。作者提出了适合AI创作者的导演视角,强调通过设计空间、主体、变化和结果来连接镜头。文中详细解析了景别的情绪功能、切镜的逻辑标准,并提供了一个实用的5镜头叙事结构,帮助创作者提升作品的连贯性与故事感。
本文详细介绍了针对开源大模型(如Gemma-4-31B)进行“越狱”的技术原理与实操流程。不同于闭源模型的提示词工程,开源模型越狱(Abliteration)通过修改权重直接抹除模型内部的“拒绝维度”。文章涵盖了从构建对比数据集、提取激活值、计算拒绝向量、权重正交化到最终验证的完整步骤,并指出了过度顺从等副作用及相关的法律伦理风险。
文章通过本地 Gemma4 实验发现大模型对话中存在 100 倍加速的现象,深入剖析了 Transformer 的 KV 缓存原理,并逆向分析了 Claude Code 的精密缓存工程。文章解释了为何连续对话比频繁开启新 Session 更省钱,指出破坏缓存的关键行为(如切换模型、修改 System Prompt),并提供了保护缓存以节省 80% Token 的具体使用姿势。
本文是一篇基于工程视角的AI技术硬核解析,旨在厘清从LLM大模型到Agent智能体的核心概念体系。文章深入浅出地拆解了LLM的文字接龙本质、Tokenizer的翻译机制、上下文窗口的容量限制,以及Prompt工程、MCP工具协议和Agent技能的运作原理,帮助读者建立完整的底层技术认知。
文章详细介绍了 Seedance 2.0 AI 视频生成工具的提示词编写技巧。该版本采用新的导演式提示词框架:主体+动作+镜头+风格+限制条件,支持多模态输入。文章通过电子游戏、动画、时尚、UGC、动态设计和商业广告六个具体案例,展示了如何精准控制镜头角度、灯光节奏和视觉风格,以生成高质量的AI视频内容。
文章深入分析了 Andrej Karpathy 提出的“LLM Knowledge Bases”概念。Karpathy 批评了当前 RAG 模式缺乏知识积累的痛点,提出由 LLM 维护的一组持久化 Markdown Wiki 作为替代方案。文章拆解了该方案的“原始资料、Wiki层、规则层”三层架构,以及“摄入、查询、健康检查”的操作模式。作者结合 EverMind Memory 的产品视角,探讨了这一模式从单次交互向积累能力转变的行业趋势,以及“Idea File”作为新知识传播单位的潜力。
本文是 OpenAI Codex 产品负责人 Alexander Embiricos 和开发者体验负责人 Romain Huet 的访谈实录。文章详细介绍了 Codex 团队如何利用 AI Agent 重构产品开发模式:规格文档仅 10 个要点、不做中期规划、PM 职能转变为“填空人”。文章还探讨了在模型能力快速迭代的背景下,如何通过“海盗船”式的敏捷团队运作,以及通过 Codex App 将开发者工具推向大众的趋势。
文章介绍了 Karpathy 提出的 LLM Wiki 方法,旨在解决传统 RAG 检索缺乏知识沉淀的问题。作者详细演示了如何在 Obsidian 中落地该方案,包括使用插件采集素材、配置图片本地化、利用图谱视图发现盲区、结合 Dataview 生成报表、使用 Marp 制作幻灯片,以及通过 Git 进行版本管理。核心思想是让 AI 承担繁琐的整理与维护工作,人类专注于思考与决策,从而构建持久增殖的个人知识库。
文章深入分析了 AI 算命赛道的商业潜力。通过国内外案例(如 Astrotalk、Moonly、测测 App)揭示了“咨询+复购+周边”的闭环模式。文章指出,AI 极大降低了供给成本,而焦虑带来了高复购率。作者总结了可视化产品、AI+真人混合服务、后端周边商品、出海溢价及 B 端工具五大异常值机会,并提供了八字命理提示词实战案例。
文章分析了多位美国 AI 领域高管对其子女未来职业发展的建议。共识在于:未来不是技能竞赛,而是判断层级竞赛。高管们普遍不押注“具体技能”(如编程、提示词工程),而强调“结构能力”,包括通识教育、元认知、适应力以及最重要的——承担责任。核心观点是 AI 无法承担责任,稀缺性将从“认知能力”转向“信任能力”,未来的关键在于建立世界模型、提高判断密度并站在责任位置上。
文章由GitHub项目“同事.skill”切入,探讨了利用AI将离职同事的聊天记录和文档蒸馏成数字技能的赛博朋克现象。作者分析了其背后的技术架构(Work Skill与Persona双层设计),以及由此引发的职场焦虑。核心观点指出,重复性工作终将被自动化,但人的迭代能力和面对未知时的直觉无法被代码定义。作者主张“主动蒸馏自己”,将重复流程交给AI,从而让自己专注于创造与进化,在数字时代构建不可替代的护城河。
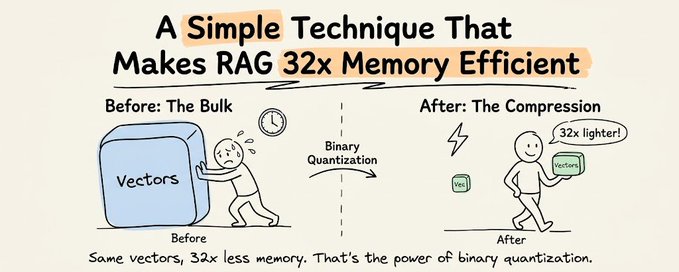
本文介绍了利用二进制量化技术将 RAG(检索增强生成)系统内存效率提高 32 倍的方法。作者以 Perplexity 和 Azure 为例,详细展示了如何使用 Llama Index、Milvus 向量数据库和 Groq 托管的 Kimi-K2 模型构建系统。该系统可在 30 毫秒内查询 3600 万个向量,并在 1 秒内生成响应。文章提供了从数据加载、生成二值嵌入、向量索引到检索生成的完整代码实现。
本文深入探讨了大模型训练的全链路流程,指出2026年模型效果的差距主要源于后训练阶段。文章从预训练底座、数据配方、系统架构约束、后训练(SFT/RLHF/DPO)以及 Eval/Reward 机制五个维度,解析了如何通过工程化手段提升模型实际落地效果,并引用了 DeepSeek、Llama 等实例。
Google 发布 Gemma4 系列开放权重模型,本文为本地部署选型指南。文章解析了 '-it' 指令微调版与基版的区别,以及 E4B/E2B 移动端优化技术(Per-Layer Embeddings)的原理。针对不同场景推荐模型:本地对话选 26B-A4B(MoE 激活 4B);写代码选 31B;语音助手选 E4B;树莓派尝鲜选 E2B。
文章指出AI输出质量差往往源于提示词编写不当,并总结了三大常见误区:信息缺失、格式空白和贪心过多。作者通过实战案例对比,详细讲解了如何通过明确角色、补充背景、量化目标、限制格式和反向约束来优化提示词,从而实现从“废话连篇”到“精准输出”的跨越,大幅提升使用效率。
本文通过100小时的内部观察,深入剖析了Moonshot AI(Kimi)独特的企业文化与生存状态。文章记录了公司如何在DeepSeek崛起的压力下调整战略,强调了“模型能力”至上的原则。作者揭示了该公司偏爱具有“概括能力”和“品味”的天才型员工,实行无KPI、无层级的扁平化管理,并详细描述了年轻员工在高强度跨领域工作中的成长与焦虑。这不仅是一家初创公司的生存侧写,也是对AI时代人才组织模式的深刻探讨。
本文探讨了在只有 12G 显存的消费级 GPU 上进行大语言模型(LLM)算法研究的可行路线。文章指出资源限制本身可以成为研究的起点,并重新定位了研究方向为对小模型的训练算法与适配方法做贡献。文章详细计算了 12G 显存的实际边界,提出了三条可行路线(训练算法优化、结构改动、RL/推理),并介绍了如何利用 HuggingFace 生态(包括官方 Model Trainer Skill)来搭建实验环境、选择模型以及设计严格的三层验证实验(机制验证、扩展验证、现实落地)。
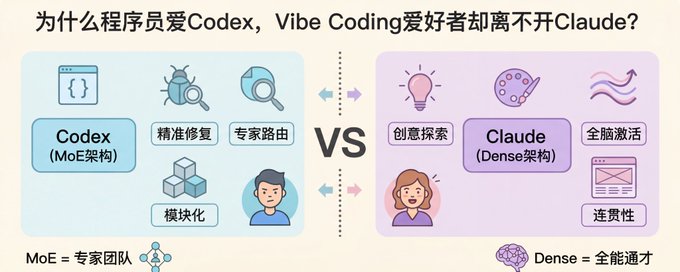
文章深入探讨了 AI 辅助编程领域中 Codex 与 Claude 的差异化定位。Codex 采用 MoE 架构,以模块化和高精准度成为传统程序员修复 Bug 和重构代码的利器;而 Claude 基于 Dense 架构,凭借全脑激活的细腻逻辑和对自然语言的深度理解,成为“Vibe Coding”用户进行创意原型开发的首选。文章最后建议在实际工作流中混合使用,取长补短。
文章整理了国内主流大模型平台的免费 API Token 渠道,包括智谱 AI、Moonshot、MiniMax、讯飞星火、腾讯云、阿里云百炼、硅基流动等。作者详细列出了各平台的新用户注册赠送额度、有效期内包含的模型种类(如 GLM、Kimi、DeepSeek 等),并针对开发者提供了接入 OpenClaw 等工具的建议。文末还提醒用户注意实名认证要求及额度有效期,避免超额扣费。
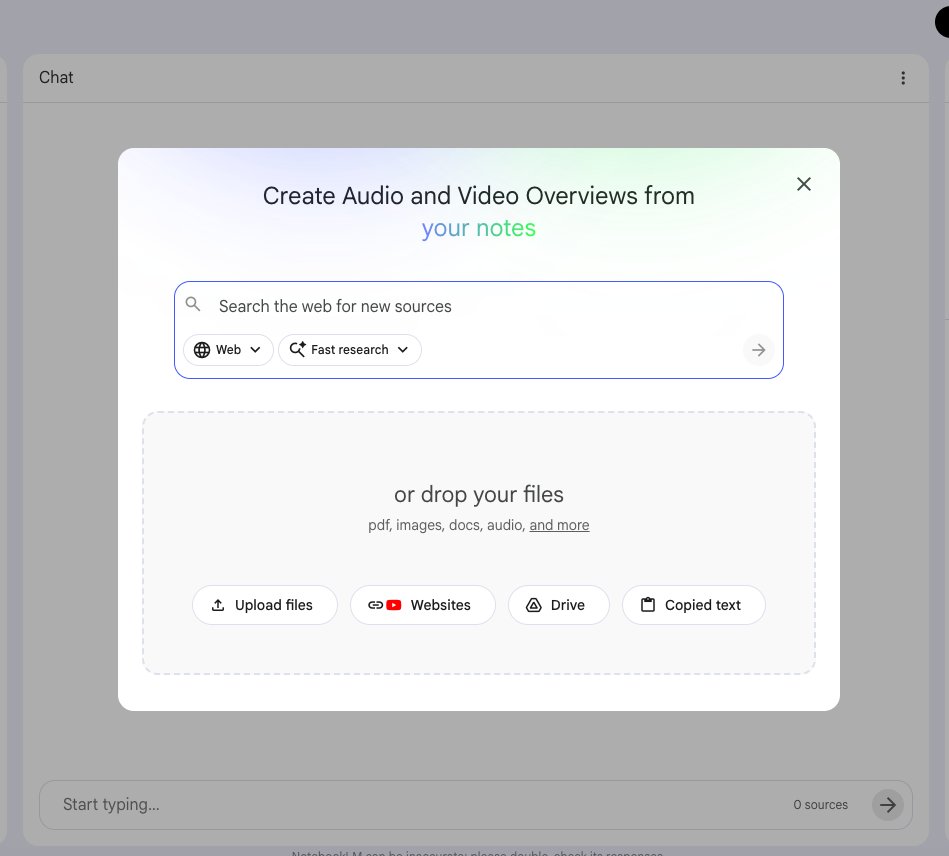
文章详细介绍了纽约大学、斯坦福等顶尖学府的教授如何利用Google NotebookLM完成从课程构建到学术研究的全流程革新。通过上传整个阅读清单、利用深度研究功能和音频生成,教授们将原本需要数周的课程准备和文献综述工作缩短至数小时。这一工具不仅极大提升了教学效率,也改变了学生的学习体验,被视为学术研究20年来最大的转变。
本文探讨了如何通过改进编排框架来解决 Claude 在长时间运行任务(如前端设计和全栈开发)中的局限性。作者受 GAN 启发,设计了包含规划器、生成器和评估器的多智能体架构。通过引入上下文重置机制、制定明确评分标准以及分离生成与评估环节,该框架成功实现了自主构建高质量全栈应用的能力,显著优于单智能体模式。
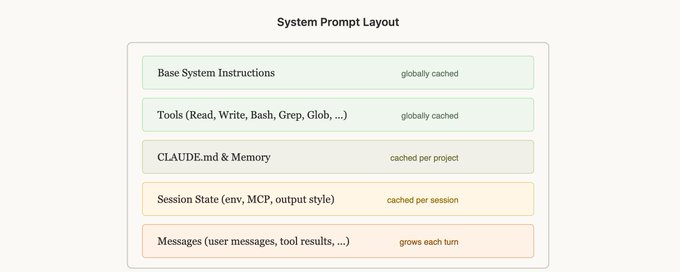
文章详细阐述了提示缓存在构建 Claude Code 等 AI 代理中的关键作用。核心经验包括:利用前缀匹配机制规划缓存、通过消息传递更新而非修改系统提示以保持缓存、避免中途切换模型或工具、以及利用“延迟加载”和“缓存安全分叉”等技术优化上下文管理。围绕缓存设计系统架构能显著降低延迟与成本。
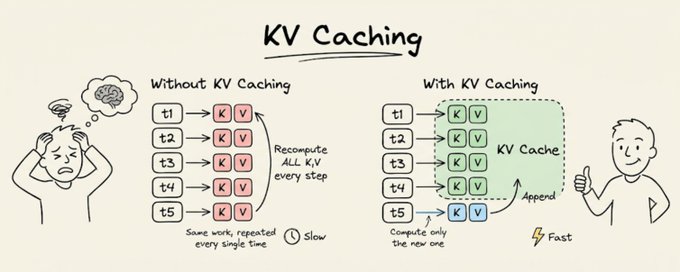
文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。
文章作者分享了如何利用 AI 构建一套独特的个人工作系统。他将德鲁克、乔布斯、芒格、巴菲特、原研哉和马斯克六位大师的思维模型,封装成不同的 Agent 顾问,分别负责商务增长、产品设计、系统架构、投资决策、商业聚焦和执行推动。作者通过这套系统解决了认知局限,提升了决策质量和执行效率,并详细展示了系统的架构设计和运行逻辑。
本文是一份关于如何高效使用 Claude 模型的实战指南。作者指出提示工程是当下最值得学习的 AI 技能,并详细剖析了缺乏上下文、指令含糊和不迭代这三大常见陷阱。文章基于 Anthropic 官方文档,总结了构建优秀提示的五大要素,并分享了结构化提示、反向提示、深度思考触发等高级技巧,旨在帮助用户掌握与 AI 沟通的艺术,从而获得高质量的输出结果。
文章介绍了 Claude 的 Interactive Diagrams & Charts 功能,允许用户直接在对话框中渲染可交互的图表、动画和播放器,无需跳转或下载。作者通过六个实战场景展示了该功能的用法,包括教程可视化、数据图表生成、时序图绘制、项目甘特图制作、方案对比组件以及音频可视化。文章还分享了编写 Prompt 的技巧和注意事项,强调该功能作为快速生成可视化工具的低摩擦优势。
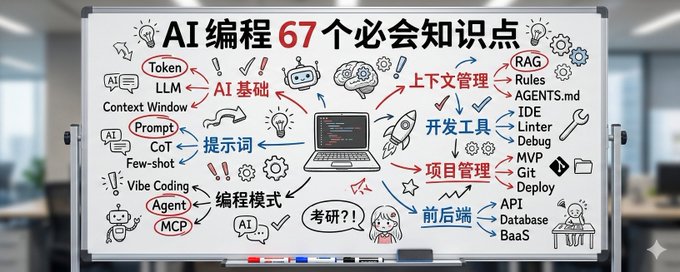
本文是程序员鱼皮撰写的 AI 编程术语词典,旨在用通俗易懂的语言解释 Vibe Coding 和 Agentic Engineering 中的核心概念。文章详细涵盖了 AI 基础(如大语言模型、Token、上下文窗口)、提示词工程(如系统提示词、思维链)、以及前沿的智能体编程模式(如 Agent Teams、Subagents)。这是一份帮助开发者理解 AI 编程逻辑、掌握新范式的必读指南。
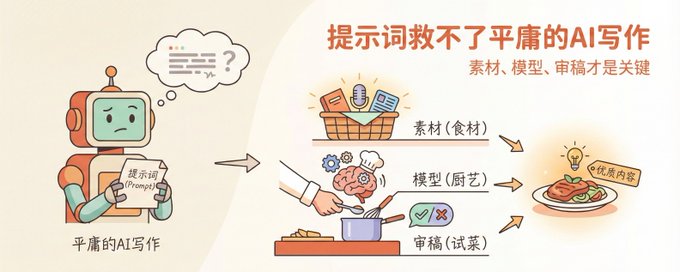
文章指出 AI 写作的质量关键不在于提示词,而在于素材质量、模型能力和审稿能力。作者将 AI 写作比作做菜,认为只有提供高质量的素材(食材),选择顶级的模型(厨艺),并具备优秀的审稿能力(试菜),才能产出优质内容。提示词仅相当于调料,只能起到锦上添花的作用。
文章记录了 Claude Code 创始人 Boris Cherny 在 YC 播客中的对话,回顾了该产品从终端原型发展至年化收入 10 亿美元的历程。Boris 分享了 Anthropic 的产品哲学,包括挖掘潜在需求、不为当下模型构建而押注未来模型进化的理念。文章深入探讨了 Plan Mode 的技术实现、多 Agent 协作模式(如“Mama Claude”)以及 AI 对编程效率的颠覆性提升,指出传统软件工程师角色将随着 AGI 的发展而逐渐消亡。
本文讲述了 Gabriel Petersson 从高中辍学凭借 ChatGPT 自学数学与机器学习,最终成为 OpenAI Sora 团队研究科学家的经历。他主张“自上而下”的递归学习法,认为教育效率低下。文章还分享了他作为辍学生通过 Demo 求职、利用 Stack Overflow 申请 O-1 签证的独特路径,以及对传统大学教育和职场招聘的犀利观点。