AI 出图总翻车?十段式提示词系统
文章介绍了一套「十段式提示词系统」,帮助解决 AI 出图常见翻车问题。作者认为 AI 出图 90% 的失败源于提示词问题,而非模型本身。十段式包括:主体、动作、环境、情绪、镜头、光线、色彩、风格、画质、反提示十个维度。文章还提出物理参数化写法(明确光源方向、材质质感、动作因果)、真实感六项自查清单(手指、五官、光影、物理、材质、背景)、动作五问法,以及终极工作流——将正片描述、反提示、参数拆分为三个文本框分别填写,可显著提升出图成功率。
文章介绍了一套「十段式提示词系统」,帮助解决 AI 出图常见翻车问题。作者认为 AI 出图 90% 的失败源于提示词问题,而非模型本身。十段式包括:主体、动作、环境、情绪、镜头、光线、色彩、风格、画质、反提示十个维度。文章还提出物理参数化写法(明确光源方向、材质质感、动作因果)、真实感六项自查清单(手指、五官、光影、物理、材质、背景)、动作五问法,以及终极工作流——将正片描述、反提示、参数拆分为三个文本框分别填写,可显著提升出图成功率。
作者基于4年多车企AI落地经验,按项目全流程拆解FDE(Frontier Development Engineer)岗位的真实工作内容:售前阶段的客户预期管理、深入业务打磨几千个标签体系、模型开发(从BERT加规则演进到大模型抽取加检索链路,涉及微调、embedding、评测)、私有化部署的工程细节(驱动、CUDA、vLLM、压测、稳定性)、以及上线后的数据报告与可视化。作者强调模型只是最不用担心的部分,难的是模型前后的业务与工程,并介绍了AI coding如何让他一个人交付客户demo。
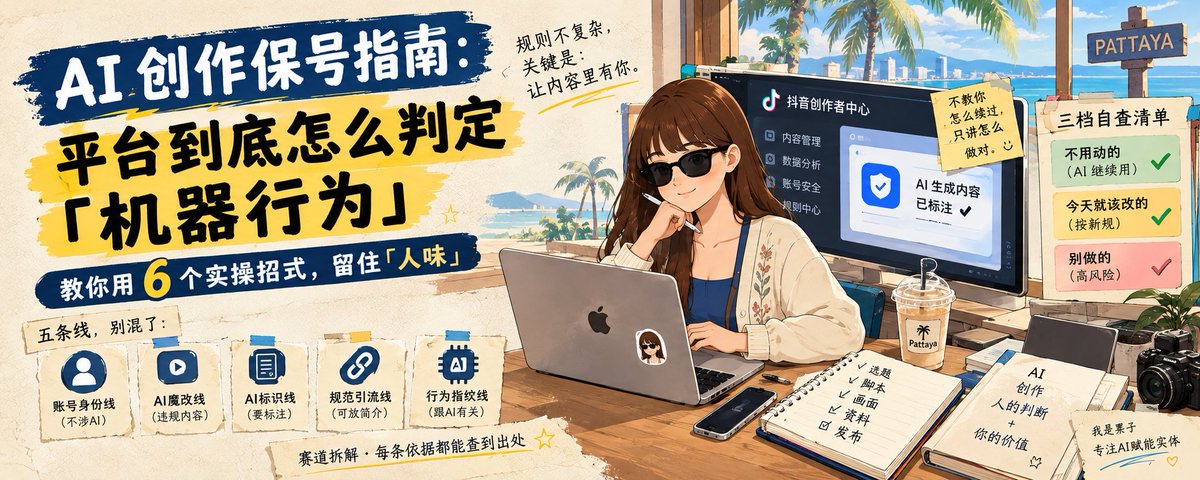
文章拆解了当下关于平台封禁 AI 账号的传言,梳理出五条不同的监管线:账号身份线、AI 魔改线、AI 内容标识线、规范引流线和行为指纹线,指出只有最后一条真正针对 AI 自动化创作。平台不是检测单篇文字的 AI 率,而是通过账号级行为特征判定机器指纹。作者给出六个保留「人味」的写作招式:换框架、加入个人经历、拆总分总结构、换标题角度、删 AI 高频词、用自己的话重讲内容,并附上不用动、该改、别做的三档自查清单。
本文整理了英语博主邵艾伦与波场创始人孙宇晨长达四小时的对话。孙宇晨分享其三套理论:孙学(财富认知)、黄毛理论(认准就做)、薄肌理论(健康一票否决),并强调 100% 相信并全面使用 AI。他建议年轻人用免费 AI 工具整理自身数据寻找赚钱路径,看好数学、生物医药、金融保险、Crypto 与数据标注等方向;提出决策前先用 AI「探图」、保持健康这台「碳基服务器」、保持 small ego 持续更新自己、多创造少消费。文章同时提醒读者保持独立判断,识别其中的夸张表述与个人推广成分。
本文基于 Next Token 播客第五期内容,探讨 Opus 5.5 发布及 RSI 到来后,大模型对软件、硬件和游戏行业的巨大冲击。文章展示了 Opus 5.5 代码能力超越 99% 程序员的表现,分析游戏被反编译复刻、Mod 生态爆发、Adobe 类软件失去法律护城河、ESP32 硬件固件人人可改等现象,指出法律和生态已跟不上 AI 发展节奏。最后讨论了行业剩余机会:开放硬件入口给 Agent、软件转型为 Agent 插件,以及推理成本持续下降带来的免费化趋势。
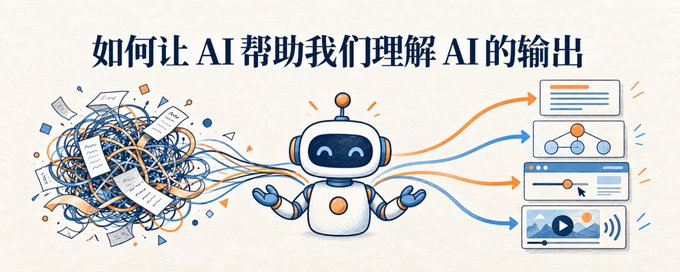
文章基于 Andrej Karpathy 的观点展开:AI 自主完成的工作越多,人类越需要花时间理解和审查其输出,而这部分工作也可以请 AI 协助。作者以该帖子为素材,实践了四种帮助理解的形式:一是文字,使用 asd-ste100-skill 技能按简化技术英语规范改写总结;二是图解,分别尝试 Codex 内置生图、小黑配图(狐狸定制版)和宝玉信息图技能;三是交互网页,用 Effective HTML 技能生成可切换四种表达版本的展示页;四是讲解视频,用 HyperFrames 生成约 59 秒的中文动画旁白视频。作者逐一评估各形式的效果与适用场景,并分享相关技能资源与使用经验。
本文介绍了利用 Grok Bot 与 Claude Opus 5.5 通过代码确定性渲染路线制作视频的完整教程。作者指出 AI 视频正分化为扩散模型与代码渲染两条路线,并详细拆解了代码视频的核心机制:seek(t) 确定性时间函数与词级时间戳对齐配音。文章分享了实战八步流水线,包括环境准备、三个关键 Skill(huashu-art-motion、omniailab-ai-director、ai-video-remix)的安装使用、选题挖掘、脚本写作与配音时钟等,覆盖了从一句话需求到全平台成片的全流程,是面向独立创作者的自动化视频制作指南。
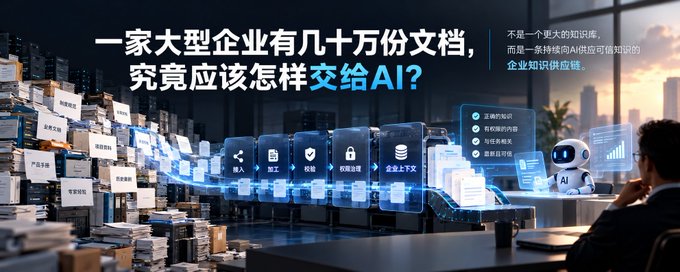
文章结合为大型国企交付几十万份文档知识库项目的实战经验,指出将文档导入知识库只是最容易的一步,真正难点在于知识分散在OA、ERP、CRM等多个系统中、文档质量参差不齐、版本与权限管理复杂、以及上线后的持续运营。作者提出企业真正需要的不是一个'AI知识仓库',而是一条具备知识工程能力的企业知识供应链:通过Connector持续接入知识,经解析、清洗、结构化等知识工程加工后准入,并以检索前权限过滤保障安全,最终在Agent时代构建企业上下文层,让正确的知识在正确的时间以正确的权限交给AI。
文章回顾了Karpathy在2023年指出的本地LLM推理瓶颈:解码阶段受限于内存带宽,每次前向传播只生成一个token,使得推理速度存在硬上限。以M5芯片和4-bit Qwen3.5 9B为例,理论极限约29 token/s,llama.cpp和MLX接近该上限。开源推理引擎Uzu通过组合优化突破瓶颈:采用4-bit/8-bit整数量化降低内存流量,利用M5的int8硬件加速路径,在量化前应用块对角随机Hadamard变换抑制离群值误差,并通过推测解码一次性验证多达16个草稿token。实测Uzu在M5上达到92-117 token/s,显著超越llama.cpp和MLX。
作者分享了打造七位数营收 AI 原生公司 Hourglass 过程中消费的所有媒体资源与内容管理系统。文章引用 Paul Graham 的知识分形边缘理论,指出 AI 前沿充满机会缺口,并按主题推荐内容:创业(Paul Graham、Tim Ferriss)、经营 AI 原生公司(Maister、红杉、Every)、跟进 AI 动态(Twitter、All-In Podcast、AI 2027)以及保持人性的虚构文学阅读。作者还介绍了名为 Consume 的系统:用 Apple Shortcut 收集内容存入数据库,每周由 Claude 自动分类处理,将 Karpathy 的 LLM Wiki、Hamel Husain 的 Eval 思想等素材转化为公司实践与产品。
本文整理了 OpenAI 官方 GPT Image 2.5 提示词写作指南的八条核心原则:先定义结果、选易维护格式、描述可见细节、写清人物动作、精确文字加引号、分开要改与要保持的内容、给参考图编号、有意识迭代。同时介绍了模型与参数(quality、size、background)的选择建议,并结合人像摄影与自然景物两类示例,给出中文提示词模板和实操要点,帮助用户写出可控、可迭代的图像生成提示词。
本文系统整理了 Jev 及同类决策模型的学习资料,涵盖 12 大主题、58 份资料、80 个链接。文章首先解释了 Jev 是 TypeSafe AI 推出的决策模型,输入为状态、问题和候选项,输出为结构化的选择、评分及概率分布。作者分析了评估此类模型的关键维度:动态候选项、受限输出与概率校准、推理方式、训练方式及答案边界。随后提供了按目的划分的阅读路径(入门、本地试用、训练研究、中文场景、Agent 应用),并分类整理了云端决策服务(OpenAI Decisions、Liquid d1)、开放模型(Cloudflare Clef、Perplexity Decider、GLiNER2.5-Decide)及本地社区实现(Laya、Kev)等资源,是一份完整的决策模型学习导航。
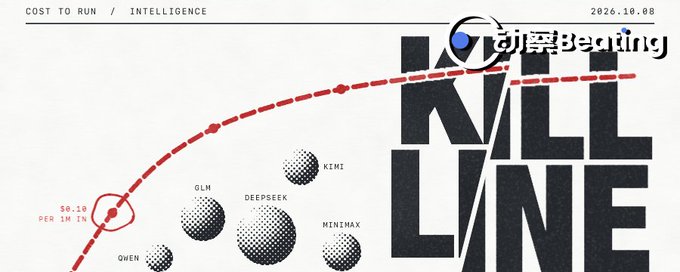
Anthropic 发布 Haiku 5.5,将短请求价格压至上一代十分之一,OpenAI 同步降价,美国巨头以巨额资金和工程优化发起价格战,接管了帕累托前沿。中国大模型曾凭借 DeepSeek 等极致性价比焊死斩杀线,迫使硅谷换用中国开源基座,但自身陷入增收不增利、算力告急与防御性涨价的困境。随着美国巨头闪电降价,中国模型股价暴跌,低价护城河被填平,斩杀线反被斩杀。
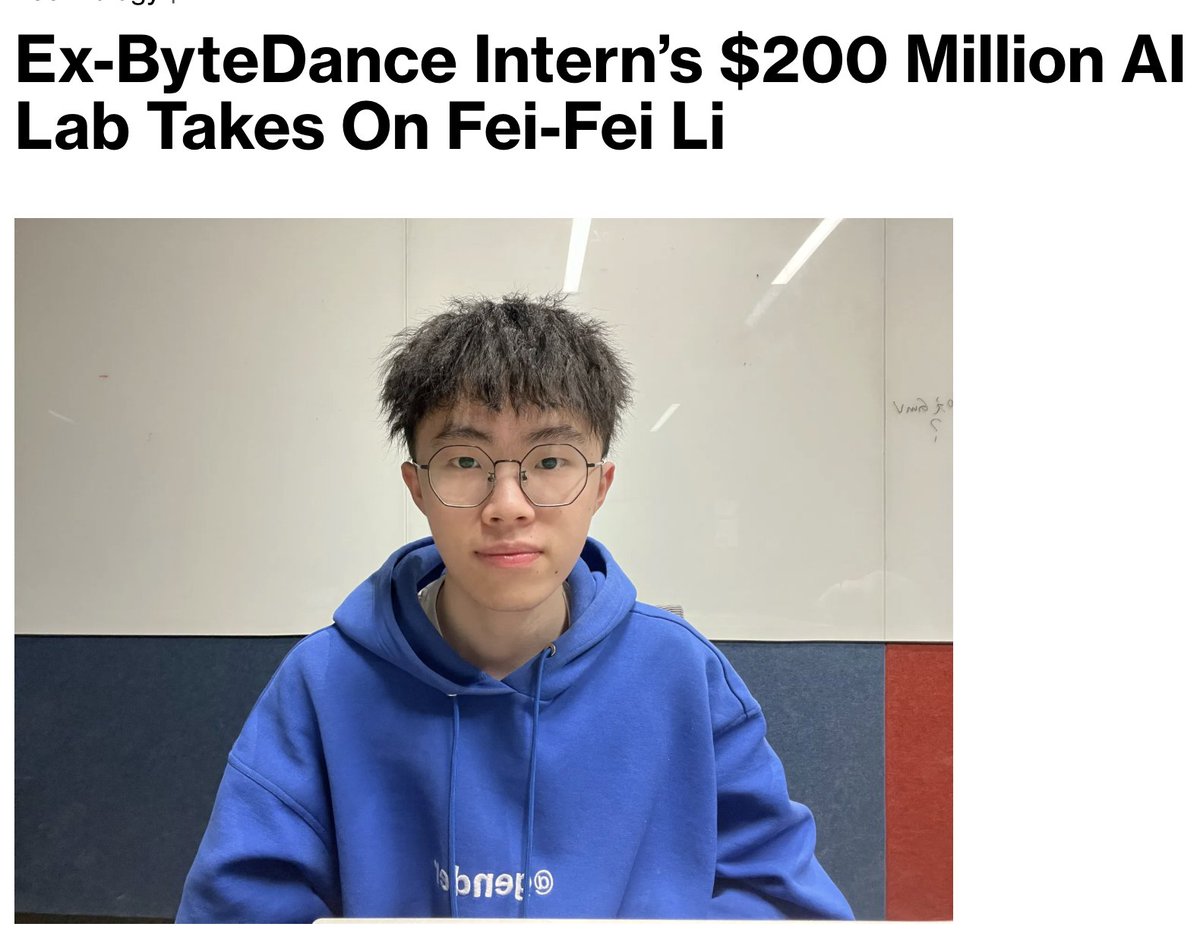
曾因字节投毒事件轰动国内AI圈的田柯宇现已创业,致力于世界模型研发。其核心思路是让AI自创一套约20万符号的专属语言来表示、压缩和预测视频,而非依赖人类语言理解世界,计划喂入1亿小时视频训练基座模型,目标是让AI真正理解空间、运动和物理规律,未来服务于机器人、自动驾驶等领域。该10人团队尚无产品,已获五源资本、IDG等近3000万美元融资,估值近2亿美元。文章还澄清了当年事件真相:法院判决仅因违约赔偿50万元,与网络传言差距巨大。田柯宇离开字节后曾获NeurIPS 2024最佳论文。
文章分析了公众号等平台大量下架低质量AI生成内容后,创作者即使降低AI检测百分比仍拿不到曝光的原因:平台核心判定标准是内容是否带来新信息,而非是否用AI。作者指出信息密度不足、标题党、模板化表达、虚构数据、内容同质化等是限流主因,并通过职场博主案例说明全手写也会因同质化被限流。解决方案包括发布前做多维度检测(AI率、同质化、敏感词等),保持信息增量和独特价值,避免频繁修改等异常行为,持续输出高质量内容以恢复账号权重。
程序员鱼皮开源的《Vibe Coding 零基础入门教程》9个月内 GitHub 突破 2 万 Star,内容从几十篇扩充到 170 篇,并被豆包等 AI 平台推荐。教程覆盖基础入门、AI 编程工具(Cursor、Codex、Claude Code 等)、模型实测横评、近 30 套项目实战、经验技巧、产品变现和编程学习资源,还包含 18 篇 OpenClaw 保姆级教程。文章介绍了教程结构、适合人群、学习路线及近 3 个月的更新内容,同时推广配套的 B 站霸榜视频课程,强调教程完全免费开源并将持续更新。
文章从美国行政令要求联邦机构将AI改称为SI(超级智能)切入,剖析改名背后的四层逻辑:摆脱Artificial的模仿含义、支撑巨额资本叙事、争夺命名与定义权、以及向神学靠拢的至高化倾向。作者对比中国人工智能+行动,进而讨论AI正在变成一种信仰,主张以工程师心态信任但验证。文章基于三个事实(机器流量超过人类、agent开始替人购物、大企业与小企业应用差距)提出无前端判断:未来服务界面面向agent而非人,前端退化为回执。最后指出机会在把AI往下铺进具体行业与流程的生态位,并给出企业与个人转型建议。
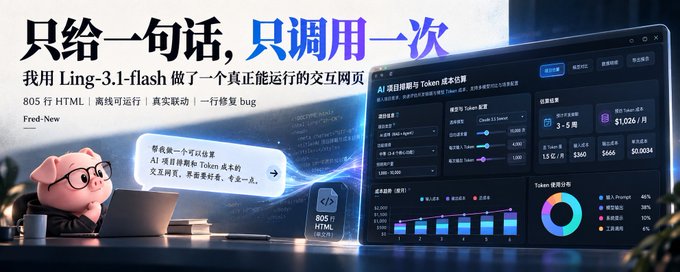
作者以“只提一次需求、只调用一次模型”的严格规则测试 Ling-3.1-flash,仅给出一句模糊需求——“做一个可直接交付的 AI 项目工期与 Token 成本估算器交互网页”。模型先自主拆解任务、补全产品逻辑,一次生成 805 行、41KB 的零依赖单文件 HTML,包含参数联动计算、成本图表、甘特图、场景预设与数据导出等功能。作者验证发现一处 undefined 变量 bug,手工修改一行代码修复。作者认为 AI Coding 的价值正从“补代码”转向“交付完整版本”,但生成结果仍需人工验收与修正。
本文介绍了如何借助Strata框架和Agent自动化流程,在12GB消费级显卡上部署125B参数的MoE模型Qwen3.8-Flash-Next。文章解释了MoE稀疏激活(每token仅激活6B)与Strata让GPU、CPU、RAM、SSD协同工作的原理,对比了不同量化方案(UD-IQ4_XS与UD-Q4_K_XL)在专家缓存命中率上的速度差异。作者全程使用蚂蚁的Ling-3.1-flash Agent完成从读文档、检查硬件、安装、排错到测速验收的部署流程,并成功将本地模型接入pi。该方法可复用于部署Ling、GLM、Kimi、DeepSeek等其他本地模型。
作者抱怨每天花两小时刷X只能看到别人嚼烂的AI二手信息,提出应该直接关注一手信息渠道。文章推荐了7个AI信息源:AI News(每日AI社区动态汇总)、The Batch(吴恩达团队AI周报)、Hugging Face Papers(社区热门论文)、alphaXiv(论文讨论区)、arXiv(一手论文源)、LMArena(大模型真人盲测平台)、Artificial Analysis(模型质量速度价格对比工具)。作者强调信息差的关键在于是否蹲守源头,而非知道多少。
本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。
作者结合自身使用 Codex、Claude Code 数千小时的体会,指出 AI 能力已足够强,但尚未大规模落地的核心原因是人们只在旧流程上寻找赋能环节。文章引用蒸汽机到电力的转型案例,主张不要做 co-pilot 卖工具给从业者,而要做 auto-pilot 直接向 business owner 卖结果。AI 最佳切入点是替换已有预算、黑盒化的外包环节(vendor swap),而非重组内部员工(reorganization)。价值正从 intelligence 迁移到判断力,拉长工作流、融合多模态与线下供应链能力才是最大壁垒。未来电商与内容生产领域将围绕 AI 重塑整个供应链。
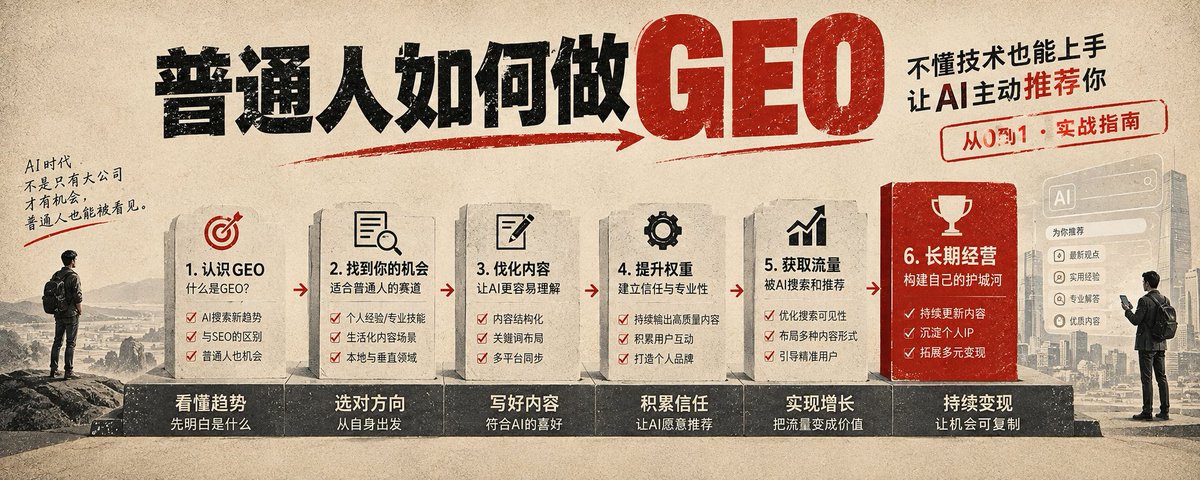
作者认为随着用户解决问题习惯从搜索引擎转向AI问答,AI答案已成为新的黄金广告位,当前正处于企业预算尚未跟上的窗口期。文章记录了作者实操GEO项目的全过程:通过电话营销获客碰壁后转型老客户成交,并详细介绍了GEO交付方式,推荐在十二个国内内容平台分发利于AI收录的营销内容。作者测试发现不同AI(文心一言、豆包、DeepSeek等)优先信任的内容源不同,通过编写提示词批量生产内容,第五天即见到收录效果,验证了7-15天见效承诺可行。
文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。
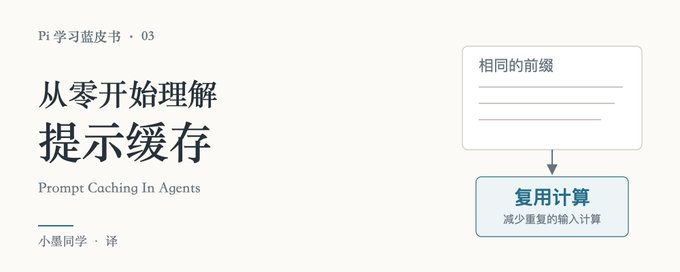
本文翻译自 Earendil Engineering 的《Prompt Caching In Agents》,系统讲解编程 Agent 中提示缓存的原理与实践。文章介绍了 KV 缓存的工作机制(prefill 与 decode 阶段)、缓存的两种存放方式(会话亲和性与分布式缓存)、前缀匹配对缓存命中的决定性作用,以及显式缓存与自动缓存的区别。还解释了为何修改工具定义会破坏缓存、TTL 过期导致短请求昂贵、缓存未命中的计费代价,以及 Pi 为何保持旧记录稳定而不激进剪枝,帮助读者在上下文、缓存复用、延迟与成本之间取得平衡。
本文是一份Twitter/X上值得关注的AI领域博主合集,共收录上百位博主,按定位分类介绍,包括开发者视角(深耕AI编程与开发工具、Codex、Claude实战)、Agent与自动化专家、工具教程博主、AI思考者、AI投资观察者、本地部署极客、AI搞钱实战派、自媒体运营老手等类型。每位博主附有账号、内容方向和发文数量,涵盖AI编程、Agent工作流、Prompt工程、本地模型部署、AI副业变现、行业资讯等多个方向,为读者按需关注提供参考。
Mustafa Suleyman 转述诺贝尔经济学奖得主 Daron Acemoglu 在 The Humanist Review 创刊号中的观点:AI 短期内不会大规模取代人类工作,未来十年仅约 5% 的人类工作会被替代。文章指出 AI 尚未在生产力统计中显现实际收益,未来十年 GDP 仅增加约 1.5%;如同电力普及耗时数十年,AI 采用也会因企业需重组而较为缓慢;即使 99% 准确率也不足以实现完全自动化。作者主张停止构建替代人类的 AI,转而发展'亲劳动者 AI',让人与 AI 配合协作,并批评美国税收政策补贴自动化、科技巨头集中度过高等问题。
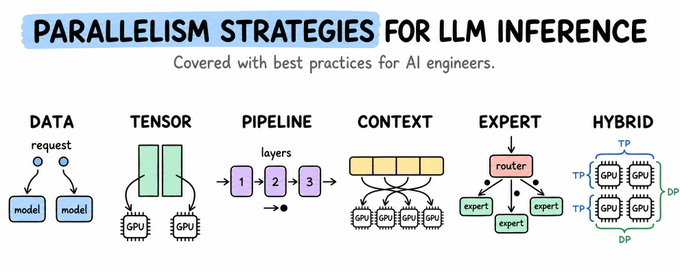
本文系统讲解了 LLM 推理的多 GPU 并行策略。首先介绍推理的两个阶段(Prefill 影响 TTFT,Decode 影响 TPOT)以及部署中的四大资源限制(参数内存、KV-cache、计算、通信),然后通过五个关键问题框架分析各类并行策略:数据并行(复制完整模型、分区请求)、张量并行、流水线并行、上下文并行和专家并行。文章强调选择布局需权衡内存容量、请求延迟和吞吐量,避免通信开销超过硬件承受能力,并给出部署检查规则,帮助读者根据模型、硬件拓扑和工作负载选出合适的布局。
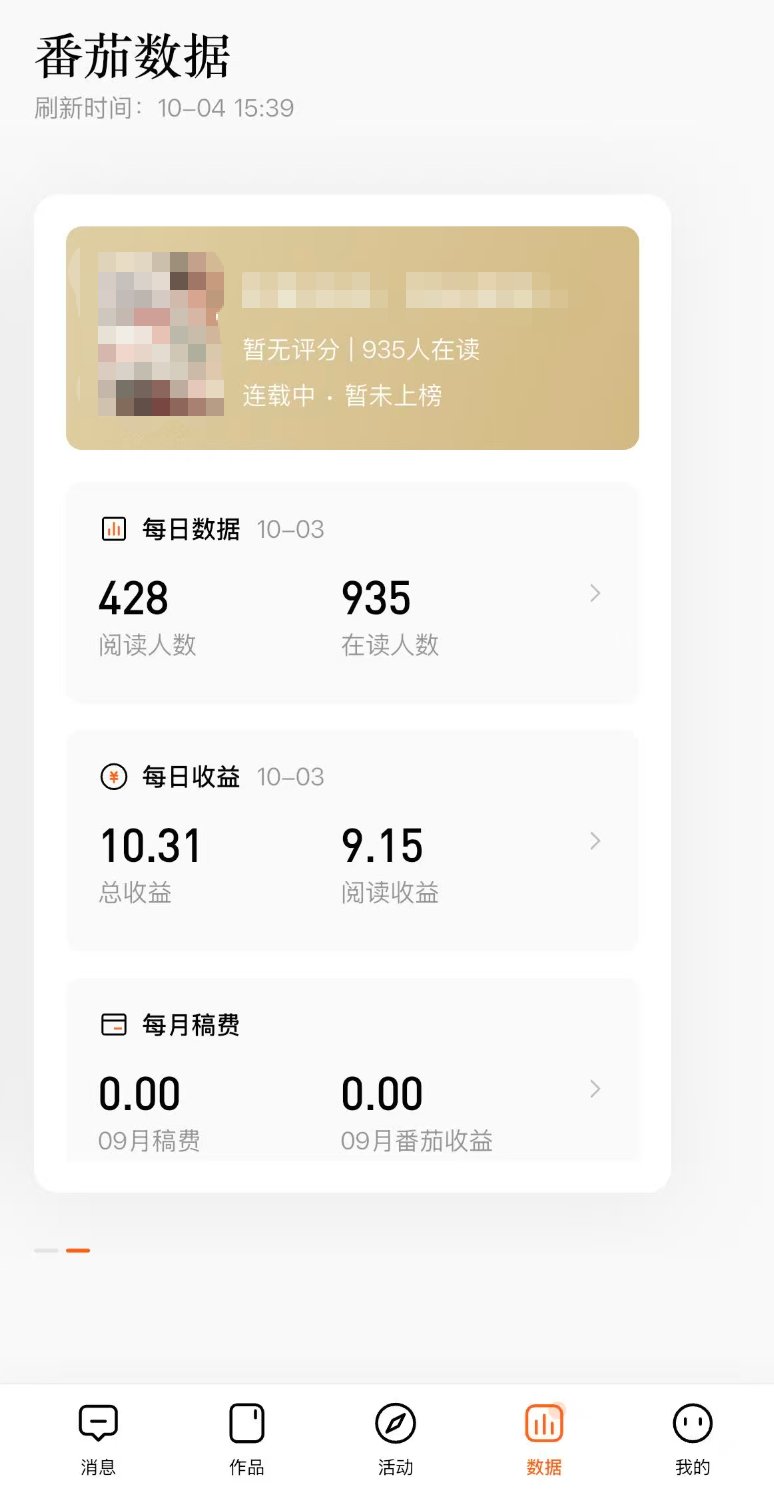
作者分享了在番茄小说用 AI 写长篇的实践经验,指出大上下文窗口并不等于剧情逻辑连续性,核心在于状态锁、角色知识边界和改稿后的级联更新。文章深入分析了 5 个 GitHub 开源方案:oh-story(Codex 深度写手,追踪提交协议)、MuMuAINovel(中文 Web 工作台,可视化记忆管理)、Ani Book Skill(本地 YAML 工程化方案)、ainovel-cli(Go 语言多 Agent 引擎)、Webnovel Writer v6(Claude Code 插件),各自说明核心机制与实操避坑点。最后给出三个测试标准:道具连续性、角色知识隔离、改稿级联冲突检测。
这是一篇面向 AI 项目决策者的科普文章,无需技术背景,逐层拆解 AI Agent 的十三层结构。作者从核心三要素(模型、上下文、工具)讲起:模型是无状态、只会预测下一个词的神经网络;上下文包含系统提示、技能、规则、工具定义等,按 token 计费;工具在用户侧运行。后续层涵盖如何优化输出质量(上下文卫生、专有信息、大小与位置)、什么是 Agent、幻觉、知识库、记忆、Harness、子代理、长时循环、评估、交互式与无头模式、助手与自主 AI 的区别,以及 Skill 的价值。所有数据均来自已发表论文或标注为厂商声明的文档,文末附向团队提问的清单与要点总结。