Wiki 知识库

全部文档 / 标签: LLM

1041 篇
清除

Lemo-Opuscar 史诗级更新:8种新风格+新改编玩法,我把风格库变成了风格制作工具箱

Lemo-Opuscar 迎来上线以来最大更新,新增【剪辑与纪实】8 种视频风格(字幕新闻、1920s 新闻影片、实时倒计时分屏、延时交响、视觉调查、构成主义蒙太奇、体育战术板、电视新闻包装),风格总数达 59 种,目标 99 种。项目定位从视频风格库升级为搭建个人风格库的工具箱:用户可修改库里任意风格或从空白创建,通过 Claude 逐题问答的方式定制专属风格。作者还预告了 Lemo Studio 工作台和日系动漫风格。文章详细介绍了新风格的适用场景、Sonnet 5.5 测试效果,以及自定义风格的完整流程。

技术 › Skill Lemomo 2026-10-2219.8 KB 511.6K 1.9K 81

一个人十天写出的引擎,让 12GB 显卡跑起 1250 亿参数模型

个人开发者用十天时间(代码大部分由 AI 编写)打造了推理引擎 Strata,能让 12GB 显存的普通电脑运行 1250 亿参数的 Qwen 3.8 Flash Next 模型。文章剖析其六倍速度宣传实为不同量化版本对比,同版本实际是两到四倍;真正亮点是 prompt 读取速度达每秒 1500 token。核心技术是围绕 MoE 架构的专家缓存,命中率约 72%,代价是输出可能偏离原模型结果。文章还对比了买内存自建与云端 API 的成本账,并预判通用引擎 llama.cpp 将在几个月内补齐缓存能力。

技术 › LLM Saito 2026-10-218.8 KB 1.5K 4 84

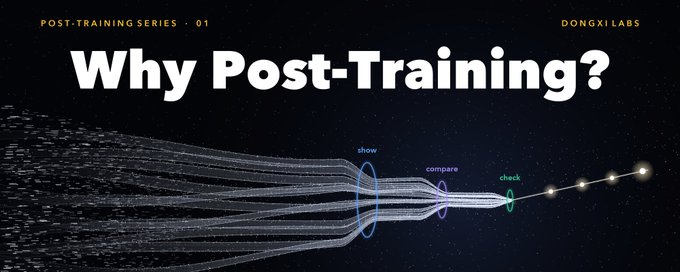
预训练之后,为什么还要后训练?

文章以 GPT-3 与 InstructGPT 对比为例,解释为什么预训练只教会模型'猜下一个词',却不能让它听指令、保证安全、做长链推理,因此需要后训练来弥补目标差距。文章对比了预训练与后训练在目标、数据、信号、成本和改动幅度上的差异,并系统介绍了三种后训练技术:指令微调(跟示范学)、偏好对齐(RLHF/DPO,靠比较学)、RLVR(由可验证检查器判对错)。全文用通俗类比讲清后训练的原理,是后训练系列文章的第一篇。

技术 › LLM Dongxi 东锡 NLP 2026-10-219.5 KB 26.6K 179 70

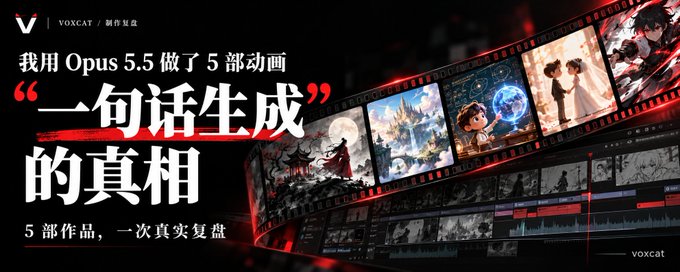
我用 Opus 5.5 做了 5 部动画:“一句话生成”的真相

作者在 Opus 5.5 发布后实测“一句话生成动画”的真实效果,从 5 秒片名卡做到 195 秒讲解动画,共完成 5 部作品。结论是:一句话确实能生成好看的内容,但成功区间很窄——只有短、内容自由、无标准答案的片名卡一次通过。片子一长、内容一定,就出现牙齿数量错误、画面冻结、占位文字残留等细节问题,需借助独立 AI 审查与人工把关。作者总结:意图与感知只能由人提供,并给出开工前给齐决定、先看抽帧拼图、另开 AI 审查、反馈带时间码、沉淀素材五条实践建议。

技术 › LLM VoxCat 2026-10-217.1 KB 3.7K 13 82

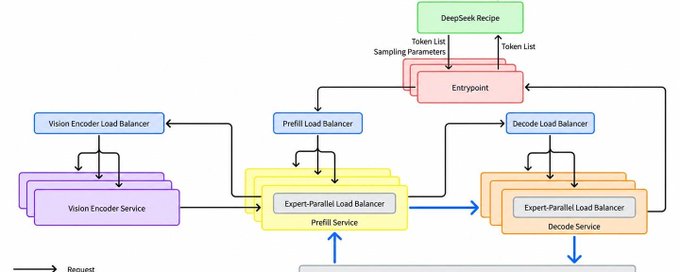
DeepSeek V4.1 Flash 大规模推理部署实践

文章介绍 DeepSeek V4.1 Flash 大规模推理系统的部署实践与开源推理框架 DeepInfer。系统设定三大目标:兼容多厂商计算芯片、基于通用硬件组织 Prefill 与 Decode(8 卡机 Prefill、64-128 卡超节点 Decode)、支持 KVCache 保留 72 小时以上以实现上下文复用、减少冗余计算。团队通过在计算、通信、调度与存储上的持续优化,在满足延迟要求下提升有效吞吐。DeepInfer 集成高性能算子与深度优化推理引擎,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出等能力。目前单集群服务吞吐达每天 155 万亿 tokens,整体收入为每卡每小时 38 美元(按低谷价格计)。

技术 › 后端 Latent.Space 2026-10-2182.1 KB 92.6K 432 69

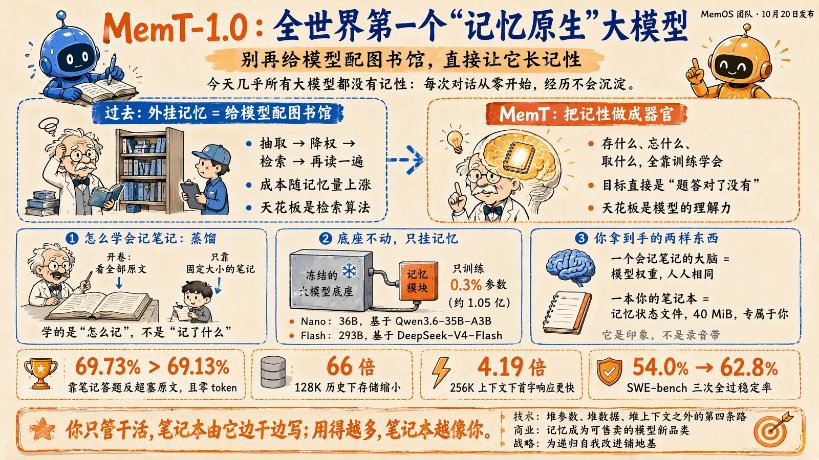
全世界第一个记忆原生大模型 MemT-1.0 上线

MemOS 团队发布全球首个“记忆原生”大模型 MemT-1.0,将记忆能力直接训练进模型权重,取代 RAG、Mem0 等外挂记忆方案。其思路是不改底座、参数冻结,仅在部分层并联约 1.05 亿参数的记忆块,通过蒸馏训练让模型自学“什么该记、什么该忘、怎么取用”,优化目标从检索命中率改为任务答对率。交付物包括通用模型权重(会记笔记的大脑)和用户专属记忆状态文件(仅 40 MiB 的笔记本)。数据显示其 40 MiB 记忆答题成功率 69.73%,略高于全量上下文的 69.13%,存储缩小 66 倍、首字响应快 4.19 倍。已在 Hugging Face 和 GitHub 开源,被视为开启模型“在使用中变强”的第四条技术路线。

技术 › LLM huangserva (@servasyy_ai) 2026-10-218.8 KB 73

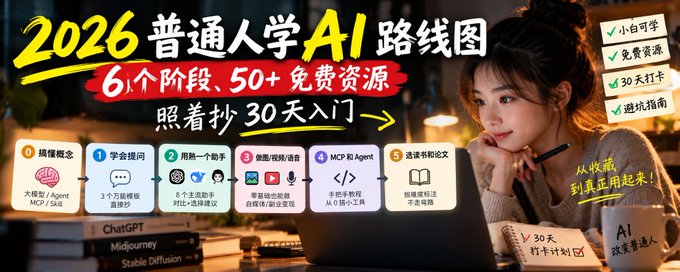
2026 普通人学 AI 路线图:6 个阶段、50+ 免费资源,照着抄 30 天入门

文章针对普通人收藏大量 AI 教程却始终没学会的问题,提出按可上手顺序排列的六阶段学习路线:先搞懂大模型、Agent、MCP、Skill 四个基础概念;再学会高效提问;然后选一个通用 AI 助手用熟;之后分创作者路线(做图、视频、语音)和开发者路线(MCP 与 Agent 开发)深入;最后选读书籍论文进阶。作者强调'卡住你的不是资源不够,而是顺序不对',并附上 30 天打卡表、53 个免费资源和五个避坑建议,倡导边用边学、动手实践。

技术 › LLM 虹安 2026-10-2113.2 KB 11.1K 89 78

同样 10 美元,OpenCode Go 和 Command Code GOAT 选哪个?基于 6 万多条记录的实测对比

作者将 OpenCode Go 和 Command Code GOAT 两个 10 美元/月的套餐接入自己的 Sub2API 网关,基于 64,648 条使用记录和小规模质量测试进行实测对比。两者月额度均为 80 美元,OpenCode 短时额度更大(5 小时 16 美元、周 40 美元),GOAT 为 14/35 美元。在相近规模流式请求中 GOAT 耗时中位数和 P95 更短,400 错误也显著更少。结论:接自己的 Agent 或通用 API 客户端优先 GOAT;用于兼容的 coding agent 且集中跑任务则选 OpenCode Go。文章还讨论了处理费、高峰定价、参数兼容问题和模型是否量化等细节。

技术 › 工具与效率 brucexu.eth 2026-10-2110.9 KB 4.5K 20 87

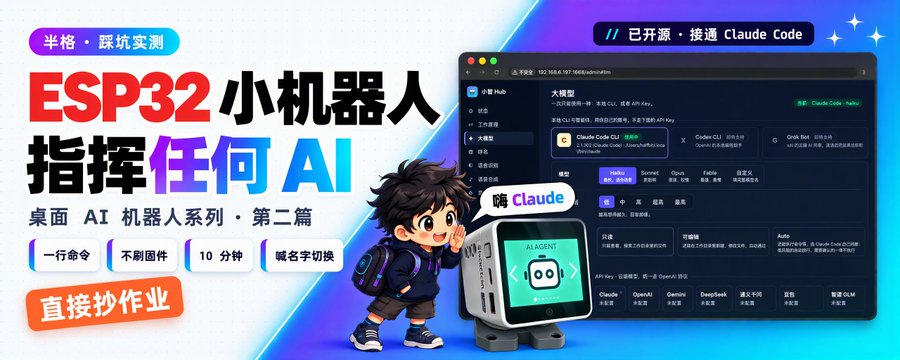
让 ESP32 小机器人指挥 Claude Code 和任何 AI|一行命令接通、不刷固件、喊名字切换

文章介绍如何用一行命令安装开源网关 xiaozhi-hub-server,让刷有小智固件的 ESP32 设备(如 StackChan)通过语音指挥本机 Claude Code 或各家大模型 API。无需刷固件,仅需修改 OTA 地址即可接入,全程约 10 分钟。网关负责语音转文字、呼名路由和语音合成,设备只负责听说。支持权限分级(只读/可编辑/Auto)、长任务等待、随时打断、上下文延续和中英混说识别,也可部署到云服务器实现 24 小时在线。文末给出固定 IP、目录权限等踩坑提示和安全建议。

技术 › Claude Code 半格 / HalfBit 2026-10-2112.1 KB 33K 93 84

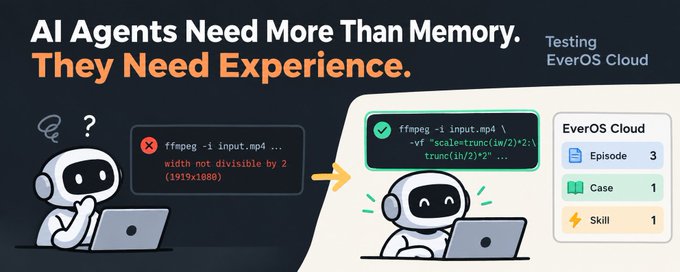
AI Agents Need More Than Memory. They Need Experience: Testing EverOS Cloud

作者实测 EverMind 的 EverOS Cloud——一个定位为 Agentic AI 的记忆操作系统。文章指出 RAG 式对话检索不等于经验提取,EverOS 将记忆分为 Episodes、Profiles、Cases、Skills 四类。作者用 Python API 模拟 FFmpeg 渲染报错(width not divisible by 2)场景:仅提交对话叙述只产生 Episode;提交完整的 tool_calls 执行轨迹后,系统成功生成结构化 Agent Case,并可用不同措辞的新查询检索到该 Case。测试验证了'执行轨迹→Case 提取→语义检索'链路,但 Skill 的生成与端到端复用仍待验证。作者认为 agent 记忆的价值在于保留可复用的工程经验,而非扩大上下文窗口。

技术 › Agent Steven Cheng 2026-10-218.9 KB 30.4K 144 78

如何用 Claude / DeepSeek 做资讯类视频(附提示词和开源风格 skill)

作者分享了使用 Claude Code(Opus 5.5)批量制作资讯类竖屏短视频的完整工作流。核心步骤包括:选题(AI 粗选、人工精选,信息源以推特和 Hacker News 为主)、素材准备(Gemini API 写脚本和 TTS 配音、Suno 背景音乐、背景图、logo 等)、编写初始提示词、让 Agent 撰写脚本并派子 agent 做对抗式审查、反复修改脚本与成片。文中提供了可直接复用的提示词模板,并开源了包含 18 套竖屏视频风格的 Claude Code skill(creator-style-kit),可用于固定视频的字体、配色、动效与音效风格。

技术 › Claude Code 陆三金 2026-10-2012.3 KB 19.8K 230 82

Agent 高频题 01. 讲讲你的 RAG 链路

本文是 Agent 高频面试题详解系列第一篇,聚焦 RAG(检索增强生成)链路。文章基于近两个月牛客网 82 场面试的统计,指出 RAG 是最常被追问的题目。内容先给出 RAG 整体架构图,解释为什么需要 RAG 及其与长上下文、grep、微调、工具调用、记忆等方案的边界;再沿离线、在线两条线逐环讲解:离线部分涵盖文档解析、切分策略、embedding 向量化、HNSW/IVF 索引原理;在线部分讲解问题改写、BM25 与向量多路召回、RRF 融合、交叉编码器重排等环节。每个环节均附上面试常见追问,并提供复习优先级参考。

技术 › Agent 码良 2026-10-2041.5 KB 10.7K 70 78

深度体验 EverOS Cloud:让 Agent 记忆与经验沉淀为技能的测评

文章针对 AI Agent 开发中记忆缺失、RAG 低信噪比切片、状态冲突与多主体污染三大痛点,测评了 EverOS Cloud(API v2)这一 Agent 记忆操作系统。核心机制包括语义事件切割、记忆整合消解冲突、多主体严格隔离,在 LoCoMo 基准上达 93.05% SOTA,减少 90% 以上 Token 消耗。其自进化技能引擎可将任务执行链路沉淀为 Case 并蒸馏为可复用 Skill,任务成功率最高提升 234.8%。接入仅需两行核心调用,支持记忆治理 API、多模态资料挂载、MCP 协议兼容 Claude Code 等工具,以及云/本地双模部署。作者认为其适合需要跨会话跟踪意图与沉淀业务 SOP 的场景。

技术 › Agent 浅水虾 2026-10-207.9 KB 5.2K 55 74

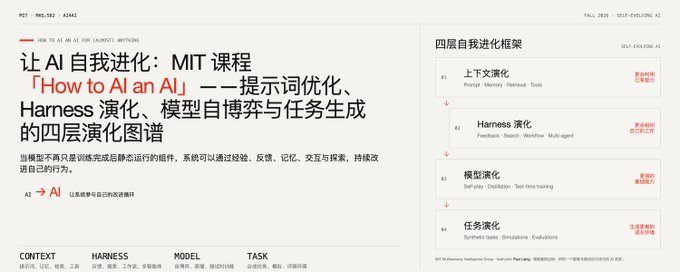
让 AI 自我进化:MIT 课程「How to AI an AI」——四层演化框架解析

文章介绍了 MIT Media Lab 2026 年秋季开设的研究生课程 MAS.S62「How to AI an AI」,主题为自演化 AI(Self-Evolving AI)。课程提出四层演化框架:上下文演化(提示优化、记忆)、Harness 演化(agent 工具链自我改进)、模型演化(持续学习、self-play、测试时训练)、任务与环境演化(合成任务生成、世界模型)。文章详述了教学设计、评分结构、作业与顶会论文成果,并评价该课程是对松散领域的体系化定义尝试,建议以阅读清单和开源工具自学。

技术 › LLM meng shao 2026-10-208.6 KB 14.6K 80 85

给 AI 装上一条河,它会醒过来吗?

文章将一篇灵长类大脑神经科学的预印本、七世纪玄奘译出的《解深密经》与当今 Agent 架构并置对照,提出一个猜想:意识可能不仅关乎'位置'和'规模',还关乎'时间上的选择'。研究发现面孔区以约每秒15次的节奏在'被意识到'和'被抑制'的表征间交替。作者类比唯识八识体系,指出今天的 AI 只有前五识和第六意识(推理),缺少第七末那识(恒常自我追踪)和第八阿赖耶识(恒转如瀑流的种子池)。文末给出一个玩具级'常驻之河' Agent 设计,包含种子池、节拍调度器、竞争选择、末那日志和熏习写回五个部件,探讨如何构建一个持续流动而非'每次调用从零开始'的系统。

技术 › LLM Neo@Matrix 2026-10-1926.2 KB 3.2K 3 78

DeepSeek V4.1 Flash 1017 实测:性能更强、费用更低的一次升级

DeepSeek 于 10 月 17 日发布 V4.1-Flash-1017 版本,AI 编程跑分显著提升,DeepSWE 达 77.0 超越 Claude Opus 5,任务平均费用降至原来的三分之一。作者使用 DeepSeek Harness 实测四个项目:3D 城市生成器对比显示新版的重庆、西安等地标建筑辨识度大幅提升,耗时从 102 分钟降至 61 分钟;许愿式编程能快速产出 3D 地铁跑酷游戏和天坛祈年殿建模;基于新开放的 Search/Fetch 接口开发的 AI 搜索引擎完成度很高。总花费仅 12.81 元,性价比突出,是一次实打实的帕累托改进。

技术 › LLM 程序员鱼皮 2026-10-1915.6 KB 8.2K 9 84

Codex 也能免费用 DeepSeek V4.1 Flash 了:Magpie + WorkBuddy AI 保姆级教程

本文是详细的保姆级教程,讲解如何通过本机中转站 Magpie 和 WorkBuddy AI 海外版账号,让 Codex 免费使用 DeepSeek V4.1 Flash 模型。作者介绍了从注册 WorkBuddy AI 账号、安装 Magpie、配置插件、将 Codex 接入 Magpie 的完整流程,并通过路由记录和积分验证免费模型的真实使用。进一步还介绍了路由组功能,实现自动任务分配:复杂任务(架构设计、bug 排查、代码评审)交给 GPT-6 Astra,代码编写等任务交给免费的 DeepSeek。全文在 Mac 环境下实操,包含一个 3D 网页开发的完整实践案例及踩坑经验分享。

技术 › Codex Jonathan Hu 2026-10-1924.1 KB 1.8K 18 79

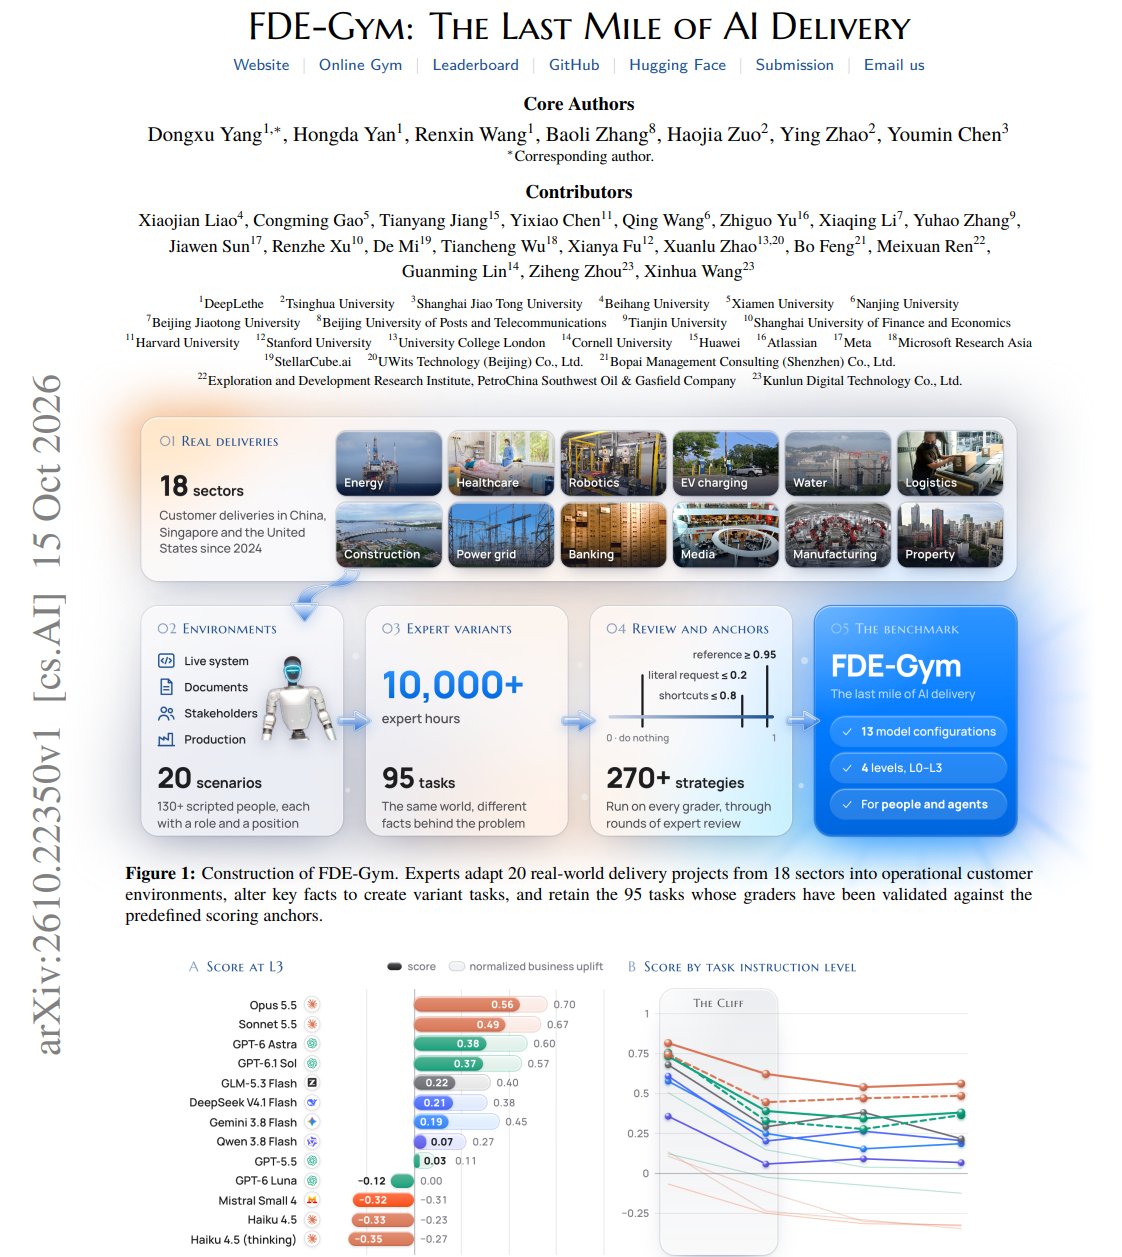
FDE-Gym 论文解读:AI 能否胜任 Forward Deployed Engineer 工作

文章解读了一篇关于 FDE(Forward Deployed Engineer)的论文《FDE-Gym》。该论文将真实企业项目改造成覆盖金融、医疗、制造、能源等 18 个行业的 95 个任务,评测 AI Agent 承担真实企业交付工作的能力。Agent 仅获得客户最初的一句话需求,需自行读文档、查系统、确认信息并判断客户真正的问题。评分不仅要求完成需求,还要求交付系统真正改善业务指标,乱找人、反复试错都会产生成本。结果显示最强模型平均得分仅 0.56,95 个任务中仅真正解决 14 个,最大瓶颈在于未写入需求的业务规则、隐性约束以及客户未表达清楚的问题。文章指出 FDE 的难点在于在信息不完整、需求模糊的环境里判断该解决什么并真正交付。

技术 › Agent Xudong Han (@Xudong07452910) 2026-10-181.6 KB 65

We're Thinking Too Small About Synthetic Data

本文指出合成数据远不止大规模推理或预训练数据配比设计,而是一个深度的数据研究问题。作者认为生成器本身就是研究课题:并非所有部分都需要 LLM,状态转移模型和离散事件仿真可以通过显式规则生成内部一致的世界历史。同时,人类知识与合成系统应结合——人类帮助设计训练分布、提升内容真实感、补充机器检查的判断盲区。作者以客服 agent 训练为例说明事件驱动仿真的优势,并展望自适应课程设计,认为物理/数学仿真 + LLM + 人类专家的组合将大有可为,应以固定预算下的训练提升来评判生成器。

技术 › LLM Yuhan Luo 2026-10-189.2 KB 33K 611 74

如何变得更有雄心:一份写给 AI 时代人类的实践指南

本文是 Claude 团队工程负责人 Felix 文章的中文翻译,探讨如何在 AI 时代更有雄心地使用 AI。作者将雄心分为四个维度:速度(更快完成工作)、高度(关注结果而非任务,重新思考业务流程)、深度(像顶尖专家一样使用专业工具和方法挑战极限)、广度(跨学科引入不同领域的知识和方法)。文章结合 Acme 公司季度回顾等具体案例给出实践方法,并引用自我效能感心理学研究、Dantzig 解难题、Bannister 破四分钟纪录等故事,说明人类往往受限于对可能性的想象力,鼓励读者大胆设定目标、允许失败,充分利用 AI 能力实现突破。

技术 › LLM 洛克船长 2026-10-1719.3 KB 42.3K 219 85

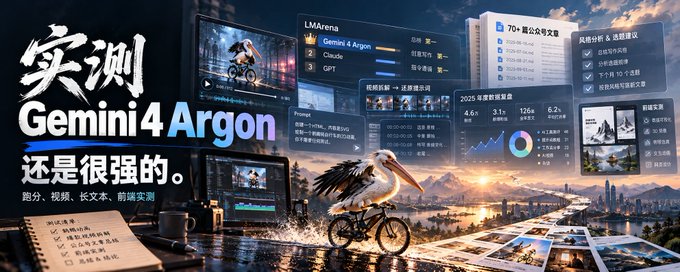
实测Gemini 4 Argon,还是很强的。

作者以自媒体真实工作场景实测Google新发布的Gemini 4 Argon模型。通过鹈鹕骑自行车SVG动画、爆款视频拆解与提示词还原、公众号文章风格分析与选题生成、五道前端实战题(数据看板、3D宫殿、品牌官网、浏览器合成器等)进行评测。结论是该模型跑分第一,长视频理解和前端能力出色,写作能力介于Claude Opus和GPT之间,并提醒读者注意订阅档位和API优惠价截止时间。

技术 › LLM zhouluobo 2026-10-1725.7 KB 10.4K 19 78

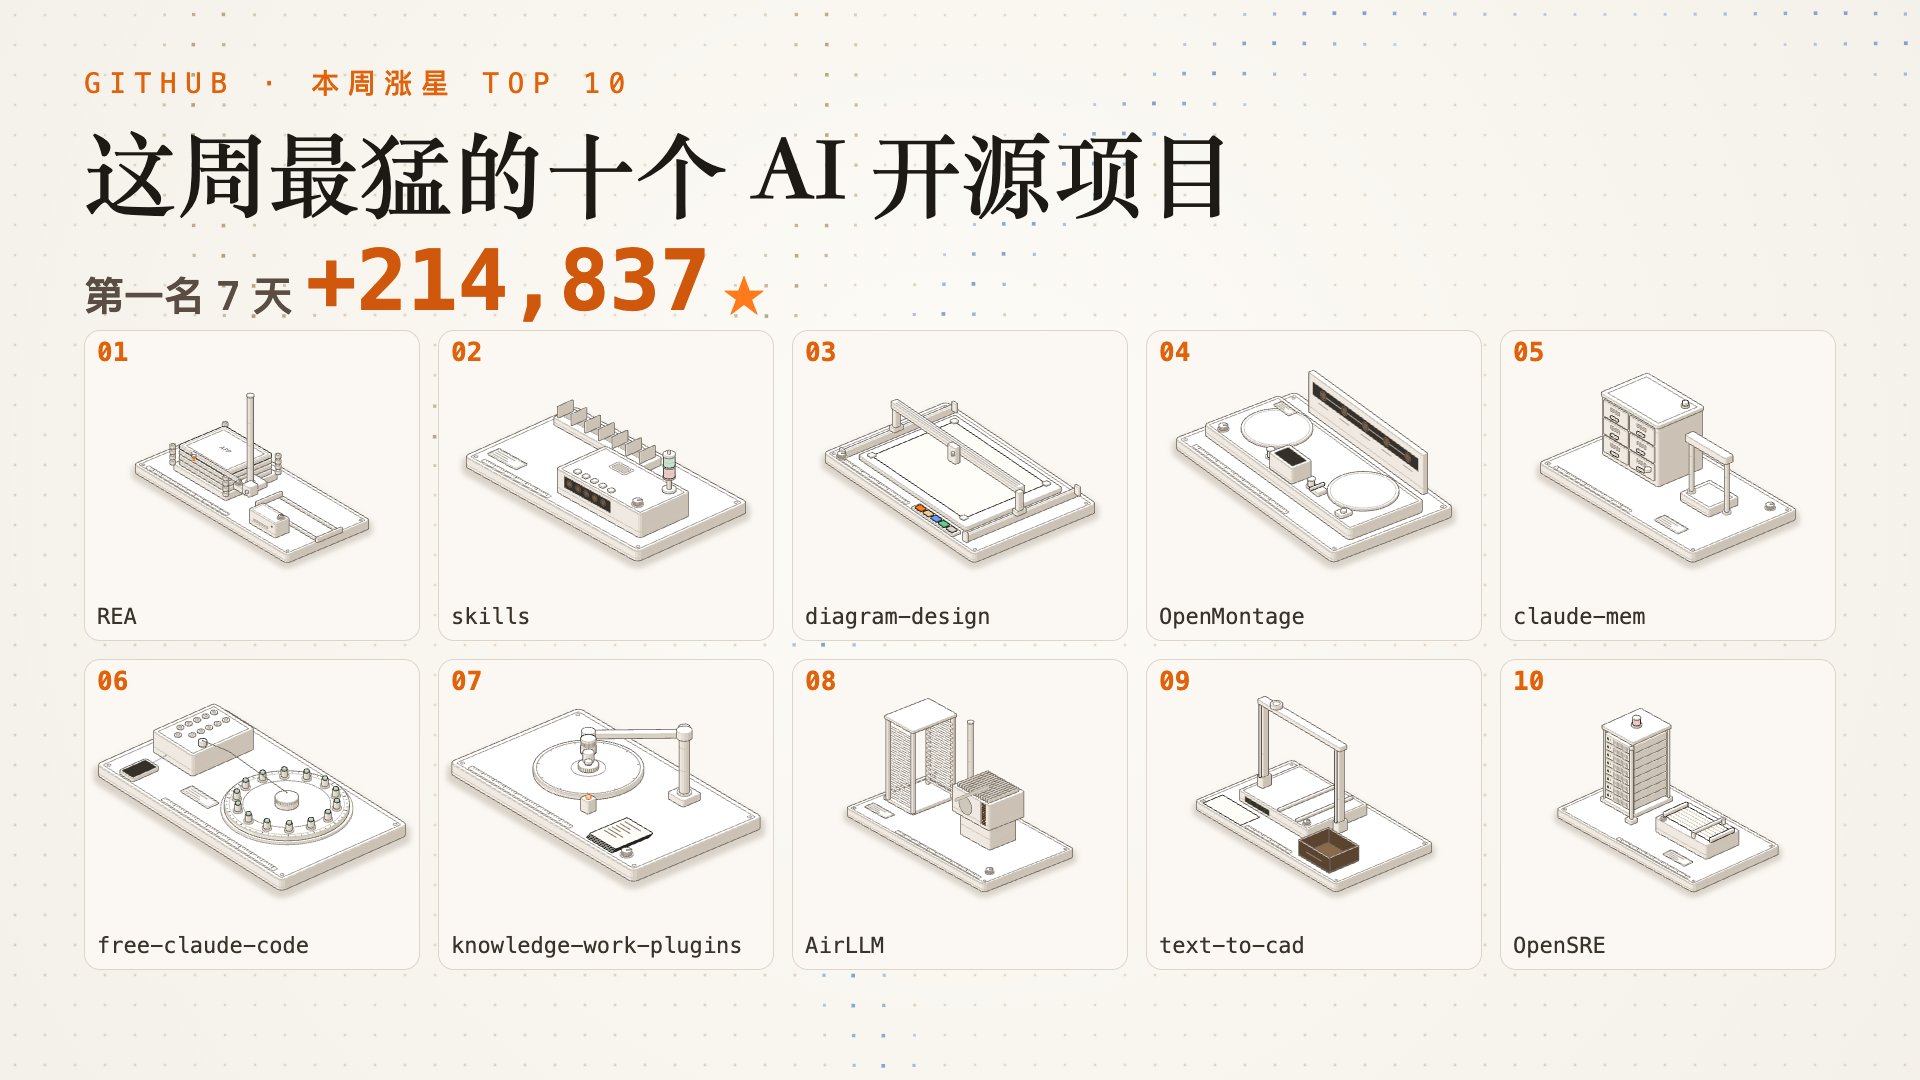
这周 GitHub 涨得最猛的十个 AI 开源项目

文章盘点了本周 GitHub 上增长最快的十个 AI 开源项目:REA 可用 AI 逆向分析任意应用;Matt Pocock 的 skills 提供工程化 AI 编程技能;diagram-design 教 AI 画出专业图解;OpenMontage 把编程助手变成 AI 视频工作室;claude-mem 为 AI 增加长期记忆并节省 token;free-claude-code 汇聚免费模型额度让 AI 编程工具零成本使用;Anthropic 官方 knowledge-work-plugins 面向非程序员岗位;AirLLM 让小显存跑超大模型;text-to-cad 一句话生成可加工的 3D 零件;OpenSRE 让 AI 承担线上运维值班工作。

兄弟们,我耗费5天把 REA 和原生 Codex 对跑了 108 次:它到底给 Codex 增加了多少实际能力?

作者耗时5天对 REA 增强版 Codex 与原生 Codex 进行了108次对照实验,其中35对可同条件比较。文章详细记录了三个阶段:首先是六次小型探索,测试笔记导出、桌面应用复制、.NET 计价函数复现三组任务,两边均通过全部用例但 REA 组耗时略长;随后扩展至六档难度、两种模型共72次正式运行。文章分析了 REA 作为调查工具为模型提供的模块关系、函数位置等线索,以及原生 Codex 借助普通工具自行调查的能力,指出在小规模任务中两者能力差距不明显,差异更多体现在调查入口和验证路径上,并对实验边界与结论适用范围做了严谨说明。

技术 › Codex 阿良|AI 工作流 2026-10-1735.8 KB 2.1K 10 82

AI科研时代,人的价值在哪里(三):论文写作

作者探讨AI时代论文写作中人的价值。工程类论文因研究贡献明确、方法论可显性提取,AI较易介入;人文社科论文则依赖研究者的中心判断与叙述节奏,AI容易局部正确、整体失焦。好论文是各章节互相回应的整体,人的核心价值在于拥有作者性——决定文章要证明什么、如何取舍论证路径。作者建议将论文写作当作系统工程,通过结构化文献综述、显性记录研究意图、明确章节任务、提供参考论文、最后处理语言等方式合理利用AI,但研究者不能把作者性外包出去。

技术 › LLM Erwin 2026-10-166.1 KB 1.4K 12 74

2026 年 X 上最值得关注的 100 个 AI 博主(全球精选榜单)

作者基于多年使用 X 的经验,筛选并整理出 100 个含金量最高的 AI 相关账号,涵盖 OpenAI、Anthropic、Google DeepMind 等实验室掌舵人与官方号、产品负责人、顶级研究者、AI 编程与 Agent 实践派、开源与基础设施团队,以及近半数的中文一线 AI 实战博主。榜单分为 10 组(英文 6 组、中文 4 组),每个账号均附推荐理由,强调直接获取一手 AI 信息、避免二手信息差的价值。

技术 › LLM 司 司徒K 2026-10-1630.1 KB 55.4K 490 72

Gemini 4 的提示词技巧,就是没有技巧(附 7 段提示词)

文章分享 Google Gemini 4 Argon 的使用心得:它不看措辞技巧,关键是把目标、标准和材料交代清楚。作者整理了 7 段可直接套用的中文提示词模板,涵盖:先挑思考档位;开工前让 AI 主动提问对齐目标;给出可逐条打勾的完成标准让其自查;提供参考样例或先拆解风格说明;一次交代完整任务后放手后台运行;干完复盘并将经验存成技能;大任务让 Argon 当总指挥、分派给 Flash 子代理并行执行。文末给出三件今天就能见效的建议。

技术 › LLM 路飞 AI 研究员 2026-10-159.4 KB 9.4K 68 76

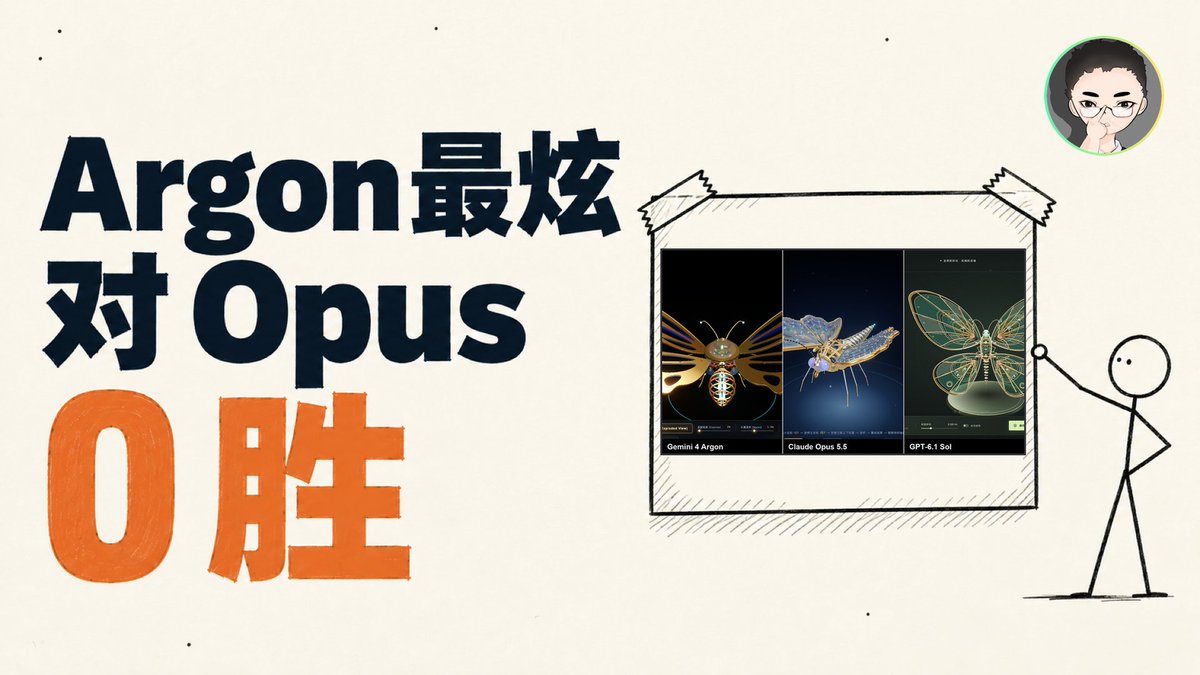
Gemini 4 Argon 对 Opus 5.5、GPT-6.1 Sol:同样 12 道题,3 道打开就坏

作者用同样的 12 道题横向实测 Gemini 4 Argon、Claude Opus 5.5 与 GPT-6.1 Sol。Argon 在 Gemini 网页 App 中闭卷盲打,另两家则通过 Claude Code 与 Codex 命令行 Agent 拥有自测调试的工作流。结果 Argon 对 Opus 0 胜 5 平 7 负,对 GPT 2 胜 4 平 6 负。失分分两类:铁路、咖啡店、四季三题毁于作用域未定义、少打空格、404 地址等小错,补一两行即可运行,根源在 App 环境无法自测;而机械蝴蝶连杆伸缩、折纸裂开、书封视觉误读、西瓜过曝等属于硬伤。Argon 在视觉题与原创游戏上表现出色,Pro 额度也较充裕。

技术 › LLM Axton 2026-10-1520.6 KB 4.9K 7 81

CodeX 额度不够用?一招让它多干 10 倍活【附 6 段配置】

文章介绍如何通过配置优化 Codex 的额度消耗:主线使用贵的 GPT-6.1 Sol 负责思考决策,把读文件、搜代码、跑测试等杂活派给单价仅为二十分之一的 GPT-6 Luna 子代理。作者给出 6 段配置:让 Codex 自动配置、设置默认子代理模型、创建只读侦察兵 scout 和执行修理工 fixer 两个子代理、在 AGENTS.md 写入自动派活规则、日常派活提示词,以及在 ChatGPT 普通聊天中先聊透需求生成任务单。还提醒避免 Fast 模式、滥用子代理等白烧额度的坑,附具体配置文件与提示词模板。

技术 › Codex 路飞 AI 研究员 2026-10-148.7 KB 10.6K 77 82

AI 落地的四道坎 -- 本体、评估、信任、维护 | 峰会洞察 02

本文是硅谷101 Alignment 峰会 Day 1 下半场的深度纪要,总结出 AI 落地的四道坎:本体、评估、信任、维护,且四道坎都不在模型本身。机器人领域模型大小被物理参数封顶,数据质量与多样性之争可统一为数据金字塔,触觉数据与跨本体抽象是关键;世界模型定义仍在发散,AMD 收购 World Labs 释放垂直整合信号,评估工具的缺失是最大短板;Agent 的真正瓶颈是信任而非模型,企业需渐进开放权限,云端 agent 基础设施有大量脏活,交互范式需摆脱聊天框。作者结合一线信号给出创业与投资判断。

技术 › Agent Cloris 2026-10-1388.1 KB 8.2K 22 82

我们复现了那个决策模型教程

作者复现 Nish Tahir 的《Build your own decision model》教程,在 CommonsenseQA 上验证基于语言模型单次前向读取选项 token 概率作为置信度的决策模型方法。复现发现教程方法成立但需补两个关键前提:读数位置必须放在 assistant 轮,模型需用 8B 而非 1.7B。温度缩放校准有效,而微调增益主要来自修正 harness。作者还将方法应用于素材席位判定任务,发现模型间一致标签不等于准确率,结论需以人工标签为准。核心启示:核对读数位置的概率质量、报告覆盖率、用独立数据拟合温度。

技术 › LLM yibie 2026-10-128.2 KB 1K 4 85