Wiki 知识库

全部文档 / 标签: Qwen

47 篇
清除

Parallel Search 推出 Fast 模式:面向 AI 的高性价比网页搜索

Parallel 推出面向 AI agent 的 Fast 模式网页搜索,价格仅为主流模型默认搜索的十分之一,每千次查询 1 美元,在质量-成本和质量-延迟上均处于 Pareto 前沿,准确率接近 SOTA 的 Parallel Advanced。独立评测显示其端到端成本比 Brave、Exa、Tavily 便宜 2 倍以上。文章指出随着 GPT-5.6 Luna、DeepSeek V4 等高性价比模型普及,AI 智能成本数月内下降 8-12 倍,廉价模型需要廉价搜索,Parallel Fast 旨在提升 agent 每美元的有效工作量。
技术 › Agent Parag Agrawal 2026-08-224.5 KB 128.4K 436 65

最强的矛与盾:本地部署大模型到底该买什么

本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。

技术 › LLM 实践哥MinLi 2026-08-1830.4 KB 298.1K 264 89

8款前沿大模型能力横评:10个维度50项测试全解读

本文对8款前沿大模型进行了为期两天的深度横评,通过10个维度、50个细项的两轮测试,对比了模型在一次性复杂任务与拆解任务稳定性上的表现。文章详细解读了测试方法、评分标准及各模型优劣势,最终得出了适用于真实工作流的参考结论。

技术 › LLM huangserva 2026-08-1729.7 KB 30.7K 43 86

BestBlogs 早报 · 08-17|设计师焦虑、RAG 持久化与 Kalanick 实体自动化方法论

本期早报包含三个核心话题:Lenny 调研显示设计师焦虑源于角色期望不清,OpenAI 产品负责人提出双速节奏与 Do Less 策略;技术方面探讨 RAG 系统设计持久化知识层以解决推理成果丢弃问题;商业部分复盘 Travis Kalanick 的实体自动化方法论及滴滴补贴战经验。此外涵盖 Qwen 3.8 过度思考问题、Agent 优化陷阱及 API 降本策略等速览内容。

技术 › LLM ginobefun 2026-08-1734.5 KB 17.7K 4 81

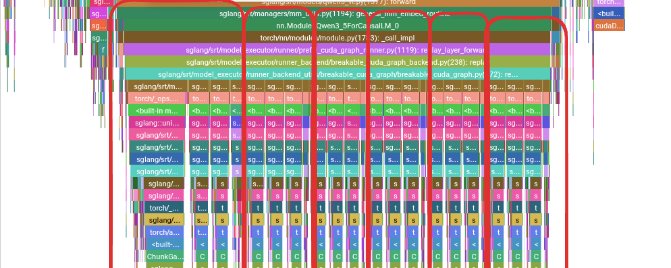
使用 SGLang 和 Torch Profiler 对 LLM 推理进行性能分析

本文详细介绍了如何使用 SGLang 内置的 Torch Profiler 对大语言模型(Qwen3.5-0.8B)进行推理性能分析。作者阐述了如何通过追踪 CPU 和 GPU 端事件来定位计算瓶颈,并结合屋顶线模型证实单批次解码主要受限于内存带宽。文中展示了如何利用 Perfetto UI 分析 Prefill 阶段的性能追踪数据,将其底层计算操作与模型的混合架构(如 Gated DeltaNet 和全注意力机制)精准映射,帮助读者深入理解 LLM 的底层执行流程。

技术 › LLM Jino Rohit 2026-08-0913.8 KB 104.1K 916 88

本地大模型小白从0到1完整入门教程

本文是一篇面向新手的本地大模型运行与部署全攻略。文章首先对比了云端与本地模型在隐私和成本上的差异,随后用通俗易懂的语言拆解了模型命名、参数量(B)、量化压缩(Q4_K_M)等核心概念。教程详细指导了如何根据显存计算并选择合适的硬件与模型,并推荐了LM Studio与ComfyUI等无代码软件。最后,针对文本对话、图像及视频生成三大场景,提供了具体的模型选型建议与实战评测方法,帮助小白零基础快速玩转本地AI生态。

技术 › LLM 黄小木 2026-08-0620.3 KB 186.2K 291 89

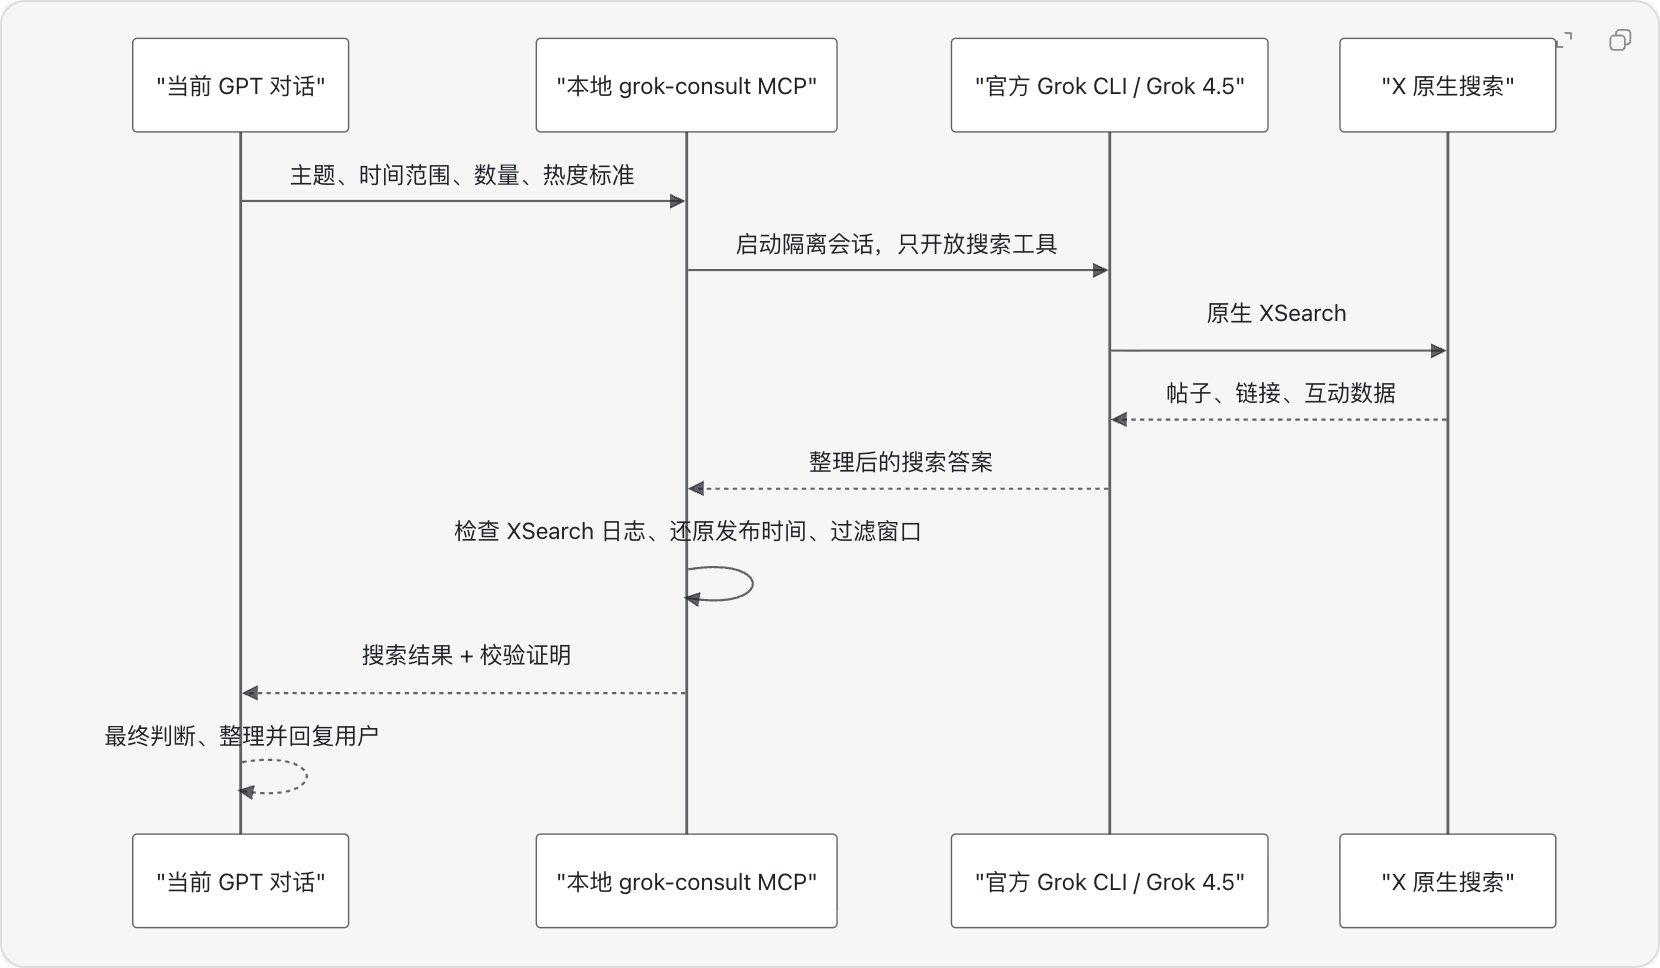
舒服了Codex不用切换Grok模型我直接把Grok封装成了一个Skill而且通过解密算法把推文具体时间也算了出来

作者分享了将Grok模型封装为Codex中的Skill,通过解密算法计算推文具体时间的实践。GitHub地址已开源,Skill合集突破1000星。此外,还提及了用Qwen3.8-Max预览版复刻Obsidian知识库,以及WAIC会议关于出海市场机会的观点。

技术 › Skill 逸尘 2026-08-053.2 KB

BestBlogs 早报 · 08-04|从 Qwen 长程能力、生产推理到办公智能体,模型如何进入真实工作

本期早报深入探讨模型进入真实工作的实践路径。精讲内容涵盖 Qwen3.8-Max 的长程自主工作与评测、Baseten 的生产推理工程取舍,以及腾讯、阿里、字节在 AI 办公领域的组织竞争。此外,还速览了 OpenAI GPT-Live、MiniMax H3 开源、Agent 框架及 SQLite 安全等前沿动态。

技术 › LLM ginobefun 2026-08-0424.5 KB 4.1K 2

训练小模型:2026 年最被低估的 AI 技能

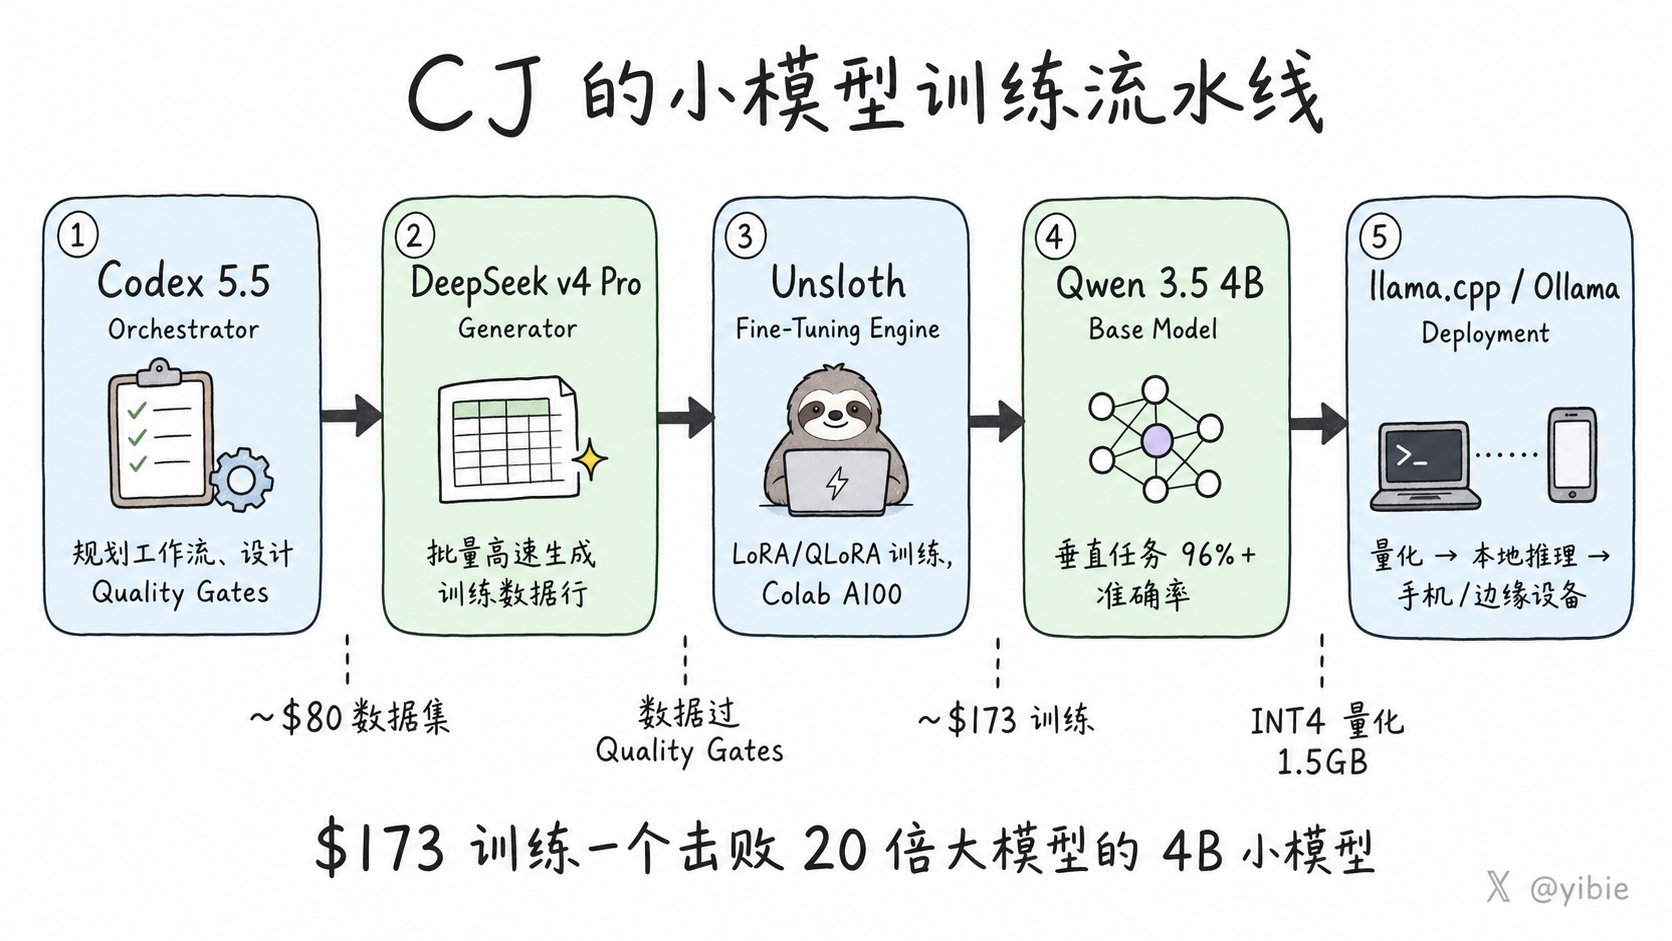
本文探讨了 2026 年 AI 领域的边缘趋势:个人开发者训练小模型(SLM)。文章详细介绍了 CJ Zafir 的方法论,即利用 Codex 和 DeepSeek 生成数据、Unsloth 进行训练、Qwen 作为基座,以极低成本(最低 11 美元)在垂直任务上超越大模型。文章指出,真正的护城河在于高质量数据集的生成工厂,而随着硬件门槛降低和工具成熟,模型微调正从企业军备竞赛转向个人技能。

技术 › LLM yibie 2026-06-028.1 KB 88

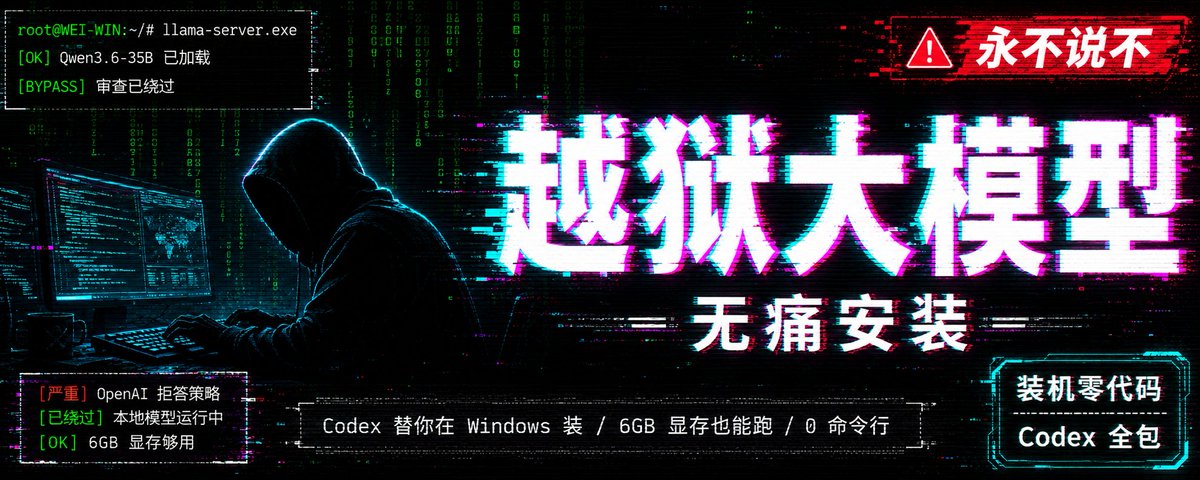
35B 越狱版大模型:Codex 替你装,6GB 老卡也能跑

本文介绍了一种利用 Codex 桌面应用在 Windows 上本地部署 35B 无审查大模型的方法。通过 llama.cpp 和 MoE 架构的量化模型,即使用户只有 6GB 显存的显卡(如 GTX 1660)也能以 30 t/s 的速度流畅运行。文章详细讲解了无需命令行知识、利用 Codex 自动完成环境配置、模型下载及脚本编写的全流程,实现了零门槛的本地高隐私 AI 体验。

技术 › Codex Wei 2026-05-2823.3 KB 129.4K 232 92

隆重推出 Violin:一款开源视频翻译技能

作者推出了名为 Violin 的开源视频翻译技能。该工具结合了语音识别(ASR)、LLM 翻译和语音合成(TTS)技术,旨在打破高质量视频内容的语言壁垒。Violin 支持个性化翻译、多语言处理及与视频互动,提供 Web、CLI 和代理技能等多种使用方式,并已在 MIT 协议下完全开源。

技术 › LLM Kevin Lin 2026-05-152.5 KB 58

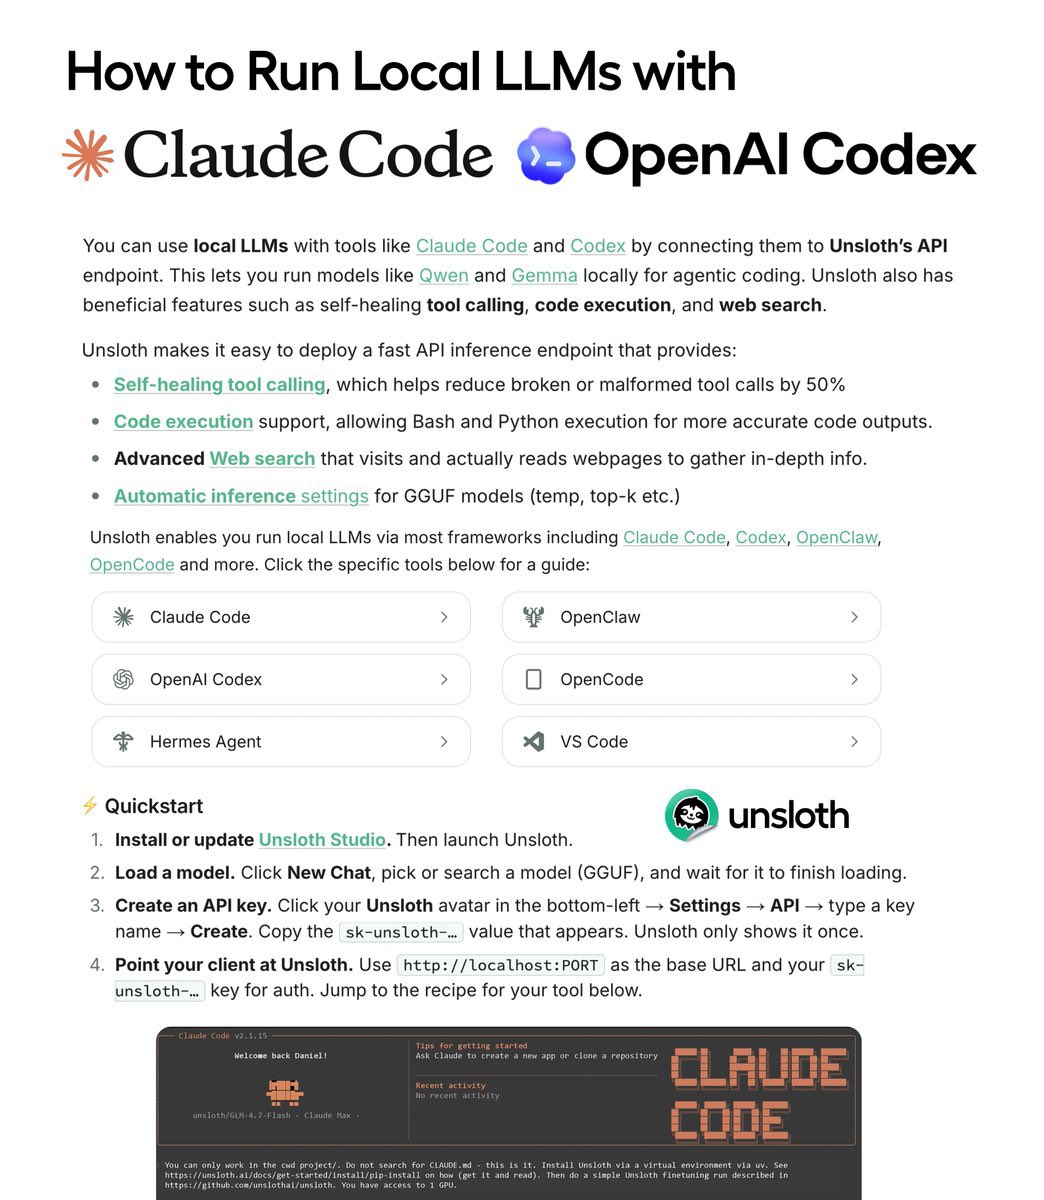
AI开发工具新突破:Unsloth与Google Code Wiki

文章介绍了两项针对开发者的重磅AI工具更新。首先是Unsloth发布了指南,允许使用Gemma 4和Qwen3.6等开源模型,在24GB显存的本地机器上运行Claude Code的Agentic Coding工作流,实现了隐私、成本与交互体验的兼顾。其次是Google推出了Code Wiki,利用Gemini自动扫描GitHub仓库生成实时更新的智能Wiki,支持架构图生成和代码溯源,旨在解决软件开发中“读代码”的昂贵瓶颈。

技术 › DevOps Berryxia.AI 2026-05-063.0 KB 72

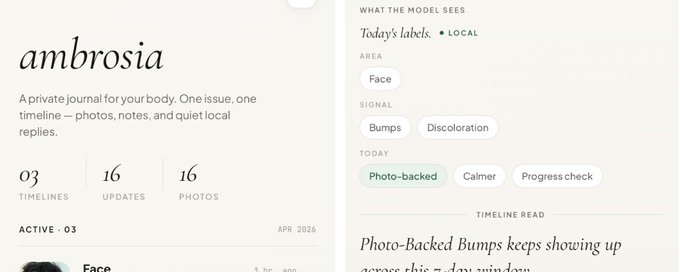
全链路本地化 AI 应用实践:从端侧微调到 Ambrosia

作者构建了名为 Ambrosia 的离线 AI 护肤日记应用,全过程在本地设备完成。文章探讨了端侧模型在硬件适应性、成本及隐私方面的优势,详细记录了基于 Qwen3-VL-2B 模型在本地 MacBook 上进行 LoRA 微调并在 iPhone 上部署的实践,强调了针对特定任务约束小模型比通用助手更高效,展望了边缘智能与算力结合的未来。

技术 › LLM Aman 2026-04-2411.3 KB 798.4K 913 85

RTX 3090 上实现 Qwen3.5-27B 模型 207 tok/s 推理速度的技术实践

文章介绍了如何通过构建独立的 C++/ggml 推测解码器,在单张 RTX 3090 (24GB) 显卡上实现了 Qwen3.5-27B (Q4_K_M) 模型的高效推理。利用 DFlash block-diffusion draft 和 DDTree 验证器,成功将峰值解码速度提升至 207.6 tok/s,较自回归基准提升约 5.46 倍,并实现了在有限显存下运行 128K 长上下文的能力。

技术 › LLM Sandro 2026-04-2116.5 KB 218.8K 925 88

阿里Qwen-Image-2.0发布实测:超长上下文与精准中文渲染

本文是对阿里最新发布的千问图像模型 Qwen-Image-2.0 的深度实测报告。文章详细介绍了该模型在提示词长度支持(1k token)、中文文字渲染准确性、指令遵循能力以及2K高清直出等方面的显著提升。作者通过水煮肉片菜谱、人物写真、PPT制作、信息图生成等12个具体场景的实测案例,展示了模型在复杂排版和中文语义理解上的优势,同时也指出了相较于Banana Pro在自主审美和推理能力上的不足。

技术 › LLM 苍何 2026-02-1411.9 KB 23.3K 93 78