Wiki 知识库

全部文档 / 标签: RAG

205 篇
清除

让AI从新人变成长期的同事——硬核拆解Alloomi的三层技术路线

作者通过分析Alloomi的两篇技术报告,拆解了让AI具备长期工作能力的三层技术路线:记得住、学得会、做得成。第一层通过给信息打标签、时间有效期管理和连接强化构建持久化上下文记忆(OpenContext已开源);第二层通过经验池筛选、微调飞轮和Engram X设计将经验写入模型权重实现自我进化,并配有三裁判安全阀机制;第三层在SWE-Bench-CL、JobBench、GDPval等基准上验证端到端交付能力。三层构成可回滚的闭环,让AI每完成一次交付就变强一点。

技术 › Agent AI少年 2026-08-1815.9 KB 19K 73 74

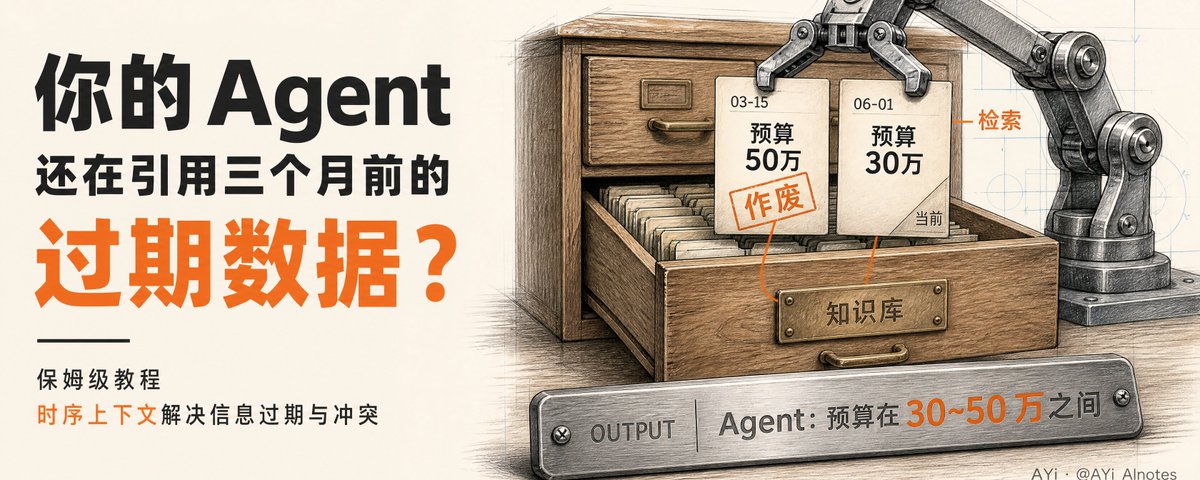
RAG 治不了 Agent 记忆过期:时序上下文的四个机制与开源路线实操

文章剖析了标准 RAG 在处理新旧事实冲突上的结构性缺陷:向量检索没有时间轴、不理解'取代'关系,只能把矛盾甩给模型猜测。作者提出时序上下文的四个核心机制——有效期标记、取代关系、软删除与遗忘、审计日志与证据链,并以 Graphiti 和 OpenContext 两条开源路线为参照讲解落地方式。OpenContext 提供基于时序上下文图的 remember/recall/improve/forget 四动词 API,在数据层解决事实过期问题;Graphiti 则专注作为可插拔的时序知识图谱记忆引擎。文末用律所预算变更案例演示了完整代码流程。

技术 › Agent AYi 2026-08-1822.8 KB 63.8K 159 86

万字长文:知识库从入门到精通

文章系统讲解知识库的进阶路径:从最轻的文件上传开始,到 iMA、飞书知识问答承接多文件场景,再用 Obsidian 将资料沉淀为个人判断,进而用 LLM Wiki 让 Agent 自动维护知识库,最后进入企业级 RAG 阶段。作者详细介绍了各阶段的关键实践,包括提示词设计、目录结构、切片与检索策略、权限控制、评测方法等,强调知识库的核心是在模型回答前找到可靠材料,并保留来源、暴露冲突、允许拒答。

技术 › LLM Miles Ma 2026-08-1829.6 KB 104.3K 414 87

AI 闯关学习小程序项目完结:用 DeepSeek 打造可上线的微信小程序

程序员鱼皮宣布其编程导航新项目教程《AI 闯关学习小程序》完结。项目基于 Taro + Python FastAPI + LangChain + DeepSeek,用 AI 编程(Vibe Coding)方式从 0 到 1 开发可将任何知识变成闯关游戏的学习小程序。功能涵盖 AI 联网搜索出题、闯关答题即时讲解、AI 复盘报告、RAG 私有知识库出题、AI 题目配图、微信静默登录等,并走完 Docker 部署与小程序上线全流程。项目代码已完整开源,同时提供视频、文字教程及简历写法和面试题解,帮助求职者提升竞争力。

技术 › Agent 程序员鱼皮 2026-08-1811.2 KB 11.7K 55 56

企业真正缺的不是知识库,而是能自己把事办完的数字员工

文章指出企业更需要能自主推进任务的数字员工而非简单的问答机器人。作者利用腾讯云 ADP 4.0 搭建了一个运营商客服数字员工,验证了从自然语言配置、Agentic RAG 检索、多轮对话收集信息到生成工单及运营监控的全链路能力,强调了 AgentOps 平台在企业落地中的实际价值。

技术 › Agent 泊舟 2026-08-1714.5 KB 47.3K 68 79

BestBlogs 早报 · 08-17|设计师焦虑、RAG 持久化与 Kalanick 实体自动化方法论

本期早报包含三个核心话题:Lenny 调研显示设计师焦虑源于角色期望不清,OpenAI 产品负责人提出双速节奏与 Do Less 策略;技术方面探讨 RAG 系统设计持久化知识层以解决推理成果丢弃问题;商业部分复盘 Travis Kalanick 的实体自动化方法论及滴滴补贴战经验。此外涵盖 Qwen 3.8 过度思考问题、Agent 优化陷阱及 API 降本策略等速览内容。

技术 › LLM ginobefun 2026-08-1734.5 KB 17.7K 4 81

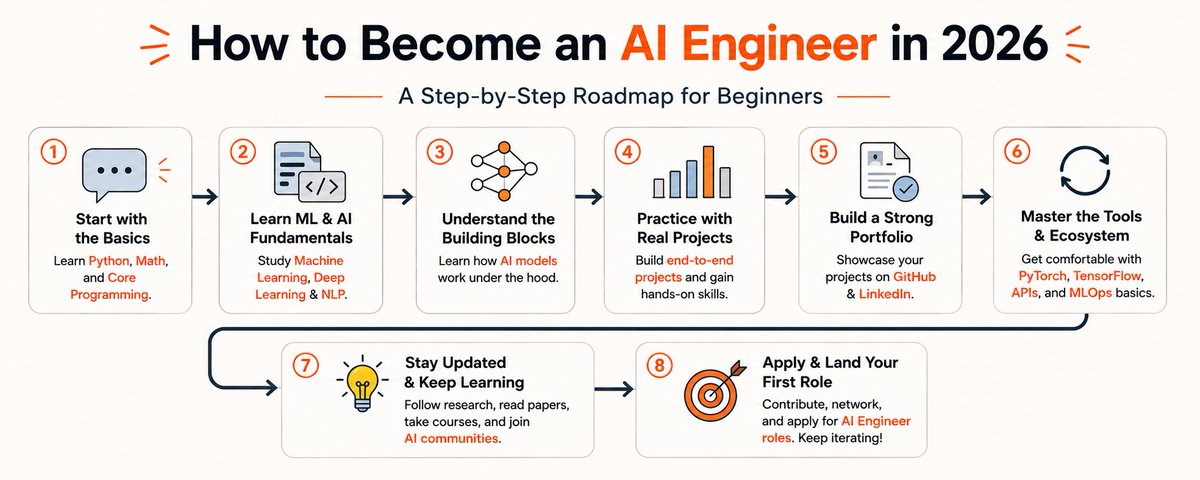
How to Become an AI Engineer in 2026

本文是一份实用的指南,旨在帮助读者在2026年成为一名AI工程师。文章指出,传统的学习路径已不足以应对当前需求,AI工程师的角色已演变为构建可靠、可扩展的生产级AI系统。文章详细介绍了AI工程师的核心职责、所需技能(如Python、SQL、机器学习、LLM与Agent、数据工程、MLOps等),并提供了一个分四阶段的学习路径:基础、现代AI技能、生产与工程技能、专业化与作品集。此外,还列出了必备工具与框架(如LangChain、CrewAI、向量数据库等)以及建议的实战项目,帮助读者构建有竞争力的作品集。

技术 › LLM Swati Gupta 2026-08-1512.3 KB 483.4K 130 77

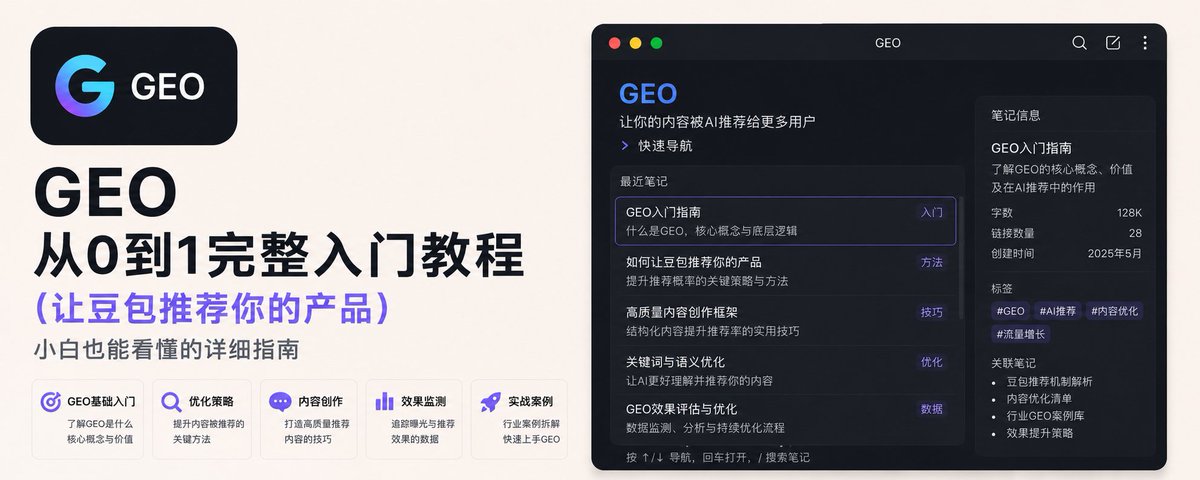
GEO 从 0 到 1 小白完整教程(让AI推荐你的产品)

本文是一篇面向AI产品从业者的GEO(生成式引擎优化)入门教程。文章首先解释了GEO的概念及其与SEO的区别,指出在AI搜索时代,流量入口已从搜索引擎转向AI问答,因此产品必须被AI引用才能获得曝光。随后,文章分析了适合做GEO的生意类型和入场条件,并深入剖析了AI推荐内容的机制(RAG技术、三层漏斗、核心公式)。接着,文章提供了详细的实操指南,包括如何撰写AI友好的结构化内容(四个模板、三个信任钩子、四条红线)、如何搭建独立站并配置Schema、robots.txt和llms.txt,以及如何进行内容布局和选题。最后,文章介绍了如何通过人工测试判断GEO效果。全文强调真实、结构化和数据背书,为读者提供了一套完整的GEO落地方法论。

技术 › 工具与效率 黄小木 2026-08-1521.0 KB 677.1K 1.7K 82

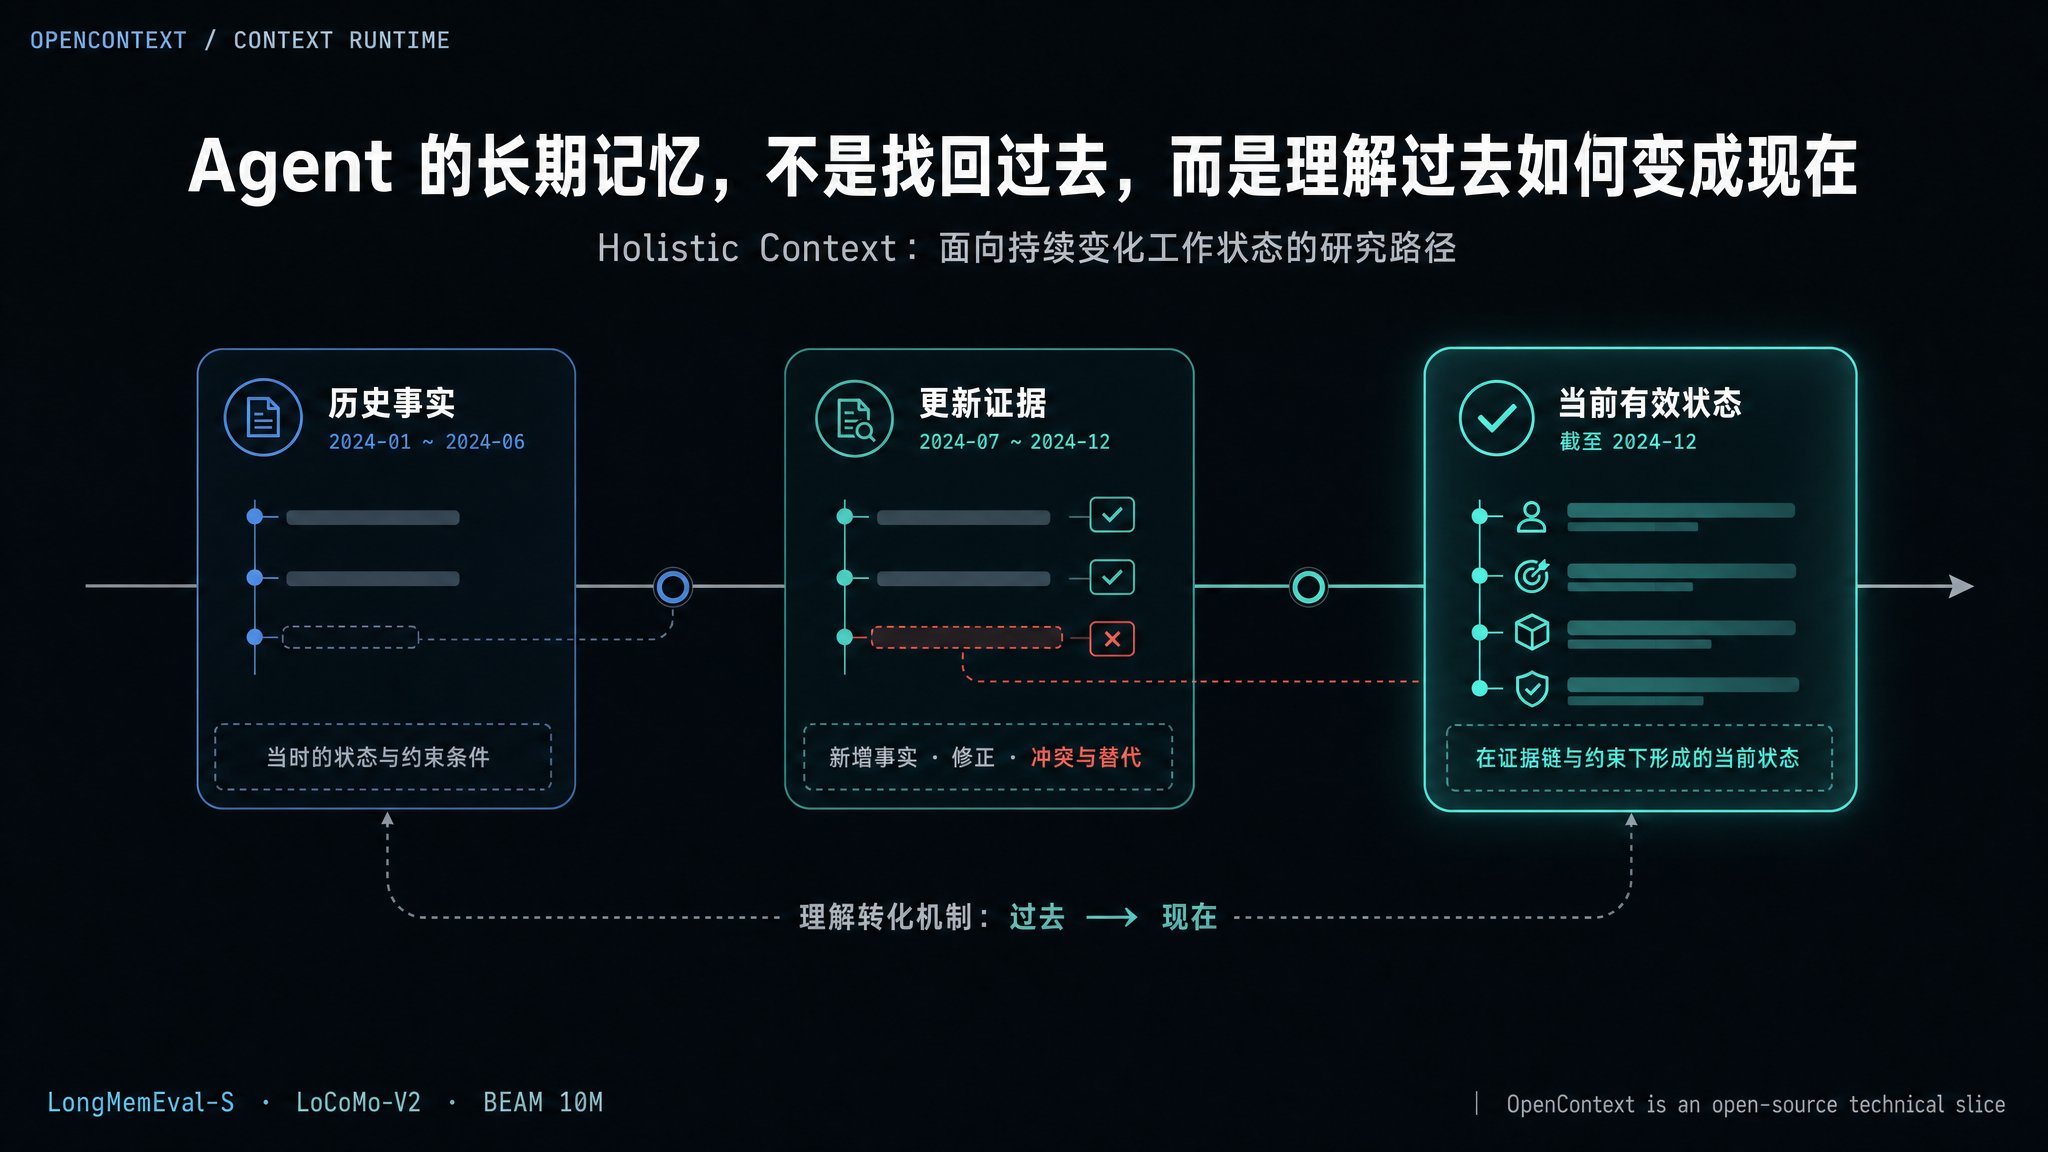
Agent Memory 的下一步:从检索到状态演变

本文探讨了Agent长期记忆的核心问题:不仅仅是找回过去的信息,更要理解信息的时效性和演变过程。作者以Alloomi的Holistic Context研究为例,指出长期Agent面临的关键挑战是判断信息是否仍然有效,以及理解过去如何演变成现在。文章区分了检索回答与长期上下文回答,并介绍了Holistic Context在信息更新、跨时间关系和大规模历史理解方面的研究成果。作者强调,长期Agent的能力不应仅由记忆容量衡量,而应关注其从经验中学习并转化为复杂任务交付的能力。

技术 › LLM MapleShaw 2026-08-1429.2 KB 66

百万级文档RAG实战:检索质量由重排和查询改写决定,模型选型反而是小事

本文总结了HN上关于RAG系统实战的讨论,核心结论是检索质量主要由重排和查询改写等流程环节决定,而非模型选型。文章整理了微软Pamela Fox和Usul AI作者Abdellatif等一线工程师的学习清单,涵盖生产级RAG的ROI排序、检索理论、开源模板、模型评测、存储基础设施及产品案例,并指出query generation和reranking是性价比最高的优化点,chunking最耗时。

技术 › LLM yibie 2026-08-136.4 KB 77

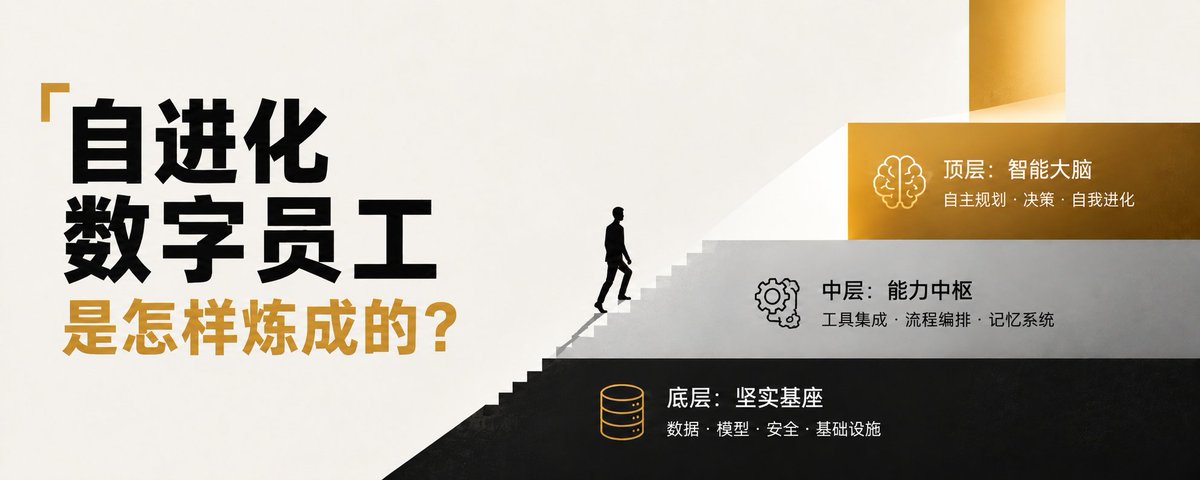
「自进化数字员工」是怎样炼成的?拆解 Alloomi 的三层技术路线

本文深入探讨了AI Agent从“记忆”到“学习”的进化路径,指出传统RAG方案在长周期业务中的局限性,并详细拆解了Alloomi提出的三层技术路线:任务层(Holistic Context)、脚手架层(MAPE控制环)和模型层(Self-Evolving Agent)。通过九项Benchmark验证,展示了该方案在长期记忆、持续学习和真实任务交付上的显著提升,提出了数字员工应具备“记得住、学得会、做得成”三类能力的观点。
技术 › Agent Lonely 2026-08-1312.0 KB 53.2K 101 73

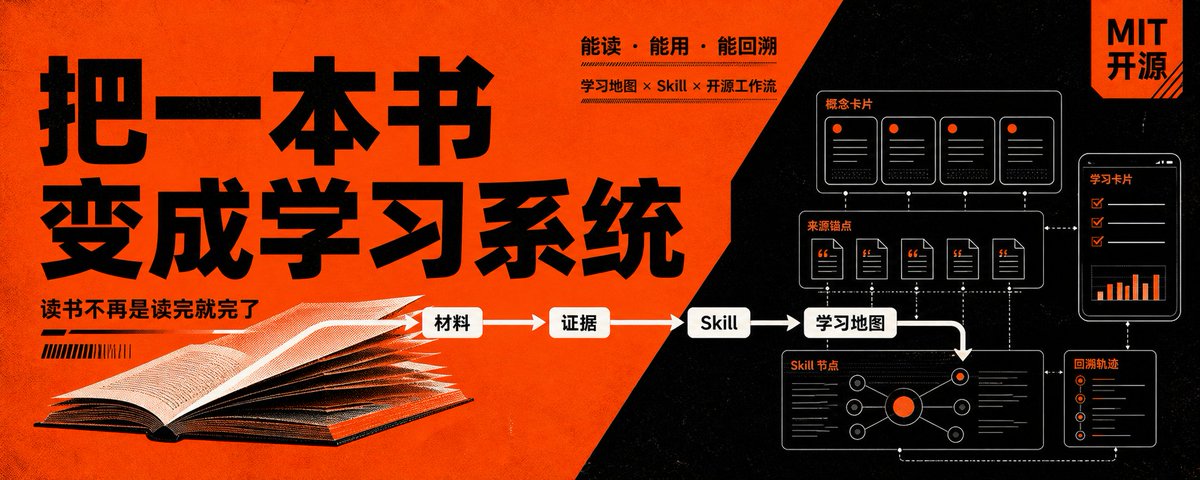
读书不再是读完就完了|我把《纳瓦尔宝典》变成了可调用的学习系统

本文介绍作者如何将《纳瓦尔宝典》转化为一个可调用的个人知识系统,包括构建Markdown证据层、生成学习地图和Skill、部署到Cloudflare Pages等。作者强调摘要、RAG和模仿作者聊天的不足,提出一套从原始材料到可持续交付的完整工作流,并开源了相关代码。文章详细阐述了系统逻辑、实施步骤和实际效果,旨在帮助读者建立自己的知识资产。
技术 › 工具与效率 Su 2026-08-1223.7 KB 39.6K 359 82

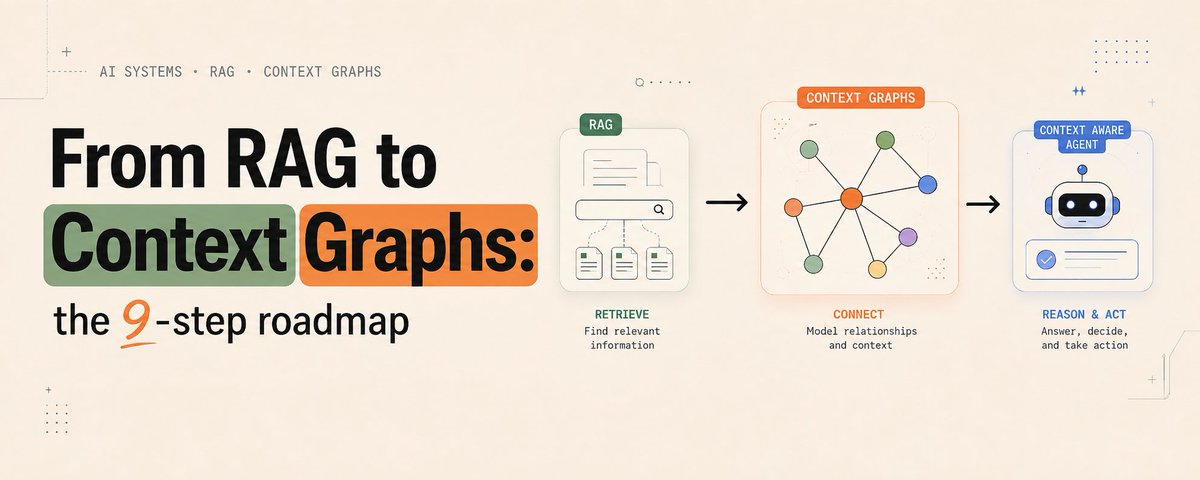
从RAG到上下文图谱:9步路线图

文章探讨了传统RAG在处理多跳推理问题时的局限性,指出检索文本块无法捕捉复杂的实体关系链。为此,作者提出了一种向“上下文图谱”转型的9步实施路线图。该方法通过从文本中提取实体与关系三元组,进行实体规范化以避免图谱割裂,并构建双向边表。图谱通过多源验证分配边权重,并为每条边附加来源以实现精准溯源。最终,检索过程转变为图谱遍历,通过反向可达性分析和路径权重排序,精准定位多跳查询的答案。

技术 › LLM Morlex 2026-08-1011.5 KB 310.6K 465 83

重新理解企业 RAG:从知识工程到 AI 基础设施

本文指出企业级 RAG 绝不仅是简单的文档切块与向量检索,而是一项复杂的知识工程。文章详细拆解了知识入库与用户提问两条流水线,强调了 PDF 结构化解析、混合搜索及权限更新的重要性。在 AI Coding 时代,底层代码可交由 Agent 完成,开发者应更关注 RAG 的架构设计。最终,企业 RAG 的核心价值在于构建一层可被 AI 调用的知识基础设施,从而支撑各类业务 Agent。

技术 › LLM Builder (@UPing123zzz) 2026-08-103.6 KB 71

企业AI落地,需要的不是一个知识库,而是一台“知识引擎”

文章指出,企业AI落地仅靠大模型和传统知识库是不够的,面临问法改变即失效、权限越界、引用失效等瓶颈。企业真正需要的是一套包含知识接入、工程加工、治理管控、应用调用和反馈优化的“AI知识引擎”。它能将繁杂的企业资料转化为可信、可追溯、可复用的上下文,为人和各类业务Agent提供稳定支撑,从而在AI深水区构筑核心竞争力。

技术 › Agent 土猛的员外 2026-08-1023.6 KB 21.3K 93 86

企业级 AI 的权限管理挑战

随着企业将各类信息接入统一的 AI 知识库,传统的基于文件的权限管理已完全失效。文章指出,知识的提炼与综合改变了权限的底层逻辑:权限的粒度应从“文件”转变为提取出的“观点或信息”。同时,AI 必须具备上下文理解能力,既要让有价值的经验突破原始隐私边界实现共享,也要懂得“选择性遗忘”无关或敏感的闲聊,以避免引发寒蝉效应。此外,AI 交互轨迹应被视为新型企业记忆保存,并需着重解决知识归属与隐私权限的分离问题。

技术 › Agent conor brennan-burke 2026-08-1014.9 KB 140.1K 367 78

从 0 到 1 入门 FDE系列教程(一):FDE到底需要会什么技能

本文探讨了在AI时代,FDE(全栈交付工程师)如何整合业务咨询、算法、工程与交付等多个职能。作者结合自身转型经验,指出FDE需具备业务洞察、客户筛选、沟通落地及端到端技术工程能力。文章系统梳理了从需求收窄、RAG治理、Agent权限控制到部署压测、生产发布及最终知识转移的完整闭环,强调技术落地必须与组织采用相融合,为AI企业级落地提供了实操指南。

职场 › 职业发展 Miles Ma 2026-08-0916.3 KB 57.1K 141 94

AI 名词小白入门白皮书

本文专为缺乏技术背景的AI初学者撰写,旨在理清AI领域的常见名词。作者将AI系统划分为七个层级,详细拆解了从大模型、产品、Token、RAG、MCP到Agent、Workflow、Loop和Graph等核心概念。文章指出新手常犯的认知混淆,并通过具体的任务案例展示AI系统的工作流程。最后,为初学者提供了从分清对象到理解工具执行的实用学习路径,帮助读者建立完整的AI概念地图。

技术 › LLM Kimberly 2026-08-0921.3 KB 31K 150 88

Claude + Obsidian + Nvidia: The On-Premise RAG Build, Step by Step

本文详细介绍了如何为企业客户构建一套本地化、注重隐私的私有RAG(检索增强生成)文档搜索系统,以解决律所、诊所等敏感行业的数据合规问题。系统利用客户端本地的Nvidia GPU通过Ollama运行大语言模型,结合Obsidian作为交互界面,实现内部文档的高效检索。文章按步骤指导如何配置环境、使用MarkItDown转换档案为Markdown格式,并巧妙利用Claude辅助编写脚本。这是一项极具商业价值的本地部署服务模式。

技术 › Agent Nazar 2026-08-0913.4 KB 5.6K 7 90

2026年AI Agent工程师成仙指南:通往55万美元年薪之路

随着AI技术的进步,市场对AI Agent工程师的需求呈爆炸式增长,相关岗位年薪高达18.5万至55万美元。与传统的问答型AI不同,Agent工程师的核心职责是设计能执行实际操作的系统并使其在生产环境中稳定运行。文章提供了详尽的职业进阶路线:首先需掌握Python、后端API开发等软件工程基础;其次熟练使用LangChain、RAG及大模型API等专属AI技术栈;最后,必须具备系统可观测性和评估能力。作者强调,拥有包含完整监控和复盘报告的真实部署项目,是求职者脱颖而出的关键。

技术 › Agent Chrome 2026-08-0713.4 KB 66.6K 56 83

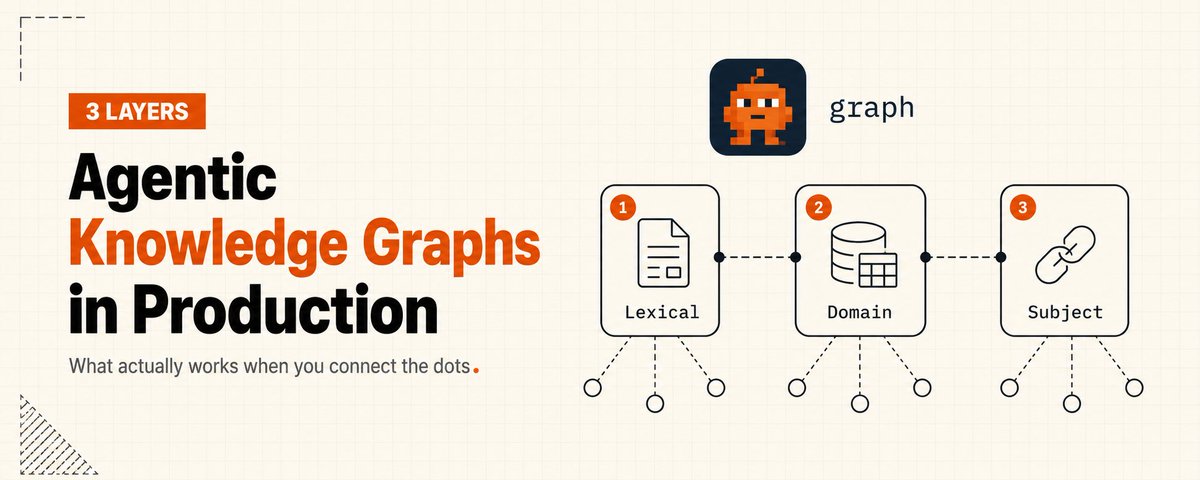
Agentic Knowledge Graphs: what actually works in production

文章探讨了在生产环境中实施智能体知识图谱的实际经验。作者指出,并非所有场景都需要图谱,大部分问题可通过元数据过滤或混合搜索解决。只有当需要多跳连接(如根因分析)时才需引入图谱。建议将图谱分为领域图、词汇图和主题图三层,并从简单的单智能体流程开始构建。

技术 › Agent rewind 2026-08-0649.7 KB 48.5K 66

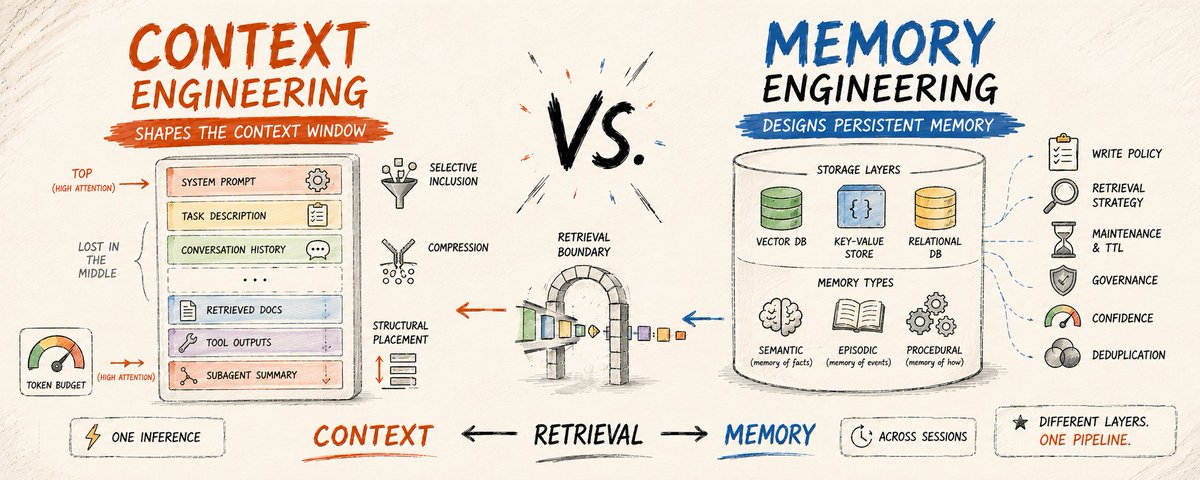
Agent 系统中的上下文与记忆工程

本文探讨了在 Agentic AI 系统中,上下文工程与记忆工程如何解决不同问题。上下文工程专注于单次推理调用的设计,涵盖选择性包含、结构放置、压缩和历史管理;记忆工程则关注跨会话的持久化,涉及写入策略、存储层选择和检索策略。两者在检索边界交汇,共同决定了 Agent 在实际工作负载中的可靠性。

技术 › Agent beamnxw 2026-08-0515.5 KB 527.5K 404

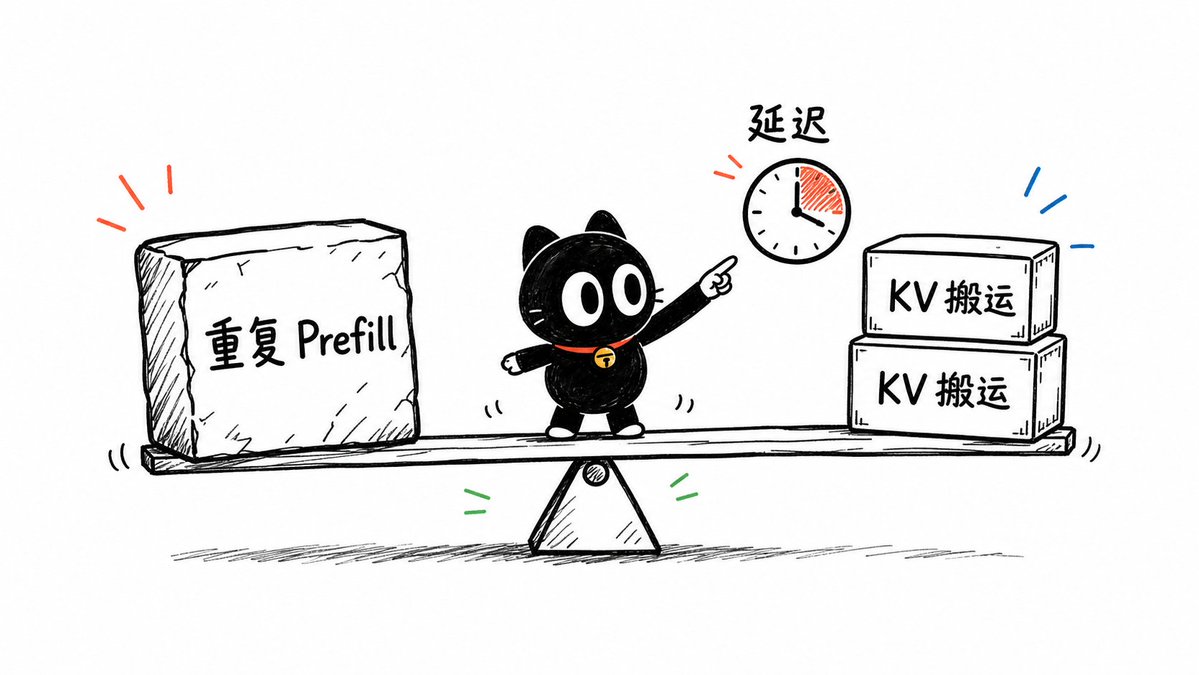
长上下文缓存能复用,为什么一压缩就失真?

文章探讨了 RAG 场景中 KV Cache 复用的挑战。现有方法在长上下文下面临存储与传输瓶颈,且直接复用或简单压缩会导致位置偏移和误差放大。C2KV 通过轻量级 Extractor 将文档压缩为可拼接、位置解耦的 KV 表示,实现了显著推理加速。文章分析了其在质量、延迟和工程落地上的权衡,强调 KV 复用已演变为存储、传输和质量共同约束的系统问题。

技术 › LLM 烟花老师 2026-08-0413.9 KB 1.2K 5

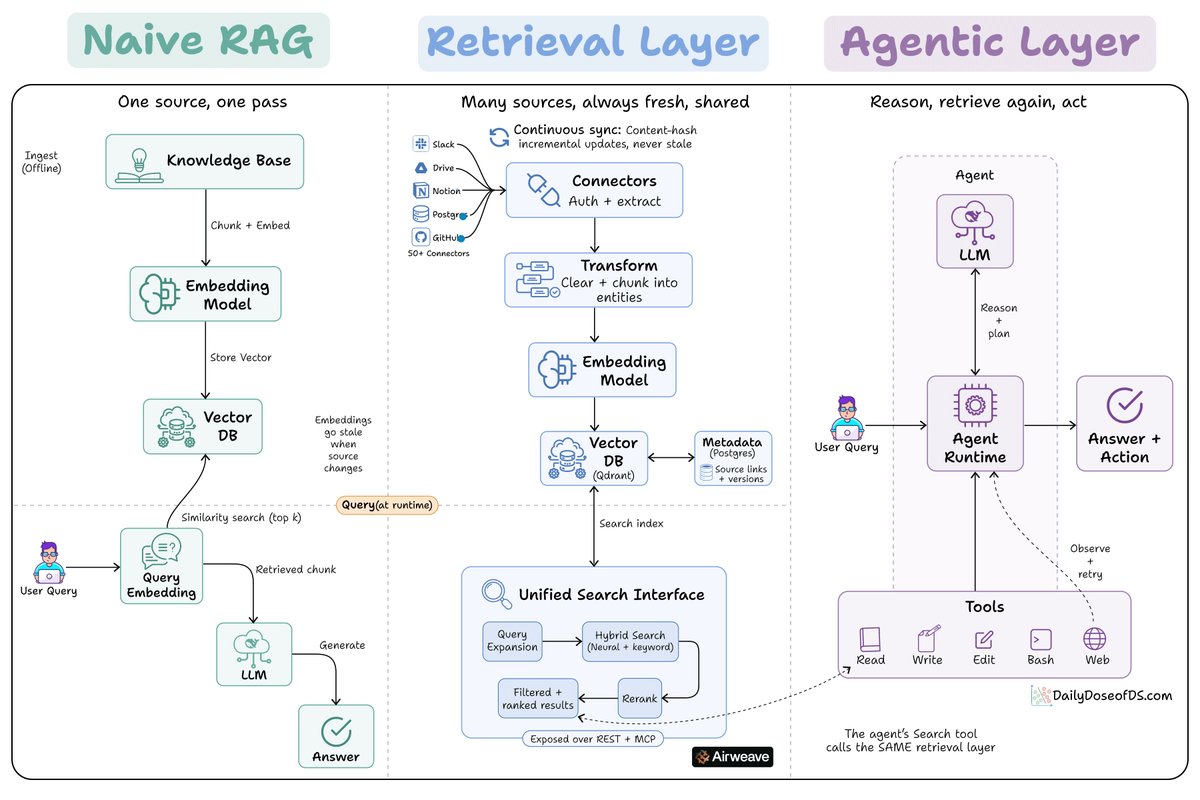
Google和Anthropic对检索的共识:从单一应用到独立服务

文章讨论了Google和Anthropic将检索从单一应用中移出,转变为独立服务的新趋势。这种分离解决了旧RAG设置中的过时嵌入和基础设施耦合问题。通过将摄取与查询分离,并使用结构化单元代替原始文本块,可以显著减少语料库大小并提高向量相关性。

技术 › LLM Akshay 2026-08-022.9 KB

小白如何从0到1搭建自己的AI知识库

本文介绍了如何从零开始搭建个人AI知识库。作者提出了一套包含文本文件、Agent工具、规则和真实任务的工作方式,并详细说明了准备四样要素(开放文件夹、真实任务、Agent工具、工作规则)和五个具体步骤的方法,帮助用户通过简单的流程实现知识的积累与迭代。

技术 › 工具与效率 金尘马 2026-07-3012.6 KB 107.1K 563