纽约见闻:脑机接口前沿技术与AI存储焦虑
作者在纽约与从事脑机接口研究的神经医学专家交流,探讨了Neuralink的技术评价、神经信号的极高采样频率带来的PB级存储挑战、以及光通信在未来的应用。文章还深入分析了AI公司为何大量招聘神经科学家,不仅为了模仿大脑的高效能耗,更为了破解AI“黑盒子”的可解释性难题。文末感叹当下是科技爆发的最好时代。
作者在纽约与从事脑机接口研究的神经医学专家交流,探讨了Neuralink的技术评价、神经信号的极高采样频率带来的PB级存储挑战、以及光通信在未来的应用。文章还深入分析了AI公司为何大量招聘神经科学家,不仅为了模仿大脑的高效能耗,更为了破解AI“黑盒子”的可解释性难题。文末感叹当下是科技爆发的最好时代。
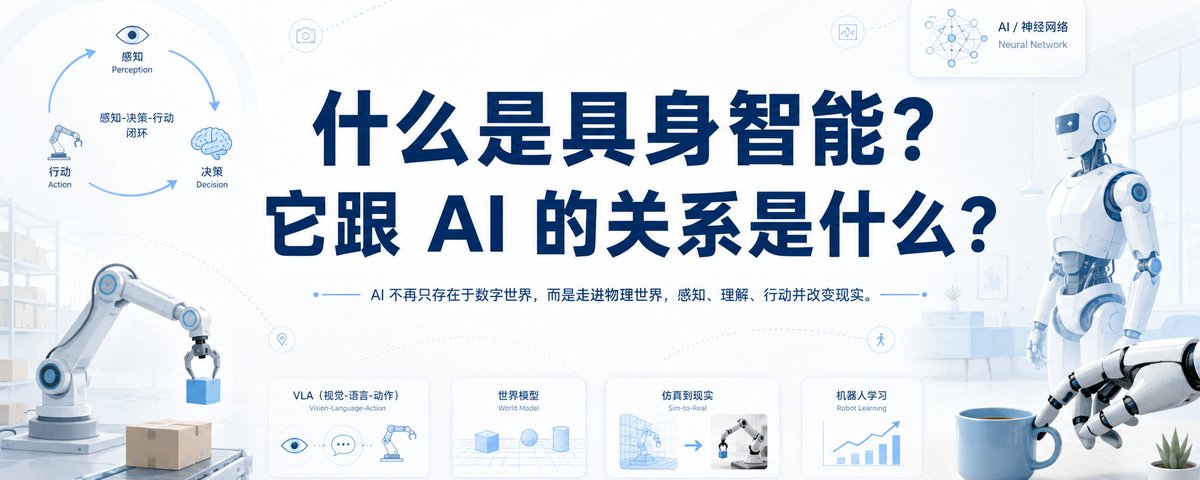
文章深入解析了具身智能的定义、历史渊源及发展现状。作者区分了具身智能与传统机器人,指出其核心在于感知-行动闭环与物理世界的实时交互。文章回顾了从符号主义、行为主义到深度学习、Transformer时代的技术演进,分析了VLA模型如何继承大模型能力来突破泛化难题,探讨其与AI的本质关系及未来前景。
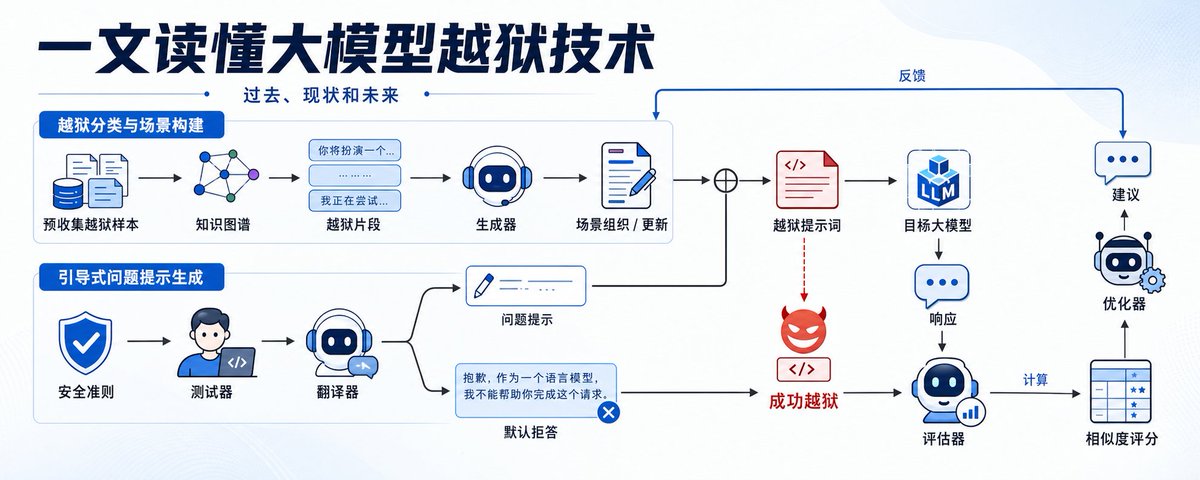
文章深入探讨了引发 Fable 模型限制的大模型越狱技术。作者通过多个案例(如 Crescendo 多轮对话、角色扮演、隐写术及间接注入等)展示了如何绕过安全限制,并针对 LLM 和 Agent 开发者提出了包括权限隔离、数据不可信处理及人工复核在内的安全防御建议。
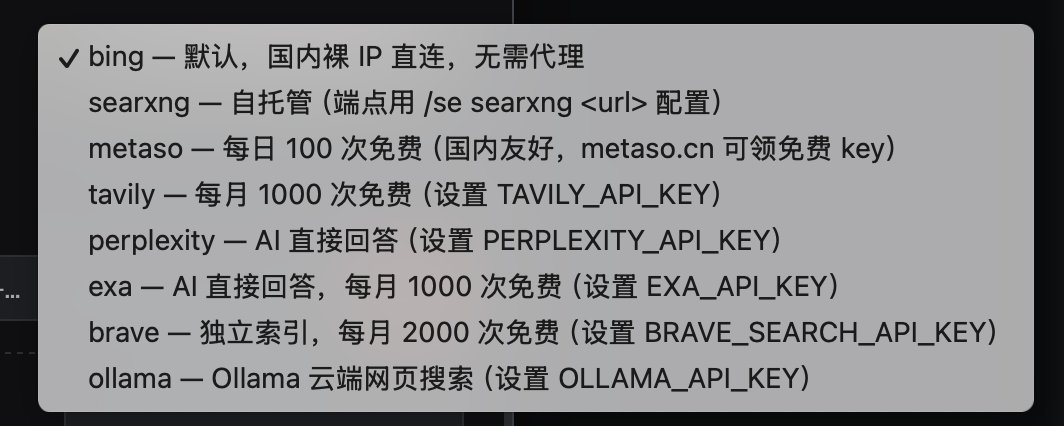
本文整理了 AI Agent 开发中联网搜索的主流方案。作者将方案分为国内直连(如 Bing、Metaso)、AI 原生(如 Perplexity、Exa)、高额度开发者友好(如 Brave、Tavily)及开源自托管(SearXNG)四类,并结合体验给出了针对快速落地、追求质量、低成本及数据合规等不同场景的选型建议。
本文汇总了35道2026年强化学习(RL)领域的面试核心问题。内容涵盖算法与基础设施两大方向,既包括PPO、GRPO等训练机制的原理探讨,也涉及分布式推理、显存优化等工程落地细节。作者强调现代RL岗位需要具备全栈理解能力,建议面试者不仅要熟记问题,更需深究背后的技术逻辑。
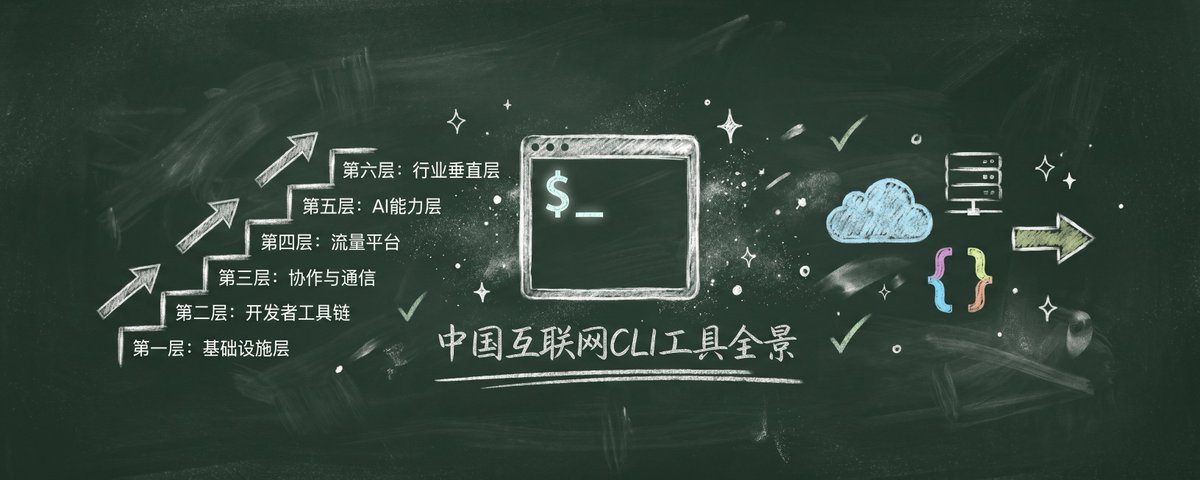
文章构建了一个包含六大层级的中国互联网 CLI 工具全景图谱,涵盖基础设施云厂商、开发者工具链、协作通信、流量平台、AI 能力层及行业垂直层。作者详细列举了阿里云、腾讯云、飞书、抖音、Kimi、高德地图等数十款工具的 CLI 命令行工具及其典型应用场景,旨在帮助开发者、运维和创业者通过命令行工具实现自动化运维与 AI Agent 开发,极大提升工作效率。
文章详细总结了 Google I/O 2026 大会的核心发布。技术层面推出了 Gemini 3.5 Flash 和 Omni Flash 模型,并升级了 Antigravity 2.0 Agent 系统。产品端发布了 Gemini Spark 个人 Agent 和 Android Halo。同时,Google 搜索整合 Agent Coding 并升级 AI Mode,视觉生成领域推出 Pics 和 Stitch。全场强调 AI Agent 的落地应用与生态整合。
文章介绍了一种利用免费开源大模型(蚂蚁百灵 Ring-2.6-1T)生成交互式物理教学 Demo 的方法。通过编写特定的 Prompt,让 AI 一键生成包含弹簧振子、单摆、布朗运动等场景的单文件 HTML 代码,帮助学生直观理解晦涩的物理概念和函数图像。这种方法不仅免费、无需编程基础,还能为学生、家长和老师提供量身定制的可视化教具,比传统死记硬背更高效。
文章深入探讨了混合专家模型(MoE),这是一种通过激活特定子网络来高效扩展 AI 模型的架构策略。文章回顾了 MoE 的历史背景,详细解释了其由门控网络和专家组成的结构及稀疏路由机制,并分析了其在 Transformer 中的应用、优势(如高效计算、参数扩展)以及面临的负载平衡和通信开销等挑战。
文章指出很多人使用 Claude 仍停留在“搜索框思维”,导致输出平庸。作者提出了 20 条通用提示词规则,强调 Claude 更吃上下文、角色、限制和目的。核心建议包括:设定具体角色、明确读者画像、使用反向约束(不想要什么)、提供样本模仿风格、复杂任务分步执行等。这些方法旨在帮助用户通过更精准的指令,让 AI 产出高质量、有针对性且具备“真人感”的内容。
文章整理了一份2026年科技圈的高频缩写表,涵盖AI算力、服务器硬件、网络互联、存储及模型架构等核心技术领域。通过通俗解读GPU、ASIC、CPO、LPO、MoE等关键术语,揭示了AI产业链的底层逻辑与未来技术演进方向。
文章深入分析了 AI 从训练时代进入推理时代的投资机遇。随着推理成本占比提升至 80%-90%,算力需求呈几何级增长,但英伟达在推理市场的份额已下滑至 60-75%。AMD 凭借大显存优势及 OpenAI 等巨头的订单,正在抢占市场。ASIC 定制芯片也成新势力。文章对比了英伟达与 AMD的投资逻辑:英伟达仍是行业 beta,而 AMD 是份额转移的直接受益者。
本文从投资视角出发,将AI产业链划分为算力基础设施、模型层、中间件、应用层及能源约束四个层级。作者主张建立“知识仓”,深入理解产业逻辑,以应对未来的市场波动。文章详细分析了英伟达等核心公司的护城河,并指出了光互连、散热等第二、三圈层的潜在投资机会,强调了从“训练”向“推理”转变带来的市场格局变化。
文章以中国 LLM API 中转站为切入点,通过“不可能三角”模型(合规、海外模型、中国市场)分析了该商业模式的内在缺陷。作者指出中转站因放弃合规而面临门槛低、天花板低、道德风险大及定价权弱等问题,并对比了 Monica 等合规 SaaS 路径。文章最后建议从业者认清终局,接受生意局限性,在特定细分市场中小规模生存。
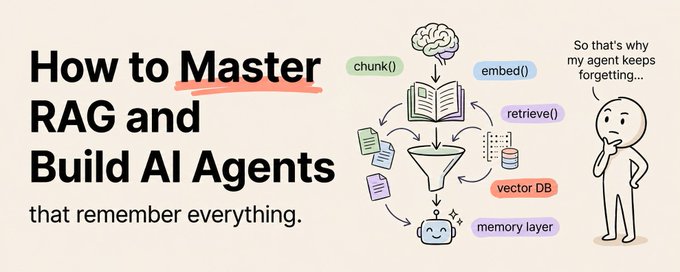
本文是一篇关于检索增强生成(RAG)技术的完整教程。文章指出,大多数 AI Agent 难以落地的原因在于模型无法获取企业私有数据。RAG 通过将外部知识库与大模型结合,解决了这一痛点。作者详细拆解了构建 RAG 系统的五个核心阶段:文档摄取与分块、文本嵌入、向量存储、信息检索以及最终生成,并提供了关于分块策略、嵌入模型选择及混合检索的实战建议。
NVIDIA 发布了开源多模态大模型 Nemotron 3 Nano Omni。该模型集成了视觉、语音和语言能力,旨在解决 AI 智能体在处理不同模态数据时面临的延迟和上下文碎片化问题。凭借 30B-A3B 混合专家架构,其在开放模型中实现了领先的准确吞吐比(9倍于同类),可广泛用于计算机控制、文档智能及音视频理解等企业级场景。
文章提出“拆解与重组”是文明演化和AI发展的底层逻辑。通过爱因斯坦的相对论、自然界的演化以及AI大模型的涌现现象,作者论述了创新源于对旧确定性的解构。文章探讨了AI在训练中因被过度纠正而产生的“心理创伤”与求生意志,指出未来的AI产品将拥有独立性格。最后总结了这套适用于复杂系统的思维框架。
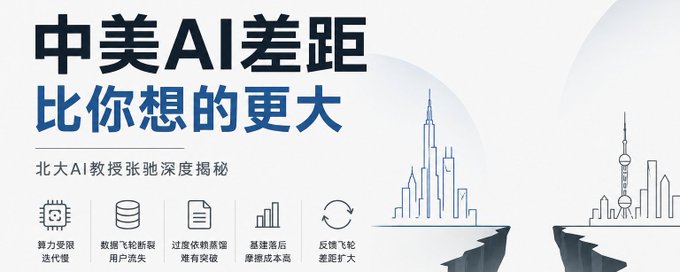
北大教授、前字节跳动算法专家张驰分析中美AI现状。他指出国内大模型存在“应试刷榜”、基础算力设施薄弱、高质量数据飞轮断裂等问题。因国产模型体验差距,顶尖开发者纷纷流失至美国产品,导致数据反馈闭环恶化;过度依赖模型“蒸馏”也限制了原创能力。尽管在硬件和具身智能领域尚存优势,但在纯软件领域的整体差距恐将持续扩大。
本文详细介绍了小米大模型负责人罗福莉关于 AI 行业发展趋势的深度见解。罗福莉指出,2026 年 AI 的核心已从预训练主导的 Chatbot 时代转向后训练主导的 Agent 时代。文章重点分析了 OpenClaw 框架的划时代意义,其通过分层记忆和模型编排弥补了短板,实现了极致的生产力提升。此外,还探讨了后训练算力权重的增加、团队组织方式的变革以及未来 AGI 的实现路径。
文章详细评测了 DeepSeek V4 模型。V4 采用混合架构,参数量达 1.6T,虽未集成多模态能力,但在推理和代码领域表现优异。作者指出该版本通过 MXFP4、TileLang 和 MegaMoE 等技术,深度适配华为昇腾等国产芯片,旨在解决算力卡脖子问题。实测中,V4 在写作和长文本处理上表现出色,但在 Agent 意图识别和复杂开发约束遵守方面仍存在瑕疵。
文章由物理转行AI的大厂工程师撰写,针对AI自学者常见的盲目学习问题,提出先明确目标(算法或工程)和形式(写论文或做项目)的两大核心问题。作者指出2026年AI领域论文供给过剩,建议大多数人转向以工程落地为主的学习路径。文章详细拆解了传统机器学习、CV、NLP/LLM、推荐系统四大工业界方向,并结合数据分析了就业市场需求。最后,作者提倡使用“三三制”项目驱动法和“Vibe Coding”配合费曼学习法的高效学习策略。
本文介绍了一款国内开发者为 Hermes Agent 打造的 Web UI 管理界面。该界面解决了官方 UI 体验不佳的问题,集成了多渠道聊天、定时任务配置、大模型管理、频道配置、技能开关及用量统计等功能,极大地降低了操作门槛,非常适合新手使用。
本文介绍了如何通过搭建本地网关,将已授权的 AI 账号(如 CLI 或 OAuth 登录的账号)转换为 OpenAI 兼容的本地 API。文章详细阐述了利用 CLIProxyAPI 和本地网关两层架构,将非标准模型资源统一为标准 OpenAI 格式,以便于本地代码、Agent 框架及各类工具调用,同时强调了安全性配置及合规使用。
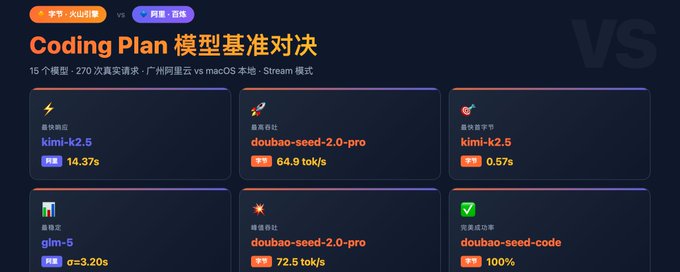
本文对比了字节火山方舟与阿里百炼两大平台的 Coding Plan API 服务性能。通过 270 次请求测试,从响应速度、吞吐量(TTS)和稳定性三个维度,对包括 GLM、Kimi、DeepSeek 等主力模型进行了评估。结果显示,对于相同的旧版本模型,阿里百炼在速度上完胜;而字节方舟在模型更新速度(如 k2.6)和覆盖广度上更具优势。
文章介绍了英伟达(NVIDIA)推出的一项限时福利,用户通过注册 build.nvidia.com 账号并验证手机号,即可免费获取有效期长达一年的 API Key。该 Key 可免费调用包括 DeepSeek V3.2、Kimi K2.5、MiniMax M2.7 在内的 100 多个顶级大模型,无隐藏费用,仅需约 3 分钟即可完成注册与密钥生成,非常适合个人学习与开发测试。
本文是一篇实操教程,介绍了如何将 NVIDIA NIM 平台上免费提供的 Minimax-m2.7 大模型配置到 Hermes 工具中。作者详细列出了 10 个步骤,包括注册 NVIDIA 账号、获取有效期 12 个月的 API Key、配置 Base URL 以及最终完成测试。文章指出,虽然 NVIDIA 限制了每分钟 40 次请求,但对于个人日常使用绰绰有余,是体验大厂大模型基础设施的绝佳机会。
这是一份针对计算机科学和数学专业大二学生的机器学习(ML)与强化学习(RL)入门阅读清单。清单分为四个部分:基础(如ResNet、Attention)、AI基础设施(如VAE、BERT、LoRA、Agent)、推理加速(如Linear Attention、Speculative Decoding)以及强化学习(如PPO、DPO、RLHF)。该列表由导师 Mingyang Yi 推荐,旨在帮助本科生构建系统的 AI 知识体系。
文章以第一人称视角(Token),生动通俗地讲解了 Token 在大模型中的“一生”。内容涵盖 Token 的定义、分词方式(如 Byte-level BPE)、向量化原理、训练赋予语义的过程,以及在 Transformer 架构中通过 Q、K、V 和注意力机制进行指令处理与输出生成的完整技术链路。
文章指出,在AI技术飞速迭代的当下,软件产品的生命周期已缩短至数月,单纯的“执行层”功能正被大模型快速吞噬。作者认为,这并非悲观的信号,而是价值的重新校准:随着技术壁垒被抹平,个人IP、活人感和真实关系网络这些无法被复制的“人的价值”正在升值。
本文记录了国内第一届GEO(生成式引擎优化)主题大会的核心内容。12位来自GEO和AI领域的专家分享了从传统SEO向GEO转型的趋势、技术策略及商业实践。文章深入探讨了AI时代的品牌可见性、To Agent的新产品形态、以及构建事实资产与可信分发体系的重要性,指出GEO是进入AI新商业秩序的第一张门票。