Wiki 知识库

全部文档 / 标签: LLM

1041 篇
清除

DGX Spark Handbook

本文是 NVIDIA DGX Spark 本地推理设备的使用手册。作者最初因其 273 GB/s 的低内存带宽而不看好,但随着 MoE 架构、推测解码等推理工程技术的成熟,DGX Spark 已能在本地以接近云服务的速度运行高智能模型。文章详细介绍了多台 Spark 通过 ConnectX-7 网卡链接实现近线性扩展带宽和内存的方案(四台可达 1092 GB/s、512 GB 内存)、低功耗适合家用部署的优势、MoE 与推测解码如何弥补硬件短板,以及单机同时服务 8 个并发会话的能力,并对比了与 Mac 的算力优势和成本分析。

技术 › LLM EXO Labs 2026-09-2651.7 KB 256.4K 703 75

Building Prod with Jev and LangGraph

TypeSafe AI 发布了决策模型 Jev,不同于传统 LLM,它不生成文本,而是返回带概率的结构化决策结果,在路由、分类等窄任务上比领先 LLM 快 200 倍、便宜 400 倍,并具有一致性和可并行性。LangChain 团队认为这与其'prod, not god'理念契合:代码掌控工作流,AI 只处理需要语义判断的分支。文章介绍如何用 LangGraph 编排 Jev 决策,包括节点、状态和边的架构,以及持久化执行、人在环路和可观测性等可靠运行时能力,实现可靠、可测试的 AI 驱动生产系统。
技术 › Agent Sydney Runkle 2026-09-2616.1 KB 108.3K 224 72

Agent traces are the new oil(Agent 轨迹是新石油)

文章提出 Agent 轨迹(traces)正成为 AI 公司间的核心交易资产,甚至出现蒸馏攻击等争夺行为。作者指出 RL 训练、长程任务代理普及使 traces 价值激增,但多数企业仍未善用这一资产。文章分析了 traces 对数据厂商、前沿实验室和应用层的价值,以及在运营优化、安全护栏、持续改进三方面的用途。作者还剖析了从 traces 中提取价值的难点:数据非结构化、体量巨大、反馈混乱、长程信用分配困难等,并类比 2010 年代的大数据浪潮,认为 traces 将成为企业专有智能层和战略资产,唯有通过提炼与使用才能释放价值。

技术 › Agent Sam Z Liu 2026-09-268.9 KB 164.1K 405 69

We built a 20x faster Grok bot

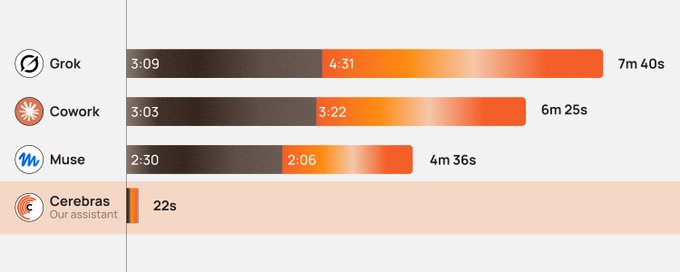
Cerebras 团队测试了主流 AI 个人助理完成订餐任务的表现,发现现有助理耗时过长(如 Grok Bot 需 7 分 40 秒)。团队使用 Qwen 3.8 27B 模型运行在 Cerebras 硬件上,以 Pi 作为 Agent Harness,通过三项优化将任务压缩至 22 秒:1) 并行执行独立的检查操作;2) 借助 Cerebras 快速推理加速模型调用;3) 将探索网站的经验固化为 Skill 复用,减少 80% 以上的工具调用。文章展示了 Harness Engineering、快速推理和经验沉淀对 Agent 效率的巨大提升潜力。

技术 › Agent Cerebras (Sarah Chieng, @0xSero) 2026-09-267.4 KB 685.5K 1.9K 70

Using Claude Code: Spending your effort

本文深入探讨了 Claude 模型中 effort(努力程度)参数的作用与使用策略。作者通过实验和 Terminal Bench 3.0 基准测试分析发现:effort 本质上是控制模型在任务上投入的算力与自主判断程度。高 effort 在验证和边界测试重要的场景(如硬件、代码审查、安全)表现更佳;低/中 effort 则适合快速迭代、保持人类在环。作者还比较了不同规格化程度任务在各级 effort 下的输出差异,并总结出一套高效工作流:先让模型访谈自己补全规格,用低 effort 实现,人工审查后,再用高 effort 做验证和测试。

技术 › Claude Thariq 2026-09-2612.5 KB 1.5M 6.2K 83

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

Coding is dead, long live Coding

作者以个人编程经历为引,回应对 AI 导致编程手艺消亡的哀悼。引用 Thorsten Ball 的观点:手写代码的工艺将像意大利手工鞋匠一样成为小众。作者认为编程虽'死',却以模型权重、框架和语言的形式延续。作为自学成才的程序员,他乐观地认为 AI 编程是新的开始——新一代程序员用自然语言表达意图,能更快、更高质量地构建产品。过去受限于个人能力,如今可以通过正确的提示词和上下文驱动 Agent 实现心中构想。作者对更多人体验创造的乐趣充满期待。

技术 › LLM lauren 2026-09-263.9 KB 174.2K 2.6K 45

在安全边界内运行私有本地 AI 的四种架构

文章指出企业 AI 部署并非只有'公有 API 或自建推理平台'的二选一,私有 AI 实际是一个从客户端设备到完全物理隔离的连续谱系。作者提出四种隔离层级:1) 使用 LiteRT、Gemini Nano 等在移动 NPU 和浏览器上进行零外泄客户端推理;2) 通过 Confidential Computing(机密虚拟机与 NVIDIA H100 TEE)对云端 CPU/GPU 内存硬件级加密;3) 在私有 VPC 内用 GKE + vLLM/JetStream 自托管开源模型权重,实现权重与日志的完全掌控;4) 使用 Google Distributed Cloud Air-Gapped 为主权工作负载提供物理断网部署。工程关键在于按威胁模型和延迟预算匹配硬件边界。

技术 › 网络安全 Sergio Villani 2026-09-2612.8 KB 30.4K 208 84

斯坦福 CS146S 首周:200 行复现 Claude Code——Agent Loop、核心工具集与系统提示词拆解

斯坦福大学 Mihail Eric 教授开设的「AI 原生软件开发」课程 CS146S 首周资料公开。第一周主题是拆解 Coding Agent 内部机制:LLM 是无状态的文本到文本函数,agent 的能动性来自外部循环,即 agent = LLM + 工具 + 循环。课程用 200 行代码复现 Claude Code 骨架,讲解核心循环设计、read/write/edit/bash 四个最小完备工具集,以及 Claude Code、Cursor 等生产级 agent 系统提示词的结构分层:身份锚定、工具规则、工作流规范、安全边界和沟通风格。课程旨在 demystify:agent 没有魔法,骨架与产品的差距全是可学习的工程问题。

技术 › Agent meng shao 2026-09-258.6 KB 23.8K 136 84

Thinking in Systems, Shipping in Loops

文章引用 DHH 的观点指出,手写代码对绝大多数程序员已不再经济,软件工程正演变为系统架构设计。通过 Artemis 和 SpaceXAI Grok 团队的案例,说明工程师如今通过设计验证循环(verification loops)让 AI 大规模正确地编写代码——如 Lauren Tan 每月发布 2000 个 PR。文章借鉴 Donella Meadows 的系统理论,提出优秀系统设计的三大特性:韧性(AI 通过测试、审查代理和生产可观测性自我校验)、自组织(循环学习将失败类型转化为新技能)和层级(将技能、工具与沙箱组合成可复用组件)。工程师的新职业是'驾驭智能'。

技术 › Agent Tomasz Tunguz 2026-09-252.9 KB 18K 300 59

BestBlogs 早报 · 09-25|Every 分享如何筛选 AI 产品创意,Elastic 原子声明验证,AI时代人际反馈不可替代

本期早报精讲三篇文章:一是 Every CEO Dan Shipper 介绍在 AI 快速演进中如何用小型实验室机制筛选产品创意,通过内部采用、早期客户测试等管线判断原型价值,其 AI 编辑助手已减少 12% 编辑工作量;二是 Elastic 分享用原子声明验证减少 LLM 幻觉的方法,将知识库文章合并拆解为可逐项核对的声明,把合并时间从一小时缩短到五分钟;三是 Thoughtworks 作者探讨健康的同行反馈机制,强调人类反馈不可被 AI 替代。速览部分涵盖 AI 代码现代化、机器人仿真资产、京东 AI 知识库、视觉模型 Skills 封装和 TPU 大模型训练复现等内容。

技术 › LLM ginobefun 2026-09-2526.6 KB 4K 1 84

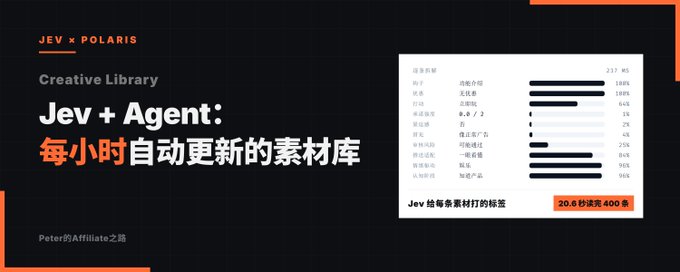
Jev + Agent:打造一个每小时自动更新的素材库

作者介绍了用 TypeSafe 新发布的判断型模型 Jev 与 Agent 协作搭建广告素材自动化筛选库的实践。Jev 不生成文本,只做选择题、打分和是非判断,单次判断 70-500 毫秒,输入价格极低。作者将 RollerAds 的 4,000 多条素材接入 Polaris 追踪系统,让 Jev 每条回答 12 个问题(钩子类型、优惠、CTA、审核风险等),400 条素材 20.6 秒即可读完。每小时自动为新素材补标签,再按规则筛选出置信样本交给 Agent 做二创和测试,大幅节省 Token 成本,实现高效的投放自动化工作流。

技术 › Agent Peter Yang 2026-09-244.7 KB 8.3K 11 78

锐评一下 Jev 和狂躁的 AI 圈

作者对近期爆火的 Jev 模型进行冷静剖析。通过分析 JevPilot 自动驾驶、通关《宝可梦·红》、大战《毁灭战士》等热门项目源码,指出其炫酷演示背后主要依赖传统算法和剪辑包装,Jev 真正参与决策极少。Jev 本质是低延迟、低成本的判别分类架构,只能做单步选择,缺乏长程推演能力。作者认为与其让大模型生成选项再由 Jev 裁决这种毫无意义的使用方式,不如将其用于任务前置过滤分流等真正能降本增效的场景,呼吁 AI 圈少些浮躁炒作,多沉下心寻找实际应用价值。

技术 › LLM 林亦LYi 2026-09-246.3 KB 9.1K 50 75

把桌面端的配置全搬到手机|Cherry Studio 移动端互联详解

本文介绍 Cherry Studio 2.1.0 新增的「设备互联」功能,解决手机使用 Agent 模型时需要手动复制 API Key 的繁琐问题。通过手机扫描桌面端生成的一次性二维码(5分钟有效),即可将电脑上已配置好的服务商、密钥和模型整包导入手机。文章详细说明了新老用户的同步入口位置,以及三步完成配对的流程:桌面端开启局域网访问、手机扫码配对、导入配置。目前实现的是配置同步,桌面端与移动端之间的数据同步功能也在后续计划中。

技术 › 工具与效率 Yinsen 2026-09-242.8 KB 2.1K 11 72

把 Jev 插进 RAG:爆速与降本到底能不能实现,实测验证

本文实测了 TypeSafe AI 发布的不生成文本的 AI 模型 Jev 在 RAG 检索流程中的效果。作者在重排、回答判断、检索前置门卫三个环节插入 Jev 进行验证:重排方面,Jev 以八分之一的成本达到接近 Cohere Rerank 的精度;在调用 LLM 之前用 Jev 判断「无法回答」,响应速度提升 5.6 倍,成本降至二十七分之一;在检索之前拦掉范围外提问,速度提升 7.4 倍,成本降至七十五分之一。此外,Jev 还能一次请求同时完成重排和回答判断。结论是用 Jev 改善 RAG 速度与成本可行,但需慎重设定阈值,避免误拦可回答问题。

技术 › LLM yibie 2026-09-2416.7 KB 10.8K 85 85

中秋国庆长假不出门的话不如学习Agent课程吧

作者整理推荐了四套值得学习的 Agent 相关课程:斯坦福 MS&E 435《AI 超级周期的经济学》从产业和经济学角度拆解 AI Stack 的价值分布;斯坦福 CS329A《自我提升型 AI 智能体》探讨 Agent 通过反馈、强化学习和记忆实现自我提升的闭环;Hamel Husain 的 AI Product Engineering 系列聚焦 Evals、Context 和 Systems,讲解如何把 AI Demo 变成可靠产品;CMU 11-768 则把 Agent 当作完整系统,涵盖 Harness、Evaluation、训练与安全。四套课程分别对应产业、研究、产品工程和系统工程四个视角,可拼成一张完整的 Agent 学习地图。其中三套已烧录双语字幕上传 B 站供大家学习。

技术 › Agent Tao Wang (@Tao100086) 2026-09-245.9 KB 73

你对 AGENTS.md 的理解几乎为零

文章探讨了开发者对 AGENTS.md 和 CLAUDE.md 等 AI 编程工具说明文件的普遍误解。作者指出,很多团队把所有希望 AI 做到的事都写进一个不断膨胀的文件,导致维护规则本身成了负担,本末倒置。正确的做法是让 AGENTS.md 保持精简(作者根文件不到 50 行),只写每次开工都需要知道的少数核心事项,再指向不同任务对应的规则文件,让 Agent 按需读取。作者引用西蒙'存储信息'与'需要时获取信息'的区分,并提醒只有在流程确实需要反复执行时才值得做成 Skill,不必急于按需调用。

技术 › Agent Roland.W (@rwayne) 2026-09-244.3 KB 75

/src 里的 Markdown:Markdown 正在变成源代码

htmx 作者、Montana State 大学教授 Carson Gross 提出:在 agent 式编程时代,Markdown 正从文档演变为源代码。他认为 LLM 生成的代码不应只源自用完即弃的提示词会话,而应将捕捉系统意图的 Markdown 签进 /src,与生成代码放在一起。Markdown 具备可 diff、可 grep、人机皆可读写的优势,且遵循局部性原则,让代码模块自带解释其意图的文档。作者提议建立 /src/md 目录约定(含 README、OVERVIEW、features、data、api 等),由人撰写维护,代码与测试从这些 Markdown 派生,测试负责自动化验证正确性。当代码越来越便宜,真正有价值的是代码背后的意图,应将其持久化于源码目录之中。

技术 › Agent Carson Gross 2026-09-249.3 KB 806 6 77

Use Jev to extract signals from millions of chat agent traces

本文介绍如何利用 Jev 类模型大规模分析数百万条聊天 Agent 生产轨迹,从中提取失败信号。传统 LLM-as-a-judge 评估依赖采样以控制成本,而 Jev 类模型可在同一上下文中并行回答多个问题,以极低成本对全部轨迹进行全面评估。文中讨论了显式反馈、行为追踪、事实结果和对话信号等不同类型的用户信号,并以航班改签客服对话为例,展示如何同时捕捉后续提问、用户挫败感和结果满意度等维度。文章最后介绍如何在 Langfuse 中配置基于 Jev 的批量评估模板,实现生产信号的监控与可视化。

技术 › LLM Annabell 2026-09-245.7 KB 59.9K 171 70

我让豆包工作从零写了一个 Jev 模型路由器,让 Codex 省钱近 45%

作者针对 Codex 账单越来越贵的问题,利用 TypeSafe AI 的 Jev 模型(只做带概率的判断、成本极低)搭建了一个外部模型路由器 HippoRoute-Jev-Codex,仅在线程首请求、新用户轮次、压缩检查点、子 agent 首请求四个缓存重建时机选模型,其余工具循环沿用钉住的模型,避免打掉 prompt 缓存。整个项目由豆包工作通过计划模式和目标模式从零完成,作者全程仅操作四次、未看一行代码,最终 76 个测试全通过并自行揪出 3 个 bug。实测机械任务省 95.4%,子 agent 场景省 79.7%,整体省 44.8%,且任务通过率无差别。

技术 › Codex huangserva 2026-09-2417.9 KB 82K 80 81

How to train your own Jev for $17

本文介绍如何以约17美元的成本微调一个类似Jev的高效分类模型。作者基于Qwen3.5 4B,从MultiNLI、BoolQ、Banking77、AG News、SST-5等多个Hugging Face数据集中采样约3.8万个样本,通过脚本归一化数据后,使用Together AI的Fine-tuning服务启动训练任务(约25分钟完成),再将模型部署到Together AI的专用端点(dedicated endpoint),并通过API查询模型完成分类任务。文中还发布了可直接使用的together/Tev1-4B-experimental模型,适用于客服意图识别、文本情感分析、论文分类等实际场景,涵盖从环境搭建、数据准备、训练到部署查询的完整流程。

技术 › LLM Hassan 2026-09-2412.4 KB 822.4K 2K 76

Jev AI 发布 168 小时:操作系统换了物种

作者回顾了自 1979 年以来的专家系统开发经历,介绍 TypeSafe AI 于 2026 年 9 月 15 日发布的首个公开 System One 模型 Jev。Jev 由前 OpenAI 研究员 Diogo Almeida 创立的公司打造,获 4000 万美元种子轮融资。与聊天型 LLM 不同,Jev 是“反聊天机器人”:它接收状态和类型化问题,在 70-500 毫秒内返回概率、置信度的决策结果,输出仅有 Choice、Score、Noul 三种原语。其训练方法为面向校准决策的强化学习(RLCD)而非 RLHF。作者认为 Jev 代表下一代操作系统形态,是将可靠的机器决策嵌入软件内核的缺失原语。

技术 › LLM Brian Roemmele 2026-09-2322.7 KB 119.9K 388 78

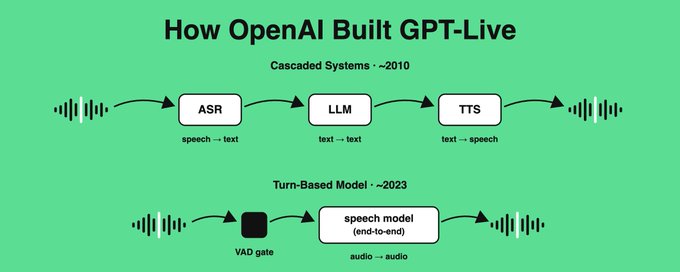
How OpenAI Built GPT-Live

本文深入解析了 OpenAI GPT-Live-1 全双工语音模型的架构原理。文章回顾了语音系统的三代演进:级联设计(ASR+LLM+TTS 串联,存在信息丢失和延迟叠加问题)、轮次式端到端语音模型(保留语气情感但依赖 turn detector,容易不自然)、以及全双工架构(模型同时监听和说话,沉默也是一种 token)。GPT-Live 通过将思考从说话中委托出去,保持语音模型小而快以实现毫秒级响应,同时依赖服务端系统的低延迟优化。文章还讨论了全双工系统的评估方法与实时系统工程经验。

技术 › TTS Alex Xu 2026-09-2320.7 KB 83.3K 507 70

国产模型年底跑不到 3T 模型就可能出局

文章梳理了曾鸣对颠覆性技术演化的三段论:AI 先成为通用基础设施,再催生海量新应用,最终诞生原生级现象级应用。2025 年 Token 成为 AI 时代共识度量衡,标志基础设施成熟;Open Claw 爆火开启 Agent 第二阶段;Agentic OS 属第三阶段,还需三五年。作者认为大模型公司本质是 AI 云公司,未来两年核心机会是打造 Agent 入口级产品,OpenAI 和 Anthropic 未必成为 AI 原生应用大赢家。另附曾鸣的公司四层分类:机会、战略、远见、使命驱动,强调使命须发自内心,外部认可驱动易受估值波动冲击。

技术 › LLM 向 向阳乔木 (@vista8) 2026-09-232.2 KB 53

一夜三连发,Claude Opus 5.5、GPT-6 Sol和Luna全部都来了

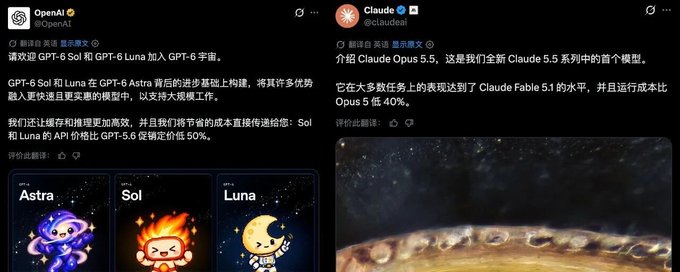
Anthropic与OpenAI同日发布多款新模型:Claude Opus 5.5、GPT-6 Sol和Luna。作者详细评测了各模型的定位与表现:Opus 5.5作为Claude系列性价比模型,Coding能力达到SOTA,成本下降40%,速度提升30%,但Token消耗大;GPT-6 Sol和Luna主打降本,价格比上代便宜50%甚至低于Deepseek,Token效率出色、幻觉率大幅降低,但审美与细节能力有明显降级。作者指出两家公司差异化路线:Anthropic专注Coding通往AGI,OpenAI专注全面Agent能力,并给出不同场景下的模型选择建议。

技术 › LLM 数字生命卡兹克 2026-09-2316.6 KB 43.1K 126 77

AI 没有智慧,你也不会有了

文章批评'不再读代码、不再写代码'的行业风气。作者指出代码可维护性和好架构难以即时度量,其恶果需要数月甚至数年才显现,而有经验工程师依靠长期实践积累的直觉来嗅出代码异味。AI 因缺乏可度量的奖励信号,无法理解什么是可维护的代码,且从质量低劣的野生代码中学习模式,在简化代码、定义可复用函数上表现糟糕。更危险的是,依赖 AI 写代码和读代码的开发者将永远无法达到精通,因为他们不再从错误中学习。作者认为 LLM 只是工具,预言未来会有公司以'无 AI'政策作为竞争优势。

技术 › LLM Alexandru Nedelcu 2026-09-226.8 KB 4.3K 23 66

Jev与你有什么关系?它提供了一套AI工作流拆分法

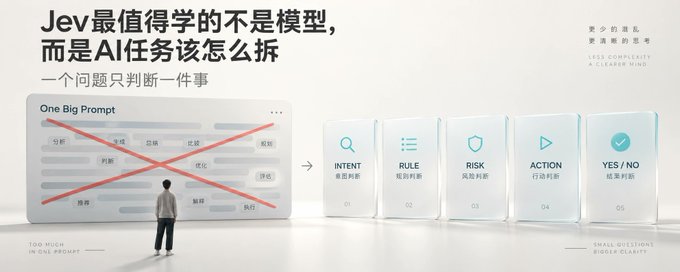
文章介绍了TypeSafe AI于2026年9月发布的Jev模型,一个不做文本生成、只做封闭判断的“System One Model”。它提供三种能力:Choice(选项选择)、Score(等级打分)和Noul(真假概率判断),直接返回类型化结果和概率,省去生成文本的延迟和成本。文章分析了Jev与生成式模型的本质区别,指出类型安全只保证接口格式而非事实正确,概率不等于正确率,并详细说明其在缺陷分诊、Agent路由、发布说明审核等真实场景中的应用方法,以及官方Agent Skill倡导的AI工作流拆分法:代码负责计算和规则,模型只做清楚的语义判断。

技术 › LLM 苏乐 2026-09-2224.6 KB 20.2K 41 85

How to build a signal-based outbound bot with Jev

作者介绍了基于 TypeSafe 发布的 Jev 模型构建信号驱动外呼机器人的方法。Jev 比通用模型快约百倍且成本极低,可为每个销售线索快速打分。作者团队曾用 Claude 做信号驱动 SDR,两周内约到 19 次会议,回复率 12%。文章详细拆解了开源项目 signal-ranker 的架构:watch.py 通过日期文件对比追踪招聘重发、融资等信号,judge.py 负责调用 Jev 评分,policy.py 用纯代码实现门槛与权重,两者分离以便复用已付费的判断结果。支持用 Claude Code 自行拉取线索或使用 yourmax.ai,可放入 Claude Code 或 Codex 终端复现。

技术 › Claude Code Nicolas Finet 2026-09-2225.0 KB 16.8K 153 83

How to use Jev for GTM Automation (Step-by-step guide)

本文介绍 TypeSafe AI 推出的 Jev 模型,它专为校准决策设计,输出概率而非文本。Jev 针对传统 LLM 过度自信、成本高、速度慢的问题,通过三种问题类型(Choice、Noul、Score)返回带置信度的概率结果,开发者可基于置信度阈值设置自动化护栏,实现无人值守运行。作者结合 treg 数据服务,展示了 Jev 在 GTM 自动化中的实战应用,包括欺诈检测与注册用户资格审核(每日 236 个注册仅花费约 $1.21)、以及购买信号分类等场景,并分享了编写评分规则(rubrics)而非传统 prompt 的使用技巧,成本远低于通用聊天模型。

技术 › LLM Jason Zhou 2026-09-2210.6 KB 64.8K 231 82

60个Jev典型案例整理与12个最值得关注案例详解

作者收集整理了60个Jev应用案例,并精选12个典型场景进行详解。这些案例的核心逻辑是:生成模型负责写作与复杂推理,Jev承担分类、筛选、评分和选择,代码执行后续动作,关键节点保留人工复核。案例涵盖品牌提及识别、实体对齐去重、RAG信源筛选、引用核验、网页操作决策、Skill选择、工具风险检查、客服工单分流、官网表达检查、论文引用验证、级联校验信息抽取及文本特征化等多个方向,对理解AI应用的工程化实践具有参考价值。

技术 › Agent 姚金刚 (@yaojingang) 2026-09-224.1 KB 79