GPT Image 2 上线:我伪造了 1987 年一个中国人的一天
作者使用 OpenAI 的 GPT Image 2 生成了 8 张具有 80 年代柯达胶卷质感的照片,虚构了 1987 年河北涿县供销社售货员刘建国平凡的一天。文章详细还原了从早晨起床、供销社工作到晚上围坐看电视的生活场景,并附带了完整的提示词(Prompt)分享。
作者使用 OpenAI 的 GPT Image 2 生成了 8 张具有 80 年代柯达胶卷质感的照片,虚构了 1987 年河北涿县供销社售货员刘建国平凡的一天。文章详细还原了从早晨起床、供销社工作到晚上围坐看电视的生活场景,并附带了完整的提示词(Prompt)分享。
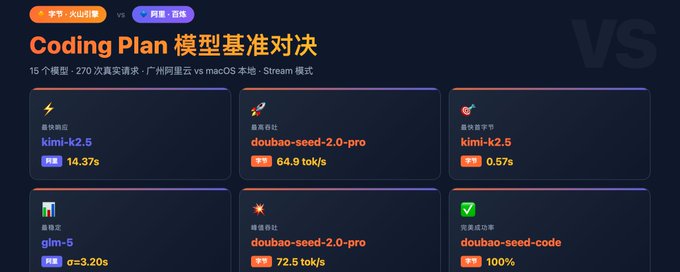
本文对比了字节火山方舟与阿里百炼两大平台的 Coding Plan API 服务性能。通过 270 次请求测试,从响应速度、吞吐量(TTS)和稳定性三个维度,对包括 GLM、Kimi、DeepSeek 等主力模型进行了评估。结果显示,对于相同的旧版本模型,阿里百炼在速度上完胜;而字节方舟在模型更新速度(如 k2.6)和覆盖广度上更具优势。
本文深入探讨了 Looped LLM(循环大语言模型)的演进及其在 Claude Mythos 中的潜在应用。作者从字节跳动实习期间的研究出发,分析了循环架构在多跳推理任务上的优势,并指出 Anthropic 新发布的 Mythos 在 GraphWalk BFS 基准上的异常提升可能与底层状态跟踪能力有关。文章进一步探讨了将 Looped LLM 扩展至大规模应用时面临的“三道门槛”:深度稳定性(借鉴 RNN/SSM 理论解决梯度问题)、推理效率(结合 Diffusion Forcing 和 YOCO 优化并行度)以及单位 FLOPs 的有效性,强调了在算力预算有限时架构选择的重要性。
文章基于作者在 ByteDance Seed 的研究经历,探讨了 Looped LLM 架构的起源与演进。作者通过分析 Anthropic 发布的 Claude Mythos 在 GraphWalk BFS 基准上的异常表现,指出 Looped 架构在多跳推理和状态追踪上的优势。文章进一步深入讨论了 Looped LLM 在扩展至 10T/100T 规模时面临的深度稳定性、推理效率和 FLOPs 有效性的三大挑战,并对比了 RNN 视角与 Parallel Looped Transformer 等解决方案。
文章重新定义了 2026 年的 SEO 为“Search Everywhere Optimization”(全渠道搜索优化)。作者指出,除了传统的 Google 本地包和自然搜索外,品牌必须重视在 ChatGPT、Claude 等 AI 搜索平台上的可见性,包括品牌被提及的频率和引用源。文章提出了 SPI Score(搜索性能指数)作为衡量品牌在本地、自然搜索、AI 平台及视频搜索等全渠道表现的综合指标,主张 SEO 策略应覆盖所有搜索触点。
文章探讨了在 AI 时代软件制造的迅速变化,提出设计师的核心任务是回答“什么值得制造”。作者介绍了新工具 Claude Design,通过 HTML 渲染、统一格式和系统化设计,显著缩短了从想法到原型的时间。该工具虽不能完全替代传统设计流程,但极大提升了团队协作效率。
本文探讨了 Claude Code 与 NotebookLM 的集成如何通过连接记忆与执行层,将孤立的研究转化为可复用的自动化基础设施。借助 MCP 协议,NotebookLM 作为结构化知识库,为 Claude Code 提供精准的上下文引用,减少幻觉并提升输出质量。这种集成不仅消除了知识存储与自动化执行之间的鸿沟,还使企业能够构建高效的商业智能系统,帮助代理机构和团队加速扩展并优化决策工作流。
文章深入剖析了AI生成壁纸作为副业的商业本质,指出赚钱的核心不在于卖图本身,而在于卖“感觉”和整套体验。作者详细拆解了该赛道的三层变现模式(卖图、卖流量、卖方法),并根据创业者能力差异,对比了闲鱼(适合无创作能力者快速验证)和小红书(适合有内容能力者做大)的运营策略。文章还包含了具体的风格推荐、工具选择(如豆包、即梦、Midjourney)及实操步骤,鼓励新手从低成本试错开始。
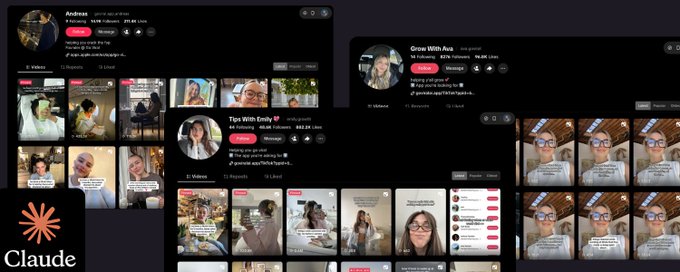
本文介绍了一套零成本的自动化工作流,利用 Claude Opus 4.7 分析 TikTok 爆款内容并提取 Hook,结合 Pinterest 获取素材,通过 Node.js Canvas 脚本批量生成幻灯片,最后使用 Postiz Agent 进行自动化分发,旨在解决手动内容制作耗时且低效的问题。
文章深入解析了2026年AI领域兴起的“API中转站”(俗称Token进口)赛道。分析了该模式基于全球AI服务价格差与访问壁垒的套利本质,揭示了其“低价资源供给、用户数据变现、模型偷换降级”的三层盈利结构。文章同时指出了用户面临的数据泄露、欺诈及法律风险,预测随着国产模型崛起,此类灰色套利窗口将逐渐消失。
文章介绍了如何通过构建独立的 C++/ggml 推测解码器,在单张 RTX 3090 (24GB) 显卡上实现了 Qwen3.5-27B (Q4_K_M) 模型的高效推理。利用 DFlash block-diffusion draft 和 DDTree 验证器,成功将峰值解码速度提升至 207.6 tok/s,较自回归基准提升约 5.46 倍,并实现了在有限显存下运行 128K 长上下文的能力。
本文探讨了递归语言模型作为一种新的推理范式的重要性。RLM 通过将模型自己的提示视为可检查、切片和递归查询的环境,直接结合了推理和工具使用。文章回顾了推理和工具使用的历史发展,从思维链到 ReAct,再到 OpenAI o1 和 Claude 的工具使用。最新研究显示,RLM 在长上下文、记忆和长推理任务中表现出色,克服了传统单次前向传播的局限。
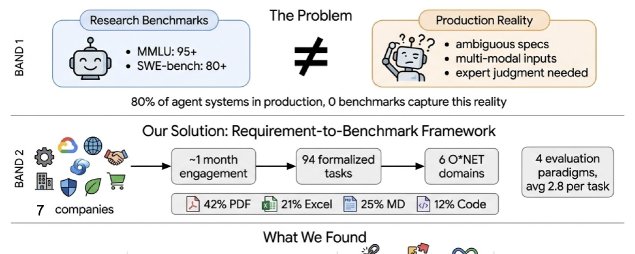
本周重点关注四大 AI 进展:Anthropic 展示 Claude 可进行全自动化对齐研究,成本仅 1.8 万美元且表现接近完美;AiScientist 提出基于文件系统的长周期工程架构;AlphaEval 揭露了 Agent 从研究到生产环境的巨大鸿沟;NVIDIA 发布开源 120B 参数模型 Nemotron 3 Super,采用混合 MoE 架构优化推理吞吐。
本文深入探讨了 LLM 中的 Prompt Caching 技术,解释了其背后的 KV Cache 机制及静态/动态上下文分离原理。文章通过 Claude Code 的案例分析,展示了如何通过保持 92% 的缓存命中率来将计算成本降低 81%,并总结了哈希敏感性和工程化落地的关键约束。
本指南介绍了如何利用 Claude Opus 4.7、Pinterest 和 Node.js 构建自动化的 TikTok 幻灯片内容工作流。流程包括使用 AI 分析病毒式传播的钩子、从 Pinterest 获取素材、通过脚本生成幻灯片,以及利用 Postiz Agent 进行自动化发布,旨在以零成本实现规模化内容生产。
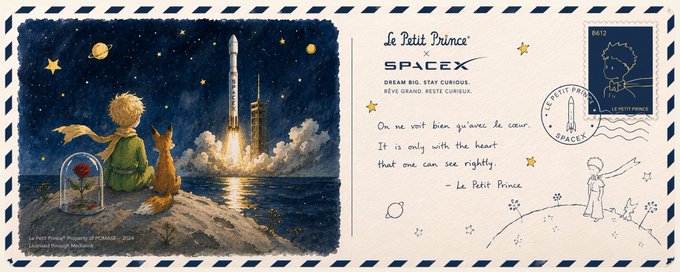
文章分享了作者在使用 GPT-image-2 生成上百张图片后的经验,认为极简提示词能生成更惊艳的效果。文中列举了 10 个极简提示词示例,涵盖工笔画书签、联名明信片、日历、节日海报、App 图标、摄影海报及印章设计等多个领域,展示了 AI 在视觉设计上的审美潜力和应用广度。
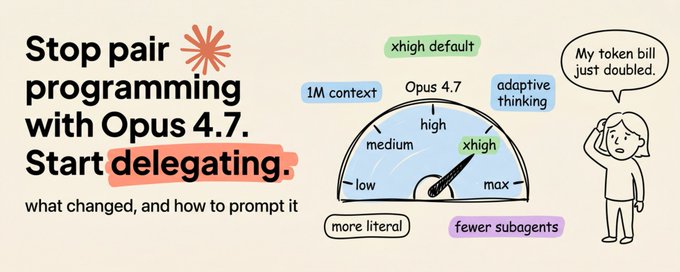
本文详细分析了 Claude Opus 4.7 与 4.6 的关键差异。新版模型采用了自适应思考机制、更严格的指令遵循以及 xhigh 默认算力等级。文章指出了升级后成本增加和召回率下降的原因,并提供了具体建议:采用“委托思维”而非“结对编程”模式,在首轮交互中明确任务意图,批量提问以减少推理开销,并针对 4.7 的字面义理解特性调整 Prompt 风格。
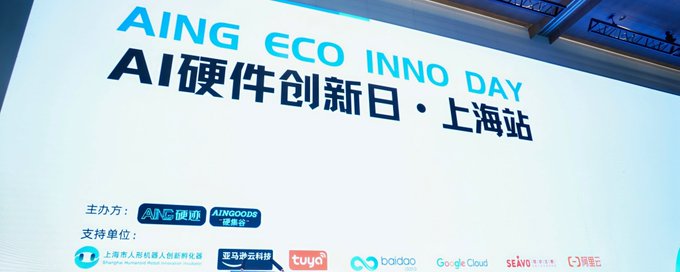
文章基于作者参加AI硬件创新日的观察,指出在技术同质化背景下,审美成为了决定成交的关键入口。通过ZenStellar禅星手链的用户数据,作者发现部分用户单纯为产品设计买单,而非仅仅为了AI功能。文章强调,随着技术门槛降低,创始人的审美判断和对情绪价值的理解将成为核心壁垒,而女性消费市场有望成为AI硬件的蓝海。
文章评测了Genentech关于Agent端到端执行生物信息学工作流的预印本。测试涵盖基因组学等领域,Codex CLI和Claude Code表现良好,但存在运行间的不稳定性。作者指出,这虽然证明了Agent在处理依赖和调用工具方面的“操作员”能力,但目前仍缺乏对生物学判断和科学决策可靠性的验证。
文章介绍了英伟达(NVIDIA)推出的一项限时福利,用户通过注册 build.nvidia.com 账号并验证手机号,即可免费获取有效期长达一年的 API Key。该 Key 可免费调用包括 DeepSeek V3.2、Kimi K2.5、MiniMax M2.7 在内的 100 多个顶级大模型,无隐藏费用,仅需约 3 分钟即可完成注册与密钥生成,非常适合个人学习与开发测试。
文章基于 Ray Kurzweil 的预测与播客内容,探讨了 AGI(2029 年)与奇点(2045 年)的时间表。作者介绍了 Kurzweil 关于人机融合、寿命逃逸速度及工作消失的观点,同时提出了对无限加速主义的质疑,认为 AI 应作为陪伴人类的伙伴而非仅仅追求物理共生,表达了 ColaOS 做有温度的 AI 的愿景。
本文详细介绍了2026年利用AI进行副业变现的5个实操项目,包括AI壁纸、短剧制作、数字人直播、短视频及写作变现。文章涵盖了项目背景、工具成本、执行步骤、避坑要点及收益预期,为初学者和进阶者提供了从0到1的落地执行方案,旨在帮助读者抓住AI成本暴跌带来的变现红利。
这是一份针对计算机科学和数学专业大二学生的机器学习(ML)与强化学习(RL)入门阅读清单。清单分为四个部分:基础(如ResNet、Attention)、AI基础设施(如VAE、BERT、LoRA、Agent)、推理加速(如Linear Attention、Speculative Decoding)以及强化学习(如PPO、DPO、RLHF)。该列表由导师 Mingyang Yi 推荐,旨在帮助本科生构建系统的 AI 知识体系。
本文深入浅出地解析了 Transformer 架构,它是现代大语言模型(LLM)的核心。文章从宏观视角出发,通过解码的方式,逐一拆解了 Transformer 的关键组件,包括编码器与解码器、分词与嵌入、位置编码、注意力机制(Attention)以及多头注意力等。作者详细解释了该架构如何解决传统模型的“遗忘”和“慢速”问题,实现了并行处理和长距离依赖捕捉,并最后阐述了其强大的原因。
文章列出了每位 LLM 工程师必须阅读的 12 篇核心论文清单,涵盖了从 Transformer 架构、BERT、GPT-3 等基础模型,到扩展定律、Chinchilla 训练法则、RLHF 对齐技术,以及 LoRA 高效微调和 FlashAttention 等工程优化技术。这些论文构成了现代大模型理解、训练和部署的理论基石。
本文是 Claude Skills 掌握指南的第二模块,重点讲述如何从单一使用的技能进阶构建可扩展的智能自动化系统架构。文章详细介绍了引入 Scripts(脚本)层来处理计算、文件操作等纯指令无法完成的任务,并通过“单一职责”、“动态参数”等最佳实践优化脚本。同时,针对多技能环境下的冲突问题,提供了定义清晰领地、设立负向边界和独特触发词的解决方案,并探讨了大型参考资料的高效加载策略,旨在帮助用户设计模块化的智能工作流。
本文探讨了超级智能已至的背景下,AI 发展的加速及其带来的挑战与机遇。作者指出 AI 将重塑高 prestige 的白领行业,同时也面临持续学习、安全和验证等难题。文章建议通过自动化低垂果实、拥抱开源权重模型、利用隐性知识及建立安全基线来应对。
本文详细记录了黄仁勋与 Dwarkesh Patel 的两小时专访。黄仁勋重申了 Nvidia “输入电子,输出 Token” 的使命,并深入探讨了 CUDA 的生态护城河、供应链管理哲学以及对 GPU 定价的看法。针对 TPU 和 Trainium 的竞争,他认为专用芯片是特例而非趋势。文章最精彩的部分在于关于对华出口管制的激烈辩论,黄仁勋强烈反对将 AI 芯片武器化,认为限制出口只会倒逼中国实现完全自主化,让美国失去市场。
本文介绍了 DeepLearning.AI 推出的“规格驱动开发”方法论,旨在解决 AI 编程中常见的“凭感觉(Vibe)”导致的不稳定问题。文章提出通过建立项目宪法、特性规格和技术方案三个核心文档,并遵循 Plan-Implement-Verify 三步循环工作流,将 Coding Agent 从“随性猜测”转变为可控的工程师。文中还详细说明了如何为老项目反向生成宪法,以及将工作流封装为 Claude Code Skill 的技巧,帮助开发者从零构建可控的 AI 编程体系。
文章通过与航空维修 AI 创始人的对话,探讨了 AI 的局限性,即无法学习人类知识中未被记录的“隐性知识”。作者指出,人类的经验、直觉、失败教训和局部网络关系构成了 AI 时代的护城河。AI 只能处理结构化信息,而真正的判断力、时机把握和人际连接仍掌握在拥有真实体验的人手中。