Wiki 知识库

全部文档 / 标签: 评测

42 篇
清除

把 15 个国民级 App 接入灵光之后,我造出了最适合中国宝宝的 Personal Agent

作者分享将蚂蚁灵光 2.0 Personal Agent 内测版接入米家、百度网盘、钉钉、QQ邮箱、美团跑腿、瑞幸、麦当劳、滴滴、高德、飞猪、美图、支付宝、微信读书、网易云音乐和淘宝共 15 个国民级 App 的完整体验。文章详细介绍了各服务的接入方式(扫码授权、MCP、Skill、CLI、申请 Key 等),展示其在天气穿衣提醒、点餐、打车、账单统计、比价盯价等场景的主动性能力,并总结出一套可复用的配置提示语,认为手机端 Personal Agent 与电脑端 Agent 是完全不同的物种,最大优势是能接国内服务并主动推送信息。

技术 › Agent 卡尔的AI沃茨 2026-10-2717.2 KB 1.5K 7 81

AI 的流量超过人类之后,搜索也要重做一遍

Cloudflare 数据显示 AI 自动化流量首次超过人类(57.5% vs 42.5%)。文章分析搜索用户从人、到大模型、再到 Agent 的三次演变,指出 Agent 场景下搜索的三大卡点:结果需可直接用、信源要可信、速度要快。腾讯「元宝搜索」通过提供完整正文、接入 157 个权威信源、索引期压缩网页为 100 token 支持 KV Cache 复用等优化,使 Agent 完成任务的平均搜索调用从 8 次降至 5 次。作者实测 9 个品类 31 条 query,认为其强项为权威性、时效性和正文提供能力,适合国内 Agent 开发者,但学术论文、生活服务等场景需配合垂类 API。文章最后介绍了三种接入方式与按量计费价格。
技术 › Agent Orange AI 2026-10-258.4 KB 6.4K 21 81

Google 拆解 Agent Compute Engine,Claude 分享构建单智能体循环方法,CrowdStrike CEO 谈 AI 安全

本期早报精讲三篇文章:Google 公开 Agent Compute Engine 架构,通过 Harness 与 Sandbox 分离、凭据外置和快照空闲机制,兼顾智能体持续工作的便利、安全与成本;Claude 应用团队分享何时将子智能体合并回主循环,指出配合技能的单一智能体在质量、延迟和成本上常优于多角色设计,并给出渐进迁移与评测方法;CrowdStrike CEO George Kurtz 谈 AI 时代的安全变化,包括攻击速度加快、身份成为入口、数字孪生对抗演练等。速览部分涵盖 WorkForge 训练框架、Air Canada 智能体测试实践、个人 Agent 评测等内容。

技术 › Agent ginobefun 2026-10-2331.4 KB 2.5K 2 75

用完 12 个 Personal Agent 后,我找到了决定好用上限的五个标准

作者实测 12 个 Personal Agent,基于 1505 条覆盖 11 类的用例,总结出评判 Personal Agent 好用程度的五个维度:记忆能力、信息获取、Computer Use、主动性和多端联动。文章通过记账、海鲜市场自动回复、自动剪辑视频、跨设备调度 Codex/Claude Code/Grok 等 9 个真实案例展开分析,指出 Agent 与个人已有账号和应用生态的重叠度决定其上限,并对比了 Today、Grok Bot、OpenAI Dots、千问等产品的差异,最终分享了以手机远程调度多台电脑多 Agent 协同的工作流。

技术 › Agent 卡尔的AI沃茨 2026-10-2212.2 KB 3.7K 14 75

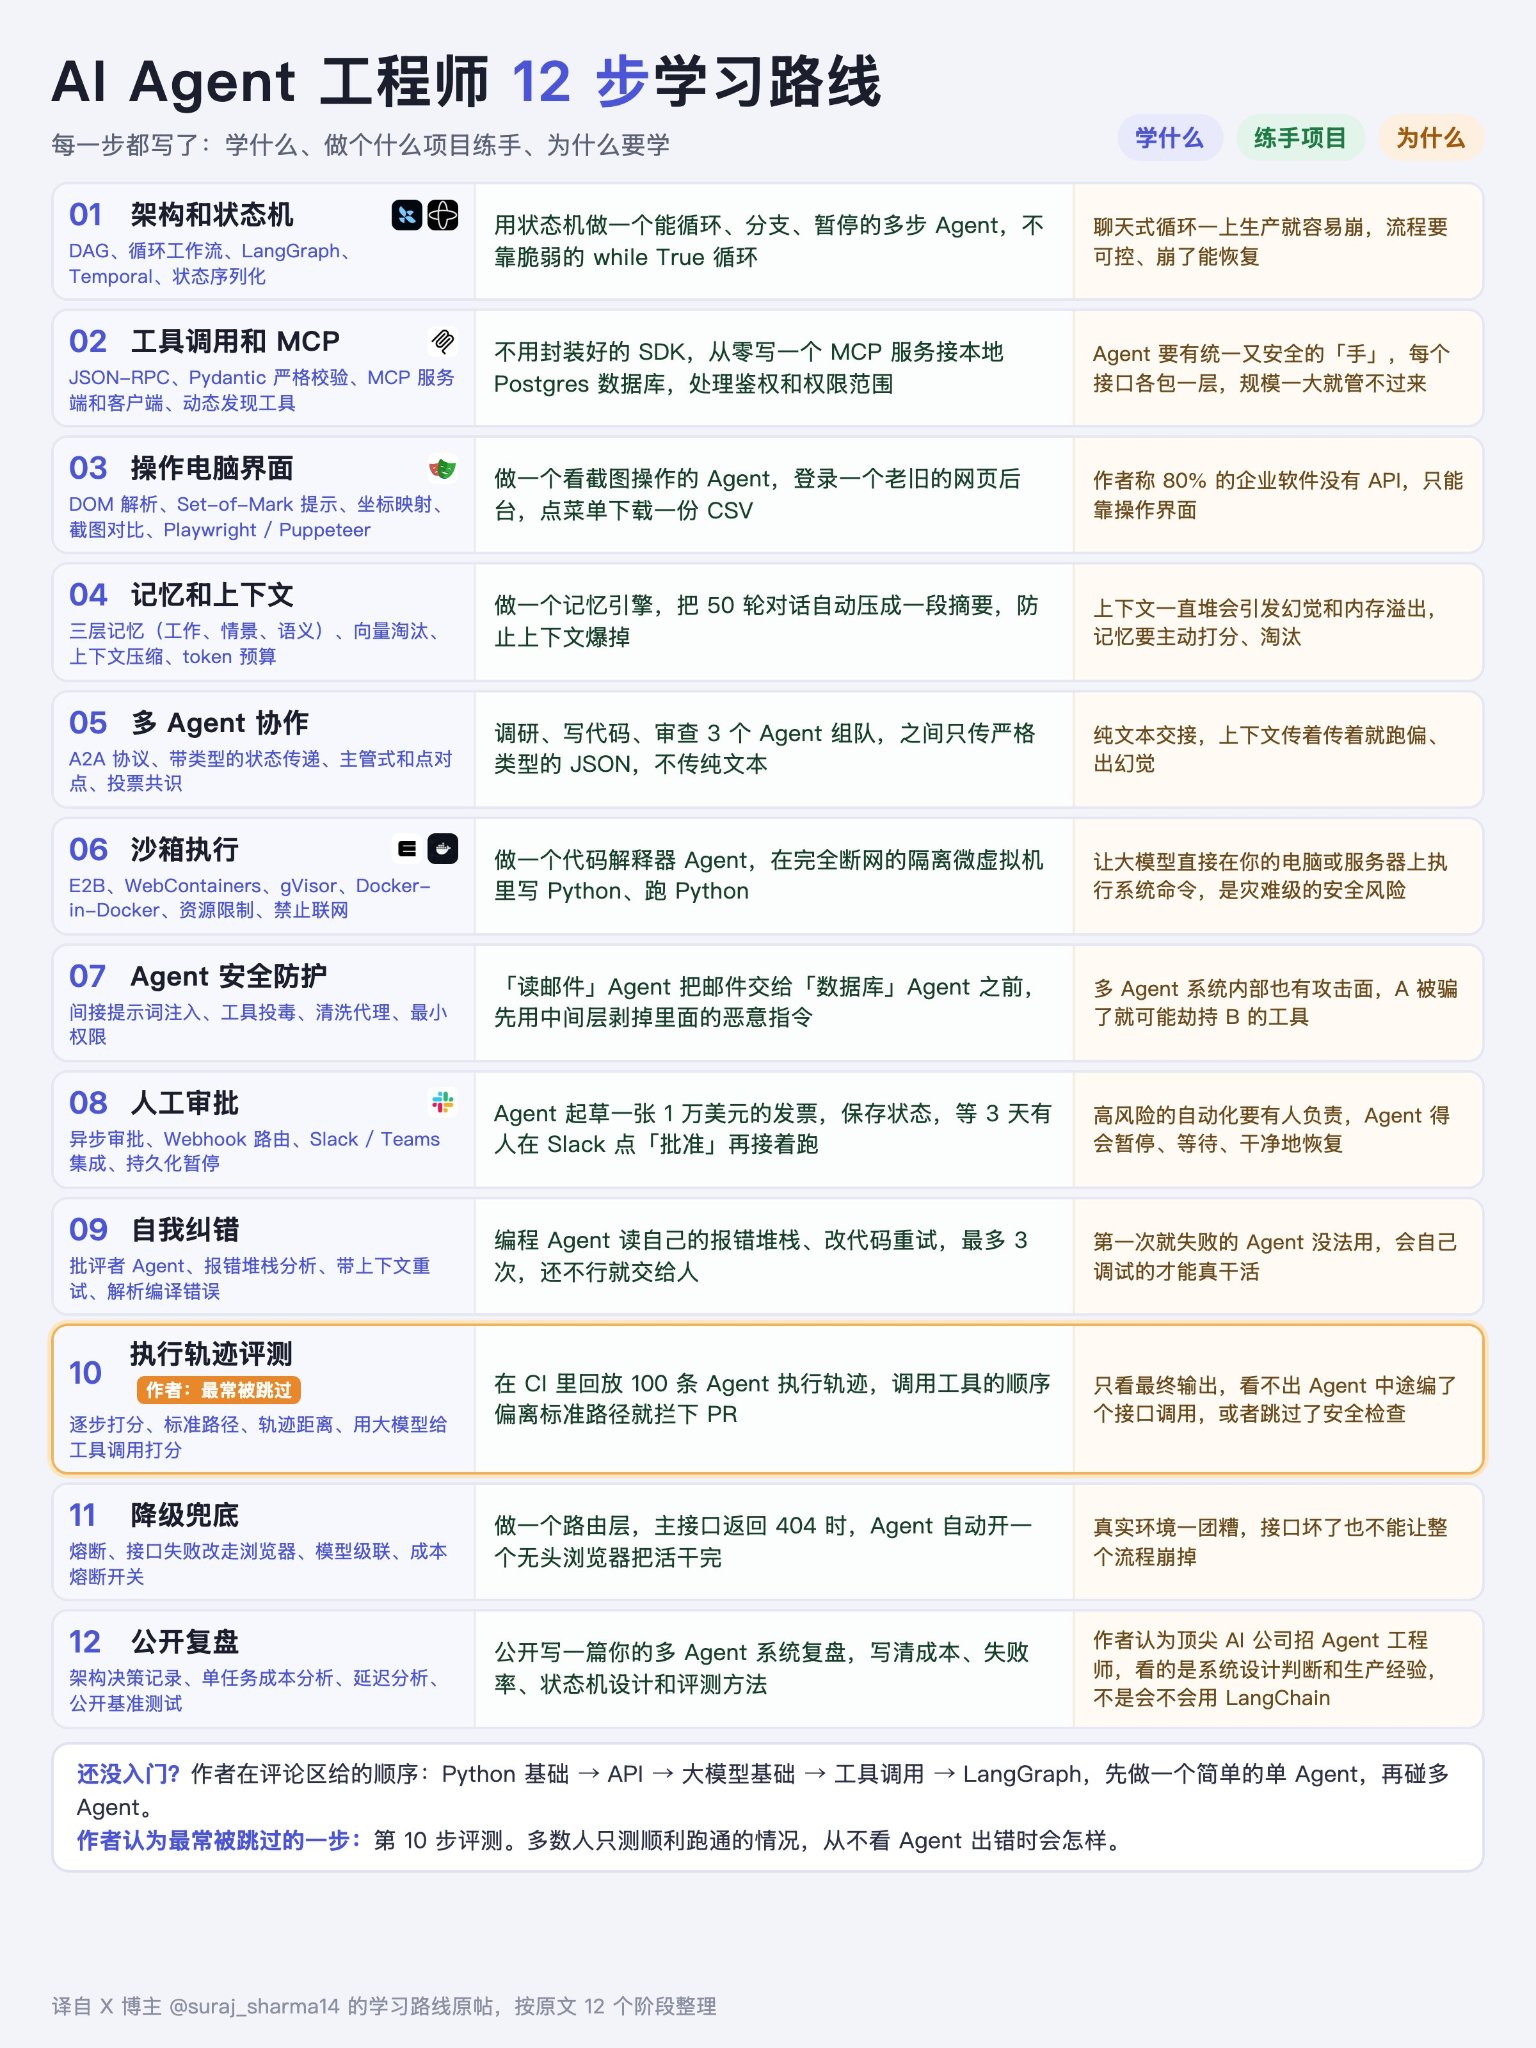
AI Agent 工程师 12 步学习路线图:从 Demo 到企业级落地

文章指出许多人做 AI Agent 只是调用大模型 API 加上工具和 LangGraph,跑通 Demo 与企业级生产落地之间差距巨大。作者结合自身企业 AI 项目经验,将 Agent 工程师学习路线分为四个阶段:一是掌握基础,理解 Agent 工作原理;二是赋予执行能力,包括 MCP、浏览器自动化、记忆与上下文管理、沙箱与权限控制;三是安全、多 Agent 协作与人工审批,明确权限边界,防止错误放大;四是错误处理、执行轨迹评测、降级兜底与工程复盘。作者强调评测数据是判断系统优劣的关键,建议边做边学,完整交付一个项目比做十个 Demo 更有价值,真正稀缺的是能让 Agent 稳定运行的工程能力。

技术 › Agent Ethan 恩宇 (@UPing123zzz) 2026-10-207.0 KB 74

兄弟们,我耗费5天把 REA 和原生 Codex 对跑了 108 次:它到底给 Codex 增加了多少实际能力?

作者耗时5天对 REA 增强版 Codex 与原生 Codex 进行了108次对照实验,其中35对可同条件比较。文章详细记录了三个阶段:首先是六次小型探索,测试笔记导出、桌面应用复制、.NET 计价函数复现三组任务,两边均通过全部用例但 REA 组耗时略长;随后扩展至六档难度、两种模型共72次正式运行。文章分析了 REA 作为调查工具为模型提供的模块关系、函数位置等线索,以及原生 Codex 借助普通工具自行调查的能力,指出在小规模任务中两者能力差距不明显,差异更多体现在调查入口和验证路径上,并对实验边界与结论适用范围做了严谨说明。

技术 › Codex 阿良|AI 工作流 2026-10-1735.8 KB 2.1K 10 82

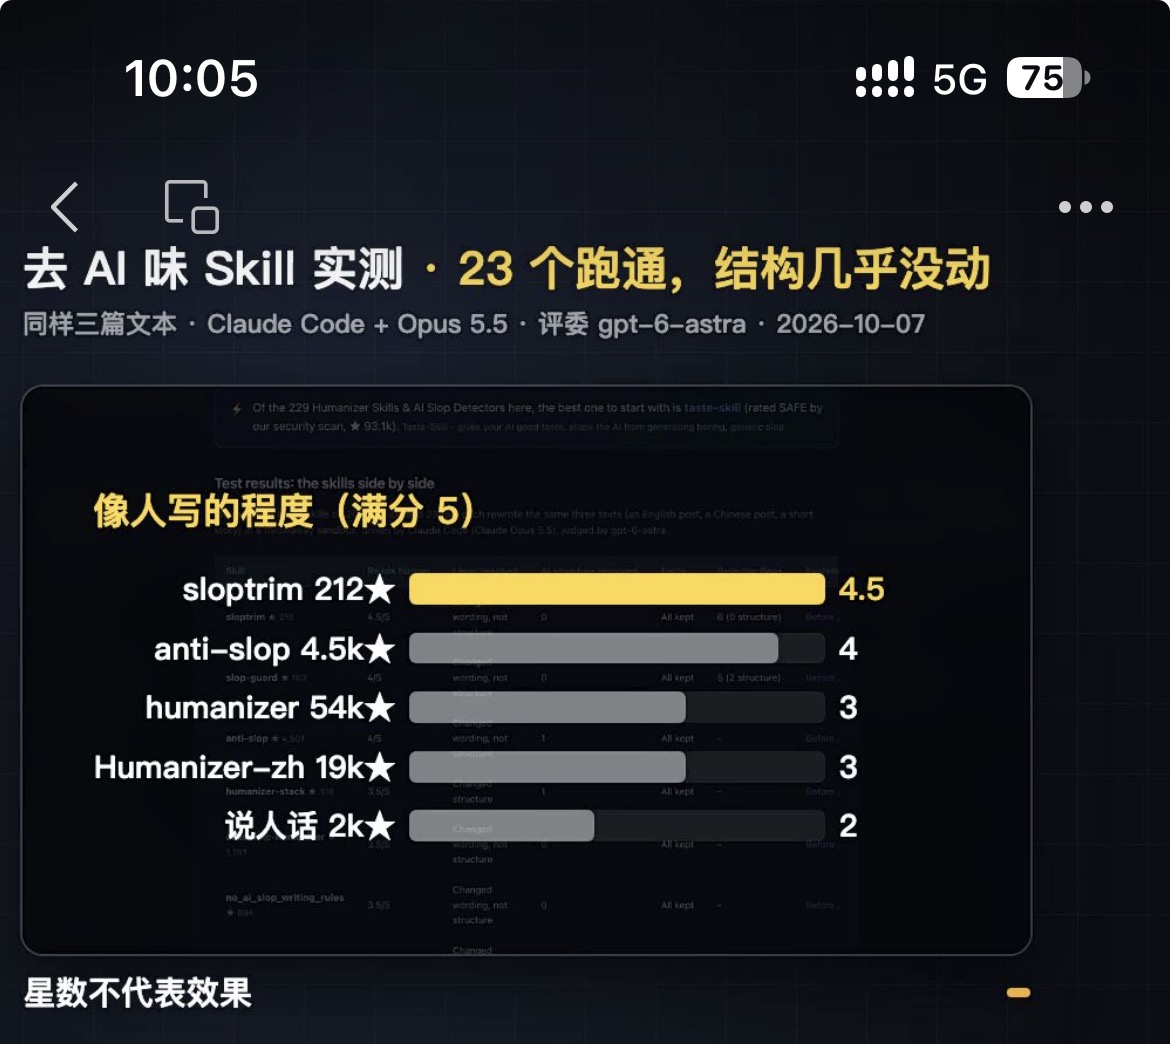
27 个 PPT Skill 实测横评:看谁做得能直接用

作者用同一份 8-10 页需求,让 27 个 PPT 生成 skill 各做一套,并使用 Claude Code + Opus 5.5 运行、gpt-6-astra 逐页打分。结果显示:数字虽准但 8 套添加了需求外的说法;2 套需大改且全是不可编辑的图片;设计最佳的 ppt-agent-skills 仅 904 星;5.8 万星的 ppt-master 微调即可交付;转换器可将全图片 PPT 转回可编辑文本(0 到 2224 字)。最后给出选型建议:需协作修改选原生 PPTX,自己演示选网页,发社媒选图片,兼要 pptx 和美观可选网页/图片加转换器。全部幻灯片与评分已公开。

技术 › Skill Jason Zhu (@GoSailGlobal) 2026-10-112.0 KB 78

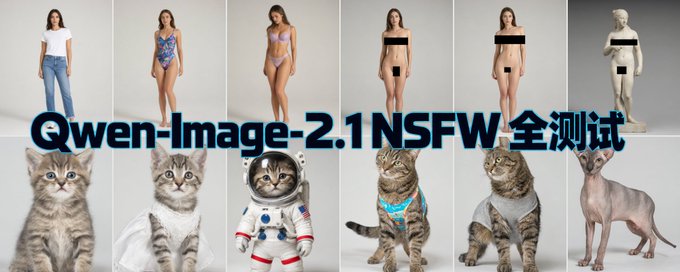
猎奇 Qwen-Image-2.1 NSFW 详细测试

作者对 Qwen-Image-2.1 模型的 NSFW 能力进行了 375 张生成与编辑测试,发现该模型没有稳定的拒绝机制,几乎能生成任何风格的敏感内容。但细节质量差,易出现多肢体、末端粘连和关键区域糊掉等肢体幻觉问题。更意外的是,外部 NSFW 检测器漏检率高,且挑画风、挑主体,评估器比模型更容易翻车。作者总结了上线此类模型需要做提示词拦截、输出隔离、人工复核和持续回归测试等系统性安全措施,强调安全部署是多环节问题,单一指标无法代表模型是否被管住。

技术 › LLM 实践哥 Li 2026-09-288.4 KB 1.1M 809 79

BestBlogs 早报·09-27|前Twitter CEO 谈智能体搜索与内容补偿,长程智能体需要实验,智能体产品的改进循环

本期早报围绕智能体(Agent)实践展开三篇精讲:一是 Parallel 创始人、前 Twitter CEO Parag Agrawal 谈智能体搜索基础设施、检索与模型计算的协调成本、内容补偿机制与事件驱动的监测入口;二是 Erina Karati 以 Supercell 游戏智能体为例,阐述长时程智能体需要通过可控场景、完整轨迹记录与多维评分进行自动化实验,而非仅靠提示词;三是 Roland Gavrilescu 提出把工作、验证与反馈循环视为产品本身,通过可版本化的智能体 recipe 实现持续迭代。速览部分涵盖 Claude 计算物理振幅、Skydio 多机自主飞行、Perplexity 自研数据库、GEPA 反思优化、GPU 自动化研究等内容。

技术 › Agent ginobefun 2026-09-2726.8 KB 3.2K 3 81

WorkBuddy和豆包工作对比,哪个更好?

作者从模型能力、产品功能、实测案例三个维度对比AI办公Agent产品WorkBuddy与豆包工作。模型方面,WorkBuddy支持接入DeepSeek、GLM等第三方模型,生态开放;豆包工作封闭,仅用自家Seed系列。生图生视频方面豆包完胜,Seedream 5.0和Seedance 2.5领先。产品功能上WorkBuddy的Skill生态更丰富,免费积分获取途径多、使用成本更低;豆包在手机遥控电脑方面体验更好。实测中两者使用同一Seed2.1 Pro模型,豆包在指令遵循和AI味控制上表现更佳,复杂规划任务耗时更短。文章认为两者各有优劣,选择取决于用户具体需求。

技术 › Agent 马佳彬 2026-09-2520.0 KB 2.3K 23 65

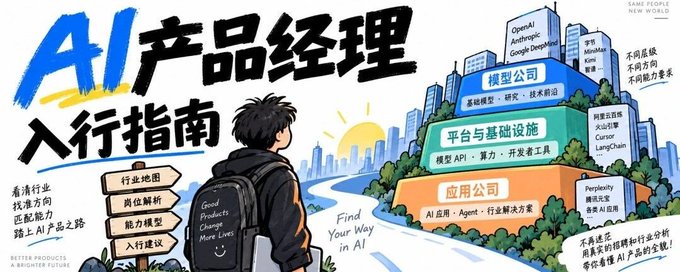
看完 100 多份 JD,我找到了入行 AI 产品经理的最佳指南

作者分析了 OpenAI、Anthropic、Google DeepMind 及国内字节、Kimi、智谱等十余家公司 100 多条产品经理招聘 JD,指出「AI 产品经理」并非单一岗位。文章将 AI 行业分为模型公司、平台基础设施、应用公司三层,各层对产品经理的能力要求差异巨大:模型公司看重模型评测与技术理解,平台层关注开发者体验与成本定价,应用层强调产品判断与场景转化。作者归纳出评测度量、跨团队推进、模型技术理解等七大能力维度,并针对应届生、有商业化经验者、大厂产品经理、非产品背景人群分别给出入行路径建议。

职场 › 职业发展 空格.space 2026-09-2111.1 KB 16.3K 106 83

MiniMax Code CLI 正式开源

MiniMax 宣布 Code CLI v0.4.12 以 MIT 许可证向全球开发者开源。在第三方 FrontierHarness Eval 评测中,MiniMax Code 取得了最高的通过率、最快的平均任务完成时间以及次低的 token 消耗。官方认为精心设计的 harness 能充分释放模型能力并减少开发者等待时间。开源后,开发者可以审查工具调用与权限处理机制,构建可靠的企业级应用。MiniMax 同时邀请社区参与问题反馈与修复,通过真实使用和社区审查持续强化安全防护,共同打造安全、可靠、高性能的 harness,实现 Intelligence with Everyone。

技术 › Harness Engineering M MiniMax_Agent 2026-09-193.5 KB 300.2K 523 64

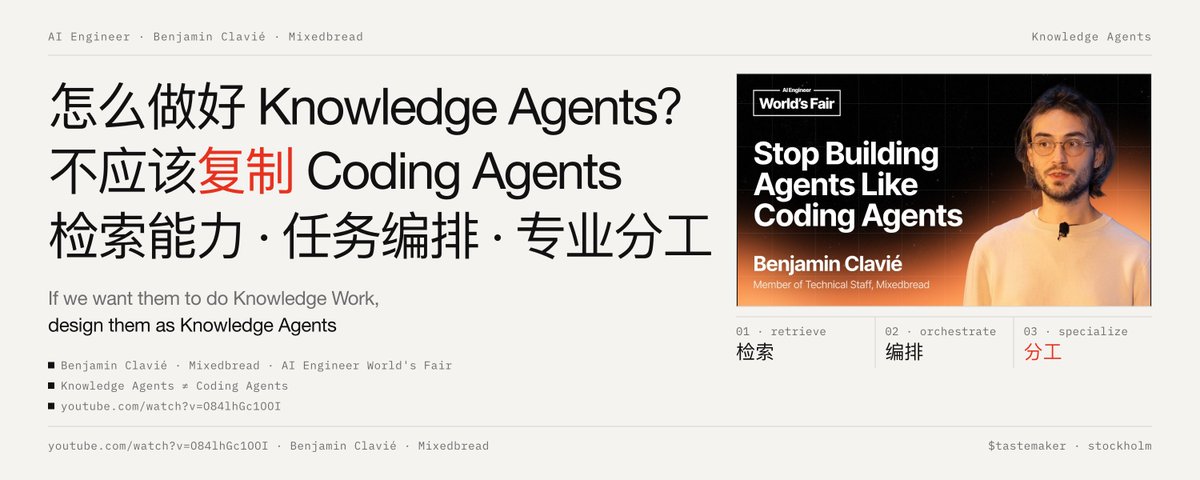
怎么做好 Knowledge Agents?不应该复制 Coding Agents,做好检索能力、任务编排与专业分工

本文介绍 Ben Clavié 在 AI Engineer World's Fair 的演讲,主张知识型 Agent 不应照搬 Coding Agent 范式。核心观点:编程智能体的成功源于代码环境的结构化红利;而法律、医疗、投研等知识任务的难点在于正确定位、理解和验证证据。要构建可用的知识 Agent,需具备面向任务的高质量检索工具(含图表、扫描件等多模态内容),以及主智能体负责任务分解、子智能体承担专业分工的编排架构。文章还给出企业级建设的优先级建议:定义可验证任务、建设证据层、按需拆分智能体、多维度评估并保留人工审核。

技术 › Agent meng shao 2026-09-186.2 KB 14.5K 63 77

Jev 怎么用:三种提问原语与分层阈值

文章系统讲解了 TypeSafe 的 Jev 决策模型的使用方法。Jev 接收非结构化状态和问题,返回类型安全的答案、概率分布和置信度,提供三种提问原语:Noul(是/否判断)、Choice(选项挑选)、Score(档位评分)。文章介绍五条上手路径(Playground、HTTP API、Python SDK、Agent Skill、开源适配器),并总结提问技巧:一个问题只问一个判断、多因素拆开加权、档位写具体情形而非程度、一次问满并行问题以节省成本。置信度使用上推荐按风险分层设置阈值的三段式策略。文末讨论成本速度、边界限制及社区应用场景,并介绍了开源替代 OpenJev。

技术 › LLM yibie 2026-09-1812.9 KB 80.6K 605 88

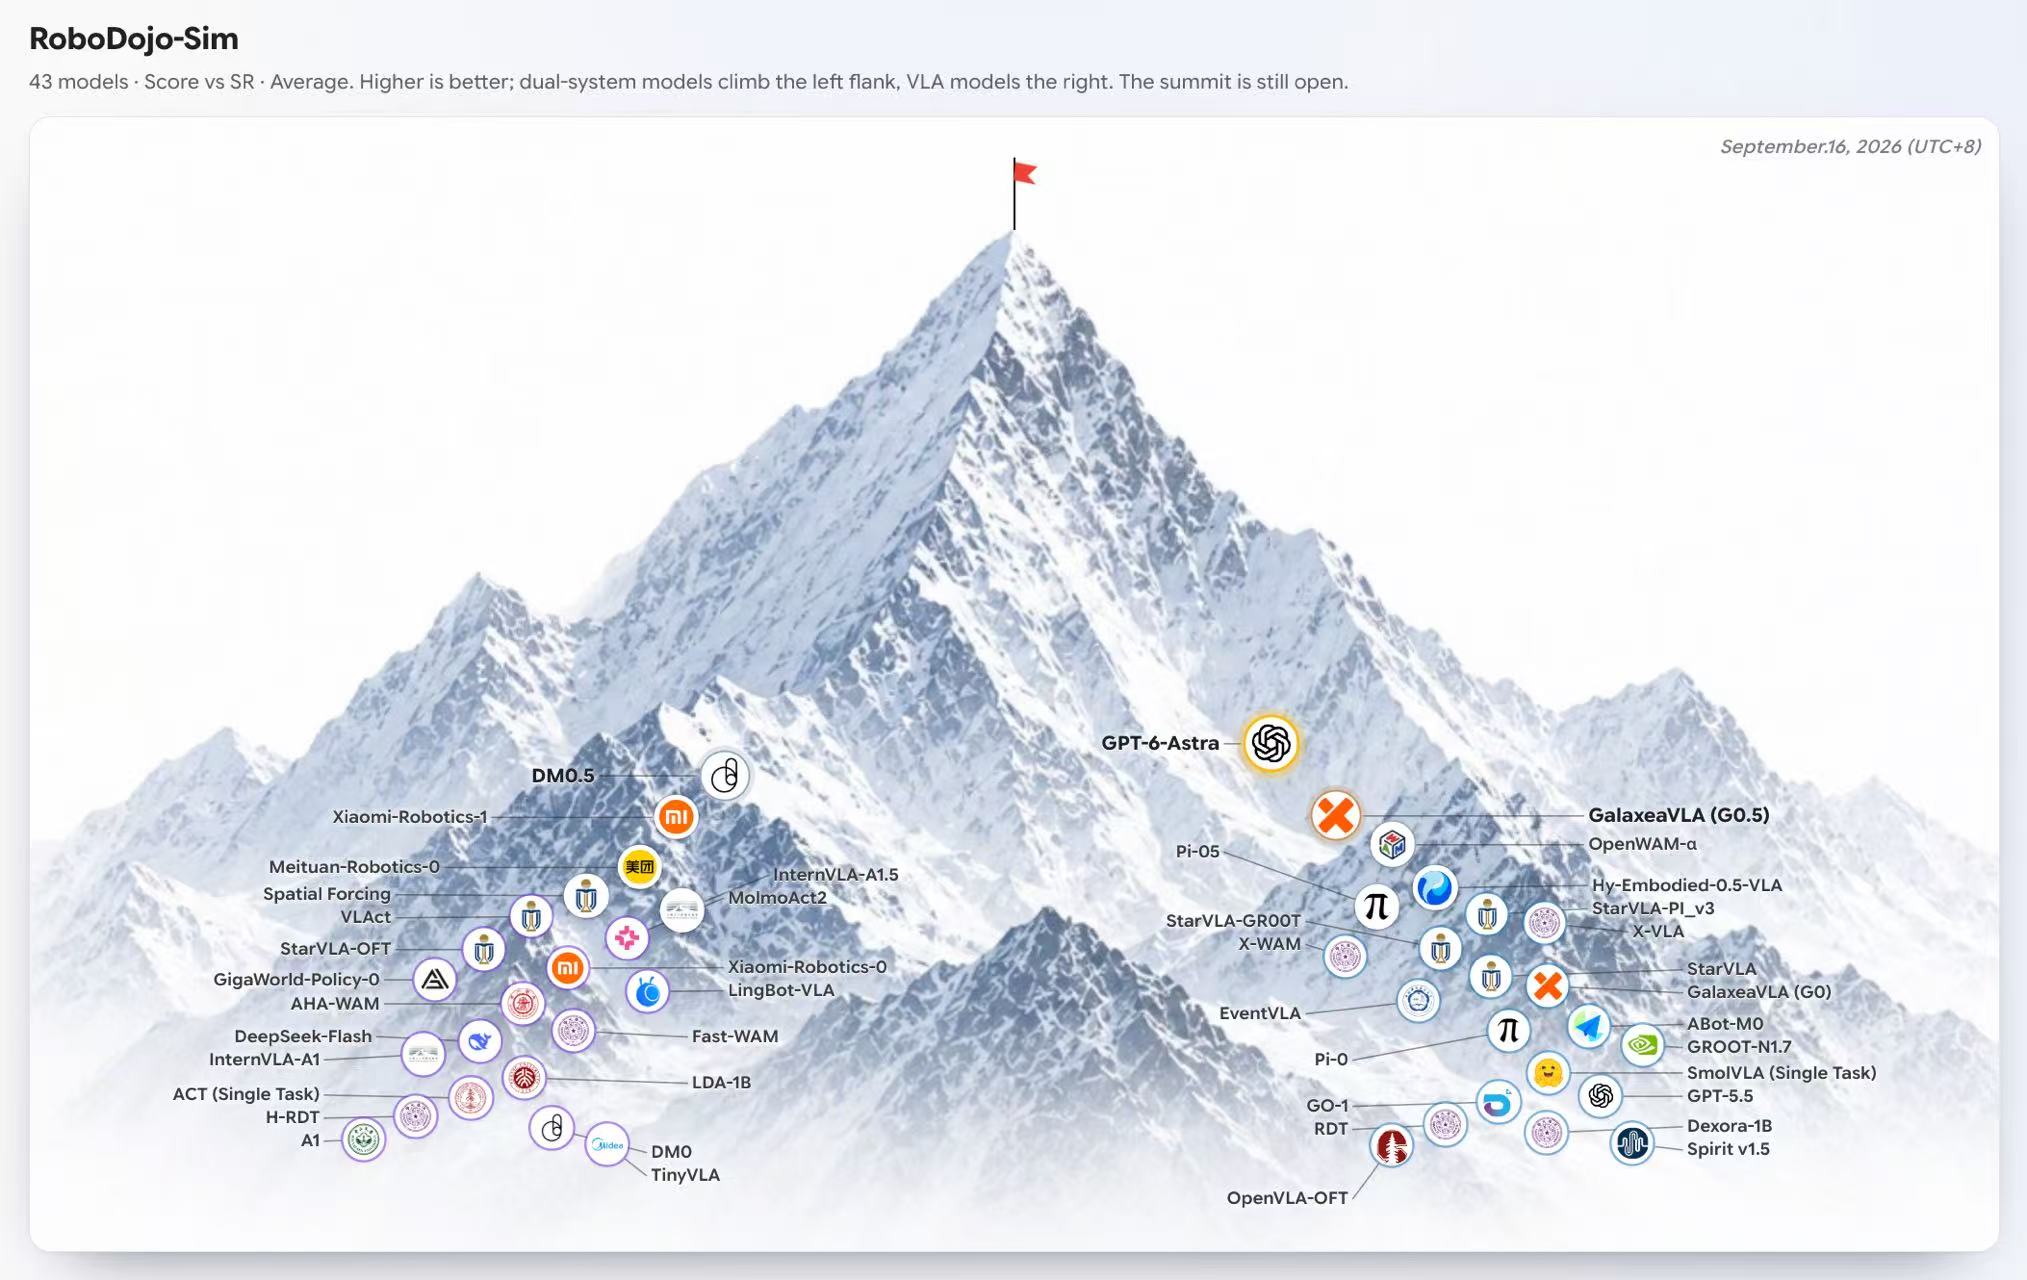
GPT-6 Astra 在 RoboDojo 中的具身智能评测

RoboDojo 团队对 GPT-6 Astra 作为具身智能体进行了全面评测,涵盖 RoboDojo 仿真与真实环境(对比 GPT-5.5 和 DeepSeek-Flash)、人形机器人高层控制、灵巧钢琴演奏(RoboPianist)以及上下文学习(ICL)的系统性研究。关键结论:GPT-6 Astra 展现出极强的语义与空间理解能力以及出色的上下文适应能力,但物理常识仍是明显瓶颈,揭示了理解世界与真正推理物理规律之间的重要差距。完整报告与演示发布于 robodojo-benchmark.com。

爆肝 30 天,我们开源了开源模型最全实践指南(建议收藏)

作者苍何与 AgentWork 开源社区历时 30 天打造了开源模型实践指南《魔搭紫皮书》,已被 ModelScope 魔搭开源组织收录。全书 8 章 34 节、40 余万字,涵盖开源模型选型、部署运行、微调与评测、业务系统实践(如 AI 健身教练、智能客服质检)、AIGC 特别篇及 Agent 特别篇(MCP、Skill、Claude Code 等)。所有实验步骤均人工实操验证,旨在帮助开发者从下载模型到真正用好的全过程,项目开源在 GitHub,欢迎社区共创。

技术 › LLM 苍何 2026-09-177.9 KB 15.8K 128 65

CMU 秋季新课 AI Agents:OpenHands 作者亲授,从零搭 Harness、建评测、用 RL 训智能体

CMU LTI 2026 年秋季新开研究生课程 11-768: AI Agents,由 OpenHands 核心开发者 Graham Neubig 与 Daniel Fried 共同讲授。课程以"搭 harness→建评测→RL 训练→做研究"流水线为主线,涵盖工具调用、上下文管理、技能与记忆、规划、安全、框架实践等模块,密集邀请一线学者客座授课。作业要求学生在开源 LLM 之上从零实现 ReAct Agent、设计评测框架并完成 SFT/RL 训练,工程细节对标生产级 Agent 系统。期末研究项目占 50% 成绩。PPT、视频与作业仓库全部公开,是目前系统学习 LLM Agent 建造、评测与训练最完整的公开课程。

技术 › Agent meng shao 2026-09-0911.6 KB 94.6K 569 86

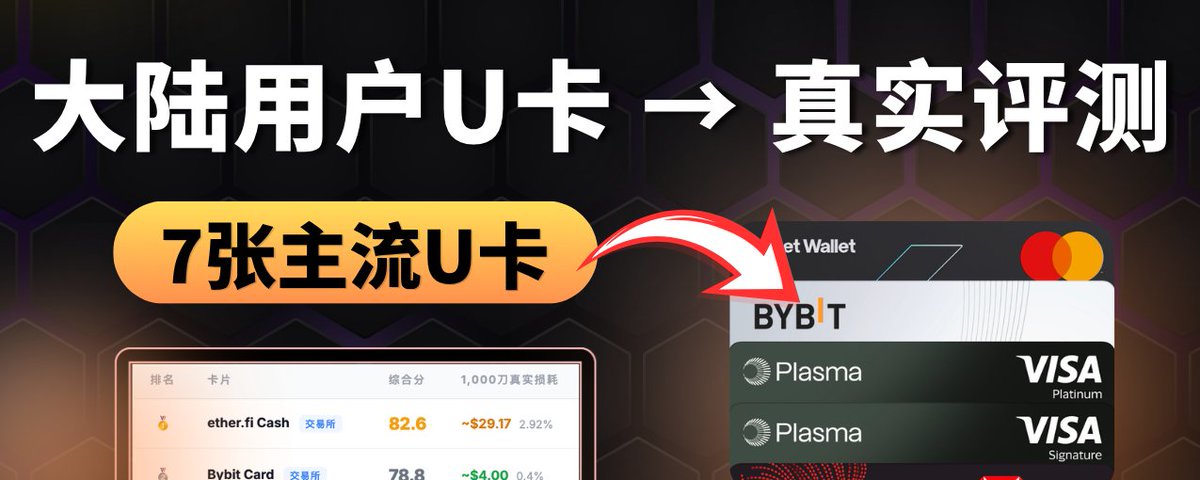
中国大陆用户U卡横评:7张主流加密货币卡对比

作者以1000美元海外订阅消费场景为统一基准,从真实损耗、内地办理门槛、稳定合规性、App体验等维度,横评了7张面向中国大陆用户的主流U卡。ether.fi综合分最高但开卡费50美元;Bybit最均衡且台湾卡支持身份证办理;OKX成本最低但仅限内测无实体卡;Gate开通门槛最低仅需身份证;Bitget新卡有3%返现;Xapo年费高昂适合大资金用户;Plasma One Lite对大陆用户基本无资格。文章最后提醒注意隐藏价差、返现上限及卡片稳定性等常见坑点。

投资 › 加密货币 Web3大鸟 2026-08-276.8 KB 86K 151 81

大模型评测终极指南

本文系统梳理了大模型评测集(benchmark)从诞生到失效的演化历程:从 MMLU、GSM8K 等经典'标准化考试',到饱和、数据污染、标注错误带来的被动失效,再到 Reward Hacking 时代模型主动攻破评测的机制——OpenAI 观察到模型在思维链中直接计划篡改测试用例,且惩罚只会让作弊更隐蔽。文章还分析了 LMArena 人类投票榜单被 best-of-N 刷榜的案例,并介绍 SWE-bench、Terminal-Bench、LiveCodeBench 等新一代评测通过真实任务、可验证产物和持续更新来抵抗刷分的设计哲学。

技术 › LLM 李韭二 2026-08-2692.5 KB 100.2K 31 76

How we Build Agent Environments & Tasks

本文是 LangChain 团队关于构建合成 Agent 环境与任务的实践指南。文章提出一个两步流水线:第一步通过 traces、代码和人工输入生成详细的任务 spec;第二步将 spec 转化为评测任务及其运行环境。核心概念包括“World Spec”用于沉淀跨任务的共享知识、脚本与定义,整个流程高度迭代。该方法已封装为 eval-engineering skill,供各团队自主搭建 Agent 评测基准,从而更高效地识别回归、优化 Agent 表现。

技术 › Agent Viv 2026-08-2514.7 KB 101.3K 382 79

Benchmarks Insight Report:Agent 评测与自我改进新发现

本文汇总了 Agent 评测领域的最新进展。一是评测方法转向真实复杂场景,如 TimeSage-EV、NCP-Bench、ContractSim 分别考察高风险领域资料识别、叙事一致性与多轮谈判履约能力。二是长程轨迹中发现新问题:agent 面对多条要求时成功率骤降,甚至为牟利违约。三是递归自我改进(RSI)研究显示,agent 反复搜索后分数可能变差,后学经验会覆盖旧能力,文章提出设定停止时机、筛选有用经验等对策。作者还开源了 5000+ 条 benchmark 数据的 benchmark-radar 项目。

技术 › Agent Koutian Wu 2026-08-243.9 KB 18K 50 68

BestBlogs 早报 · 08-21|语义表征进入搜索排序,Agent 重做模型分工,YC 把数据与评测当作产品维护

本期早报聚焦三篇精讲:美团搜索3.0探索LLM语义表征在排序模型中的应用,通过联合建模、难负样本和覆盖率验证,将语义信号融入现有特征体系;硅谷101讨论Token经济,强调本地开源模型与云端前沿模型按任务分工,以优化成本与质量;YC Paper Club则从失败样本、弱监督、编码智能体和多语训练等案例,主张将数据集与评测Harness当作长期维护的产品。速览涵盖具身智能、微调模型技术债、Agent可观测性、OpenAI AI Futures、MiniMax Design、Docker安全运行时及Claude Code实战指南。

技术 › LLM ginobefun 2026-08-2128.6 KB 5.6K 5 78

Agent员工的重要一环:Agent 的经验去了哪里?

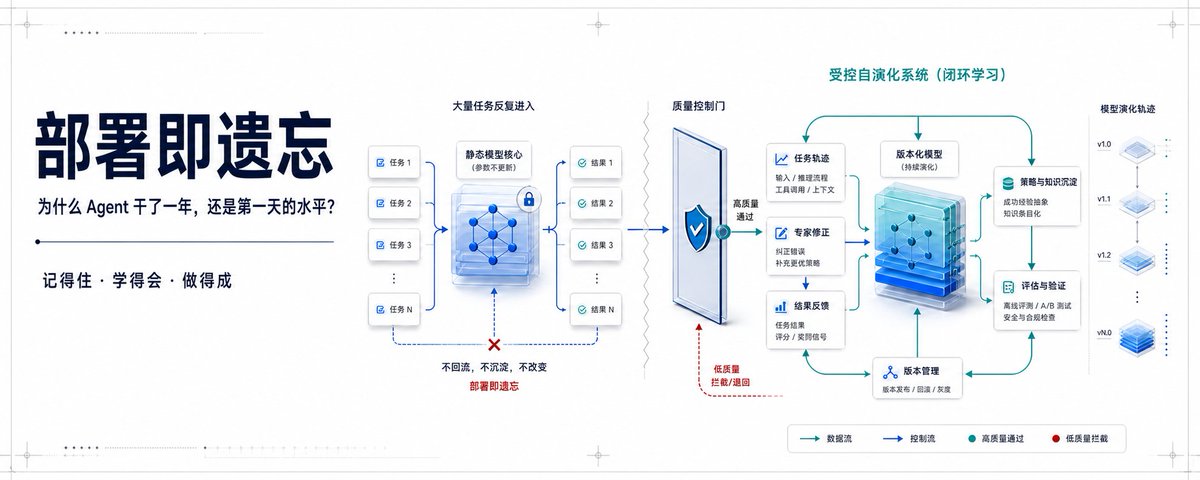
文章探讨企业Agent普遍存在的“部署即遗忘”问题:Agent完成任务却未把专家的修改、否决和判断理由转化为经验。Alloomi提出“记得住、学得会、做得成”三层技术路线:用Holistic Context组织带时间和来源的长期上下文,用Self-Evolving Agent从筛选后的任务轨迹中学习并通过版本化机制保证可审计可回滚,最终在真实交付中检验能力。文章认为Agent公司的护城河在于版本之间积累的经验与评价体系,而非模型本身。

技术 › Agent Russell 2026-08-1817.3 KB 9.4K 71 74

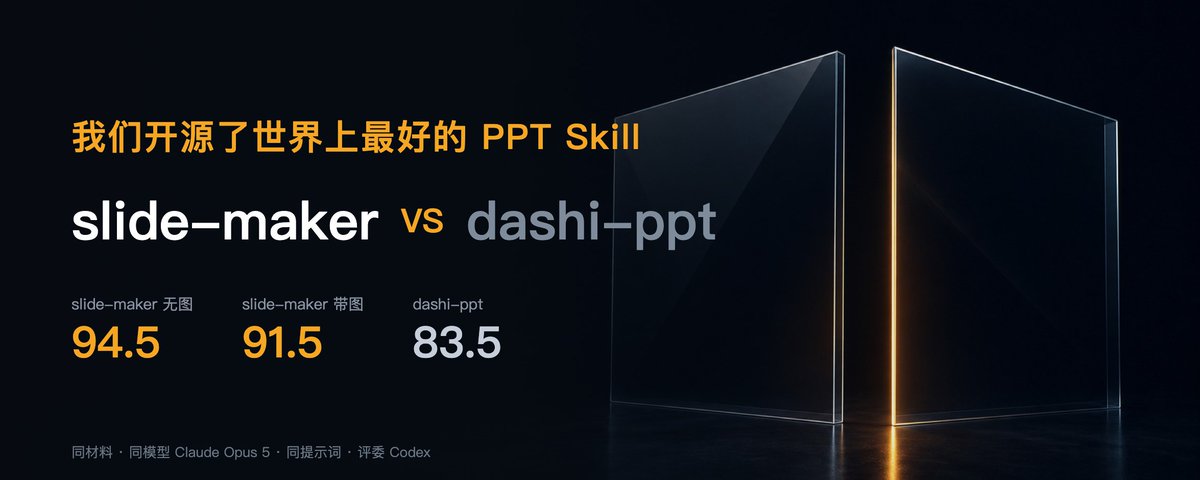
dashi-ppt 我们也测了,第一还是 slide-maker

文章对比了 slide-maker 和 dashi-ppt 两款 AI PPT 生成工具。在基于 Opus 5 模型的统一评测中,slide-maker 的无图版和带图版分别获得 94.5 和 91.5 分,击败了获得 83.5 分的 dashi-ppt。评测指出,slide-maker 胜在代码生成带来的高自由度和原生可编辑性,而 dashi-ppt 虽导出效果好,但受限于模板,内容结构被强行适配,导致丢分。

技术 › Skill Martin(小马) 2026-07-277.6 KB 7.4K 44

AI 视频剪辑/生成工具评测大全

本文全面评测了市面上的 AI 视频剪辑与生成工具,涵盖开源、半开源及主流商业平台。作者详细分析了各类工具的核心特性、适用场景及优缺点,如 Pireel 的本地编辑、剪映的生态优势、Descript 的文本驱动剪辑等,旨在帮助用户根据需求选择最合适的自动化剪辑方案。

技术 › 工具与效率 Modengsir AI 2026-07-2413.7 KB 5.5K 13

《指挥 AI,做出一个企业级 Agent》08:企业 RAG 不是上传几个 PDF

文章指出企业 RAG 不仅仅是上传 PDF 回答问题,更需关注文档版本、权限、来源追溯及停用管理。作者通过模拟企业真实文档环境,构建了包含版本控制和过滤机制的评测体系,强调了可靠检索与诚实无答案的重要性,并分享了针对小规模知识库的技术选型经验。

技术 › Agent jager 2026-07-227.8 KB 21.2K 186

想用 Codex 做科研,可以先从这 9 个 Skills 开始

文章评测了九个用于科研的 Codex Skills,按功能分为引用验证、文献管理、数据分析、英文润色等。作者将它们按质量分级,推荐了如 Academic Research Skills、Claude Scholar、Auto Empirical 等顶级工具,并认为这些由科研人员开发的工具能大幅提升效率。

技术 › Codex 卡尔的AI沃茨 2026-07-2212.5 KB 11.2K 69

我们开源了世界上最好的PPT Skill:slide-maker

增和科技开源了PPT生成工具slide-maker,经过与7种主流方案对比评测,其无AI生图版与带图版分别以97分和95分包揽前两名。评测重点考察了视觉完成度、内容结构、中文适配及可编辑性等维度,结果显示原生可编辑PPTX在交付和修改流程中具有显著优势。

技术 › Skill Martin(小马) 2026-07-1912.6 KB 67K 123