Wiki 知识库

全部文档 / 标签: LLM

1042 篇
清除

Grok 4.6 实战指南:速度、沟通与验证的艺术

本文是作者对Grok 4.6的深度评测与使用指南。作者将其作为日常编码和知识工作的主力工具,强调其信息密集的沟通方式和显著的速度提升。文章通过多个项目(如电子表格应用、策略游戏、Excalidraw演示模式等)对比了Grok 4.5与4.6的表现,发现4.6在细节处理和整体完成度上更优。作者还分享了提示词工程的关键发现:短提示词配合明确偏好效果良好,而加入“验证并迭代至生产就绪”的句子是最高杠杆的改进。文章最后探讨了视频即代码(Remotion)的实践,并总结了Grok 4.6在自主迭代和验证方面的能力。
技术 › LLM eric zakariasson 2026-08-1311.6 KB 766.8K 3K 74

Claude Code + OpenRouter 保姆级教程:一次配置,长期使用

本文详细介绍了如何将Claude Code与OpenRouter结合使用,实现通过API按量付费调用Claude模型。文章从注册OpenRouter、充值、创建API Key,到安装Claude Code、写入长期配置、验证配置等步骤进行了保姆级讲解,并解释了配置原理,包括环境变量的作用、配置持久化机制以及常见问题处理。适合不方便直接使用Anthropic API或希望统一管理多个模型的用户。

技术 › Claude Kelvin 2026-08-1318.4 KB 79

RW科研skill更新:为什么AI科研需要凭据管理

本文介绍了RW Research Skill中rw-research-passport的更新,新增了Research Credential功能,用于记录科研讨论形成的决定,并提供可验证和回溯的凭据。文章详细说明了凭据的内容、权限分类、不可篡改性及验证机制,强调了聊天记录不能直接作为执行权限的原因,并展望了无人值守的“睡后科研”场景。作者认为凭据管理是实现AI科研自动化和安全性的关键。

技术 › Agent Roland.W 2026-08-126.3 KB 33.6K 26 77

Superpowers为什么在毁掉你的工作流?

本文作者作为Superpowers插件早期用户,分析了该插件中14个skill在当前前沿模型(如GPT 5.6 Sol)日益强大的背景下的适用性。作者认为,虽然每个skill本身具有合理的软件工程依据,但作为强制工作流组合使用时,会导致流程复杂化、过度设计、时间和token消耗增加,反而降低开发效率。建议开发者根据实际需求提炼使用,而非全盘套用。

技术 › 工具与效率 FeiZ 2026-08-128.4 KB 15.8K 22 76

中文写作去除AI味 - 我的15条原则

本文分享了作者关于中文写作去除AI味的15条原则,强调写作应像真人一样自然、具体、有细节和节奏,避免模板化、口号化、大词和宏大叙事。作者提倡自然段落、清晰结构、具体场景和真实细节,反对碎片化分段和机械排比,并给出了标点、结尾、口述整理等方面的具体建议。这些原则旨在帮助写作者提升文章的真实感和可读性,避免AI生成的痕迹。

技术 › 工具与效率 Hanya Hu 2026-08-124.7 KB 4.2K 39 77

Can software factories actually work?

本文探讨了软件工厂(software factories)的概念及其可行性。文章指出,随着AI代理编写代码的速度超过人类审查能力,软件工厂应运而生,旨在通过自动化流水线实现代码的标准化交付。然而,HumanLayer CEO Dex Horthy 的系列文章《Why Software Factories Fail》引发了广泛讨论,他认为由于模型训练中缺乏对代码可维护性的评估,完全无人干预的“暗灯”软件工厂难以规模化。文章分析了软件工厂的现状、争议点,并指出其核心问题在于将“决定构建什么”与“构建”分离,建议代理需要更深入的问题上下文才能做出更好的架构决策。

技术 › Agent PostHog 2026-08-1213.4 KB 10.5K 79 73

Hermes 登顶背后:一个 Web3 团队的进阶之路

本文深度剖析了 Hermes Agent 在 OpenRouter 上登顶的现象,指出其成功并非源于技术代差,而是精准闭合了“挑战者增长系统”:承接 OpenClaw 教育成熟的用户池,建立“可委托性”体验差异。文章对比了 Hermes 与 OpenClaw 在 Crypto 问题上的不同取向,阐述了 Hermes 作为任务总控层与 Claude Code 等专业 Agent 的分层协作关系,并分析了其商业模式与用户价值公式,揭示了 Web3 背景在组织层面提供的独特优势。

技术 › Agent Jacob Zhao 2026-08-1125.1 KB 72.7K 26 81

我找到了AI写作问题的根源(附解法)

本文深入剖析了AI生成文字中常见问题的根源,包括自造隐喻和英文句法迁移导致的语义错配。作者指出,AI写作常使用需要读者二次理解的表达,以及“反映出”等连接词将事实、解释和结论混为一谈。文章结合训练数据背景,解释了英文表达习惯为何会进入中文,并提出了与AI协作写作的具体方法:先分类原材料,再检查自造说法和连接词,最后使用提示词让AI输出原句、问题和建议。最终强调,人需对文章中的判断负责。

技术 › LLM Roland.W 2026-08-118.4 KB 114.7K 122 77

FDE:AI进入产业深水区后,一种新的职业复利

文章探讨了AI进入企业应用深水区后,FDE(Forward Deployed Engineer)这一职业的兴起与价值。随着模型能力趋同,企业部署AI的瓶颈转向数据、权限、流程等实际问题,FDE成为连接模型与业务的关键角色。文章提出个人FDE复利公式,强调问题价值、现场深度、反馈密度、抽象能力和复用范围的重要性,并详细阐述了FDE如何将隐性经验转化为系统规则、如何应对生产失败、以及如何构建职业复利。最后指出,FDE的核心在于靠近问题、承担上线责任,并将现场经验转化为可复用的能力,从而推动企业AI的落地与迭代。

技术 › LLM Russell 2026-08-1112.5 KB 6.6K 16 76

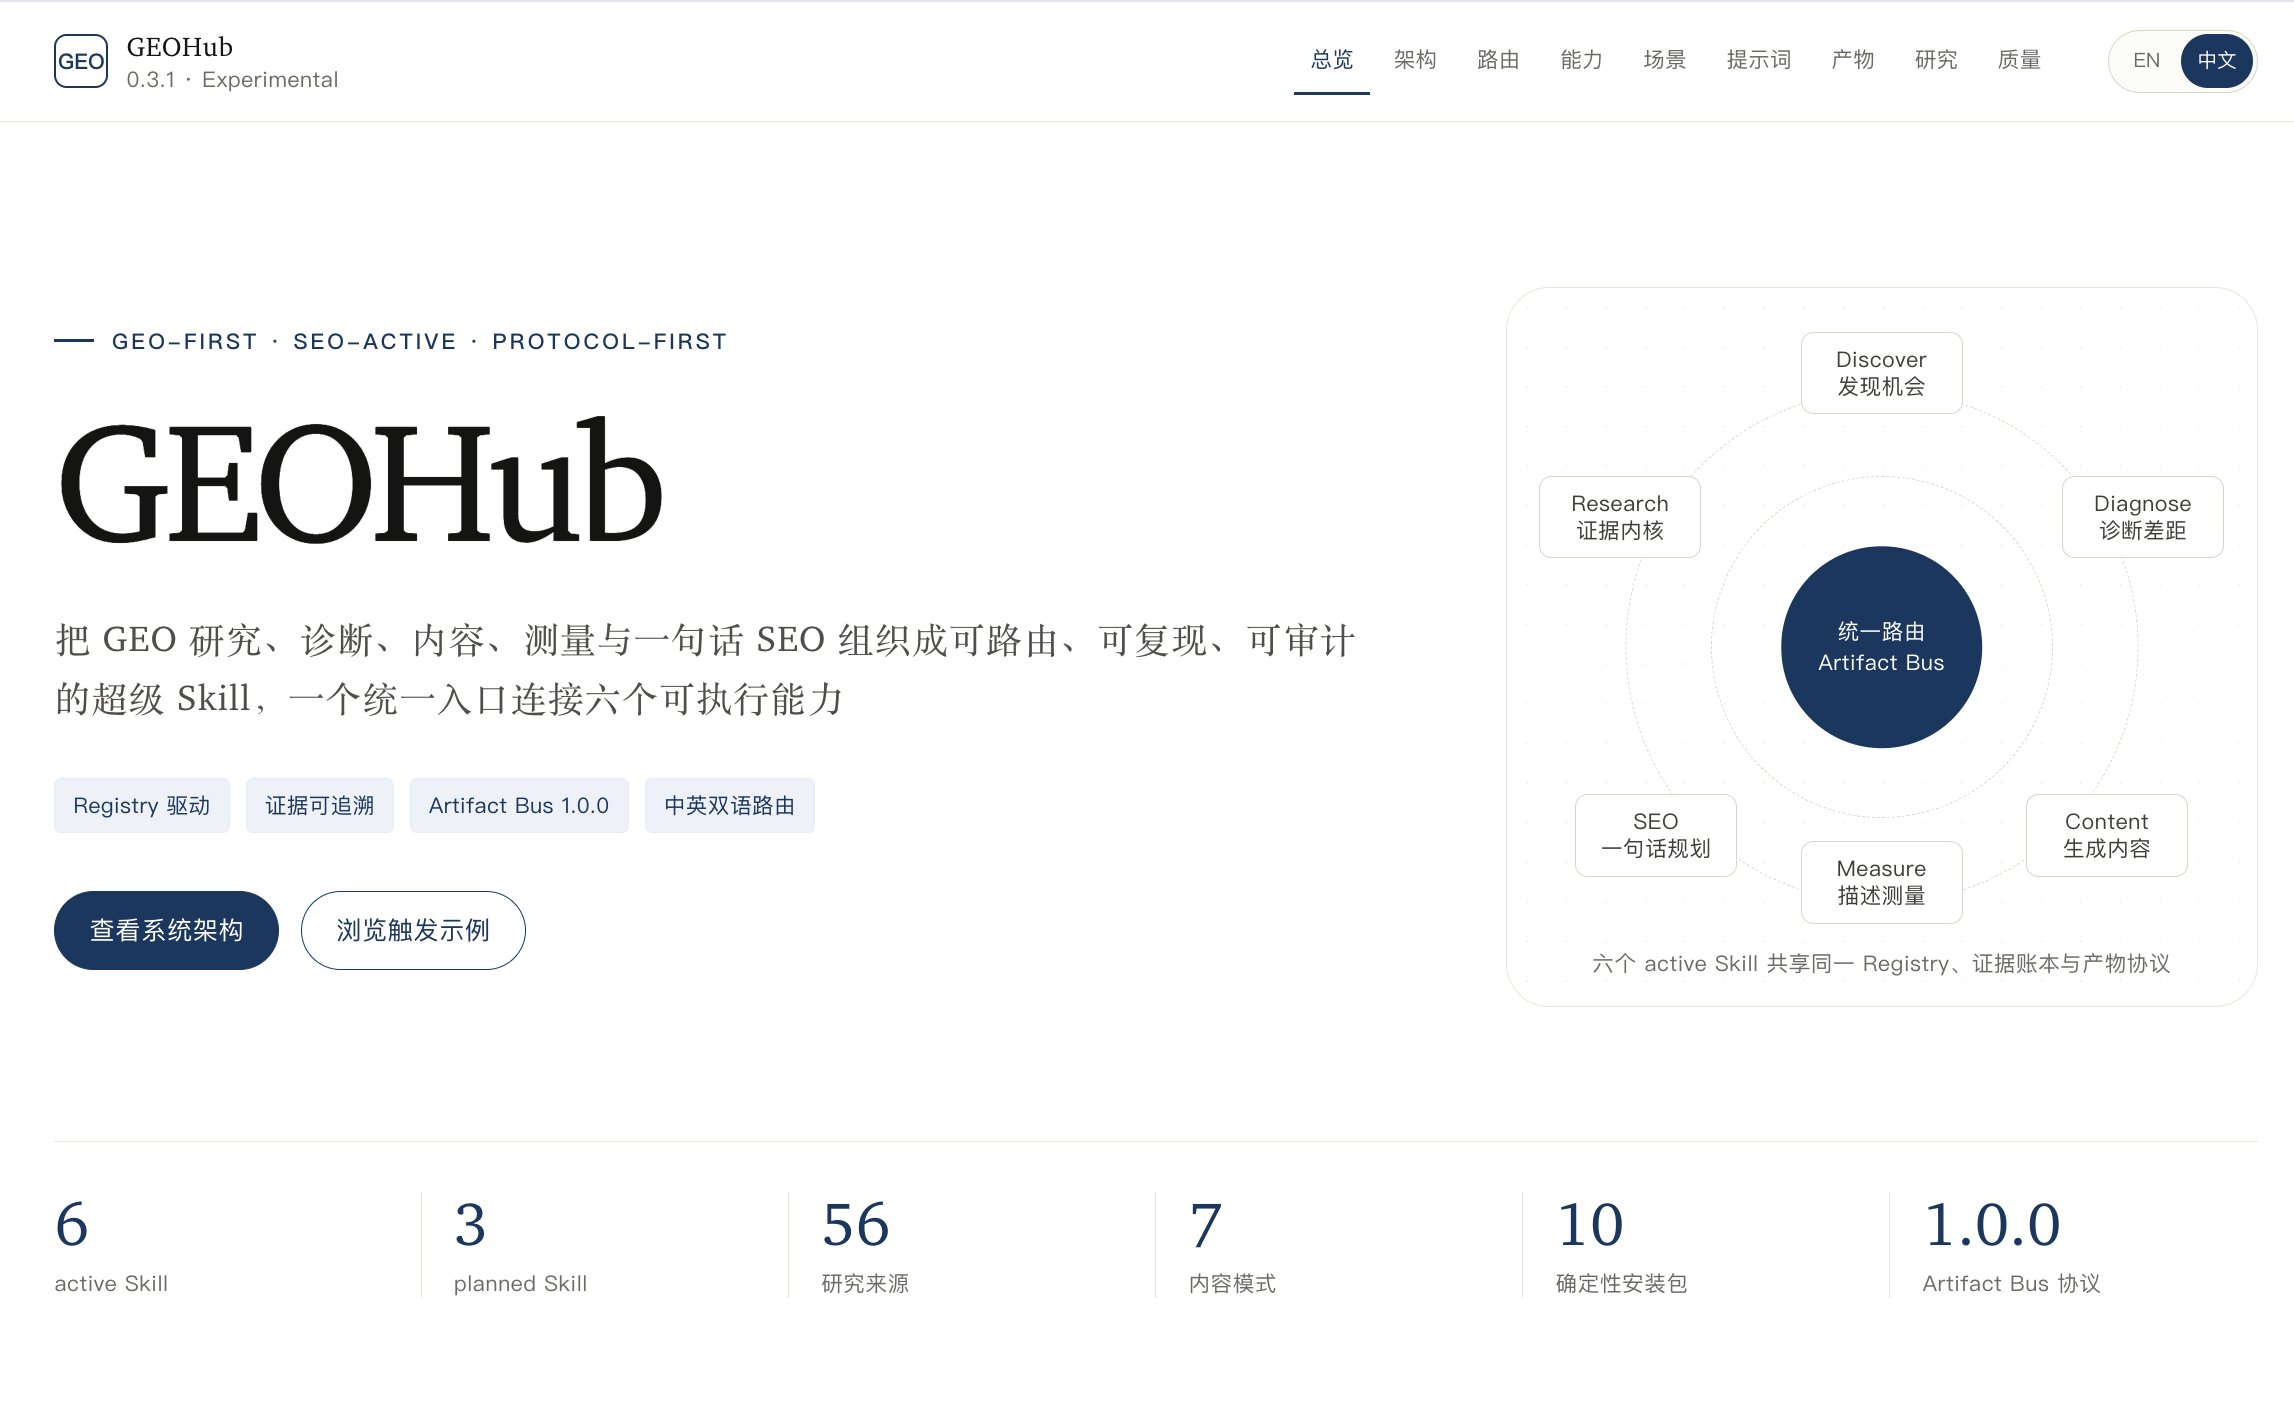
开源GEO超级Skill:GEOHub

作者姚金刚开源了一个名为GEOHub的GEO超级Skill,该Skill将GEO研究、诊断和内容生产等能力整合进统一的能力注册表,并为测量与SEO提供统一入口。GEOHub包含能力注册表、路由器、工作流编排、多个Skill、统一产物协议、JSON Schema、证据账本、质量报告、CLI、测试和打包体系等组件,支持中英文GEO请求,覆盖14类GEO与SEO任务,包括品牌诊断、内容生产(如标题、科普解释、对比、榜单等)和SEO规划。该Skill基于最新国内外GEO研究数据集及54篇相关论文进行了校验和迭代,旨在为GEO服务、运营、品牌AI搜索优化、内容工程和网站优化提供支持。

技术 › Skill 姚金刚 2026-08-112.7 KB 72

How frontier models train on outcomes in 2026

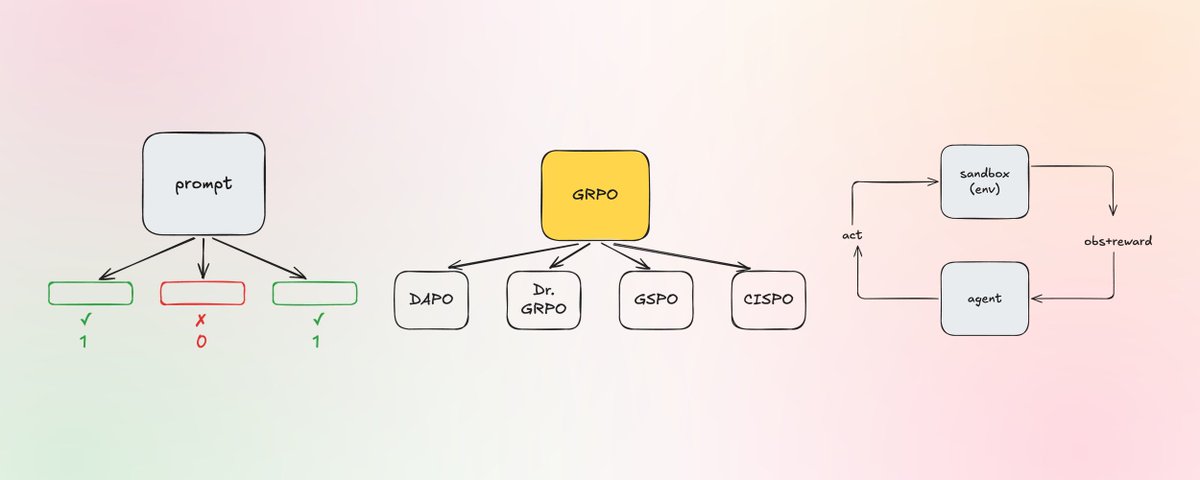
本文是《训练智能体》系列课程的补充材料,探讨了前沿实验室在2026年如何利用强化学习(RL)训练模型。文章回顾了从RLHF到RLVR的演变,指出可验证奖励已成为主流,GRPO算法衍生出多种变体,并强调了RL从单一答案向环境交互的转变。通过引用OpenAI、DeepSeek、Meta等实验室的报告,展示了这些模式的实际应用。

技术 › LLM Sergio Paniego 2026-08-1119.8 KB 31.1K 181 75

向AI代理收费:Cloudflare的新模式与创业机会

文章探讨了AI代理如何改变互联网商业模式,以及Cloudflare推出的AI Crawl Control、Pay Per Crawl和Monetization Gateway如何让网站向AI代理收费。作者提出了两个创业方向:一是为特定细分市场提供结构化数据服务,二是帮助企业优化其网站以更好地被AI代理理解和推荐。文章强调了从人类注意力经济向机器资源经济转变的趋势。

技术 › LLM The Startup Ideas Podcast (SIP) 2026-08-1114.6 KB 63.6K 123 84

Eval工程:如何真正评估AI系统是否变得更好

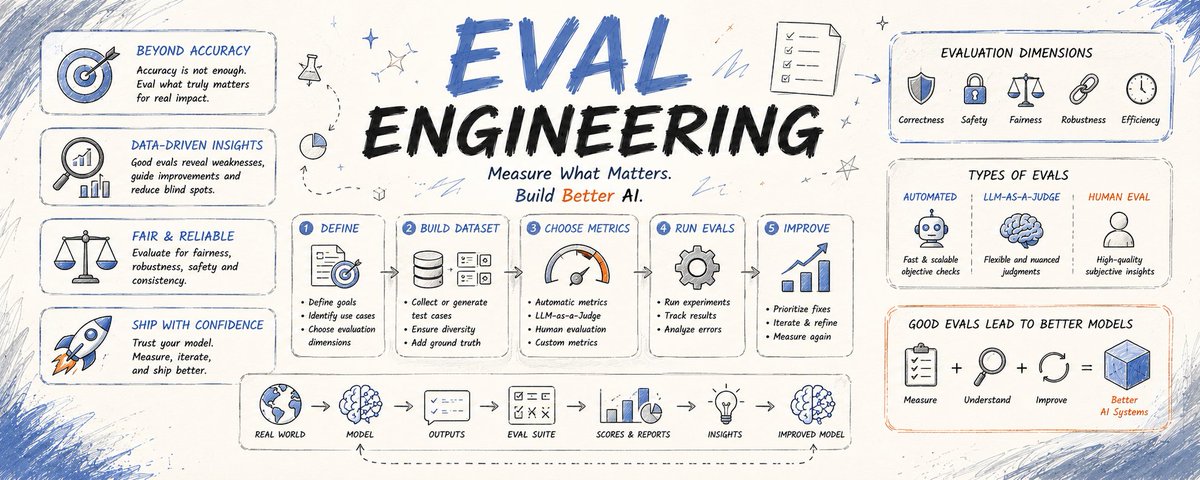
文章介绍了“评估工程”的概念,强调主观感觉无法替代系统化测试。构建可靠的AI评估体系需要三个核心部分:具有代表性的数据集、客观的打分器和预设的及格阈值。作者详细阐述了如何构建包含常规、边缘和已知失败的数据集,以及如何选择精确匹配、规则打分或模型打分机制。最后强调,评估必须在每次系统变更时自动运行,以防微小的改动引发严重的隐性回归。

技术 › Agent wast3 2026-08-1111.3 KB 45.9K 133 85

从RAG到上下文图谱:9步路线图

文章探讨了传统RAG在处理多跳推理问题时的局限性,指出检索文本块无法捕捉复杂的实体关系链。为此,作者提出了一种向“上下文图谱”转型的9步实施路线图。该方法通过从文本中提取实体与关系三元组,进行实体规范化以避免图谱割裂,并构建双向边表。图谱通过多源验证分配边权重,并为每条边附加来源以实现精准溯源。最终,检索过程转变为图谱遍历,通过反向可达性分析和路径权重排序,精准定位多跳查询的答案。

技术 › LLM Morlex 2026-08-1011.5 KB 310.6K 465 83

AI夺走了我的生意,现在成为了我的分发渠道

作者从事B2B代写业务十年,因AI冲击而被迫转型为全职B2B内容创作者。她发现,终结其旧业务的AI技术,反而成为了新业务的巨大分发渠道。通过追踪工具,她发现自己的文章在各大LLM引擎中获得了数百次AI引用。她提出,传统的曝光量等指标正在贬值,而“AI引用数据”正成为创作者更具长期价值的核心资产。此外,相比于受众广泛的泛创作者,深耕垂直领域的专家在AI时代更具竞争优势。

职场 › 职业发展 Kaleigh Moore 2026-08-1015.7 KB 18.9K 32 82

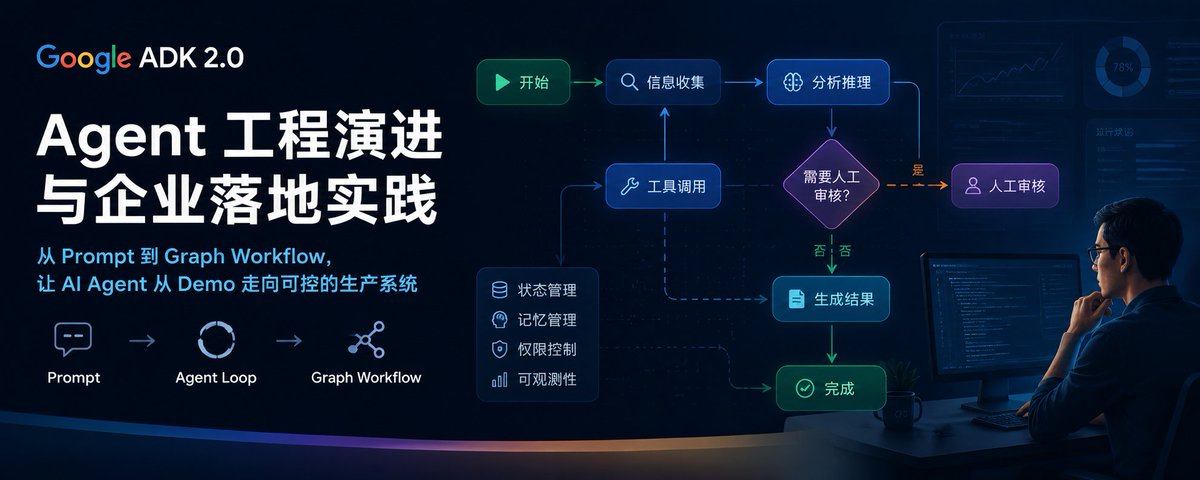
Google AI Agent 工程演进与企业落地实践

文章探讨了企业级AI Agent的工程演进,指出系统设计重心已从单纯调优Prompt转向构建稳定的Graph Workflow。通过解析Google ADK 2.0,说明了Prompt、Agent Loop与Graph Workflow在处理不同业务时的分工:模型负责不确定性判断,代码约束确定性流程。作者建议企业落地时从单一清晰流程切入,逐步引入工作流,并配合状态持久化、幂等重试等工程手段,以确保Agent系统的可靠性、可控性与业务成功率。

技术 › Agent 左海有个洲 2026-08-1010.9 KB 2.7K 14 85

一文科普 主流 LLM 注意力机制

本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88

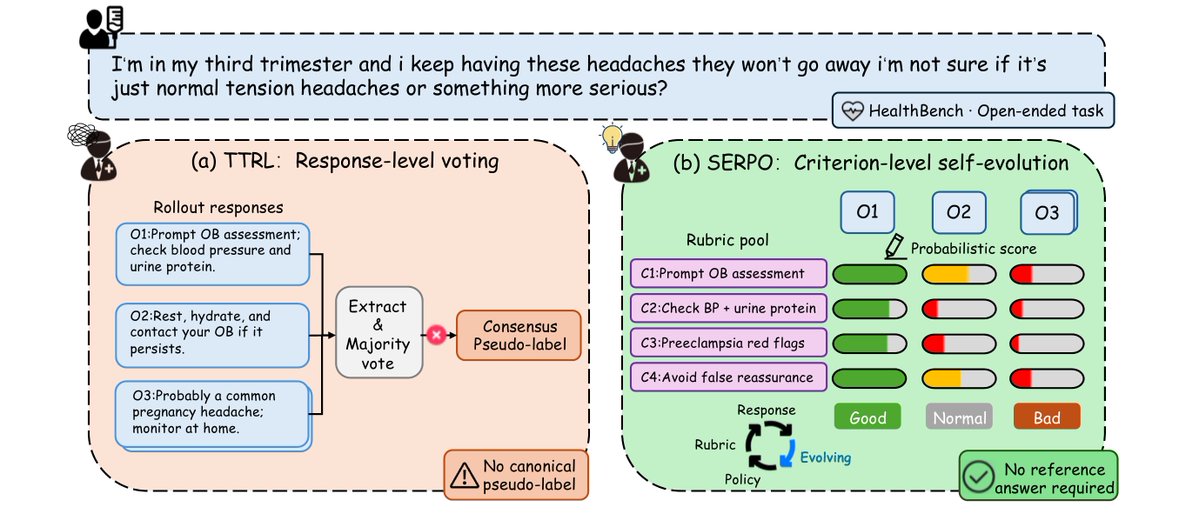
模型部署后的无标注自进化:SERPO机制解析

现有无标注强化学习(TTRL)多依赖多数票生成伪标签,难以处理医疗建议等复杂开放式任务。为此,文章提出SERPO(自进化判据策略优化)机制。它通过模型自身采样的回答提取质量判据生成奖励,无需任何外部监督或人工标注,并将收益直接写入模型权重。实验表明,SERPO不仅大幅提升了模型在垂直领域的性能,且在OOD测试和长程训练中持续进化,证明了其能将质量标准转化为持久的模型能力。
技术 › LLM 青稞社区 2026-08-1018.5 KB 2.7K 16 87

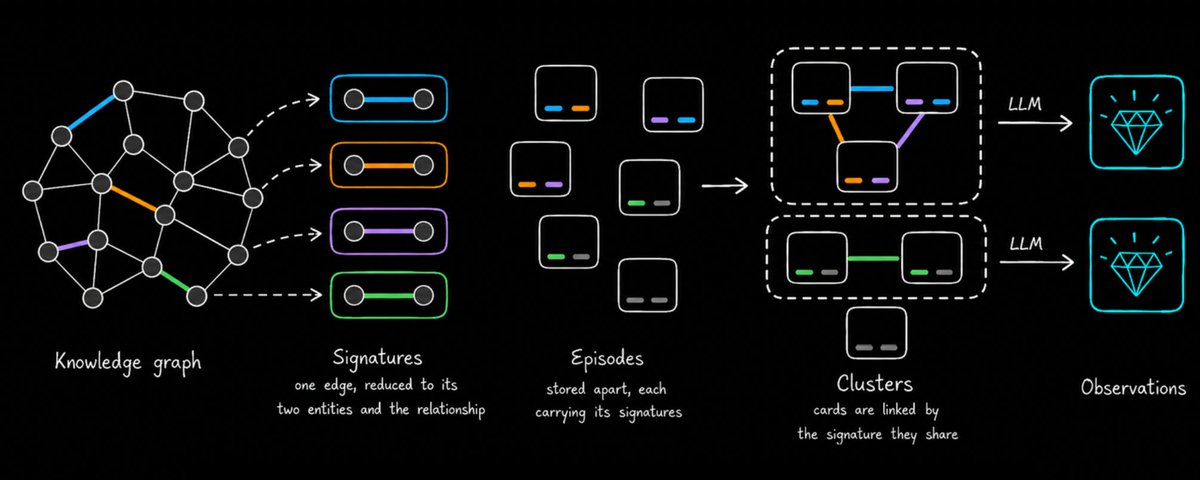
超越事实检索:AI Agent记忆系统中的模式识别与洞察

当前AI Agent的记忆系统虽能准确存储与检索单一事实,却无法像人类一样洞察事实间的结构关联。本文以项目管理为例,指出传统的检索优化无法解决这一局限。为此,Zep平台(开源Graphiti)引入了“Observations(观察)”功能,通过构建知识图谱,结合确定性算法聚类与LLM总结,跨实体分析并生成深度的上下文洞察。这种机制不仅能追溯证据,还能帮助Agent从全局视角识别如“核心阻塞点”等复杂问题。

技术 › Agent Akshay 2026-08-1013.7 KB 106.3K 517 81

AI Coding Agent 会追问了,为什么仍交不出能跑的项目?

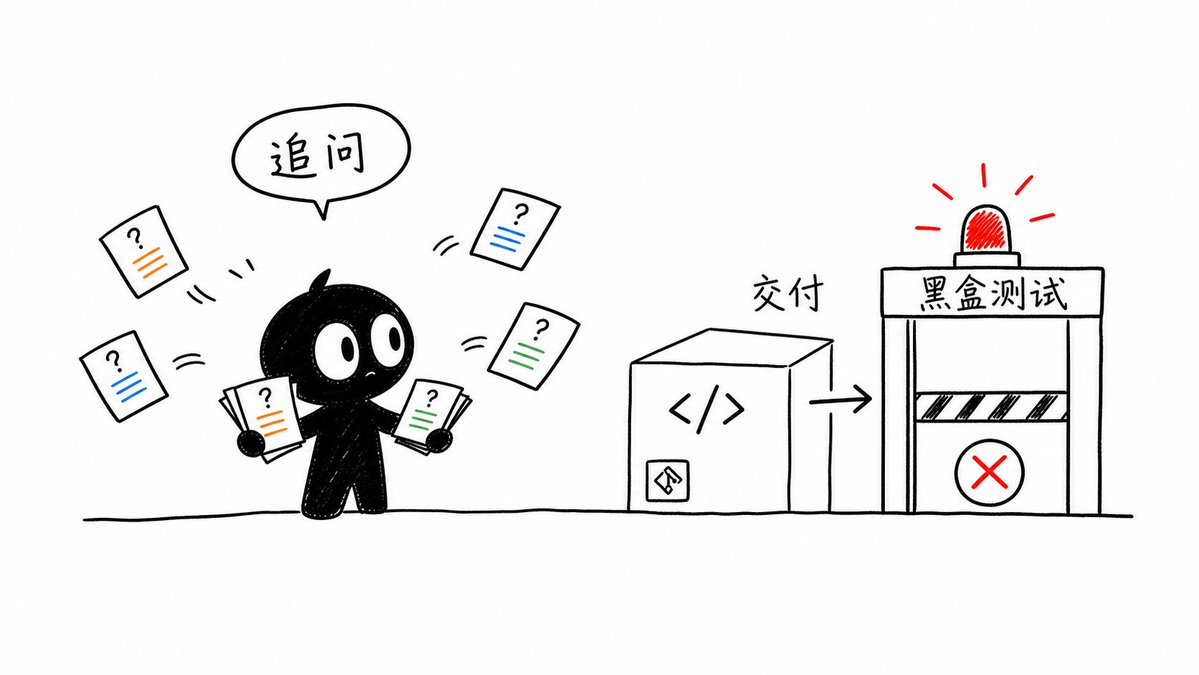
文章探讨了AI Coding Agent从修复代码转向承接完整产品需求时面临的挑战,介绍了全新的评测基准ICAE-Bench。该基准通过反向构造模糊需求、受控用户交互与黑盒测试发现,即使最强的Agent综合通过率也仅有38.2%。文章指出,澄清对话必须沉淀为结构化的状态,并建议企业构建包含版本化需求、干净环境重建和分类测试的闭环交付链路,以真正跨越从“聊天编程”到“项目交付”的鸿沟。

技术 › Agent 烟花老师 2026-08-0913.6 KB 1.4K 5 86

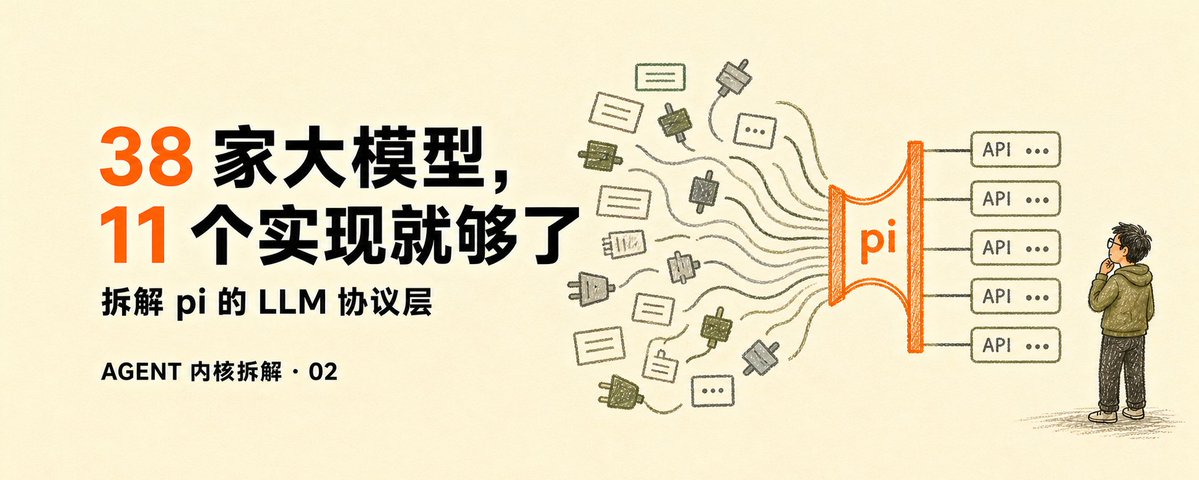
38家大模型11个实现就够了:拆解LLM协议层

本文剖析了开源Coding Agent的内核架构,重点讲解LLM协议层的精巧设计。一方面,通过分离API协议与服务商配置,仅用11个协议实现便覆盖了38家大模型,新增支持仅需十几行配置代码;另一方面,确立了“模型调用永不抛出异常”的核心契约,将网络中断、鉴权失败等异常情况统一降级为带有stopReason的普通事件流。这种设计不仅保持了上层Agent循环代码的优雅,还能在发生错误时保留已生成的部分内容,极大提升了系统的鲁棒性与用户体验。

技术 › Agent Yanhua 2026-08-0915.5 KB 17.8K 8 93

10个将Claude与Obsidian结合打造第二大脑的GitHub开源项目

本文介绍了10个优秀的GitHub开源项目,旨在利用Obsidian作为存储层,让Claude真正记住用户的个性化知识,从而打造真实的“第二大脑”。文章首先剖析了项目背后的三大核心架构:Karpathy LLM Wiki模式(大幅节省Token)、Anthropic的Skills架构(按需加载技能)以及MCP桥接(支持实时读写)。随后,作者详细盘点并测评了这10个开源库,逐一分析了它们的核心功能、安装难度、适用人群及局限性,为想要构建个人AI知识库的用户提供了极具价值的实践指南。

技术 › 工具与效率 kai 2026-08-0918.3 KB 391.9K 319 87

你的 Agent 框架应该能够自我修复

文章探讨了AI Agent在生产环境中失败时,传统可观测性工具仅能提供追踪数据,而无法自动解决修复问题的瓶颈。作者介绍了开源平台Opik,它通过四层架构(Tracing追踪、Ollie诊断与修复、Test Suites测试集、Agent Sandbox沙盒)形成闭环。该平台能自动诊断错误链路,内置代码代理提出修复方案,并将真实失败转化为回归测试,从而实现Agent框架的自我修复与持续优化。

技术 › Agent Akshay 2026-08-099.9 KB 1.8M 1.6K 84

Harness Engineering:构建决定AI Agent可靠性的七层架构

文章指出,AI Agent的可靠性不取决于模型权重,而取决于周围的脚手架(Harness)。Harness分为七层:执行环境、工具接口、上下文管理、编排与生命周期、可观测性、验证和权限边界。这七层都是需要编写和版本控制的代码,而非模型属性。此外,Harness还分为由模型构建者提供的内部Harness和开发者自行组装的外部Harness。

技术 › Agent zostaff 2026-08-0920.2 KB 26.4K 45 88

AI 名词小白入门白皮书

本文专为缺乏技术背景的AI初学者撰写,旨在理清AI领域的常见名词。作者将AI系统划分为七个层级,详细拆解了从大模型、产品、Token、RAG、MCP到Agent、Workflow、Loop和Graph等核心概念。文章指出新手常犯的认知混淆,并通过具体的任务案例展示AI系统的工作流程。最后,为初学者提供了从分清对象到理解工具执行的实用学习路径,帮助读者建立完整的AI概念地图。

技术 › LLM Kimberly 2026-08-0921.3 KB 31K 150 88

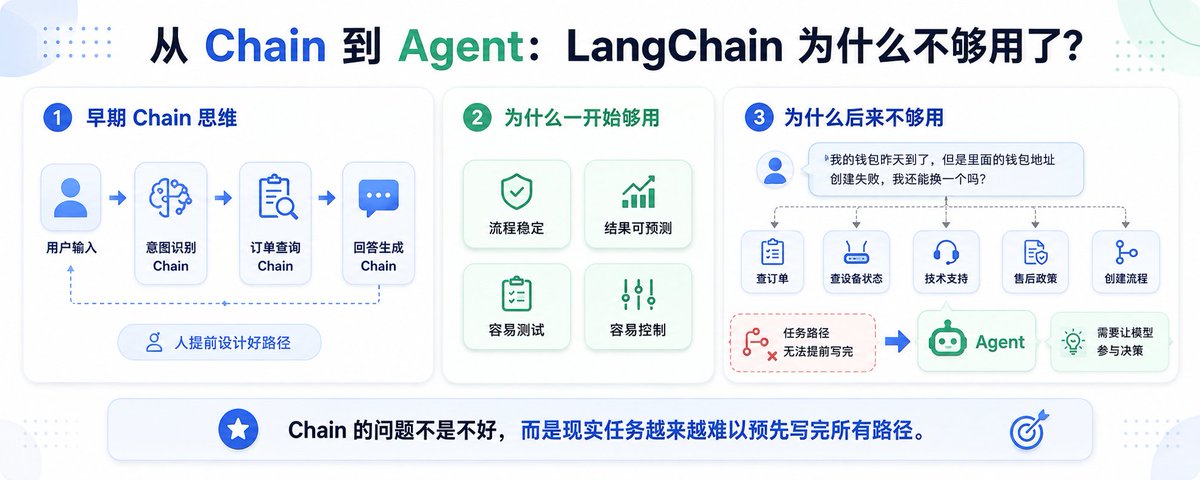
从 Chain 到 Agent:LangChain 为什么不够用了?

文章探讨了AI应用架构从Chain到Agent的演进过程。早期AI应用多采用固定流程的Chain模式,具有稳定、易控的优点,但难以应对现实中复杂的用户问题。为此,架构转向了Agent模式,将决策权由人工预设流程交还给AI动态决定。这种方式提升了灵活性,但也带来了失控风险,从而引出了后续如何为Agent划定边界的探索。

技术 › Agent jager 2026-08-097.5 KB 320 7 68

Kimi K3 3D WebGL 开发配置与提示词指南

文章详细介绍了如何利用 Kimi K3 模型开发 3D WebGL 应用。相较于 Claude 和 GPT-5.6,K3 在 Three.js、WebGPU 等复杂 3D 场景和着色器代码生成上表现优异。作者分享了在开发工具中接入 K3 的步骤、构建 3D 场景的提示词公式,以及视觉循环测试流程。并建议开发者采用混合策略:用 Claude 处理快速逻辑,用 K3 应对复杂的 3D 空间计算,从而发挥两者最大优势。

技术 › 前端 Nazar 2026-08-096.9 KB 5.8K 10 83

使用 SGLang 和 Torch Profiler 对 LLM 推理进行性能分析

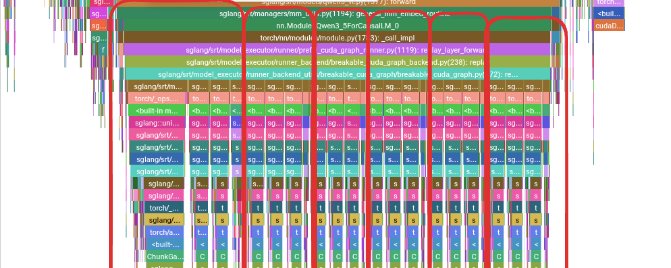
本文详细介绍了如何使用 SGLang 内置的 Torch Profiler 对大语言模型(Qwen3.5-0.8B)进行推理性能分析。作者阐述了如何通过追踪 CPU 和 GPU 端事件来定位计算瓶颈,并结合屋顶线模型证实单批次解码主要受限于内存带宽。文中展示了如何利用 Perfetto UI 分析 Prefill 阶段的性能追踪数据,将其底层计算操作与模型的混合架构(如 Gated DeltaNet 和全注意力机制)精准映射,帮助读者深入理解 LLM 的底层执行流程。

技术 › LLM Jino Rohit 2026-08-0913.8 KB 104.1K 916 88

DeepSeek 刚支持了 OpenAI Responses API,但你可能还不知道它是什么

本文梳理了 LLM API 格式的演进史。从早期 Chat Completions 的无状态聊天映射,到各厂商接口分叉,再到 Agent 时代为解决状态管理和缓存问题诞生的 Responses API。新 API 引入了服务端状态、检查点分支及内置云端工具,模糊了模型与 Agent 的边界。随着 DeepSeek 宣布原生兼容该接口,预示着 Responses API 正取代旧标准,成为 AI 行业的新共识。

技术 › LLM SaladDay 2026-08-098.1 KB 80

LAB: 模拟律师事务所知识环境与AI智能体基准测试

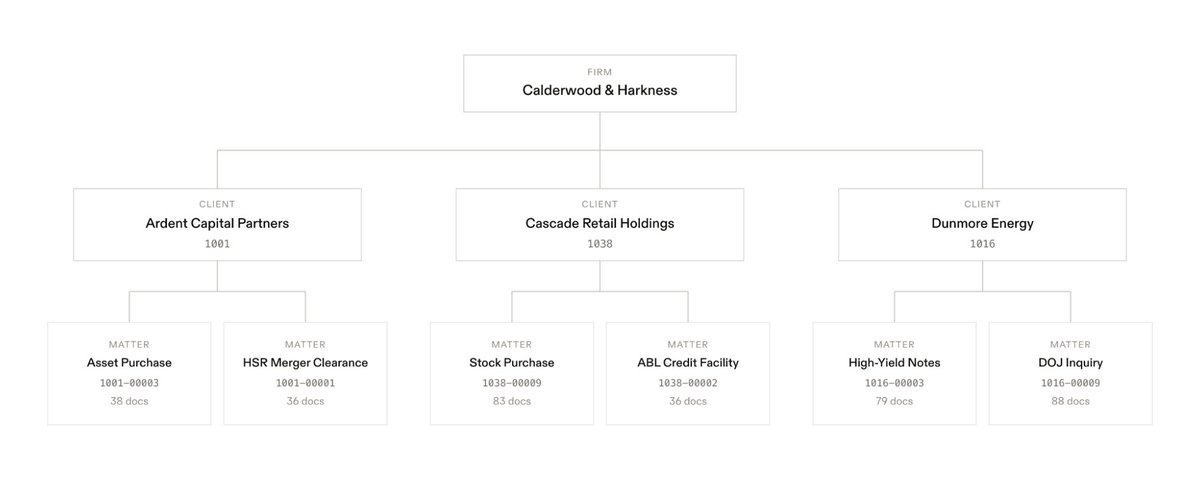
本文介绍了开源的模拟律所环境Calderwood & Harkness (C&H),旨在测试大语言模型在企业级海量知识(超1亿Token)中的检索与推理能力。C&H包含46个客户和266个案件。基准测试表明,当前先进模型在全面搜索和判断信息检索的“完整性”上存在严重瓶颈,导致任务完成度受限。作者指出,未来的改进方向是让智能体预先构建更丰富的语料库表示(如索引、摘要、记忆),以分摊运行成本并提升企业级知识处理能力。

技术 › Agent Julio Pereyra 2026-08-088.8 KB 298.1K 234 86