MiniMax H3: 打破任务与模态界限的开源多模态生成模型
MiniMax 发布通用多模态生成模型 H3,支持文本、图像、视频和音频的统一理解与生成。H3 可生成原生立体声的 2K 分辨率视频,具备优异的指令遵循和精准编辑能力,并计划近期开源模型权重,旨在打破任务边界,降低成本,加速商业化内容创作。
MiniMax 发布通用多模态生成模型 H3,支持文本、图像、视频和音频的统一理解与生成。H3 可生成原生立体声的 2K 分辨率视频,具备优异的指令遵循和精准编辑能力,并计划近期开源模型权重,旨在打破任务边界,降低成本,加速商业化内容创作。
文章分析了中国风险投资生态的独特性,指出尽管中国在开源AI、生物技术和机器人领域具有优势,但其资本市场对创始人更为严苛。文章解释了为何中国初创公司倾向于IPO而非被收购,并详细介绍了人民币基金、美元基金和外资基金这三种资本池的特点与差异。
本文专访了正行创新创始人姚颂,回顾了他从清华本科毕业创立深鉴科技,到3亿美元卖掉公司,再到投身商业航天和物理 AI 的十年创业历程。姚颂分享了对技术创业、战略取舍、人生状态以及硬科技发展的深刻思考。
文章提炼了DeepSeek创始人梁文锋关于AI未来的演讲精华,强调“克制”的重要性。梁文锋指出,想拿得多的人会被想拿得少的人打败。他为AI发展制定了清晰的路径,并建议普通人不要盲目追逐风口,而应注重提升“把话说清楚”和“长期沉淀”的能力,通过行业深耕和AI应用找到属于自己的机会。
文章介绍了Applied Intuition公司如何通过提供仿真、数据和操作系统工具,从自动驾驶领域的非主流选择发展为物理AI应用平台,并成功拓展到国防、建筑等多个行业。
本文讲述了作者深入 AI 独角兽 Moonshot AI(Kimi 母公司)内部进行 100 小时的观察记录。文章回顾了公司从早期的营销挣扎到面对竞争对手 DeepSeek 突围时的战略调整,展现了这家年轻、高估值且充满内向天才员工的神秘企业文化。
文章介绍了科技领域最热门的角色 Forward Deployed Engineer (FDE),其年薪可达15万至100万美元。FDE 负责在企业内部部署 AI,连接业务流程与模型。文章提供了30天行动计划,涵盖流程理解、判断、构建部署及人际应对,强调实战经验的重要性。
文章探讨了在写作中使用 AI 的态度。作者指出,完全不用 AI 可能是逃避将模糊直觉转化为清晰判断的思考过程。真正的关键不在于工具本身,而在于作者是否能承担选择和责任,确保作品反映真实的思考。
本文探讨了复杂性与涌现的数学本质,强调不连续性在系统跃迁中的关键作用。作者提出“堆叠流形”概念,解释神经网络如何通过无属性激活和满秩变换处理高阶非线性,指出涌现是数学上可预期的结果。
文章深度对比了WorkBuddy和Codex的产品基因,指出Codex源于代码仓库,擅长可验证的软件工程;WorkBuddy源于腾讯生态,擅长抵达中文办公场景。两者在通用工作Agent领域扩张,真正的战争在于谁能成为默认的工作环境。
文章解析了关于通用人工智能(AGI)的前沿框架,将其比作电与火的“文明级重启”。文章探讨了AGI带来的风险与机遇,提出了建立类似FINRA的标准机构来监管前沿模型的方案,强调了在技术竞速中保持审慎和国际合作的重要性。
Demis Hassabis 探讨了通用人工智能(AGI)的临近及其对人类社会的深远影响。文章提出建立一个由公私合营的前沿 AI 标准机构,负责评估模型能力、制定安全标准,并建议在保持创新的同时,通过国际合作应对潜在风险,确保技术造福全人类。
文章盘点了今年上半年加入Anthropic的9位行业巨佬,包括Andrej Karpathy、诺贝尔奖得主John Jumper等。他们放弃了顶尖职位押注Anthropic,展示了AI成为各学科公共地基的趋势,被视为人类黄金时代的前夜。
文章深入浅出地讲解了信息论的起源、核心概念及其与人工智能的关系。内容涵盖香农在1948年奠定的信息论基础(如熵、比特、信道容量定理),回顾了奈奎斯特、哈特利及玻尔兹曼等前人的贡献,并探讨了交叉熵、KL散度等概念如何成为衡量AI模型误差的关键工具。文章指出,尽管信息论为AI提供了度量语言,但在解释智能本质上仍有局限。
本文是一篇WorkBuddy Agent产品的深度实战教程。作者详细介绍了WorkBuddy的核心功能区(助理、项目、专家、自动化),讲解了任务场景选择、三种工作模式、模型匹配策略及Skill的使用方法。文章还通过真实案例演示了如何利用WorkBuddy进行深度调研,并强调了固定工作目录和权限管理的重要性,旨在帮助用户降低Agent上手门槛,提高工作效率。
本文是《人工智能的工程全景》系列的下篇,深入探讨了2025-2026年AI行业的竞争焦点——Agent工程层。文章从Agent定义的演变出发,区分了Workflow与Agent的本质差异,解析了ReAct架构与关键能力清单。重点介绍了Function Calling的工业化起点、MCP协议带来的工具调用标准化,以及Context Engineering与Harness Engineering在Agent系统构建中的核心地位。
文章详细介绍了微信“小微”的内测体验,涵盖了其功能架构、底层模型、交互逻辑及与微信原生能力的打通情况。作者指出,虽然受限于算力成本和安全风控,目前的Agent策略偏向“只读不动”且需频繁确认,但在小程序调度、聊天记录上下文理解及AI生成工具方面表现出色。作者认为这是微信有史以来最大的更新,标志着平台级AI应用的正式落地。
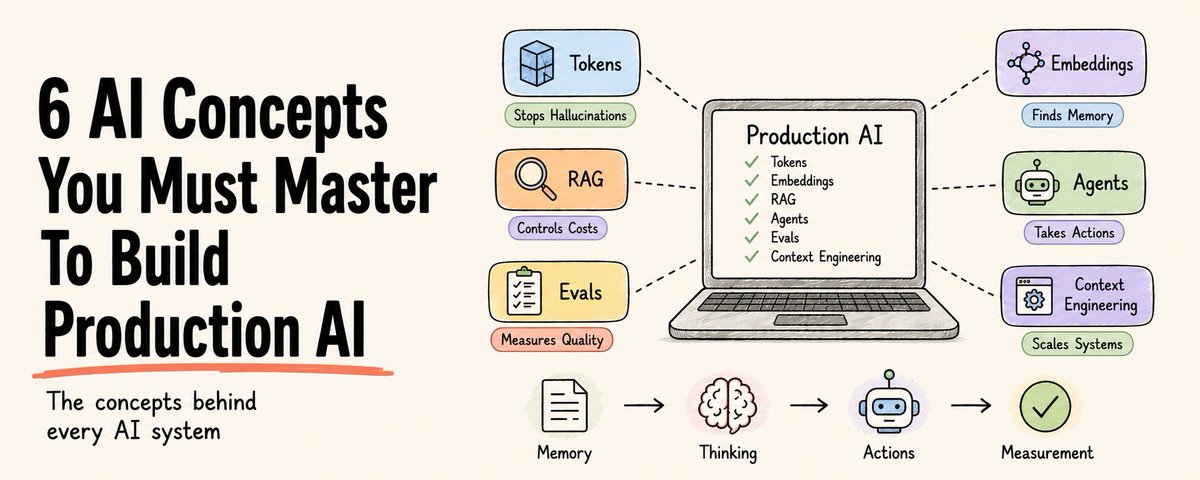
本文由作者因遭遇 AI 智能体失控产生高昂费用的经历引出,旨在阐述构建生产级 AI 系统必须掌握的核心概念。文章提出了 AI 系统的通用公式:记忆(RAG)+ 思考(LLM + Tokens)+ 行动(Agents)+ 测量(Evals)。文中重点解析了 Tokens 与上下文窗口的成本与限制、嵌入向量与语义搜索的原理、RAG 检索增强生成的正确姿势、智能体循环中的工具使用与停止条件等关键技术细节,帮助开发者从“调参侠”进阶为真正的 AI 工程师。
文章深入解析了具身智能的定义、历史渊源及发展现状。作者区分了具身智能与传统机器人,指出其核心在于感知-行动闭环与物理世界的实时交互。文章回顾了从符号主义、行为主义到深度学习、Transformer时代的技术演进,分析了VLA模型如何继承大模型能力来突破泛化难题,探讨其与AI的本质关系及未来前景。
文章指出许多人学习 AI Agent 时陷入了“工具焦虑”,盲目追逐 LangChain、MCP 等框架,却忽视了 Agent 的本质是一套围绕目标运行的系统。作者强调,真正的难点在于系统设计——理解工具调用、记忆、反馈修正及工程化约束,而非仅仅跑通 Demo。文章推荐 GitHub 项目 agent_learning,主张从 LLM 基础、Prompt 等底层原理开始,逐步构建从基础到工程化的完整知识体系,最终实现 Agent 在真实环境中的稳定运行。
本文介绍了 Cursor 如何构建一个包含数千个 Agent 的递归系统,以加速 Composer 模型的训练。系统通过主 Agent 管理子 Agent 的“健康”状态,实现并行实验的自动化监控与故障修复。该架构将研究员的效能提升了数量级,使大量计算资源能像企业组织一样协同工作。
文章以武汉某公司利用AI将视频生产成本从500元降至5元、实现单条视频最高300万曝光的真实案例为切入点,剖析了“AI负责执行,人负责判断”的短视频工作流。详细介绍了AI在脚本生成、辅助剪辑、私域引流及客户维护四个环节的应用,并指出选题判断和数据复盘是核心。最后为普通人提供了三条变现路径:做垂类账号、帮实体老板搭建系统或寻找行业合伙人。
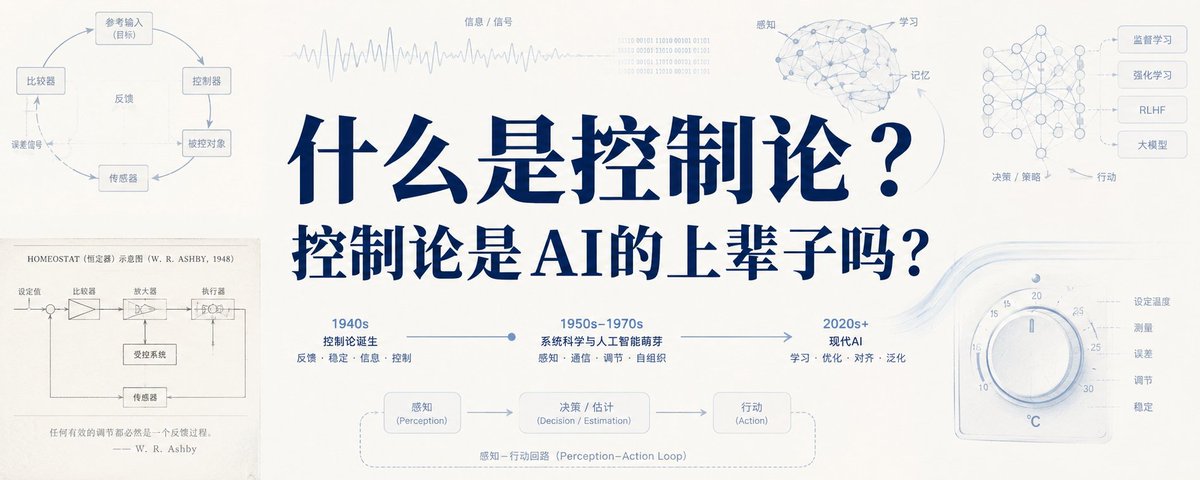
文章深入探讨了控制论的起源、发展及其与人工智能的深厚渊源。作者指出,AI中的梯度下降和强化学习本质上是控制论中“负反馈”与“修正差距”思想的延续。从Wiener在二战期间对防空火炮的研究,到Macy会议的跨学科讨论,控制论曾试图用统一数学解释机器、生物和社会。随着符号AI的兴起,控制论作为独立学科逐渐消失,但其核心思想已融入现代AI的底层逻辑之中。
本文记录了作者将 MemOS 2.0 本地插件集成到 Bloome Agent 的实战过程。通过引入「执行即学习」的记忆操作系统,解决了传统 Agent 仅依赖上下文窗口导致记忆丢失和经验无法积累的痛点。文章详细解析了 MemOS 的四层认知资产架构、云端沙箱的部署踩坑解决方案(如 ngrok 内网穿透)、历史记忆的迁移方法,以及跨 Agent 记忆共享的配置,展示了 AI 助手如何从被动工具进化为具备主动记忆能力的智能体。
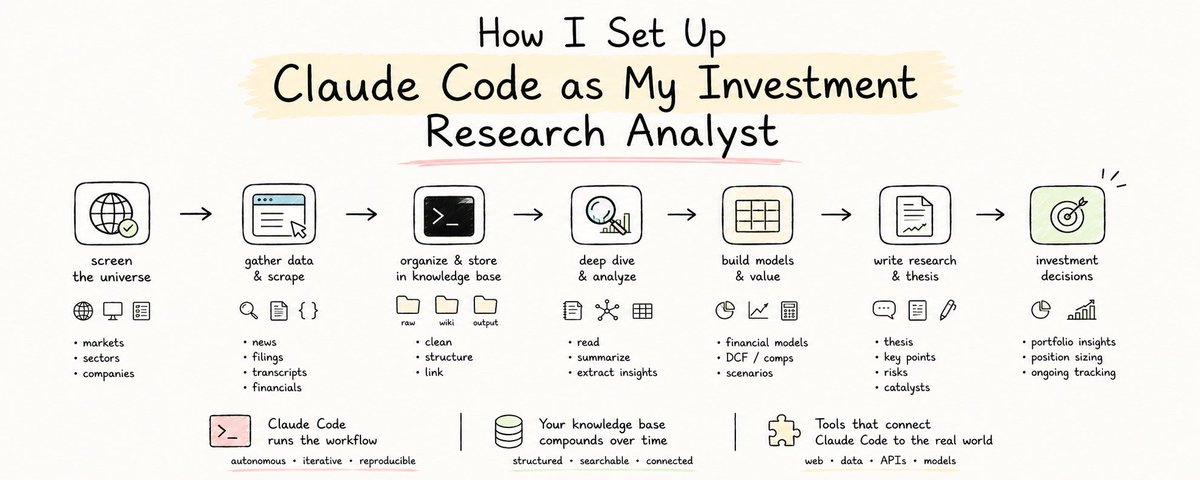
文章讲述了作者如何利用 Claude Code 这一编程工具,成功转型为个人的投资研究分析师。通过将其与 Obsidian 知识库及浏览器自动化工具集成,作者构建了一个能够自动筛选数据、抓取信息、建模并撰写报告的工作流。文章指出,与普通的聊天机器人不同,Claude Code 能够独立执行复杂的任务链条,极大地提高了金融研究的效率。
本文回顾了1970年代之后现代数学的发展历程。随着物理学进展放缓,数学失去了最大的外部“客户”,导致代数几何、朗兰兹纲领等结构化数学分支陷入内循环和高塔化。与此同时,计算机科学与AI的崛起为数理逻辑和形式化证明带来了新的机遇。文章探讨了在基础物理停滞和计算机加速的背景下,纯数学界面临的“象牙塔”困境及AI是否会成为新的推动力。
文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。
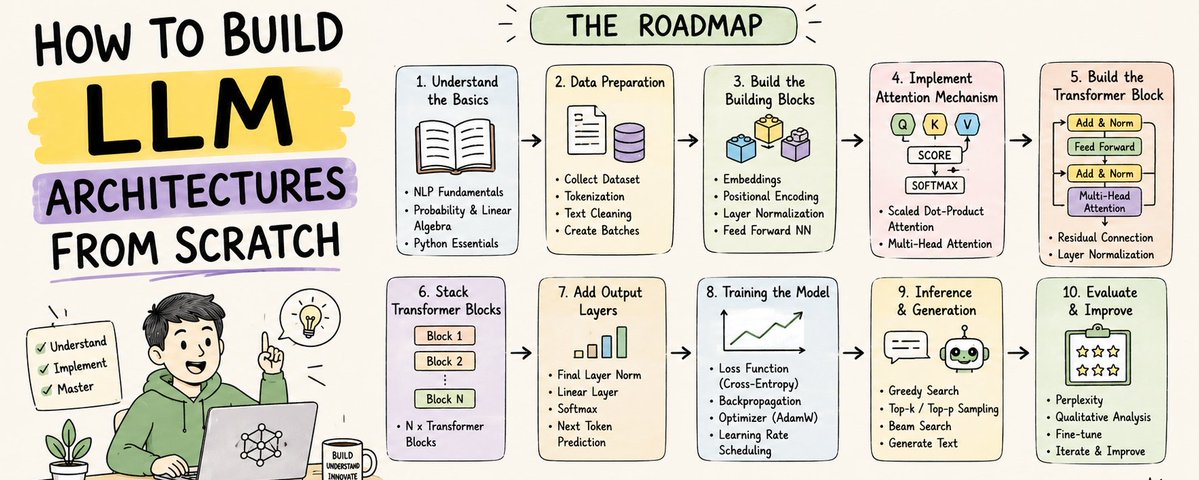
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
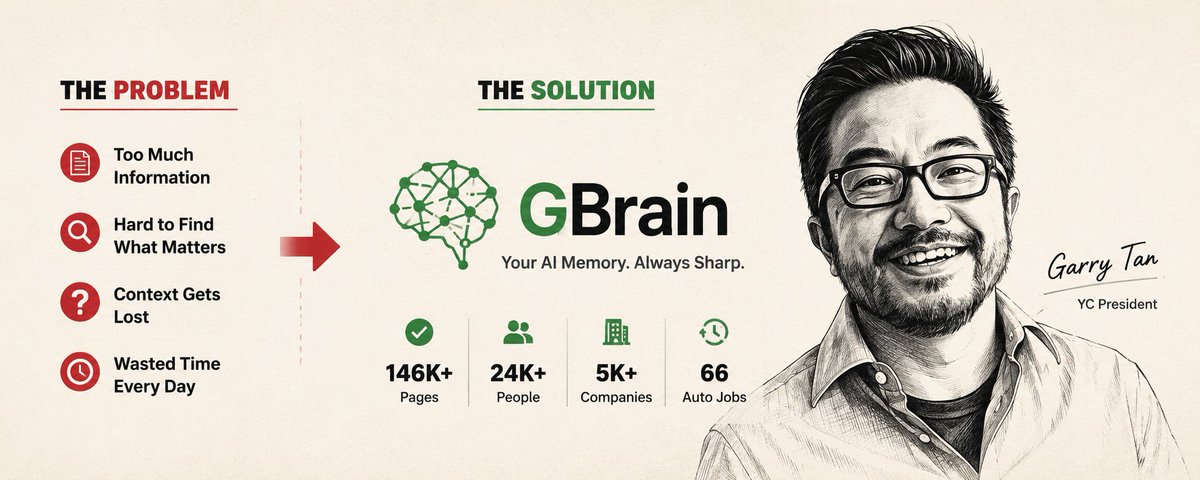
本文深入探讨了当前 AI 行业被忽视的“痛点”:AI 缺乏长期记忆。作者认为,比单纯追求更聪明的大模型或自主 Agent 更重要的是构建“持久认知层”。文章以 GBrain 为例,阐述了它如何超越传统的检索生成(RAG),通过自建知识图谱和“梦境周期”维护,实现对信息的真正理解与关系连接。这种能积累上下文、提供确定性智能的“记忆基础设施”,将成为未来 AI 的真正护城河。
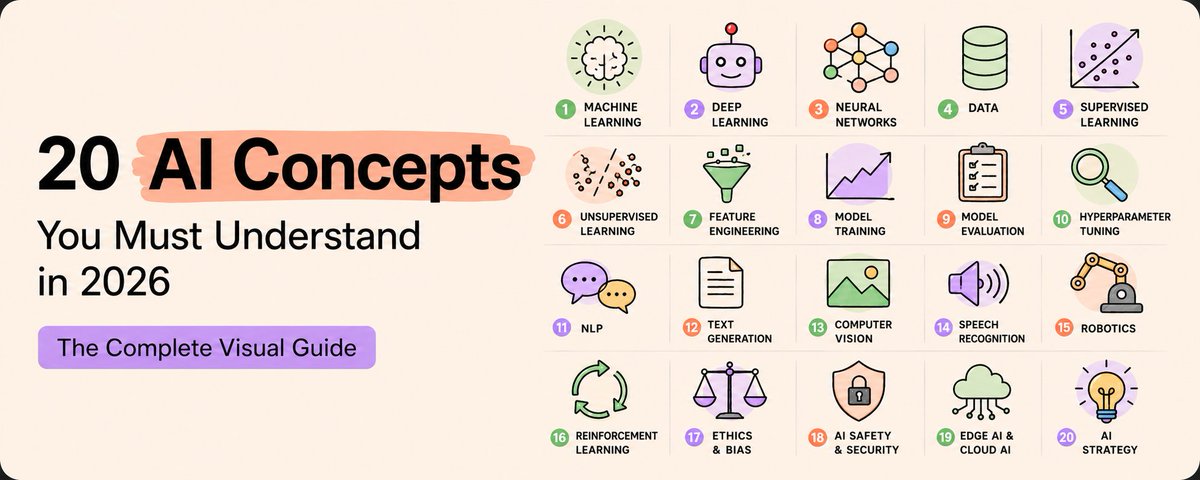
文章通俗易懂地解释了现代AI的基础原理,涵盖神经网络、Token化、Embeddings、注意力机制及Transformers架构。深入探讨了LLM的工作原理,如上下文窗口、温度控制和幻觉问题,并讲解了提示词工程技巧。