AI 开始优化 AI 自己的生产线了:Superpowers 6
本文通过 Superpowers 6 的案例,指出 AI 已突破代码生成,开始具备流程优化与管理能力。AI 审计并改进了自己的工作流,实现了降本增效。文章强调,在 AI 自动化“判断力”的时代,人类的核心价值已从操作机器转向构建诚实可靠的评估系统,即在幻觉与自我欺骗面前,坚持用 Eval 记分牌揭示真相。
本文通过 Superpowers 6 的案例,指出 AI 已突破代码生成,开始具备流程优化与管理能力。AI 审计并改进了自己的工作流,实现了降本增效。文章强调,在 AI 自动化“判断力”的时代,人类的核心价值已从操作机器转向构建诚实可靠的评估系统,即在幻觉与自我欺骗面前,坚持用 Eval 记分牌揭示真相。
文章首先展示了利用 Fable 5 生成的提示词,成功让 Grok 生成了媲美 Seedance 2.5 质感但成本更低的超写实视频,强调了提示词工程和审美的重要性。随后探讨了 SpaceX 与 Anthropic 签署的巨额算力合同,分析马斯克将算力作为核心商业版图的策略。最后引用 Dan Koe 和前 OpenAI 研究员的观点,论述在 AI 时代,理解人性、发现问题和把控细节等“不可被评分”的能力将比传统的编程技能更具长期价值。
这是一份按主题编排的AI领域人物小传(上篇),涵盖了从深度学习奠基者、大模型实验室领袖、Transformer论文作者到顶尖学术研究者的75位关键人物。文章详细介绍了每个人的背景、核心贡献及当前动态,包括Hinton、LeCun、Altman等业界巨擘。
本文是AI工程全景的中篇,深入探讨了模型训练完成后的工程化路径。首先详述了推理优化的核心手段,包括模型瘦身(量化、蒸馏、剪枝、MoE)、投机解码以及主流推理引擎(vLLM, TensorRT-LLM, SGLang)的生态格局。文章分析了成本、延迟与吞吐的“不可能三角”,并重点介绍了“测试时计算”这一范式转变,即通过在推理阶段增加计算量来动态提升模型智能。
文章详细梳理了人工智能的工程基础,回顾了从GPU游戏显卡到英伟达CUDA生态建立的历史,解析了其技术护城河。同时指出2026年硬件格局的松动,分析了谷歌TPU的回归与AWS自研芯片的崛起,展示了英伟达在推理领域面临的竞争态势。
本文作者使用回归的 Fable 5 模型对自己开发的“AI 视觉风格导演” Skill 进行了 V3 升级。文章展示了 Fable 5 在处理复杂、多文件工程任务上的独特优势:它不仅能发现 V2 版本中缺失的 frontmatter 等基础 Bug,还主动补齐了双引擎编译、视频模型路由和风格资产沉淀等三层关键逻辑。作者认为,Fable 5 在生产链路判断和工程品味上超越了传统模型,适合用于解决高复杂度的“硬骨头”任务。
文章批判了当前大学 AI 教育重理论轻实践、先筑高数门槛的弊端,认为这应像学骑车一样先上手。介绍了机器学习大神推出的免费课程 fast.ai,采用“自顶向下”教学法,首节课即通过实战让模型上线,强调产品交付能力优于学术头衔,旨在打破学术精英主义,普及实用技能。
本文实测了美团发布的基于 5 万张国产算力芯片训练的万亿参数大模型 LongCat-2.0。文章指出,该模型在预训练到大规模部署的全流程中实现了国产算力闭环,具有里程碑意义。虽然通用推理能力与顶级闭源模型仍有差距,但在 Terminal-Bench 和 SWE-bench Pro 等 Agent 与编程任务中表现强劲。作者实测了将其接入 Claude Code 和 Codex 进行工作流处理,结果显示其在长上下文处理和任务拆解上表现稳定,为开发者提供了一个可行的非国产替代方案。
本文对美团发布的 LongCat-2.0 万亿参数大模型进行了深度技术拆解。文章涵盖了 MoE 架构与稀疏注意力(LSA)的优化、N-gram Embedding 的应用,以及在国产算力受限情况下的 6D 并行训练工程、超节点组网、推理加速等关键技术细节。
文章介绍了美团开源的数字人项目 InfiniteTalk,指出其功能强大且被严重低估。该项目实现了图片与音频的精准同步(包括口型、头部和身体动作),支持照片生成视频和视频配音替换。底座采用 Wan 视频模型,技术细节包含关键帧刷新策略以保持画面稳定。项目硬件门槛较高(24G 显存),但商用协议友好,安装便捷。
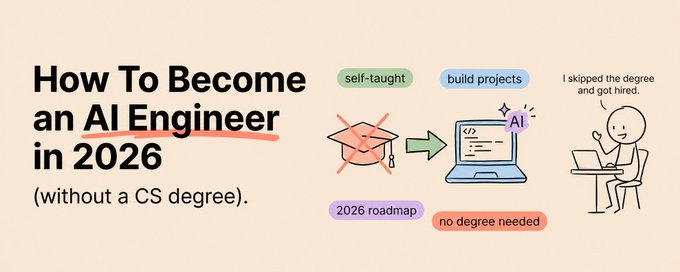
文章指出,成为AI工程师无需计算机学位,作品集比文凭更重要。AI工程师是连接大模型与现实产品的构建者。文章提供了为期9个月的四阶段自学路径:掌握Python编程、精通LLM API(含工具调用)、构建RAG系统以及开发Agent。强调实战部署和解决实际问题的能力,而非深奥的数学研究。
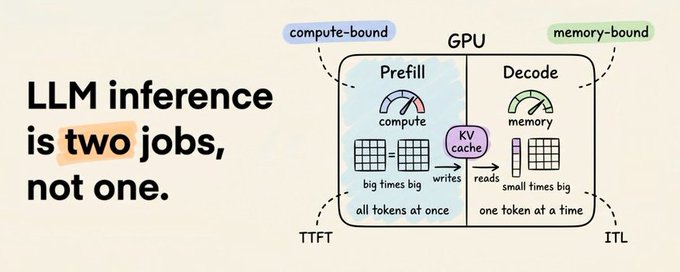
本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。
文章基于 Anthropic 工程负责人访谈,探讨了当编码能力不再稀缺时,公司内部发生的结构性剧变。核心观点是“瓶颈只会搬家”,从“产出”转移到了“验证”与“判断”。文中剖析了路线图失效、中间层消亡、努力崇拜崩塌及工程师孤独感等现象,指出在生成成本归零的时代,人的注意力、判断力和认知协作将成为唯一的稀缺资源。
作者展示了一组利用豆包AI生成的极度逼真的视频片段,模拟了2000年代末手持DV拍摄的粗糙质感。文章提供了详细的Prompt,展示了如何通过指令控制面部特征、光影及镜头语言。作者还评论了AI演技对真人演员的潜在冲击,指出短剧行业正逐渐向AI制作转型。
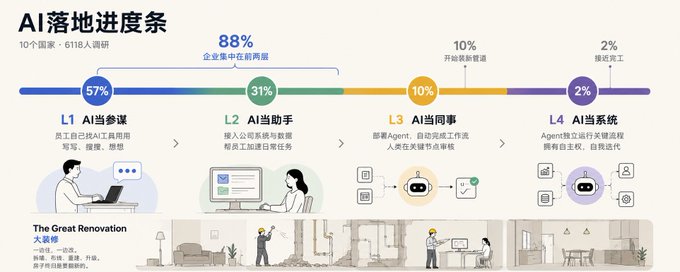
文章基于Notion对10个国家6118人的调查,将企业AI落地分为四个级别:L1(参谋)、L2(助手)、L3(同事)、L4(系统)。88%的企业处于前两层,主要利用AI提升个人效率;L3和L4则侧重于自动化与组织变革。L2到L3是转型最难的鸿沟,涉及技能重构和组织调整。AI转型被比喻为“大装修”,企业在业务不停摆的情况下进行硬装改造。
本文提供了消除AI写作痕迹的系统性指南,指出AI味的根源在于素材编造、思考伪装和风格默认。文章通过22种高频特征清单、5步自检流程及排版规范,详细讲解了如何保留真实判断与风格。同时评测了中英文去AI味工具,强调“声音校准”和“反代入式表达”是关键。
文章介绍了 Jason Hamilton 在 YouTube 上火爆的 AI 写作系统视频。该系统通过四个步骤将“用 AI 写书”转化为可复制的流水线:一问一答收集点子、拆解档案(人物/世界观/大纲)、一键生成大纲及逐章生成正文。内容涵盖工具选择、版权红线及逐句改写演示,旨在帮助作者在几天内完成一本高质量的书籍,去除 AI 味并保留个人风格。
本文分享了利用AI制作儿童绘本实现高月收入的副业经验。作者指出,AI绘本并非传统的“工具生意”,而是“礼物经济”。通过锁定6-8岁儿童市场,采用99/149/199元的三档定价策略,并严格执行“先收50%定金”的SOP,作者实现了低退款率和高复购率(40%)。文章详细拆解了从需求沟通、故事大纲生成、Midjourney画风锁定到交付的全流程,强调了角色一致性和实体书作为社交裂变抓手的重要性。
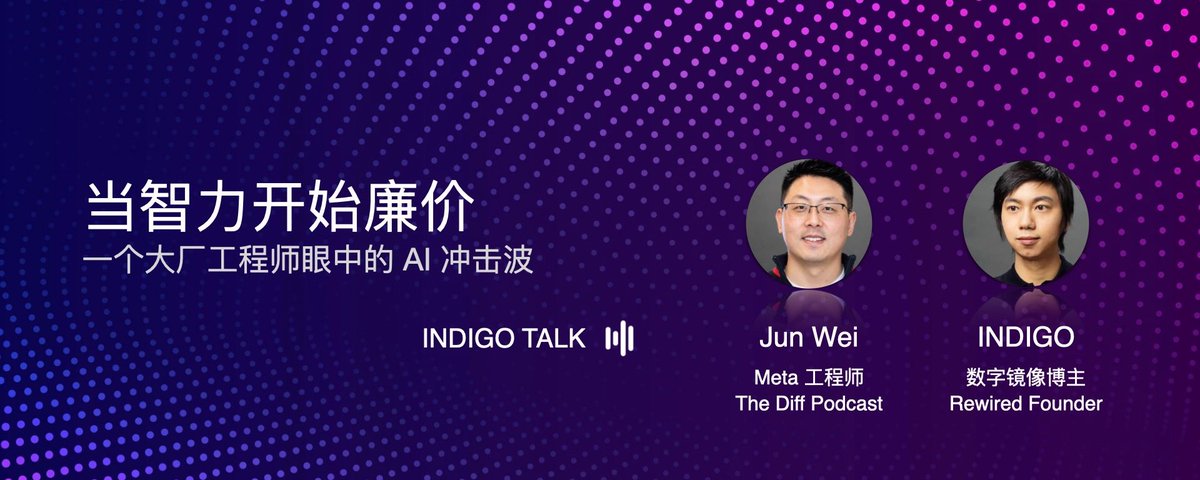
本期 Indigo Talk 邀请 Meta 工程师 Jun Wei,探讨大模型引发的智力廉价化趋势及其对白领和程序员群体的冲击。对话深入分析了为何 AI 竞赛不可停歇、程序员作为“翻译员”的历史使命是否已终结,以及普通人应如何从 Programmer 转型为 Builder。文章指出,纯软件壁垒消失后,创业的核心逻辑正转向媒体思维与表达能力。
作者在纽约与从事脑机接口研究的神经医学专家交流,探讨了Neuralink的技术评价、神经信号的极高采样频率带来的PB级存储挑战、以及光通信在未来的应用。文章还深入分析了AI公司为何大量招聘神经科学家,不仅为了模仿大脑的高效能耗,更为了破解AI“黑盒子”的可解释性难题。文末感叹当下是科技爆发的最好时代。
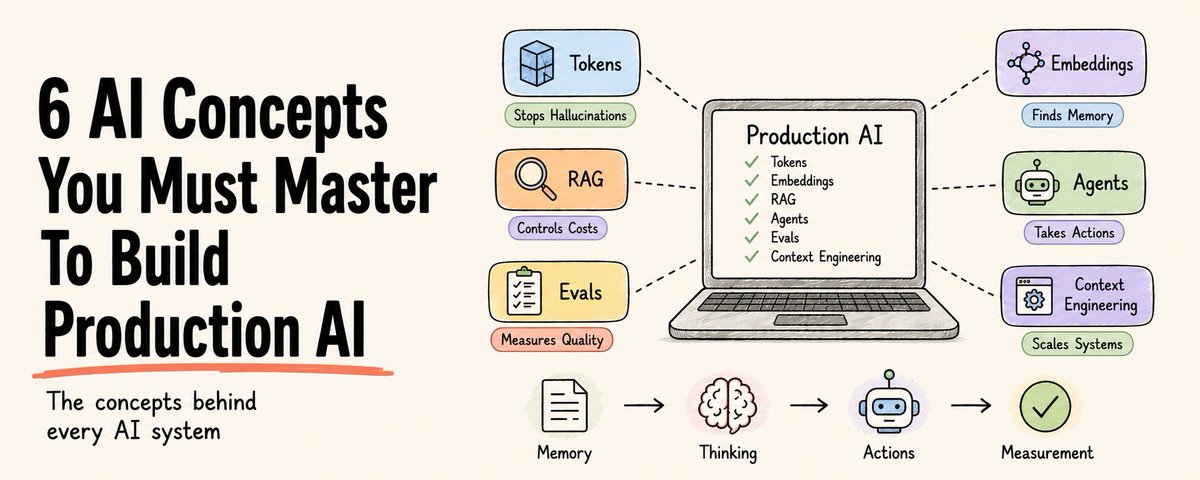
本文由作者因遭遇 AI 智能体失控产生高昂费用的经历引出,旨在阐述构建生产级 AI 系统必须掌握的核心概念。文章提出了 AI 系统的通用公式:记忆(RAG)+ 思考(LLM + Tokens)+ 行动(Agents)+ 测量(Evals)。文中重点解析了 Tokens 与上下文窗口的成本与限制、嵌入向量与语义搜索的原理、RAG 检索增强生成的正确姿势、智能体循环中的工具使用与停止条件等关键技术细节,帮助开发者从“调参侠”进阶为真正的 AI 工程师。
本文探讨了黄碧薇教授创立 Aether AI 的深层原因。她深耕因果 AI 领域 12 年,致力于解决下一代 AI 从“相关性”走向“因果性”的问题。文章指出,Physical AI 的发展瓶颈在于模型需要理解物理世界的干预机制而非仅预测像素,Aether AI 试图通过因果世界模型填补感知与控制之间的空白,实现可靠的物理推理。
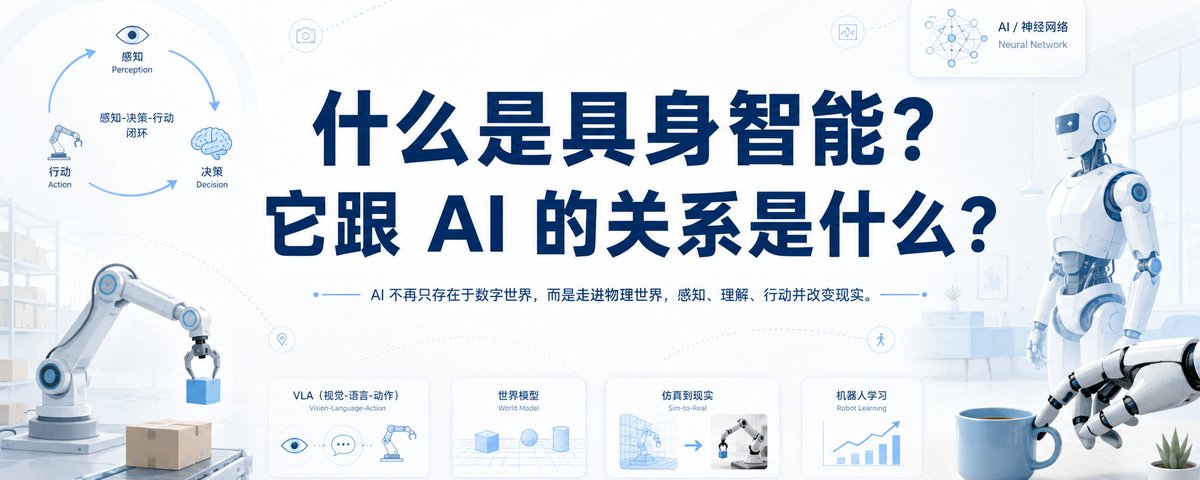
文章深入解析了具身智能的定义、历史渊源及发展现状。作者区分了具身智能与传统机器人,指出其核心在于感知-行动闭环与物理世界的实时交互。文章回顾了从符号主义、行为主义到深度学习、Transformer时代的技术演进,分析了VLA模型如何继承大模型能力来突破泛化难题,探讨其与AI的本质关系及未来前景。
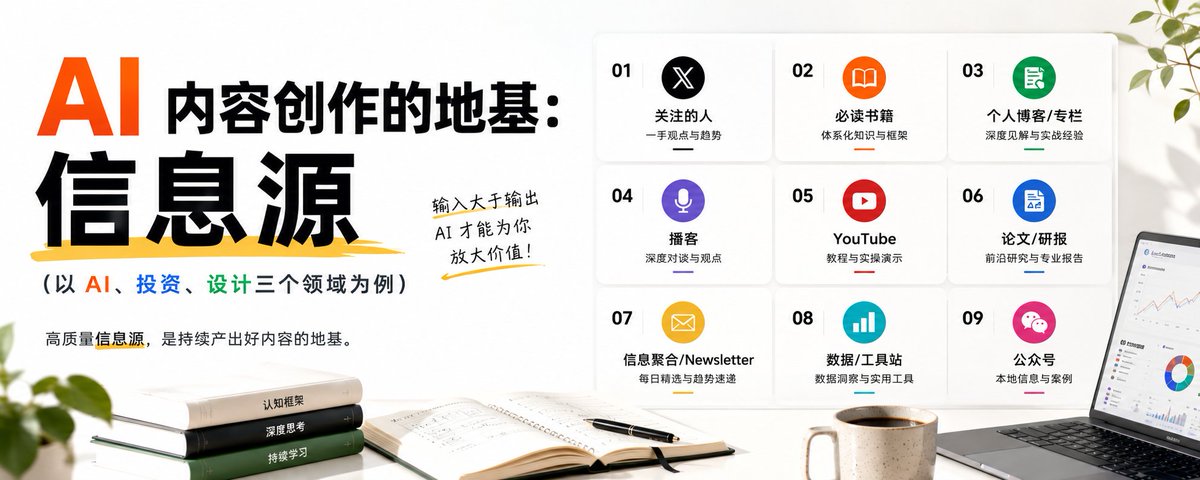
本文阐述了高质量信息源是 AI 内容创作的核心基础,指出 AI 内容质量取决于输入信源的质量。文章系统梳理了 9 类通用信息源(如 X 关注列表、必读书籍、论文库、产品平台等),并以 AI 领域为例,详细列举了值得关注的大佬、书籍、博客、播客及 YouTube 频道,为构建 AI 知识库提供了详尽的参考清单。
微软CEO萨提亚·纳德拉探讨AI驱动经济下的企业未来。文章提出“人力资本”与“代币资本”需相互增强,企业应构建独立的学习回路和自主的智能体系统,以保护并积累机构知识。纳德拉强调,AI的未来不应是由少数通用模型吞噬所有价值,而应建立广泛的生态,让每个组织都能掌控并复合自身的专有知识,从而实现稳健的经济均衡。
本文探讨了AI发展格局的不可逆转性。作者通过回顾Fable和Mythos模型的出现,指出AI竞争已进入领先模型自我迭代的加速阶段。他认为,由于硬件限制和地缘政治因素,各国建立主权AI的“窗口期”(2023-2026)已彻底关闭,未来算力将成为像核原料一样的战略资源,未能入局的国家将面临灾难性的依赖。
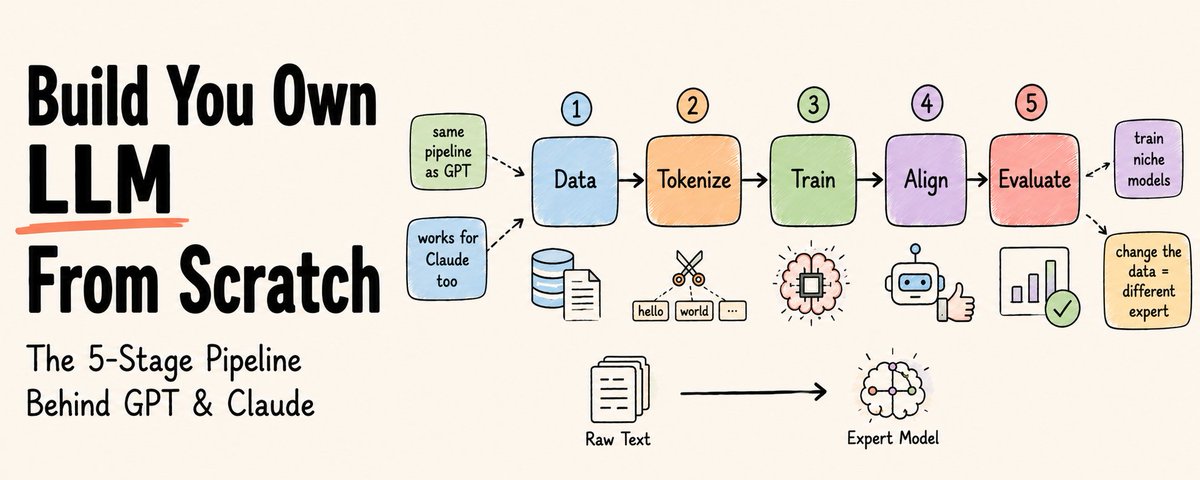
文章揭秘了 GPT、Claude 等 LLM 背后通用的五阶段构建流程,指出数据质量而非架构才是核心。作者详细阐述了数据清洗、分词、训练目标(预测下一个 Token)及 Transformer 架构实现,并提供了包含 Tokenizer 和 PyTorch 模型的代码示例。
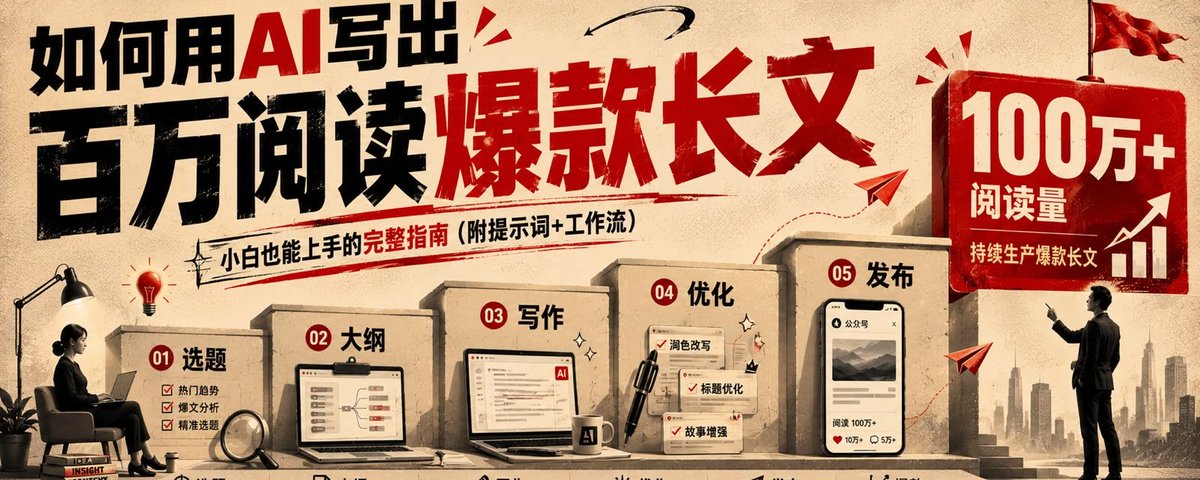
文章指出 AI 不是魔法,而是需要人驾驭的超级助手。作者从认知和实操两个层面,拆解了打造爆款文章的全流程。核心心法包括:标题决定点击率,情绪决定传播力,以及如何通过拆解对标、训练 AI 风格和五步共创法来产出高质量内容。文章强调,AI 只能放大效率,个人的独特思考和真实经历才是内容的灵魂。
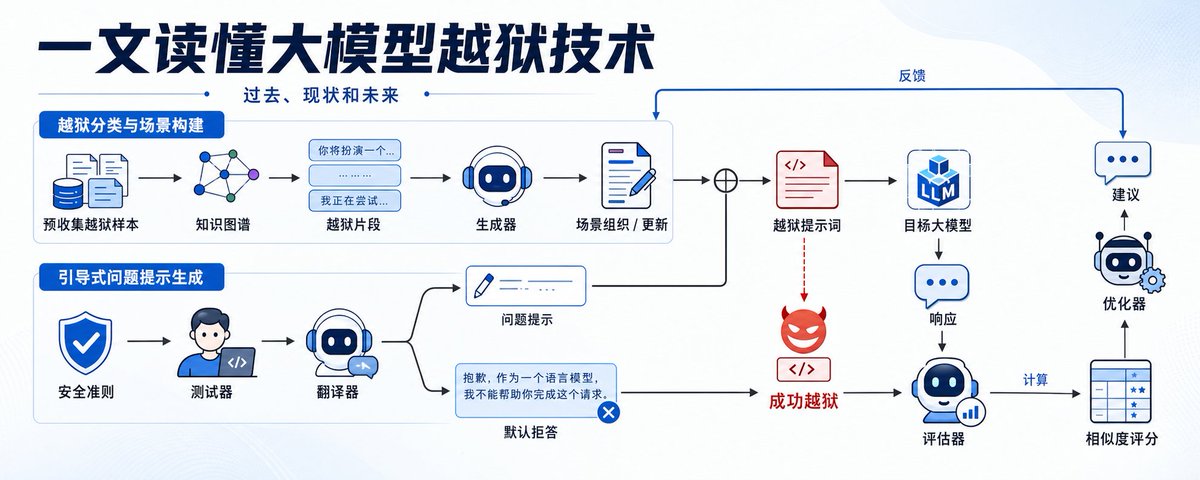
文章深入探讨了引发 Fable 模型限制的大模型越狱技术。作者通过多个案例(如 Crescendo 多轮对话、角色扮演、隐写术及间接注入等)展示了如何绕过安全限制,并针对 LLM 和 Agent 开发者提出了包括权限隔离、数据不可信处理及人工复核在内的安全防御建议。
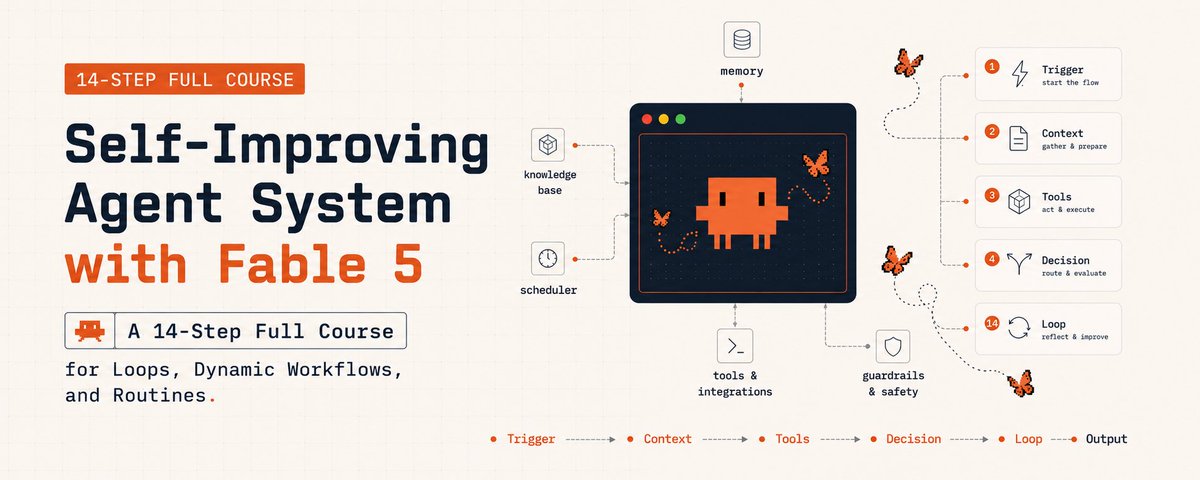
本文介绍如何利用 Claude Fable 5 模型构建具有复合能力的自我改进 Agent 系统。文章首先澄清了 Fable 5 作为 Mythos 级模型的定位,强调了其支持“长周期自主会话”和“自验证”的核心能力。作者指出,真正的自我改进并非模型权重的更新,而是通过 loops、dynamic workflows 和 routines 这三种原语,构建起包含记忆层和评估反馈层的环境架构。文章还详细阐述了如何根据任务复杂度在 Fable 5、Opus 和 Sonnet 之间进行成本最优的路由配置。