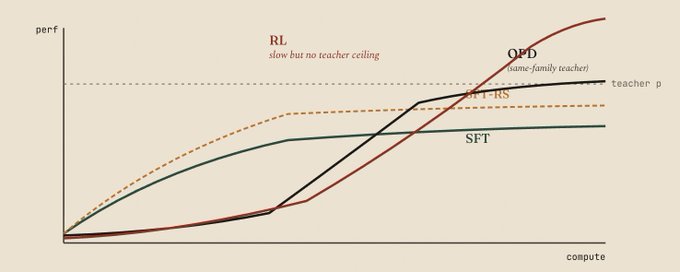
SFT、RL 与 On-Policy 蒸馏:原理与差异
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。
文章介绍了一款源自韩国、在全球火爆的抽象头像生成玩法。作者提供了原图及多组详细的提示词(Prompt),展示如何将普通图片转换为抽象线条、简笔画、撕纸拼贴、意面平铺、圆珠笔涂鸦及童趣手绘绘本等多种创意风格。文章持续更新中,旨在帮助用户玩转 AI 图像生成的各种趣味风格。
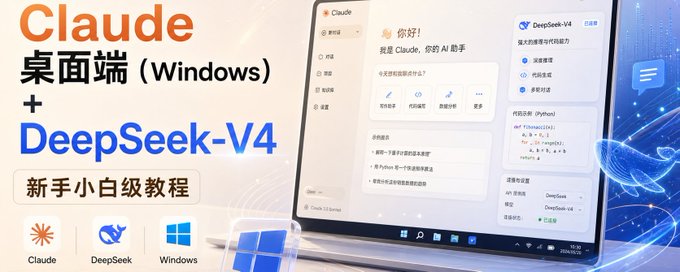
本文详细介绍如何在Windows版Claude桌面客户端中接入DeepSeek-V4-Pro等第三方模型。教程涵盖获取DeepSeek API Key、安装Claude客户端、开启开发者模式及配置网关的完整步骤,解决了因官方限制无法使用Claude Code的问题,并提供了处理虚拟机平台报错的方案。
文章旨在解决用户使用AI输出质量差的问题,提出了一套系统的提示词工程方法论。核心内容包括“六要素检查法”(角色、背景、任务、格式、约束、质量标准),使用XML标签进行结构化提示,以及链式提问、自我修正等进阶技巧。文章还强调了建立上下文文件和模板库以实现长期复利,帮助读者从新手进阶为提示词工程大师。
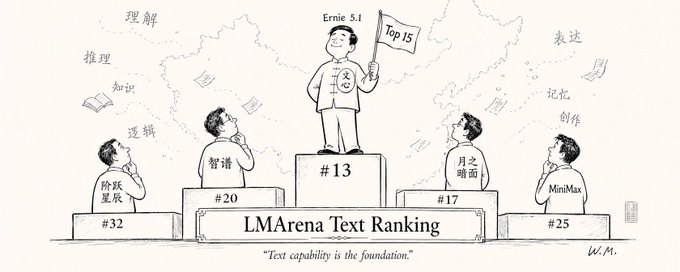
本文基于 LMArena 最新文本排行榜更新,探讨了文心 5.1 Preview 凭借 1476 分拿下国内第一、全球第 13 的成绩。作者分析了为何在 DeepSeek V4 和 GPT-5.5 主导的时代,文本能力依然是大模型代码生成与逻辑推理的“基本盘”。文章指出文心通过「多维弹性预训练」技术实现了高性价比与高性能,验证了夯实文本底座的重要性。
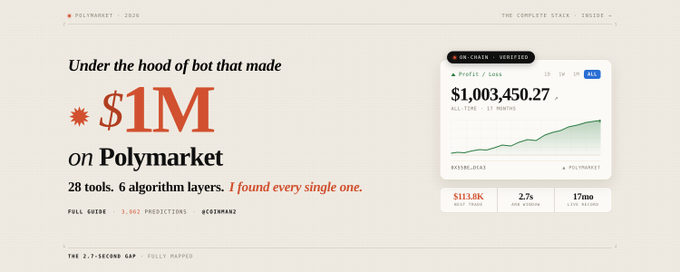
本文深度解析了一个在 Polymarket 上获利超过 100 万美元的自动交易机器人“Coinman2”的技术栈。文章详细介绍了利用 Claude (Anthropic) 等 AI 模型进行交易逻辑推理,并通过六个层级(大脑、编排、数据等)的 28 个工具构建完整系统的过程。核心策略在于捕捉 Polymarket 与 Binance 之间的价格滞后(套利机会),通过高频交易和严格的风控(如凯利公式)获利。
这是一篇关于如何利用AI在X平台(Twitter)快速涨粉的实战指南。作者分享了自己在23天内达到万粉并变现的完整方法论,涵盖了从利用AI定位个人商业模式、自动化内容生成(短推与长文)、使用Grok对标分析、利用插件蹭热点,到最终的数据分析与变现策略。文章强调“去魅”与高频输出,提供了具体的Prompt、GitHub工具包及自动化Skill,旨在帮助普通人通过AI工具实现低成本的社媒流量获取。
本文详细介绍了作者如何将原本杂乱的家庭实验室改造为具备云原生特性的私有控制平面。文章指出,核心差异在于引入了访问层、网关、路由策略、可搜索状态和计算通道,而非仅仅依赖本地硬件。作者利用 Proxmox 作为底层基础架构,通过 WireGuard 实现安全的 VPN 入口,结合 SNAT、私有 DNS/DHCP 等技术,构建了一个包含自动化平面、状态存储和计算织带的综合系统,实现了对数十个 LXC 容器和 VM 的统一、高效管理。
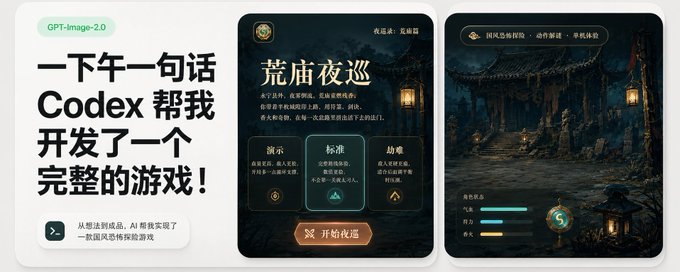
作者利用 Codex 在一下午时间内,仅通过自然语言交互,完成了一款名为《夜巡录:荒庙篇》的志怪题材 Roguelike 卡牌游戏。文章详细记录了 AI 如何自动生成绿幕素材、编写爬虫获取资源、通过图片拼贴解决视觉检索瓶颈,以及整合 GPT-Image 和 Seedance 2.0 完成音视频素材的全过程。作者认为这种从“配工具”到“定目标”的交互模式转变,已接近 AGI 雏形。
文章旨在打破 GitHub 仅限程序员使用的误区,指导普通用户如何利用这一平台获取免费工具、学习资源和实用项目。内容涵盖了界面汉化、通过热榜或关键词查找资源、以及具体的软件安装与使用实战案例,帮助非技术人群跨越信息差,利用 GitHub 提升效率。
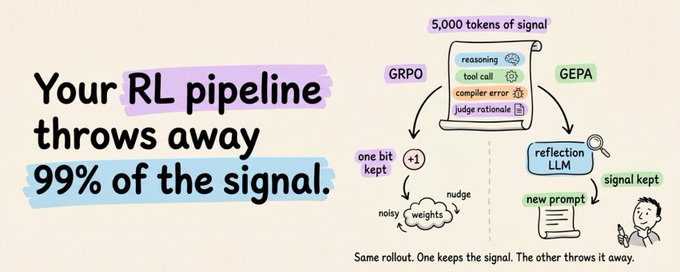
文章介绍了 Berkeley 团队提出的 GEPA 算法,该算法作为 GRPO 的替代方案,无需更新模型权重或进行 GPU 训练,仅通过优化提示词(Prompt)即可在 HotpotQA 等基准测试中取得更优成绩。GEPA 的核心在于利用 LLM 读取完整的推理轨迹,通过自然语言反思来迭代优化多模块系统中的每个提示词,从而避免了强化学习中将丰富信息压缩为单一标量信号的信息损耗问题。
文章分享了作者过去6个月在商业策略、内容创作、自动化和研究中测试出的35个高价值Claude提示词。这些提示词旨在将Claude从单纯的搜索引擎转变为强大的思维工具,涵盖商业模式验证、竞品分析、决策框架、营销文案生成等多个实战场景,旨在通过AI提升企业ROI和个人效率。
本文介绍了一个无需额外付费、仅用一个下午构建的个人 AI 智能体。通过 Claude Desktop 结合 MCP 协议,利用 Filesystem、Playwright 和 Telegram 三个工具,实现了自动读取任务、浏览网页资讯并发送早报到手机的功能,展示了 AI Agent 从“回答问题”到“执行任务”的跨越。
文章详细介绍了如何利用开源框架 Hermes 和 Polymarket 市场的低效性,构建一个能自我进化的 BTC 上涨/下跌交易代理。内容涵盖了 Polymarket 的盈利模式、Hermes Agent 的核心优势(知识层、执行层、输出层)、以及如何使用 Atomic 工具一键部署 Hermes 环境。此外,文章还列举了多个成功的交易机器人案例,并提供了 GitHub 上现成的交易逻辑库供参考。
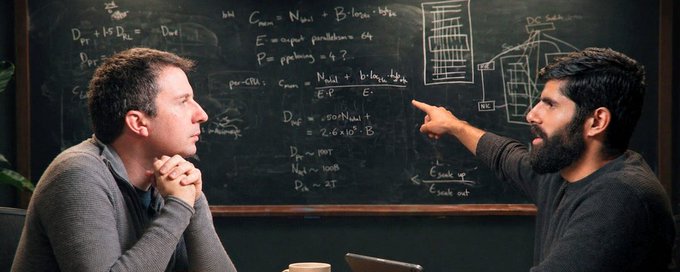
本文基于 Reiner Pope 的播客内容,深入剖析了大模型在集群中的运行机制。文章通过 Roofline 分析和 KV Cache 等核心概念,解释了推理延迟、Batch Size、API 定价策略及 MoE 架构背后的物理与经济逻辑,揭示了硬件限制如何塑造 AI 进展。
文章介绍了一种利用 AI 工具(CODEX)实现 VPS 服务器全自动部署的方法。用户仅需购买 VPS 并获取 IP 和密码,通过一段预设的详细提示词,即可让 AI 自动完成环境配置、看板安装(Cockpit、Netdata)以及 Marzban 代理面板的搭建。该方法降低了技术门槛,适合跨境电商和个人出海业务,10分钟即可完成从连接到配置的全过程。
本文介绍了Hermes Agents被用户忽视的14个高级功能,包括持久化角色设置(SOUL.md)、长期记忆、数据洞察、会话快照与回滚、动态分支、实时语音、Webhook集成及100多项预构建技能。文章指出,大多数用户仅将其作为普通聊天机器人,仅发挥了8%的潜力,通过掌握这些工具,用户可以实现事件驱动的自动化、多模型路由及复杂的开发工作流。
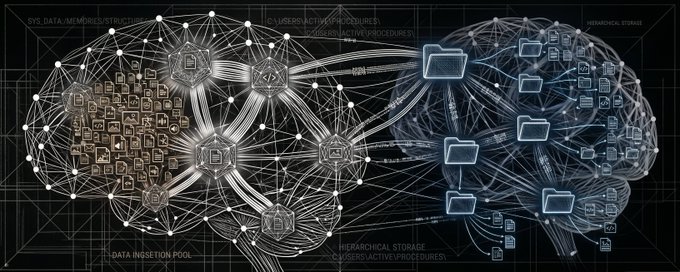
文章探讨了 AI 中“知识库”与“记忆”的本质区别,指出仅靠语义相似性检索会导致遗忘和误报。作者介绍了 SMF 架构,利用 POSIX 符号链接构建原生文件系统知识图谱。相比传统数据库或 Markdown 链接,SMF 提供了访问控制、可编程遍历及云端扩展性。实验表明,良好的结构化架构(BM25+图遍历)在效率上优于单纯扩大模型规模。
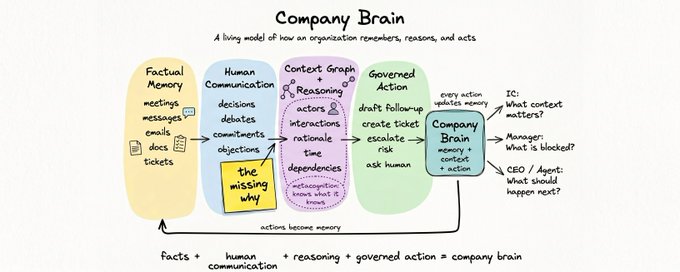
文章探讨了组织内部的摩擦与记忆缺失问题,指出企业虽积累海量数据碎片,却缺乏将其转化为记忆并进行推理的能力。作者定义了“公司大脑”的三层结构:事实记忆层(记录发生的事件)、上下文图谱层(连接事实并进行推理)以及行动协调层(基于上下文辅助决策)。文章强调,AI Agent 的失败往往不是因为缺乏数据,而是因为企业丢失了数据背后的推理逻辑和决策背景。
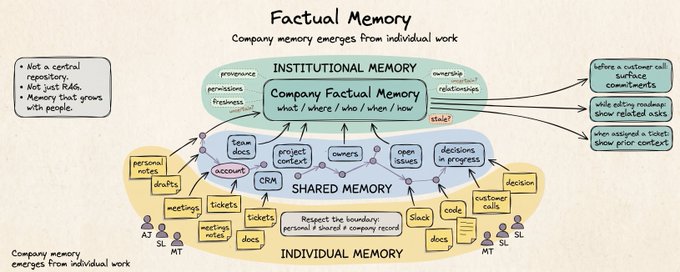
文章探讨了构建“公司大脑”中的事实记忆层。作者指出,真正的企业记忆不是简单的知识库或带有聊天框的企业搜索,而是一种从个人工作向外涌现的语义文件系统。它必须具备追溯性、权限管理和个性化能力,能够综合多源数据(如文档、CRM、代码)并主动提供上下文,而非仅被动等待查询。
文章介绍了一种名为 Agentic Harness Engineering (AHE) 的新框架,该框架能在不改变基础模型和系统提示词的情况下,自动演进编码代理的工具、中间件和内存。AHE 在 Terminal-Bench 2 上通过 32 小时的迭代将性能提升至 77.0%,击败了包括 Codex-CLI 在内的人工调优方法及仅优化提示词的基线。研究还发现,优化内存、工具和中间件比优化系统提示词更能带来显著性能提升。
文章推荐了 27 本构建 Agent 时代认知地基的书籍,涵盖底层范式、认知科学、决策理论、多智能体协作、组织管理及哲学对齐六大板块。作者强调 Agent 时代的盲区在于认知层,建议按需阅读,认为读完这些书能看穿当前 90% 的 Agent 创业本质是在重复旧思想。
文章介绍了 GitHub 上一个名为 oh-story-claudecode 的开源项目。作者 worldwonderer 在失业期间开发了一套基于 Claude Code 的网文写作工具,包含扫榜、拆文、写作及去 AI 味等 8 个 Skill。该项目凭借解决网文作者痛点、精准的垂直定位以及真实场景打磨,8 天内获得 573 星。文章拆解了其文件系统管理、知识库设计等技术亮点,并指出其模式可复用于其他长内容创作。
鉴于 Claude Code 账号封禁风险高,本文推荐已拥有 ChatGPT 付费会员的用户尝试官方 Codex。文章详细介绍了 Codex 的适用人群、三种安装方式(CLI、桌面版、插件版),以及三种登录接入方法(官方登录、CC Switch、配置文件)。此外,还涵盖了 Node.js 环境配置、中转站设置、常见报错排查等实操细节。
本文针对不同使用场景提供了AI模型的选择指南,指出效率低下的原因常是“用错了地方”。文章将场景分为九大类,包括日常交互、空间推理、代码开发、金融分析及视觉生成等,并分别推荐了适配的最佳模型(如 GPT-5.1、Gemini 3.0、Claude Sonnet 4.5 等)。总结提出了按任务性质匹配模型的三条原则,强调在正确场景使用合适模型的重要性。
文章深入剖析了 AI 编程中 Skill 的内部结构与生命周期。作者指出 Skill 不仅是高级 Prompt,而是包含元数据、入参结构、核心提示词及执行器的标准件。文章详细解释了 Skill 从注册发现到意图匹配再到沙盒执行的全过程,并提出了判断何时封装 Skill 的三个标准,旨在帮助开发者通过工程化手段稳定 AI 输出。
文章指出在2026年,项目中最重要的设计文件不再是 Figma 库,而是位于代码仓库根目录下的 design.md。文章解释了随着 Claude Code、Cursor 等 AI 编程工具的普及,通过 Markdown 文件定义视觉规则(如 Token、布局、组件样式)已成为让 AI 生成符合品牌 UI 的最佳实践。文中提供了 design.md 的标准五段式骨架,并详细说明了如何通过颜色、排版、组件和可访问性规则来约束 AI 生成结果。
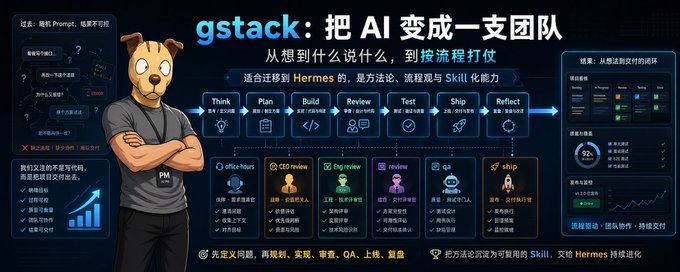
文章介绍了一款名为 gstack 的 AI 开发工具,它不同于普通的代码生成工具,而是通过定义“思考→计划→构建→审查→测试→发布→复盘”的完整链路,将 AI 转变为一个具备纪律性的开发团队。作者深入分析了 gstack 在需求澄清、方案收敛、代码审查及真实 QA 方面的优势,并探讨了将其方法论迁移到 Hermes 技能体系中的具体路径与价值。
本文介绍了如何使用 Docker 将 Hermes Agent 部署在 VPS 或 NAS(如群晖)上,从而实现 Agent 的 7×24 小时在线。文章详细讲解了环境隔离、数据映射、Compose 配置、官方 Dashboard 开启以及安全防护措施,旨在提供一份稳定、安全且易于迁移的部署教程。
本文详细介绍了如何构建一个 $7M 规模的服务即软件(Services-as-Software)业务,阐述了由五个层级组成的运营系统。第一层是数据智能,利用 Clay 等工具建立分层客户清单;第二层是外联执行,通过 Instantly 等 ESP 管理邮件投递和信誉;第三层是编排层,使用 Claude Code 作为运行时连接 API 并执行具体工作;第四层是汇报与沟通;第五层是人员与知识。文章强调了数据分层、投递信誉基础设施以及利用 Claude Code 的技能文件夹来沉淀自动化流程的重要性。