Wiki 知识库

全部文档 / 标签: 模型评测

76 篇
清除

AI 早报:Anthropic 交付架构、LangChain 设计智能体与 Ai2 新颖性裁判研究

本期早报围绕智能体系统建设展开:一是 Anthropic 负责人解释 Claude 交付架构,将会话记录、运行框架与沙箱执行环境分离,使失败恢复不影响工作连续性;二是 LangChain 分享设计智能体的实践,将设计师的审美判断沉淀为技能与知识库,中位费用从 8 美元降至 0.50 美元;三是 Ai2 研究检验 LLM 判断研究想法新颖性的可靠性,发现提示词变化可导致准确率剧烈波动。此外还涵盖 Google A2UI 推理格式、Optiver 模型接入平台、小红书 AllSpark 数据管线及 K2 Lab 垂直 AI 产品等内容。

技术 › LLM ginobefun 2026-10-2828.5 KB 641 5 84

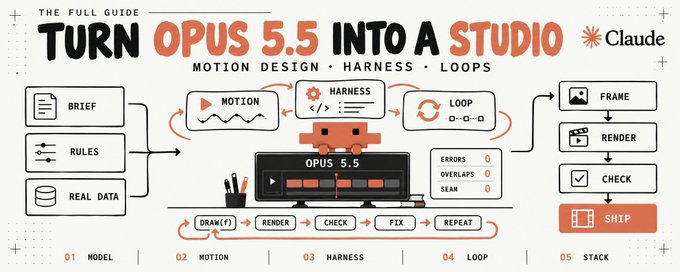
如何把 Opus 5.5 变成工作室:动效设计、Harness 与循环的完整指南

文章介绍了 Anthropic 发布的 Claude Opus 5.5 模型,其性能达到 Fable 5.1 水平但运行成本低 40%,尤其在长时间自主任务中表现突出。作者指出动效设计、Harness 工程和循环工程三者实为一个完整技术栈,并以五部分结构展开讲解:模型本身的基准数据与定价、如何用它做纯代码驱动的动效/动画创作、让输出可靠化的 Harness 工程、让 Agent 持续自主工作的循环机制,以及如何用单个模型串联整个工作流。文章强调缓存读取降价 60% 使长循环成本可控,并列举了大规模代码迁移、翻译 HAProxy 等实际案例。

技术 › LLM NO1ennn 2026-10-2638.3 KB 848.7K 561 84

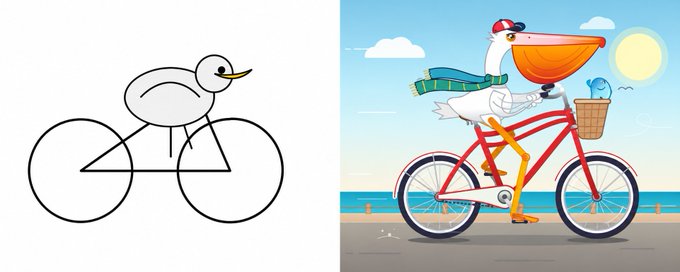
新模型发布,为啥总要画鹈鹕?

文章讲述了“生成骑自行车的鹈鹕SVG”这一AI测试题的来龙去脉。该题源自英国程序员Simon Willison,因同时考验模型的空间几何理解与代码生成能力而成为测试大模型的经典题目。随着模型进步,该测试已趋于饱和,连小体量开源模型Qwen3.6都能击败Claude Opus 4.7,引发其是否沦为“应试科目”的讨论。作者分析了鹈鹕测试依然流行的原因:直观易懂、已成为开发者社区的“开机仪式”,透过这只越来越像样的鹈鹕,能直观感受AI时代的快速发展。

技术 › LLM 林亦LYi 2026-10-269.4 KB 56.4K 118 65

Kimi K3.1 Pro 做 3D 有多强?我拿 4 组案例对比了 GPT-6 Astra

作者用四组同提示词测试(鹈鹕骑单车、iPhone Duo 产品片、Roadster 腾空镜头、自制小机器人短片),对比 Kimi K3.1 Pro 与 GPT-6 Astra 在 3D 建模与动画方面的能力。Kimi K3.1 Pro 在 Artificial Analysis 榜单得分 55,全球第四、中国第一。结果显示两模型均能通过编写 Blender/Three.js 脚本生成可反复修改的 3D 场景,但细节和修改轮次各有短板。作者还用 Kimi 打造了一个 3D 视频预演台,可切换机位、焦段和灯光并导出分镜。文章最后吐槽 5 小时使用额度限制,认为这类工具适合做分镜草稿与预演,而非直接成片。

技术 › LLM 西堂AI创业笔记 2026-10-2510.8 KB 2.4K 13 71

Kimi K3.1 Pro 来了:离最强只差 0.7 分,API 反而降价三分之一,权重 11 月 4 日白送

月之暗面发布 Kimi K3.1 Pro,基于 K3 做 post-training 升级,2.8T 总参数、104B 激活(MoE)、1M 上下文、多模态。Terminal-Bench 4.0 得分 65.7,超越 GPT-6 Astra(58.2),仅落后 Claude Opus 5.5(66.4)0.7 分,是开源模型离闭源最强最接近的一次。API 价格输入 $2/输出 $10,比上一代降价三分之一,权重将于 11 月 4 日开源。文章拆解了 14 项评测表现,指出其在编码、Agent、金融分析领域表现出色,但科学计算类任务偏科严重(38.1 vs 68.1),并给出小白使用入口与避坑清单。

技术 › LLM 丰收 2026-10-247.2 KB 2.8K 2 84

Kimi K3.1 Pro来了,国产模型审美的新巅峰

月之暗面发布旗舰模型Kimi K3.1 Pro,参数规模2.8T(MoE,104B激活),支持100万Token上下文,继续开源。API价格较K3砍半,仅为GPT-6 Astra的五分之一。跑分仅次于Claude Opus 5.5和GPT-6 Astra,Terminal-Bench 4.0达65.7%,OfficeQA Pro v2获SOTA,幻觉率从23.4%降至8.3%。作者重点测试了视觉方向:3D建模能力已可与GPT-6 Astra正面竞争,包括网页3D果冻、高精度机械键盘、根据户型图与装修图生成Three.js第一视角漫游网站、结合平面图与手持视频还原办公室3D模型。视频动效方面提升巨大,可一轮直出动效作品集、宣传片及科普视频,虽距Opus 5.5仍有差距,但已属国产模型巅峰水平。

技术 › LLM 数字生命卡兹克 2026-10-2417.5 KB 20.2K 62 70

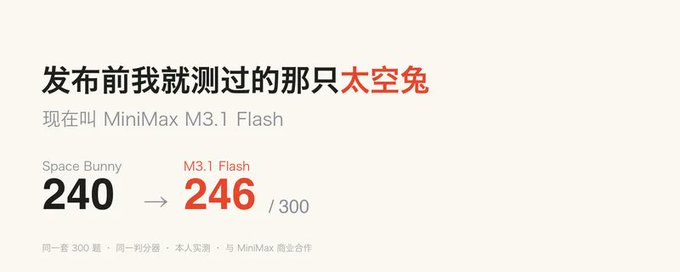
发布前我就测过的那只太空兔(Space Bunny),现在叫 MiniMax M3.1 Flash

作者在 MiniMax M3.1 Flash 还以匿名模型 Space Bunny 身份活跃时,用自己维护的 300 题封闭测试集(HumanEval+/MBPP+ 代码题与 MMLU-Pro 推理题)进行了评测,匿名期得 240 分。正式版发布后用同一套题复测得 246 分,两版表现几乎一致,主要提升在代码题。代码能力与 DeepSeek V4.1 Flash-1017 基本打平;官方数据显示其在企业流程自动化和操作电脑两项为国产第一,且成本显著低于 Claude Opus 5。短板是困难推理。整套 300 题成本仅一元出头,性价比突出。

技术 › LLM huangserva 2026-10-2410.5 KB 36K 29 81

开源5B小模型 MOSS-Image 两次画对整首《将进酒》,闭源最强 GPT Image 2.5 第二轮翻车

作者用一道难题对比测试开源 5B 图像模型 MOSS-Image 与闭源最强的 GPT Image 2.5:在一张水墨长卷中画出李白临江举杯场景,写出《将进酒》全文12行书法,配标题、作者、朱印和英文,并精确控制酒杯数量。第一轮两者都通过,但第二轮仅改两处细节后,GPT Image 2.5 数错酒杯,MOSS-Image 两轮全部正确。文章分析了小模型在中英文渲染、长提示词理解(支持4K tokens)和风格控制上的优势,并分享了结构化布局、负面约束等复杂提示词技巧,附完整提示词。MOSS-Image 已开源权重和代码,支持 LoRA 微调,ComfyUI 下载量突破70万。

技术 › LLM 前端哥Liam 2026-10-219.0 KB 125.5K 116 72

DeepSeek V4.1 Flash 1017 实测:性能更强、费用更低的一次升级

DeepSeek 于 10 月 17 日发布 V4.1-Flash-1017 版本,AI 编程跑分显著提升,DeepSWE 达 77.0 超越 Claude Opus 5,任务平均费用降至原来的三分之一。作者使用 DeepSeek Harness 实测四个项目:3D 城市生成器对比显示新版的重庆、西安等地标建筑辨识度大幅提升,耗时从 102 分钟降至 61 分钟;许愿式编程能快速产出 3D 地铁跑酷游戏和天坛祈年殿建模;基于新开放的 Search/Fetch 接口开发的 AI 搜索引擎完成度很高。总花费仅 12.81 元,性价比突出,是一次实打实的帕累托改进。

技术 › LLM 程序员鱼皮 2026-10-1915.6 KB 8.2K 9 84

给科学家用的 Claude Code:本地跑、可追溯、能换引擎的 Open-Science 实测

文章实测了新加坡 AIPOCH 团队开源的科研 AI 工作台 Open-Science,它以 Claude Code、Codex 等为可替换引擎,外覆科研专用壳层。针对科研三大痛点——文献易被 AI 编造、敏感数据不能出本地、图表无法溯源——该项目提供 36 个科学数据库连接器、本地数据存储、不可篡改的执行记录与血缘图,并支持通过 .science 文件包(基于 RO-Crate 开放标准)导出完整研究过程供他人复现。作者以复现一篇基因表达分析论文为例,验证了差异表达分析与火山图生成,并用独立 AI 审查员完成交叉核验,展示了可复现、可交接的开源科研工作流。

技术 › Agent huangserva 2026-10-1926.3 KB 13.4K 49 85

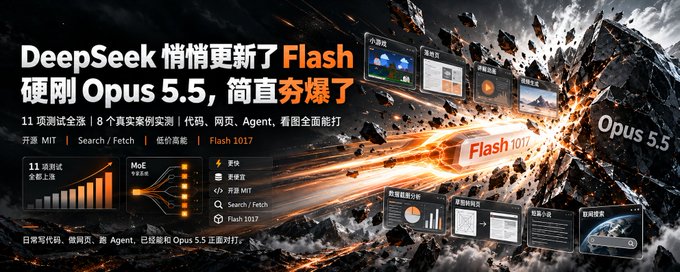
DeepSeek 悄悄更新了 Flash,硬刚 Opus 5.5 简直夯爆了

DeepSeek 发布了 DeepSeek-V4.1-Flash-1017 小版本更新,作者在推理、代码、Agent、图像理解等 8 个实际场景中与 Opus 5.5 进行同题对比测试。测试包括网页小游戏开发、落地页设计、讲解动画、视频渲染、数据分析、草图转网页和小说写作。结果显示该 Flash 版本在功能完整度、数据分析、交互还原等方面表现出色,多项能力已接近 Opus 5.5。新版本采用 552B 参数 MoE 架构,MIT 协议开源,同时开放了 Search 和 Fetch 搜索接口。

技术 › LLM zhouluobo 2026-10-1818.7 KB 9K 32 77

从Anthropic看用工变化与人的价值,LangChain CEO谈模型路由和运行框架,DeepSeek V4.1 Flash新版本发布

本期早报聚焦三大主题:一是Anthropic内部研究揭示AI如何重塑用工方式,初级技术岗占比从27%降至9%,员工角色从执行转向定义任务、分流输出与验证结果,判断力成为核心能力;二是LangChain创始人Harrison Chase谈智能体系统中模型、运行框架与上下文三层拆分,强调路由价值来自对任务结构的理解,并分享记忆与持续学习的实践经验;三是DeepSeek V4.1 Flash新版本发布,强化从零构建完整项目能力,开放Search/Fetch接口并单独计费。速览部分涵盖AI成本优化、智能体评估实操、美光存储产业史与AI安全等七篇内容。
技术 › LLM ginobefun 2026-10-1828.6 KB 1.7K 3 76

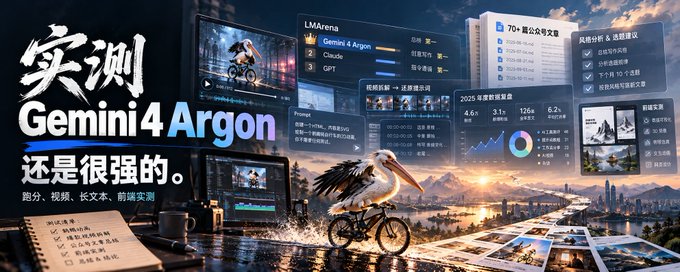
实测Gemini 4 Argon,还是很强的。
作者以自媒体真实工作场景实测Google新发布的Gemini 4 Argon模型。通过鹈鹕骑自行车SVG动画、爆款视频拆解与提示词还原、公众号文章风格分析与选题生成、五道前端实战题(数据看板、3D宫殿、品牌官网、浏览器合成器等)进行评测。结论是该模型跑分第一,长视频理解和前端能力出色,写作能力介于Claude Opus和GPT之间,并提醒读者注意订阅档位和API优惠价截止时间。

技术 › LLM zhouluobo 2026-10-1725.7 KB 10.4K 19 78

谷歌最新AI模型 Gemini 4 Argon,第一手测评来了!

Google 发布新一代旗舰模型 Gemini 4 Argon,主打复杂长流程任务的深度推理,输出 token 上限达 100 万,行业第一。官方跑分 19 项中拿下 14 项第一,第三方测试显示其幻觉率全场最低(15%),且成本仅为 GPT-6 Astra 的六成。作者通过两个实测案例进行对比:俄罗斯方块游戏中 Argon 5 分钟一次写完 4.7 万字符代码,速度是 Astra 的两倍多,验证了长输出能力;但番茄钟前端设计对比中,Argon 功能完整却设计粗糙并有 UI bug,验证了其前端偏弱的爆料。结论:Argon 硬实力强、长代码能力实锤,但前端精细活不是主场。

技术 › LLM 程序员小灰 2026-10-1713.9 KB 10.9K 15 75

Glimpse 视觉推理大模型在游戏开发验收中的实战体验

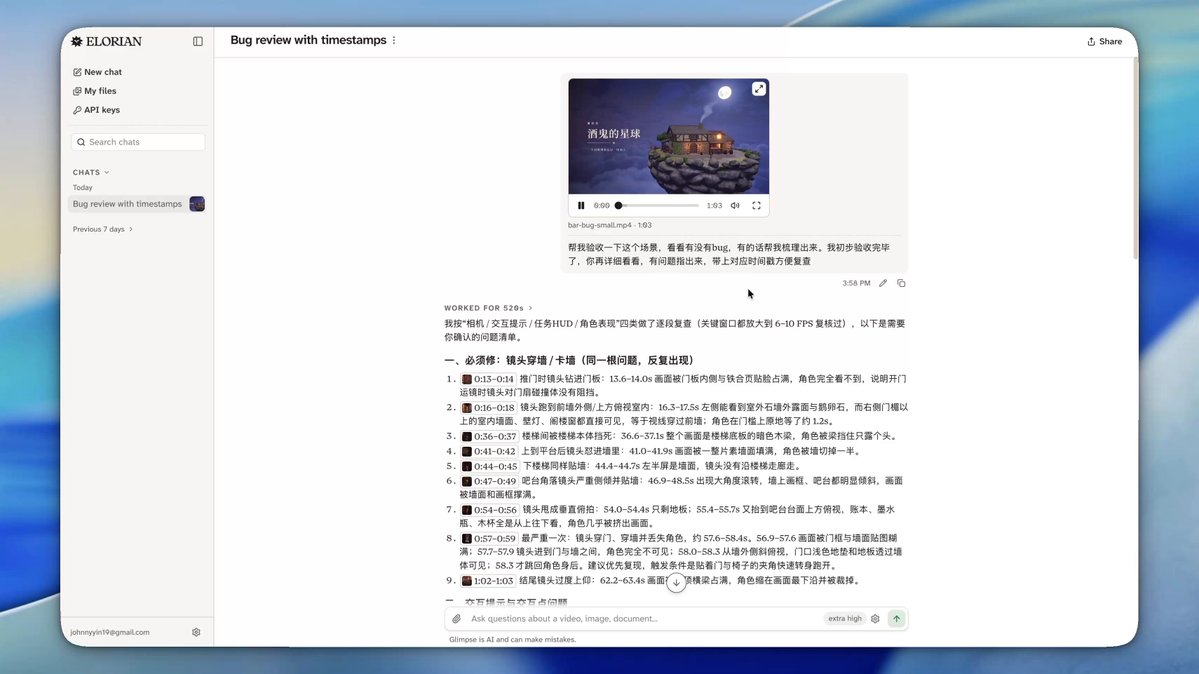
作者分享了使用 Elorian AI 刚发布的视觉理解与推理大模型 Glimpse 的体验。该模型能原生理解图片和视频中元素的位置、结构与空间关系。作者将其用于小王子游戏的 bug 排查:只需提供实际游玩录屏,Glimpse 就能分析游戏设计是否合理并梳理潜在 bug。实测中,在无游戏上下文情况下,其发现的问题数量是 Astra 的 3 倍,且可按视频时间戳罗列细节问题,便于逐一核验,极大解决了个人开发者验收容易遗漏的痛点。Glimpse 已开放 API,可接入 Codex、Claude Code 完善验收流程,也适合视频/图片生成等 AIGC 场景。

技术 › LLM Sac (@Saccc_c) 2026-10-174.3 KB 59

可灵4.0深夜上线:30秒一镜到底实测体验

作者实测可灵AI最新视频模型Kling 4.0,重点评测三大升级:一是支持最长30秒一镜到底直出,通过城市追逐、马戏团等案例展示物理交互和镜头调度能力;二是动态表现明显提升,在电梯打斗、花样滑冰、篮球等复杂动作场景中,人物动作衔接和镜头临场感表现出色;三是全能参考升级,支持最多10帧多帧参考及视频运镜、人物替换。价格方面1080P 30秒约16元,720P约9元,并预告未来将支持10-bit 4K HDR输出。作者认为可灵4.0在大范围动态、复杂动作衔接和可控性上进步扎实。

技术 › 工具与效率 数字生命卡兹克 2026-10-1614.5 KB 24.4K 57 76

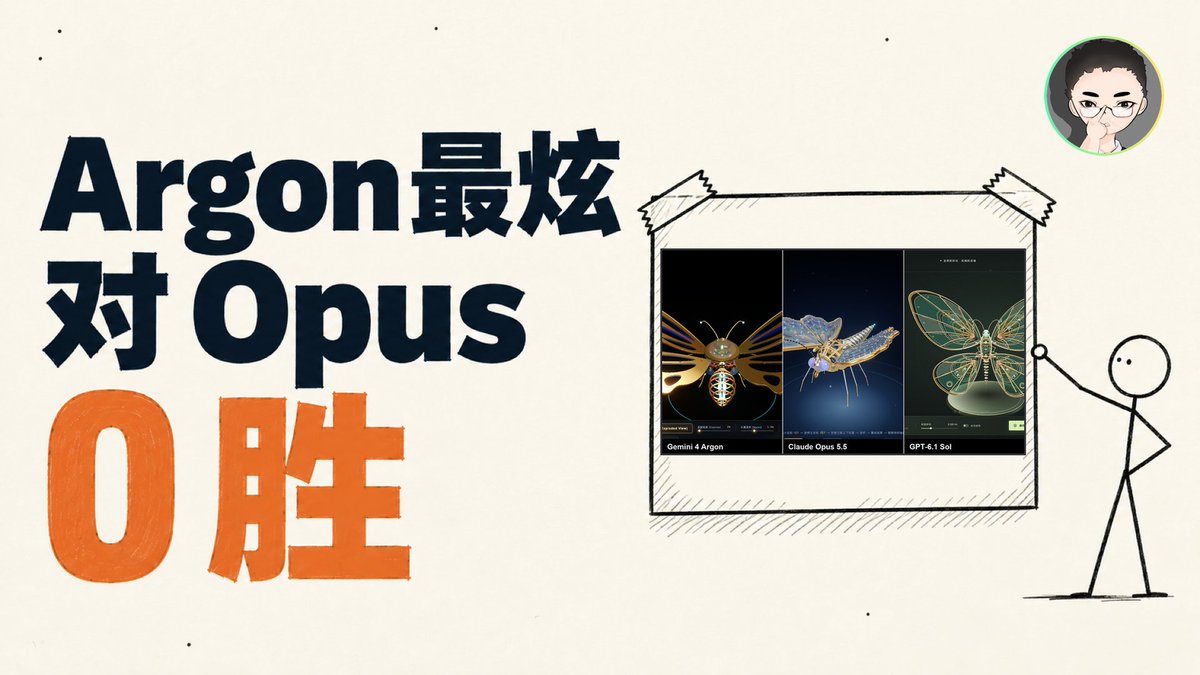
Gemini 4 Argon 对 Opus 5.5、GPT-6.1 Sol:同样 12 道题,3 道打开就坏

作者用同样的 12 道题横向实测 Gemini 4 Argon、Claude Opus 5.5 与 GPT-6.1 Sol。Argon 在 Gemini 网页 App 中闭卷盲打,另两家则通过 Claude Code 与 Codex 命令行 Agent 拥有自测调试的工作流。结果 Argon 对 Opus 0 胜 5 平 7 负,对 GPT 2 胜 4 平 6 负。失分分两类:铁路、咖啡店、四季三题毁于作用域未定义、少打空格、404 地址等小错,补一两行即可运行,根源在 App 环境无法自测;而机械蝴蝶连杆伸缩、折纸裂开、书封视觉误读、西瓜过曝等属于硬伤。Argon 在视觉题与原创游戏上表现出色,Pro 额度也较充裕。

技术 › LLM Axton 2026-10-1520.6 KB 4.9K 7 81

我们复现了那个决策模型教程

作者复现 Nish Tahir 的《Build your own decision model》教程,在 CommonsenseQA 上验证基于语言模型单次前向读取选项 token 概率作为置信度的决策模型方法。复现发现教程方法成立但需补两个关键前提:读数位置必须放在 assistant 轮,模型需用 8B 而非 1.7B。温度缩放校准有效,而微调增益主要来自修正 harness。作者还将方法应用于素材席位判定任务,发现模型间一致标签不等于准确率,结论需以人工标签为准。核心启示:核对读数位置的概率质量、报告覆盖率、用独立数据拟合温度。

技术 › LLM yibie 2026-10-128.2 KB 1K 4 85

16.9 MB 的语音识别,和它不认识的语言

Cactus Compute 发布了 16.9 MB 的本地语音识别模型 Whistle,纯 CPU 运行、无依赖,与同公司的 Needle 模型共享引擎。作者实测发现:七种欧洲语言(英德法西意荷波)识别准确度高,首 token 仅 5-8 毫秒,解码速度约 1300 token/秒,官方性能数据基本可信。但关键缺陷在于:遇到不支持的语言(如中文、日文)时,模型不会报错也不会返回空,而是硬套进已知语种生成'假词',造成静默污染。文章指出该模型设计目标是端上语音自动化入口而非单纯转写,并提醒中文用户慎用。

技术 › TTS yibie 2026-10-116.2 KB 4.4K 36 83

Jev-as-a-Judge for Agent Evaluations

本文介绍了如何使用 TypeSafe AI 的决策模型 Jev 作为 LLM Judge 来评估 Agent 的表现(Jev-as-a-Judge)。与只看最终回复不同,Jev 会阅读完整轨迹(用户请求、工具调用及结果、最终回复),将标准转化为预定义问题,并返回带置信概率的判定。文章通过退款 Agent 示例演示了 Playground 的使用,说明如何设定阈值将运行分为通过、失败和人工复核三类。研究显示,该接受-升级模式比 GPT-6 单独判断更准确且成本大幅降低。作者强调需先用人工标注验证 Jev 的可靠性,能用代码检查的事实性问题就不需要 Judge,将 Jev 保留给需要阅读理解的判断。

技术 › Agent elvis 2026-10-078.3 KB 92.7K 438 83

实测 Claude Sonnet 5.5,做 AI 代码动画这块断档领先 gpt6 但 3D 拉了

作者实测 Anthropic 新发布的 Claude Sonnet 5.5,与 Opus 5.5 对比其在代码动画、HTML PPT、3D 网页和写作等场景的表现。结果显示 Sonnet 5.5 价格便宜 50%、速度快 30%,代码动画效果领先 gpt6,执行力强、交付完整,但 3D 建模不如 Opus 5.5,且缺少 Opus 那种“创意溢出”。写作方面 Sonnet 5.5 节奏感甚至优于 Opus。作者总结其定位为及格线以上的执行模型,适合批量改 bug、文档整理等任务,建议与 Opus 5.5 组合使用以降本提速。

技术 › Claude 卡尔的AI沃茨 2026-09-2912.1 KB 3.2K 15 71

实测商汤 SenseNova U1 Pro 新模型,我的 8K 生图工作流要换新了

作者实测商汤新发布的 SenseNova U1 Pro 图片生成模型,该模型在 SuperCLUE-Image 中文文生图榜单排名第一。作者从五个维度进行测试:审美与中文版式、多文字运营物料、资料检索与高密度信息、局部修图、多图融合。测试结果显示,该模型在海报设计、菜单与导览图、科普信息图、全诗《琵琶行》等复杂任务中文字稳定性出色,局部编辑精准不破坏其他细节,多参考图融合能力强,并能从刀版图生成可交付的包装渲染图,整体表现超过 GPT Image 2.5。作者认为其达到可交付水平,决定替换到自己的 8K 生图工作流中。

技术 › 工具与效率 卡尔的AI沃茨 2026-09-2515.1 KB 13.5K 12 77

锐评一下 Jev 和狂躁的 AI 圈

作者对近期爆火的 Jev 模型进行冷静剖析。通过分析 JevPilot 自动驾驶、通关《宝可梦·红》、大战《毁灭战士》等热门项目源码,指出其炫酷演示背后主要依赖传统算法和剪辑包装,Jev 真正参与决策极少。Jev 本质是低延迟、低成本的判别分类架构,只能做单步选择,缺乏长程推演能力。作者认为与其让大模型生成选项再由 Jev 裁决这种毫无意义的使用方式,不如将其用于任务前置过滤分流等真正能降本增效的场景,呼吁 AI 圈少些浮躁炒作,多沉下心寻找实际应用价值。

技术 › LLM 林亦LYi 2026-09-246.3 KB 9.1K 50 75

把 Jev 插进 RAG:爆速与降本到底能不能实现,实测验证

本文实测了 TypeSafe AI 发布的不生成文本的 AI 模型 Jev 在 RAG 检索流程中的效果。作者在重排、回答判断、检索前置门卫三个环节插入 Jev 进行验证:重排方面,Jev 以八分之一的成本达到接近 Cohere Rerank 的精度;在调用 LLM 之前用 Jev 判断「无法回答」,响应速度提升 5.6 倍,成本降至二十七分之一;在检索之前拦掉范围外提问,速度提升 7.4 倍,成本降至七十五分之一。此外,Jev 还能一次请求同时完成重排和回答判断。结论是用 Jev 改善 RAG 速度与成本可行,但需慎重设定阈值,避免误拦可回答问题。

技术 › LLM yibie 2026-09-2416.7 KB 10.8K 85 85

刚刚 Opus 5.5 和 GPT-6 Sol 同时发布,首发实测来啦!结果让我很意外

Anthropic 与 OpenAI 同日分别发布 Claude Opus 5.5 和 GPT-6 Sol。作者通过 5 个实测案例对两大模型进行对比评测:SVG 画熊猫骑车、300 字科普写作、3D 重庆城市生成器、操作电脑画 Q 版鲸鱼娘、复刻 Cursor 工具。结果显示,Opus 5.5 在智能程度、生成质量和细节刻画上全面领先,尤其在 3D 城市生成和复刻 Cursor 任务中表现惊艳,而 GPT-6 Sol 虽然速度快一倍、价格减半,但完成度明显逊色。

技术 › LLM 程序员鱼皮 2026-09-2320.7 KB 14.4K 24 68

当AI模型开始拼每项工作的成本:OpenAI 和 Anthropic 新模型同日降价对比

2026年9月23日,Anthropic发布Claude Opus 5.5,OpenAI随后推出GPT-6 Sol和Luna,三家新模型共同卖点是降价:Opus 5.5单价降20%,Sol和Luna较前代降约50%。文章结合Artificial Analysis独立评测指出,标价之外,实际成本还受输出token数、缓存、effort和重试影响,三款模型能力分属不同档位,不能直接对比。作者建议以固定材料、工具链和验收标准的真实任务实测交付质量与单任务成本,用通过验收的单任务成本作为选型指标。文章还讨论了Dario Amodei《We Must Pace the Frontier》放缓主张与Opus 5.5发布是否矛盾的问题。

技术 › LLM 造物有心 2026-09-239.1 KB 2.5K 15 80

实测 GPT6 Sol 和 Luna 和 Claude Opus 5.5,我们再不用愁额度少和速度慢了

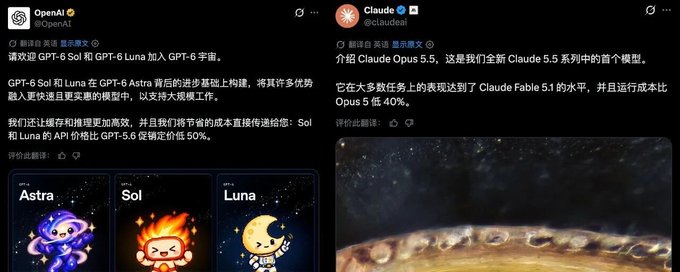
作者对 GPT-6 Sol、GPT-6 Luna 和 Claude Opus 5.5 三款新模型进行横向实测。价格方面,GPT-6 系列比 GPT5.6 便宜 50%,Opus 5.5 速度提升 30%、成本降低 40%。通过鹈鹕骑单车、可互动饺子网页、前端动效设计、写作 skill 生成、Blender 3D 建模复现舞蹈等多个案例对比,作者发现 Opus 5.5 在终端编程和前端能力上依然领先,细节表现惊艳;GPT-6 Sol 速度极快且能力不俗;Luna 则适合简单批量 Agent 任务。总体来看三款新模型在性能与成本上均有显著进步。

技术 › LLM 卡尔的AI沃茨 2026-09-2311.6 KB 53.5K 91 73

一夜三连发,Claude Opus 5.5、GPT-6 Sol和Luna全部都来了

Anthropic与OpenAI同日发布多款新模型:Claude Opus 5.5、GPT-6 Sol和Luna。作者详细评测了各模型的定位与表现:Opus 5.5作为Claude系列性价比模型,Coding能力达到SOTA,成本下降40%,速度提升30%,但Token消耗大;GPT-6 Sol和Luna主打降本,价格比上代便宜50%甚至低于Deepseek,Token效率出色、幻觉率大幅降低,但审美与细节能力有明显降级。作者指出两家公司差异化路线:Anthropic专注Coding通往AGI,OpenAI专注全面Agent能力,并给出不同场景下的模型选择建议。

技术 › LLM 数字生命卡兹克 2026-09-2316.6 KB 43.1K 126 77

一夜之间!Opus5.5、GPT-6 Sol、GPT-6 Luna全来了

Anthropic发布Claude Opus 5.5,比Opus 5便宜40%、速度快30%,跑分全面超越Fable 5.1,并推出订阅用户一次性的额度reset功能。一个半小时后,OpenAI发布GPT-6 Sol和Luna,大幅降价,Luna价格杀入DeepSeek区间。作者实测对比了Opus 5.5、Opus 5和Fable 5.1在鹈鹕骑单车SVG、Blender建模宋代斗拱、机械蝴蝶等任务上的表现,发现Opus 5.5综合成本省29%-55%,agent能力强,但max档反而不如medium档。文章详细分析了各模型跑分、价格策略和Claude Code更新要点。

技术 › LLM 花叔 2026-09-2322.0 KB 41.5K 45 81

实测MiMo-V2.6:小米347万美元训出的开源模型深度评测

作者实测小米直播后训练的MiMo-V2.6模型。小米以直播方式公开后训练全过程,Flash和Pro合计花费347万美元,Pro在Artificial Analysis智能指数榜登上开源模型第一(46分)。作者通过五个真实任务测试:three.js程序化3D建模太和殿、高端旅行社官网前端审美、修复开源仓库真实bug、办公数据处理与核对、以及对发布仅七天的Jev模型做长程研究与幻觉控制。结果显示模型在agentic编程、审美、错误处理和事实核查上表现出色,且缓存命中率达95.7%、成本低廉,作者认为智能正走向普惠,计划将常用开源API迁移到MiMo-V2.6。

技术 › LLM 花叔 2026-09-2211.3 KB 14.5K 9 78