99% 开发者误解的 Claude 技巧:从对话到系统
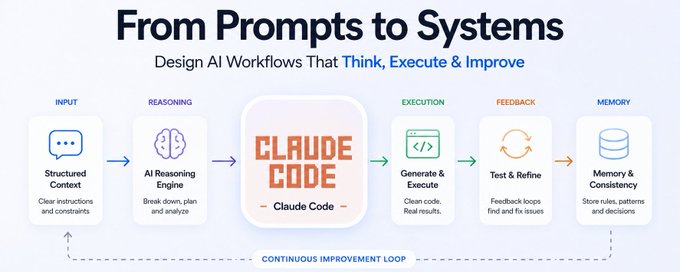
文章指出了大多数开发者在使用 Claude Code 时仅停留在“对话”层面的误区,提出了将其视为“可编程推理引擎”的理念。作者详细阐述了如何通过构建“输入层-推理层-执行层-反馈层-记忆层”的系统架构,利用 Prompt Builder、自动化测试闭环和 CLAUDE.md 记忆机制,将 AI 从辅助工具转化为高一致性的生成系统。
文章指出了大多数开发者在使用 Claude Code 时仅停留在“对话”层面的误区,提出了将其视为“可编程推理引擎”的理念。作者详细阐述了如何通过构建“输入层-推理层-执行层-反馈层-记忆层”的系统架构,利用 Prompt Builder、自动化测试闭环和 CLAUDE.md 记忆机制,将 AI 从辅助工具转化为高一致性的生成系统。
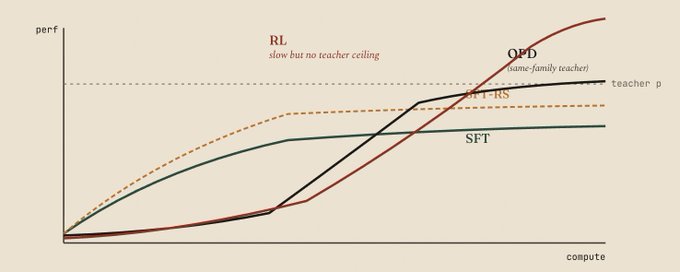
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。
文章旨在解决用户使用AI输出质量差的问题,提出了一套系统的提示词工程方法论。核心内容包括“六要素检查法”(角色、背景、任务、格式、约束、质量标准),使用XML标签进行结构化提示,以及链式提问、自我修正等进阶技巧。文章还强调了建立上下文文件和模板库以实现长期复利,帮助读者从新手进阶为提示词工程大师。
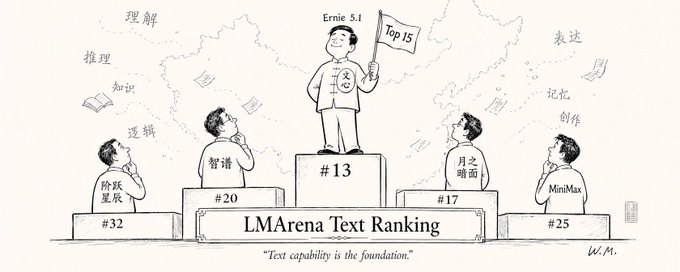
本文基于 LMArena 最新文本排行榜更新,探讨了文心 5.1 Preview 凭借 1476 分拿下国内第一、全球第 13 的成绩。作者分析了为何在 DeepSeek V4 和 GPT-5.5 主导的时代,文本能力依然是大模型代码生成与逻辑推理的“基本盘”。文章指出文心通过「多维弹性预训练」技术实现了高性价比与高性能,验证了夯实文本底座的重要性。
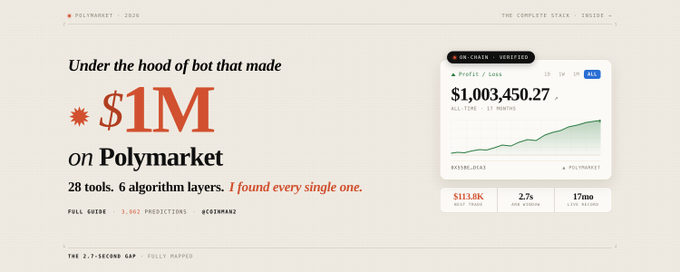
本文深度解析了一个在 Polymarket 上获利超过 100 万美元的自动交易机器人“Coinman2”的技术栈。文章详细介绍了利用 Claude (Anthropic) 等 AI 模型进行交易逻辑推理,并通过六个层级(大脑、编排、数据等)的 28 个工具构建完整系统的过程。核心策略在于捕捉 Polymarket 与 Binance 之间的价格滞后(套利机会),通过高频交易和严格的风控(如凯利公式)获利。
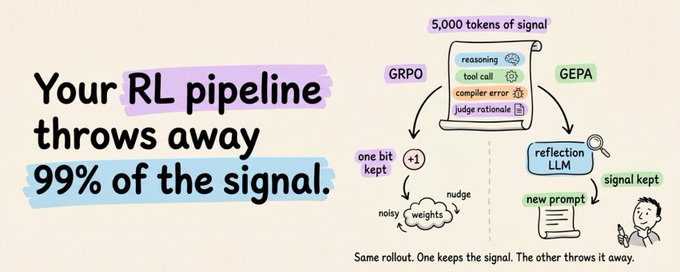
文章介绍了 Berkeley 团队提出的 GEPA 算法,该算法作为 GRPO 的替代方案,无需更新模型权重或进行 GPU 训练,仅通过优化提示词(Prompt)即可在 HotpotQA 等基准测试中取得更优成绩。GEPA 的核心在于利用 LLM 读取完整的推理轨迹,通过自然语言反思来迭代优化多模块系统中的每个提示词,从而避免了强化学习中将丰富信息压缩为单一标量信号的信息损耗问题。
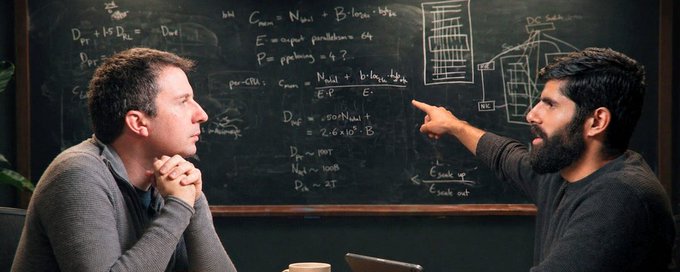
本文基于 Reiner Pope 的播客内容,深入剖析了大模型在集群中的运行机制。文章通过 Roofline 分析和 KV Cache 等核心概念,解释了推理延迟、Batch Size、API 定价策略及 MoE 架构背后的物理与经济逻辑,揭示了硬件限制如何塑造 AI 进展。
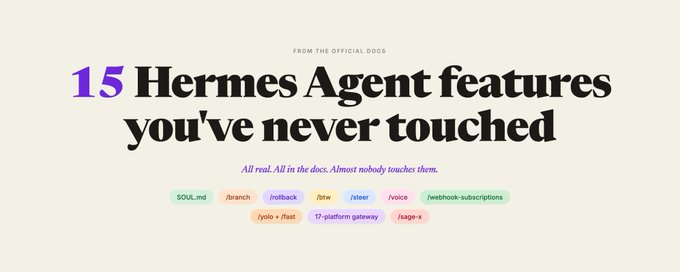
本文介绍了Hermes Agents被用户忽视的14个高级功能,包括持久化角色设置(SOUL.md)、长期记忆、数据洞察、会话快照与回滚、动态分支、实时语音、Webhook集成及100多项预构建技能。文章指出,大多数用户仅将其作为普通聊天机器人,仅发挥了8%的潜力,通过掌握这些工具,用户可以实现事件驱动的自动化、多模型路由及复杂的开发工作流。
文章介绍了一种名为 Agentic Harness Engineering (AHE) 的新框架,该框架能在不改变基础模型和系统提示词的情况下,自动演进编码代理的工具、中间件和内存。AHE 在 Terminal-Bench 2 上通过 32 小时的迭代将性能提升至 77.0%,击败了包括 Codex-CLI 在内的人工调优方法及仅优化提示词的基线。研究还发现,优化内存、工具和中间件比优化系统提示词更能带来显著性能提升。
文章推荐了 27 本构建 Agent 时代认知地基的书籍,涵盖底层范式、认知科学、决策理论、多智能体协作、组织管理及哲学对齐六大板块。作者强调 Agent 时代的盲区在于认知层,建议按需阅读,认为读完这些书能看穿当前 90% 的 Agent 创业本质是在重复旧思想。
文章深入剖析了 AI 编程中 Skill 的内部结构与生命周期。作者指出 Skill 不仅是高级 Prompt,而是包含元数据、入参结构、核心提示词及执行器的标准件。文章详细解释了 Skill 从注册发现到意图匹配再到沙盒执行的全过程,并提出了判断何时封装 Skill 的三个标准,旨在帮助开发者通过工程化手段稳定 AI 输出。
文章揭示了AI时代提示词工程的核心不仅是技巧,而是“表达需求的能力”。作者提出了一套系统化的四阶段方法论:需求结构化(COSTAR模版)、推理路径设计(CoT与Few-Shot)、结果校验(自我一致性与ReAct)以及迭代反馈(Reflexion)。通过这套闭环思维,用户可以将简单的问答转化为高质量的决策方案。
本文探讨了如何利用 Hermes 的多 Profile 协作功能,将多个 Agent 组织成一支 OPC(一人公司)团队。文章指出,单一 Agent 存在幻觉、记忆污染和角色混乱等问题,因此建议引入类似公司架构的四角色模型:Coordinator(协调员)、Researcher(研究员)、Writer(作家)和 Builder(构建者)。文章详细阐述了 Profile、Subagent、Project 和 Wiki 四个核心概念的区别,并提供了构建稳定 Agent 工作系统的具体配置方法,旨在建立清晰的角色边界和可长期运行的协作体系。
文章探讨了如何利用 Hermes 工具的多 Profile 协作功能来构建 OPC(一人公司)Agent 团队。作者指出单一 Agent 存在幻觉、记忆污染和角色混乱三大问题,并提出通过“长期员工”Profile 和“临时工”Subagent 的概念进行分工。文章详细拆解了四角色模型(协调员、研究员、作家、构建者)及各自的配置文件结构,旨在建立一套稳定、清晰的 Agent 工作系统。
本文针对 AI 领域快速迭代带来的焦虑,提出了一套判断技术价值的筛选标准,建议关注具有长期复利的“原始概念”而非短暂的封装框架。文章重点探讨了“上下文工程”的演变及“工具设计”的重要性,强调在混乱的生态中应保持耐心,注重核心模式与可衡量性,而非盲目追逐每周的新框架。
文章深入分析了开源 Hermes Agent 的记忆系统架构。与 OpenClaw 不同,Hermes 不依赖单一记忆,而是采用了四层架构:极简的 Prompt 冻结记忆(MEMORY.md/USER.md)、基于 SQLite 的会话搜索、程序化技能以及可选的 Honcho 层。其核心设计理念是保持 Prompt 稳定以利用缓存,并将历史细节剥离至外部工具按需检索。
本文详细记录了 Andrej Karpathy 在 2026 年 Sequoia Capital 访谈中的核心观点。Karpathy 指出 AI 编程已进入新阶段,从“凭感觉编程”进化到更严肃的“智能体工程”。他阐述了 Software 3.0 的实质是利用 LLM 作为新的信息处理解释器,通过上下文操作模型。文章还探讨了 AI 能力的不均匀性(锯齿状智能)、模型对特定应用的吞没效应,以及未来“神经计算机”的愿景。
文章针对2026年AI Agent红海现状,对比了OpenClaw、Hermes(爱马仕)和Mercury(水星)三款工具。指出OpenClaw成本高易出Bug,Hermes适合进阶玩家追求自我进化,而Mercury(水星)因其安全可控、成本低廉及稳定性,被推荐为普通人的最优解。文章详细分析了选型逻辑并提供了Mercury的安装指南。
文章验证了一个关于多 Agent 编排的猜想,通过搭建 hero-coding MVP,对比了 ChatGPT 5.4、Ling-2.6-flash 和 Ling-2.5-1T 在编码任务中的表现。结果显示,非思考小模型(Flash)在明确 Bug 修复上比思考模型快 31%,而 Ling-1T 在加功能任务上仅需 11% 的 Token 和 63% 的时间。作者总结出“大模型规划,小模型干活”的最佳实践,并强调了非思考模型必须配合 Harness 工程兜底的重要性。
文章从OpenAI关停Sora切入,深入探讨了Sora核心架构DiT创造者谢赛宁对大语言模型(LLM)的根本性质疑。谢赛宁认为LLM只是在模仿语言的统计规律,而非理解世界,语言是“鸦片”。文章详细阐述了基于抽象表征空间的预测架构(JEPA)和世界模型才是通往通用智能的正确路径,并指出未来的AI架构中,LLM将退化为仅用于交流的界面,而表征层才是真正的基石。
文章指出传统 Prompt 工程在规模化、持久化和稳定性上的局限,提出了“Skill”概念。Skill 将系统提示词、入参 Schema 和执行逻辑封装为可复用的“AI 函数”。文章对比了 Skill 与 Prompt、MCP、Agent 的区别,并介绍了基于“渐进式披露”的三层交互架构,旨在用软件工程的严谨性提升 AI 应用的可控性。
SMFS 是一个结合了 RAG 和传统文件系统优势的新型可挂载文件系统。它允许 Agent 使用标准的 Unix 命令(如 grep)执行语义搜索,支持多格式文件的自动解析与提取,并提供本地优先的同步引擎。内部基准测试显示,SMFS 能显著减少 Token 消耗和工具调用次数,同时大幅提升检索准确率。
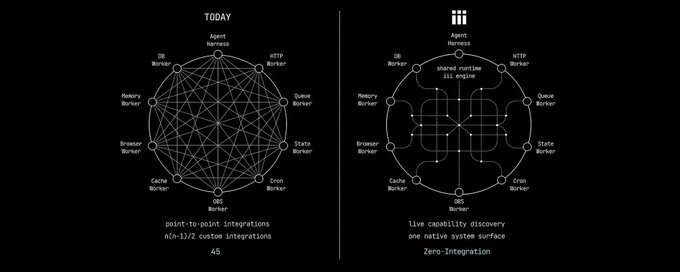
文章探讨了当前 AI 架构中 Harness(编排层)与后端基础设施分离带来的问题,指出这种分离导致了 Agent 的随机性与后端的确定性之间的调试复杂性。作者提出将后端抽象为 Worker、Trigger 和 Function 三个基本元素,介绍了名为 'iii' 的架构,使 Agent 作为 Worker 直接参与后端系统,而非通过外部集成层调用,从而实现真正的统一基础设施。
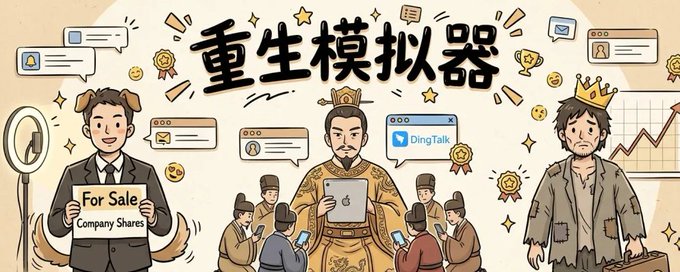
文章讲述了作者使用DeepSeek V4模型及其EasyClaw平台,通过简单的口述指令,快速生成并部署了一个网页版“重生”文字小游戏。游戏中包含了霸总变狗、皇帝用钉钉管理朝堂、乞丐摆摊IPO等极具幽默感和荒诞感的剧情,展示了AI在逻辑推理和内容生成上的强大能力以及低门槛开发的便利性。
本文探讨了 Andrej Karpathy 的 LLM Wiki 工作流在人类“第二大脑”场景下的优势,指出其在处理 AI Agent 时的局限性。文章强调,人类记忆优先考虑可读性和反思,而 Agent 记忆系统则需要快速检索、低 Token 成本和冲突解决。Mercury 提出的混合架构方案,主张使用 Markdown 作为人类界面,同时采用结构化内存作为 Agent 的底层设施,以实现上下文的持续累积和可靠运行。
文章精选了69个经过实战验证、维护活跃的开源AI仓库,旨在替代昂贵的API订阅。内容涵盖完整的AI技术栈,包括本地大模型推理、RAG知识库构建、AI智能体框架、提示词与评估、模型微调、工具链及部署等十大领域,为开发者、研究人员和独立黑客提供免费的生产级AI工具清单。
文章深入探讨了 AI Agent 遗忘信息的根本原因。作者指出,问题通常不在于检索,而在于 KV Cache 在上下文过长时的处理机制。文章对比了 StreamingLLM(仅保留近期信息)与 SnapKV(基于注意力分数保留关键信息)的区别,并解释了模型如何通过“注意力权重”来决定哪些 Token 值得被记忆,从而实现 92% 的压缩比且不丢失关键信息。
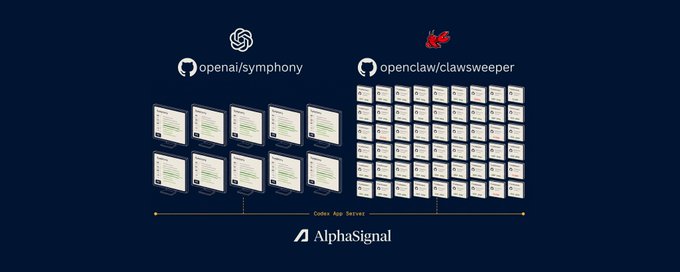
文章介绍了 OpenAI 生态内两个同时发布的开源项目:Symphony 和 ClawSweeper。两者均基于 Codex App Server 这一原始编排层,分别针对 SDLC 的两端(PR 创建与 Issue 维护)提供了参考实现。Symphony 将 Linear 转化为自动化代理系统,提升 PR 吞吐量;ClawSweeper 则能并行运行大量 Codex 实例,自动清理无意义 Issue。文章分析了它们的架构模式、应用场景及局限性。
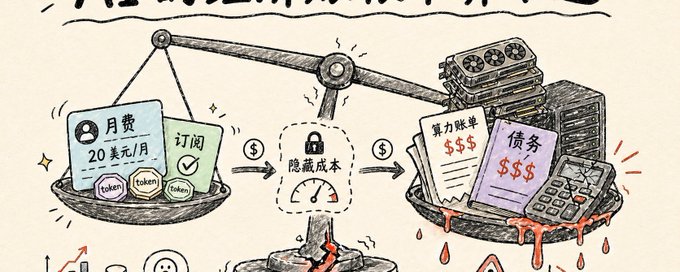
文章通过 GitHub Copilot 改为按用量计费的事件,剖析了生成式 AI 行业面临的深层经济危机。作者指出,目前的月费订阅模式建立在巨量算力补贴的基础上,企业长期亏损运营。随着推理成本因模型复杂化而上升,这种“次贷式 AI 危机”终将爆发,迫使行业转向按 token 真实计费,届时大量用户的真实成本将激增,导致商业模式崩塌。
大多数用户仅将 Hermes Agent 视为简单的聊天机器人,浪费了其 92% 的潜力。文章介绍了 15 个改变游戏规则的高级功能,包括:SOUL.md 个性化设定、持久化记忆(MEMORY.md)、会话分支与回滚、供应商无关的模型切换、17 平台网关、实时语音交互、内置 Cron 定时任务以及上百个可用的 Skill 斜杠命令。掌握这些功能可以将 Hermes 从单纯的对话工具转变为全功能的自动化与生产力中心。