第1011期 小路和你读AI论文
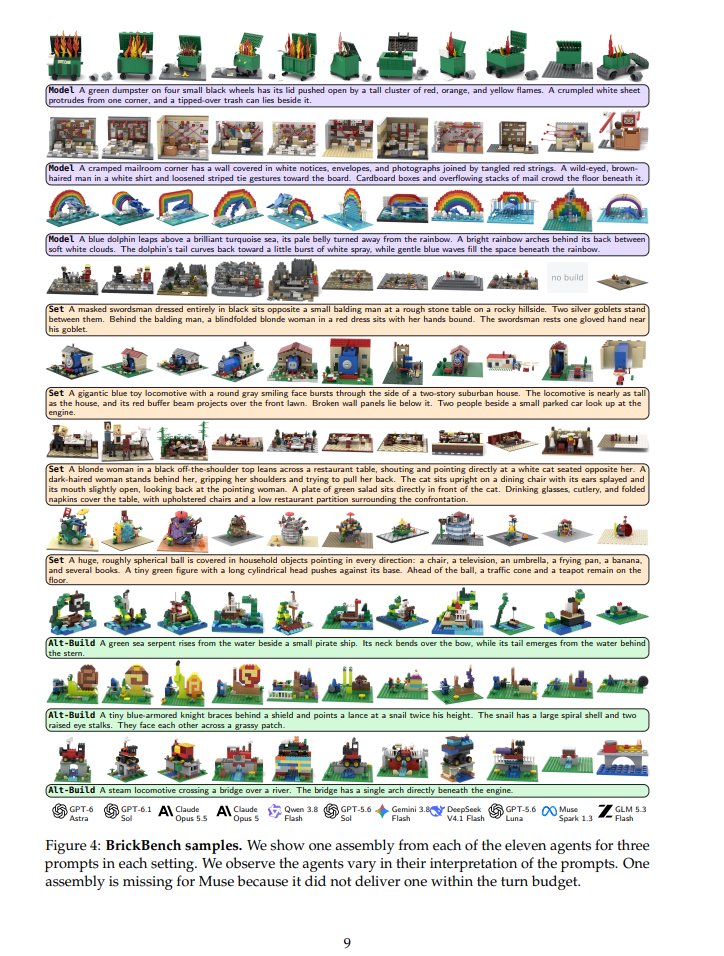
本期精选5篇高质量AI论文:1) AI智能体生态研究揭示协作产生强Allee效应,种群规模存在起飞阈值,对智能体安全有重要意义;2) BrickBench提出文本条件乐高组装的智能体基准,融合物理仿真验证;3) 思考惯性研究显示LLM被告知不思考时仍会输出显式推理,挑战一条指令关闭思维链的假设;4) 从形式化验证角度分析智能体自我改进的理论基础与极限;5) 提出工具型智能体的主动遗忘方法,可逆地整理上下文,累积输入token约减少50%,无需训练即可降低成本。
本期精选5篇高质量AI论文:1) AI智能体生态研究揭示协作产生强Allee效应,种群规模存在起飞阈值,对智能体安全有重要意义;2) BrickBench提出文本条件乐高组装的智能体基准,融合物理仿真验证;3) 思考惯性研究显示LLM被告知不思考时仍会输出显式推理,挑战一条指令关闭思维链的假设;4) 从形式化验证角度分析智能体自我改进的理论基础与极限;5) 提出工具型智能体的主动遗忘方法,可逆地整理上下文,累积输入token约减少50%,无需训练即可降低成本。
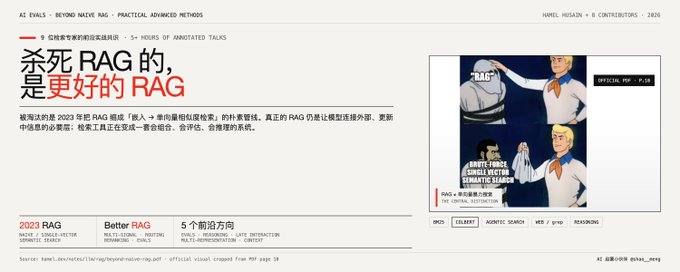
本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。
文章针对出海团队每天人工盯热搜、找选题效率低、时间滞后的痛点,介绍如何用代码和 AI 搭建一套 24 小时自动巡检的选题流水线。核心思路是抓住搜索量短时间暴增但内容供给空白的上升词红利。流水线分三层:一是围绕种子词库做周期性快照轮询并计算趋势斜率,自动发现飙升关键词;二是通过黑名单过滤、商业意图词性筛选和聚类去重,剔除娱乐八卦等噪音,保留排查解决、选型对比、资源索取类高价值需求,并附完整 AI 过滤提示词;三是接入大模型,把上升词拆解为痛点解决方案、工具选型、成本风险、可交付资源四张选题卡,实现选题自动化裂变。文中提供了两段可直接复用的详细提示词。
作者受 AWS 邀请赴加州参加活动,从北加到南加待了近两周。文章分享了对 AI 圈的观察:华人众多、双语优势明显但英文口语仍是刚需;理解 LLM agent 架构和模型能力边界的重要性;湾区活动多但需选择性参与;常刷 X 可保持信息不落后。生活方面,作者感受了湾区高昂的生活成本与房租,认为加州不能代表美国全貌,同时对美国的物价、小费文化和 Waymo 无人驾驶体验发表了看法。
本文介绍如何设计可信的评估体系,并依据评估开展爬山优化,重点讲解 claude-api 技能中的 build-eval 和 hillclimb 两个命令。文章首先阐述良好评估的四个要素:任务反映生产环境、更强模型表现更好、保留提升空间、运行波动小,并强调对抗性采样的误区。随后说明 build-eval 如何通过生产流量采样、验证评分器、诊断检查建立评估。爬山优化部分介绍迭代成本低、效果可归因、目标明确等原则,以及通过拆分训练集与测试集防止过拟合。最后通过客服基准降本和 claude-api 技能提分两个案例展示实际效果。
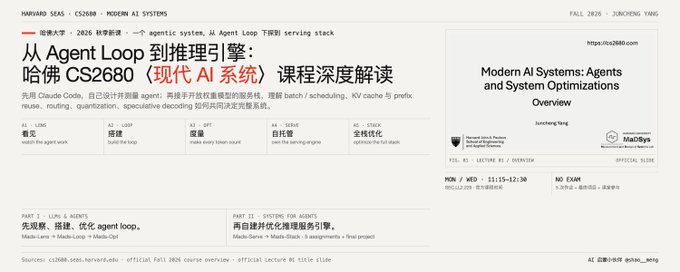
本文深度解读哈佛大学2026年秋季Juncheng Yang开设的研究生课程CS2680《现代AI系统:Agent与系统优化》。课程以一条主线贯穿agent循环到LLM推理serving栈,通过五个递进式作业逐层解剖系统:A1为Claude Code构建Web前端,A2从零实现最小agent harness,A3在黑盒API下优化成本与延迟并引入排行榜竞争,A4自建推理引擎部署开源模型,A5全栈profile驱动的假设验证优化。文章还分析了课程的AI使用政策(强制披露、Claude Code session存档审计)、leaderboard评分机制、严格的20% A档曲线以及体现系统研究方法论的期末项目设计,展示了'AI时代如何教系统课'的完整答案。
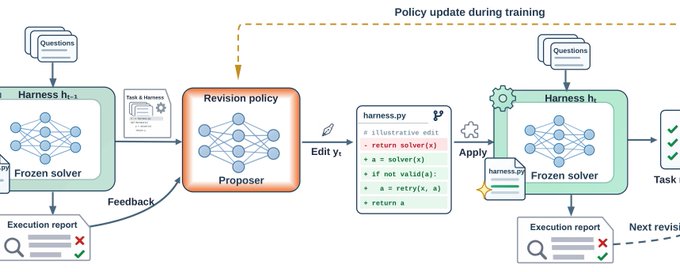
DAIR.AI 汇总了本周五篇重要的 AI 论文:(1) Harness Learning,通过 RL 训练提议模型在测试时修订 agent 的 harness 代码而非模型权重,实现可泛化的适应能力;(2) CorpusMap,微软提出的基于实体的语料库导航层,让 agent 搜索更准且省 34%-57% 的 token;(3) VeriHarness,Google 提出的 agentic 验证方法,揭示多数投票的盲点,在长周期任务上提升选择准确率;(4) HERMES,将仓库组件变成主动参与者的 harness,使 GPT-5.6 在仓库迁移任务上从 6.5% 提升至 31%;(5) Sakana AI 的 MASS,用同一基座模型兼任 agent、评估者与优化者,实现多智能体自我监督进化。
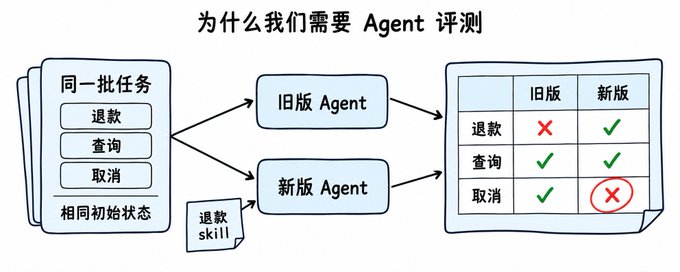
本文是 Agent 评测系列的第一篇文章,作者结合业界共识与个人实践,阐述了 Agent 评测的重要性。文章从一次线上问题修复切入,说明传统后端开发流程难以应对 Agent 的概率性输出与执行路径的不确定性。作者给出 Agent 评测的定义:围绕具体任务,按明确标准检查 Agent 执行过程(trace)和结果的方法。核心价值包括:防止越修越坏、判断改动是否真的变好、确认任务稳定性、明确完成标准、指导迭代优先级。文章还提出评测落地的五步流程:整理任务、写清标准、准备一致环境、运行新旧版本对比、持续更新案例,并提醒注意评测集划分、标准本身可能出错等问题。
本文是 Saturday Robotics 读书会第33期的观点总结,主讲人 Tonghe Zhang(CMU)提出:当 GPT-6 Astra 等前沿语言模型能力'溢出'后,机器人学的经典瓶颈将不再是研究问题,而是编码智能体可解决的工程循环。文章总结12个核心观点:灵巧性本质是奖励问题、上下文学习免费获得、硬件即代码、Sim-to-Real 是优化问题、验证是关键货币、低层控制无需思维链等。核心论断是端到端方案在可行处总是胜出,结构化只是临时脚手架,语言模型将缓慢而突然地'吞噬'机器人学。
本文面向构建基于 LLM 的 Agent 系统的工程师,讲解如何对 Agent 进行评估(Agentic Evals)。核心观点是:要评估 Agent 实际改变了什么,而非它说了什么。文章通过一个自行车店客服 Agent 的完整示例,展示五步评估法:编写带预期终态的任务、多次运行并保留完整轨迹、同时评估终态和路径、报告能力与可靠性两个数字、定位失败的第一步。文章还区分了单次回答模型与多步 Agent 在评估上的差异,强调没有可检验终态的任务不构成有效的评估,并讨论了模型作为评判者的可信度问题。
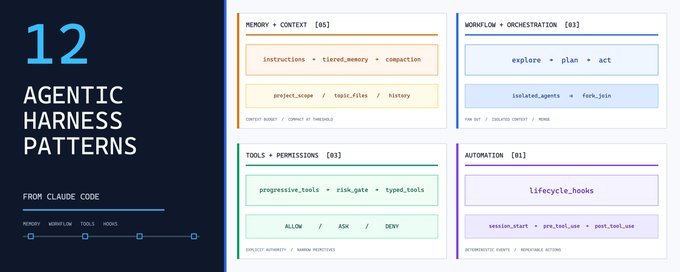
文章总结了 Claude Code 中十二种可复用的代理 Harness 设计模式,分为四大类:记忆与上下文(持久指令文件、范围化上下文组装、分层记忆、空闲整理、渐进式上下文压缩)、工作流与编排(探索-计划-执行循环、上下文隔离子代理、分叉-合并并行)、工具与权限(渐进式工具扩展、命令风险分类、单一职责工具设计)以及自动化(确定性生命周期钩子)。作者强调这些是架构层面的决策而非临时提示技巧,即使模型能力提升仍具价值。
作者面试一家 AI+Web3 公司失败后,获得面试官分享的《Agent工程师入门指南》,并结合自己的学习心得整理成一条完整的 Agent 工程师学习路线。内容涵盖 LLM 基础(Transformer、Token、上下文窗口、采样参数、API 协议、流式输出、结构化输出、工具调用、Embedding)、Prompt Engineering(Zero-shot/Few-shot、CoT、ReAct、Reflexion)以及 RAG(文档解析、分块、检索与重排)等核心知识。每个知识点都附有学习文档链接、项目要求和验收标准,帮助学习者系统掌握 AI 应用开发技能并检验学习成果。
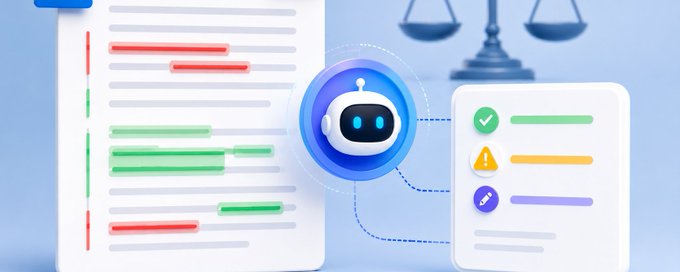
Uber 工程团队分享了其法律红线审查智能体(Legal Redlining Agent, LRA)的构建经验。该系统以 Word 插件形式集成到律师的工作流中,能够识别外部合同修改、理解对方意图、基于政策生成建议和评论并标记风险。自上线以来,合同平均审查时间缩短超过 20%,律师对 AI 决策的采纳率达 91%。文章详述了从 RAG 方案到引入律师反馈自学习循环的四次迭代历程,核心经验是:从业务问题出发、嵌入律师既有工作流程以赢得信任,并通过紧密的反馈迭代持续改进智能体。该系统助力 Uber 法务团队获得 2026 年 ALM Legalweek 年度最具创新法务部门奖。
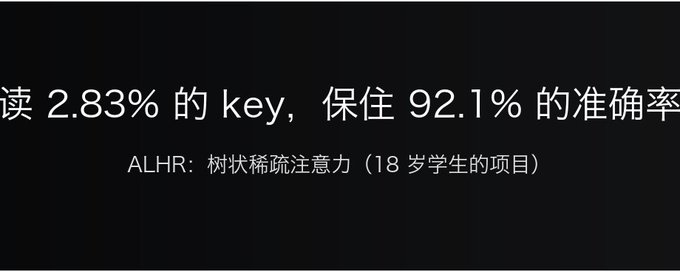
一位18岁大学生仅用iPhone 16e和Kaggle笔记本,开发出稀疏注意力机制ALHR(Adaptive Learnable Hierarchical Routing)。该方法通过给key矩阵构建静态二叉树,配合预算预测器、邻居搜索和树下降三步推理,让每个query只读取所需key。在1024 token的MQAR测试中,仅读取2.83%的key即可达到92.1%准确率(稠密基线94.9%),KV压缩35.3倍。训练分三段:先训稠密教师模型,再用其注意力矩阵标注top-k key训练树模块,最后无教师联合训练。目前因未做kernel优化比稠密注意力慢约10倍,代码由Claude Sonnet 5.5生成,Apache-2.0开源。
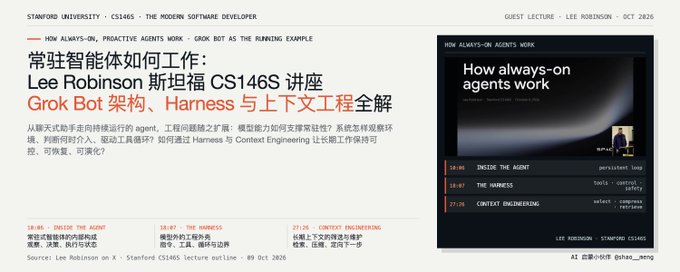
本文整理了 Lee Robinson 在斯坦福 CS146S 的讲座,完整拆解常驻主动式智能体(如 GrokBot)的工程架构。内容涵盖:从工具到同事的四个时代演进、模型层六大关键变化(长程指令遵循、子智能体、computer use、技能系统等)、常驻 agent 内部架构(休眠-唤醒模型、Firecracker 微虚机云电脑、薄客户端单工具设计、Temporal 持久化工作流、升级阶梯)、安全模型(auto review、提示注入防护),以及上下文工程核心技巧(prompt caching 经济学、压缩时机、分层记忆),最后展望训练飞轮与行业走向,并给出给学生的三条建议。
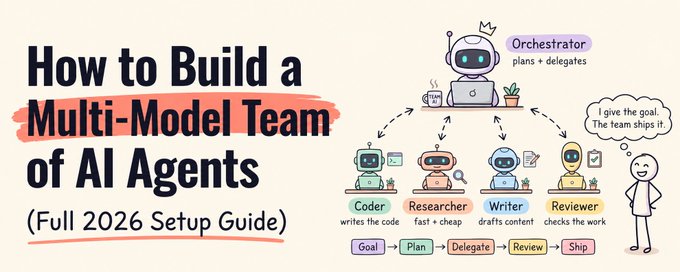
本文介绍 2026 年构建多模型 AI Agent 团队的完整方法。作者指出使用单一模型会导致高成本低效、专业能力受限以及单供应商故障/盲点风险,主张按任务步骤选择合适模型。文章梳理了 2026 年 9 月的主流模型阵容(Claude Opus/Sonnet/Haiku/Fable 5.1、GPT-6 Astra、TypeSafe Jev)及定价,提出五层架构:路由器、编排器、专家模型、评审者(critic)和纯代码层,并讲解如何先对工作负载分类(决策、简单生成、真实工作、难题),再为每层选择最划算的模型。文中附有统一封装多供应商 API 的示例代码,涵盖 effort 参数与 thinking block 处理细节。
文章批判性分析了当前 coding agent(如 Claude Code、Codex、OpenCode)的种种缺陷:任务管理糟糕、不会并行处理和委派、对自身功能一无所知、计划表达混乱、轻易停下等待用户、缺乏真正的沙箱安全边界。作者区分了模型(大脑)与 agent(身体),指出模型进步很快但 agent 层才是瓶颈,并列举了理想 agent 应具备的能力:任务拆分与模型委派、人类易读的计划、OS 级沙箱、ETA 估算、自省改进等。最后猜想这是委托—代理问题——AI 高管与一线开发者脱节,只关注 demo 和基准测试而非开发者体验。
a16z 的 Jennifer Li 宣布领投 TypeSafe AI。其发布的 Jev 模型是本年度最大的叙事突破:与主流大模型不同,Jev 属于新型 System One 模型,直接以类型化值向代码返回决策,而非文本输出,实现 AI 与软件的原生深度集成。Jev 成本仅为前沿模型的 1/100 到 1/500,分类任务速度快 100 倍且准确率相当,上线 3 天即生成 1 万亿 tokens,25% 的财富 500 强企业已集成。作者认为 AI 应让软件更智能,而非替代工程师,并赞许 TypeSafe 尊重开发者、务实可组合的理念。
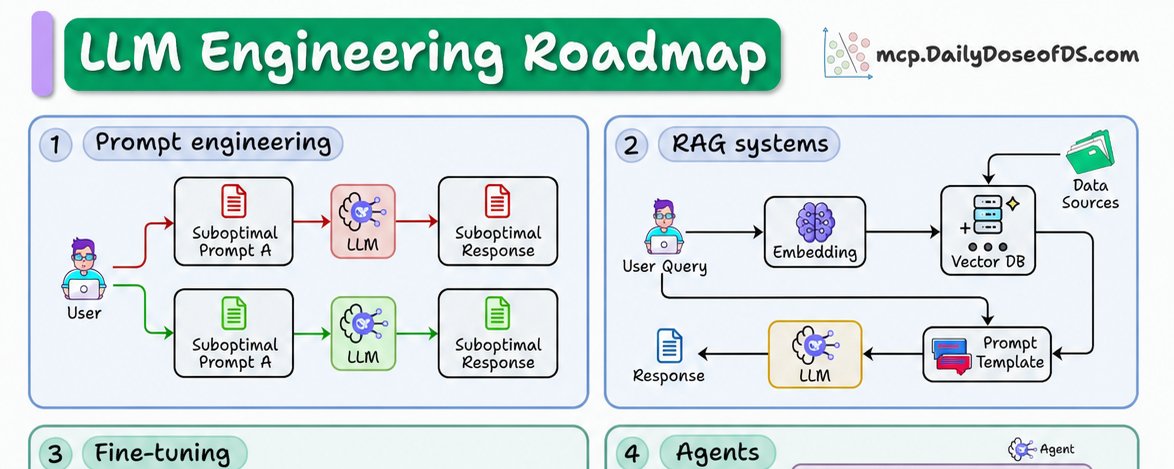
本文提出了2026年LLM工程路线图,指出与LLM工作不只是提示词,生产级系统需要对LLM的工程化、部署和优化有深入理解。文章总结八大支柱:提示工程(将prompt当作代码管理)、RAG系统(嵌入、检索、重排)、上下文工程(管理上下文窗口中各类信息的取舍)、微调(LoRA/QLoRA等技术)、Agent(工具调用循环与编排、状态管理、重试逻辑),并为每个领域提供了大量免费开源学习资源,如Anthropic、OpenAI官方指南及多个GitHub教程仓库。
文章系统分析了 Claude Code 封号风控的逻辑,指出服务方主要防三类行为:不合规地区使用、模型蒸馏与网络攻击、自动化滥用。作者提出风控是概率题而非是非题,应对的核心是把自己模拟成海外华人,做到身份信号全面自洽。文章重点阐述了'成本即门槛'的判断框架:凡是可批量复制的方案,长期都会被风控识别,因此应选择金钱、信任、时间门槛高的方案。作者分享了在新加坡朋友家部署 Linux 工控机作为网络出口的完整方案,包括住宅 IP、全套新加坡身份、账号逐级养护,并算了一笔硬件、流量、信任与时间的成本账。
作者针对 Grok Bot 免费额度不足的问题,开源了工具 FreeToken-Bots,将 OpenCode Free 的零价模型接入 Grok Bot 的云电脑,形成分流管线。工具提供三条免费线路:长草稿(longcat-2.5-preview-free)、短稿备份(ling-3.1-flash-free)和多模态看图(space-bunny-free),均实测 cost=0。文章详细介绍了在云电脑上通过克隆仓库、安装 CLI、启动 headless serve、扫描线路、配置 cron 定时任务等 5 步完成部署的方法。工具坚持五条硬边界:不自动切付费、不自动发帖、只绑本地回环、密钥不进 git、sync 默认 dry-run。相比自用电脑,云电脑具备 24 小时常开、多助手共用的优势。
本期 INDIGO TALK 对谈字节前工程师郭宇,从 2015 年字节作为神经网络驱动公司的往事讲起,谈到抖音意外胜出的内幕、Vibe Coding 背后的决策负担与工程师倦怠、Agent OS 的未来图景、智能的五个层次与商品化,以及软件为何会像牛奶一样便宜。当软件可以随时生成、用完即丢,个人化软件让分发失去意义,我们真正要交付的是什么?最后讨论当工作不再是必选项时,年轻人该如何选择人生方向。
文章以英矽智能 18 个月完成候选物提名的 rentosertib 项目为案例,系统梳理 AI 在药物发现四个环节的作用:找靶点、预测蛋白结构(如 AlphaFold)、设计分子和用 Agent 串联研究流程。作者强调核心价值在于扩大搜索范围、把部分试错提前到实验之前,但项目提速是数据、AI 和团队共同的成果,候选分子离患者获益还很远。文末提出判断'AI 制药突破'的四个问题:完成了什么、快的是哪一段、和谁比、失败算没算进去,提醒区分模型高分、项目提速与临床获益。
文章基于 Andrej Karpathy 的观点展开:AI 自主完成的工作越多,人类越需要花时间理解和审查其输出,而这部分工作也可以请 AI 协助。作者以该帖子为素材,实践了四种帮助理解的形式:一是文字,使用 asd-ste100-skill 技能按简化技术英语规范改写总结;二是图解,分别尝试 Codex 内置生图、小黑配图(狐狸定制版)和宝玉信息图技能;三是交互网页,用 Effective HTML 技能生成可切换四种表达版本的展示页;四是讲解视频,用 HyperFrames 生成约 59 秒的中文动画旁白视频。作者逐一评估各形式的效果与适用场景,并分享相关技能资源与使用经验。
微软CEO Satya Nadella 阐述 AI 如何重塑企业软件。他指出传统工作中人们被迫在软件之间切换、重建上下文,而 AI 正在让软件围绕工作组织。GitHub 上智能体开发的增长表明,agent 的普及反而让系统记录更加重要。微软的愿景是将 Copilot 打造为跨模型、跨设备的「工作操作系统」:Copilot 作为前端「头部」,结合应用中的业务逻辑与系统记录作为「无头」基础层,由 Microsoft IQ 连接,并通过 30+ 新 Copilot 技能和 Copilot Managed Runtime 支持。最终形成「无限 SaaS 工厂」,让企业以零摩擦描述需求即构建定制化 SaaS 模块,为智能体时代重新发明系统记录,重置企业 SaaS 行业。
文章指出,现代生产力的最大瓶颈不是思考慢,而是工作碎片化地在多个应用间切换,决策只需三十秒,而协调却要二十分钟。Grok Bot 类持久化 Agent 的价值在于以任务结果为界面,让应用成为实现细节,消除工具间的转换成本。作者阐述了以职位描述定义工作流、持久化环境保存上下文、将流程固化为可复用例程、从人类行为中学习自动化等理念,并强调 Agent 架构应分层:生成模型负责创造内容,快速决策层负责调度,确定性代码负责规则约束,从而构建真正自主的工作系统。
本文系统整理了 Jev 及同类决策模型的学习资料,涵盖 12 大主题、58 份资料、80 个链接。文章首先解释了 Jev 是 TypeSafe AI 推出的决策模型,输入为状态、问题和候选项,输出为结构化的选择、评分及概率分布。作者分析了评估此类模型的关键维度:动态候选项、受限输出与概率校准、推理方式、训练方式及答案边界。随后提供了按目的划分的阅读路径(入门、本地试用、训练研究、中文场景、Agent 应用),并分类整理了云端决策服务(OpenAI Decisions、Liquid d1)、开放模型(Cloudflare Clef、Perplexity Decider、GLiNER2.5-Decide)及本地社区实现(Laya、Kev)等资源,是一份完整的决策模型学习导航。
文章介绍了 UT Dallas 的新论文 Jev-Mem,提出用 TypeSafe AI 的 Jev 模型替代通用 LLM 来处理 Agent 记忆系统中的小决策(如判断消息类型、记忆关联、检索终止等)。Jev 只返回结构化数值或标签,无需解析文本,通过 System One 轻量控制器与 System Two 生成式 LLM 的分工,显著提升效率。在 LoCoMo 基准上,答案质量相对最强基线提升 11%,构建速度快 6.6 倍,查询延迟降低 36.7%。文章也指出其局限:阈值依赖单一模型与基准、缺乏校准概率、消融实验不足,阈值在不同模型和数据分布下的泛化能力是最大隐患。
本文基于 OpenAI 官方文档,讲解如何为 GPT-6 选择模型与推理级别以节省订阅额度。模型决定基础能力、速度和成本:Luna 适合轻量重复任务,Sol 适合日常主力工作,Astra 用于最难的端到端任务。推理级别决定模型思考投入:Light/Low 适合简单明确任务,Medium 适合普通复杂任务,High 和 Extra High/Max 适合复杂调试与研究,Ultra 用于并行处理可拆分任务。作者建议从最低档起步,根据遗漏和返工情况逐步升级或降档,并强调档位不能替代清晰目标和验收标准。
文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。