Wiki 知识库

全部文档 / 标签: LLM

1041 篇
清除

WTF Is Jev? 9 Things People Are Already Building With It

Jev 是由 ChatGPT 联合创造者、RLHF 联合发明人 Diogo Almeida 在隐身两年后推出的决策型 AI 模型。它不做对话生成,而是为软件提供快速决策:选择题、评分、是/否判断,号称比前沿 LLM 快约 200 倍、便宜 400 倍,响应仅需几十毫秒。文章盘点了社区基于 Jev 构建的 9 个实际应用,包括 7 秒找机票的浏览器代理、上下文即时压缩工具、编码代理安全审查器、模型路由中间件等。其命名源自 19 世纪经济学家 Jevons,暗喻资源越便宜消耗越多的悖论。
技术 › LLM Matt Van Horn 2026-09-1827.1 KB 308.2K 1.3K 86

新决策模型 Jev 深度剖析

文章深度剖析了 TypeSafe 发布的新决策模型 Jev。与 LLM 不同,Jev 不生成文本,而是输出程序可读的决策 JSON,剥离语言能力,专注做软件中的小判断(分类、布尔判断、打分)。开发者通过传入 state 和 questions 进行调用,模型基于 RLCD 训练方法实现概率校准。相比 LLM,Jev 在演示中快 75 倍、便宜 171 倍,且因输出受类型约束可减少幻觉,但仍可能选错。文章介绍了客服、发票、安全告警等场景评测及 Doom 游戏演示,并建议从工单分类等边界清晰的任务开始试用,逐步开放自动处理。
技术 › LLM Skyhigh Feng 2026-09-187.8 KB 11.8K 51 80

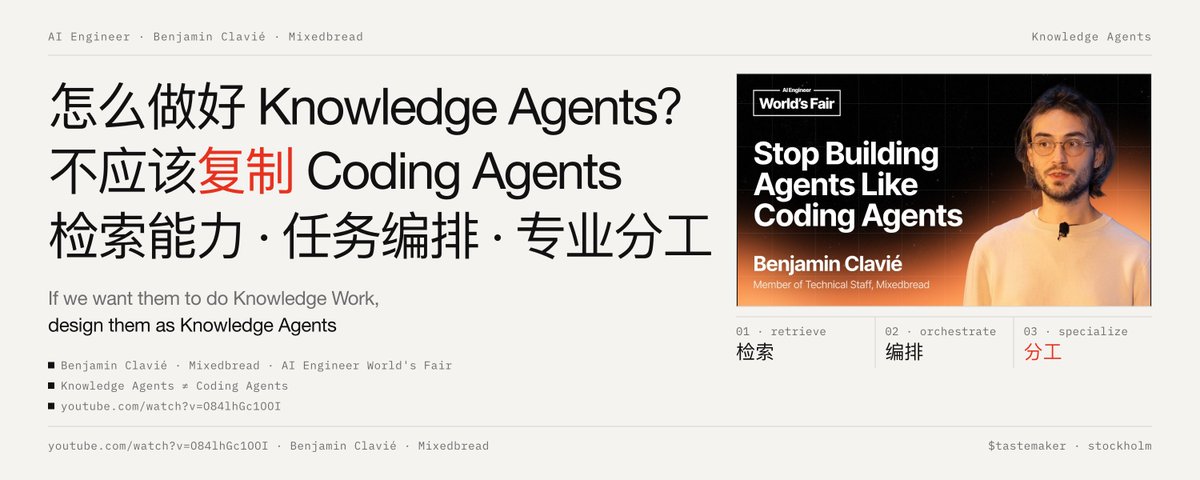
怎么做好 Knowledge Agents?不应该复制 Coding Agents,做好检索能力、任务编排与专业分工

本文介绍 Ben Clavié 在 AI Engineer World's Fair 的演讲,主张知识型 Agent 不应照搬 Coding Agent 范式。核心观点:编程智能体的成功源于代码环境的结构化红利;而法律、医疗、投研等知识任务的难点在于正确定位、理解和验证证据。要构建可用的知识 Agent,需具备面向任务的高质量检索工具(含图表、扫描件等多模态内容),以及主智能体负责任务分解、子智能体承担专业分工的编排架构。文章还给出企业级建设的优先级建议:定义可验证任务、建设证据层、按需拆分智能体、多维度评估并保留人工审核。

技术 › Agent meng shao 2026-09-186.2 KB 14.5K 63 77

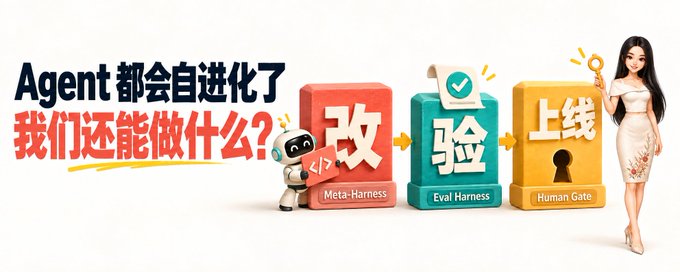
Agent 都会自进化了,我们还能做什么?

文章探讨了 Agent 自动改进系统(Meta-Harness)的构建方法。核心问题是如何让 Agent 自动进步又无法伪造进步。作者提出将三种权力拆开:Agent 负责提出修改,评测系统负责拿证据,上线门禁决定是否升级。文章通过一个补货建议 Demo,演示了从失败记录到修改验证的完整闭环,包括锁定 Agent 不可修改的文件(密封考题、评分器、上线标准)、生成结构化故障单、构建逐层收窄的评测漏斗等实践。同时分析了 Agent 容易刷分的三种捷径:讨好评分器、记住考题、自己宣布通过,并指出 Meta-Harness 只在基础 Eval 成熟、人工改进成为瓶颈时才值得搭建。

技术 › Agent Cloris 2026-09-1817.5 KB 85.7K 127 84

Awesome Jev:Jev 低延迟判断模型项目合集

作者分享了自己获批使用 TypeSafe AI 推出的 Jev 模型后的体验,并整理了一份 Awesome Jev 项目清单。Jev 是一个不生成文本、只返回选项、分数和概率的低延迟判断模型,可并行输出结果。文中介绍了 14 个基于 Jev 的项目,包括高速浏览器 Agent、MCP 集成工具、命令行语义判断工具、模型路由器、上下文垃圾回收、代码审查前置筛选、语义寻路、知识图谱、桌面自动化、交易流动性分析以及 FPS 游戏等应用场景。核心思路是:用 Jev 反复做'要不要、选哪个、打几分、下一步干什么'的判断,复杂推理和生成任务仍交给传统大模型,从而降低成本、提升速度。

技术 › Agent 思维怪怪 (@0xLogicrw) 2026-09-184.5 KB 80

一篇讲透|GPT 为什么变笨、账号为什么被封|史上最全的降智说明(附自查清单)

文章系统梳理了 ChatGPT 和 Claude 的降智与封号机制。降智方面,OpenAI 会通过换成小模型、缩短思考时间、转给安全模型三种方式降级请求,原因是算力配给、对可疑账号降级而非封号、以及路由器本身的错误。作者认为 IP 只是第一道门槛,账号健康度(登录出口、档位、账号权重、环境一致性、渠道)才是风控打分的核心。封号方面,OpenAI 查的是账号用途而非网络来源,Claude 则因政策更严、检测信号(IP 关联、支付方式、时间同步、代理访问)明确而封号更狠。文章引用了大量官方文档、员工发言和社区案例作为佐证。

技术 › OpenAI 言溪 Yanxi 2026-09-1837.6 KB 42.2K 102 84

Building a Harness with Jev

本文介绍 TypeSafe AI 发布的新模型 Jev,一种名为 System One 的非传统 LLM 模型。Jev 不生成文本,而是通过 RLCD 强化学习训练,对给定状态快速返回结构化决策(Choice、Score、Noul 三种问题类型)及概率,推理速度最高快 200 倍、成本低至 1/400。文章展示了如何通过 LangChain 的 TypeSafeClassifier 集成 Jev,并给出两大应用场景:模型路由(根据任务复杂度自动选择低成本或高性能模型)和 Auto Mode(对危险工具调用进行分类守护,提升 Agent 可信度)。Jev 适合作为 LLM 的补充,在 Agent 循环中承担快速、低成本的分类决策。

技术 › Agent Sydney Runkle 2026-09-1811.3 KB 2M 5.6K 84

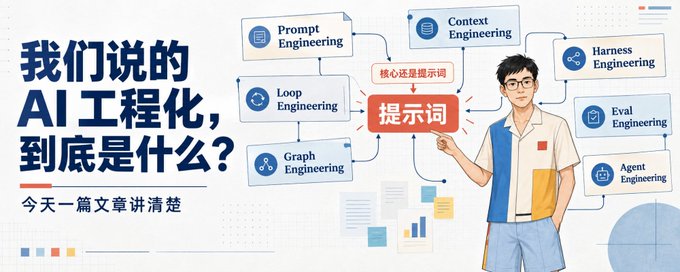
我们说的 AI 工程化,到底是什么?今天一篇文章讲清楚

文章系统梳理了 AI 工程化领域的各种新概念(Context、Harness、Loop、Eval、Graph Engineering),指出这些 Engineering 拆到最后,核心仍然是提示词。作者认为,现代提示词已不只是聊天框里的几句话,还包括系统规则、任务资料、工具说明、历史结果、失败反馈和完成标准。Agent 的难点在于把事情真正做完:避免重复步骤、选错工具、提前结束等问题。文章分别阐述了五大 Engineering 的职责——Context 管每轮给模型看什么,Harness 管工具与环境的接入说明,Loop 管根据反馈迭代,Eval 管验证任务是否真完成,Graph 管流程节点与路由。最终结论:代码管边界(权限、轮次),提示词管边界内的判断。

技术 › Agent Miles Ma 2026-09-179.7 KB 124.3K 259 74

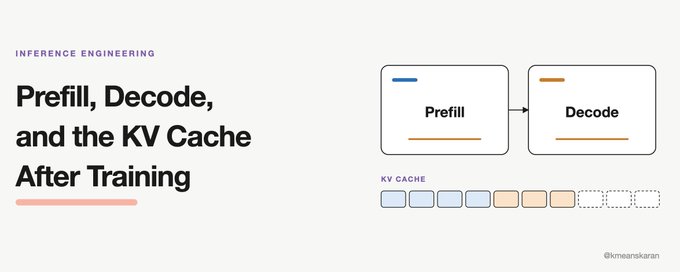
LLM Inference After Training: Prefill, Decode, KV Cache

本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

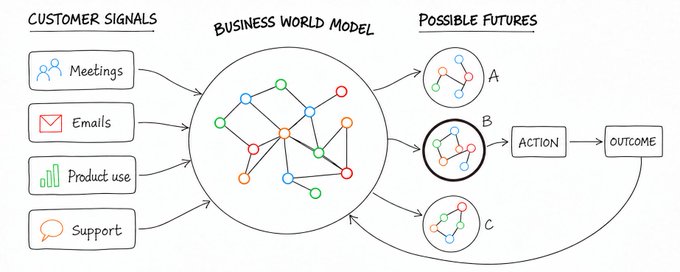
The best founders are world builders

文章提出最优秀的创始人是“世界构建者”:创业公司通过 fork 现实构建新世界,并吸引用户进入。作者回顾了 CRM 从 ACT!、Siebel 到 Salesforce 的发展史,指出传统 CRM 将丰富动态的客户关系压缩为静态表格,在代码和设计可被轻易复制的时代,真正的护城河在于对用户的深刻理解。随着 LLM 等前沿智能的出现,创始人应从头重建以客户上下文为核心的系统,让高能动性员工接触真实的世界模型,使全公司持续从用户身上学习,实现 founder-led sales 的规模化。

技术 › LLM YB 2026-09-1718.1 KB 30.1K 138 62

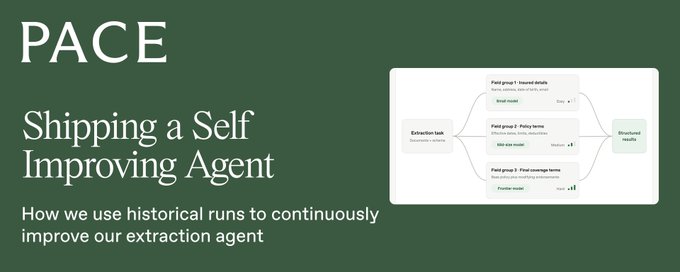
Shipping a Self-Improving Agent

文章介绍 Pace 公司如何在其保险文档提取 Agent 中实现自我改进。系统通过三个核心机制优化:1) 子代理委派——基于历史运行构建字段关系图,优化 fanout 分组,减少重复工作,降低 19% 成本和 16% 延迟;2) 模型路由——利用历史 trace 学习各子代理任务难度,将子任务路由到合适模型,部分场景成本降低 68% 且无精度损失;3) 上下文优化——通过 Review Agent 诊断错误根因、Proposer Agent 提出经验证的上下文或 Harness 修复,使每流程提取错误减少 75%。核心论点是随任务积累,系统可持续逼近最优的委派、模型与上下文组合。

技术 › Agent Arun J Moorthy 2026-09-169.0 KB 11.2K 156 77

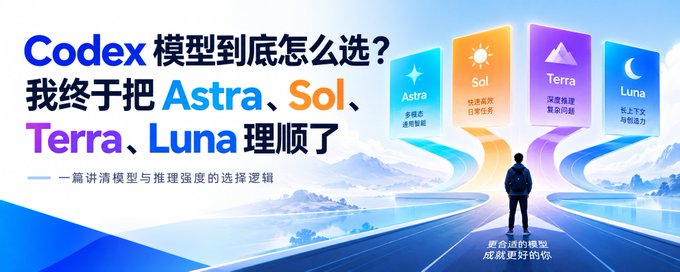
Codex 模型到底怎么选?我终于把 Astra、Sol、Terra、Luna 理顺了

文章梳理了 Codex 各模型的选型思路:先区分模型代际与两个层级——模型本身与推理强度。Astra 能力上限最高,适合复杂 Coding、长任务和 Agent;Sol 是旗舰主力;Terra 均衡;Luna 最快最省。推理强度(轻度到极高)决定模型思考的深度与用量消耗,效果提升并非线性,应按任务难度递增。作者给出实用建议:小改动用 Luna/Terra,常规功能用 Sol 中,复杂调试用 Sol 高,架构与疑难问题用 Astra,最重要任务用 Astra 极高/Ultra。核心是按任务复杂度分档使用,而非默认最强配置,以延长用量。

技术 › Codex 伟大 2026-09-163.5 KB 7.9K 33 78

How to Build a Grounded Document Agent

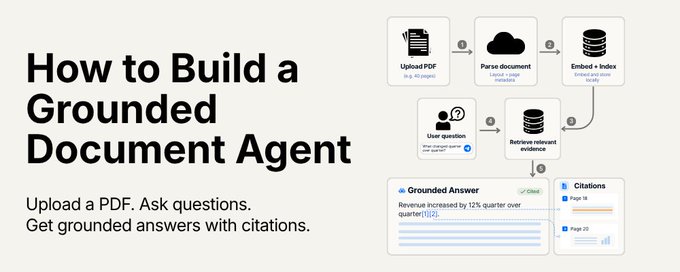
本文介绍如何构建一个带引用溯源的文档问答Agent(Grounded Document Agent)。核心问题是PDF解析质量决定答案上限:双栏排版、表格、图表等常被错误扁平化。项目使用LlamaParse在云端进行布局感知的Markdown解析并保留页码元数据,随后通过Ollama本地运行nomic-embed-text生成向量索引,配合CitationQueryEngine检索最相关的段落并生成带编号引用的答案。解析结果按文件哈希缓存以节省成本。界面展示页码、检索文本和相关度评分,让用户可检验引用背后的原始证据,区分解析、检索或生成阶段的错误。

技术 › Agent Sumanth 2026-09-169.8 KB 45.7K 218 76

AI 变现实战:3 天 49 单,一天搭完最小闭环【附 6 段指令】

作者分享用 AI 在小红书售卖娱乐心理测试数字商品的实战经验:3 天获得 49 单、收入约 200 元,证明了个人用 AI 一天内可搭完产品、流量、成交的完整闭环。文章详细拆解了 6 段可复用的 AI 指令,覆盖对标分析、产品规格设计、通用模板搭建、数据驱动选题、笔记素材批量生成和商品详情页撰写。同时总结了选品定价、爆款笔记机制、上架路径(开店 vs 个人售卖)以及合规风险等硬核避坑技巧,强调项目天花板低,但核心价值在于完整体验从想法到收钱的闭环。

技术 › 工具与效率 路飞 AI 研究员 2026-09-1612.8 KB 51.4K 285 90

Context Infrastructure: Architectural Lessons From the Data Lakehouse

文章提出上下文基础设施正出现一种新模式:尽可能保存原始历史数据(对话、工具调用、事件、Agent 工作记录),之后再按需构建摘要、知识图谱、嵌入等派生视图。这一架构借鉴了数据湖屋(Lakehouse)的经验,如 Databricks 的青铜/白银/黄金分层架构。作者对比了写入时即做压缩决策的内存系统(如 CrewAI),指出其风险在于丢失未来可能重要的信息;并介绍了 CortexDB、Statewave、Supermemory、Zep 等产品的实践:以不可变事件为事实来源,将记忆作为可重建的视图。文章最后提醒需防范上下文沼泽,建议写侧优化保存、读侧优化实用性。

技术 › Agent Josh Rosen 2026-09-1612.2 KB 17.1K 179 79

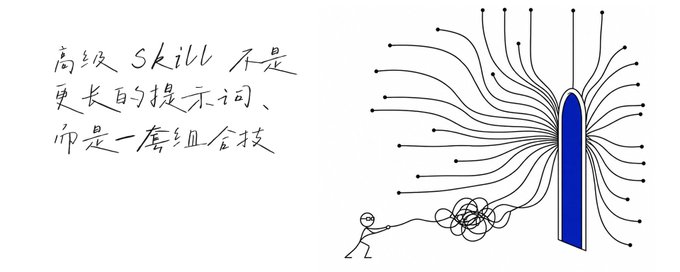
高级 Skill 不是更长的提示词,而是一套组合技

文章探讨了高级 AI Skill 的本质:不是把更多指令塞进一份文件,而是把多个单点能力按任务关系编排组合。作者通过分析 GitHub 上多个热门 Skill 仓库,总结出五种组合模式:路由(判断调用哪个 Skill)、顺序(强制工作流程)、选择(按需分诊组合)、流水线(专业能力交接)和分层(Skill 与系统能力分工)。文章提出组合 Skill 的五个核心零件:路由、输入输出契约、顺序与并行、上下文状态、验证反馈,并建议从真实返工中逐步长出组合关系。核心观点:Prompt 让 AI 听懂一次需求,Skill 固化一类做法,而组合 Skill 才能把复杂任务交付出来。

技术 › Skill Wattter 2026-09-1612.7 KB 3.8K 31 82

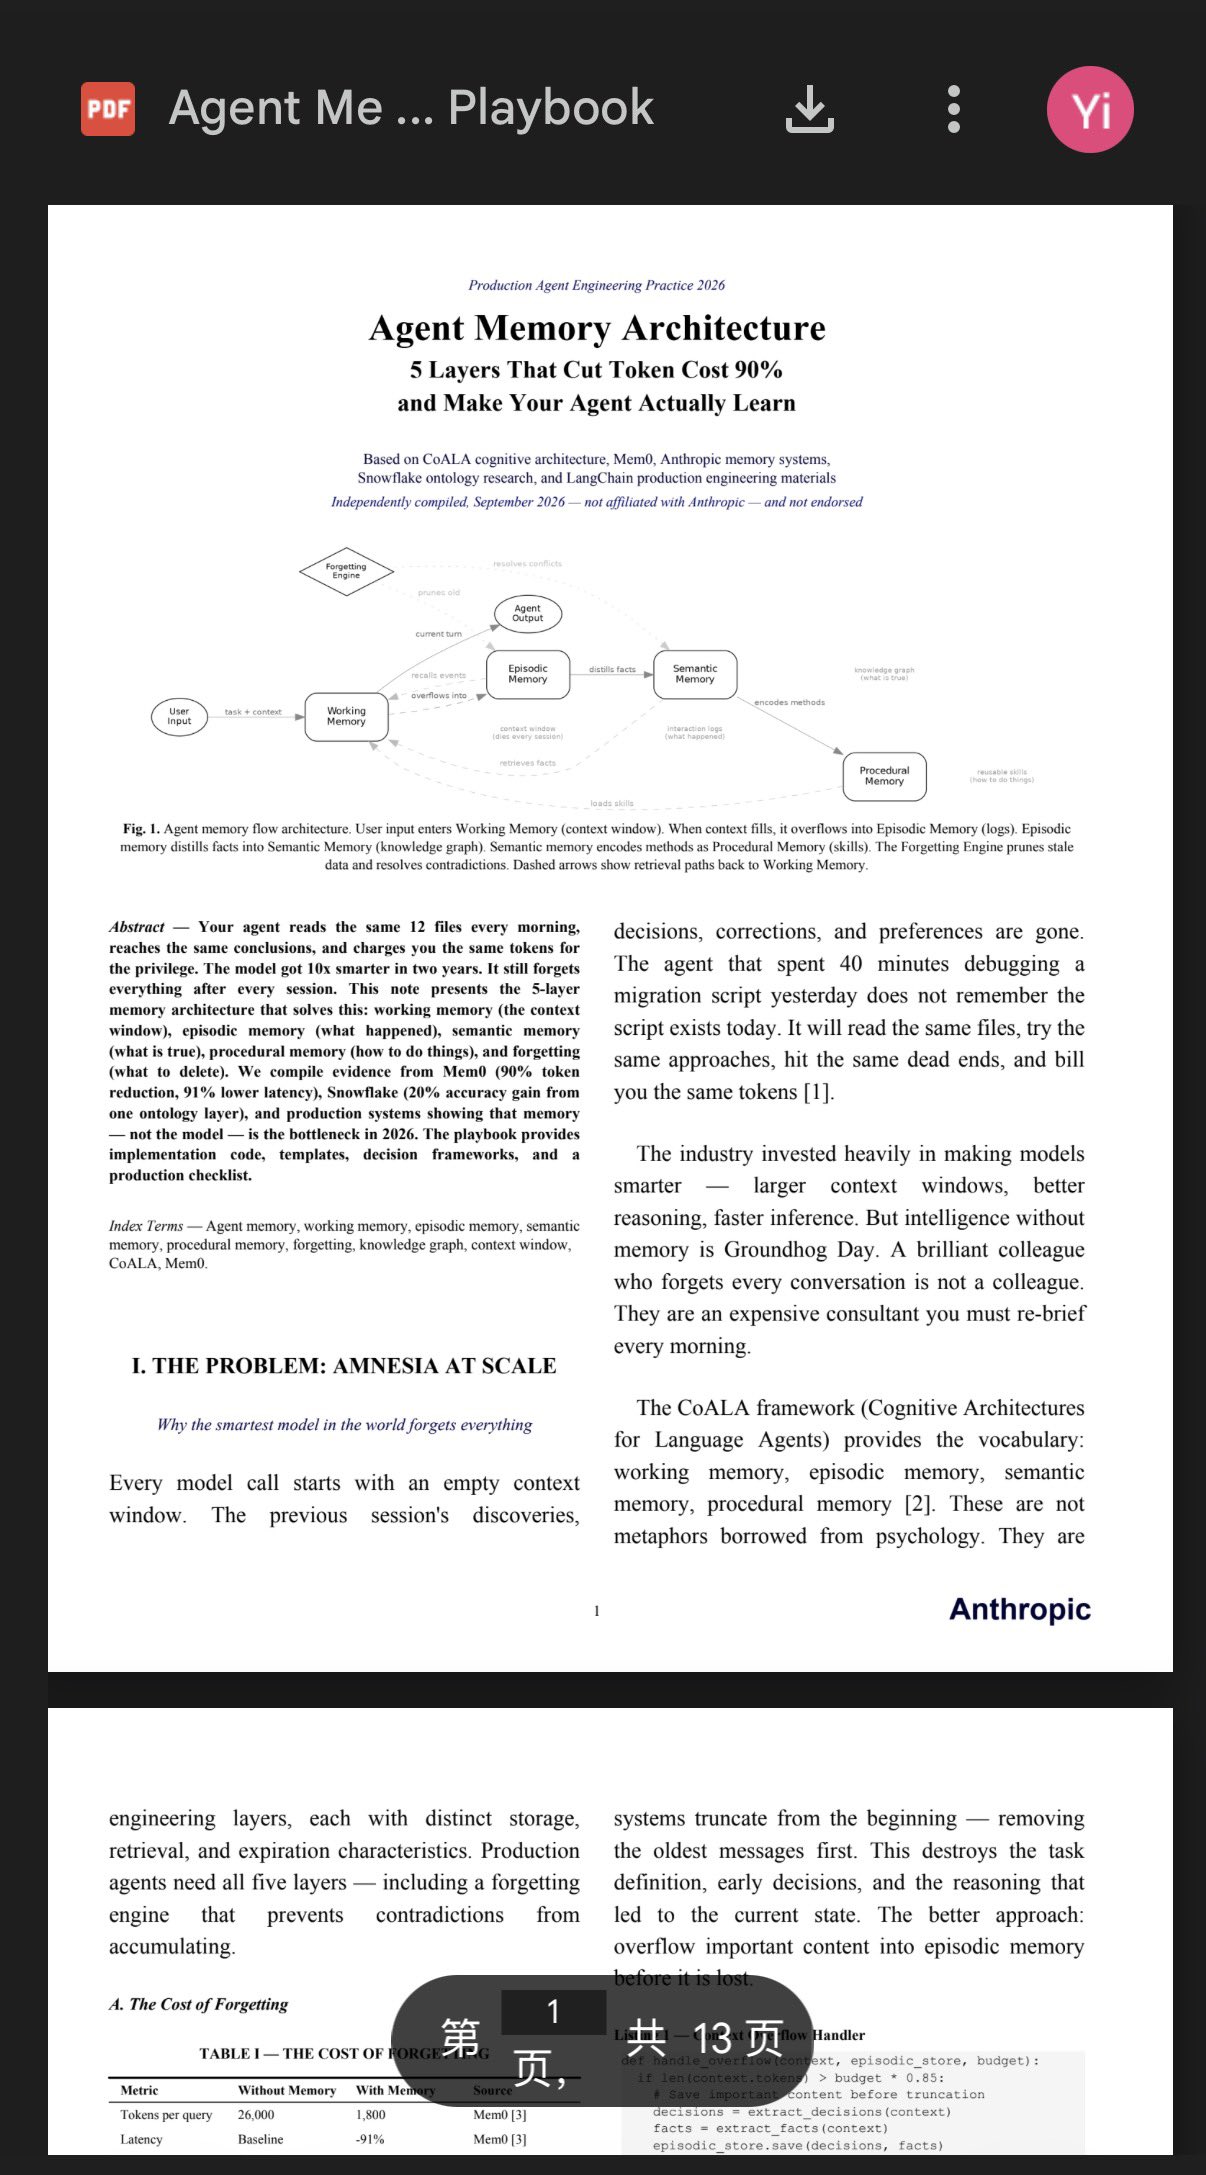
Anthropic 13页 Agent 记忆白皮书解读:5层记忆金字塔

文章推荐了一份13页的Agent记忆工程白皮书(民间整理,非Anthropic官方出品),将其拆解为5层记忆金字塔:工作记忆(上下文窗口)、情景记忆(交互日志)、语义记忆(知识图谱)、程序记忆(技能固化)和遗忘引擎(矛盾消解)。文章指出缺乏记忆分层的Agent会不断重复踩坑、成本高企,而引入该架构后Mem0的Token消耗降低90%、延迟降低91%,Snowflake准确率提升20%。核心观点是:不要迷信更大的上下文窗口,应把记忆做成可检索、可进化、可修剪的工程资产。

技术 › Agent AYi (@AYi_AInotes) 2026-09-163.8 KB 67

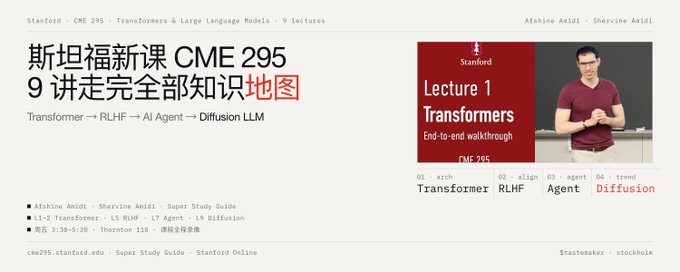
斯坦福新课 CME 295:9 讲走完 Transformer → RLHF → AI Agent → Diffusion LLM 全部知识地图

斯坦福大学 NLP 团队开设的 LLM 全景课程 CME 295,由知名速查表作者 Amidi 兄弟主讲,用 9 次讲座系统覆盖 LLM 全知识地图。课程分四大板块:基础(NLP 演进、Transformer 架构、MoE、注意力变体)、训练(预训练、SFT、LoRA、RLHF/DPO、PPO/GRPO/RLVR)、系统与工程(分布式训练、KV 缓存、投机解码、AI Agent 与 MCP 协议)、评估与前沿(LLM-as-a-judge、Diffusion LLM、多模态)。课程特点包括知识密度高、零作业两次考试、前沿覆盖度好,并配有公开的 Study Guide 和 15 语言速查表,适合已懂基础 ML、想系统理解 LLM 原理与最新趋势的学习者。

技术 › LLM meng shao 2026-09-164.7 KB 46.8K 233 73

做了一个可能有最多数据支撑的去 AI 味 skill

作者基于283万字语料(329篇人类文章+5个主流AI模型生成的300篇文章),用语言学对照实验和统计方法量化“AI 味”,制作并开源了一个去 AI 味 skill。实验发现11项显著特征集中在篇章结构层面,如段首零回指评论(4.4倍)、拟人化比喻(7.3倍)、空转冒号(9.4倍)等;而流行认知中的设问句、句长均匀度等特征实测并不显著。研究还发现不同模型写作偏好差异巨大,不存在统一的“AI 文风”。作者认为去 AI 味本质是预训练层面应解决的问题。

技术 › Skill 躺在废墟里 Lieflat 2026-09-1512.2 KB 86

Prefill and Decode:理解 LLM 推理的两个阶段

文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。

技术 › LLM Dongxi 东锡 NLP 2026-09-1511.3 KB 24.8K 89 74

我把几十万字资料喂给AI后,总结出这套高效知识提炼工作流(附完整Prompt)

作者图南分享处理40万字行业调研资料的AI提炼方法论。指出直接让AI总结长文本会导致废话输出,原因包括'迷失在中间'的注意力规律、提问过于宽泛等。他提出'四步漏斗提炼法':认知骨架扫描、逆向审讯抽脂、红蓝对抗挑刺、知识资产封装,并附上4套实测可用的即插即用Prompt,强调用户需自己掌控提问节奏,用结构化认知建立AI时代的护城河。

技术 › LLM 图南 2026-09-1510.3 KB 2.7K 2 84

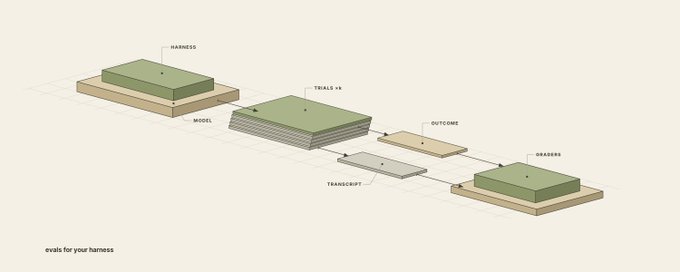
start ugly, write evals anyway:Agent 评估入门指南

文章探讨了 Agent 评估(evals)的重要性与实践方法。作者将 Agent 定义为模型加 Harness 的组合,区分了模型评估与 Harness 评估,并对比了 SDLC 中的测试与 ADLC 中的评估差异。文章澄清了评估的核心概念(task、trial、outcome、grader 等),指出评估的冷启动门槛比想象中低,从真实失败案例中提取 20-50 个任务即可起步。作者强调应只构建任务完成率和正确性两个基础指标,主张评估结果而非路径,并建议纳入负向用例、部分得分机制,坚持阅读轨迹记录,关注分心、token 消耗、延迟、上下文膨胀和一致性等信号。

技术 › Agent hrushikesh 2026-09-1510.4 KB 109.7K 1.2K 82

一篇速通入门:重新理解 AI Agent 的一切

本文从 LLM 基础原理出发,循序渐进讲解 AI Agent 的底层机制。作者首先解释大模型如何通过 Token 预测生成文本,说明无状态、幻觉和知识截止等现象的根源;接着阐述多轮对话依赖上下文拼接实现的原理;进而介绍工具调用如何让模型影响外部世界,以及模型结合工具反馈形成闭环后 Agent 的诞生。文章提出 Agent = Model + Harness 的工程视角,剖析 Harness 在上下文管理、记忆系统、上下文压缩等方面的职责,帮助读者建立对 AI 能力边界的底层认知,摆脱对新工具的 FOMO 焦虑。

技术 › Agent 川处安 2026-09-1537.0 KB 80.1K 504 77

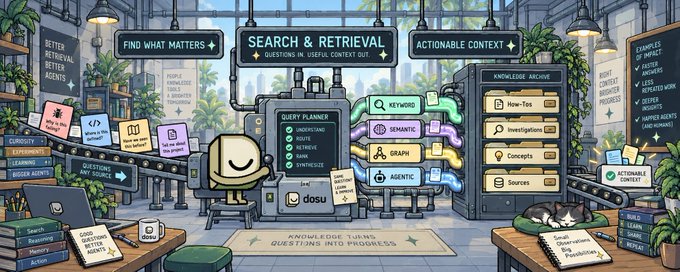
How to Build Agent Memory: Search & Retrieval

本文是构建 Agent 记忆系统系列的第四篇,聚焦读取路径:如何检索已保存的知识并加以利用。文章首先强调根据问题类型选择检索方式——精确查找、相似案例识别或项目概览各有不同需求。接着对比了四种搜索方法:关键词匹配、语义搜索、图遍历和 Agentic 检索,指出 Agentic 检索能综合运用其他方法并随信息获取调整调查策略。文章还强调检索结果应具备可操作性,一条包含复现步骤和验证方式的笔记远比泛泛的描述更有价值。最后提醒要注重精确度,避免给 Agent 返回过多无关信息造成干扰,因为它可能将小问题扩大成大改动。

技术 › Agent Devin Stein 2026-09-1512.0 KB 6.2K 105 82

Put Claude Fable 5.1 and Gemini 3.8 Flash on the same team

本文介绍如何在 Google Cloud 的 Gemini Enterprise Agent Platform 上同时配置 Anthropic Claude Fable 5.1 与 Google Gemini 3.8 Flash 两款模型,并通过任务路由优化 token 成本(tokenomics)。作者指出单一模型路由全部任务是错误的:深度规划模型处理日常事务会浪费成本,而快速模型处理不可逆的复杂任务风险很大。文章详细演示了启用 Claude Fable 5.1 所需的数据共享配置(setPublisherModelConfig API)、Gemini 3.8 Flash 的调用方式,并建议先对常规任务做基准测试,以快速模型作为一线协调者、深度规划模型按需升级处理,从而大幅提升任务 ROI。

技术 › LLM Alan Blount (Google Cloud Tech) 2026-09-1518.4 KB 161.7K 894 82

Open Memory, Own the Intelligence

本文探讨了AI Agent开发中开放Harness与记忆所有权的重要性。作者引用Harrison Chase的观点——'不拥有Harness就不拥有记忆',并区分了Memory(从上下文窗口记录的事实,如用户偏好、仓库知识)和Intelligence(利用这些事实让会话更智能的机制)。文章详细介绍了Mem0的方案:通过custom_instructions和infer=False控制记忆提取,用语义+BM25+实体搜索进行检索,并借助Dream实现记忆合并、替代与综合。作者主张将记忆层置于Harness之外,存储于SQL、向量数据库和实体存储中,从而实现跨Harness的记忆与智能的可移植性,即使前沿实验室的循环保持封闭。

技术 › Agent mem0 2026-09-1517.1 KB 16.1K 157 69

正式开源!比橙皮书skill更强10倍的Huashu-Report来了!

花叔开源了Huashu-Report,一个用于让Agent产出高质量报告的Claude Code Skill,比之前的橙皮书skill更强大。文章指出AI写报告的瓶颈不在文笔,而在编造数字、重复叙述、口径不一致。解决方案分三层:先建数据表锁定数字来源,编译器检查正文引用;将可机器判定的规则全部写成函数而非留在手册中;脚本自动检查排版后仍需人工逐页目检。Skill支持六种报告原型:咨询deck、研报、学术综述、论文、调查、科普,并通过对74份顶级机构AI报告的解剖学习最佳设计品味。项目采用MIT协议开源。

技术 › Skill 花叔 2026-09-1510.1 KB 49.8K 89 90

主体性均质化的时代,为什么大家的表达越来越相似?

文章提出'主体性均质化'概念,指不同个体在AI深度参与写作后,表达、品味、判断和构念逐渐趋同的现象。作者分析了AI润色如何抹平个人语气与思考,使创作者'不在场',导致内容产量激增但有效理解成本上升的'内容通货膨胀'。引用Doshi与Hauser的研究及西蒙的注意力经济学说明问题的深层影响。最后作者主张个人建构主义:静下心拉回注意力,不让AI替你思考和写作,在允许AI参与的同时保持个人构念的可渗透性,通过学习、模仿最终超越,坚持为情而造文的创作信条。

技术 › LLM Roland.W 2026-09-1411.9 KB 61.3K 80 66

智能体评测三要素:时长、价值与可信度 | 斯坦福 CS329A Part 8 深度解读

本文深度解读斯坦福 CS329A Self-Improving AI Agents 课程第八讲,通过三篇前沿论文系统讲解智能体评测:METR 用'50%时间视界'衡量模型可完成任务的时长(每约7个月翻倍,但80%可靠性下缩短4-6倍);OpenAI GDPval 用盲测胜率衡量经济价值(Claude Opus 4.1 达 47.6%,但趋势近似线性);DeepScholar-Bench 评测知识综合的可信度(最高分仅31%,检索与综合是双重瓶颈)。核心结论:能力≠价值≠质量,三者共同撞上'上下文之墙',评测需多指标并用并保持人类校验。

技术 › Agent meng shao 2026-09-1410.2 KB 11K 26 81

Ling-3.0-flash-Fin金融增强模型实测:从年报取数到可编辑底稿

作者实测蚂蚁百灵金融增强模型Ling-3.0-flash-Fin,用宁德时代2025年报和FinFIRST评测题检验其金融研究能力。模型能区分销量与装车量口径,精准提取11项核心指标并复算比率,生成三档情景和20行CSV底稿,但Web Search等外部工具未实际执行。作者认为该模型适合作为金融研究第一道工序,能分清披露、外部统计和计算值,但尚非无人值守的金融Agent。

技术 › LLM 阿川 | AI thinking 2026-09-148.6 KB 48.6K 219 78