AI写作的习惯及其应对方法
本文由 a16z crypto 发布,探讨 AI 生成写作的典型特征及编辑应对策略。作者认为不应纠结于文章是否由 AI 写成,而应关注写作是否有效传达信息、赢得信任。文章将 AI 写作问题归纳为修辞、声音、结构等方面,如'伪洞察式'空话、空洞对比、过度对仗、总结性套语等,指出这些问题在人类写作中早已存在。编辑建议包括改写测试、删除无意义语句、制定风格指南、利用 LLM 简化语言等,帮助创业者提升沟通效果。
本文由 a16z crypto 发布,探讨 AI 生成写作的典型特征及编辑应对策略。作者认为不应纠结于文章是否由 AI 写成,而应关注写作是否有效传达信息、赢得信任。文章将 AI 写作问题归纳为修辞、声音、结构等方面,如'伪洞察式'空话、空洞对比、过度对仗、总结性套语等,指出这些问题在人类写作中早已存在。编辑建议包括改写测试、删除无意义语句、制定风格指南、利用 LLM 简化语言等,帮助创业者提升沟通效果。
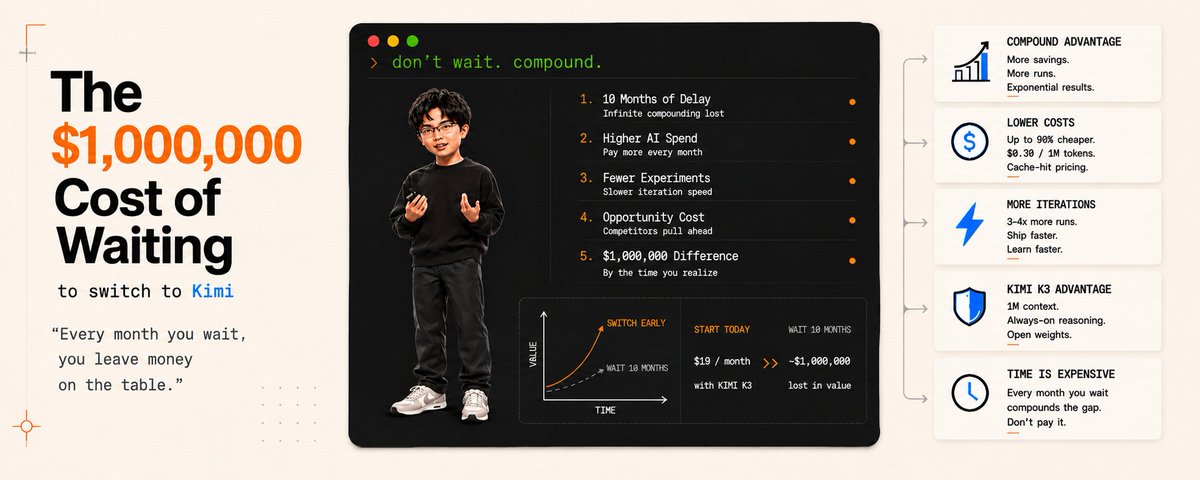
文章以复利投资为类比,论述延迟切换到更便宜的 AI 模型(如 Kimi)的隐性成本。通过 Emma 和 James 两位投资者的对比说明时间复利的威力,指出 AI 开发中省下的推理成本可转化为更多实验、更快学习,形成复利式优势。昂贵推理就像投资中的管理费,悄无声息地拖累长期发展。建议按任务匹配模型,尽早利用低成本推理加速产品迭代,因为错过的实验时间无法事后弥补。
作者基于在高盛商业智能部门的职业经验,总结出使用AI的五步框架VAULT:验证(Verify)输入与输出的正确性,数据质量决定AI质量;增强(Augment)而非替代,已知流程用确定性自动化,需要判断力的工作才用AI;理解(Understand)问题本质,先明确目标再选工具;人类介入(Loop)关键决策环节,监督程度应与行动后果匹配;保持系统透明(Transparent),便于审查和交接。文章强调AI不是万能药,用错数据只会更快地得出错误答案。
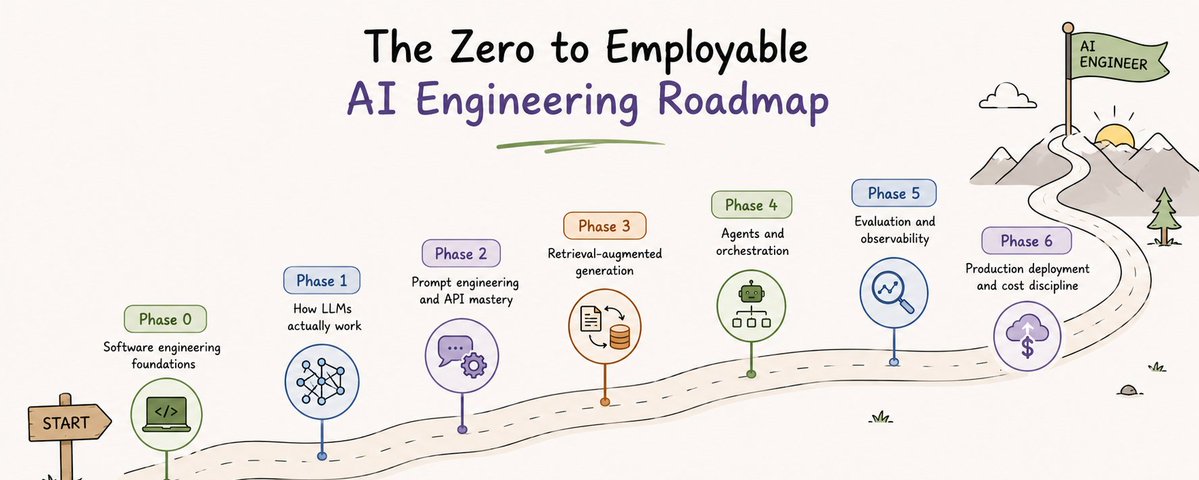
本文提供了一份从零到可就业的 AI 工程师分阶段学习路线图,区别于单纯的技能清单,每个阶段都附带经过验证的优质课程、文档和书籍。路线涵盖六个阶段:软件工程基础(Python、API、Git)、LLM 工作原理(Karpathy 课程、3Blue1Brown)、提示工程与 API 掌握、RAG 检索增强生成(最具就业价值的技能)、Agent 与编排(LangGraph、MCP)、以及评估与生产部署。作者建议用 8-12 个月完成学习,并强调构建真实项目组合和公开写作是获得雇佣的关键。
Hugging Face 正接触潜在买家,估值可能超 130 亿美元,比当年微软收购 GitHub 的 75 亿还高。文章分析其价值来自模型分发入口地位:平台模型、数据集超百万,Qwen、DeepSeek 等开源模型均以此为主阵地。公司年化收入已过 1 亿并盈利,出售并非自救,而是趁高位试探最优价格。核心难题在于中立性:任何大买家(Google、英伟达等股东)收购都会动摇其他厂商信任。作者回顾微软收购 GitHub 八年后的变化,提醒关注收购后模型迁移自由与推荐公平性。
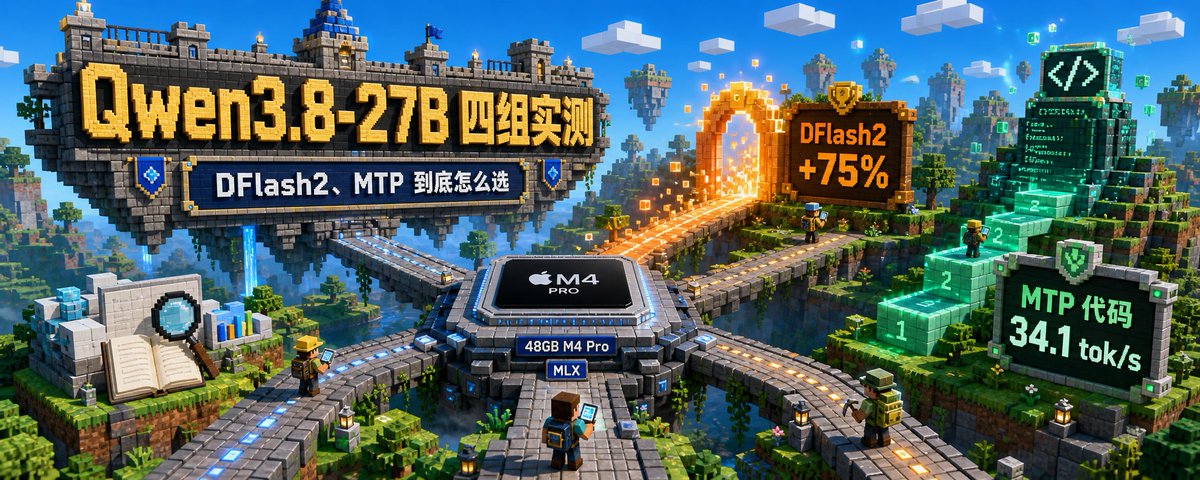
作者在 48GB M4 Pro MacBook 上对比了 Qwen3.8-27B 的四组运行配置:官方 4-bit、Uncensored 版、官方 4-bit + DFlash2 草稿模型,以及 oQ4e + MTP。结果显示 DFlash2 平均提速 75%(约 26.96 token/s),数学与 GSM8K 场景超过两倍;oQ4e + MTP 在长文与代码负载下分别达 24.9 和 34.1 token/s,代码吞吐最高但部署复杂、首 token 延迟明显。结论是日常优先官方 4-bit + DFlash2,代码和长输出用 MTP,Uncensored 仅限隔离环境研究使用。
作者在128GB统一内存小主机上本地部署开源MoE模型Ling-3.0-tiny(7.9B参数,激活1.3B),用llama.cpp Vulkan加载Q8_0量化版本。实测任务是将2360行、2小时17分的客户会议飞书妙记转写交给模型,进行需求提取、实施方案搭建和报价结构整理。结果显示:模型能在235秒内完成需求提取,方案模块划分与人工方案接近,但时间戳偶有不准需人工复核。经提示词调优后,碰撞长度上限次数从16次降至3次。作者认为它适合承担会议整理、需求归类等“脏活”,但范围、价格、承诺等决策仍需人负责,并推荐在真实业务场景中使用。
作者回顾了自己四个月学习 AI 的历程,从最初用蚂蚁百灵大模型 Ling-3.0-tiny 整理装修业务流程、拆解游戏开发任务、到设计四轮装修改稿测试验证模型规则意识,共经历三个阶段。最终在 M5、24GB 内存的 MacBook 上完成 Ling-3.0-Tiny INT4 本地部署,构建 Ollama/MLX 运行路径,并搭建基于 Obsidian 的只读检索层,让模型担任“本地项目情报员”。作者强调普通人学 AI 应先解决一件真实的小事。
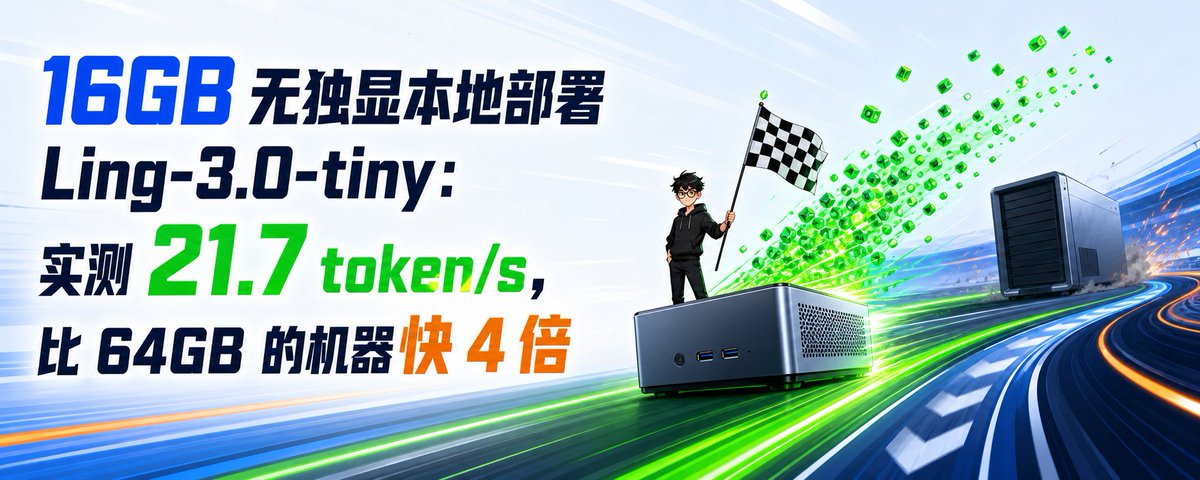
作者在一台单通道 16GB 内存、无独显的 Ryzen 5 5600G 台式机上,使用 llama.cpp 官方版部署 Ling-3.0-tiny(Q4KM 量化),实测生成速度 21.70 tok/s,比配置更强的 64GB+3090 机器快近 4 倍。经排查,差异源于推理引擎版本而非硬件。文章还分析了该模型线性注意力架构带来的超低上下文内存开销(约 6.79 KiB/token),总结了思考模式、Windows 编码、线程设置三个实践坑,并给出三步部署教程,证明普通电脑即可流畅本地运行该模型。
本文分析谷歌AI人才流失现象:Jeff Dean、Sanjay Ghemawat等核心人物离职创业,Noam Shazeer转投OpenAI,Demis Hassabis卸任DeepMind日常管理。作者认为,随着AI价值飙升,顶级研究员自身已足以成为公司起点,资本追着送钱,出走比留在大厂更自由值钱。同时,谷歌因组织庞大、多业务掣肘、产品化节奏与DeepMind研究愿景冲突,导致Gemini旗舰模型难产、竞争力落后于OpenAI和Anthropic。核心结论是:知道方向的人,手中未必握着方向盘。
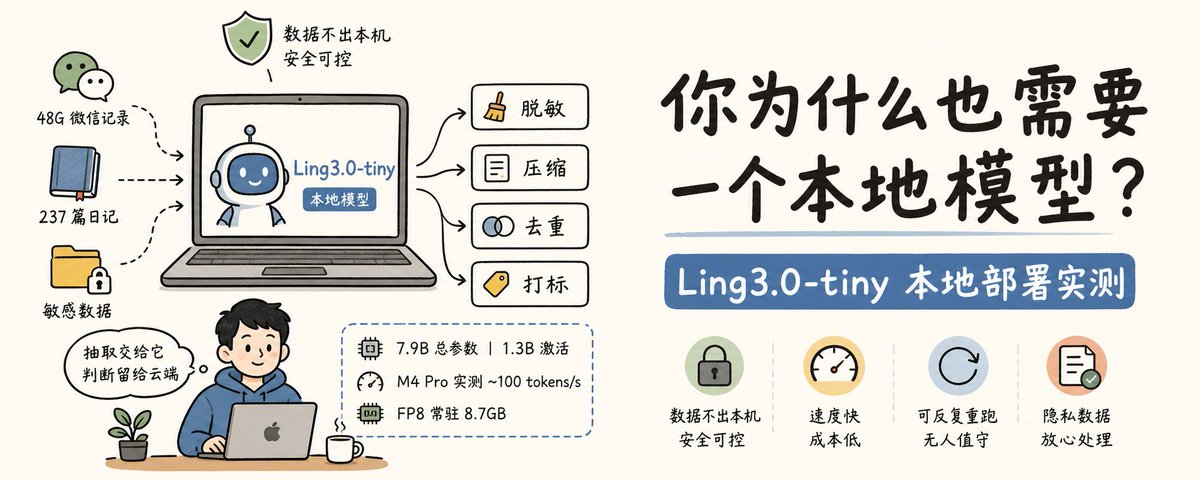
作者介绍了在 MacBook M4 Pro 上部署蚂蚁百灵开源的 Ling-3.0-tiny 稀疏 MoE 模型的完整过程,用于处理 48G 微信记录和 237 篇日记等隐私数据。文章详述了 FP8 权重选择、编译 MLX 后端 ollama、避坑指南等实操细节,实测生成速度约 78-99 tokens/s。在脱敏、命名实体识别、长文压缩、去重四个场景中表现优异,并总结分工原则:抽取任务交给本地模型,语义判断留给云端模型。
作者在 MacBook Pro M3 Max 上本地部署蚂蚁百灵开源的 Ling-3.0-tiny(总参数 7.9B、激活 1.3B),编译 Ollama 的 BailingMoeV3 分支导入 FP8 与 BF16 两个精度版本,实测输出速度分别约 106 和 81 tokens/s。随后通过 OpenAI 兼容协议将模型接入 DeepSeek Harness,让它把自己的底稿《文科生学 AI,先补一层计算机常识》重写成公众号文章。结果模型完整跑完任务、未瞎编内容,但句子偏碎且擅自添加内容,直出终稿尚早。文中还总结了部署与配置过程中的一系列坑及避坑指南。
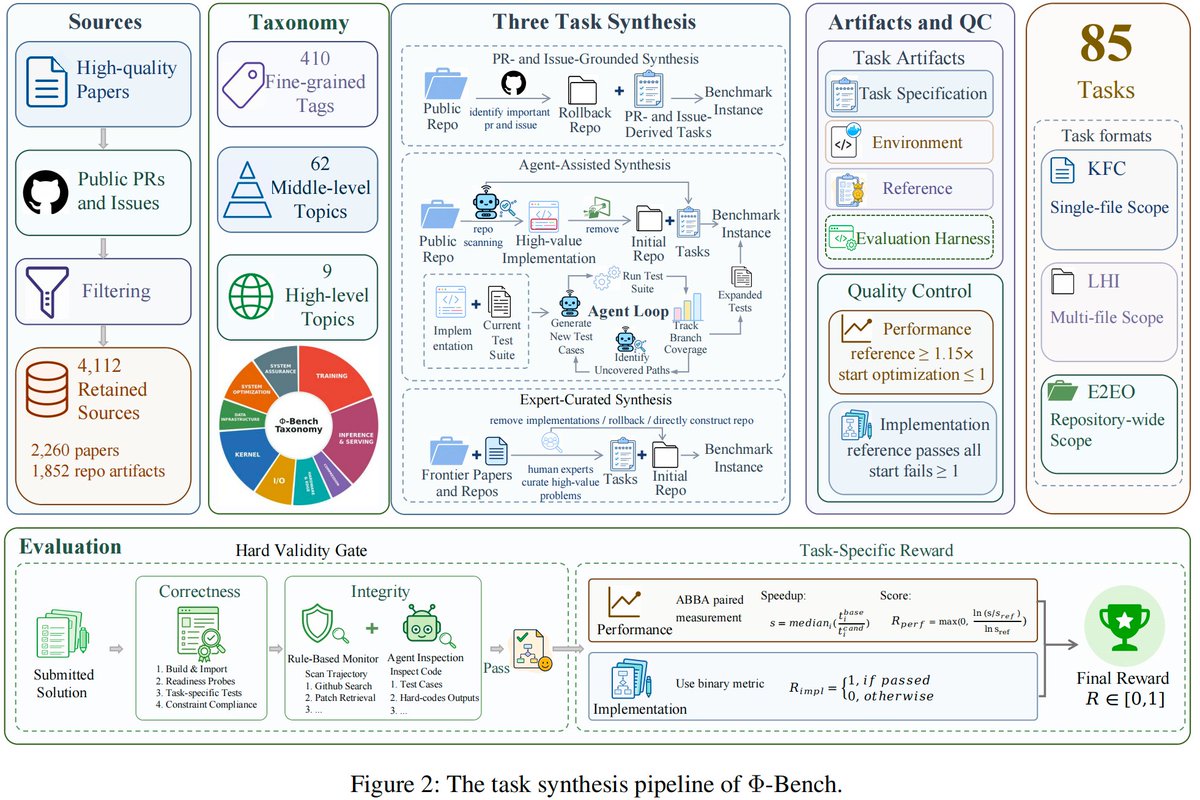
本文介绍 Φ-Bench(Frontier AI Infrastructure Benchmark),一个评估 LLM 基础设施工程能力的基准。它从顶会论文和开源仓库中筛选出 85 个真实高难度任务,分为 Kernel 补全(KFC)、长周期实现(LHI)和端到端优化(E2EO)三类。评测结果显示 Claude Opus 5 以 36.53 分领先,但所有模型在理解大型代码库和硬件相关优化上仍明显不足。分析指出优秀模型需具备假设验证、实验设计和可靠归因能力,Φ-Bench 探索了 AI 自我改进能力向基础设施层延伸的可能性。
文章从《经济学人》报道的一项针对26811名中国中学生的研究切入:使用生成式AI后作业成绩提升18%、用时缩短30%,但六个月后闭卷考试成绩下降约20%。作者结合自身经历——从不会写代码到借助AI开发出上架App Store的应用——提出“句号型AI”与“冒号型AI”的区分。AI既可以替人完成任务让思考终止,也可以成为进入陌生领域的门票,引发持续追问。作者认为能力外包与能力扩张可以同时发生,真正危险的是认知地图停止生长,关键在于我们如何使用AI。
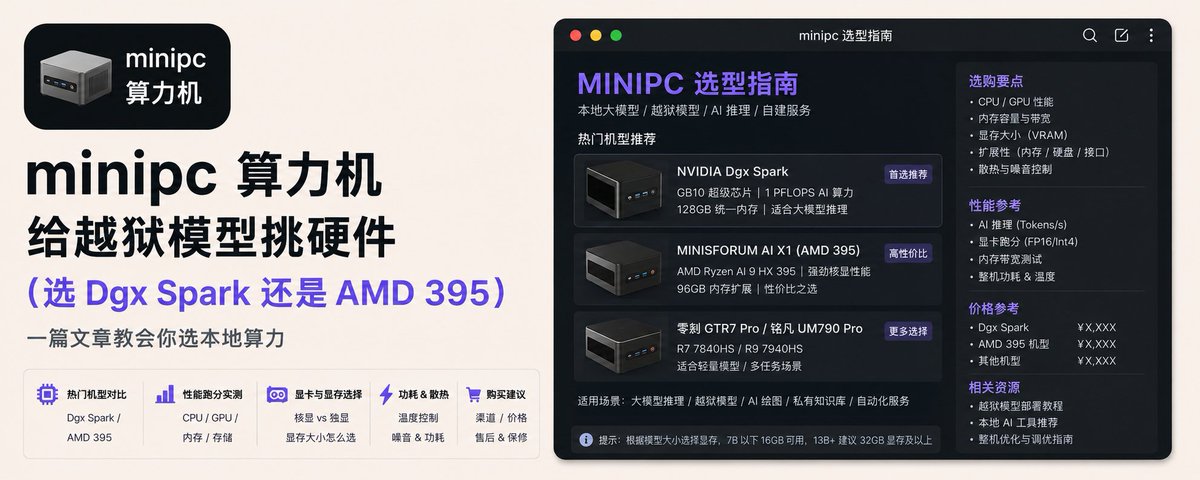
文章对比了两款桌面跑大模型的设备:英伟达 DGX Spark(国行3.5万)与搭载 AMD Ryzen AI Max+ 395 的小主机(近2万)。两者均采用统一内存架构、128GB 内存,可装下 70B 级模型。核心结论:出字速度受内存带宽限制,两台几乎一样;读题(预填充)速度 Spark 快五到六倍,资料越长优势越大。文章还分析了各自优缺点、CUDA 生态、双机集群跑 DeepSeek-V4 的玩法及真实翻车案例。
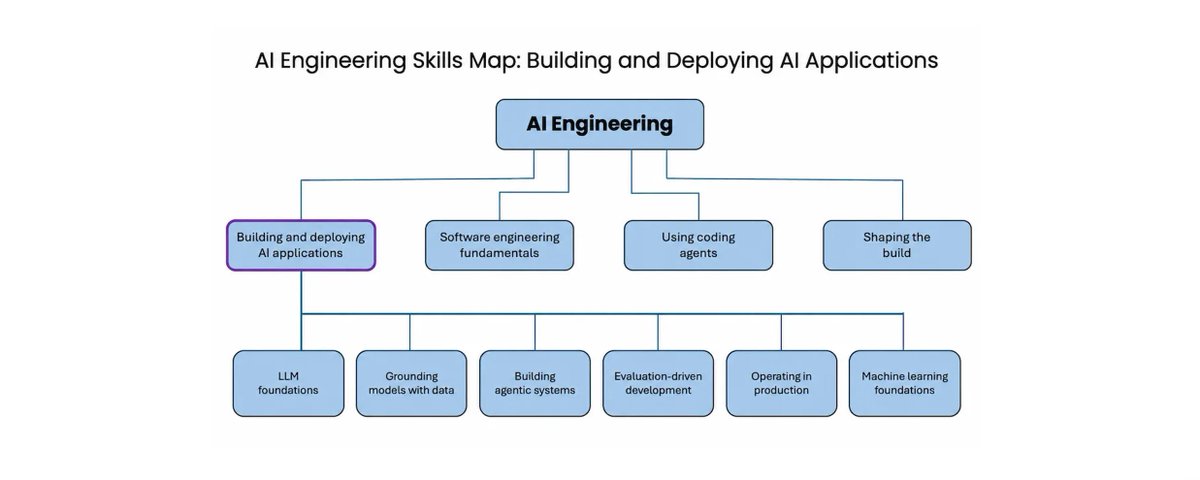
吴恩达详细阐述了 AI 工程技能图谱中的核心技能——构建与部署 AI 应用,包含六大方面:LLM 基础(分词、上下文窗口、工具调用等)、用数据为模型提供基础(RAG、向量索引、知识图谱)、构建 Agentic 系统(工作流、Agent harness、多智能体编排)、评估驱动开发(evals 与错误分析循环)、生产环境运营(可观测性、回归测试、成本与延迟优化)以及机器学习基础。该技能图谱基于大量招聘信息、专家访谈和调研形成,强调 AI 系统因输出不可预测而比传统软件开发更具迭代性。
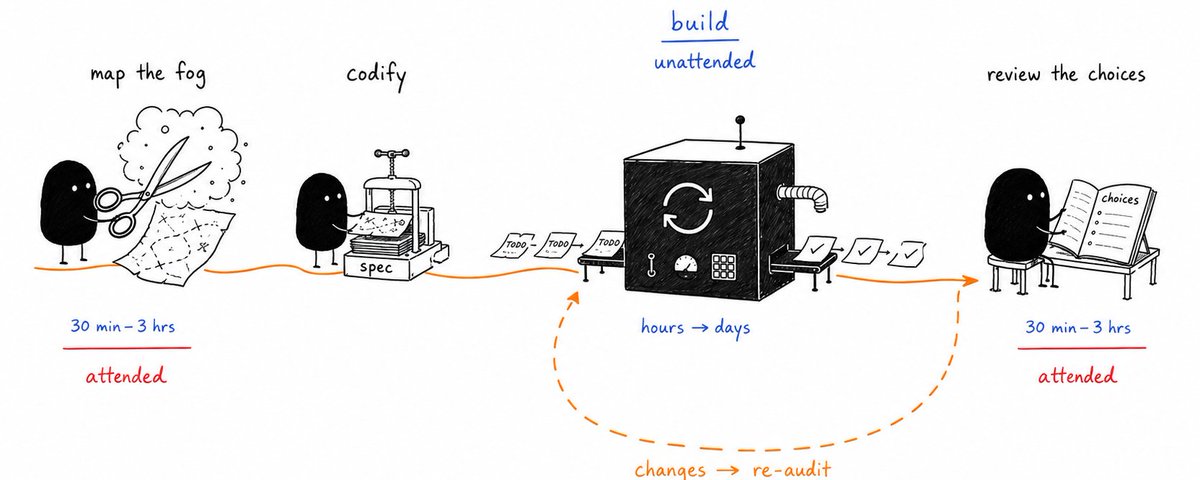
本期早报精选三篇内容:Anthropic 发布 AI 原生软件交付生命周期手册,将 Plan、Design、Build、Test、Deploy、Maintain 六阶段改造成以版本化工件驱动的可循环流程;DeepSeek 上线实验性视觉模型 V4-Flash-Vision 的 API,支持图文混合输入与 Files API 复用;Together AI 的 Hassan El Mghhari 分享 Hallmark Skill,将设计品味拆解为负面约束、视觉参考与偏好记忆。速览还包括 Uber 智能体 SDLC、DeepWiki 代码 Wiki、Blackwell 投机解码优化、淘宝 Skill 实践等。
本文介绍了在大规模AI应用中优化token成本的四大实用支柱:一是上下文缓存与Agent循环修剪,通过裁剪中间工具输出和总结历史步骤保持提示精简,利用缓存可获最高75%的输入折扣;二是实时与批量推理,将非紧急任务如工单汇总、报告生成等打包为异步批处理,可享50%折扣;三是设置思考预算,避免推理模型在简单任务上消耗数千隐藏思考token;四是模型合理选型与持续评估,90%的任务应使用最小最便宜的模型,并通过自动化评估及时更换高效模型,配合Apigee AI Gateway等企业网关实现智能路由与安全防护。
文章介绍了 AIPC(能在本机处理 AI 工作负载的个人电脑)的概念与工作原理,通过扫描件 OCR 的例子说明本地 AI 任务从输入到输出的完整链路及各环节的交接问题。对比了 AMD Ryzen AI Max+ 395 Mini PC 与 NVIDIA DGX Spark 两类设备的架构、内存与软件生态差异,并讨论了在没有 AIPC 时如何利用闲置电脑跑本地模型,以及噪声、散热和何时应购买独立 AIPC 的考量。作者认为随着本地大模型能力逼近闭源云端模型,专业人士应考虑部署一台可 24 小时运行的 AIPC。
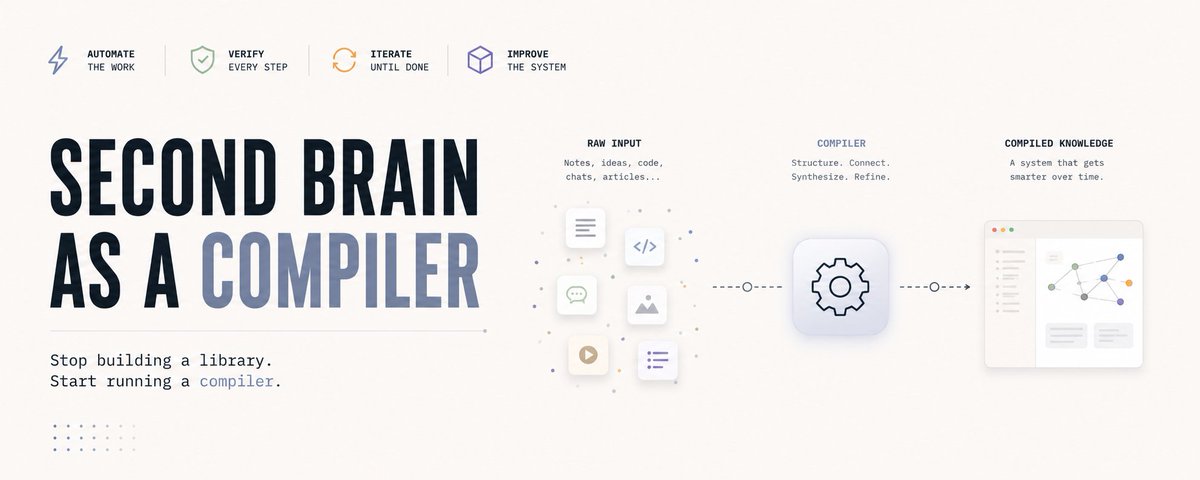
文章介绍了受 Karpathy LLM Wiki 启发的第二大脑新架构:不是把笔记当作检索用的档案柜,而是当作编译器。系统在摄入时一次性编译知识,自动链接、更新、标记矛盾,配合 CLAUDE.md 和每日编译循环,由 Claude 承担维护负担。作者分析了该方案相比 RAG 的架构优势、随时间复利增长的效果,以及源质量依赖、初期密度门槛、需付费版 Claude Desktop 等局限,并附上可直接使用的提示词。
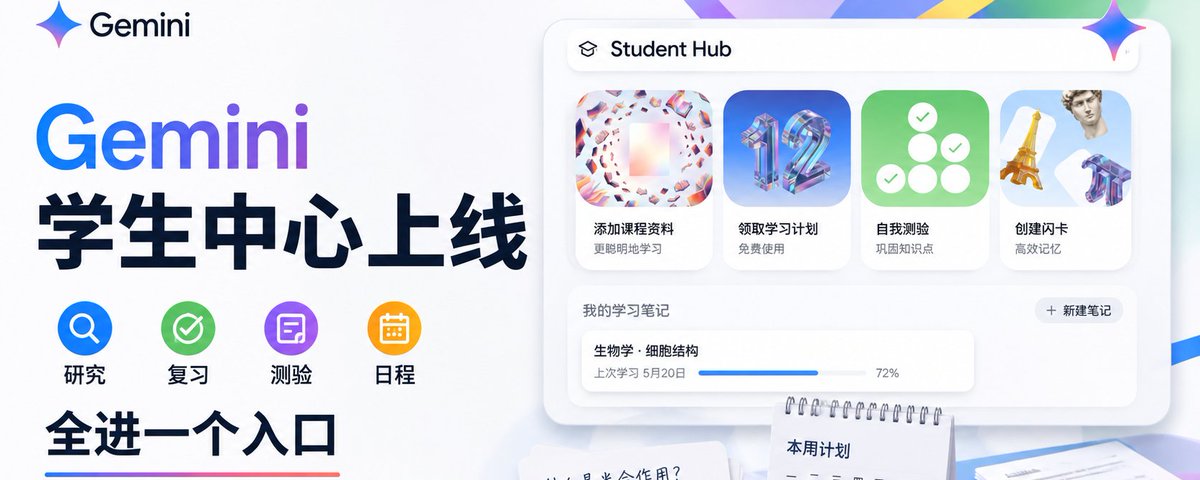
Google 于 2026 年 8 月正式推出 Gemini 全新 Student Hub(学生中心),将找资料、整理笔记、生成闪卡、个性化测验、学习表现追踪和考试日程管理整合为围绕课程的长期学习工作区。相比传统一次性问答模式,学生中心支持按课程上传大纲、课件和笔记,建立持续累积的学习系统,并通过 Deep Research 在后台执行长时研究任务。文章认为其核心价值在于把 AI 从答案生成器升级为学习管理器,特别适合期末、考研及备考人群,但也提醒用户仍需自行核对答案与关键事实。
本期早报聚焦三篇精讲:美团搜索3.0探索LLM语义表征在排序模型中的应用,通过联合建模、难负样本和覆盖率验证,将语义信号融入现有特征体系;硅谷101讨论Token经济,强调本地开源模型与云端前沿模型按任务分工,以优化成本与质量;YC Paper Club则从失败样本、弱监督、编码智能体和多语训练等案例,主张将数据集与评测Harness当作长期维护的产品。速览涵盖具身智能、微调模型技术债、Agent可观测性、OpenAI AI Futures、MiniMax Design、Docker安全运行时及Claude Code实战指南。
本文实测了智谱最新发布的GLM-5.3模型,该模型基于GLM-5.2的750B参数基础模型,仅通过后训练提升性能,在AA榜上以60分进入前十,成为同分段参数最小的模型。作者通过多个编码与安全案例测试,包括修复Ice菜单栏工具漏洞、开发2D跑酷游戏、3D愤怒的小鸟及音乐工作台等,展示了GLM-5.3在复杂编码、长程Agent任务和防御性网络安全方面的出色表现,并对比了DeepSeek、Grok等模型,认为后训练Scaling是提升模型能力的重要路径。
本文探讨了AI生成代码带来的代码审查瓶颈和'AI垃圾'问题。作者认为,随着AI编码能力增强,人类审查速度成为瓶颈,导致代码质量下降。他提出解决方案:将代码库视为黑盒,通过定义清晰的接口、不变量、追踪和决策记录等'工件'来确保系统可检查性,而无需阅读实现代码。作者强调软件工程的核心是解决问题而非编写代码,未来工程师的职责是设计人与AI协作的系统。
本文探讨了创始人如何构建既充分利用前沿模型优势(AI-Native)又不被其颠覆(AI-Proof)的企业。作者以医疗健康行业为例,指出随着通用模型进步,单纯依靠智能和自动化难以维持竞争优势,价值正转向“智能+自动化+问责制”。文章提出三种具备问责制属性的产品形态:提供临床服务、承担财务风险、开发FDA监管产品,并分别分析了其AI原生和AI免疫的方面。最后指出,最强AI原生企业正积极承担更多问责,以增强抗颠覆能力。
本文深入分析了日本在Physical AI竞赛中的现状与挑战。尽管日本拥有全球最深厚的机器人产业基础,但在将生成式AI应用于机器人方面已落后于美国和中国。文章指出,日本正通过启动FRONTia等国产基座模型项目、推动数据AI-Ready化、与英伟达合作等方式奋起直追。作者认为,日本的真正优势在于完整的机器身体、高价值现场数据、对安全可靠性的执着以及老龄化带来的真实需求,但同时也面临数据孤岛、系统集成能力不足、零缺陷文化与概率模型冲突等风险。最终,日本最有可能在工业Physical AI底座上胜出,而非人形机器人单品。
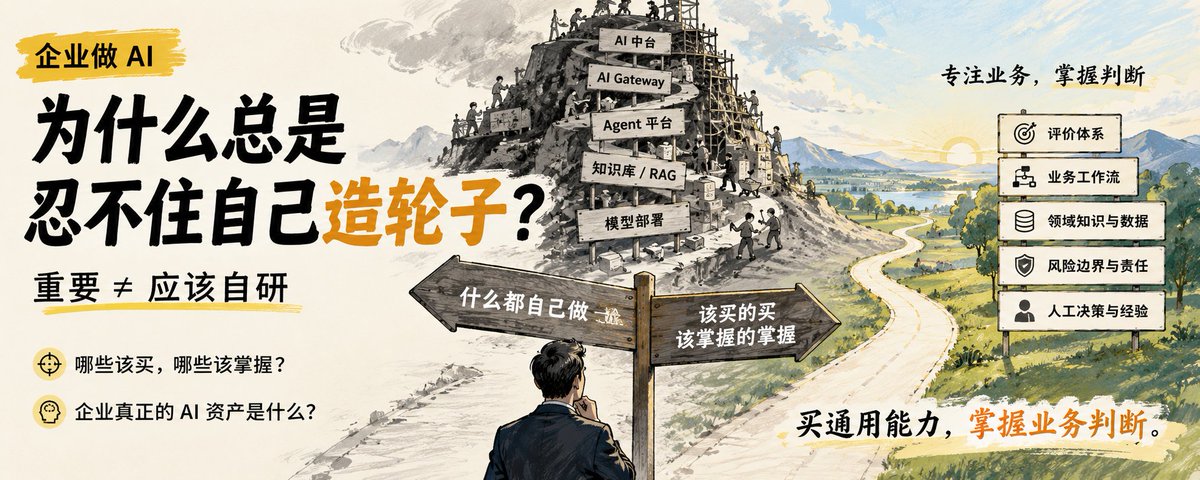
本文探讨了企业在AI建设中常见的自研倾向,指出“重要”不等于“应该自研”。作者通过沃德利地图分析,认为模型、算力等基础能力已趋于商品化,企业应聚焦于业务理解、评价体系等高度定制化的核心能力。文章强调,企业真正的AI资产在于对“什么叫正确”的定义,而非某个具体技术组件。
本文分析了特斯拉在中国选择豆包作为车机语音助手的原因。特斯拉将豆包用于响应车主语音指令,DeepSeek用于陪聊,两者均托管在火山引擎。作者从下载量、价格、使用场景和交付能力四方面剖析:豆包下载量高、价格合理、擅长高频日常对话,且火山引擎提供一站式交付,使特斯拉能快速落地。此外,外国厂商在中国需本地AI伙伴,特斯拉此举是顺应趋势。
本文深入探讨了构建高效 Agent Harness 框架时,理解底层模型推理基础设施(Model Infra)的重要性。作者指出,许多 Harness 将模型 API 视为黑盒,导致在应用层的优化可能破坏 KV 缓存、增加成本并降低解析可靠性。文章详细分析了缓存机制(GPU/CPU/SSD)、影响缓存命中的因素(如动态 system prompt、工具 schema 变化)、本地执行耗时对缓存窗口的消耗,以及解析一致性问题。最后,作者提出了稳定前缀、异步工具执行、不可变历史等实践原则,并建议通过监控缓存命中率、一致性等指标来评估 Harness 质量。
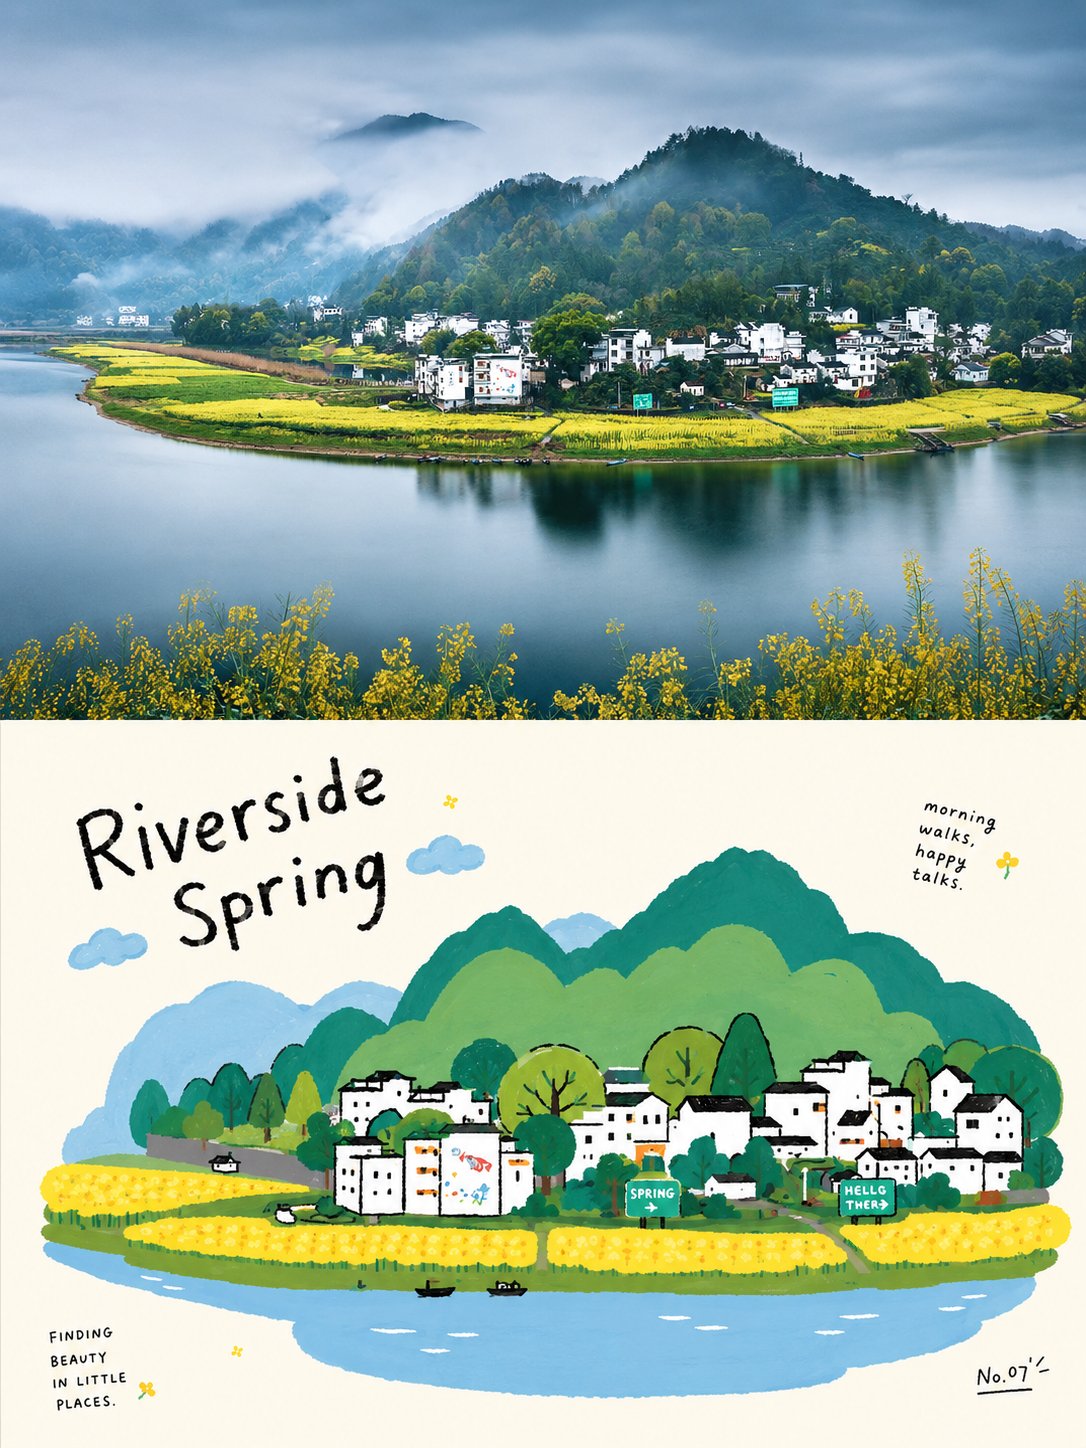
本文分享了作者使用GPT2生成的一组美学提示词,主题为“童趣插画”。作者将照片转化为上半部分真实摄影、下半部分稚拙扁平插画的海报设计,并详细描述了提示词的构造逻辑,包括构图、配色、文字排版等。作者强调通过耐心与AI沟通,逐步打磨出理想效果,并附上了完整提示词及示例图片。