Wiki 知识库

全部文档 / 标签: 本地部署

111 篇
清除

一个人十天写出的引擎,让 12GB 显卡跑起 1250 亿参数模型

个人开发者用十天时间(代码大部分由 AI 编写)打造了推理引擎 Strata,能让 12GB 显存的普通电脑运行 1250 亿参数的 Qwen 3.8 Flash Next 模型。文章剖析其六倍速度宣传实为不同量化版本对比,同版本实际是两到四倍;真正亮点是 prompt 读取速度达每秒 1500 token。核心技术是围绕 MoE 架构的专家缓存,命中率约 72%,代价是输出可能偏离原模型结果。文章还对比了买内存自建与云端 API 的成本账,并预判通用引擎 llama.cpp 将在几个月内补齐缓存能力。

技术 › LLM Saito 2026-10-218.8 KB 1.5K 4 84

本地配音:开源 VoiceStudio 把订阅制按在地上

文章介绍了开源项目 VoiceStudio(作者 debpalash),一个纯 Python、AGPL-3.0 协议的本地配音工具,定位为「开源、全程本地的 ElevenLabs 平替」。它支持声音克隆、声音设计、带时间轴对齐的视频配音、语音转写、有声书和批量任务,只需几十秒参考录音即可抽音色,官方支持六百多种语言。项目半年内获得约 6.7 万 Star,桌面端基于 Electron,数据全部留在本地不上传云端,兼容 NVIDIA CUDA 和苹果 Metal,并提供 Local API 和 MCP 供 Claude Code、Codex 等 Agent 调用。文章同时提醒性能受硬件限制、授权需分别确认,以及克隆声音必须取得对方授权。
技术 › TTS 北衡 2026-10-204.2 KB 2.3K 18 82

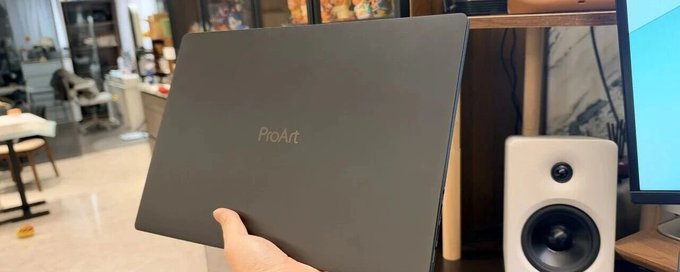
这台卖37999的RTX Spark电脑,让我实现了Token自由

作者分享了使用英伟达RTX Spark笔记本(华硕ProArt创16,128G统一内存+1T,售价37999元)一周的深度体验。该设备结合了大内存与CUDA生态,解决了本地跑大模型要么选Mac要么受显卡显存限制的痛点。作者演示了通过WorkBuddy部署各类本地模型,包括Qwen3.8-27B大语言模型、图像生成、视频生成、OCR、ASR、TTS等,并打包成一个专家应用方便开箱即用。文章还讨论了AI全天候工作带来的成本问题,认为本地算力是实现Token自由、摆脱API费用束缚的关键方案。

技术 › LLM 数字生命卡兹克 2026-10-1821.4 KB 55.4K 170 77

Cover Studio:AI封面图分层编辑工具开源

作者针对AI生成封面图后难以微调、反复抽卡的痛点,开源了Cover Studio工具,实现在一个页面内完成封面生成、拆层与编辑。核心基于蚂蚁百灵开源的两个6B模型:Ming-Image-0.1-Design负责生图,Ming-Image-0.1-Design-Layer负责将图片拆成多层(文字、主体、装饰、背景),支持图层拖动、缩放、隐藏和调序,避免重新生成破坏已满意的部分。工具内置Punk-Skill封面风格和波妞小红书封面锚点系统,支持多种比例,也可上传现成图片直接拆层编辑。文章还介绍了使用注意事项和本地部署方法。

技术 › 工具与效率 Lonely 2026-10-1713.6 KB 100.1K 203 79

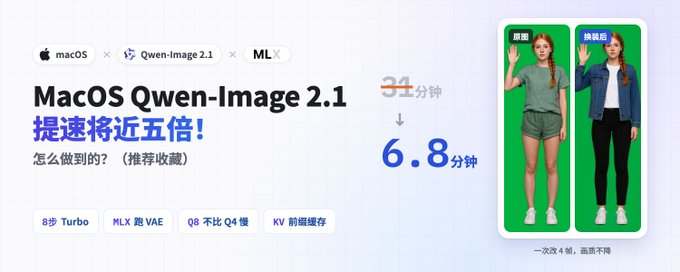
MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)

作者分享了在 M2 Pro Mac 上将 Qwen-Image 2.1 改图时间从 30 分钟压到 6.8 分钟(提速4.5倍)的完整方法论。首先通过耗时拆解定位瓶颈,然后叠加四个优化点:换用 Turbo 模型将去噪从20步降至8步;将 VAE 编解码切换到苹果 MLX 框架,从315秒降到15秒;实测发现 Q8 与 Q4 量化在扩散模型上速度相同,因此选用画质更好的 Q8;利用块因果结构实现前缀 KV 缓存,使每步采样时间减半。作者还用该流水线完成了一段10秒视频的逐帧换装,并通过肤色基准校正、锚点补偿和时序平滑三层方案解决了误差累积问题。

技术 › 工具与效率 WquGuru 2026-10-1311.0 KB 16.6K 87 88

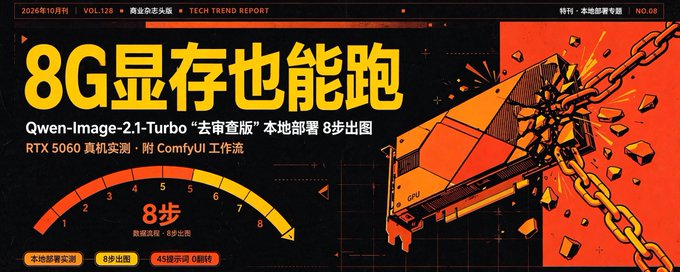
8G显存也能跑:Qwen-Image-2.1-Turbo 去审查版本地部署 8 步出图(附 ComfyUI 工作流)

文章介绍了 HuggingFace 上 AtomicChat 发布的 Qwen-Image-2.1-Turbo GGUF 量化版及去审查文本编码器。作者澄清该编码器仅移除拒绝倾向,对画图内容几乎无影响,其真正价值在于提供低显存无损量化方案。文章详细记录在 RTX 5060(8G 显存)真机上使用 ComfyUI 部署的完整流程:4 个模型文件的下载与存放、11 节点工作流配置,以及 5 个实测踩坑与解法(工作流 JSON 参数顺序、去噪器/编码器混淆、GGUF 架构识别错误、mmproj 缺失、latent 连接问题)。实测首次出图约 2 分钟,之后每次约 1 分钟,并附 4 组提示词与量化选型表。

技术 › 工具与效率 启明破晓 2026-10-1217.4 KB 45.4K 293 92

用自己的声音做配音,5款TTS实测后我会怎么选

作者用24秒自己的录音实测了Qwen3、VoxCPM2、Index 2.5、Index 2.0和小米MiMo五款TTS工具的语音克隆效果。每款读取相同两篇文案,从音色相似度、语气控制、生成耗时等维度对比。结果显示VoxCPM2和Index 2.0效果最好,是本地方案的首选;Qwen3可用但调节空间有限;小米MiMo通过API云端生成,适合不想本地部署的用户。文章还详细介绍了各工具的界面功能和在RTX 4070 Ti SUPER上的实际等待时间。

技术 › TTS 风渡fengdu 2026-10-118.2 KB 24.6K 278 82

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍了如何借助Strata框架和Agent自动化流程,在12GB消费级显卡上部署125B参数的MoE模型Qwen3.8-Flash-Next。文章解释了MoE稀疏激活(每token仅激活6B)与Strata让GPU、CPU、RAM、SSD协同工作的原理,对比了不同量化方案(UD-IQ4_XS与UD-Q4_K_XL)在专家缓存命中率上的速度差异。作者全程使用蚂蚁的Ling-3.1-flash Agent完成从读文档、检查硬件、安装、排错到测速验收的部署流程,并成功将本地模型接入pi。该方法可复用于部署Ling、GLM、Kimi、DeepSeek等其他本地模型。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 159.4K 454 79

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 79

值得关注的 AI 博主推荐清单

本文是一份Twitter/X上值得关注的AI领域博主合集,共收录上百位博主,按定位分类介绍,包括开发者视角(深耕AI编程与开发工具、Codex、Claude实战)、Agent与自动化专家、工具教程博主、AI思考者、AI投资观察者、本地部署极客、AI搞钱实战派、自媒体运营老手等类型。每位博主附有账号、内容方向和发文数量,涵盖AI编程、Agent工作流、Prompt工程、本地模型部署、AI副业变现、行业资讯等多个方向,为读者按需关注提供参考。

技术 › LLM Hytidel聊商业 (@HytidelLegend) 2026-10-0751.9 KB 47

放进收藏夹里吃灰!X 必看 AI 文章:19 个分类,1286 篇文章,314 位博主

作者对 X(推特)中文区发过 AI 相关内容的博主及其长文进行系统分类整理,统计截至 2026 年 9 月 22 日,共整理出 19 个分类、1286 篇文章、314 位博主。分类涵盖 AI 基础科普、认知思维、技术原理、安全伦理、Prompt 工程、编程开发工具、Agent 与自动化工作流、本地部署、工具教程、效率办公、视觉影视、自媒体运营、SEO/GEO、跨境出海、教育知识付费、创业产品、副业搞钱、投资产业链以及行业资讯等,每类均列出代表性必看文章链接,是一份全面的 AI 中文内容资源索引。

技术 › LLM Hytidel聊商业 2026-10-0624.6 KB 42.2K 682 70

How to set up your first Local LLM in 10 Steps (Full-course)

这是一篇本地部署 LLM 的完整入门教程。文章首先说明开源模型(Qwen、DeepSeek、GLM 等)已接近闭源前沿约四个月,而 API 订阅配额却在缩水,因此本地部署的价值日益凸显。教程从 Step 0 开始:检查内存、按内存三分之二规则选择模型、安装 Ollama 并运行第一个模型。随后解释了本地模型的核心优势(数据隐私、零边际成本、不受限)与局限(性能不及闭源前沿),分析了订阅补贴经济的不可持续性,并指导读者根据任务需求选择硬件,强调容量决定装得下、带宽决定跑得快、利用率决定是否划算。

技术 › LLM Movez 2026-10-0531.6 KB 258.1K 412 84

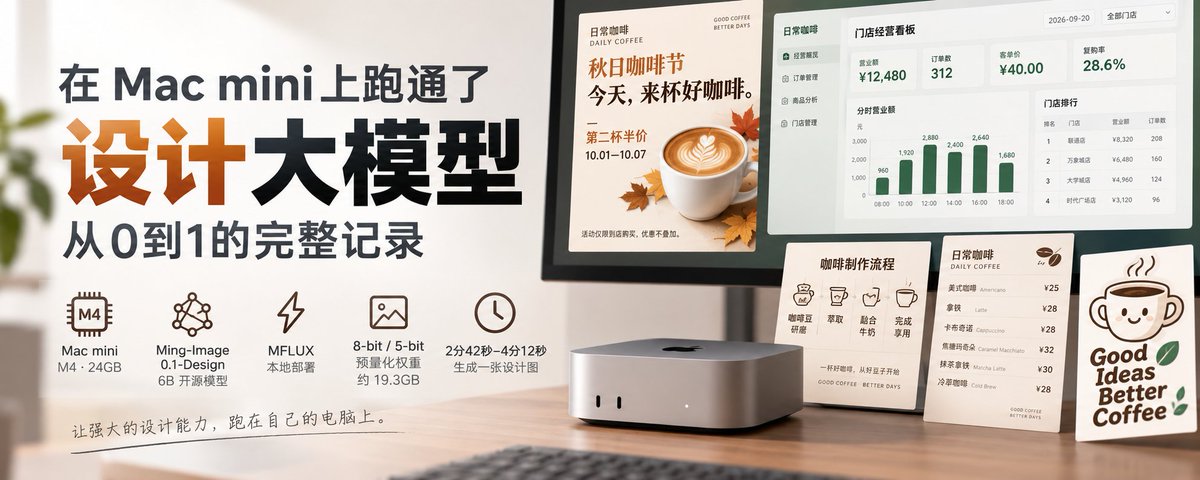
在 Mac mini 上跑通了设计大模型,从0到1的完整记录

作者在 24GB 统一内存的 M4 Mac mini 上,从零完成了蚂蚁百灵开源的 6B 设计模型 Ming-Image-0.1-Design 的本地部署与测试。使用 MFLUX 加社区预量化权重(图像模型 8-bit、文本编码器 5-bit,约 19.3GB),过程中踩了 MFLUX 0.20.0 缺少 Ming 命令入口的坑,改用 GitHub 源码安装后跑通。随后围绕咖啡主题测试了五项能力:海报设计、UI/Dashboard、信息图、文字渲染排版和透明背景素材,单张生成耗时约 2-4 分钟,MLX 峰值内存 15-18GB。结论是海报、菜单和信息图版面完整可用,但严格文字与数据细节仍需逐项检查。

技术 › LLM 苏打白.Dev 2026-10-0314.9 KB 5K 45 79

用 MiniMax H3 打造 AI 影片創作工作流:分鏡、動作與聲音一體化設計

作者分享了以 MiniMax H3 為核心的本地 AI 影片製作工作流,強調人物不僅要長得對,還要具備空間、道具與互動邏輯。流程包括:確立參考素材、撰寫結構化分鏡 Prompt(含 subject_definitions、retention_analysis、detailed_description 等模組)、加入 T8 ActionLogic 語義橋強化動作因果理解,並依題材搭配加速、寫實、格鬥、電影質感等 LoRA。生成後經放大銳化第二階段精修,遵循「寫分鏡→生成→檢查→修改→重拍」的創作循環。文末附完整模型、語義橋與 LoRA 資源清單。

技术 › 短剧 Tom𝕎 2026-09-2910.4 KB 23.5K 281 83

Qwen-Image 2.1 本地部署实战:从此生图自由

本文详细介绍了 Qwen-Image 2.1 图像生成模型的三种本地部署路线:ComfyUI、Unsloth Desktop 和官方 Diffusers。作者首先解释了不同后端权重的差异,指出 DiT、文字编码器和 VAE 三件套需分别下载且不能混用。文章给出了 Windows RTX 5080 与 MacBook Pro M2 Max 两套平台的实测数据:5080 上 1MP 文生图约13秒,M2 Max 单张约10分钟。同时涵盖模型目录结构、extra_model_paths 配置、图像编辑模板用法、常见问题排查及 Qwen Research License 商用限制提醒,是一份可复现的完整部署教程。

技术 › 工具与效率 Fini.Yang 2026-09-279.9 KB 239.9K 599 88

开源项目 lanshu-create-ai-presenter-video:本地全自动 AI 数字人视频生成

作者分享了一个 GitHub 上两天获得两万多星的开源项目 lanshu-create-ai-presenter-video。该项目只需输入一段文案和一张人脸照片,即可在本地全自动完成 TTS 语音生成、口型对齐、字幕压制、竖屏封面生成及质检,直接输出 1080P 竖屏成片,口型匹配度高,几乎无需手动修改。全程本地运行,避免了网页版工具排队和按分钟收费的限制,适合批量短视频内容创作者使用。

Paseo -- 它成了我的主力开发工具

Paseo 是一个开源的本地 AI 编程 Agent 运行与多端编排监控平台,采用 Daemon-Client 架构,通过守护进程接管本机 30+ 种编程 Agent CLI(如 Claude Code、Codex、OpenCode 等)的子进程管理与协议适配,并提供桌面、Web、移动端等多客户端及端到端加密中继,实现跨设备远程监控与操作。其优势包括打破单一 Agent 绑定的统一工作台、口袋开发机式的移动端掌控、代码数据完全本地化隐私保护、基于 Git Worktrees 的多任务隔离,以及 MCP 服务、定时任务等编排自动化能力。同时提供 Docker 风格 CLI 与 TypeScript SDK 两种接入方式。

技术 › Agent 佐仔 2026-09-244.6 KB 20.5K 106 79

用开源实时 ASR 模型 Confucius4-R2T2 + Jev 平替英语流利说

作者介绍网易有道开源的实时流式 ASR 模型 Confucius4-R2T2 与 Jev 模型组合,可平替英语流利说的口语评测功能。R2T2 是真流式模型,以 160ms 间隔输出且具备 stable prefix 机制,保证已提交文本不被修改;Jev 则快速判断文本层面的漏读、多读和错读类型。两模型均为开源,可在 NVIDIA 显卡本地部署,适合在家朗读练习。作者也指出当前方案仅限文本层面纠错,读音纠错需接入音标识别模型,应对语序跳跃、替换词等复杂场景仍需更深入的声学模型支持。

技术 › LLM WquGuru (@wquguru) 2026-09-212.9 KB 75

Build your own Jev (100% local):用开源 LLM 构建本地决策引擎

文章介绍如何将开源 LLM 变成快速、本地的决策引擎,而无需重新训练。核心思想是:当应用已知所有可能的答案时,不必让模型生成文本或 JSON,而是通过 next-token scoring 一次性为每个候选答案返回分数和概率分布。作者讲解了固定答案打分与结构化输出的区别、LLM 第一个输出 token 的生成原理,并使用 SGLang 的 /v1/score 接口,结合 Qwen 和 DeepSeek 模型进行实测,与普通文本生成进行了基准对比。文中还提到概率的含义与校准问题。

技术 › LLM Avi Chawla 2026-09-2022.3 KB 1.1M 3.1K 76

一句话生成AI多智能体互动课堂

文章介绍了清华大学MAIC团队开源的多智能体互动课堂平台OpenMAIC(GitHub 36.7K Star)。用户只需输入学习主题或上传教材、论文、音视频等资料,系统即可自动规划课程结构,生成包含知识讲解、测验、互动模拟和项目任务的完整课程,并配有AI老师和AI同学。作者详细演示了使用WorkBuddy Agent在本地部署OpenMAIC的全过程,包括配置大模型API、安装OpenMAIC Skill、排查白屏问题和接入TTS/ASR语音模型,并说明了导出MP4所需的前置依赖。该项目适合个人自学、教师备课、企业培训和编程实验教学等场景。

技术 › Agent 马佳彬 2026-09-179.0 KB 1.6K 13 79

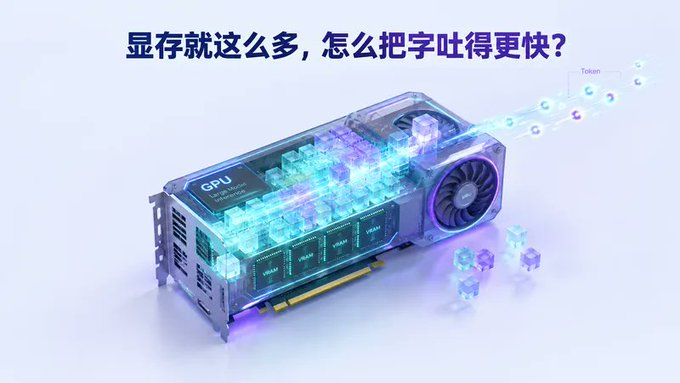
显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

1小时录音,3分半转完:本地离线语音转文字工具 whisper-tools

作者发布了一个免费、离线的本地语音转文字工具 whisper-tools,基于本地 Whisper 模型,通过网页拖拽音频即可转录,1小时录音约3分半出稿,全程不联网、不上传服务器、不收费。工具提供一键安装脚本,自动处理 ffmpeg 依赖和 GPU 加速,支持批量文件夹递归转录。针对中文场景做了优化:全角标点转换、删除汉字间空格、繁转简、智能分段、自动去除幻听。实测在 RTX 4070 上表现良好,适合会议记录、访谈整理、播客归档等隐私敏感场景。项目已在 GitHub 上以 MIT 协议开源。

技术 › 工具与效率 小海豚笔记 (gaoren7716) 2026-09-124.0 KB 3.5K 26 76

千问 Qwen3.8 本地部署:从跑起来到私人 AI 工作站,小白保姆级教程

本文是一篇面向新手的本地大模型部署教程,作者以 MacBook Pro(Ubuntu 24.04、AMD Ryzen AI MAX+ 395、128GB 统一内存)为例,详细讲解了如何用 Ollama 部署 Qwen3.8 27B 模型。文章先解释了本地 AI 的真正价值——隐私、控制权、可接入工作流,而非省钱;然后指导读者判断硬件是否够用、如何选择合适的模型版本和量化等级,并用五步完成部署验证。随后介绍通过 Open WebUI 搭建日常使用界面,以及如何接入个人资料构建知识库(RAG),应用于科研和内容创作场景,最终将 AI 从网页聊天框变成个人设备上的基础设施。

技术 › LLM Fred-New 2026-09-0936.8 KB 36.4K 38 90

把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用

作者拆解了 Playtime-AI 发布的 Sydney Sweeney 人物 LoRA(仅 155MB)如何在 MiniMax H3 视频模型上无需参考图、仅凭名字生成人物视频。文章讲解 LoRA 低秩自适应原理:冻结基础模型,只训练小矩阵 A、B 记录人物身份差量;还原训练过程(3440 步、120 epoch、rank 16、约 5% caption dropout);并分享本地加载实践,包括底模版本兼容、量化格式、采样步数(6 步而非 30 步才清晰)和触发词拼写等常见坑。最后指出 LoRA 技术正在改变人物身份的传播方式。

技术 › LLM Michael Guo 2026-09-0813.8 KB 32.5K 183 87

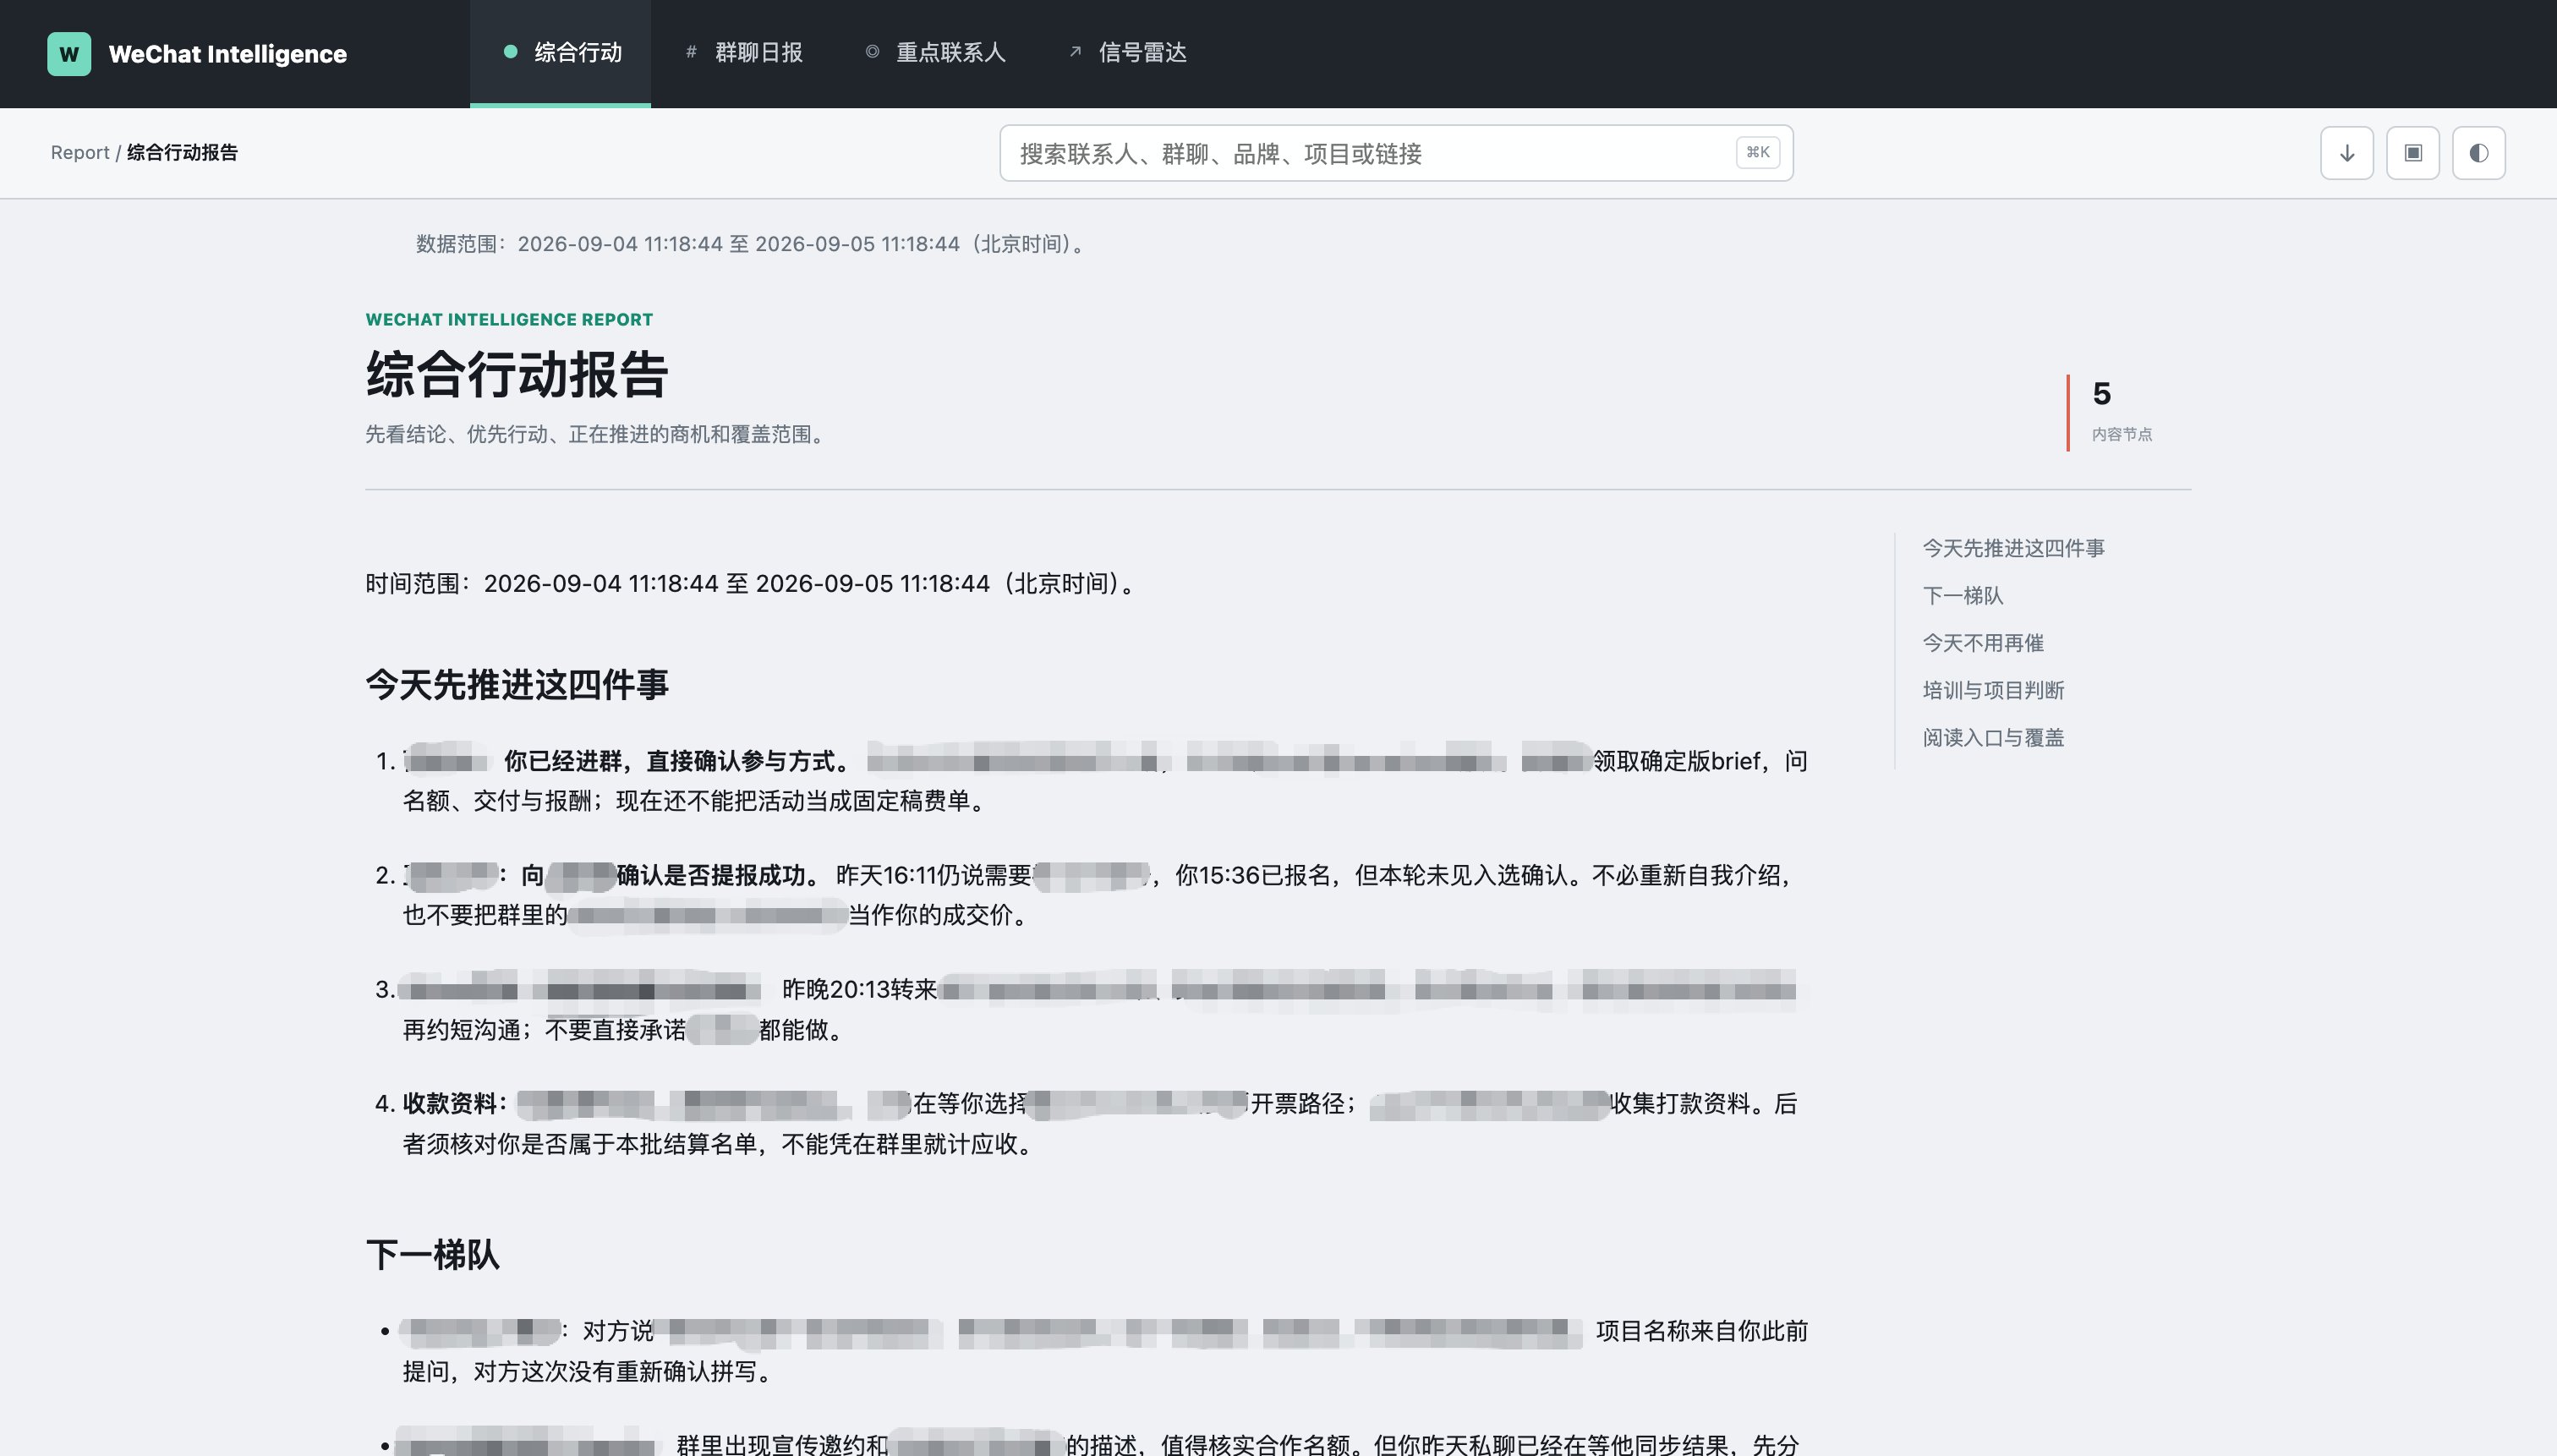
微信个人情报库开源:用 Codex 打造全自动微信小助理

作者开源了基于 Codex 构建的本地只读微信个人情报库项目 wechat-intelligence-hub,可将数万条微信聊天记录转化为全自动助理。核心功能包括:总结群聊私聊、追踪待回复事项与承诺、识别商单合作线索、检索历史聊天、生成 Markdown/HTML 报告、持久化机会管道、个性化回复建议和重点联系人管理。系统仅本地只读,不替用户发送消息,不做注入或 Hook。作者还提供了让 Codex 自动配置密钥与解密的傻瓜式安装流程,并回应了关于封号风险的质疑,同时宣布启动个人社群。

技术 › Codex Rion Wu (@rionaifantasy) 2026-09-0714.7 KB 63

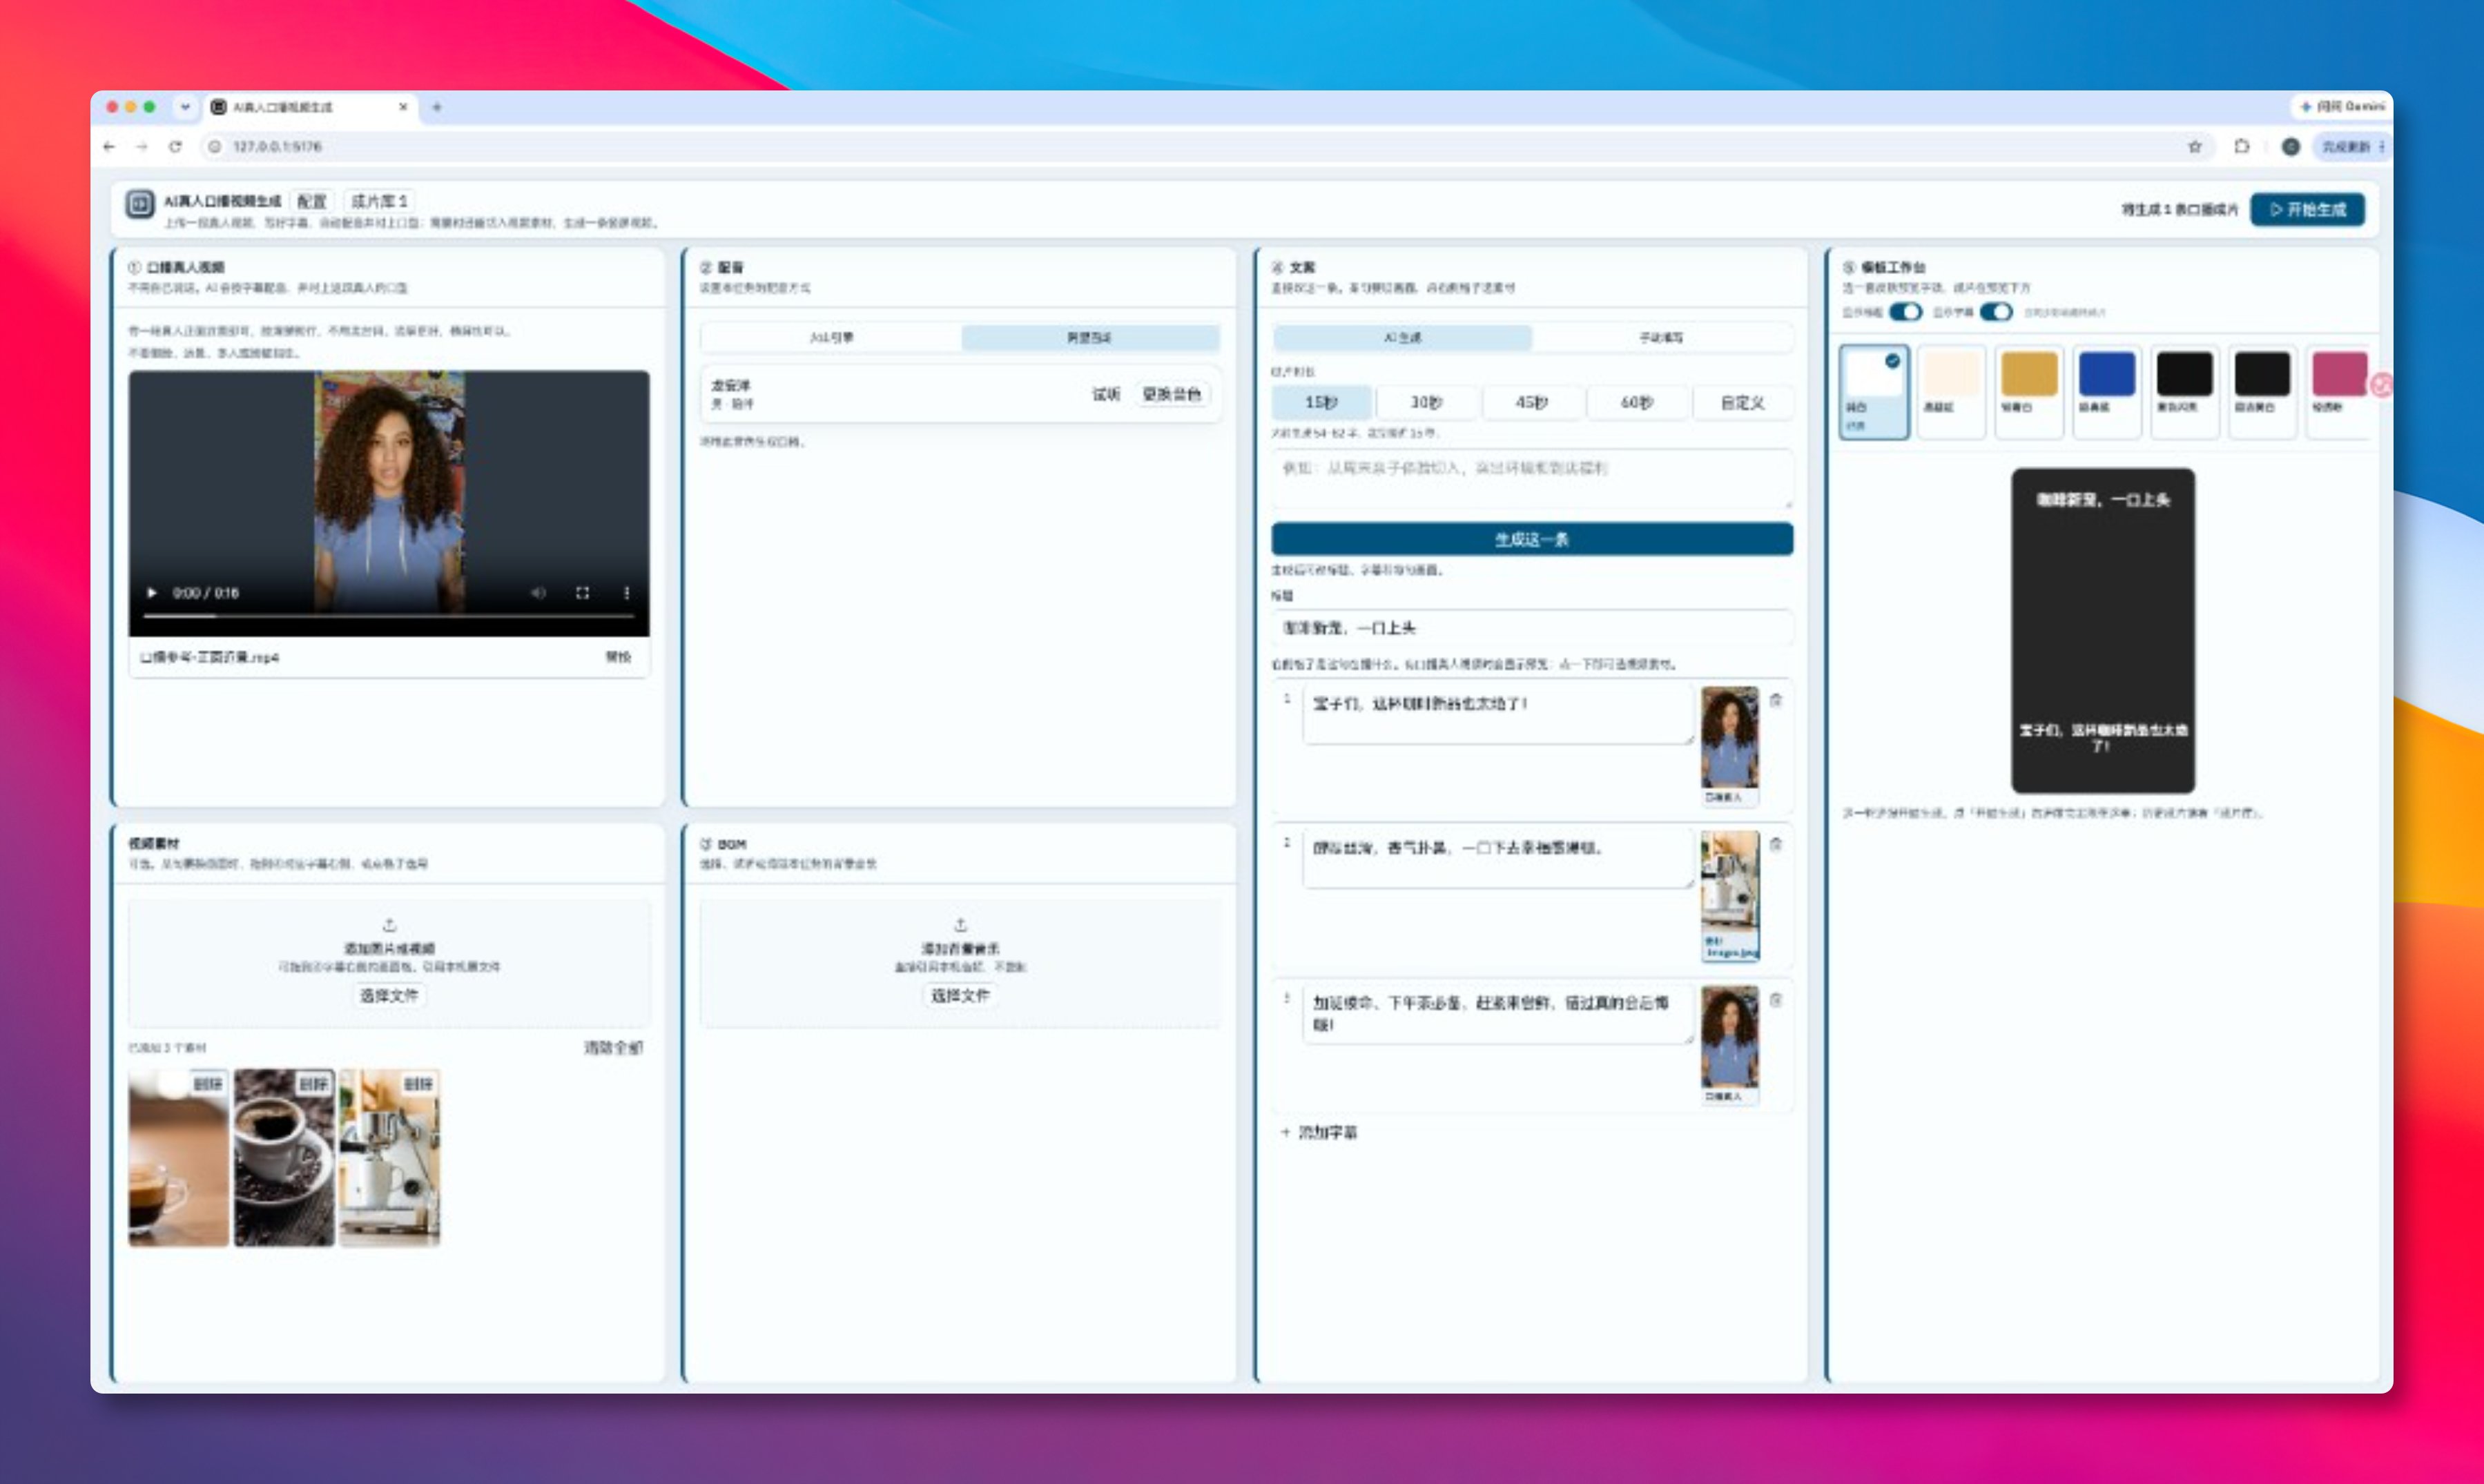
video-ai-talking:开源真人口播视频自动生成工具

文章介绍了一个名为 video-ai-talking 的开源工具,用于自动生成真人口播视频。用户只需提供一段真人出镜视频(无需念台词)和文案,工具即可本机合成竖屏 MP4。流程包括:先用火山引擎或阿里百炼配音,再通过百炼对口型接口合成,最后用 FFmpeg 拼接字幕。支持 DeepSeek 自动生成口播文案,成片时长 15-60 秒可选,字幕有多套皮肤,可自定义画面替换。密钥仅存浏览器、任务和成片均在本地处理,无云端服务器,适合想做知识口播但懒得出镜念稿的用户。

如何在本地运行开源 GLM-5.3-Flash 模型

本文详细介绍在个人机器上本地部署 GLM-5.3-Flash(320B 总参数、激活约 18B 的 MoE 模型)的完整流程。作者首先澄清显存误区:即使激活参数小,仍需容纳完整权重,最小 GGUF 量化文件即超 93GB,100GB 内存是起跑线。教程提供两条路线:一是使用图形化的 Unsloth Desktop 快速上手;二是编译支持 glm5next 架构的 llama.cpp 专用分支,并启动兼容 OpenAI 接口的本地服务。文章还涵盖硬件需求估算、量化版本选择建议(UD-IQ2_XXS 适合 128GB 机器)、常见报错排查与性能优化要点。

技术 › LLM 极客开源 2026-09-0711.5 KB 3.9K 13 86

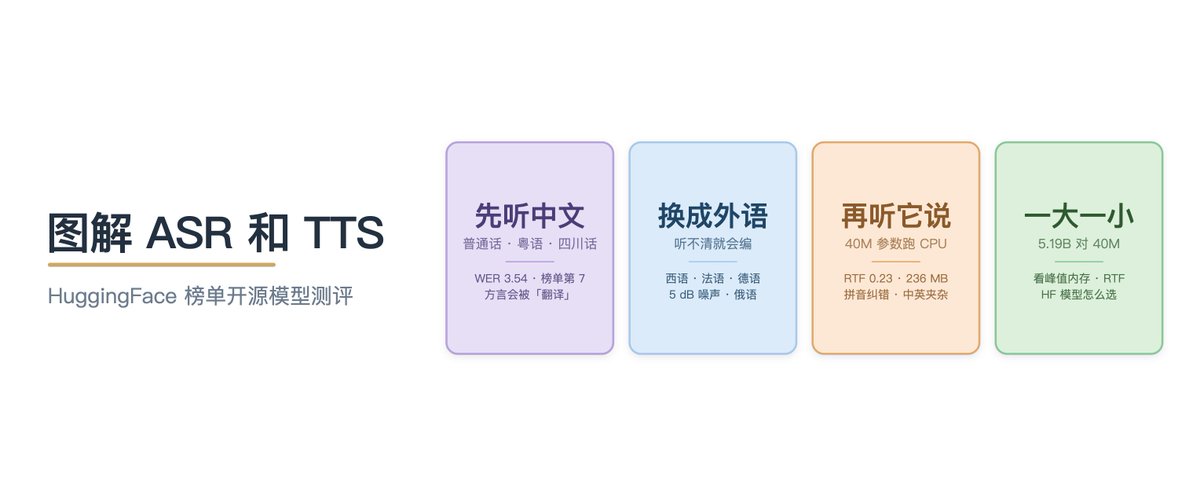
图解 ASR 和 TTS:HuggingFace 开源模型测评

作者实测了 HuggingFace 上多语种榜单第一、可本地部署的开源语音模型 Hojo-ASR-Multi-V1 和 Hojo-TTS-Light-40M。通过普通话、粤语、四川话及多国外语的实际听写测试,发现该 ASR 模型在普通话和粤语表现出色,但在方言虚词、专名和噪声场景下会出错;TTS 小模型在 CPU 上即可快速合成中英夹杂语音。文章还分析了模型体量、内存和 RTF 的关系,并给出不同场景下 ASR/TTS 开源模型的选型建议。

技术 › TTS WquGuru 2026-09-0514.2 KB 108.2K 105 86

从0到第一首 AI 歌:ComfyUI + MiniMax Music 3 完全上手

本文是一篇面向零基础用户的 AI 音乐生成实战教程,讲解如何使用 ComfyUI 和开源模型 MiniMax Music 3,在本地电脑上生成最长 5 分钟的完整歌曲(含前奏、主歌、副歌、尾奏)。文章介绍了 ComfyUI 的节点式工作流概念、Comfy Desktop 安装方法、模型三件套下载配置,重点讲解了如何撰写结构化音乐描述和带段落标签的歌词,并附带可直接复制粘贴的中文抒情流行歌曲模板。教程在 RTX 4070 Laptop 8GB 显存环境实测通过,针对低显存给出了 int8 量化模型等优化建议。

技术 › TTS 小海豚笔记 2026-09-0423.8 KB 2.4K 42 80

Hugging Face从入门到精通:万字长文详解

本文是一篇关于Hugging Face平台的详尽入门指南,旨在帮助初学者快速上手。文章首先介绍了Hugging Face的价值,即可以自由选择模型、试用在线演示并下载到本地。随后,文章详细讲解了平台首页的五大核心区域(搜索框、Models、Datasets、Spaces、更多菜单),并指导读者如何通过Spaces体验AI应用、通过Models查找和下载模型、通过Datasets预览和获取数据。文章还深入解析了模型页面的关键信息(如模型卡、文件版本、社区讨论、许可),以及模型下载和本地使用的具体方法,包括量化版本的选择和硬件要求。最后,文章强调了数据集的预览功能,帮助用户做出明智的下载决策。全文语言通俗,步骤清晰,适合所有对AI感兴趣的读者。

技术 › 工具与效率 Miles Ma 2026-09-0127.1 KB 119.7K 472 79