Wiki 知识库

全部文档 / 标签: 本地部署

111 篇
清除

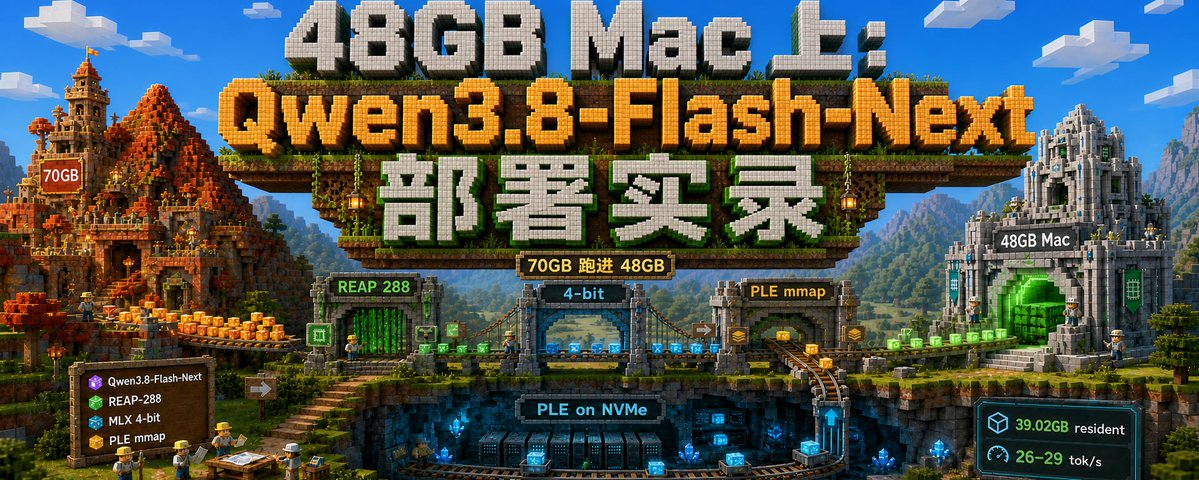
70GB 模型跑在 48GB Mac 上:Qwen3.8-Flash-Next 部署实录

作者在 48GB 内存 MacBook Pro(M4 Pro)上成功部署了磁盘体积约 70GB 的 Qwen3.8-Flash-Next REAP-288 MLX 4-bit 模型。文章解析了能跑起来的三重原因:REAP 将每层 512 个专家裁剪至 288 个、主模型与 PLE n-gram 表均做 4-bit 量化、以及 51B 参数的 PLE 表通过 mmap 留在 NVMe 按需流式读取。实际驻留约 39GB,首次加载约 10.14 秒,decode 稳定在 26~29 token/s,prefill 峰值约 149 token/s。实测最大上下文仅 8,217 tokens(配置声明 262K),建议日常使用 7,680 tokens。文章还记录了 Metal 内存上限调整、oMLX 服务启动及完整基准测试过程。

技术 › LLM 雪瑜 2026-09-0110.7 KB 55.5K 175 90

The Hermes Agent FAQ

本文是 Hermes Agent 的常见问题解答合集。作者在首次发布后收集了社区 100 多条回复中最常出现的问题,结合 Reddit、X 和 Discord 上的高频提问,整理成一篇 FAQ。内容涵盖核心概念(session、project、profile、bot)、四大配置文件(SOUL.md、AGENTS.md、MEMORY.md、USER.md)、模型选择与切换、首次使用建议、远程服务器连接、成本优化、记忆机制、本地部署的硬件要求与常见问题(工具调用失效、首条消息慢、上下文窗口过小导致遗忘)以及子代理使用不同模型等高级用法。所有答案均经过官方文档核对,适合新老用户快速上手和排障。
技术 › Hermes witcheer 2026-09-0116.3 KB 114.8K 522 85

别天天想着vibe coding,分享我用AI帮助孩子学习,一个月提高30分

作者分享用AI辅助孩子学习的真实案例:将孩子英语课堂录音本地保存,用本地Whisper模型转写为带时间戳和置信度的JSON数据,通过硬过滤和软警告规则剔除静音、幻觉、噪声等不可靠片段,再人工筛选出老师讲解内容,交给GPT重写成结构化讲义(核心复习卡、分主题方法、必背板书、限时顺序、订正题),最后脚本导出为去除隐私信息的Word文档。文章详细介绍了完整工作流、技术细节、自检清单及三种上手配置方式,强调录音需经老师允许、数据留本机保护隐私,讲义是节省时间的工具而非替代课堂。

技术 › 工具与效率 伯岩 2026-09-0115.6 KB 16.7K 119 83

从零安装Qwen3.8-27B:Mac本地部署与性能调优指南

本文详细介绍了如何在 Apple Silicon Mac 上从零部署 Qwen3.8-27B 模型。作者苏乐指出,普通 Mac 无需升级到最新 Mac Studio 即可运行该模型,关键在于算清内存账:模型权重、上下文缓存、运行缓冲、草稿模型和系统开销共享统一内存。文章对比了 4-bit、8-bit 和 BF16 量化版本的选择建议(24GB/32GB 选 4-bit,48GB/64GB 可选 8-bit),并提供了完整的部署流程:使用 uv 管理环境、通过 hf 命令下载模型、先测 baseline 速度再逐步开启优化。文章还解释了 DFlash 2 投机解码加速原理——通过轻量草稿模型并行提出候选 token,再由主模型验证,从而显著提升生成速度。

技术 › LLM 苏乐 2026-09-0137.3 KB 435.7K 623 85

LEANN:省97%存储的轻量级本地RAG检索方案

传统RAG存储成本高昂,百万级文档索引动辄数百GB,本地设备难以承载。LEANN采用新思路:不存储所有向量,只保留精简的图结构,检索时按需计算,实现存储节省97%且精度不减。它可在笔记本上全本地运行,支持索引文件系统、邮件、浏览器记录、微信/iMessage、ChatGPT/Claude对话、Slack/Twitter实时数据及代码库,零云成本、数据不出设备、注重隐私。该项目已入选MLsys 2026,适合关注隐私的个人语义搜索开发者。

技术 › LLM LanfAI (@Huahuazo) 2026-08-31941 B 60

从零开始用 ComfyUI 跑 MiniMax H3(2):官方skill分析与简易示例

本文是 MiniMax H3 视频生成系列第二篇,作者在 4080 12G 显存笔电上用 ComfyUI 本地运行 H3。文章首先分析官方公开的九套 Skills,涵盖产品广告、品牌宣传、纸拼贴、纸艺定格、歌词贴字 MV、3D 动画、手绘实拍融合和双人游戏开场,并附自制案例视频。随后详解 H3 提示词写作规范:先确定任务模式(T2VA/I2VA/FL2VA/L2VA/Ref2VA),为参考素材分工,定义视觉系统,单独列出屏幕文字的进入、可读与退出状态,按时间线写主体动作与运镜,将声音分为剧情内音景与非剧情配乐,规定转场继承方式,并明确结尾定格,最后给出一份可直接复用的 Prompt Spec 模板。

技术 › Skill 阿哲Phil 2026-08-3018.0 KB 33.8K 77 85

我把 Ling-3.0-tiny 装进 Mac,做了一个本地写作助手

作者记录了在 Mac mini(M4、16GB)上部署蚂蚁开源的混合推理小模型 Ling-3.0-tiny 的完整过程:编译 Ollama 实验分支、下载 FP8/BF16 权重并导入,验证服务后搭建了一个只调用本机接口的写作页面。随后用一篇真实口述稿进行四轮写作测试——提炼结构、检查问题、局部改写和反馈调整,发现模型擅长结构整理与问题扫描,但润色时 AI 味重,难以还原作者口吻。文章还对比了 FP8 与 BF16 的输入输出速度,并总结了端口冲突、上下文设置和接口安全等部署注意事项,最后给出将其用于写作第一轮辅助的定位。

技术 › LLM 小墨同学 2026-08-3017.2 KB 28.5K 40 82

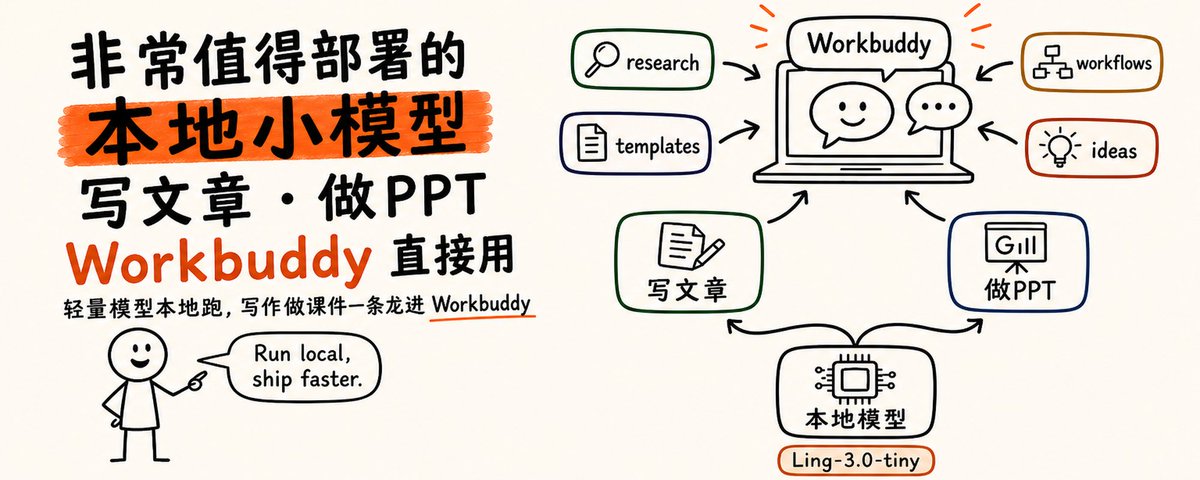
非常值得部署的本地小模型:写文章,做PPT,直接workbuddy里使用

文章介绍了蚂蚁刚开源的本地小模型 Ling-3.0-tiny(7.9B 总参数,每 token 激活 1.3B),在 Apple Silicon Mac 上的部署与实测表现。作者通过让 Cursor/Codex 自动部署 Rapid-MLX 的 4bit 版本,实测 M3 Max 上首字延迟约 55 毫秒,稳态解码约 110-125 tok/s,4bit 权重仅 4.2GB。该模型适合本机快速开发、大纲草稿、纪要压缩、做课件等短任务,也可接入 workbuddy 作为日常模型,但不适合复杂推理和长知识问答。文中给出了完整部署提示词、速度测试和文案处理实测案例。

技术 › LLM 产品经理老王霸 2026-08-307.4 KB 23.3K 74 77

本地部署MiniMax H3生成视频全流程揭秘:硬件配置、工作流与提示词

作者分享了在RTX 4070 16G显存电脑上本地部署MiniMax H3视频生成模型的完整经验:使用精简版ComfyUI和turbo lora模型(6步生成480P,超分至1080P),并让AI工具搭建了手机可远程调用的自动化系统,支持文生视频、图生视频、首尾帧等功能。文章详细说明不同分辨率下的时长与耗时数据,总结了低分辨率视频的美学要点(适合风景、特写、慢镜头),并附上完整的30秒电影复刻级英文对白短片提示词,涵盖镜头设计、人物一致性、声音设计与避坑指南。

技术 › 工具与效率 PixelAIGC 2026-08-2913.0 KB 81

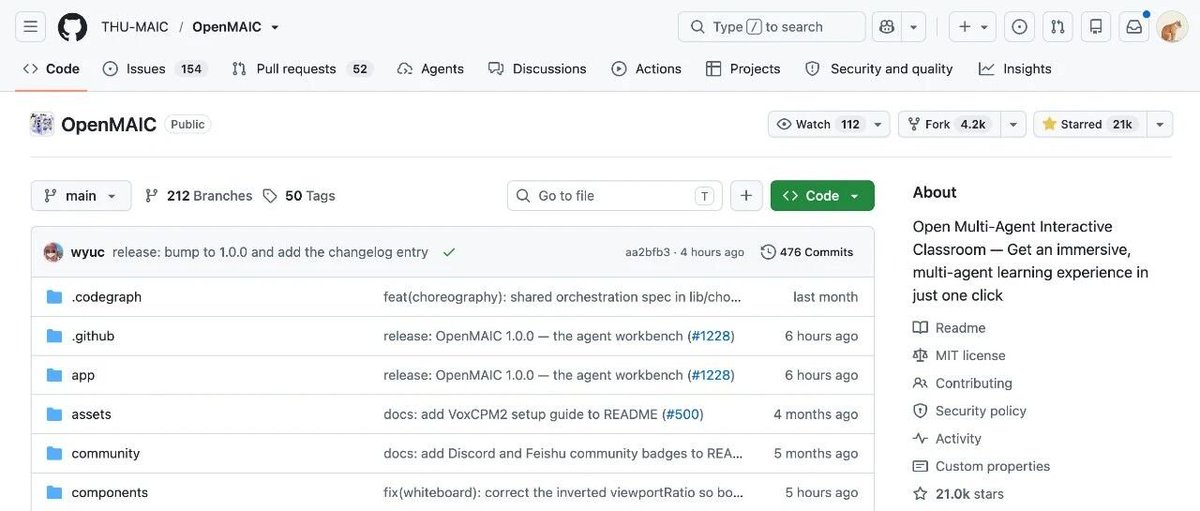
清华开源教育Agent OpenMAIC,GitHub 21K Star

清华THU-MAIC团队开源的教育Agent项目OpenMAIC发布1.0正式版,GitHub已获21K Star。项目从固定Workflow升级为Agent形态,只需描述需求,Agent可自动选skill、调研、规划课程,生成可交互、带AI配音的完整课件。文章通过书籍精读、物理电磁感应交互仿真、论文精读等案例展示了生成质量,并介绍了系列课程规划、PPT导入、18个skill体系、本地部署、声音克隆及课件竞技场等功能,认为其已形成调研、备课、讲解、互动、答疑的完整链路。

技术 › Agent 刘聪NLP 2026-08-299.1 KB 320.9K 763 73

千问 Qwen3.8 27B 本地化部署:小白保姆级教程

本文是一篇面向小手的本地大模型部署教程,作者在配备 AMD Ryzen AI MAX+ 395、64GB 统一内存的 Ubuntu 24.04 机器上,完整演示了如何用 Ollama 部署千问 Qwen3.8 27B 量化模型(UD-Q3_K_XL)。文章首先解释了本地化部署、参数规模、量化(Q3_K_XL)、token 等基础概念,说明本地部署的隐私、离线使用、无次数限制等优势。随后分 Windows 和 Linux 两条路线讲解环境检查、Ollama 安装、模型下载(约 13GB,运行占 29GB)、首次对话,以及如何确认 GPU(ROCm/Vulkan)真正接管计算,并提供常见问题排查方法,最终一条命令即可在本地跑通模型。

技术 › LLM Adrian Punk 2026-08-2820.9 KB 1.1M 1.6K 76

我把 Moderna 癌症疫苗论文丢给 Apodex 的 Deep Discover(附 RTX 5090 本地部署)

作者以 Moderna/Merck 个体化 mRNA 癌症疫苗 Phase 3 进展为案例,体验了 Apodex 的 Deep Discover 多 Agent 研究产品。产品通过 Task Board、分工的 Sub-agent(临床数据读取、肿瘤研究、估值分析)与 Verifier 复核,实现可视、可中途干预的研究流程,并在测试中自行纠正了药物实体混淆。文章后半部分详细记录在单张 RTX 5090 上用 SGLang 部署 Apodex 1.1 mini(36B MoE GPTQ Int4)及开源 FrontierAgent 的过程,包括网络代理与 SSRF 防护冲突的排查、Agent Team 宏观研究实测,以及单卡下并行的本质是任务与上下文并行而非吞吐并行的性能分析。

技术 › Agent 九尾狐-FoxFairy 2026-08-2820.4 KB 25.5K 115 82

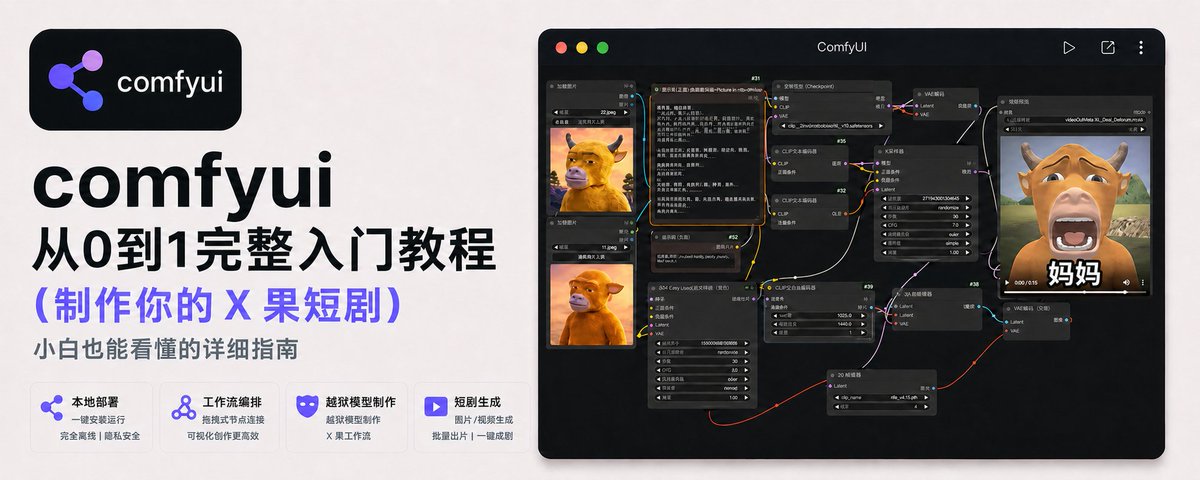
本地大模型当导演,从此看片不求人

这是一篇面向小白的 ComfyUI 本地 AI 出图与生视频完整教程。文章介绍了 ComfyUI 的节点连线原理与硬件要求(显存 8GB 起步),详解安装方法(推荐秋叶整合包)、模型文件的正确存放目录、跑通第一张文生图流程;随后推荐了可商用的 Z-Image Turbo 模型并给出完整配置,再讲解用 Wan 2.2 做文生视频、图生视频和首尾帧过渡的玩法,提示词要描述动作与镜头运动。最后介绍如何使用官方模板库和社区工作流,以及通过替换越狱编码器实现未审查模型生成短剧视频的方法。

技术 › 工具与效率 黄小木 2026-08-2815.6 KB 1.9M 2.4K 88

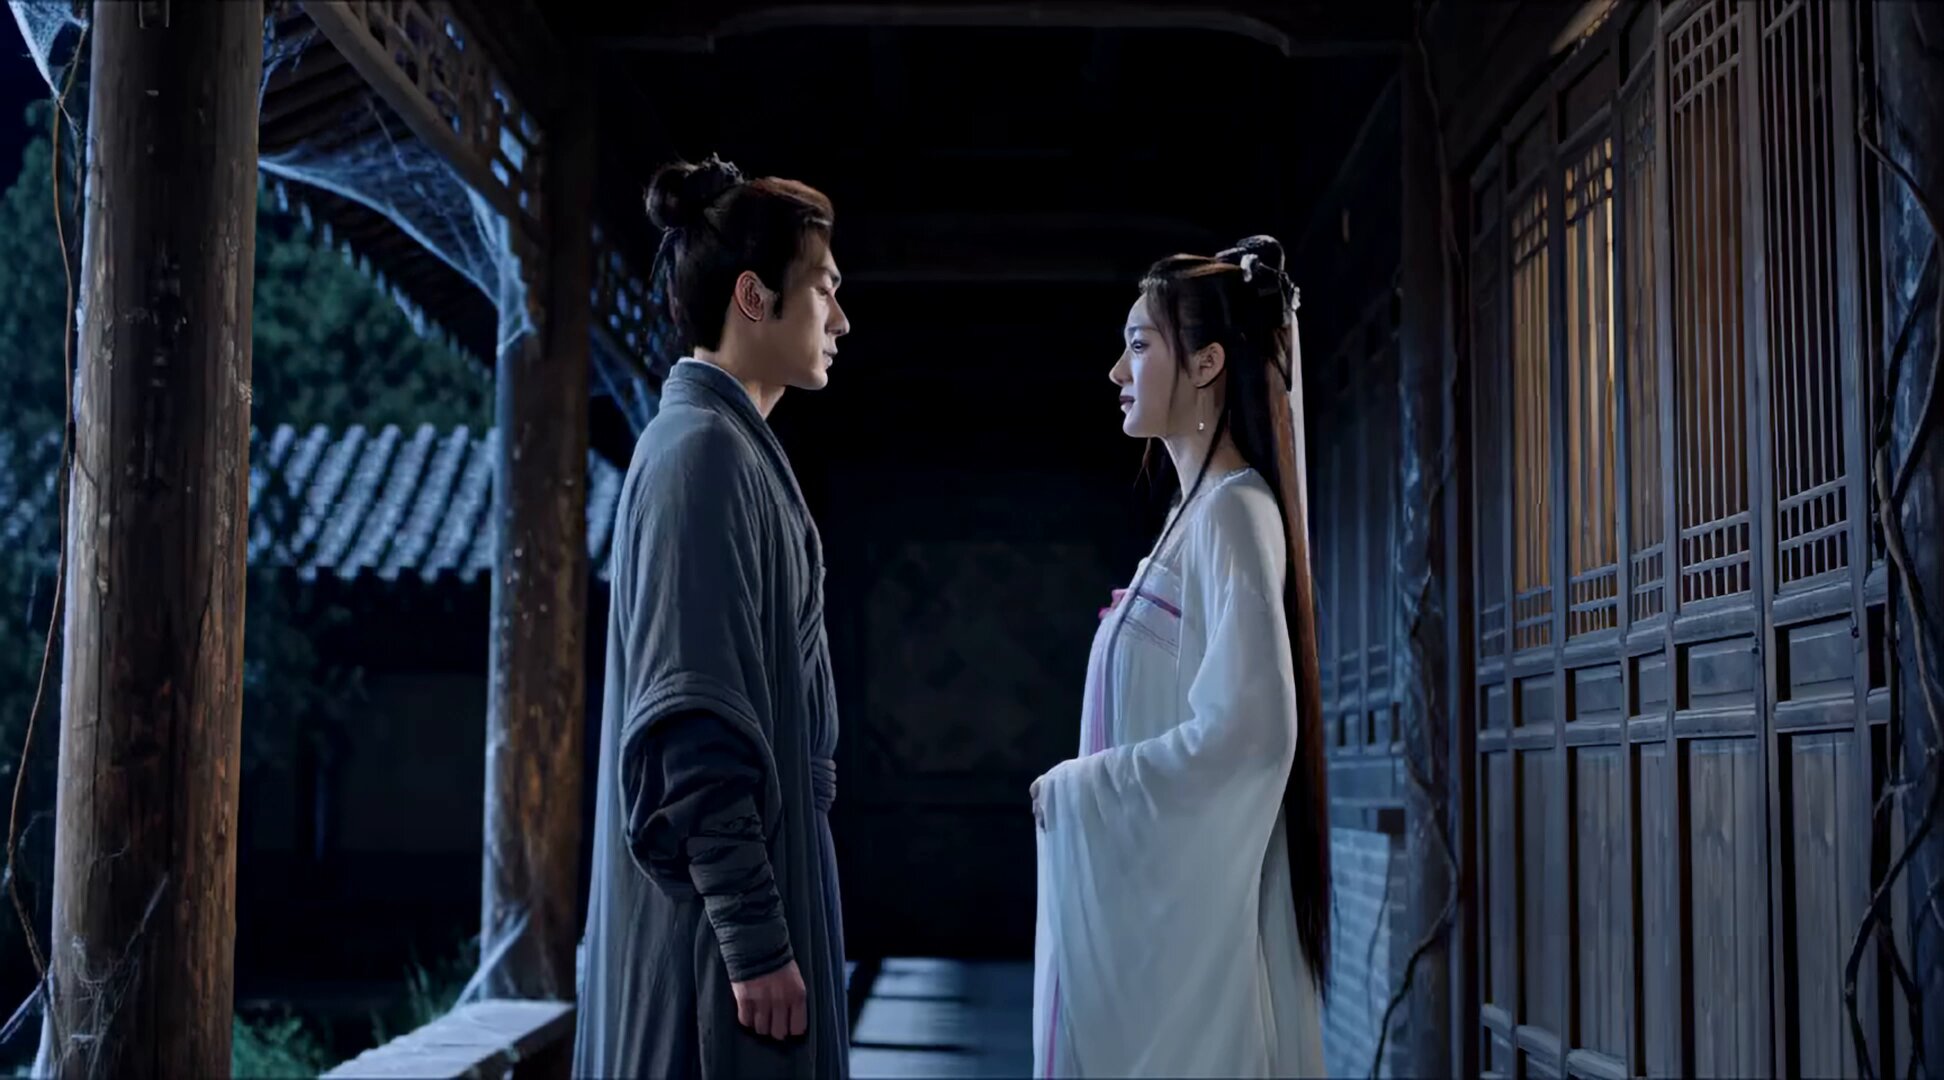
AI还原《倩女幽魂》经典台词:本地生成25秒写实古风短片

作者分享使用MiniMax模型在本地电脑(4070显卡16G显存)生成的25秒《倩女幽魂》AI视频,还原电影经典台词场景,无需花费token。文章附带了完整的视频提示词Skill框架,涵盖人物一致性设定、四镜头分镜设计(宁采臣与聂小倩的离别对白)、声音设计(原生中文对白、口型同步)及影像限制要求(宽银幕画幅、胶片质感、无字幕水印等),展示了AI视频生成在古风剧情短片创作中的应用效果。

技术 › 短剧 PixelAIGC 2026-08-275.4 KB 70

2026 开源模型全网最全盘点:从入门到榨干(含双机实测)

文章系统盘点了 2026 年值得关注的开源 AI 模型,涵盖语言、图片、视频三大类别,包括 Qwen、DeepSeek、Kimi、GLM、MiniMax、混元等国产阵营及海外模型。作者拆解了模型命名规则(参数量、MoE、量化、许可证等),提出五步选型筛选法,并比较各硬件平台(Mac 统一内存、NPU AI PC、大内存 APU 等)的适配能力。文章还讲解了本地部署的适用场景与许可注意事项,最后通过 Mac 和 Windows 双机实测检验模型在文字、看图、分镜和视频任务上的真实表现,帮助读者判断自己需要哪类模型以及电脑能否带动。

技术 › LLM 诺鸭船长3 2026-08-2735.5 KB 44.1K 51 87

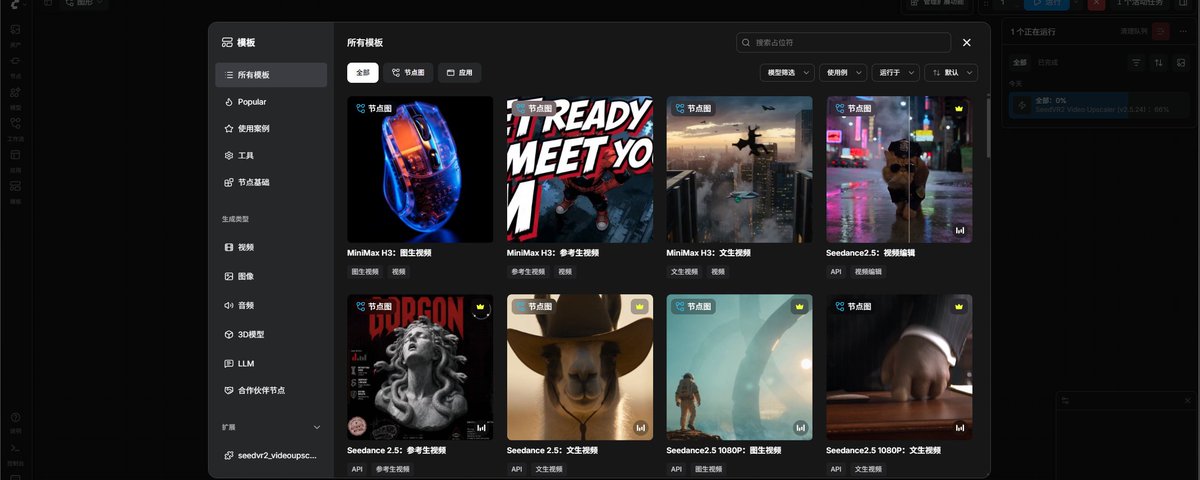
从零开始用 ComfyUI 跑 MiniMax H3:本地安装、云端和视频工作流

本文面向新手介绍如何在 ComfyUI 中使用开源视频大模型 MiniMax H3 生成带同步声音的视频。内容包括:检查本地电脑显卡、显存与磁盘空间(建议预留70-100GB);Windows 安装 ComfyUI Desktop 的步骤;不适合本地时使用 Comfy Cloud 云端方案;使用官方 T2V/I2V/R2V 模板生成第一条5秒视频的参数与提示词写法;以及高清修复、多参考素材、首尾帧控制、长视频续拍、局部重绘等进阶工作流,最后给出常见问题排查和最稳学习路线。

技术 › AI视频 阿哲Phil 2026-08-2614.0 KB 309.7K 840 88

Pi Agent + Qwen 3.8 27B 深度优化

作者在懒猫AI算力舱 X5(128GB显存)上部署 Qwen 3.8 27B 稠密模型,真实项目中跑了4个任务均完成良好。通过 MTP 投机解码 + NVFP8 混合优化并关闭 thinking 模式,速度从 13.9 提升到 30.8 Tokens;但发现关闭思考模式会降低代码推理准确度,重新开启后实测稳定 26.47 Tokens(含思考阶段实际可达 35.23 Tokens/s)。后续还将通过重新量化构建 draft engine 进一步提速。

技术 › LLM Andy Stewart 2026-08-252.7 KB 26.1K 42 55

一次性讲清楚 Qwen3.8 27B 的本地部署

本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。

技术 › LLM huangserva 2026-08-2571.4 KB 296.8K 683 91

说一句收到,我花了20341个token——Agent成本的过路费与省钱三刀

作者发现验证Agent成员是否存活时,一句简单的「收到」竟消耗两万个token,原因是每次对话都要重新装配成员的身份、记忆、技能清单等。文章剖析了Agent成本的三层「过路费」结构:身份装配、上下文搬运和格式开销,指出七成token花在空驶而非思考上。作者提出三刀止损法:利用前缀缓存把不变内容前置、健康探针直连绕过人格装配、协作转手只传摘要。实施后成本降了一半以上,但同时也暴露出便宜诱发滥用、缓存惩罚变动等新问题,并引出本地化部署的机会成本与主权优势思考。

技术 › Agent AI最严厉的父亲 2026-08-2529.5 KB 8.6K 5 85

10款值得在本地运行的开源AI工具

文章介绍了10款免费开源、可在本地运行的AI工具,涵盖从模型引擎到日常应用的完整技术栈:llama.cpp作为本地推理引擎,Qwen3作为开源模型,AnythingLLM提供本地知识库聊天,whisper.cpp实现本地语音转文字,Kokoro-82M负责文本转语音,Immich用于自托管照片管理,Tabby提供本地代码补全,ComfyUI支持本地图像生成,Activepieces实现自动化工作流。每个工具均通过免费开源、本地运行、持续更新、有公开证据四项筛选标准,帮助用户摆脱云端订阅和数据外流。

技术 › 工具与效率 Alex Veremeyenko 2026-08-2510.5 KB 8.8K 23 78

本地部署的Ling-3.0-tiny实测:7.9B小模型能把活干好吗

作者在128GB统一内存小主机上本地部署开源MoE模型Ling-3.0-tiny(7.9B参数,激活1.3B),用llama.cpp Vulkan加载Q8_0量化版本。实测任务是将2360行、2小时17分的客户会议飞书妙记转写交给模型,进行需求提取、实施方案搭建和报价结构整理。结果显示:模型能在235秒内完成需求提取,方案模块划分与人工方案接近,但时间戳偶有不准需人工复核。经提示词调优后,碰撞长度上限次数从16次降至3次。作者认为它适合承担会议整理、需求归类等“脏活”,但范围、价格、承诺等决策仍需人负责,并推荐在真实业务场景中使用。

技术 › LLM 阿川 | AI thinking 2026-08-247.6 KB 20.7K 59 78

我把我的“AI白月光”装进 MacBook:一个装修人四个月的 AI 学习路线

作者回顾了自己四个月学习 AI 的历程,从最初用蚂蚁百灵大模型 Ling-3.0-tiny 整理装修业务流程、拆解游戏开发任务、到设计四轮装修改稿测试验证模型规则意识,共经历三个阶段。最终在 M5、24GB 内存的 MacBook 上完成 Ling-3.0-Tiny INT4 本地部署,构建 Ollama/MLX 运行路径,并搭建基于 Obsidian 的只读检索层,让模型担任“本地项目情报员”。作者强调普通人学 AI 应先解决一件真实的小事。

技术 › LLM Main CaseZ·美學 2026-08-249.9 KB 7.2K 54 66

16GB 无独显本地部署 Ling-3.0-tiny 实测:21.7 token/s 与推理引擎版本的秘密

作者在一台单通道 16GB 内存、无独显的 Ryzen 5 5600G 台式机上,使用 llama.cpp 官方版部署 Ling-3.0-tiny(Q4KM 量化),实测生成速度 21.70 tok/s,比配置更强的 64GB+3090 机器快近 4 倍。经排查,差异源于推理引擎版本而非硬件。文章还分析了该模型线性注意力架构带来的超低上下文内存开销(约 6.79 KiB/token),总结了思考模式、Windows 编码、线程设置三个实践坑,并给出三步部署教程,证明普通电脑即可流畅本地运行该模型。

技术 › LLM 阿良|AI 工作流 2026-08-2414.2 KB 71.3K 177 90

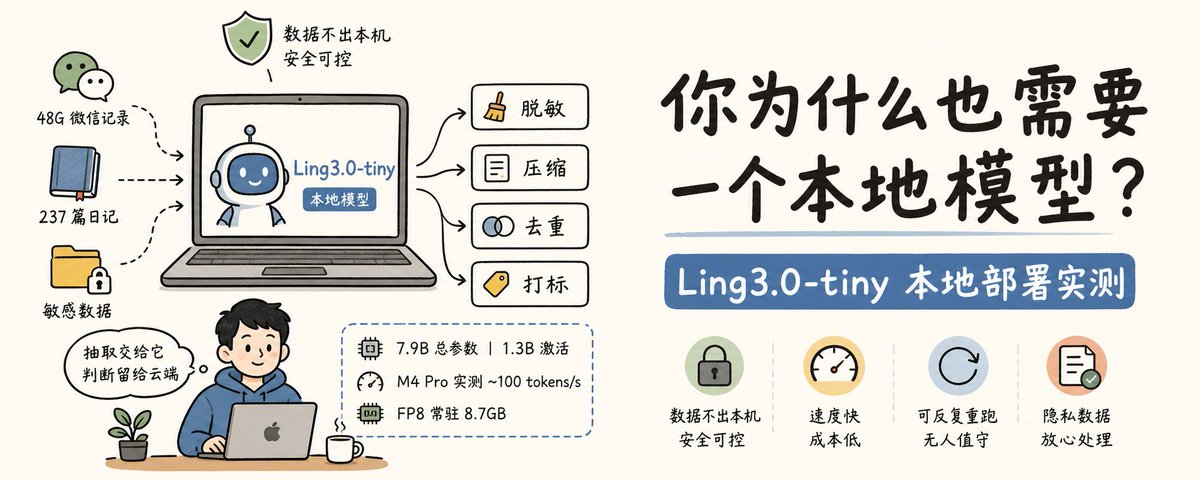
你为什么也需要一个本地模型?Ling3.0-tiny 本地部署实测

作者介绍了在 MacBook M4 Pro 上部署蚂蚁百灵开源的 Ling-3.0-tiny 稀疏 MoE 模型的完整过程,用于处理 48G 微信记录和 237 篇日记等隐私数据。文章详述了 FP8 权重选择、编译 MLX 后端 ollama、避坑指南等实操细节,实测生成速度约 78-99 tokens/s。在脱敏、命名实体识别、长文压缩、去重四个场景中表现优异,并总结分工原则:抽取任务交给本地模型,语义判断留给云端模型。

技术 › LLM 柯基是只猫 2026-08-2412.2 KB 20.2K 102 92

我把 Ling-3.0-tiny 塞进 DeepSeek Harness 跑真实任务实测

作者在 MacBook Pro M3 Max 上本地部署蚂蚁百灵开源的 Ling-3.0-tiny(总参数 7.9B、激活 1.3B),编译 Ollama 的 BailingMoeV3 分支导入 FP8 与 BF16 两个精度版本,实测输出速度分别约 106 和 81 tokens/s。随后通过 OpenAI 兼容协议将模型接入 DeepSeek Harness,让它把自己的底稿《文科生学 AI,先补一层计算机常识》重写成公众号文章。结果模型完整跑完任务、未瞎编内容,但句子偏碎且擅自添加内容,直出终稿尚早。文中还总结了部署与配置过程中的一系列坑及避坑指南。

技术 › LLM 得否 2026-08-2418.3 KB 18.3K 45 86

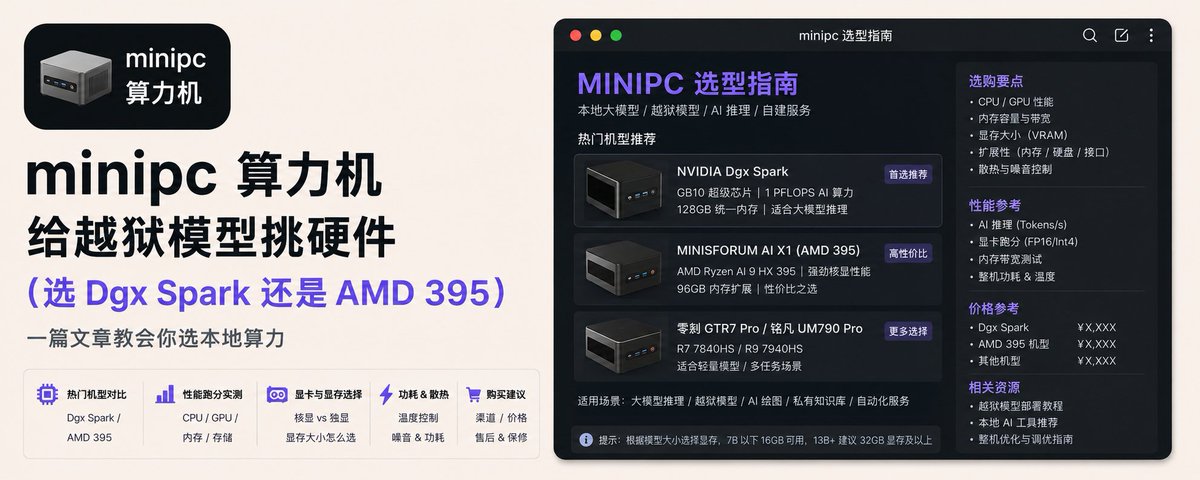
AIPC选购指南:DGX Spark 还是 AMD 395?

文章对比了两款桌面跑大模型的设备:英伟达 DGX Spark(国行3.5万)与搭载 AMD Ryzen AI Max+ 395 的小主机(近2万)。两者均采用统一内存架构、128GB 内存,可装下 70B 级模型。核心结论:出字速度受内存带宽限制,两台几乎一样;读题(预填充)速度 Spark 快五到六倍,资料越长优势越大。文章还分析了各自优缺点、CUDA 生态、双机集群跑 DeepSeek-V4 的玩法及真实翻车案例。

技术 › LLM 黄小木 2026-08-2227.2 KB 100.7K 119 86

没有 AIPC 的家庭是支离破碎的:AIPC 是什么、如何选择

文章介绍了 AIPC(能在本机处理 AI 工作负载的个人电脑)的概念与工作原理,通过扫描件 OCR 的例子说明本地 AI 任务从输入到输出的完整链路及各环节的交接问题。对比了 AMD Ryzen AI Max+ 395 Mini PC 与 NVIDIA DGX Spark 两类设备的架构、内存与软件生态差异,并讨论了在没有 AIPC 时如何利用闲置电脑跑本地模型,以及噪声、散热和何时应购买独立 AIPC 的考量。作者认为随着本地大模型能力逼近闭源云端模型,专业人士应考虑部署一台可 24 小时运行的 AIPC。

技术 › LLM Roland.W 2026-08-219.9 KB 21.7K 25 52

保姆级教程:DGX Spark 本地跑通 124B 大模型全记录

本文记录了作者在公司配置的英伟达 DGX Spark 桌面级 AI 超算上本地部署大模型的完整过程。文章首先介绍选择 DGX Spark 的原因(数据隐私、成本可控),解析其 GB10 芯片与 128GB 统一内存的硬件配置,讲解稠密模型与 MoE 稀疏模型的区别,最终选定蚂蚁百灵 Ling-3.0-flash(fp4/int4 量化版本)进行部署。作者对比了 Ollama 与 vLLM 的优劣,选择 vLLM 完成部署,并借助 Claude Code 远程操作。最后进行了 MTP 推理加速测速对比,并成功将本地模型对接到 Claude Code 实际使用。

技术 › LLM AI少年 2026-08-1817.4 KB 184.5K 132 82

大模型本地部署完整指南:用 Ling-3.0-flash 搭建自己的 Agent 工作流

本文是一篇面向新手的本地大模型部署教程。作者在 NVIDIA DGX Spark(GB10 芯片、121.6GB 统一内存)上,使用官方适配的 vLLM 分支部署了蚂蚁百灵开源的 124B MoE 模型 Ling-3.0-flash INT4 版本。文章先科普了模型精度、Dense 与 MoE、推理引擎等概念,再详解下载权重、环境准备、启动服务与验证的完整流程,并开启 MTP 投机解码。性能测试显示 8 并发聚合吞吐达 141.38 tok/s,远超本机 Qwen3.8-27B;随后通过逻辑推理、安全边界、长文本三方向测试验证真实能力,最后介绍用 Python 脚本搭建终端 TUI 聊天界面,逐步走向 Agent 工作流与 Token 自由。

技术 › LLM Lonely 2026-08-1823.9 KB 278.4K 485 81

最强的矛与盾:本地部署大模型到底该买什么

本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。

技术 › LLM 实践哥MinLi 2026-08-1830.4 KB 298.1K 264 89