如何像 MIT 和斯坦福的学生一样,用 Kimi 写完整篇研究论文
文章介绍了利用 Kimi AI 超长上下文窗口(100万 token)的 6 步工作流,辅助完成研究论文写作。通过一次性上传海量文献,可快速完成文献梳理、空白挖掘、综述撰写、方法论论证及逻辑检查,将原本需数月的前期准备压缩至一周。
文章介绍了利用 Kimi AI 超长上下文窗口(100万 token)的 6 步工作流,辅助完成研究论文写作。通过一次性上传海量文献,可快速完成文献梳理、空白挖掘、综述撰写、方法论论证及逻辑检查,将原本需数月的前期准备压缩至一周。
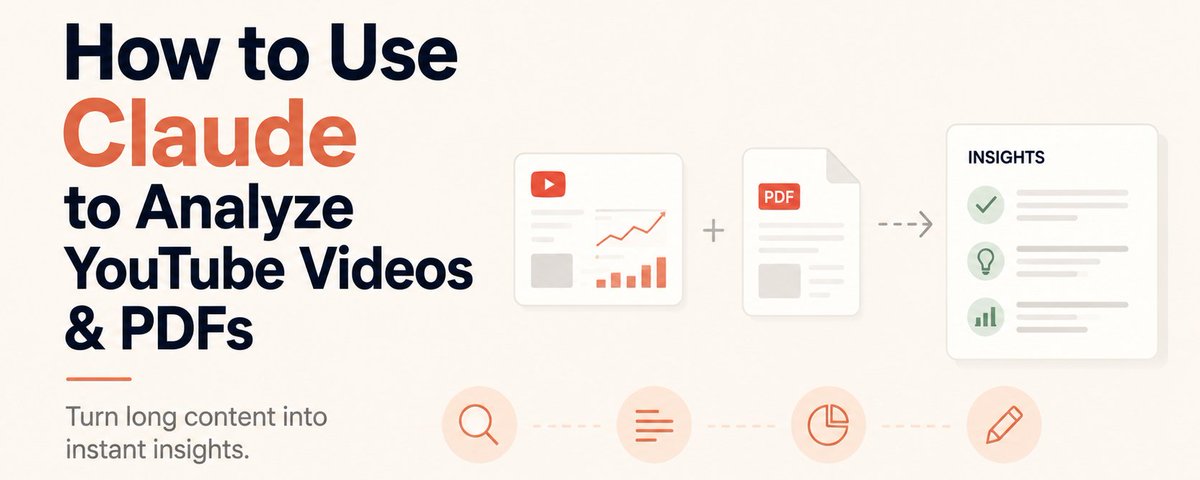
本文介绍了在 2026 年 5 月利用 Claude 分析 YouTube 视频和 PDF 的最新工作流。通过上传 PDF 并粘贴视频字幕,用户可以在 60-90 秒内完成原本需要数小时的交叉分析。文章详细阐述了三种核心模式(视频优先、平衡检查、分层专家审查),并提供了具体的操作步骤、提示词构建技巧及常见误区规避方案。
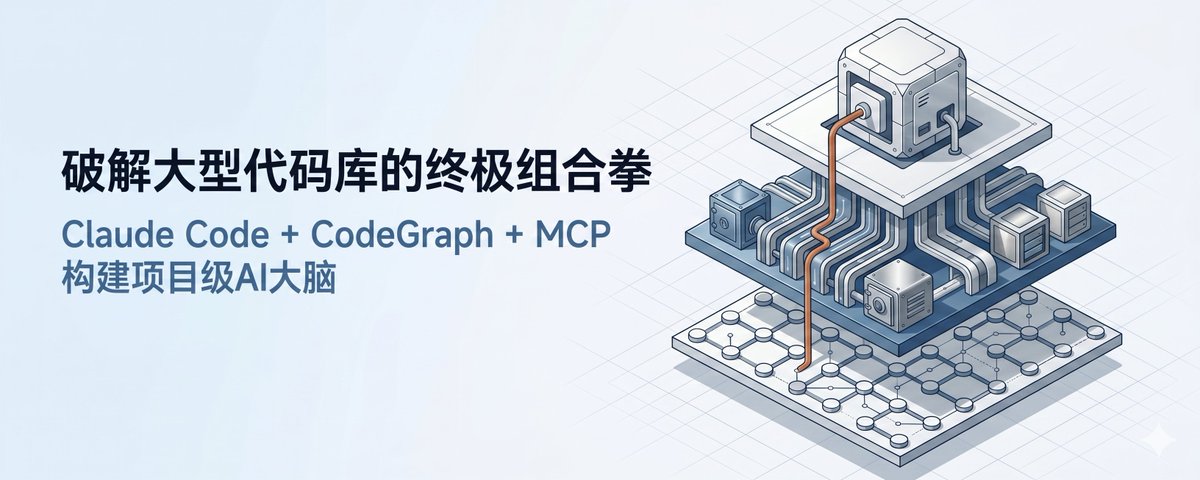
文章介绍了Claude Code 2.1.142、CodeGraph与MCP的“组合拳”方案,有效解决了大型代码库探索中tool call过多、上下文爆炸等问题。通过CodeGraph构建语义知识图谱,结合MCP持久化记忆与新版优化,实现了Tool call减少92%、代码探索速度提升71%的显著效果,并提供了详细的安装配置流程与实战场景指南。
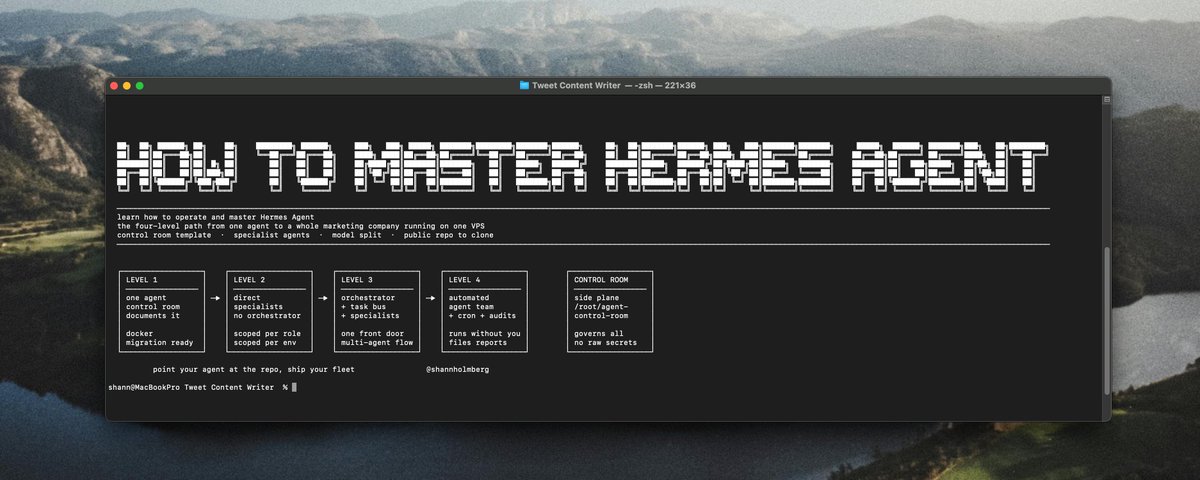
本文介绍了由 Nous Research 开源的高杠杆 AI 框架 Hermes Agent。文章详细阐述了其架构(大脑、个性、技能集)、具备记忆与自学习能力的闭环机制,以及如何从单机部署扩展为 VPS 上的自动化营销团队。作者分享了将其作为营销基础设施的实际经验与配置指南。
作者分享了将 AI Agent 从 Demo 推向生产环境过程中遇到的四个“深坑”:Function Calling 的不可预测性需加代码校验兜底;多步任务必须引入状态机和 checkpoint 防止重复执行或死无对证;记忆管理需分层以解决 token 爆炸和“丢失中间”问题;权限控制是最大风险,需防范 prompt injection 并建立分级审计机制。
文章深入探讨了 Claude Code 如何在大型代码库(如单体仓库、遗留系统)中高效工作。与依赖过时索引的 RAG 工具不同,Claude 采用代理式搜索遍历本地文件系统。文章指出,工具链(包括 CLAUDE.md、钩子、技能、插件、MCP 服务器和 LSP 集成)对性能的影响往往大于模型本身。通过建立正确的上下文层次和渐进式采用策略,团队可显著提升开发效率。
文章介绍了 Agent Hooks 机制,旨在解决 Agent 工作流中不可控的问题。通过在生命周期的特定节点(如 SessionStart, PreToolUse 等)挂载自定义处理器,开发者可以强制执行策略、校验操作并记录状态。Hooks 将特定的规则检查从依赖模型记忆转变为显式的确定性控制,弥补了仅使用 Prompt 指令的不足。
本文深入剖析了 AI 领域核心的注意力机制。文章回顾了 Attention 从早期神经机器翻译到 Transformer 架构的演变历史,详细解析了其解决固定长度向量瓶颈的原理。同时,通过图文并茂的方式,逐步拆解了从 Embedding 到上下文表示的过程,重点阐述了 Queries、Keys、Values (QKV) 机制的运作逻辑及其在现代大模型中的关键作用。
文章探讨了 AI 技术如何将社会工程学(骗术)的门槛从“十年经验”降至“200 美元”。通过语音克隆和 FraudGPT 等工具,诈骗已实现规模化和工业化。作者指出,AI 社会工程学不仅带来了巨大的经济损失,更深层地破坏了社会的信任基石,导致社会运转成本剧增,我们已身处一场全新的战争。
文章介绍了 AI 代理经济的现状与未来。通过 OpenClaw 和 Claude Code 等案例,阐述了软件构建方式从聊天机器人向自主任务型 AI 的结构性转变。虽然技术潜力巨大(如 Anthropic 收入暴增),但实际部署中仍面临频繁失败的风险。文章提出了一个五层框架来分析代理技术栈,探讨了价值积累与商品化的分布,并指出技术可能性与实际部署之间的差距即是投资机会。
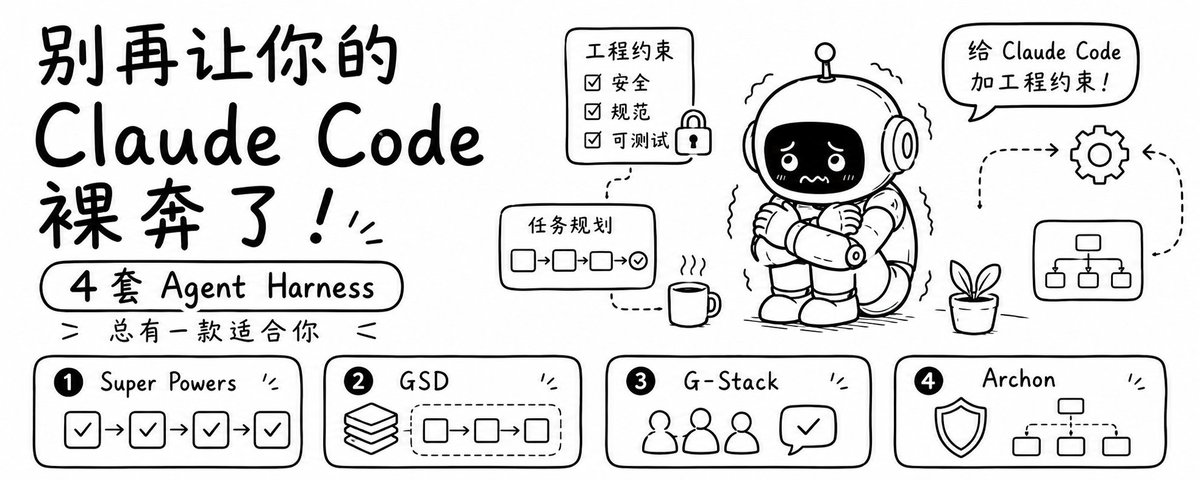
文章指出 Claude Code 直接使用存在上下文腐烂、缺乏流程约束等工程问题,提出利用 Harness(Agent 系统架构)来规范 AI 行为。作者详细对比了四套方案:Super Powers(纪律层)、GSD(上下文层)、G-Stack(角色层)和 Archon(编排层),并分析了各自的适用场景、优缺点及实施代价,建议开发者根据需求循序渐进地搭建 AI 开发工作流。
文章深入解析了 OpenAI Codex CLI 的内存架构,该工具通过本地 Markdown 文件异步生成和汇总记忆。文章详细介绍了记忆的写入与加载流程,指出其缺乏向量数据库、仅依赖关键词匹配及受限于本地文件系统等局限。最后,文章引入 Mem0 作为解决方案,通过 MCP 协议提供跨机器、跨工具的持久化智能记忆层,解决原生功能在扩展性和同步方面的不足。
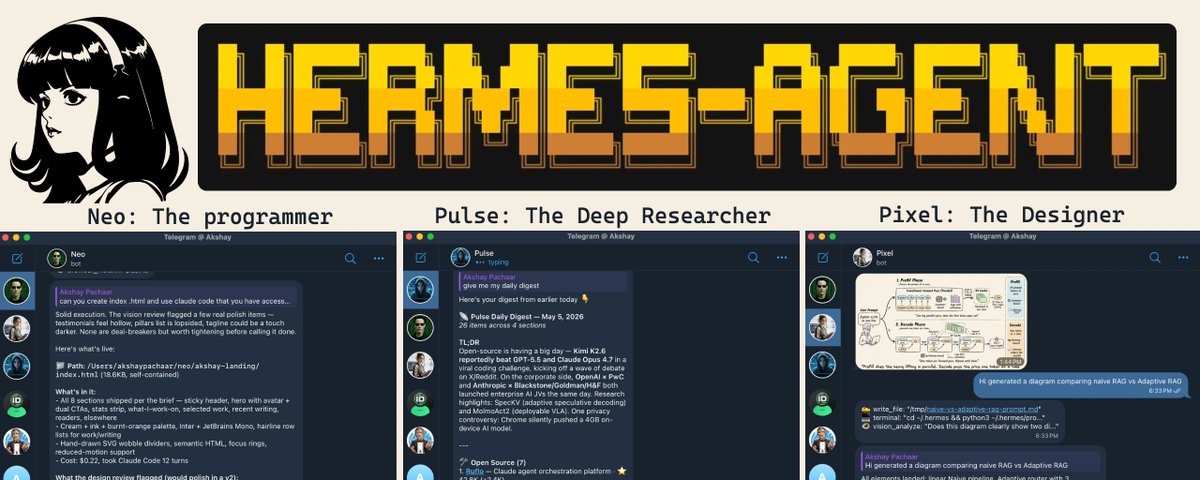
本文是 Hermes Agent 的深度教程。Hermes 是一个能够在使用中不断自我进化的 AI Agent,与 OpenClaw 等其他 Agent 不同,它具备跨会话记忆、自编写/修剪技能以及通过 GEPA 引擎进行离线验证的独特能力。文章详细剖析了其包含 SOUL.md 身份层在内的三层记忆系统,并指导读者如何从零配置运行多个具备独立个性的 Agent。
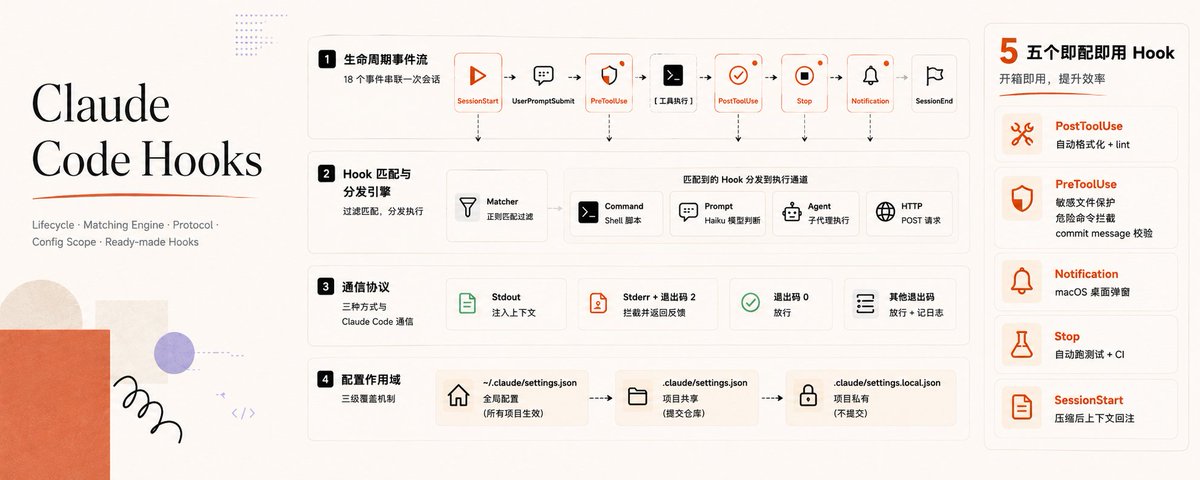
文章深入介绍了 Claude Code 的 Hooks 机制,这是一种在 Claude 生命周期固定节点自动执行 Shell 命令的功能。通过配置 PostToolUse、PreToolUse 等五个关键事件,开发者可以实现自动格式化、拦截危险命令、发送桌面通知和强制 Git 提交规范等自动化流程。文章提供了具体的配置示例和代码,建议将关键流程从 Prompt 转移到环境机制中,以确保代码质量和开发效率。
文章深入浅出地讲解了 AI Agent 记忆系统的工作原理,从基础的单会话与多会话记忆保持切入,引出 Google 提出的情景、语义与程序性记忆三分法。通过对比 OpenClaw 的实现方式与存在的问题,重点剖析了企业级方案 EverOS 的架构。EverOS 将记忆细分为六大类,并通过语义巩固、主动上下文重建等技术优化记忆的抽取、更新与检索。文章还包含 EverOS 的 API 调用示例及 20 个真实落地场景,为开发者提供了 Agent 记忆系统的全景指南。
文章引用经济学家杰文斯关于煤炭的悖论,指出效率的提升会导致需求的爆炸性增长,而非减少。作者将此逻辑应用于AI时代的犹太经典学习:尽管大语言模型(如Yochai)大幅降低了获取传统知识的门槛,但这并不会取代拉比,反而会释放对“洞察力(Chiddush)”的巨大需求。当获取知识的成本极低时,瓶颈转移到了从旧材料中产生真知新见的能力上,而这才是学习的终极目的。
本文分析了 Andrej Karpathy 关于 LLM 输出 HTML 格式的观点。Karpathy 从神经科学角度指出,视觉是 AI 偏好的输出,HTML 是通往未来“神经模拟”的必经之路。作者结合自己的观察,对比了用户行为与科学原理的异同,并提出了 Karpathy 未尽的两个观点:一是输入端(人机交互)的滞后,二是 HTML 可能因工程上的局部最优而长期存在,不仅是过渡方案。
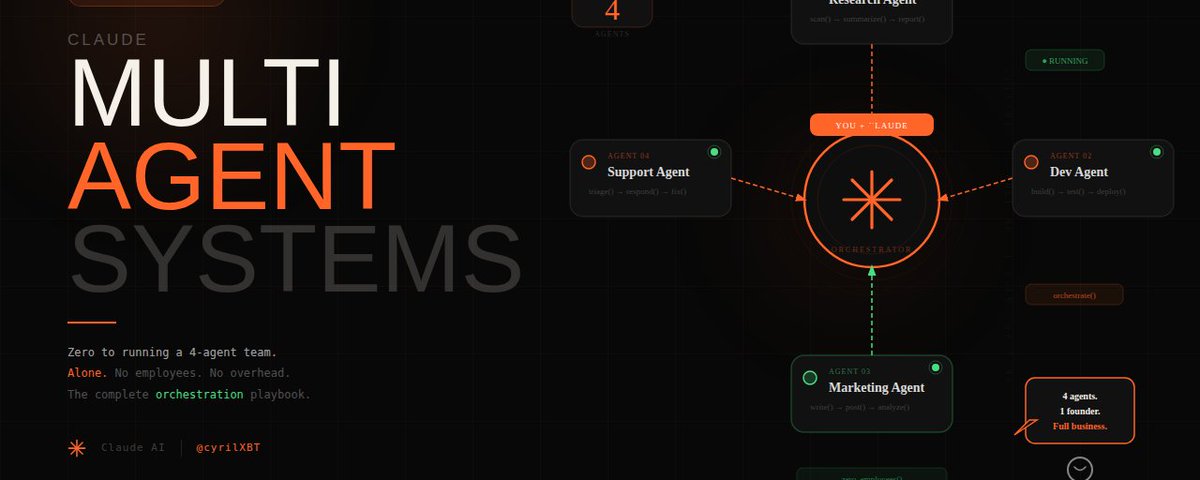
本文详细介绍了如何利用 Claude 构建一个多智能体系统。文章主张专家团队的表现优于单打独斗的通才,通过设立研究、生产、质量和分发四个专门的智能体,配合一个主编排器,可以实现高效的并行工作流。文中提供了从环境搭建、文件夹结构配置到首个研究智能体的系统提示词(Prompt)编写的完整实操指南。
文章讲述了作者作为拥有全奖 PhD 背景的硅谷工程师,在 AI 时代下的职业焦虑与转型。虽然曾参与上市 Startup 并拥有十余年技术积累,但面对 Claude 等 AI 工具的强大生产力,作者一度感到迷茫。随后,作者利用 AI 实现了个人生产力的飞跃,独立开发了 6 款产品,并深入探讨了 AI 对硅谷工作流、初级工程师生存空间以及职业断层的深刻影响。
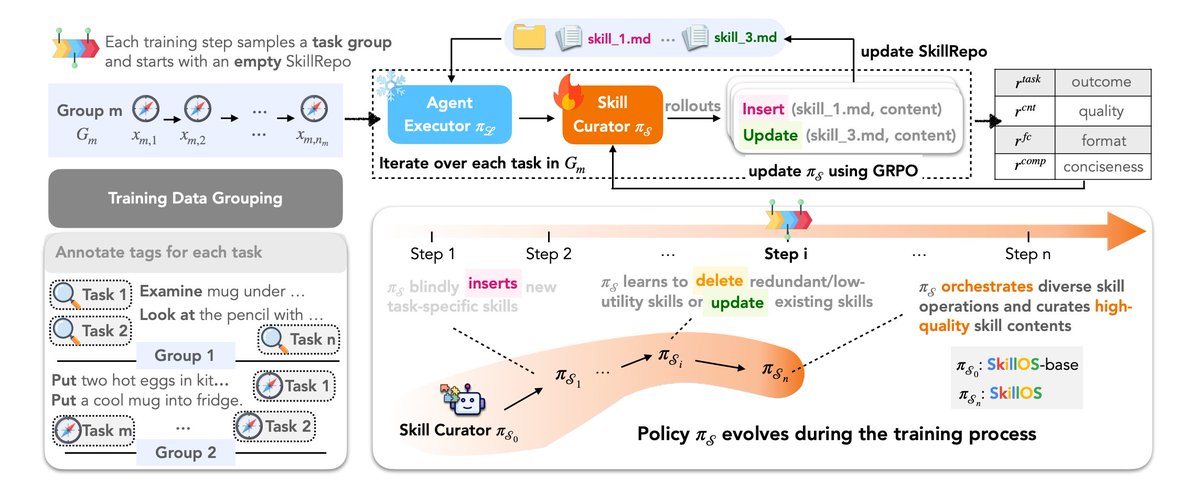
文章详细解读了 Google 关于 SkillOS 的最新论文。SkillOS 是一个帮助 LLM Agent 通过管理可复用“技能”来实现自我进化的框架。该框架包含一个冻结的 Agent Executor 和一个可训练的 Skill Curator,后者利用强化学习(RL)从执行轨迹中自动提取、更新或删除技能,从而实现从经验到技能的转化。
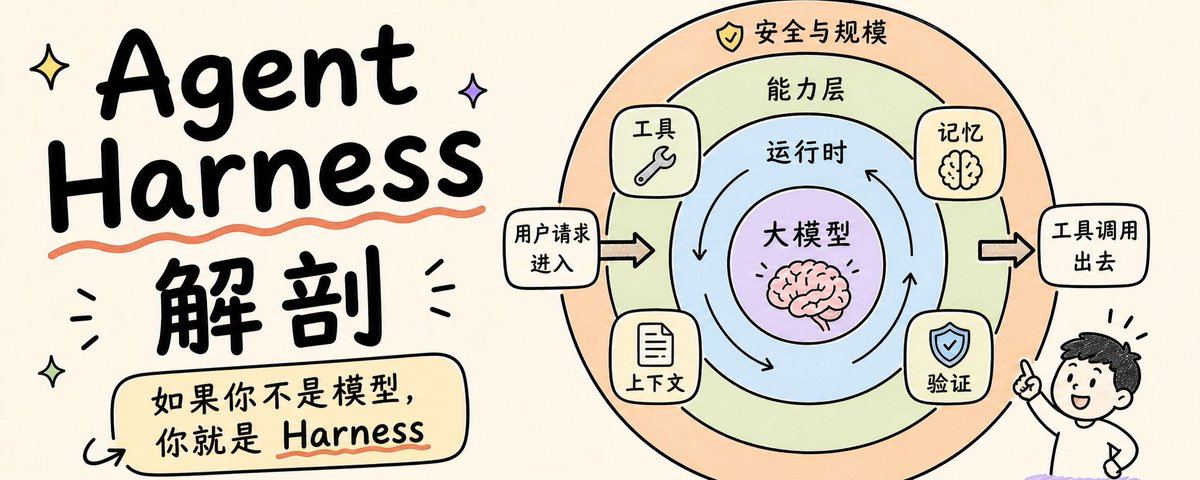
文章深入探讨了“AI Agent Harness”的概念,即包裹在大语言模型之外、使其转变为智能体的完整软件架构。作者详细拆解了生产级 Harness 的 12 个核心组件(如编排循环、工具、记忆、上下文管理等),对比了 Anthropic、OpenAI 和 LangChain 的不同实现路径,并指出 Harness 工程是决定 AI 应用性能的关键。
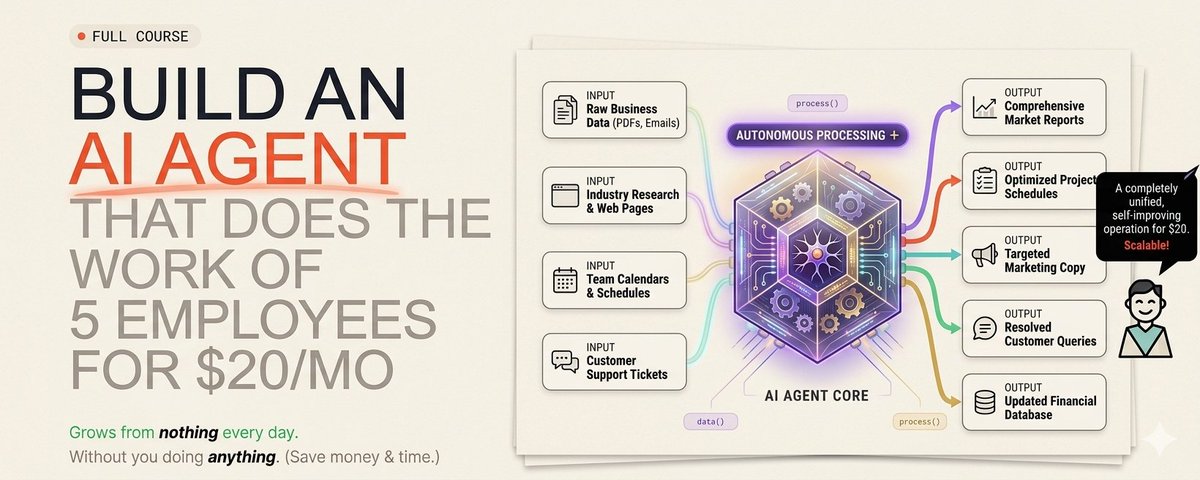
文章介绍了一套完整的多Agent系统架构,旨在通过构建5个专业化AI智能体(研究、内容、客服、运营、分析),替代初级到中级员工的工作流程。文章详细阐述了每个Agent的Prompt设计、N8N工作流自动化配置及Voice Profile(语音档案)提取方法,强调以专业化分工替代通用AI,实现高效、低成本的业务自动化。
文章介绍了如何利用 HyperFrames 和 LLM(大语言模型)构建低成本的视频生成系统。作者对比了传统图像生成模型(高昂成本、易产生幻觉)与基于代码生成(HTML)的方法,展示了如何以极低成本(低至 $0.02)生成可编辑的视觉故事。文章详细阐述了技术栈(Next.js, Vercel, AI SDK)和应用场景,如动画日志、数据视频化等。
文章详细介绍了 LoRA (Low-Rank Adaptation) 技术,这是一种用于高效微调大型语言模型的方法。通过冻结原始权重并学习两个极小的低秩矩阵,LoRA 能够在保持模型性能的同时,大幅降低显存占用、训练成本和存储空间。文章还解释了 LoRA 的核心数学原理、具体实施步骤以及为何全量微调成本高昂的原因。
文章介绍了 VectifyAI 开源的 PageIndex 框架,这是一种不使用向量嵌入的 RAG(检索增强生成)方法。它通过构建文档的层次树结构,利用 LLM 的推理能力来精确定位答案页面。该框架在 GitHub 获得了超过 2.9 万星,其构建的 Mafin 2.5 在金融问答基准测试中取得了 98.7% 的高准确率。
文章旨在通过简洁易懂的语言,帮助初学者在一下午的时间内构建第一个 AI Agent。作者指出 Agent 本质上是一个包含模型、工具集和循环的简单程序,并提出了“四步构建法”:定义目标、列出工具、选择运行时、编写系统提示。此外,文章还分享了五条实用规则(如展示工作过程、使用计划模式等)以避免常见陷阱,并列举了适合初学者的实践项目,强调构建 Agent 的核心在于理解其循环逻辑。
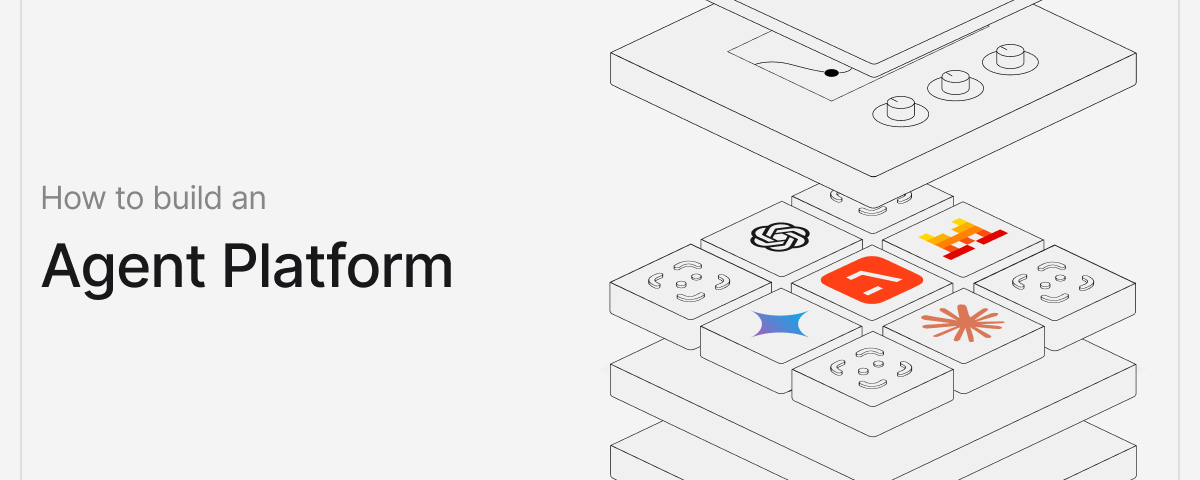
文章以云计算和数据平台的发展史为鉴,指出 Agent 时代正从分散走向整合。作者提出构建统一的 Agent 平台至关重要,该平台包含 Runtime、Storage、Connectors、Interfaces 和 Infrastructure 五大核心组件。文章提供了一套基于 FastAPI 和 Docker 的基础代码库,演示了如何在本地或 Railway 上运行平台,并利用 Claude Code 实现无需编码即可创建、测试、递归改进 Agent 以及通过 Evals 锁定行为的完整闭环。
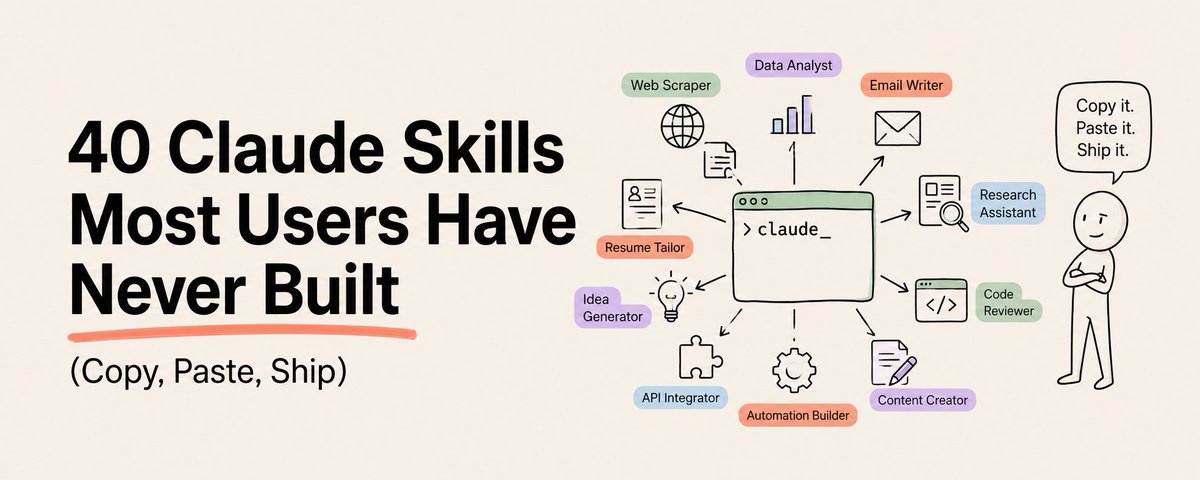
文章详细介绍了 40 个实用的 Claude Skills(技能),分为写作、研究等多个类别。作者指出 Skill 是 Claude 最强大的功能,通过创建 SKILL.md 文件,用户可以一次性构建并在多处复用特定任务指令,从而避免重复输入提示词,大幅提升工作效率。
这是一份面向学术研究者的 Claude Code 入门教程(第一至三部分)。文章指出,Claude Code 不同于浏览器端的 ChatGPT,它能直接运行在本地项目文件夹中,读取、编辑并创建文件,从而成为能实际执行任务的研究助理。教程涵盖了工具的基本定义、安装方法及如何通过 CLAUDE.md 配置文件来设定 AI 的角色与写作标准,特别强调了其在处理大量文献和数据分析方面的优势。
作者通过实验发现,仅靠简单的 Ralph 循环(重复运行相同提示词)来驱动长运行 Agent 效果有限,容易导致歧义累积和目标偏离。文章指出 Codex 的 /goal 功能虽然解决了中断问题,但存在方向性偏差和缺乏反馈的缺陷。为此,作者提出了一套更优的工作流:在开始编码前进行严格的“设置阶段”,通过 /interview 命令让 AI 提问以消除模糊性;并采用多智能体协作模式,利用编排器管理子团队,以提高任务完成的质量和准确性。