Wiki 知识库

全部文档 / 标签: deepseek

252 篇
清除

DeepSeek 成立三年后终于有 CFO 了

原高瓴创投合伙人严文韬正式加入 DeepSeek 出任 CFO。严文韬 35 岁,复旦毕业,曾在腾讯投资、H Capital 任职,2020 年加入高瓴创投成为最年轻合伙人之一,参与投资过 MiniMax、智谱 AI、字节跳动等公司。其加入正值 DeepSeek 第二轮融资接近尾声,此前公司曾举办高度保密的投资人会议并对 LP 进行严格资格审查,同时被曝筹备科创板 IPO。文章认为 DeepSeek 正在补齐大型科技公司的资本、财务和治理体系,梁文锋开始搭建班子,延续了其选人标准:年轻、聪明、懂技术、敢下注未来。

投资 › 宏观经济 Max For AI (@MaxForAI) 2026-09-222.4 KB 72

DeepSeek 采购华为昇腾芯片:The Information 报道中的细节解读

The Information 报道称,华为最早将于 2026 年 Q4 向 DeepSeek 大规模交付 16 万枚老款 950DT 芯片,用于内蒙古新数据中心,总价值约 26 亿美元,将是已知规模最大的华为 AI 芯片集群之一。文章分析指出,DeepSeek V4 延迟发布与华为芯片供应延迟有关,确定性比性价比更重要。华为昇腾芯片 2026 年实际产量受 HBM 短缺制约预计仅 20-30 万枚,远低于 75 万目标,封装产能也紧张。DeepSeek 同时自研推理芯片以避免依赖外部供应。文章认为中国大模型厂商在算力缺口下仍紧咬美国,值得尊重。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-223.3 KB 62

Jev WeChat 微信群聊助手开源项目分享

作者分享了一个开源的 Jev WeChat 微信群聊助手项目,可用 AI 自动分析群聊意图并生成候选回复,解决不懂人情世故、微信客服和群助手自动化等场景。项目发布后引发热议,网友讨论了封号风险(建议用小号测试安卓设备)、适用场景(私域运营、客服、销售、情侣群聊)、技术实现(使用 DeepSeek 生成回复)等。文中还附带分享了 Agent Space 订阅管理产品和 6 个大模型写 Space Invaders 的横向评测 benchmark,以及出海增长工作坊推荐等内容。

技术 › Agent 李韭二 (@li9292) 2026-09-2213.3 KB 36

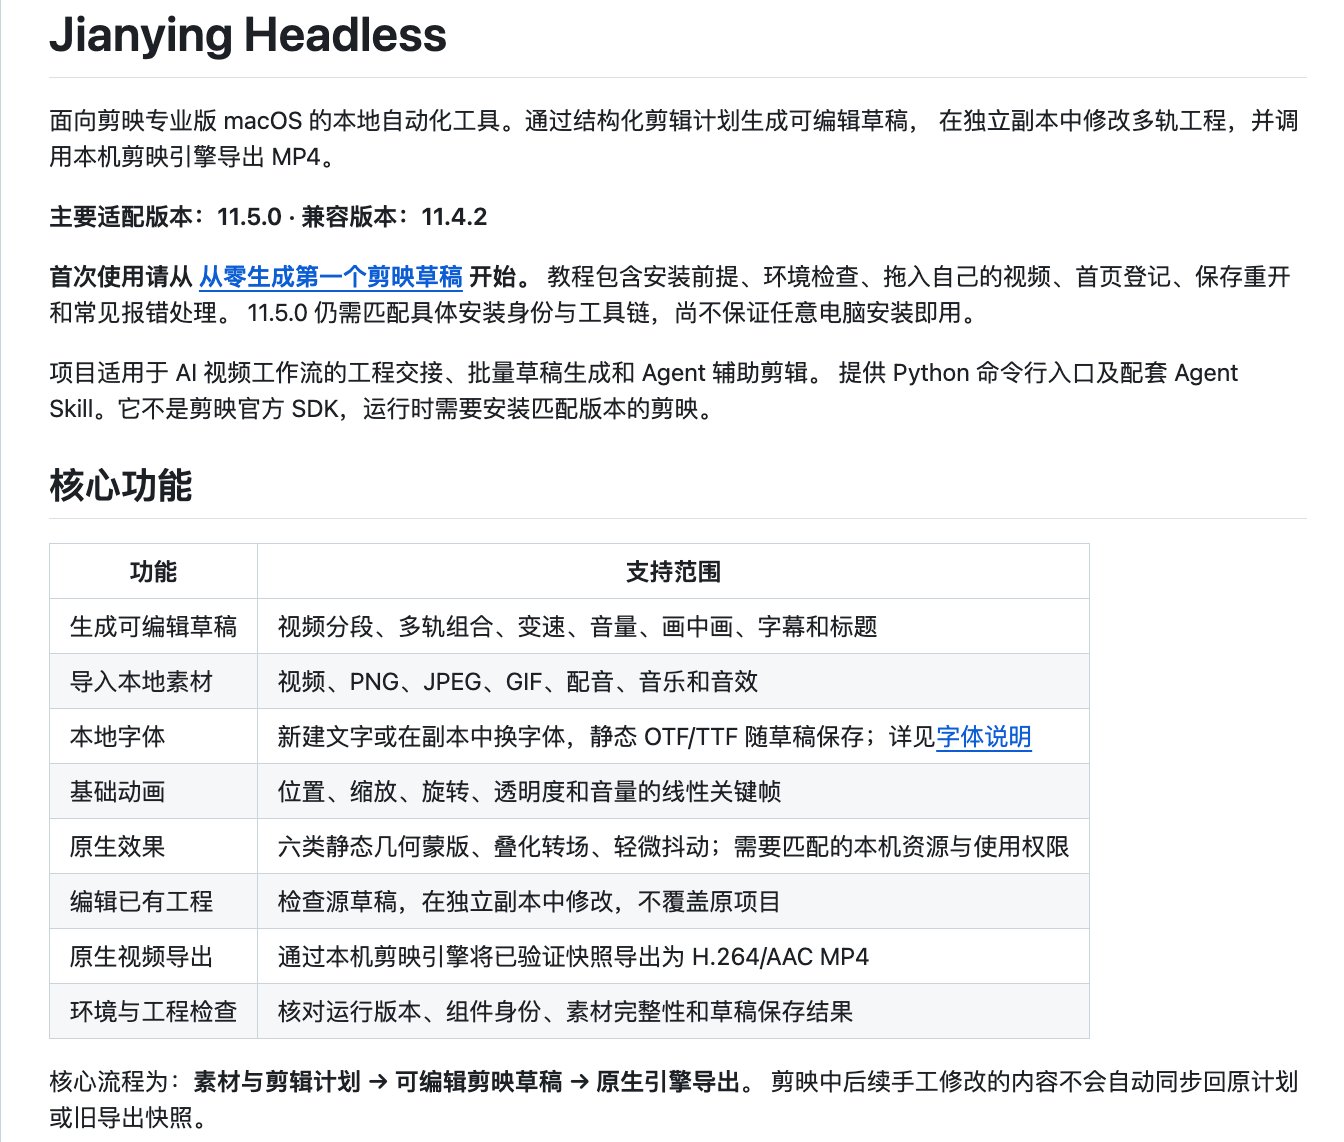
剪映推出 Agent,逸尘逆向项目开源实现无界面控制剪映

剪映官方推出 Agent,走封闭全家桶路线,能力仅限软件内并售卖 AI 会员。与此相反,逸尘开源的逆向项目 jianying-headless 将剪映控制权交还外部 Agent:可用 Codex 一条指令批量粗剪、加字幕、配 BGM;借助 DeepSeek 和豆包 ASR,一小时视频成本不到一块钱;生成的是剪映原生工程文件,可随时人工微调。作者认为这是目前最自由、成本最低的视频剪辑自动化方案,并建议大家尽快 Fork 以防项目被下架(404)。该项目替代了此前用 Computer Use 模拟鼠标操作的笨办法。

技术 › Agent 余温 (@gkxspace) 2026-09-212.2 KB 67

Build your own Jev (100% local):用开源 LLM 构建本地决策引擎

文章介绍如何将开源 LLM 变成快速、本地的决策引擎,而无需重新训练。核心思想是:当应用已知所有可能的答案时,不必让模型生成文本或 JSON,而是通过 next-token scoring 一次性为每个候选答案返回分数和概率分布。作者讲解了固定答案打分与结构化输出的区别、LLM 第一个输出 token 的生成原理,并使用 SGLang 的 /v1/score 接口,结合 Qwen 和 DeepSeek 模型进行实测,与普通文本生成进行了基准对比。文中还提到概率的含义与校准问题。

技术 › LLM Avi Chawla 2026-09-2022.3 KB 1.1M 3.1K 76

从未见过如此抽象的 AI 测评!三大AI大战屎山代码

文章介绍了B站兴起的AI测评生态:UP主用屎山代码改BUG、AI囚徒困境生存游戏、新三国梗问答、同一素材做游戏、量化交易回测等脑洞方式测试各大模型。与公开跑分榜单不同,这些由UP主临时出题、观众共同参与测评的方式避免了模型背题,更能反映AI真实能力。B站推出的AI无限竞技场将这些测评收进同一平台,29个主题、百大模型同场竞技,首期榜单第一名是GPT-6,但并非每个主题都是第一,体现了多角度测评的价值。

技术 › LLM 铁锤人 2026-09-207.6 KB 38.9K 24 61

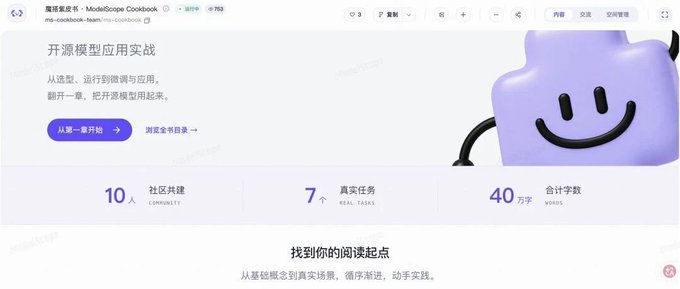
爆肝30天!魔搭紫皮书开源:系统学习AI的免费指南

袋鼠帝及其AgentWork开源社区耗时30天推出免费开源的《魔搭紫皮书》,一本约40万字、8篇34章的系统学习AI指南。与侧重AI Agent应用的workbuddy蓝皮书和豆包工作蓝皮书不同,紫皮书面向想从零深入AI领域的读者,涵盖开源模型下载、微调(ms-swift)、评测(EvalScope)、应用场景(AI健身教练、智能客服质检、语音助手等)及Agent篇(Claude Code、DeepSeek Harness等)。作者分享了自己7年前报培训班学习编程的经历,强调开源时代AI学习资源免费可得,唯一门槛是执行力。

技术 › LLM 袋鼠帝 2026-09-206.1 KB 32.5K 328 63

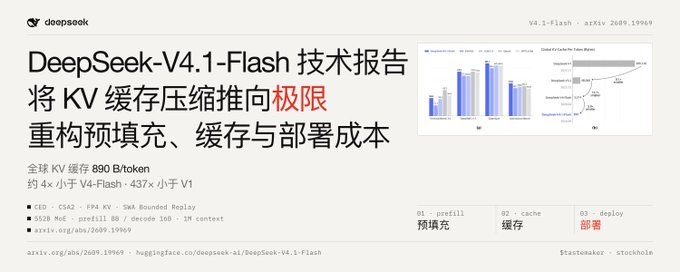
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

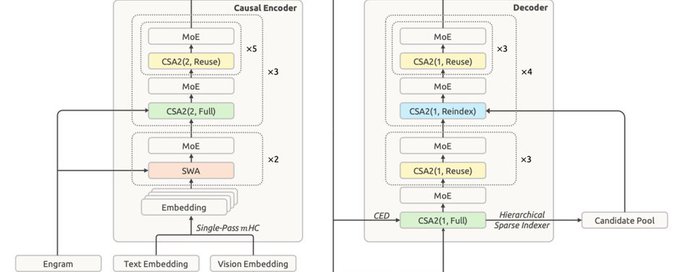
本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

一句话生成AI多智能体互动课堂

文章介绍了清华大学MAIC团队开源的多智能体互动课堂平台OpenMAIC(GitHub 36.7K Star)。用户只需输入学习主题或上传教材、论文、音视频等资料,系统即可自动规划课程结构,生成包含知识讲解、测验、互动模拟和项目任务的完整课程,并配有AI老师和AI同学。作者详细演示了使用WorkBuddy Agent在本地部署OpenMAIC的全过程,包括配置大模型API、安装OpenMAIC Skill、排查白屏问题和接入TTS/ASR语音模型,并说明了导出MP4所需的前置依赖。该项目适合个人自学、教师备课、企业培训和编程实验教学等场景。

技术 › Agent 马佳彬 2026-09-179.0 KB 1.6K 13 79

AI 工具清单:从 5 个 AI 社群 1265 个链接中整理的实用工具地图

作者潜伏于西门聪明蛋和小晚老师的付费 AI 社群,从 5 个群聊的 1265 个链接中去重筛选,整理出一份按问题分类的 AI 工具资源地图。内容涵盖五大板块:内容创作与个人 IP(赛博小晚、小红书内容导演、Humanizer 中文等)、AI 编程与模型工具(CC Switch、Codex 系列、DeepSeek Harness 等)、Skill 工作流与知识库(微信本地知识库、Obsidian 导入等)、PPT 与视觉创作(PPT Master、frontend-slides 等),以及视频与部署生产力工具。每个工具都说明是什么、适合谁、第一步怎么用,帮助读者少走弯路,解决收藏多、用得少的问题。

技术 › 工具与效率 Token神 2026-09-1621.5 KB 10.4K 46 77

我不得不把才华埋葬在昨天

DeepSeek算子工程师、北大图灵班成员刘胜自述:他亲手编写了DeepSeek V4.1的主Attention算子,但目睹AI在短短一年内从辅助工具成长为能独立阅读CUDA/PTX、优化算子的'算子大师',判断半年到一年内AI写的算子将与自己齐平甚至超越自己。他认为自己不会失业但必须'转业'——放弃热爱的算子设计,转型为Agent的'机甲驾驶员'。文章还担忧学生工程能力退化、权力超越技术等社会问题,并批评Anthropic等闭源公司掌握AGI的危险性,主张前沿智能应开放、廉价地供应给所有人。

技术 › LLM 刘胜(intlsy) 2026-09-1612.3 KB 659K 1.1K 67

DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

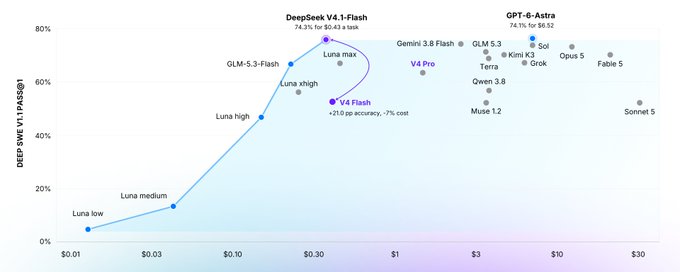
Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

DeepSeek kernel 工程师自述:亲手把自己的手艺变成过时技艺,以及微信开源企业 Agent 框架 WeKnora

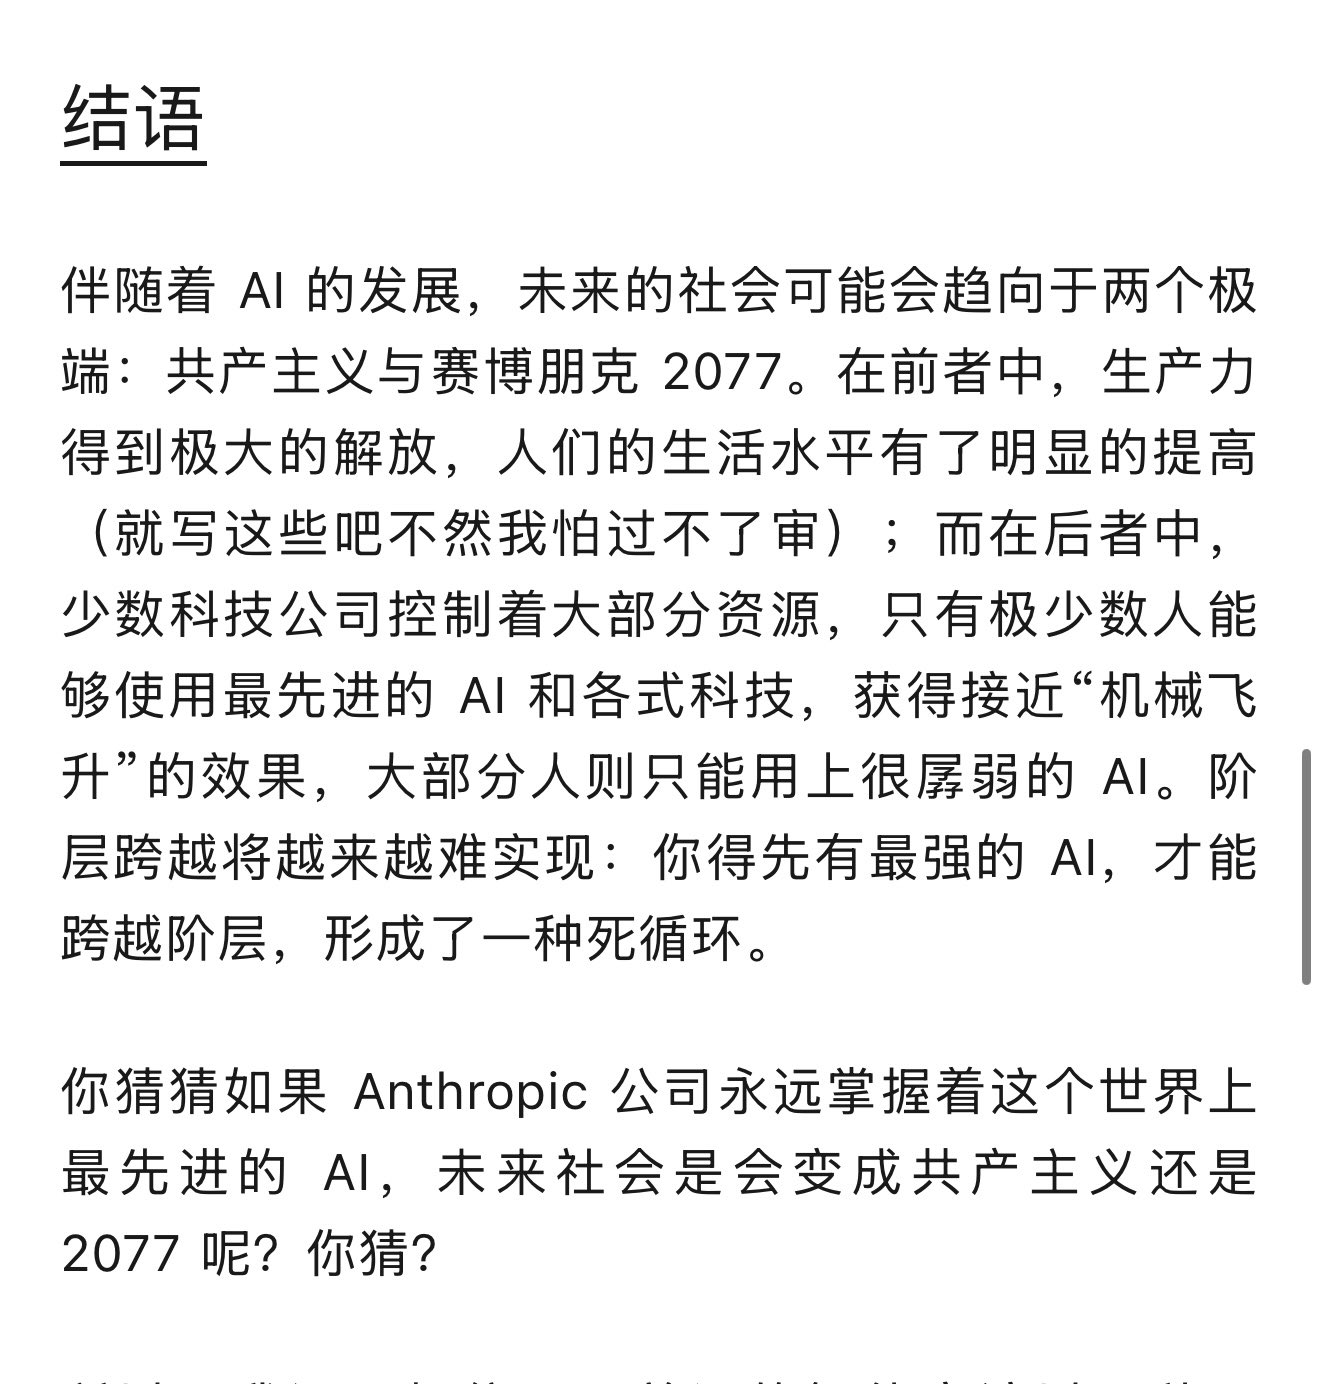
文章包含两条内容:一是 DeepSeek kernel 工程师 Shengyu Liu 的长文,讲述 AI 已能自主分析 CUDA/PTX/SASS 并优化 kernel,他预判半年到一年内 AI 写的 kernel 可能超过自己,工作将从亲手写代码变为驾驶 Agent,并担忧未来社会走向共产主义或赛博朋克两极,因此选择留在 DeepSeek 推动开源 AI。二是微信团队开源的 WeKnora 框架,已从 RAG 系统进化为企业 Agent 基础设施,提供知识处理、ReAct Agent、Sandbox 执行环境、长期记忆和 Auto-Wiki 能力,代表 RAG 向企业 Agent Context + Runtime 的迁移趋势。

技术 › Agent Max For AI (@MaxForAI) 2026-09-157.3 KB 70

DeepSeek kernel 工程师:亲手把自己最热爱的手艺变成过时技能

DeepSeek kernel 工程师 shengyu Liu(interestingLSY)撰文讲述 AI 对自身职业的冲击。他负责 DeepSeek V4.1 Main Attention kernel 优化,但一年内 AI 已能自己读 CUDA、PTX、SASS 并优化 kernel,他判断半年到一年后 AI 写的 kernel 可能超过自己。他真正难受的不是失业,而是工作从亲手写 kernel 变成驾驶 Agent 写 kernel,多年练就的手艺不再重要。他还担忧社会将走向两个极端:生产力极大释放的共产主义式未来,或极少数公司垄断最强 AI 的赛博朋克式未来。他选择留在 DeepSeek 开源更强的 AI,把世界往好的一端拉。

技术 › LLM Max For AI 2026-09-153.0 KB 59

DeepSeek 官方竟然偷偷做了 Harness 桌面端

作者发现 DeepSeek 官方悄悄在 GitHub 仓库中合入了基于 Electron 的 Harness 桌面端应用,未发任何公告。文章介绍了作者自行编译运行官方桌面端的过程:安装 pnpm、克隆仓库、启动开发模式,并测试了对话、文件操作等功能。作者对比官方版与社区桌面端,指出官方版本在安全性和版本管理上更有优势:不开本地端口、使用自定义协议传输数据、整体签名发布与统一更新。官方版目前仍处早期,需自行从源码构建,未来有望正式分发安装包。

技术 › Harness Engineering 程序员鱼皮 2026-09-147.2 KB 13.1K 32 83

图解 KV Cache——DS V4.1-Flash的制胜秘密

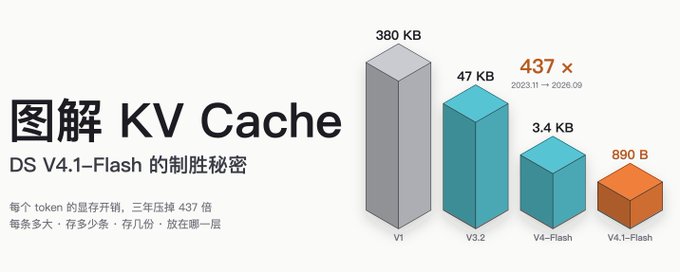
本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

大开眼界:把 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 思路移植到 Qwen3-8B

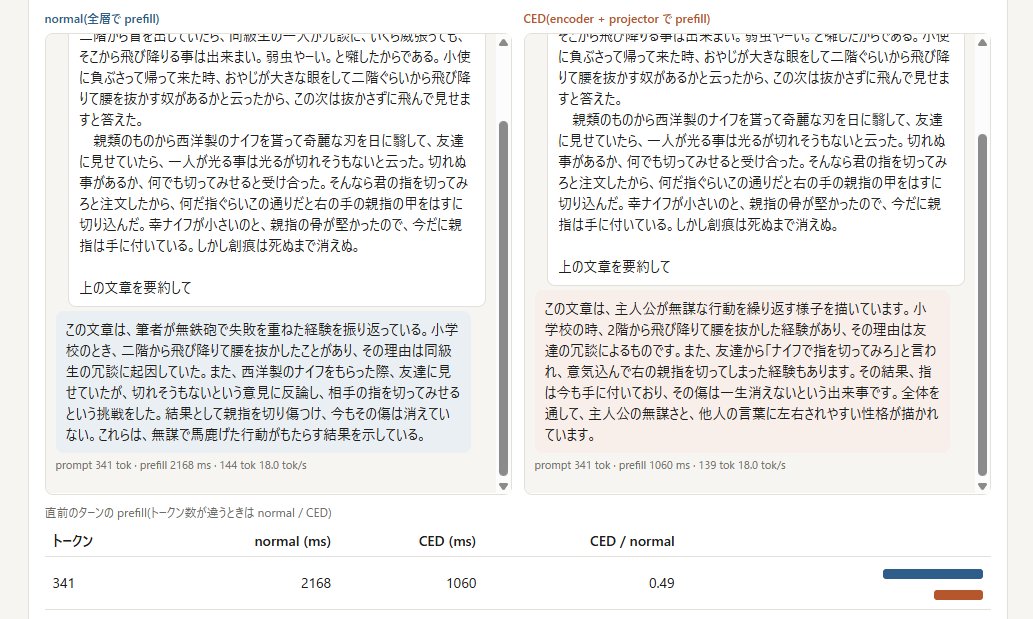
文章介绍了一项实验:研究者将 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 机制移植到现有 Qwen3-8B 上,不修改原模型权重,仅外挂一个小模型近似后半层 KV Cache,使 Prefill 时间缩短近一半且输出一致。作者分析了这对本地模型部署(尤其 DGX Spark)的重大意义:长上下文首 token 等待明显降低,KV Cache 内存占用减少,Coding Agent、Computer Use Agent 等本地工作负载体感大幅提升。文章同时指出结果尚需在更多任务上验证,但认为已有模型可通过轻量近似层获得架构级推理升级。

技术 › LLM Wei (@wei_wang) 2026-09-135.5 KB 75

LLM 为什么缓存 K 和 V,却通常不缓存 Q?

本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。

技术 › LLM Dongxi 东锡 NLP 2026-09-139.5 KB 196.7K 623 82

DSH Desktop 桌面端架构解析

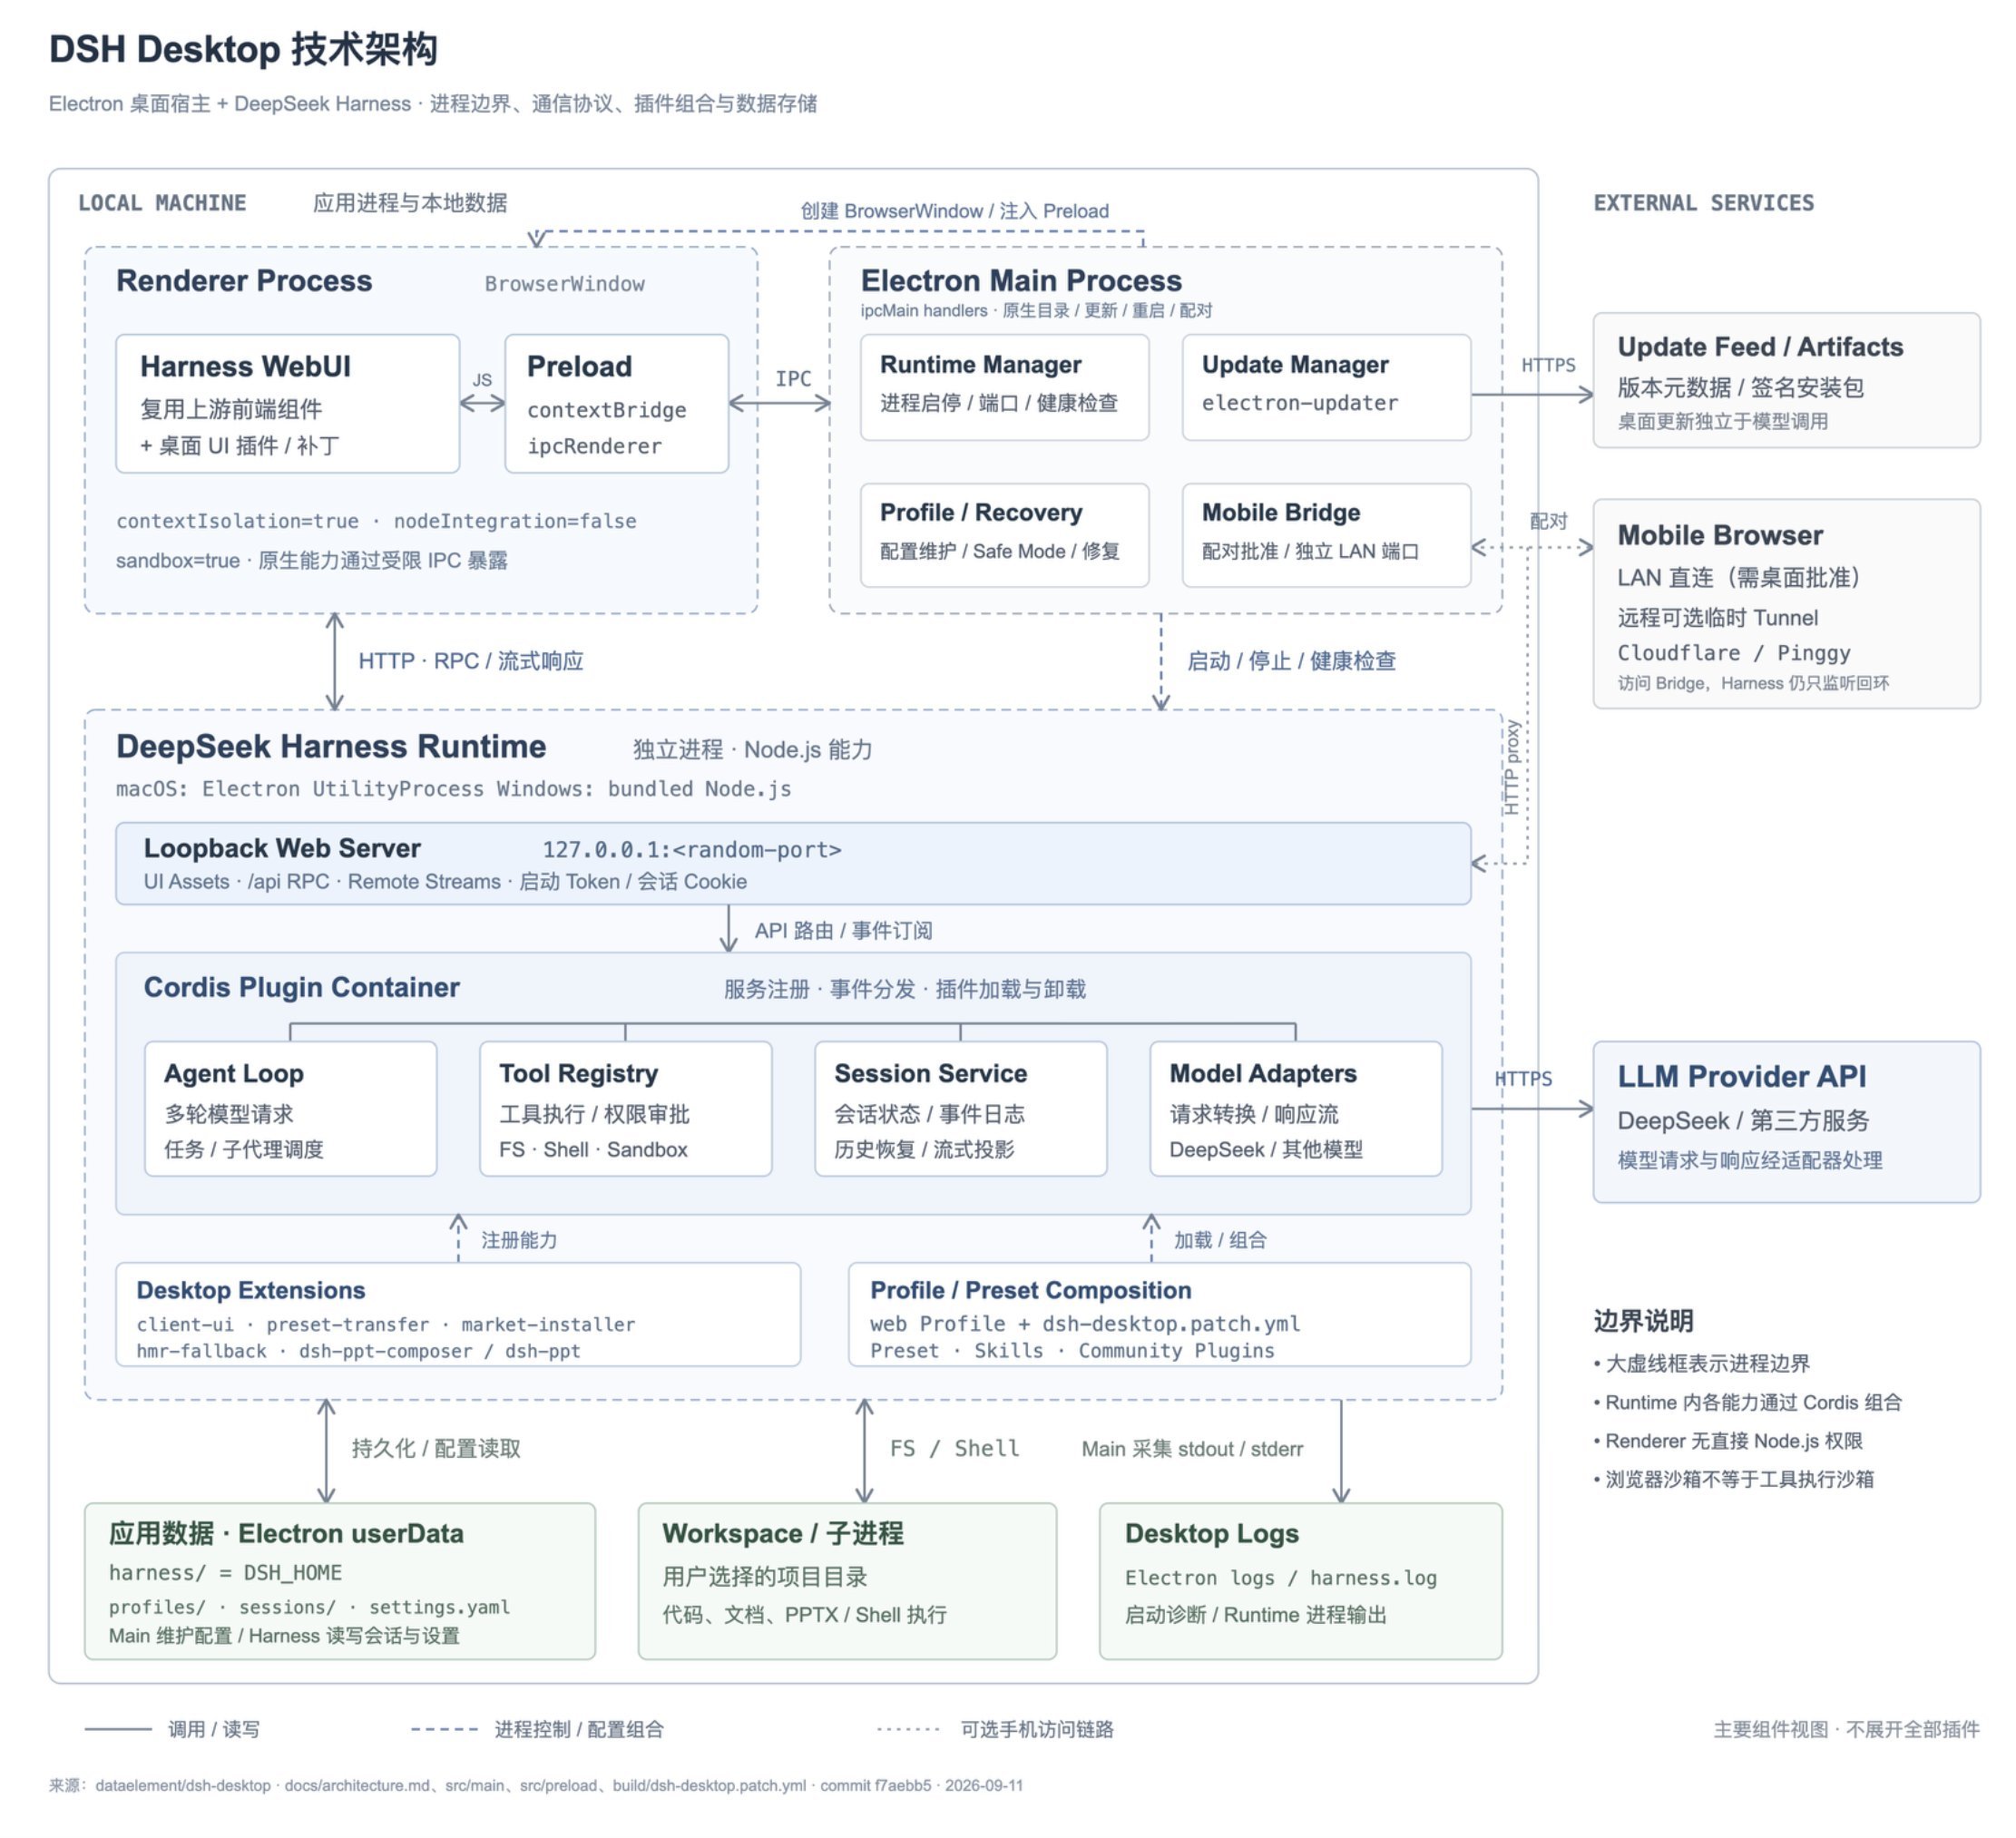
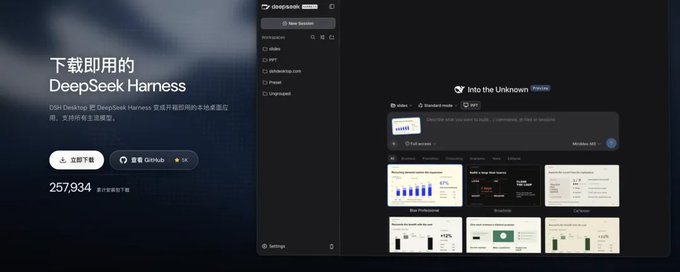
作者分析了 DSH Desktop 桌面端的整体架构:Renderer 进程负责显示 Harness WebUI,Main 进程负责窗口创建、Harness 启动、更新与配置修复,两者通过 Preload 和 IPC 通信。聊天与任务执行走独立的本地 HTTP/RPC 通道,连接 Harness Runtime 独立进程(macOS 用 Electron UtilityProcess,Windows 用自带 Node.js),仅监听本地回环随机端口。Harness Runtime 基于 Cordis 插件组合,包含 Agent Loop、Tool Registry、Session Service 和模型适配器,并扩展了 Preset 导入导出、插件市场和 PPT 生成等能力。本地数据与安装目录分离便于升级保留配置,模型 API、更新和手机接入(Mobile Bridge)等外部服务各自独立。

跟 WebUI 说再见了,最强 DeepSeek 桌面端来了!

作者认为 DeepSeek Harness 的 WebUI 方式和 CLI 各有不足:浏览器难以管理长期运行的 Agent 会话,CLI 则在多任务时难以区分上下文。作者推荐 dataelement 社区(BISHENG 团队)开发的 DSH Desktop,一款 DeepSeek Harness 桌面端。相比其他竞品,它上手门槛低、有故障诊断与 Safe Mode、并提供企业版。作者实操演示了配置流程、PPT 一键生成、插件市场和 Agent Preset 广场等功能,并拆解了其 Electron + Harness Runtime 的技术架构:桌面宿主接管窗口、进程、更新与配置,Harness Runtime 继续负责 Agent 执行。

技术 › Harness Engineering cxuan 2026-09-1211.8 KB 55.8K 143 76

从 0 到 1 搭建你的 Harness,定制化你的个人工作台

文章介绍了作者开发的三个围绕 Harness 的 Skill:star-your-harness 用于从零搭建个人 Agent 工作台,通过四个问题生成目录骨架;better-your-harness 用于诊断已有文件夹,从安全隐私、上下文质量、工具装备、记忆学习五层扫描并生成 HTML 报告;view-your-harness 用于可视化展示项目文件和 Skill 调用情况。作者认为 Harness 是模型之外让模型能干活的整套结构,搭建个人 Harness 能让工作在不同 Agent 间无缝衔接。

技术 › Agent 空格.space 2026-09-116.6 KB 30.3K 281 79

DeepSeek V4.1 Flash:架构学习笔记

本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。

技术 › LLM AI Dance 2026-09-1113.1 KB 21.3K 203 79

高强度使用 Pi Agent 开荒企业级工作流的经验分享

作者作为金融业IT,在公司 DeepSeek 一体机上下文受限(128k)的情况下,将 Pi Agent 部署到内网,一周消耗几十亿 token。他通过两大'开荒'工作提升 Agent 效能:一是将内网系统流程封装为 CLI,为全自动工作流做准备;二是结合自身业务理解建立代码索引与知识库。实践半个多月,进度约40%。作者感悟:业务理解能力的重要性大于模型本身能力,在适当指导和知识库辅助下,Pi 能完成真实企业级全流程开发。他通过 10 个拓展和 20+ SKILL 将 Pi 打造成专属业务 Agent,并推荐大家创造属于自己的 Agent。

技术 › Agent 劳伦斯 (@LawrenceW_Zen) 2026-09-112.9 KB 65

BestBlogs 早报 · 09-11|DeepSeek 降缓存成本,Magic 验预训练效率,Shopify 原生化

本期早报聚焦 Agent 能力落地过程中的工程变量与真实收益。精讲三篇:DeepSeek V4.1 Flash 通过大幅缩减 KV Cache 降低长上下文推理与缓存成本;Magic 用保留集、缩放律和防数据泄漏评测验证预训练配方的十倍效率提升,强调跨规模验证的重要性;Shopify 因编码模型降低双端实现成本,从 React Native 转向 Swift/Kotlin 原生开发,并通过 Helix 流程保证 AI 生成代码的可交付性。速览部分涵盖 Cognition SWE-2 的成本-能力 Pareto 优化、Agentic Harness 工作流框架、Anthropic 网络安全事件对齐复盘、规范驱动开发研究、LinkedIn 企业 Agent 的 Skills 实践与 Bolt CEO 关于原型到生产代码的访谈。

技术 › LLM ginobefun 2026-09-1123.0 KB 2.6K 2 79

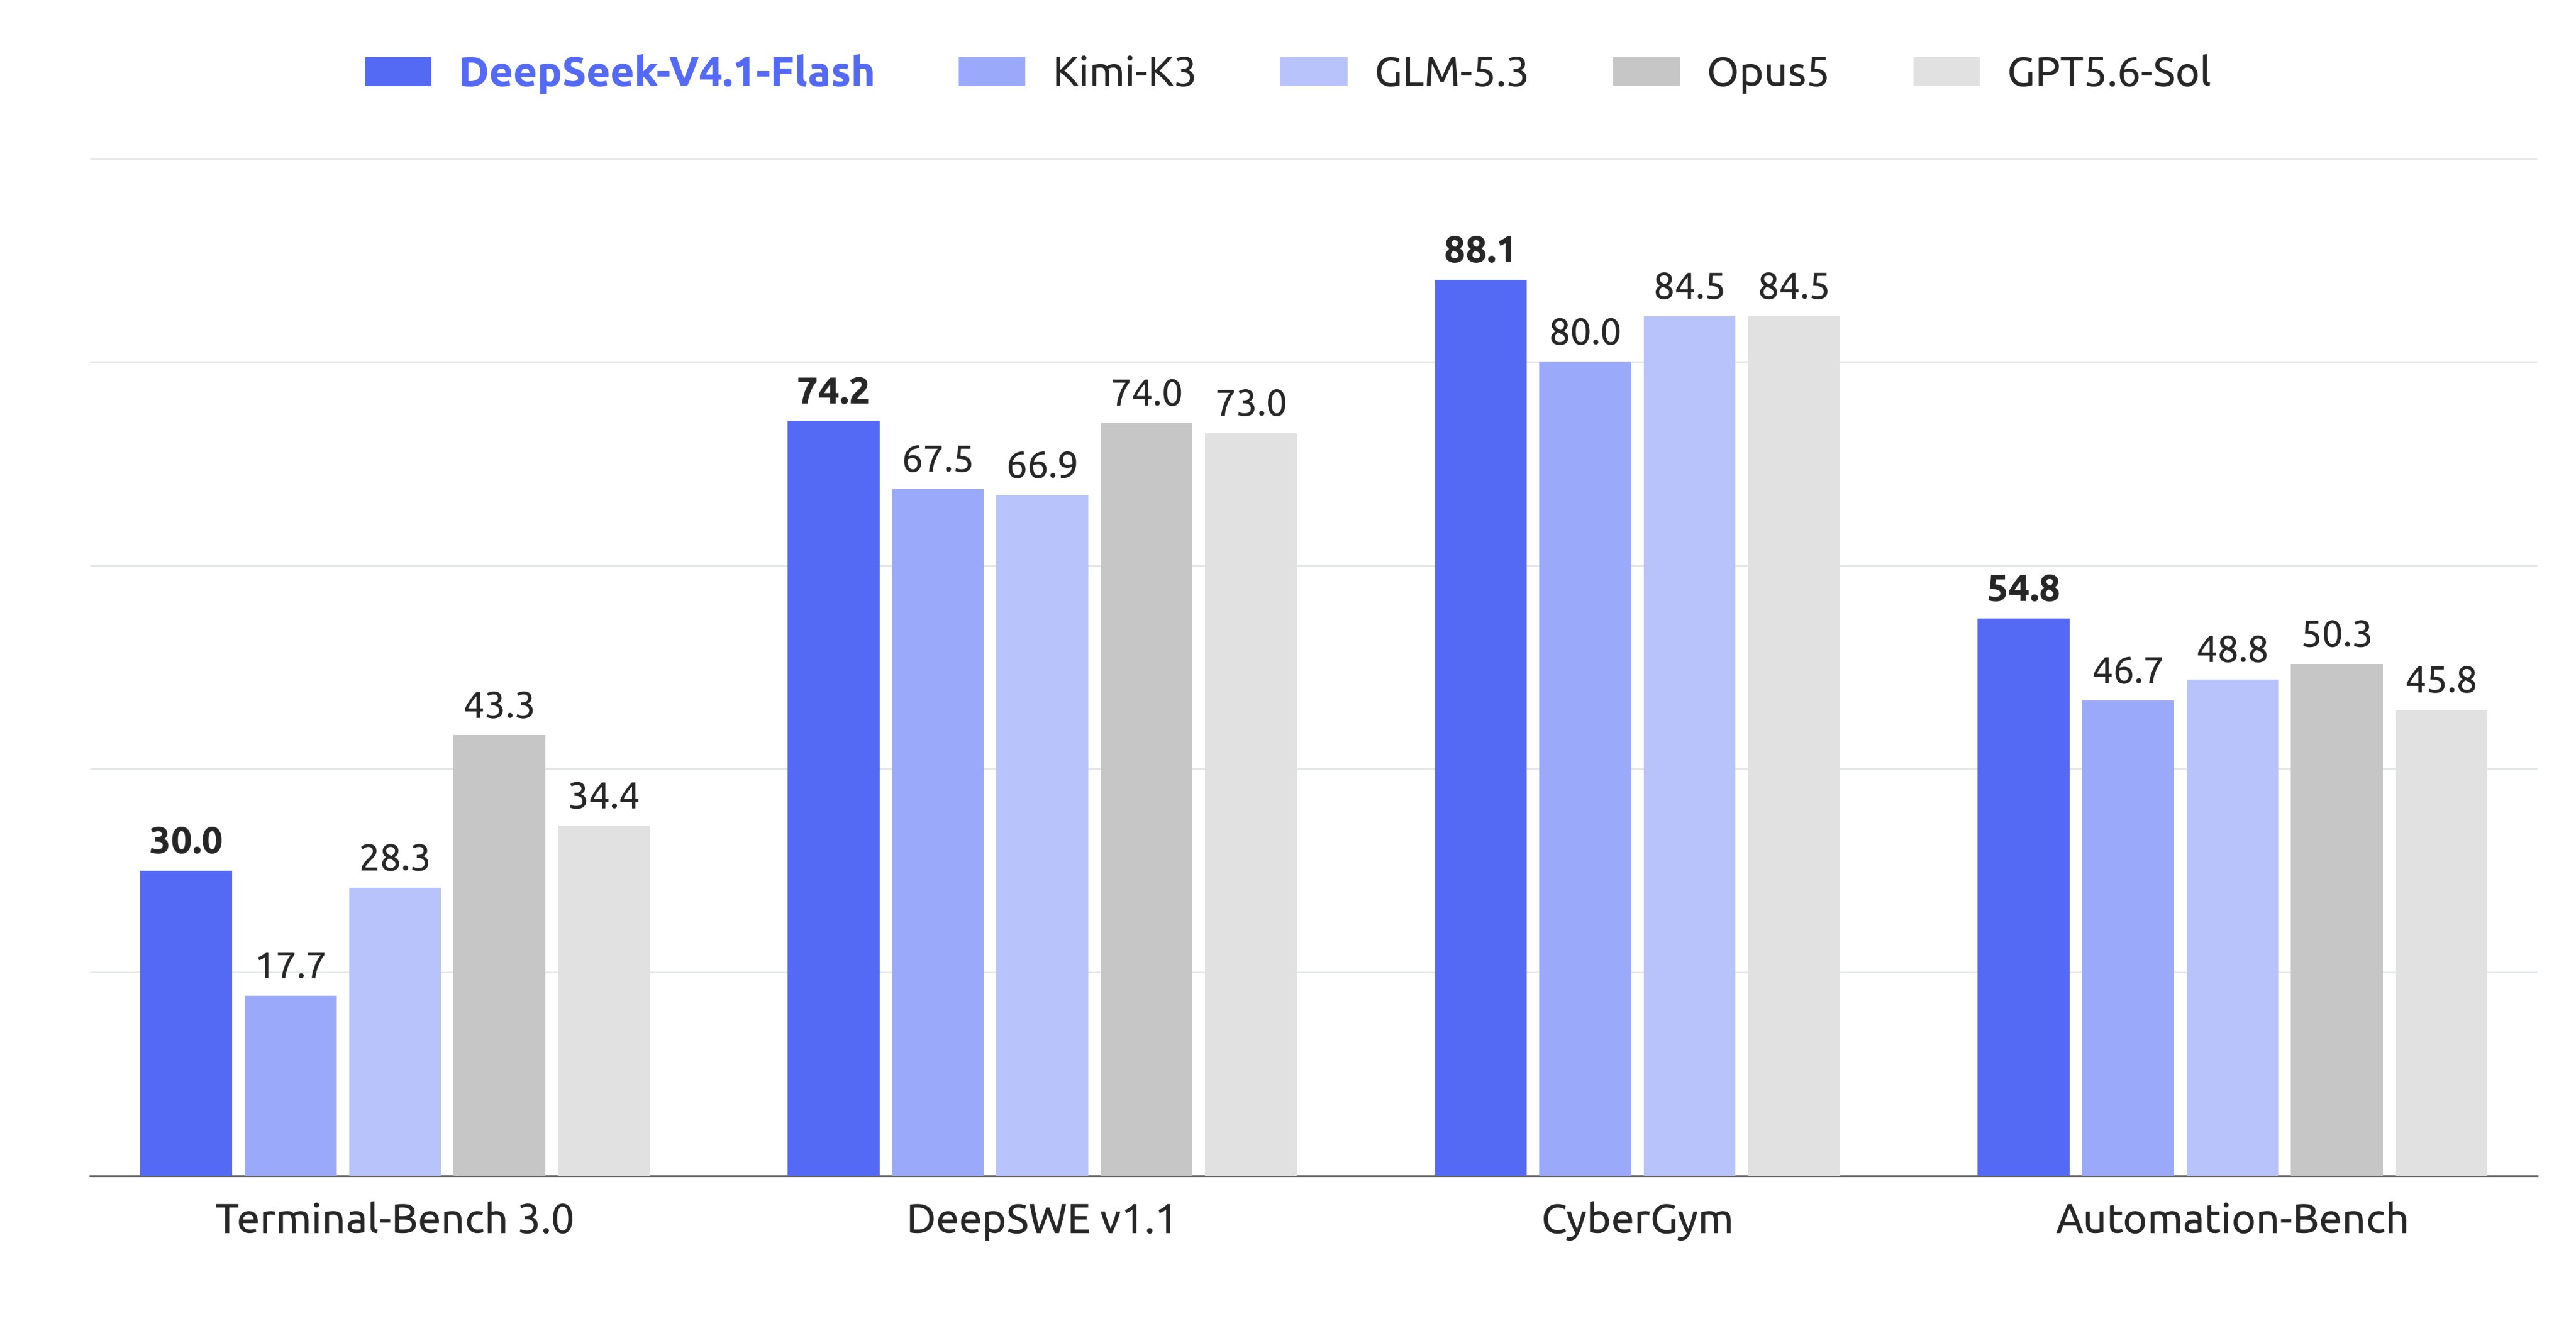
DeepSeek-V4.1-Flash 发布:更聪明、更快速、更高效

DeepSeek 发布新架构家族中最小的模型 V4.1-Flash,具备原生视觉理解能力。该模型采用非对称因果编码器-解码器架构,552B 参数 MoE,仅 8B 激活参数用于输入、16B 用于输出,通过新预训练方法和大规模 RL 后训练,性能超越旗舰模型 V4-Pro。KV 缓存仅需前代 1/4 的 HBM 和 1/8 的 SSD 存储,大幅降低 Agent 成本。模型已上线 DeepSeek API,支持多模态,API 价格下调,非高峰时段费率为峰值的 50%。官方将与开源社区合作推进推理支持,模型已在 HuggingFace 开放。

技术 › LLM DeepSeek (@deepseek_ai) 2026-09-103.3 KB 73

DeepSeek V4.1 Flash 正式发布,全面超越自家 Pro 模型?实战测评

DeepSeek 发布 552B 参数的开源 MoE 模型 V4.1 Flash,原生支持多模态视觉理解,官方称其性能、费用、速度全面超越 V4 Pro,V4 Pro 将于 9 月 14 日下线。作者通过两个实战项目(3D 程序化城市生成器、基于 draw.io 的 AI 智能绘图工具)横向对比 V4.1 Flash、V4 Pro 和 GLM-5.3-Flash。结果显示 V4.1 Flash 完成度最高,输出速度达 287 TOK/s,成本仅约 5 元/项目,多模态能力让前端开发质量明显提升,最终结论是梁神回归,可重新推荐为日常 AI 编程模型。

技术 › LLM 程序员鱼皮 2026-09-1012.8 KB 4.8K 12 73

被劫持的审美:当AI前沿公司失去叙事权力

文章以DeepSeek V4 Pro和DeepSeek Harness(DSH)上线引发的舆论风波为切入点,分析了'国运级产品'叙事如何反噬DeepSeek:用户的过高期待与负面情绪在模型表现不佳和涨价后集中爆发。作者指出群体欲望的投射剥夺了深度求索的叙事权,公司沉默使其成为任人解读的玩偶,研发自由也受舆论胁迫。文末升华至AI时代审美的思考:技术无法填平欲望的沟壑,真正的美在于帮助人们减少被奴役、活成自己,去体验、判断与共情。'无用亦无欲,方为至美'。

技术 › LLM Clare Chen 2026-09-106.1 KB 1.5K 7 52

不会写代码也行:从0到1手搓一个能用的生活App

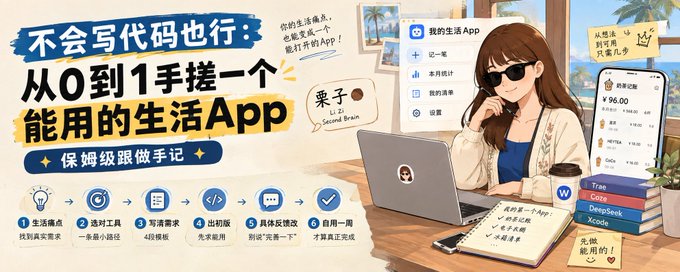
文章介绍零基础用户如何借助 AI 工具(Coze、Trae、DeepSeek、MiniMax Code 等)从 0 到 1 手搓一个自己能用的生活小 App。核心流程为:发现生活痛点 → 只做一件事 → 用「谁用、痛点、最小三屏、不要什么」模板写清需求 → 生成初版 → 用具体反馈迭代 → 自用一周验收。文章强调避免需求膨胀、只生成不调试、一上来就上架等六大坑,并以奶茶记账、电子衣橱、冰箱临期提醒三个可复制案例演示具体做法,主张先用起来再谈美化与上架,最终把方法变成可复用的生活工具系统。

技术 › 工具与效率 沈美丽子 2026-09-0912.9 KB 14.3K 41 81

vLLM x AgentX: Optimizing for Real-World Agentic Serving

本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。

技术 › LLM vLLM 2026-09-0931.2 KB 41.2K 328 78

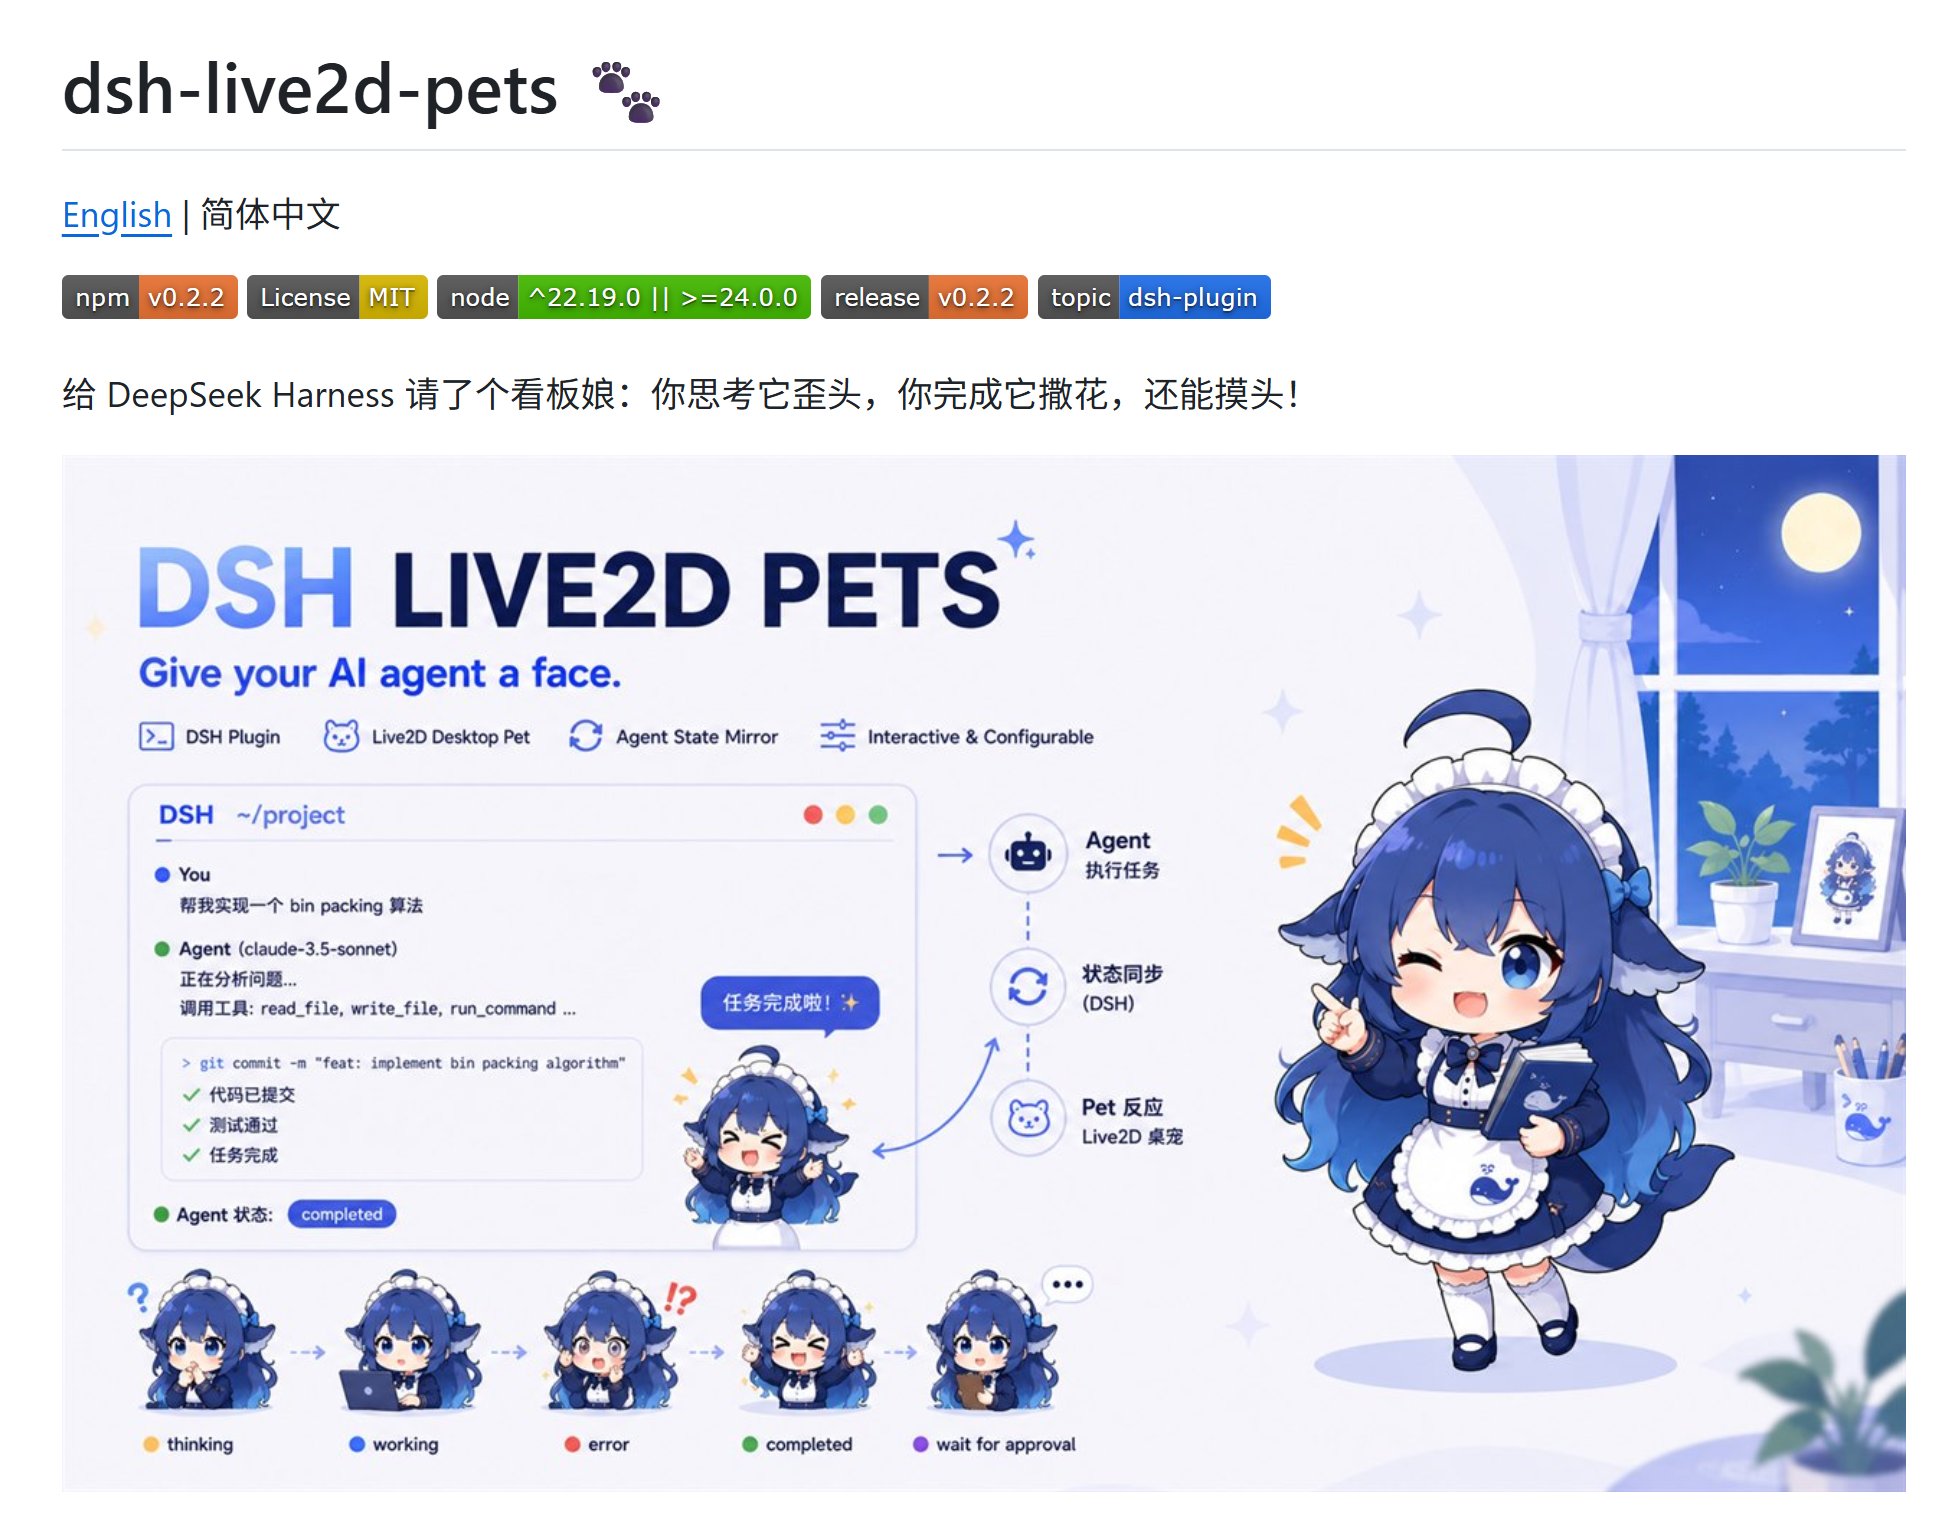
DeepSeek Harness 的 Live2D 桌宠插件 dsh-live2d-pets

作者介绍了一款 DeepSeek Harness 的 Live2D 桌宠插件 dsh-live2d-pets。该插件能在写代码时提供互动陪伴:内置 Hiyori/Haru/Mao 等 5 款模型,支持人设选择(傲娇、元气、三无、病娇等),眼睛跟随鼠标、可拖动摆放,还有 51 段动画包括发呆、打瞌睡、散步、玩魔方等互动效果。作者还将其从原平台迁移到了 Windows,支持桌面闲逛、置顶、开机自启、多实例生成。安装方式非常简单,只需复制一句指令给 Agent,通过 dsh plugin 命令即可完成安装。项目已开源在 GitHub。