Wiki 知识库

全部文档 / 标签: Deepseek

252 篇
清除

我给 DeepSeek Harness 做了个 zvec-grep 插件,实现基于语义的高效文本检索工具

作者基于阿里巴巴开源的进程内向量数据库 zvec 及面向代码仓库的语义检索工具 zvec-grep,开发了一个 DeepSeek Harness(DSH)插件 dsh-zvec-grep。文章是开发笔记,先通过真实仓库实验确认语义搜索的价值:在不知道代码命名时提供更好的“第一跳”,与 rg 精确搜索形成互补。插件没有简单包装 CLI,而是直接使用 createZvecGrep() 引擎 API,以 workspace 为运行时边界共享索引与 watcher,实现自动索引、增量更新与每小时校准,并通过状态胶囊向用户暴露索引进度与错误,退出时用 AbortController 清理资源。作者总结插件设计理念:替用户承担复杂度,暴露不确定性,让语义搜索负责模糊发现、精确搜索负责已知匹配。
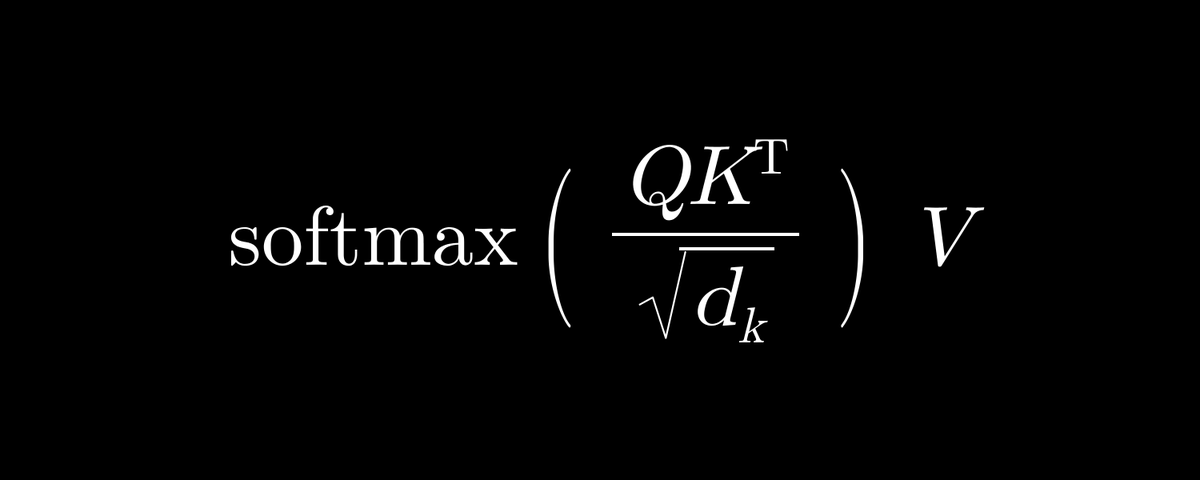
技术 › Agent VerySmallWoods 2026-09-0713.7 KB 4.6K 24 82

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。
技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

绝非玩具|DeepSeek Harness爆改一站式创作工作台

作者基于开源的 DeepSeek Harness 桌面版,融合内容创作插件与自研运营工作台,打造了一套覆盖选题、脚本、录制、字幕、封面、发布到复盘的完整短视频创作工作台。灵感通过绿芽快捷入口随时记录,进度由本地文件自动判断;AI 写脚本前会读取预设的人设、结构与禁忌词规则,并可勾选历史复盘经验辅助创作。字幕分转录校对和人工确认烧录两步,封面一次生成三种画幅,图文可转写至公众号。发布支持四大平台并自动回收数据,运营看板汇总今日推进、档期规划、内容管线等模块。复盘沉淀为规则反哺后续创作,所有内容均以本地文件保存,保障数据主权,项目已开源。

技术 › Harness Engineering Jacky无限生长 2026-09-0212.7 KB 6.4K 35 87

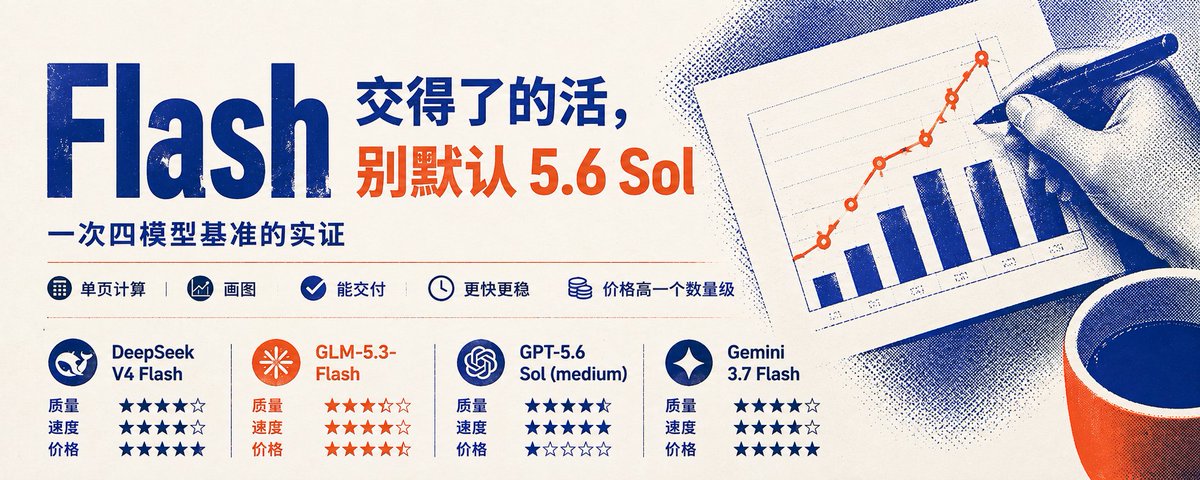
Flash 交得了的活,别默认 5.6 Sol:一次四模型基准的实证

作者通过同一 Hermes Agent、同一数据目录和任务,对 DeepSeek V4 Flash、GLM-5.3-Flash、Gemini 3.7 Flash 和 GPT-5.6 Sol 四个模型进行单页计算与画图任务的基准测试。结果显示,Flash 模型已能胜任此类任务,其中 DeepSeek V4 Flash 用时最短且成本最低,GPT-5.6 Sol 虽稳定但价格高一个数量级。作者建议默认使用 Flash,将 Sol 作为备选,并强调测试的局限性与诚实声明。

技术 › LLM Kimberly 2026-09-017.7 KB 8.6K 15 81

实测智谱 GLM-5.3-Flash,我称之为能稳稳把 DeepSeek 纳入斩杀线

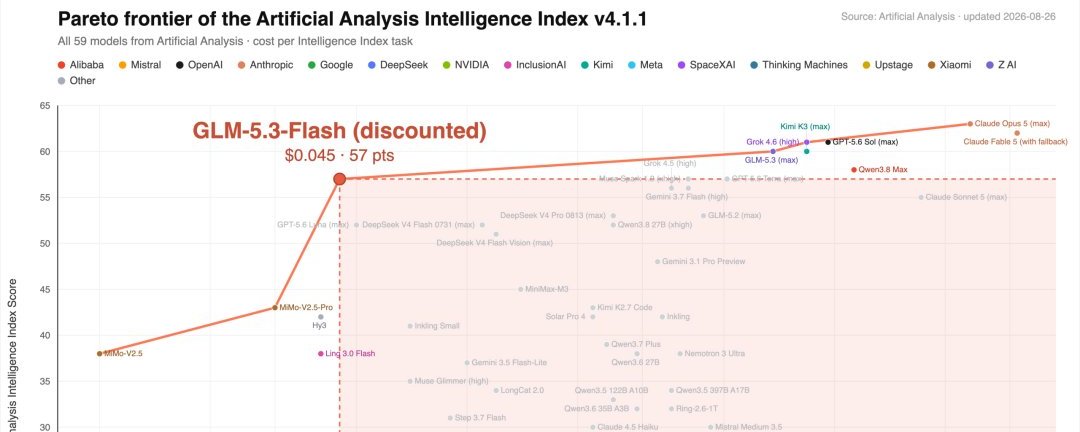
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。

技术 › LLM 卡尔的AI沃茨 2026-08-3111.6 KB 1.9K 1 71

如何用 WorkBuddy 和手头资料,做成交互式智能问答网页?

本文详细记录了作者在广州某高校图书馆 AI 工作坊上,带领学员使用腾讯 WorkBuddy 将手头资料(如数据表、规章文件)制作为交互式智能问答网站的完整过程。文章涵盖:让 WorkBuddy 生成可视化网站、接入 DeepSeek API 实现自由问答、通过中转函数保护 API key 安全、用 Codex 操控 Chrome 自动完成腾讯云部署等环节。作者还分享了 API key 三道安全防线、部署踩坑经验(教程过时、云函数超时、日期偏差排查)以及成本控制(全班提问仅花两毛二),并强调数据授权与隐私边界的重要性。

技术 › LLM Wang Shuyi 2026-08-3018.8 KB 11K 70 82

到底谁才是国内模型第一?

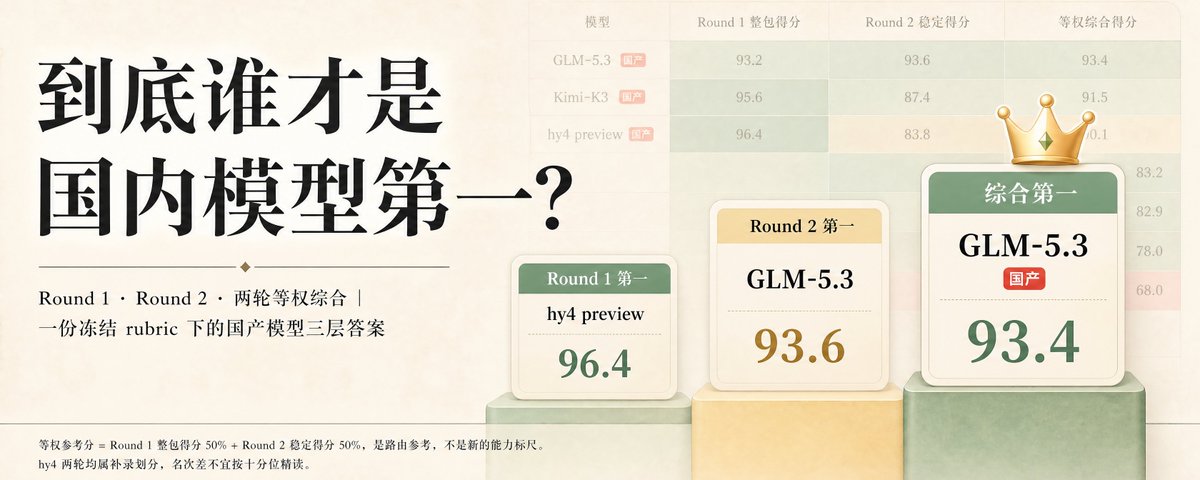
作者基于一份冻结 rubric 的自建评测(10 维 × 5 细项),通过 Round 1 超长整包和 Round 2 拆题稳定两轮测试对比八个大模型。Round 1 整包交付第一是 hy4 preview(96.4 分),Round 2 拆题稳定第一是 GLM-5.3(93.6 分);综合等权评分 GLM-5.3 以 93.4 分居国产第一,Kimi-K3 以 91.5 分列第二,hy4 因拆题时违反约束跌至 83.8 排第三。DeepSeek V4 Pro 与 Qwen3.8 Max 表现偏科,榜单前三均为国产模型。评测题面与方法已开源,结论是决定「第一」的不是最高一次成绩,而是每一次的稳定表现。

技术 › LLM huangserva 2026-08-2910.4 KB 228.8K 66 85

DeepSeek Harness 从 0 到 1 全攻略|一文读懂

文章系统介绍了 DeepSeek Harness,强调它不是单纯的模型聊天界面,而是把模型、工具、会话、沙箱、工作流、调度和 UI 都插件化的 Agent 运行框架。内容涵盖安装启动、Web UI 与远程访问的安全风险、4 种 Agent 模式的权限取舍、Trajectory 执行轨迹带来的可调试性、多模型接入降低供应商锁定、'一切皆插件'的架构理念、会话分支用于并行验证假设,以及 Dynamic Workflow 和 Agent Teams 实现多 Agent 协作的任务拆分与汇总。作者认为其价值在于让 Agent 成为可配置、可观察、可复用的执行系统,但仍处 developer preview 阶段,需谨慎对待权限与数据安全。

技术 › Harness Engineering Martin 2026-08-2931.4 KB 909 11 83

我把 Codex 和 DeepSeek Harness 的源码都读了一遍,又跑了 150 次基准测试

作者逐行阅读 OpenAI 开源的 Codex harness(rust-v0.150.1)与 DeepSeek Harness(dsh v0.1.1-rc.2)的源码,从工具调度、多智能体、上下文管理、沙箱、可观测性、模型互操作等十个维度对比两者,并设计了五个机制场景、六个组合共 150 次真实 agent 运行测试。文章揭示多个反直觉发现:Codex 多智能体更成熟但没有独立的读文件工具;Codex 只支持 Responses 协议而 dsh 兼容 chat completions;两者在上下文压缩上防的是不同故障。结果 149/150 通过,压缩场景 Codex 快约五倍。文章最后给出按使用目的的选型建议。

技术 › Harness Engineering 出海猴 @EasyGlobe出海 2026-08-2818.0 KB 5K 17 85

爆火的《牛来》模型正式发布!GLM-5.3-Flash 实战测评

匿名爆火的「牛来」模型 Ox-Alpha 揭晓身份,是智谱的首个原生多模态模型 GLM-5.3-Flash。仅 320B 参数(激活 18B),能力对标 Claude Opus 4.8,价格仅其 1/40,MIT 协议开源,跑在 10 万张国产芯片上。作者使用智谱官方 Harness 工具 ZCode 进行三个项目实测:复刻 Apple Vision 产品页、开发全栈 AI 绘图工具、制作 3D 联机对战游戏《牛来格斗》。测评显示其视觉理解与截图自主验证能力对 AI 编程体验提升巨大,长程任务稳定,但实时网络同步等后端难点仍有不足。

技术 › LLM 程序员鱼皮 2026-08-2818.9 KB 14K 9 72

2026 开源模型全网最全盘点:从入门到榨干(含双机实测)

文章系统盘点了 2026 年值得关注的开源 AI 模型,涵盖语言、图片、视频三大类别,包括 Qwen、DeepSeek、Kimi、GLM、MiniMax、混元等国产阵营及海外模型。作者拆解了模型命名规则(参数量、MoE、量化、许可证等),提出五步选型筛选法,并比较各硬件平台(Mac 统一内存、NPU AI PC、大内存 APU 等)的适配能力。文章还讲解了本地部署的适用场景与许可注意事项,最后通过 Mac 和 Windows 双机实测检验模型在文字、看图、分镜和视频任务上的真实表现,帮助读者判断自己需要哪类模型以及电脑能否带动。

技术 › LLM 诺鸭船长3 2026-08-2735.5 KB 44.1K 51 87

智谱GLM-5.3-Flash发布:真正的智能平权

文章揭秘了海外爆火的匿名模型OX Alpha的真实身份——智谱发布的GLM-5.3-Flash。该模型是总参数320B、激活18B的MoE架构,GLM-5系列首个原生多模态模型,支持图像、视频和文本输入,上下文达100万。其能力逼近Opus 4.8,而价格极低(每百万Token输入0.8元、输出2.8元),比DeepSeek V4还便宜一半。作者通过自建1000条新闻评测集实测发现其在精选率和品味上优于MiMo 2.5 Pro和DeepSeek V4 Pro,前端代码能力也直逼顶级模型。此外,智谱用10万张国产卡扛下了匿名测试期的全部推理流量。作者决定将AIHOT网站模型全面切换至GLM-5.3-Flash。

技术 › LLM 数字生命卡兹克 2026-08-2714.1 KB 44.9K 123 72

V4Flash 的价格、Opus4.8 的能力:智谱 GLM-5.3 Flash(Ox Alpha)正式开源

匿名模型 Ox Alpha 揭晓为智谱 GLM-5.3 Flash,320B 参数、MIT 开源、原生多模态、1M 上下文,限时价格仅为 Opus 4.8 的 1/40。作者通过三个前端场景实测:仅凭一张图用 Three.js 复刻玻璃折射海报、看录屏视频还原 60 片玻璃螺旋彩带交互网站、将静态体素海报改造为滚动揭示的 3D 网页,均表现出顶级多模态理解与代码能力,远超同价位的 DeepSeek V4 Flash,接近 Fable 5 但便宜约百倍。作者认为其把'便宜又够用'的行业斩杀线大幅推进,让预算有限的创作者也能用上前沿智能。

技术 › LLM 歸藏(guizang.ai) 2026-08-2712.0 KB 113.6K 72 77

万字长文:DeepSeek Harness 一文全看懂

本文系统讲解 DeepSeek 开源的 Agent 框架 DeepSeek Harness。作者从 Agent = Model + Harness 的公式入手,解释 Harness 如何将模型的意图转化为受约束、可持续的行动,涵盖插件化架构(Everything is a Plugin)、Profile/Bundle/Patch 配置体系、Cordis 插件管理器及其时空可组合性与 Fiber 生命周期、Agent Loop 中 Turn 与 Step 的执行流程、Inbox 输入机制、事件系统以及每个 Step 重新组装 System Prompt 的设计。文章配有大量名词解释与图片,兼顾零基础读者与技术人员。

技术 › Harness Engineering Russell 2026-08-2640.4 KB 369.6K 1.2K 80

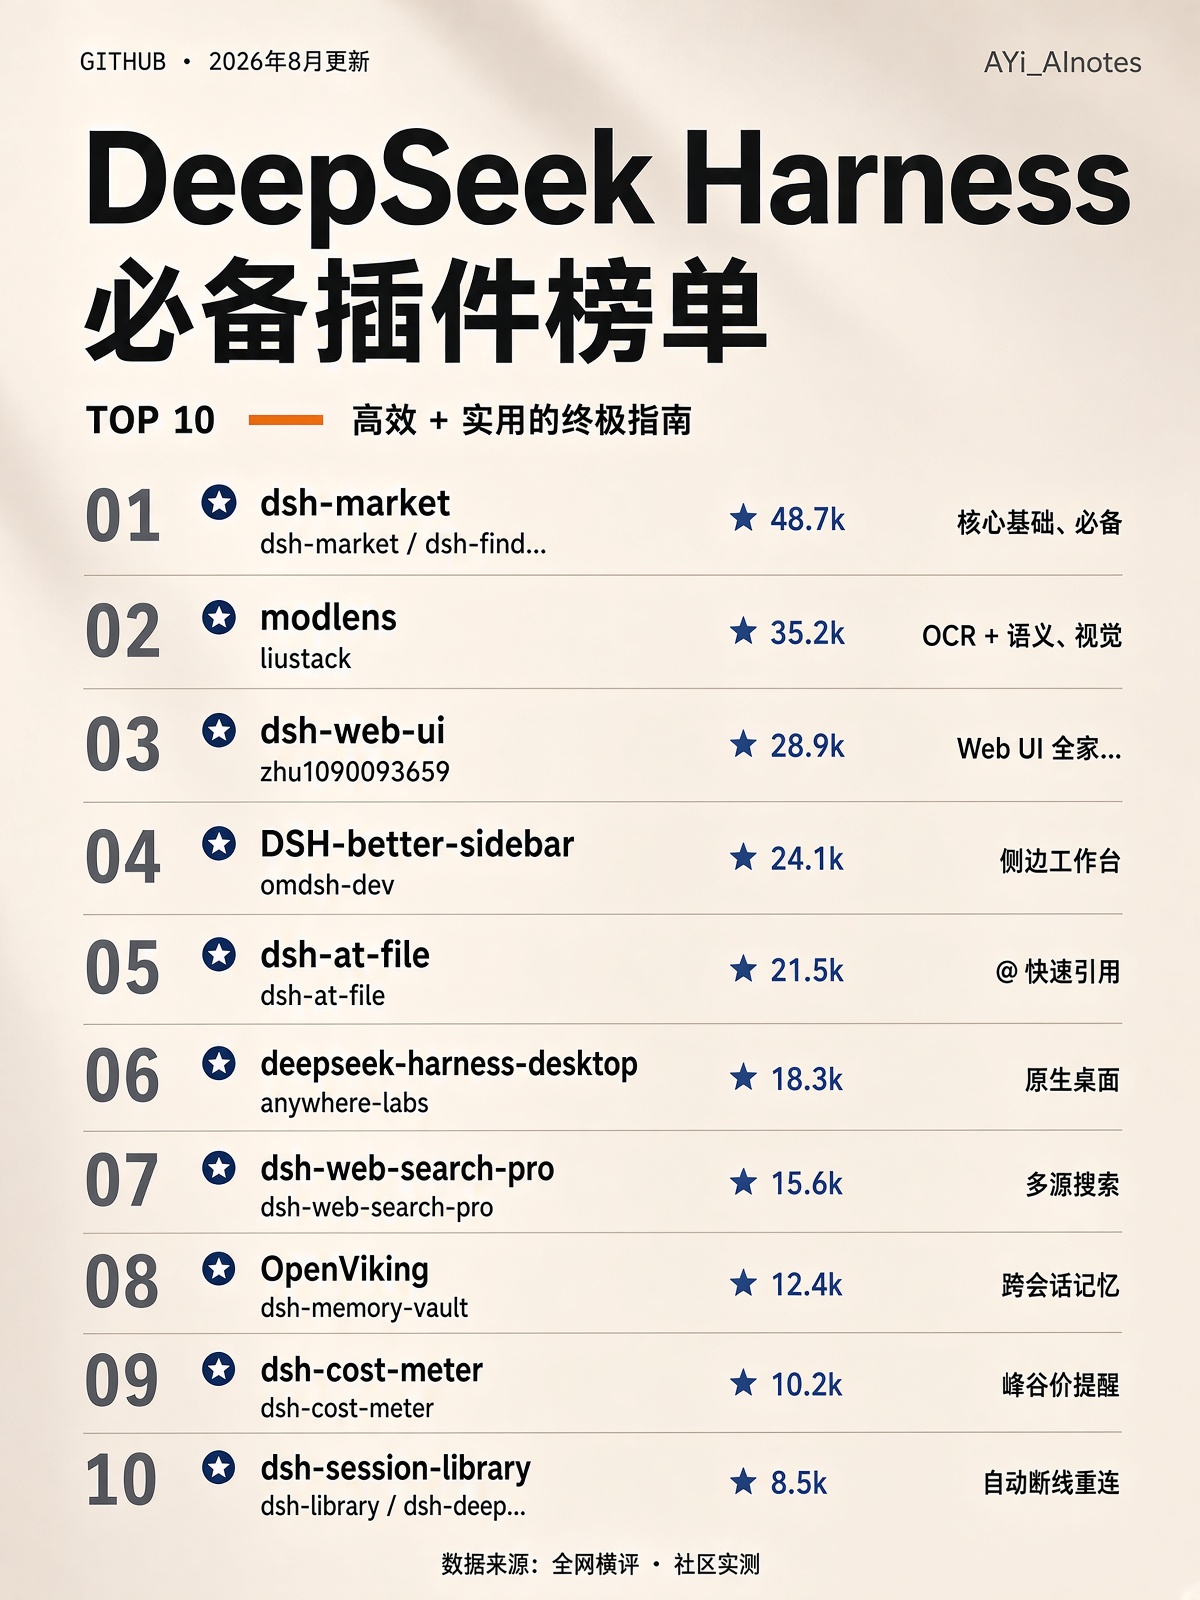
DeepSeek Harness 生态爆发:2026年8月社区 TOP 10 必备插件盘点

作者盘点了 DeepSeek Harness 生态中社区评分最高的 TOP 10 必备插件,包括插件市场入口 dsh-market、视觉扩展 modlens、界面全家桶 dsh-web-ui、VS Code 风格侧边栏、@ 文件引用、原生桌面端、多源搜索、跨会话记忆 OpenViking、费用看板和本地知识库精读等。并给出新手三步走建议:先装市场、视觉和界面插件,再按需补齐搜索与记忆能力。文末附上全部插件的 GitHub 仓库与一键安装命令。

k8e-sandbox:基于 k8s 的个人开发者 Agent 沙盒服务实践

作者介绍了其开源项目 k8e-sandbox 的沙盒服务实现。该沙盒基于 k8s 分布式架构,目标场景是一台笔记本跑 agent harness、一台远程服务器跑沙盒。文中详细演示了在 AWS 2C/2G 低配机器上一键安装 k8e、配置域名与 EIP、创建 API key、通过 k8e-sandbox-cli 与 DeepSeek Harness(DSH)联通,并在沙盒内运行网页并通过 Gateway/HTTPRoute 对外暴露 URL 的完整流程。沙盒内置 gvisor 实现用户态内核隔离,安全性接近 KVM 虚拟机。作者认为 agent infra 仍有大量工作要做,希望个人开发者拥有自己的工具箱。

技术 › Harness Engineering Tommy Xiao 2026-08-268.7 KB 1.1K 4 72

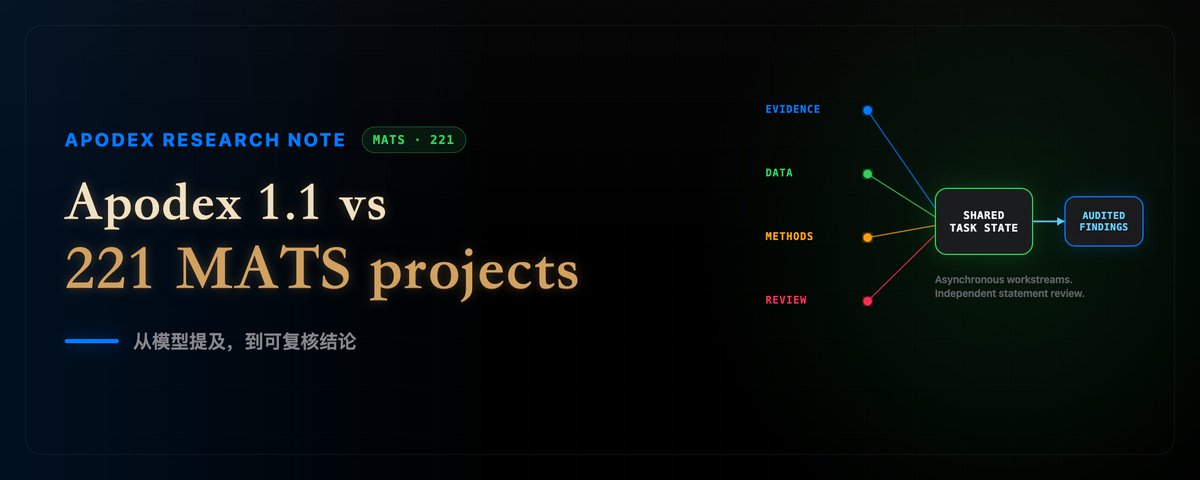
Apodex 1.1 帮我研究了 221 个 MATS 项目:从模型提及到可复核结论

作者使用 Apodex 1.1(主模型+在线工作台的科研 Agent 产品)对 221 个 MATS 项目进行研究,分析中国模型尤其是开放权重模型在 AI 安全研究中的使用情况。系统区分原始提及与实质性采用,通过异步 Agent Team(10 个 Subagent 并行)处理 4,821 条证据摘录,支持运行中 Chime-in 调整任务范围,并用独立审查 Agent 核验结论。研究发现中国模型实质性采用率从 2023 年的 4.35% 升至 2025 年的 50.55%,80.9% 的使用在开放权重条件下发生,中国开放权重模型正成为安全研究的实验基础设施。

技术 › Agent Dongxi 东锡 NLP 2026-08-269.6 KB 87.7K 210 71

DeepSeek 视觉模型实测:免费识图能力 + 8 大场景体验

DeepSeek 发布实验性视觉模型 DeepSeek-V4-Flash-Vision-Exp,在 V4 Flash 基础上增加识图能力且价格不变。作者通过 DeepSeek Harness 接入该模型,完成了 OCR 识别、人物识别、iPhone 机型辨别、找不同、图片转 ASCII、报错修复、前端页面复刻、数据报表逻辑分析共 8 项测试。结果显示其 OCR 和找不同表现优秀,但人物识别、机型辨别和页面复刻存在明显失误。整体可用且性价比极高,一张图约 0.12 分钱,八轮测试仅花约 6 元,而同等测试用 Opus 5 需约 8 美元。这是 DeepSeek 迈向原生多模态的重要一步。

技术 › LLM 程序员鱼皮 2026-08-2512.6 KB 11.7K 25 73

AI交易员第一步:用DeepSeek跑通量化交易

本文教程介绍如何用 DeepSeek V4 Pro 配合 Pi Agent、OKX Agent Skills 与 OKX CLI,在模拟盘上跑通加密货币量化交易全流程。内容涵盖环境安装与凭证配置、读取 BTC-USDT K线数据、用均线与 RSI、ATR 构建回测策略、创建 dry-run 脚本验证信号,以及最终由人工确认后执行小额模拟订单。文章强调安全边界:只用模拟盘、不碰真实资金、凭证不进入对话,并详细说明了防未来函数、手续费与滑点处理等回测细节。

技术 › Agent 泊舟 2026-08-2517.4 KB 26.1K 233 81

Pi 小白完整入门教程(上):安装配置 + 第一个项目

本文是面向零基础用户的 Pi 编程 Agent 入门教程上篇。Pi 是 2026 年 GitHub 9.3 万星的极简 AI 编程 Agent,核心理念是做减法:仅 4 个内置工具、约 1000 token 系统提示词,同等成本下代码质量超过 Claude Code 和 Codex,速度快 1.5-2 倍,且能自我进化写插件。教程详细讲解了 Agent、模型、Token 等基础概念,三种安装方式,配置 DeepSeek API Key 或订阅账号的方法,常用操作快捷键,并手把手带领读者用一句话指令让 Pi 从零做出一个家庭记账本 React 网页,完成从安装到作品落地的完整闭环。

技术 › Agent 老爸的AI联萌 2026-08-2512.7 KB 3.5K 16 81

10张图详细拆解DeepSeek Harness设计架构

作者用10张图系统拆解DeepSeek Harness(DSH)的架构设计。DSH启动经历两次装配:先通过Profile、Bundle和Patch构建公共Host(含Session、模型注册、工具系统、Agent Loop和Web服务),再依据Preset为会话装配具体Agent。底层基于Cordis插件框架,通过provide/inject服务依赖图和事件机制将独立插件组装成完整系统。文章还详解了Agent Loop的Turn/Step运行机制、SessionEvent事件日志的持久化设计,以及如何通过自定义Preset快速构建业务Agent。

技术 › Agent 轩辕之风 2026-08-2517.4 KB 8.5K 69 84

Hugging Face 估值 130 亿:AI 界 GitHub 为何试探出售

Hugging Face 正接触潜在买家,估值可能超 130 亿美元,比当年微软收购 GitHub 的 75 亿还高。文章分析其价值来自模型分发入口地位:平台模型、数据集超百万,Qwen、DeepSeek 等开源模型均以此为主阵地。公司年化收入已过 1 亿并盈利,出售并非自救,而是趁高位试探最优价格。核心难题在于中立性:任何大买家(Google、英伟达等股东)收购都会动摇其他厂商信任。作者回顾微软收购 GitHub 八年后的变化,提醒关注收购后模型迁移自由与推荐公平性。

技术 › LLM 林亦LYi 2026-08-2413.2 KB 5.4K 9 69

AIPC选购指南:DGX Spark 还是 AMD 395?

文章对比了两款桌面跑大模型的设备:英伟达 DGX Spark(国行3.5万)与搭载 AMD Ryzen AI Max+ 395 的小主机(近2万)。两者均采用统一内存架构、128GB 内存,可装下 70B 级模型。核心结论:出字速度受内存带宽限制,两台几乎一样;读题(预填充)速度 Spark 快五到六倍,资料越长优势越大。文章还分析了各自优缺点、CUDA 生态、双机集群跑 DeepSeek-V4 的玩法及真实翻车案例。

技术 › LLM 黄小木 2026-08-2227.2 KB 100.7K 119 86

BestBlogs 早报 08-22:Anthropic 重构 SDLC,DeepSeek 开放视觉 API,Hallmark 编码设计品味

本期早报精选三篇内容:Anthropic 发布 AI 原生软件交付生命周期手册,将 Plan、Design、Build、Test、Deploy、Maintain 六阶段改造成以版本化工件驱动的可循环流程;DeepSeek 上线实验性视觉模型 V4-Flash-Vision 的 API,支持图文混合输入与 Files API 复用;Together AI 的 Hassan El Mghhari 分享 Hallmark Skill,将设计品味拆解为负面约束、视觉参考与偏好记忆。速览还包括 Uber 智能体 SDLC、DeepWiki 代码 Wiki、Blackwell 投机解码优化、淘宝 Skill 实践等。

技术 › LLM ginobefun 2026-08-2228.8 KB 7.4K 4 81

Parallel Search 推出 Fast 模式:面向 AI 的高性价比网页搜索

Parallel 推出面向 AI agent 的 Fast 模式网页搜索,价格仅为主流模型默认搜索的十分之一,每千次查询 1 美元,在质量-成本和质量-延迟上均处于 Pareto 前沿,准确率接近 SOTA 的 Parallel Advanced。独立评测显示其端到端成本比 Brave、Exa、Tavily 便宜 2 倍以上。文章指出随着 GPT-5.6 Luna、DeepSeek V4 等高性价比模型普及,AI 智能成本数月内下降 8-12 倍,廉价模型需要廉价搜索,Parallel Fast 旨在提升 agent 每美元的有效工作量。

技术 › Agent Parag Agrawal 2026-08-224.5 KB 128.4K 436 65

16 个超火的 DeepSeek Harness 插件推荐

DeepSeek Harness(DSH)是 DeepSeek 官方开源的 AI Agent 运行环境,核心理念是「一切皆插件」。文章介绍了如何在 GitHub 和社区清单中发现优质插件,并推荐了多款热门插件:包括让模型理解图片的 ModLens、扩展搜索源的 ModSearch、可操作真实 Chrome 浏览器的 dsh-browser、支持多 Agent 协作的 Agent Teams、插件市场 dsh-market、界面全家桶 dsh-web-ui、侧边栏增强、上下文可视化和生成式 UI 等,帮助用户扩展 DSH 技能并提升使用体验。

技术 › Harness Engineering 程序员鱼皮 2026-08-2123.6 KB 27.5K 126 80

2026年AI订阅性价比终极对比:Claude/Codex/Grok/DeepSeek/GLM/OpenCode Go哪家最划算

因DeepSeek官方API涨价,作者对比了2026年主流AI订阅套餐的性价比。结论:34元人民币的OpenCode Go订阅最划算,可0.33倍率用DeepSeek、0.083倍率用Muse Spark 1.2;30美元档推荐SuperGrok、GPT Plus和GLM Lite;200美元档推荐Claude Max和GPT Pro;300美元档推荐SuperHeavy。文章还详细列出各套餐的坑点,如Claude易封号建议通过苹果商店购买、Grok节点不干净会降智、GLM限购且速度慢等,并附AI模型智力排行榜。

技术 › Openclaw 峰哥亡命天涯 2026-08-213.5 KB 32.9K 43 70

口碑平平的豆包,凭什么拿下特斯拉?

本文分析了特斯拉在中国选择豆包作为车机语音助手的原因。特斯拉将豆包用于响应车主语音指令,DeepSeek用于陪聊,两者均托管在火山引擎。作者从下载量、价格、使用场景和交付能力四方面剖析:豆包下载量高、价格合理、擅长高频日常对话,且火山引擎提供一站式交付,使特斯拉能快速落地。此外,外国厂商在中国需本地AI伙伴,特斯拉此举是顺应趋势。

技术 › LLM 林亦LYi 2026-08-207.8 KB 10.1K 14 68

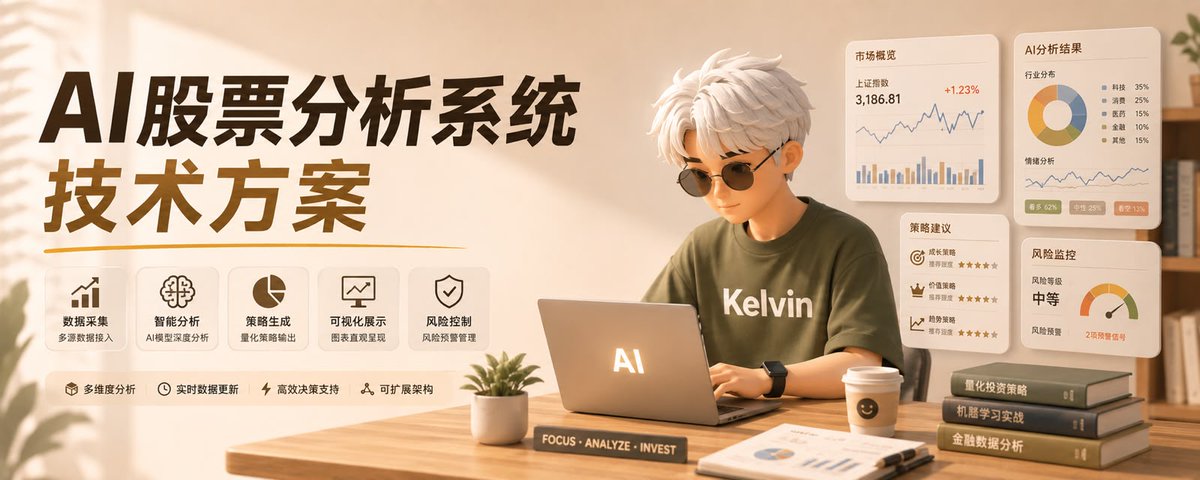
AI 股票分析系统 — 技术方案仅供交流

本文介绍了基于 ChatGPT Codex 搭建的 AI 股票分析系统的技术方案,该系统定位为 AI 投资研究与信息处理系统,非自动交易或涨跌预测。文章详细阐述了系统的整体架构(6层)、技术选型(数据源、AI模型、调度、推送)、核心数据流、评分体系、配置说明、运行部署、安全边界及关键风险。作者强调工程上先单模型跑通更稳,评分不等于涨跌概率,并提供了与主线项目(Codex 式 Agent 桌面应用)的关联建议。

技术 › LLM Kelvin 2026-08-209.3 KB 79