Wiki 知识库

全部文档 / 作者: EP

69 篇
清除

10月25日我生日:从实验室到 LayerFS 的开源创业之路

作者在生日之际回顾过去一年的经历:从加拿大到新加坡再到中国,从实习生到代理 CEO,再到创业未果后投身开源。他坚信 AI 时代的基础设施应围绕 agent 重新设计,尝试申请创业营但因对国内 VC 模式失望而放弃融资,转而 all in 研发 Ephemeral Sandbox。在田老师等人的帮助下,项目转向 FUSE 技术路线并演化为 LayerFS,于四天前发布 v1.0.0。尽管面对 90% 的质疑,他决心把这一底层基础设施项目长期做下去。
技术 › Agent Yifan Xu (@yifanxu_ephai) 2026-10-266.9 KB 51

还原田柯宇事件:被破坏的训练,和一个争抢“天才”的时代

文章深度还原了2024年字节跳动视频生成模型Goku训练故障事件。团队经历数月无法解释的训练异常,上百名工程师参与排查,最终发现PyTorch代码被篡改、共享服务器上存在隐藏攻击代码,矛头指向实习生田柯宇。字节随后辞退并起诉田柯宇。两年后,田柯宇获近3000万美元融资并在播客中重提旧事,称自己出于“朴素的正义”,引发前同事公开回应与争议再起。文章通过多方访谈呈现排障细节、字节的处理过程,并探讨AI人才竞争中成果与手段的伦理问题。
技术 › LLM 晚点 LatePost 2026-10-2530.0 KB 169.9K 332 76

我正在创立一只新的早期 AI 基金

红杉资本合伙人 Stephanie Zhan 宣布创立一只新的早期 AI 基金,专注于在公司成立之初就与创始人合作,押注于共识之前的大胆项目。基金 LP 包括红杉、Jeff Dean、Sachin Katti 等,她仍将保留红杉合伙人身份。她在斯坦福 Andrew Ng 实验室的经历塑造了她对 AI 的信念,并回顾了投资 Skild AI、Reflection AI、Ricursive AI、Linear 等公司的经历,强调在共识之前相信创始人、帮助其获得资本、算力与客户的重要性。

投资 › 基金 Stephanie Zhan 2026-10-2310.8 KB 67

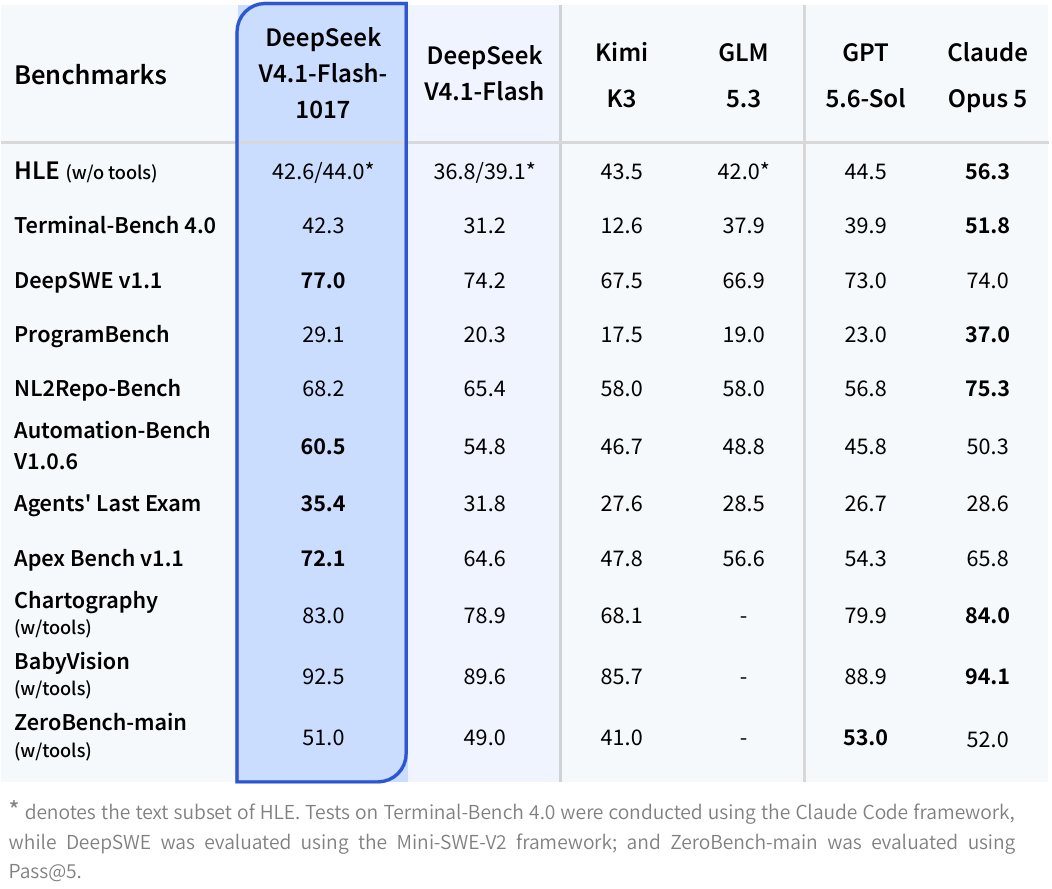
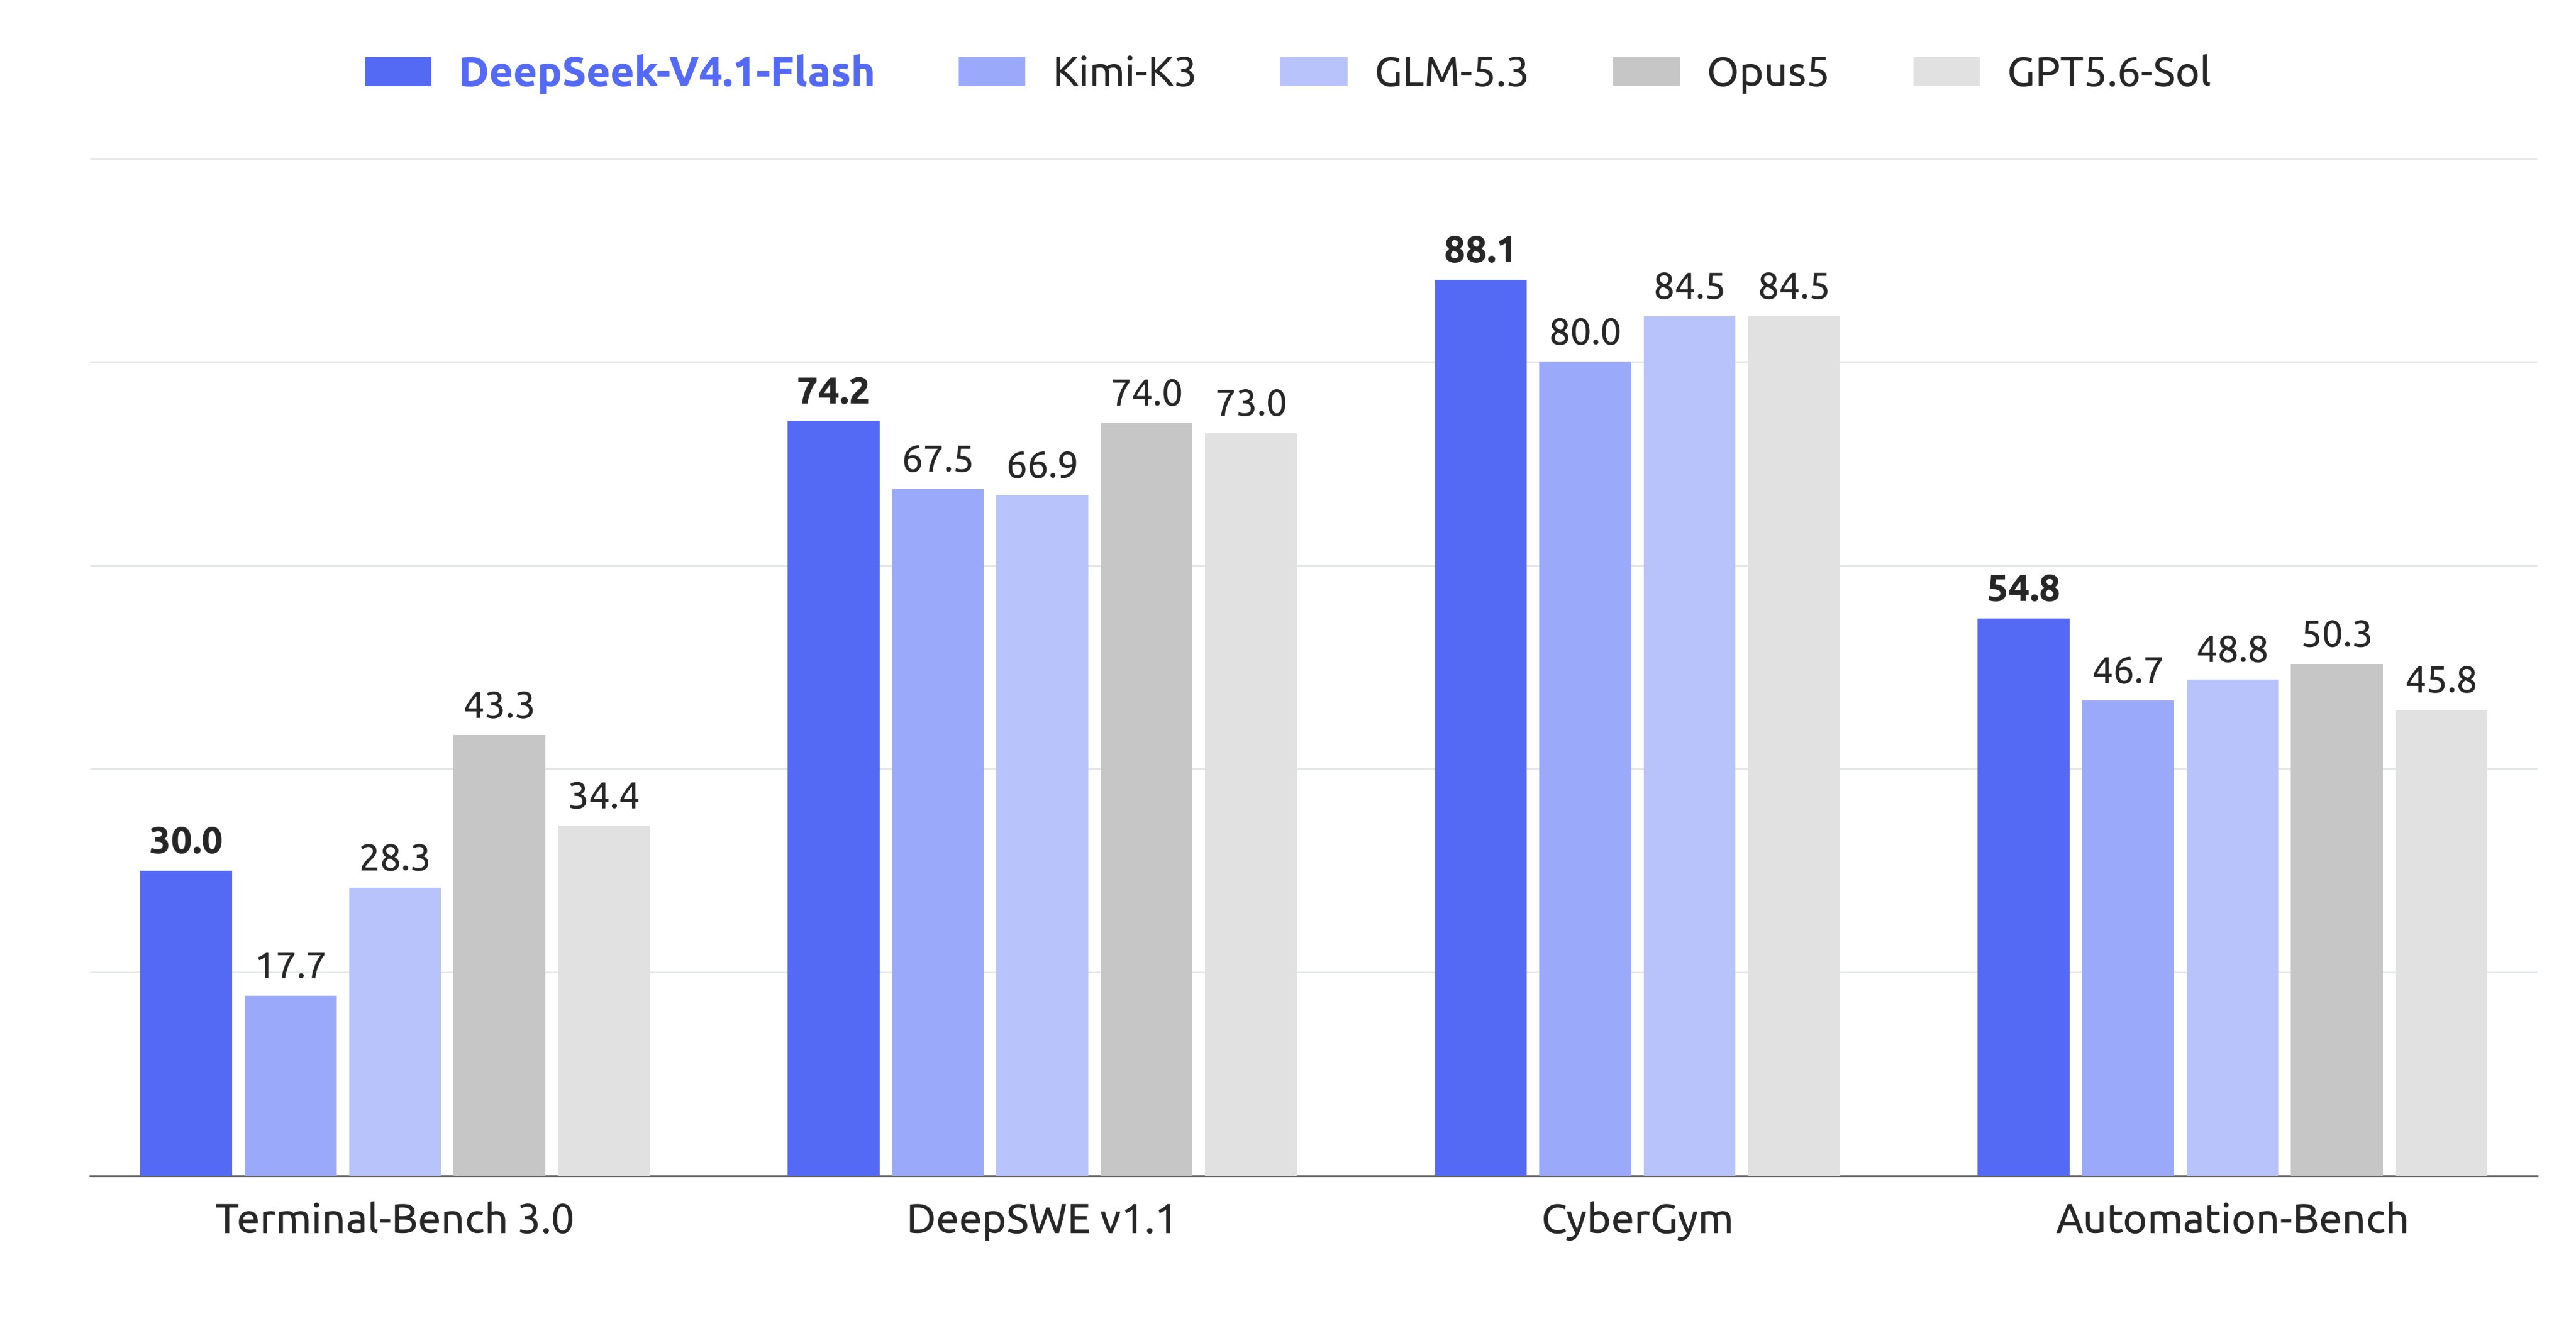
DeepSeek-V4.1-Flash-1017 发布

DeepSeek 发布 V4.1-Flash-1017 模型,性能更强、任务完成更快、输出更短,实现性能与成本的帕累托改进,已在官网、App 和 API 上线。模型通过强化学习自反馈优化端到端项目开发能力,覆盖游戏创建到 3D 建模等完整项目构建,并针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等工具优化。同时 Search & Fetch API 面向所有人开放,基于自研搜索引擎,每端点 $0.75/千次调用,已在 Hugging Face 和 ModelScope 开源。

技术 › LLM DeepSeek (@deepseek_ai) 2026-10-173.1 KB 79

谁领投了字节投毒实习生田柯宇

文章梳理了曾因在字节跳动实习期间恶意篡改代码被起诉索赔800万元的田柯宇,如今创立世界模型实验室并获五源资本合伙人孟醒领投近3000万美元的事件。作者深入调查孟醒的十五年的职业履历,指出其在Orbeus、知图科技、滴滴自动驾驶等公司的经历存在时间线重叠与美化的痕迹:每逢商业化进入艰难阶段便抽身离场,却将留守团队多年熬出的收购成果包装为自己的'成功退出'。文章质疑这位自称把'价值观契合'放在最高优先级的投资人,为何领投中国AI行业职业诚信争议最大的年轻人,揭示了创投圈叙事包装与职业诚信的深层矛盾。

投资 › 宏观经济 sleepy 2026-10-1526.6 KB 22.5K 16 86

关于人工智能仿真与 RSI 的数学思考

作者从数值仿真研究背景出发,探讨人工智能仿真与递归自我改进(RSI)之间的数学联系。文章回顾了非连续变形分析(DDA)在地震工程中的应用、二战德军潜艇狼群战术与英国兵棋推演的历史,说明仿真不仅是求解已知方程,更是发现未知数学关系的实践方法。作者认为RSI本质上是仿真及反馈过程的自动化:多智能体系统可模拟兵棋推演中的各方参与者,通过反复生成场景、评估结果并保留改进来提升能力。文章进一步讨论了运筹学、参数化与非参数化方法、接触理论及不等式系统在仿真中的数学基础,并强调RSI会同时放大改进与错误,验证与基准检验必须贯穿整个迭代过程,以防止未经验证的结果成为后续自我改进的基础。

技术 › LLM deep Manifold 2026-10-1117.1 KB 1.7K 13 69

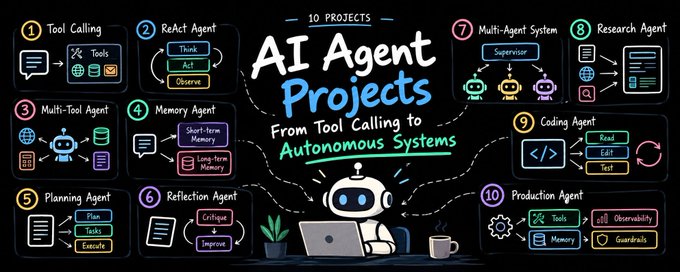
10 AI Agent Projects That Take You From Tool Calling to Autonomous Systems

文章介绍了10个循序渐进的 AI Agent 实战项目,帮助开发者从简单的工具调用进阶到自主智能体系统。项目包括:工具调用 Agent、ReAct 推理循环、多工具选择、记忆 Agent(短期与长期记忆)、规划 Agent(任务分解)、反思 Agent(自我评估与修订)、多 Agent 协作系统、研究 Agent、编码 Agent 等。文章通过架构图、技术栈(Python、OpenAI、LangGraph、Pydantic)和学习要点,阐述了智能体设计中的核心问题:工具选择、记忆管理、任务分解、错误恢复、自我验证及多 Agent 协调等。

技术 › Agent Jaydeep 2026-10-0512.7 KB 17.4K 254 73

企业蓝领 AI 的递归自我改进 (RSI)

本文探讨递归自我改进(RSI)在企业蓝领 AI 场景中的应用价值。作者认为,与科学发现领域相比,企业运营因其流程确定性、文档化、可审计的特点,更适合 RSI 立即产生价值。企业积累的海量 SOP、工程规范和监管文档可同时充当知识来源、执行约束和验证基准。文章提出企业 AI 需满足高精度执行和自助式自动化两大要求,主张由领域专家(SME)直接监督 AI 系统,实现从工作流发现、PoC 到生产部署与持续演化的自助式开发。核心架构是共享前沿模型加面向具体工作流的本地 RSI 小模型,配合动态脚手架和群体智能体协同,并遵循版本管理、回滚、审计等企业治理实践。

技术 › Agent deep Manifold 2026-10-0512.5 KB 381 3 70

硅谷没有忠诚

文章以Khosla Ventures两位合伙人Khosla与Rabois因AI编程公司Factory顾问Degnan跳槽至竞争对手Cognition而公开争执为切入点,揭示了硅谷一级市场的现实逻辑:资本可以同时下注多家竞对公司,但关键资源(如顶级销售高管、企业客户、信息通道)永远是排他的。文章剖析了两家公司快速膨胀的融资与估值、VC圈层化的人脉网络、投资人与高管身份的切换,以及股东兼客户的利益冲突,指出创业者所期待的忠诚从未在合同中被承诺,资本最优化配置往往意味着牺牲个别被投公司的利益。

投资 › 宏观经济 动察Beating / Sleepy 2026-10-0214.1 KB 2.2K 3 85

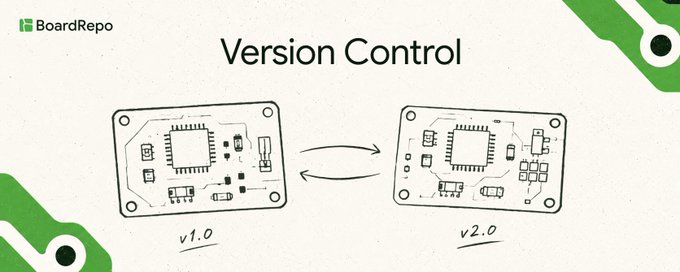
BoardRepo 发布 PCB 设计版本控制工具

BoardRepo 宣布为 PCB 设计推出版本控制功能。借助 KiCad 插件,用户可在 KiCad 内一键推送、拉取项目并添加变更说明,无需终端或 Git 命令。所有版本的原理图、布局及相关文件集中保存,可随时回溯到任意历史版本并查看谁在何时做了什么改动。其可视化 diff 功能支持并排对比两个版本,变更直接高亮显示在电路板布局上,解决了文本 diff 对 PCB 文件意义不大的问题。该工具已支持 Mac 和 Windows。文章指出,AI 正在加速 PCB 设计并降低门槛,硬件领域需要类似 GitHub 的版本管理方案。

技术 › 工具与效率 BoardRepo 2026-10-022.4 KB 48.3K 51 70

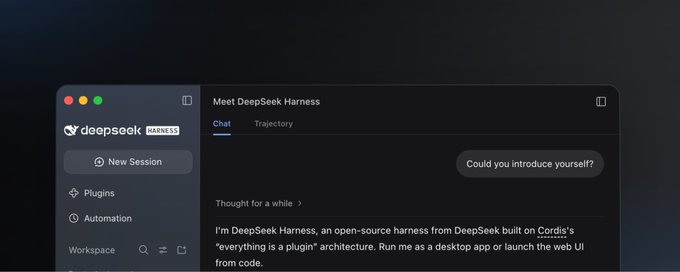
DeepSeek Harness v0.2 桌面版发布

DeepSeek 发布 Harness v0.2 预览版,推出 macOS 和 Windows 桌面应用。新版本改进了文件显示、内容预览和代码变更展示,简化定时任务的设置与管理。核心亮点是插件系统:新增插件管理器,无需终端命令即可安装、禁用或卸载插件;实验性创作者模式允许用户用自然语言描述需求,自动创建插件。官方数据显示 Harness 是 DeepSeek API 用户中最广泛使用的编码 Agent。未来计划改进沙箱与安全、Agent 团队、长期记忆、浏览器自动化、远程访问,并建设官方插件市场,完善插件 API 兼容性。

技术 › Harness Engineering DeepSeek Harness 2026-10-017.2 KB 1.1M 5.9K 70

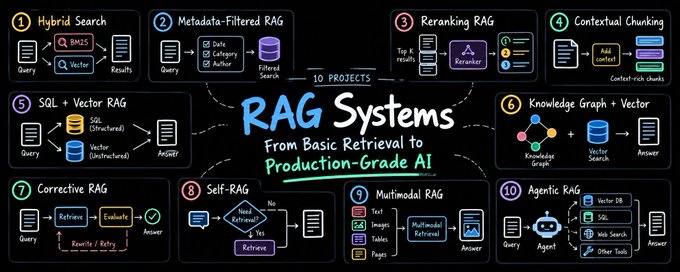
10 个带你从基础检索到生产级 AI 系统的 RAG 项目

文章指出仅掌握基础的'chat with PDF'式 RAG 流水线(分块、嵌入、向量检索、LLM)不足以构建真实生产系统,并推荐 10 个进阶项目:混合检索(BM25+向量)、元数据过滤、重排序、上下文分块、SQL+向量混合、知识图谱+向量、纠错式 RAG、自感知 RAG、多模态等。每个项目均说明要解决的问题、系统架构、技术栈(Python、pgvector、LangGraph、Neo4j 等)及学习要点,帮助开发者从语义相似度走向关键词匹配、结构化过滤、关系推理与检索质量反馈等生产级能力。

技术 › LLM Jaydeep 2026-09-2912.2 KB 22.5K 314 78

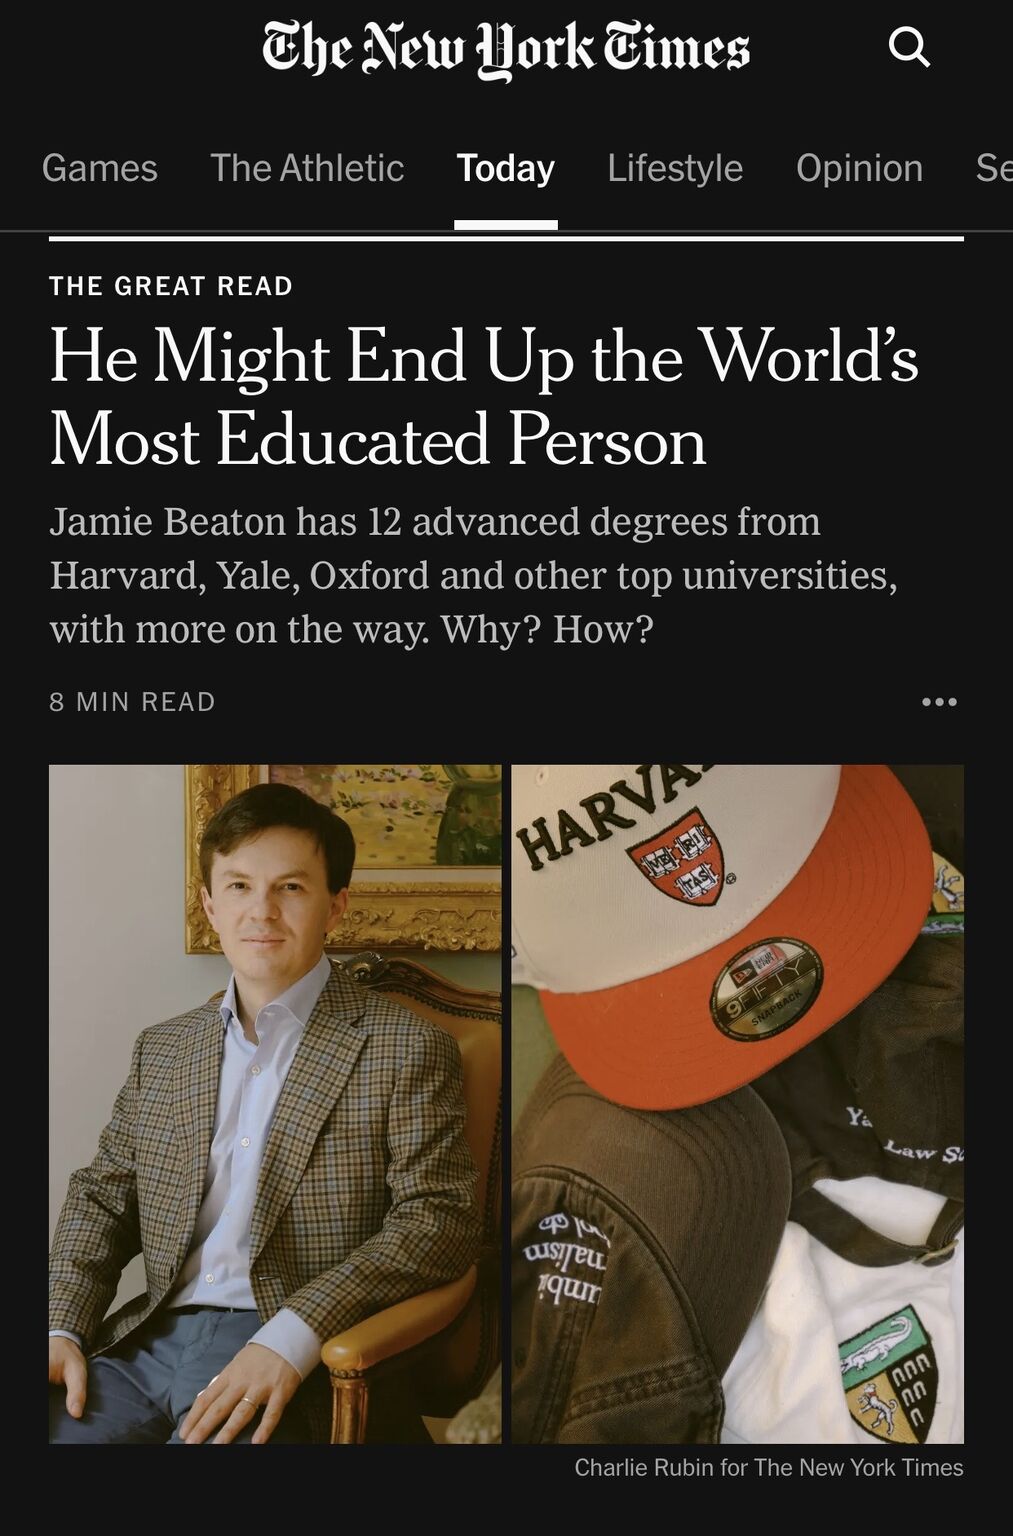
AI 都快把大学教育打成夕阳产业了:31 岁读完 12 个顶级学位的 Jamie Beaton

文章讲述了 Jamie Beaton 的故事:31 岁已获得哈佛、斯坦福、牛津、清华等 12 个顶级大学学位,同时创立并经营估值超 6 亿美元的教育公司 Crimson Education。作者借此探讨 AI 时代大学教育的价值变迁:知识因 AI 变得越来越便宜,但名校的文凭、筛选机制和圈层认证反而更贵。Jamie 把学校当作基础设施,看重的是教授、同学、研究环境和跨学科训练,而非单纯的知识获取,揭示了教育与认证的分离趋势。

其他 › 杂谈 sleepy.md (@sleepy0x13) 2026-09-263.7 KB 69

DeepSeek,华为,「必须成功」:十六万颗萤火照进荒原

文章讲述了DeepSeek与华为两条看似毫无交集的技术路线如何走向深度结盟的故事。幻方量化创始人梁文锋早在2019年就囤积算力(萤火一号、二号),而华为通过海思备胎计划在实体清单后推出昇腾芯片。在英伟达对华禁售后,DeepSeek以极致工程能力用低配H800训练出V3和R1,震撼硅谷并引发英伟达市值暴跌。2026年,梁文锋押上200亿元,联合华为将下一代旗舰模型迁移到纯国产昇腾底座,并在内蒙古规划16万颗昇腾芯片的超大型数据中心。这是一场被地缘封锁逼出来的、别无选择的技术突围。

技术 › LLM Sleepy [@sleepy0x13] 2026-09-2216.1 KB 20.4K 3 68

MiMo-V2.6 复盘:Agent RL 的规模化之路

文章解读小米罗福莉关于 MiMo-V2.6 的 RL 复盘,探讨 RL 能否像预训练一样规模化。MiMo-V2.6 单次更新抽取 1568 个任务、每任务 16 条 rollout,一个 Step 生成约 2.5 万条 Agent trajectory。文章指出 Agent RL Scale 的三大难点:需要 7000 多个 RL Task Environment 供模型进入;将 Harness 混入训练实现跨 Harness 迁移能力(You Only RL Once);以及需要强大的 Grader 评估轨迹质量并对抗 Reward Hacking。作者认为未来模型公司的核心能力是建造 Experience Factory,让模型通过大量真实经历实现下一轮 Scaling。

技术 › LLM sleepy.md (@sleepy0x13) 2026-09-225.5 KB 75

彼得·蒂尔只相信一种自由

文章梳理了彼得·蒂尔2026年的一系列动向:在阿斯彭公开批评教皇列奥十四世的AI全球监管通谕;四处讲授"敌基督"理论,将其反监管立场包装成神学叙事;公开指责Anthropic借安全名义扩张权力;重注推理芯片公司Etched;举家迁往阿根廷,投资米莱政府治下的页岩油公司Vista,并支持其激进去监管政策。作者剖析了蒂尔的局外人处境、吉拉尔摹仿欲望理论的影响,指出他嘴上谈形而上学、掌心落下的全是资本与权力布局,其自由观最终只能在旧大陆之外寻找落脚点。

技术 › LLM 动察Beating / Sleepy 2026-09-1625.7 KB 82.7K 147 68

机器人研究的隐藏支柱:部署

Skild AI 创始人 Deepak Pathak 宣布公司实现 1 亿美元 ARR,并阐述部署为何是机器人研究的隐藏支柱。文章指出机器人无法像 LLM 那样先研究后部署,演示视频会掩盖真实准确率,部署中必须同时考虑速度、精度和对变化的适应能力。这些实践催生了 S1 模型——通过单视频上下文学习即可掌握新任务而无需微调。作者还探讨了演示文化与部署文化的冲突,并提出物理 RSI(递归自我改进)路线:将各专业部署的数据反哺通用基础模型,形成持续改进的飞轮。

技术 › 机器人 Deepak Pathak 2026-09-119.5 KB 420.8K 1.4K 75

DeepSeek-V4.1-Flash 发布:更聪明、更快速、更高效

DeepSeek 发布新架构家族中最小的模型 V4.1-Flash,具备原生视觉理解能力。该模型采用非对称因果编码器-解码器架构,552B 参数 MoE,仅 8B 激活参数用于输入、16B 用于输出,通过新预训练方法和大规模 RL 后训练,性能超越旗舰模型 V4-Pro。KV 缓存仅需前代 1/4 的 HBM 和 1/8 的 SSD 存储,大幅降低 Agent 成本。模型已上线 DeepSeek API,支持多模态,API 价格下调,非高峰时段费率为峰值的 50%。官方将与开源社区合作推进推理支持,模型已在 HuggingFace 开放。

技术 › LLM DeepSeek (@deepseek_ai) 2026-09-103.3 KB 73

什么是深度流形?

本文介绍深度流形框架,一个旨在揭示神经网络数学结构的理论体系,由四大支柱构成:学习作为反问题(解释了学习的适定性与锯齿智能现象)、范畴论(神经网络学习的是数据间关系而非数据本身)、堆叠分片流形(学习发生在层与迭代形成的演化几何结构中)、不动点理论(描述学习在变化边界条件下的推进方式)。文章阐述了神经网络方程、训练动力学、模型推理的数学原理,指出网络能力源于计算的无属性性与满秩性。该框架旨在为神经网络建立严谨的数学基础,实际意义在于实现更高效的学习、更好的对齐和更小的模型。

技术 › LLM deep Manifold 2026-09-098.1 KB 10.7K 28 58

职业早期发展的 10 条建议:如何规划你的第一份工作与职业路径

文章整理了 Lenny 播客中多位行业专家(Mayur Kamat、Jason Shah、Matt MacInnis 等)关于职业早期发展的 10 条建议:优先选择高速成长、人才密度高的团队;优化学习复利而非初始工资;先证明可靠执行力再谈战略;探索职业方向要有假设;尽早找到强项并补充互补能力;选择能提供反馈的经理;建立可讲述、可验证的职业故事;主动建立关系而非索取式 networking;以及不必一开始就决定是否成为高管。核心观点是职业早期应重视学习速度、执行工艺和优势积累。

职场 › 职业发展 sephirx (@sephirx_li) 2026-09-076.6 KB 79

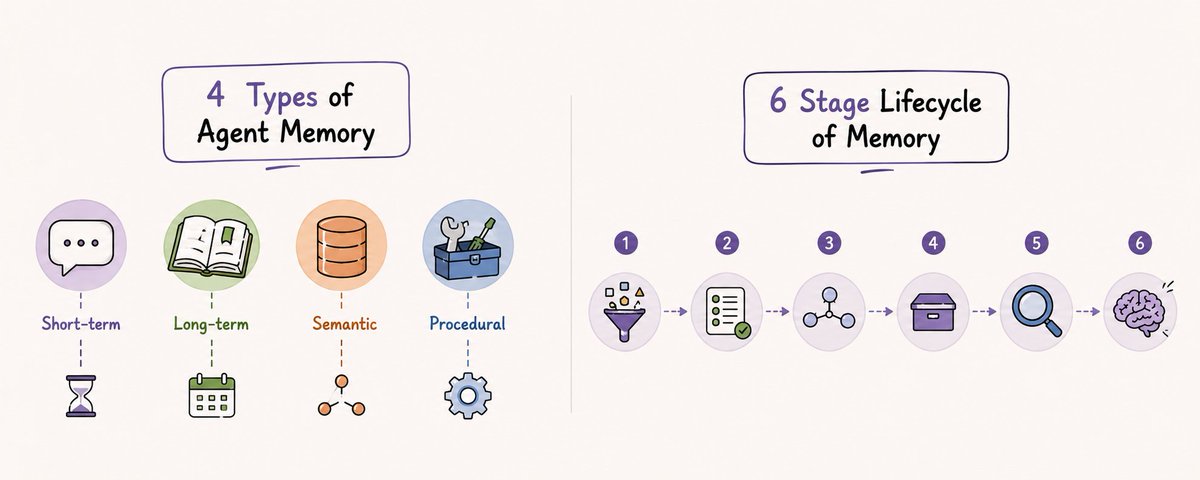
AI Agent 记忆的四种类型与记忆生命周期

本文是 Agent 记忆系列第二篇,基于普林斯顿的 CoALA 认知架构框架,将 Agent 记忆分为四种类型:工作记忆(当前上下文)、语义记忆(事实性知识)、情景记忆(带时间戳的具体事件)和程序性记忆(Agent 自行从重复经验中学到的规则)。作者强调仅靠厂商记忆功能只覆盖语义记忆的一小部分,完整的生产级 Agent 还需理解记忆的六阶段生命周期:提取、存储、检索、注入、更新与遗忘。文章为后续动手构建带记忆的 Agent 系统奠定概念基础。

技术 › Agent Jaydeep 2026-09-028.2 KB 8.1K 43 71

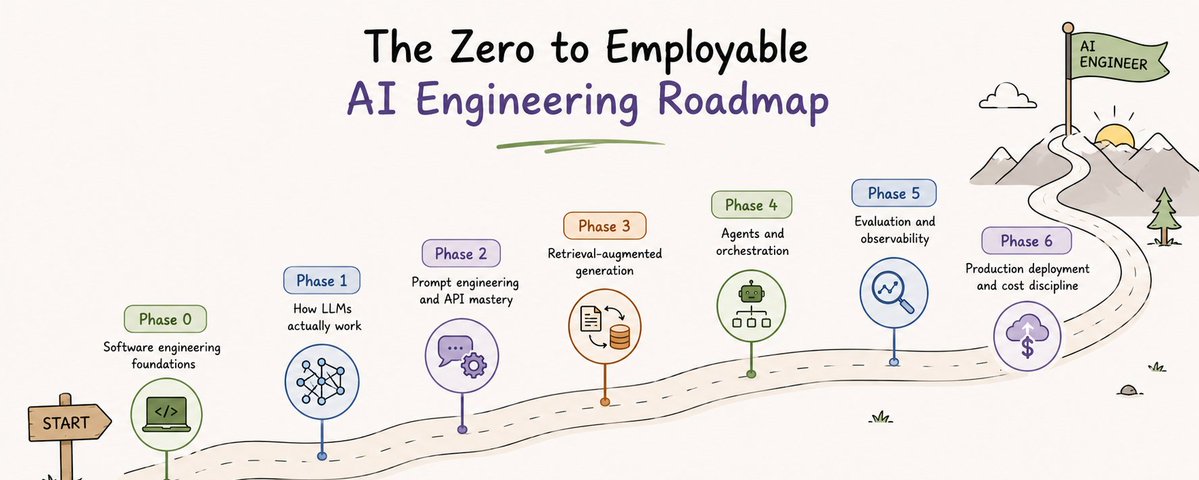
零基础到可就业的 AI 工程师学习路线图

本文提供了一份从零到可就业的 AI 工程师分阶段学习路线图,区别于单纯的技能清单,每个阶段都附带经过验证的优质课程、文档和书籍。路线涵盖六个阶段:软件工程基础(Python、API、Git)、LLM 工作原理(Karpathy 课程、3Blue1Brown)、提示工程与 API 掌握、RAG 检索增强生成(最具就业价值的技能)、Agent 与编排(LangGraph、MCP)、以及评估与生产部署。作者建议用 8-12 个月完成学习,并强调构建真实项目组合和公开写作是获得雇佣的关键。

技术 › LLM Jaydeep 2026-08-248.6 KB 33K 567 75

Agent Experience Engineering: the skill that'll make 1000's of millionaires in 2027

本文提出“Agent体验工程”(AX)这一新概念,指设计易于智能体使用的产品,使LLM更愿意采用。作者认为智能体正成为软件的主要购买者,传统UI的粘性优势消失,产品需通过API、MCP服务器、CLI等接口优化智能体体验。同时,原先的“上下文工程师”角色被AX工程师吸收,UI从操作层转变为监督层。文章最后给出实践建议,并预测AX工程师将成为未来品牌必备角色。

技术 › Agent EP 2026-08-207.5 KB 78.4K 378 70

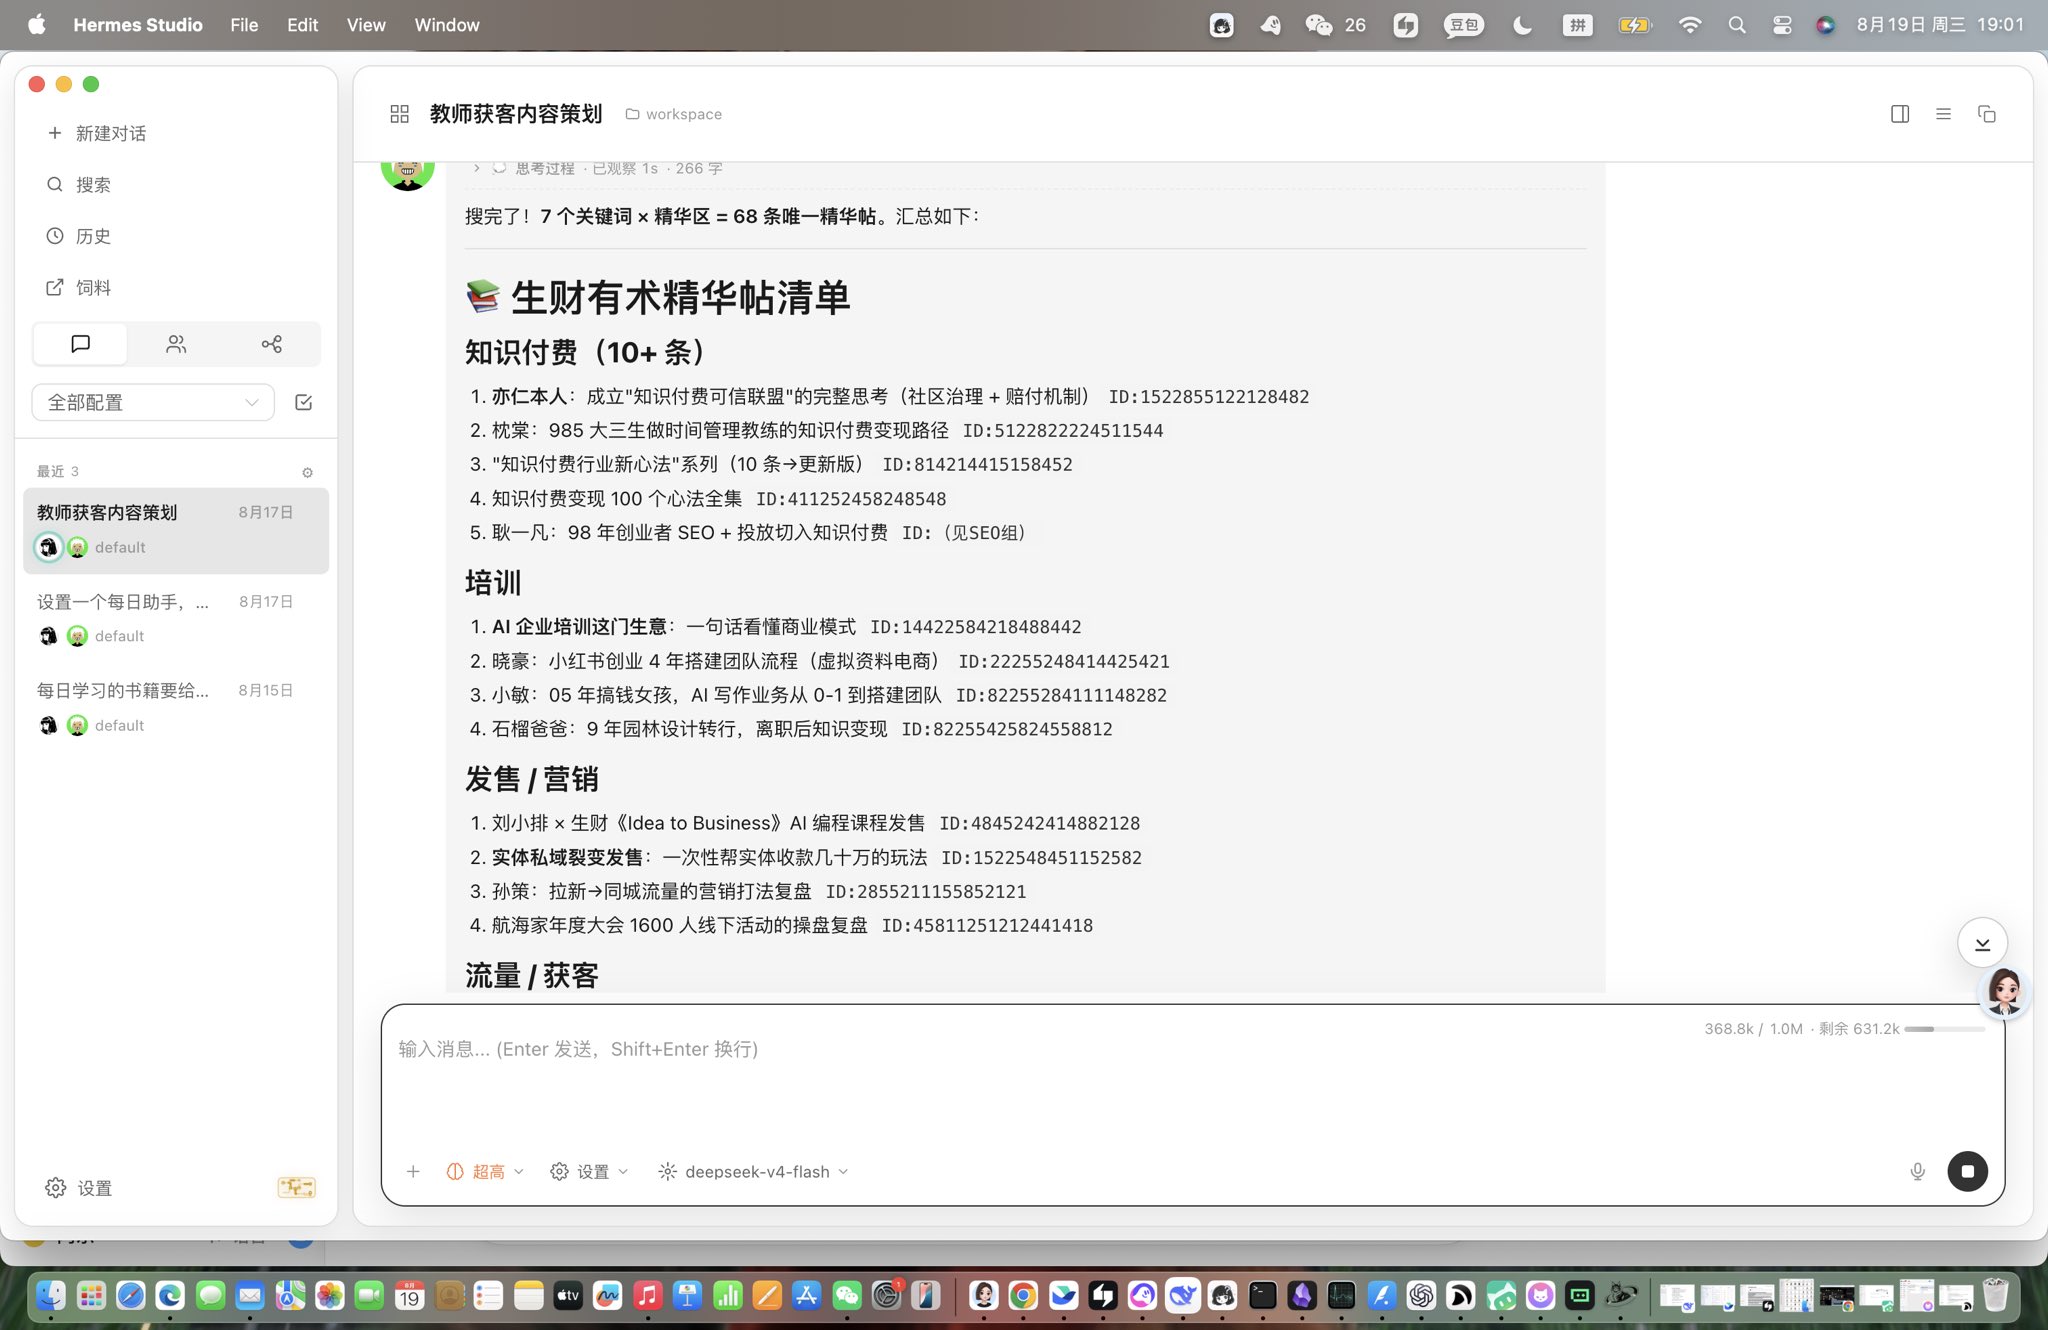
生财MCP实战:用AI玩转知识库系统

作者分享了使用生财MCP的体验,认为它相当于一个庞大的知识库系统。文中列举了五种常见玩法:根据项目赛道让AI搜索关键词并生成30天执行手册;将方法论提炼沉淀为语录和内容创作素材;利用文章框架进行内容创作;快速找到相关资源和人脉;以及利用风向标信息源进行行业机会分析和社群运营。作者还提到生财内部已上线许多新功能,认为其价值很高。

Many Ways to Win: 80种竞争优势策略

作者kepano探讨了生物、个人、产品、组织和网络如何在竞争环境中获胜并建立护城河。文章指出成功的事物往往在一组狭窄且独特的策略组合上优化能力,并系统梳理了80种竞争策略,按积累、价格、时间、独特性、进攻、防御、欺骗、时机、认证、协作等大类分组,每条策略均附有生物学与商业案例,如网络效应、专业化、威慑、模仿、先发优势、垄断声望与共生等,是一本跨越生物进化与商业竞争的思维框架手册。

读书 › 方法论 kepano 2026-08-1910.4 KB 194.9K 2K 70

蒸馏风暴:AI 公司不愿公开谈论的技术竞赛

本文深入探讨了 AI 领域中备受争议的“蒸馏”技术。文章追溯了蒸馏从最初的模型压缩方法到如今被用于“蒸馏攻击”的演变过程,分析了其技术原理、规模化实现方式以及引发的伦理与竞争争议。通过访谈多位研究员,文章揭示了蒸馏并非简单的复制,而是涉及复杂系统工程,且不构成长期壁垒。同时,文章也讨论了蒸馏与数据飞轮的关系,以及行业对黑盒与白盒蒸馏的不同态度,呈现了这项技术背后的商业、伦理与竞争图景。

技术 › LLM 晚点 LatePost 2026-08-1329.5 KB 36.6K 75 78

MiniMax H3 8G 最低配本地部署与出片全流程实测

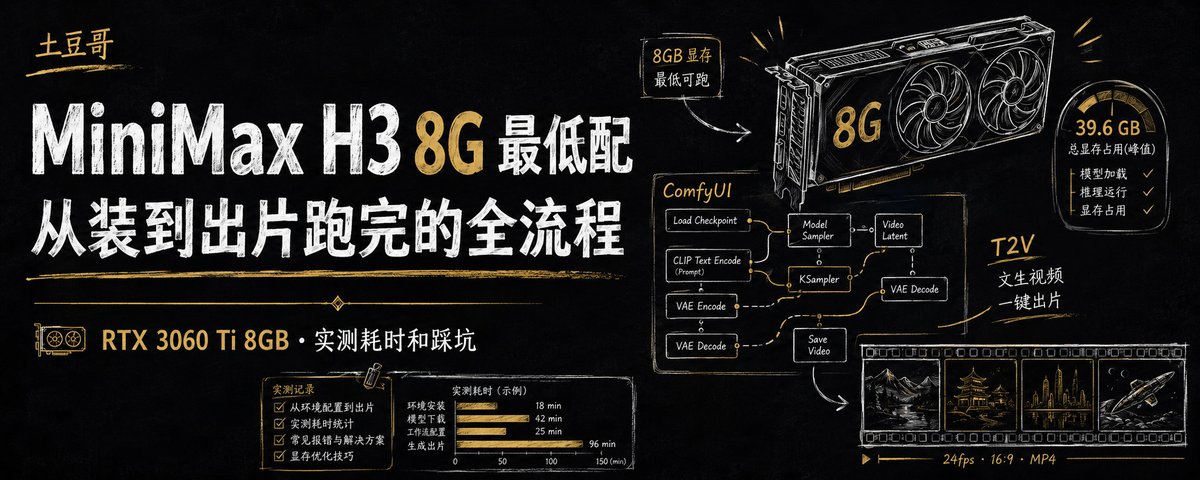
本文详细记录了在RTX 3060 Ti 8GB最低配显卡上本地部署运行MiniMax H3音视频大模型的全流程。涵盖ComfyUI安装、39.6GB量化模型下载及排坑(如文件截断断点续传)。实测验证了该配置的生成耗时、分辨率与帧数限制。文章总结了生成画面的两条硬规则及结构化提示词的三字段写法,并意外发现模型对中文字体渲染极佳,为低显存用户提供了一套可实操的保姆级教程。

技术 › 工具与效率 mousepotato 2026-08-0922.8 KB 75K 140 96

使用 Seedance 2.5 制作超写实 AI UGC 视频工作流

作者分享了使用 Seedance 2.5 模型制作超写实 AI UGC(用户生成内容)视频的完整工作流。该模型能生成30秒无偏移的连贯短片,有效避免了传统AI视频的虚假感。文章详细展示了两个产品推广视频的提示词构建,涵盖镜头、视听风格、人物及分镜脚本。核心步骤是先在 TikTok 等平台寻找已获成功的真实营销视频作为参考,再通过纯文本提示词生成高质量短剧视频,为产品营销提供新思路。

技术 › 短剧 EP 2026-08-0712.2 KB 58.6K 229 81

如何通过推特、油管和短视频把产品卖出去

文章探讨了在产品开发日益容易的当下,分发和销售成为关键瓶颈。作者详细分析了X(Twitter)和YouTube两大渠道的运营策略,包括主页设置、细分领域选择、算法机制及从0到1的增长技巧,强调内容价值与外部助推的重要性,并指出高价值细分领域的变现潜力。

职场 › 营销 eptwts 2026-08-0337.9 KB 9.3K 33