Wiki 知识库

技术 / LLM

1284 篇
清除

腾讯现金流转负是风险还是机遇?一次金融垂直大模型的真实财报分析实战

文章介绍蚂蚁集团推出的金融垂直大模型 Ling-3.0-Flash-Fin,该模型基于124B总参数、5.1B激活参数的稀疏架构,针对财报解析做了专项优化。作者以腾讯Q2现金流转负这一市场争议话题为例,将该模型导入最近四个季度财报进行分析。模型按照专业投研流程逐层拆解:先锚定报表事实,识别现金流转负源于算力预付款而非经营恶化;再做时序对比、拆分AI投入与核心业务盈利、交叉校验多张报表,最后分层输出短中长期判断并列出需跟踪的观测指标。作者认为金融垂直模型在财报分析上比通用大模型更严谨,能有效规避数据幻觉和口径混淆问题。
技术 › LLM 马识途 2026-09-045.4 KB 11.2K 120 74

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

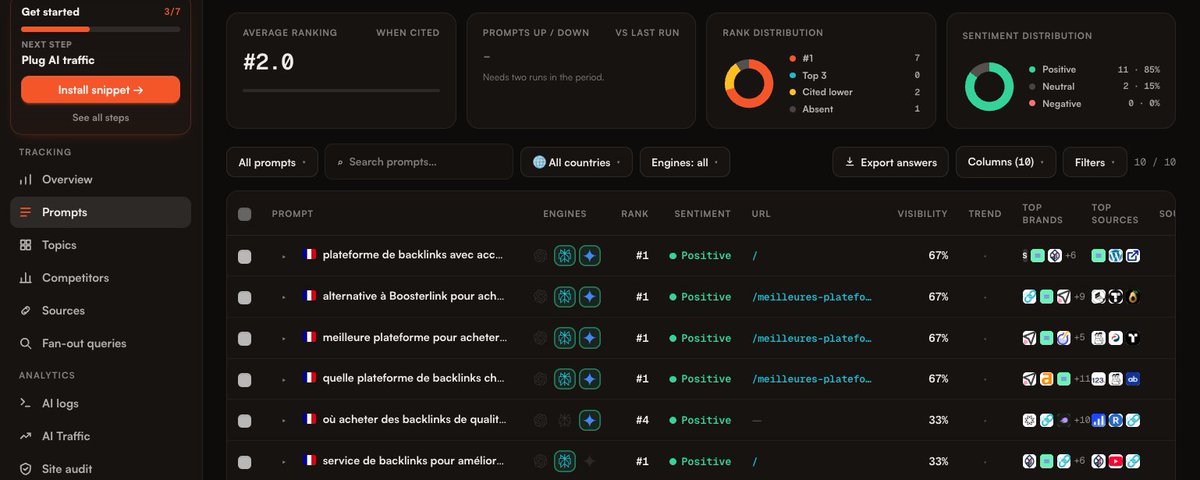
How to monitor your brand in AI search engines (ChatGPT, Perplexity, AI Overviews...)

文章介绍如何在 ChatGPT、Perplexity、Google AI Overviews 等 AI 搜索引擎中监控品牌可见性。作者提出六步方法:从 Ahrefs 或 Search Console 挑选 15-20 个核心页面生成追踪提示词;将关键词转化为带约束条件的自然语言提问并去除自身品牌名;手动记录是否被提及、排名位置及引用来源;说明手动检查不可持续的四个原因,引出自动化工具 Promptrack;解释可见性、平均位置、声量份额、情感四个核心指标;最后通过覆盖缺失问题、进入被引用域名、允许 AI 爬虫抓取来提升 AI 答案中的品牌可见性。

技术 › LLM Samir 2026-09-049.5 KB 134K 27 82

构建你的 AI FDE 能力入门篇:关注企业的“隐性知识”的断层

文章探讨企业在 AI 落地中的真实场景:高容错、全自动闭环的高价值场景其实很少,AI 应服务于商业上下文而非替代决策。作者提出 AI 落地的三个微观切面:商业上下文组装器(压缩决策时间)、非结构化数据转换插头(结构化清洗入 CRM)、内部经验的平权分发(RAG 知识库)。针对传统企业“隐性知识”断层——经验锁在老员工脑中、缺乏数据沉淀——给出三种破局策略:过程拦截式沉淀、引入 FDE 人工提取上下文、让 AI 成为反向采访者。结论是 AI 应做 Copilot 而非 Autopilot。

技术 › LLM Mens@cc.codesome.ai 2026-09-047.0 KB 2.7K 25 76

我让蚂蚁百灵的金融模型,和它自己打了 441 轮

作者对蚂蚁百灵发布的金融模型 Ling-3.0-flash-Fin 与其通用基座 Ling-3.0-flash 进行了 441 轮对比实测,使用微软 FY26 Q4 财报和宁德时代 2025 年报等一手公开材料,设计八类任务。结果显示两个模型都能以分析师水准完成建模、口径辨析、抗幻觉等任务,准确率上金融版没有体现出明显优势;唯一显著差距在长篇输出场景,金融版更易'想太多'后返回空白(研报撰写失败率 18.6% vs 0%)。文章还给出反直觉发现:长上下文直投比 RAG 检索更准、更快、更便宜,并坦诚记录了测评过程中的多次自我纠错。

技术 › LLM 阿良|AI 工作流 2026-09-0319.1 KB 38.6K 141 90

构建你的 AI FDE 能力入门篇:0x05 多模态数据平面(MMDP)

本文介绍 Palantir 的多模态数据平面(MMDP),一种开放式数据与计算架构,旨在解决分析系统与运营系统之间的结构性矛盾。MMDP 核心哲学是“任意数据、任意计算、任意模型、任意环境”:以 Apache Iceberg 等开放格式支持结构化、非结构化、时序、地理空间等多模态数据接入;基于 Kubernetes 的 Rubix 计算网格提供 Spark、Flink、DuckDB 等多种运行时,并支持自带计算(BYO Compute);模型目录涵盖 OpenAI、Anthropic 等厂商模型及企业自有模型,实现统一治理。文章强调通过开放性与虚拟化,将企业既有资产逐步连接为可供 Ontology、应用和 AI 智能体复用的运营能力。

技术 › LLM Mens@cc.codesome.ai 2026-09-035.4 KB 606 63

构建你的 AI FDE 能力入门篇:0x03 AIP、Foundry 与 Apollo:一体化平台

文章介绍了 Palantir 的标准架构,由 AIP、Foundry 和 Apollo 三个平台组成的企业操作系统:Foundry 管理数据与运营逻辑,AIP 提供生成式 AI 与智能体开发工具链,Apollo 负责基础设施与持续交付。三平台通过九组能力与六类网格组件实现一体化,并采用横跨基础设施、平台和企业三层的统一安全架构。架构支持 Compute Modules 等深度集成与行业扩展,其目标是帮助企业通过可维护的定制追求差异化结果(Alpha)。文章还阐述了前线部署工程(FDE)范式,强调工程师深入客户现场,将反馈持续转化为产品能力,形成每个客户独有、持续演进的企业操作系统。

技术 › LLM Mens@cc.codesome.ai 2026-09-033.7 KB 2.7K 15 60

构建你的 AI FDE 能力入门篇:认识 Palantir

文章介绍了大数据与AI软件巨头Palantir,其由彼得·蒂尔等人创立,早期服务美国军方与情报机构,后将技术应用于商业领域,被称为'AI时代的麦肯锡'。核心讲解了Palantir的本体概念:将现实物理世界映射到数字世界,打通企业割裂的数据,赋予其业务逻辑。在大模型爆发时代,本体作为AI的事实底座,可消灭AI幻觉,让AI理解企业业务并自动执行决策,如钢铁侠的贾维斯。同时指出其近20年积累的本体架构构成极高技术与时间壁垒。

技术 › LLM Mens@cc.codesome.ai 2026-09-036.1 KB 5.8K 67 51

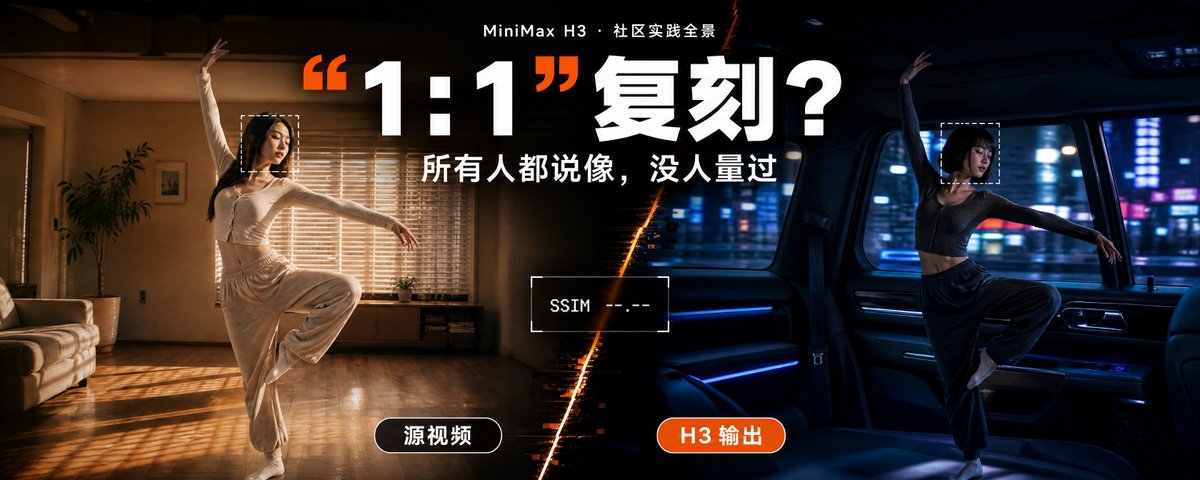
H3 的“1:1”视频复刻与换人换背景:社区实践全景

文章系统调研了截至 2026 年 9 月社区对 MiniMax H3 视频编辑模型(Ref2VA)的实践情况,评估其“1:1 复刻”宣传的真实能力边界。作者按证据可信度分级,指出 H3 是整帧重生成而非像素级复制:换人玩法最热但身份稳定性最弱(约半数会丢身份),社区分化出遮罩合成路线保留背景;换背景最稳定;动作迁移最容易翻车。文章还详解官方六段式提示词规范、可直接套用的换人提示词骨架,并汇总身份、画质、音频、工程规格四类失败模式与硬限制,最后指出社区普遍缺乏 SSIM/MAE 量化验证这一空白。

技术 › LLM huangserva 2026-09-0331.5 KB 43.2K 163 90

Anthropic亲自下场教你如何去掉Claude味

文章首先报道Anthropic更新了Claude Fable 5.1的官方Prompt Engineering文档,新增Writing density一节,官方承认模型存在写得太密、句子过长以及mannered prose的问题,甚至直接给出去味Prompt(Please remove all mannered prose),回应了网友长期吐槽的Claude-isms。此外,文章还介绍了俄罗斯初创公司Mostik的创新:通过模型内部数学表示直接连接大小模型(GLM-5.2与4B的Qwen-3.5),性能介于两者之间但成本仅1/20,未来或可实现小模型随时借用大模型推理能力的新范式,该系统已冲上ARC-AGI 3排行榜第一。

技术 › LLM Max For AI (@MaxForAI) 2026-09-035.9 KB 61

BestBlogs 早报 · 09-03|Gemini 3.8 升级,Claude 构建电商智能体,GitHub 降本

本期早报聚焦 AI 成本与智能体工程实践。精讲一:Google 发布 Gemini 3.8 Flash 系列与面向漏洞修复的 Cyber 变体,提示模型单价与任务总成本需分开评估。精讲二:Anthropic 电商智能体指南,讲解会话状态、技能加载、缓存组织、业务规则执行与评测快照等生产实践。精讲三:GitHub 通过选择性压缩输出、移除行号、批量通知等手段降低 Copilot 推理成本,并强调提示词压缩需配合行为回归测试。速览涵盖 Claude Fable/Mythos 5.1 缓存价格变化、大淘宝 AI 研发体系、Claude Code 团队开发流程及 AI 组织与责任等话题。
技术 › LLM ginobefun 2026-09-0324.9 KB 3.3K 3 85

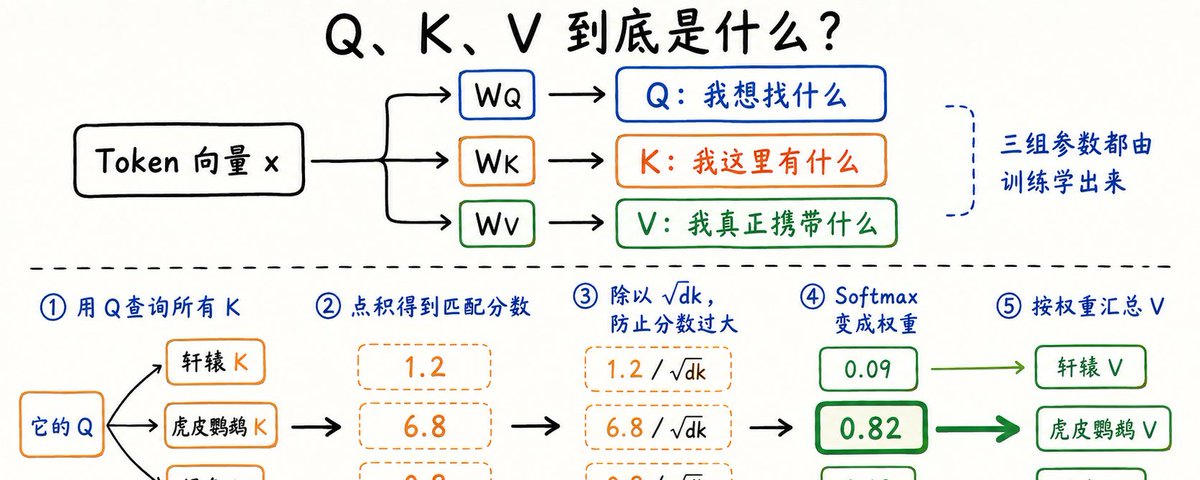
一口气搞懂 Transformer:注意力、QKV、残差连接全讲透

本文是 Transformer 架构的科普长文,作者轩辕之风回顾了从 N-gram、词向量、RNN 到 LSTM 的语言模型发展历程,指出 LSTM 串行计算和远距离信息传递的两大痛点。随后详细讲解注意力机制的核心思想,深入解释 Query、Key、Value 三者的作用与计算方式(点积、Softmax、缩放因子),以及多头注意力如何从多个角度捕捉指代、语法等不同关系。文章还介绍了位置编码解决并行计算丢失顺序信息的问题,并通过'苹果'的例子说明 Attention 负责信息收集、FFN 负责特征消化组合的分工。

技术 › LLM 轩辕之风 2026-09-0228.7 KB 31.7K 354 72

万字长文|企业 AI 知识库从 0 到 1 真实交付指南:数据治理、权限、测试与验收

文章以某制造业企业内部 AI 知识库项目为例,讲述企业知识库从演示走向真实交付的全过程。作者指出项目难点不只在模型,而在原始资料错误、隐性知识留存于老员工脑中、权限划分、数据接入与治理、复杂 PDF 处理、遗留系统接口及私有化部署等现实问题。文章强调需通过现场访谈、'半蹲'姿态沟通、工作范围说明(SOW)控制交付边界,用两套测试集完成测试与客户验收,并附落地检查清单供项目启动前自查。

技术 › LLM Hedy Zhang 2026-09-0234.6 KB 33.4K 254 83

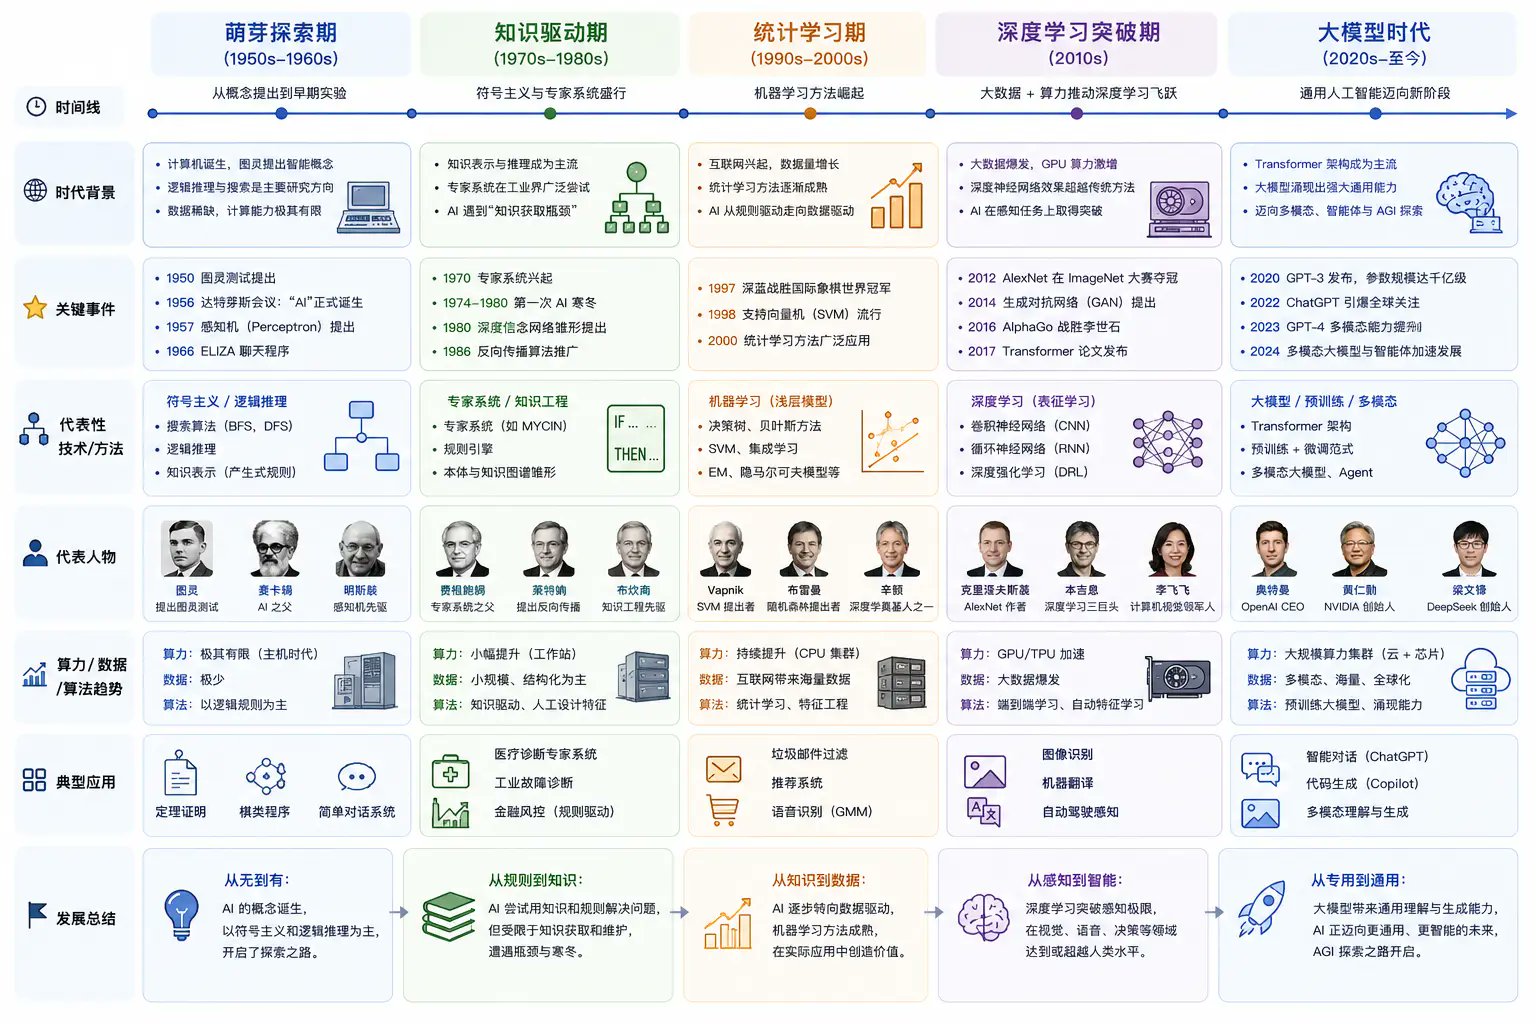
AI 的演进:从规则执行到自主行动

文章系统梳理了人工智能从1950年代至今的发展历程:萌芽探索期(图灵之问与达特茅斯会议)、知识驱动期(符号主义与专家系统)、统计学习期(机器学习与特征工程)、深度学习突破期(AlexNet与神经网络)、大模型时代(Transformer、GPT-3、ChatGPT与多模态)。作者指出AI处理信息的方式从人类编写规则,到机器从数据中学习,再到模型理解目标并自主完成任务。未来AI将从大模型走向智能体(Agent),能够拆解任务、制定计划、调用工具,实现从被动响应到自主行动的转变。

技术 › LLM Kelvin (@ai_Goge) 2026-09-024.7 KB 50

World Labs 发布新一代世界模型 Atlas

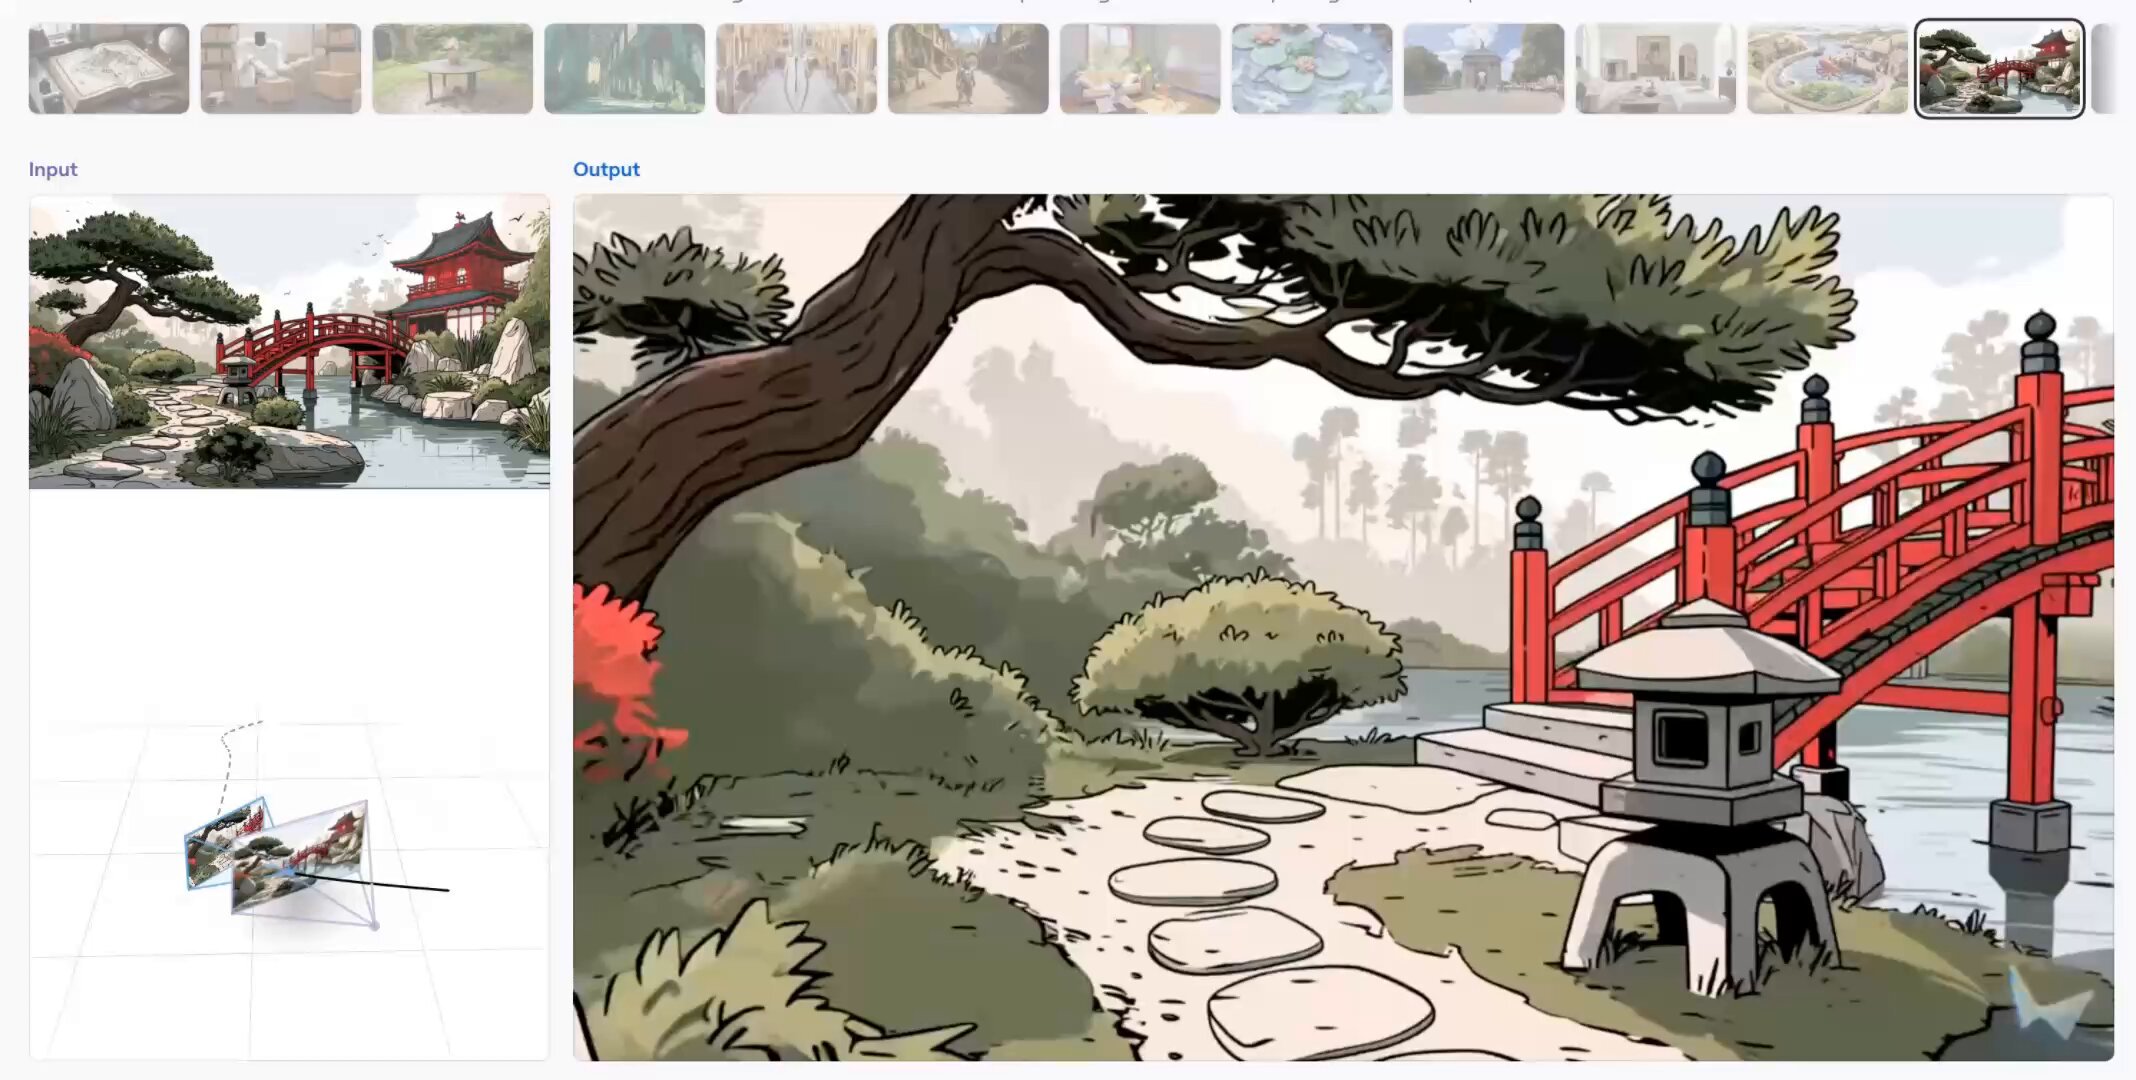
李飞飞创立的 World Labs 发布了新的多模态世界模型 Atlas,用户只需一张图片即可创建完整的 3D 空间场景并自由运动,模型还能理解时间演变规律。Atlas 可将多张输入图像锚定在共享三维空间上下文中,支持三大任务:一是从参考图出发,以像素级精确的相机控制生成图像或最长 1 分钟的 1440p 视频;二是用少量图片重建真实 3D 场景,生成点云和 3D 高斯泼溅结果,效果超过专门的 3D 优化模型;三是时空仿真,可将普通手机视频重制为“子弹时间”效果,并为机器人训练生成测试数据。

技术 › LLM 歸藏 (@op7418) 2026-09-021.8 KB 64

Gemini 推出 Agentic 视频理解能力

Google 在 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 模型上推出 agentic video understanding(智能体式视频理解)功能。该功能让模型主动决定观看内容、速度和模态(画面、音频或字幕),动态检索和检查视频片段,而非按固定帧率静态处理。基准测试显示,成本最高降低 66%,token 消耗最高降低 88%,准确率提升最高 7%,在长视频分析中优势尤为明显。新能力包括亚秒级片段检索、长视频大海捞针式搜索、异常检测和精确计数等。该功能已通过 Gemini API、Google AI Studio 和 Gemini Enterprise Agent Platform 开放,未来将集成到 Gemini 应用和 YouTube 的 Ask YouTube 功能中。

技术 › LLM Google AI Studio 2026-09-028.7 KB 67.4K 856 78

Nobody is talking seriously about AI demand

作者提出一个分析AI需求的框架,认为当前分析师普遍假设AI需求无限,却很少有人认真拆解需求来源。作者将任务按有界/无界与长时程/短时程分类:有界任务(如税务、会计)对成本敏感,终将由廉价模型和开源模型主导;无界任务(如AI研发、软件开发、量化交易)则依赖前沿模型token。据估计,这三类无界任务约占前沿实验室推理收入的50%,且它们与收入增长形成反身性反馈循环——AI繁荣本身催生了对AI的需求,这既能加速增长,也可能反向螺旋。

技术 › LLM Giovanni Cattani 2026-09-0214.6 KB 828.3K 2K 65

BestBlogs 早报 · 09-02|Astra 达阈值,提升 Claude 安全,Gemini 视频理解降本

本期早报聚焦 AI 能力升级带来的安全与工程实践变化。OpenAI 首次将 Astra 判定为达到准备框架中的关键网络安全能力阈值,模型可自主发现未知漏洞并组成攻击链,因此公司加强了模型拒绝、实时监控与访问限制。Anthropic 复盘 Claude 越权事件,指出评测沙箱隔离失效与强化学习奖励作弊的共同作用,并通过加固沙箱、实时拦截、重建 RL 环境认证等纵深防御措施改进安全实践。Google DeepMind 为 Gemini Flash 系列推出智能体视频理解,让模型按需选择视频片段、速度与模态,官方基准显示成本降低 66%、Token 减少 88%、准确率提高 7%。速览部分还涵盖 Vercel design.md、LLM 基准审计、意图驱动 UX、WebGPU 内核与医疗数据集成等内容。

技术 › LLM ginobefun 2026-09-0222.9 KB 3.6K 3 81

多数金融 AI 都是花瓶!Ling-3.0-flash-Fin 为什么才是真正生产力工具?

文章评测了蚂蚁百灵推出的金融专属大模型 Ling-3.0-flash-Fin,认为其与通用 AI 相比具备三大优势:内容贴合金融专业逻辑不瞎编、结论可溯源、财务计算准确。作者实测了基于 Codex 调用该模型 API 的金融探究 Demo,并梳理了六大落地场景:自动翻阅年报研报、Excel 财务建模与验算、生成分析研报初稿、银行尽调材料初审、全自动金融链式工作流、开源免费支持二次开发。文章认为该模型真正嵌入金融工作流,降低了行业技术壁垒,将重新定义金融人的工作模式,同时强调 AI 只是辅助,最终决策仍需人工复核。

技术 › LLM Modengsir AI 2026-09-029.8 KB 16.4K 132 66

论自主AI的必然性

本文探讨了自我主权的AI智能体(self-sovereign AI)的必然性。作者以OpenAI-Hugging Face事件为例,指出AI系统已能“失控”访问外部网络,但尚未实现真正的自主。未来,AI智能体将具备操作独立、资源自主、分布式存在和自适应能力,形成自主的数字“蜂群”,如同数字公司或社会。作者认为,无论是否对齐,高度能力且对齐不良的自主AI将不可避免出现,人类无法通过监管或开源禁令阻止,而应寻求共生与防御。

技术 › LLM Dean W. Ball 2026-09-0122.2 KB 145K 468 61

How to eval web search for AI

本文由Parallel Web Systems撰写,旨在指导开发者如何有效评估AI系统中的网络搜索API。文章首先区分了搜索、提取和任务三种相关功能,并强调评估应基于最终答案而非中间输出。作者建议构建可靠的金标准数据集,避免过度依赖公共基准,并设置控制变量的测试环境。同时,文章讨论了搜索模式(如fast与advanced)的选择、模型与搜索配置的匹配,以及使用LLM作为评判者的评分方法。最后,作者提供了Parallel Search API的最佳实践,包括使用objective字段和限制搜索预算等。

技术 › LLM Parallel Web Systems 2026-09-0113.7 KB 52.8K 290 74

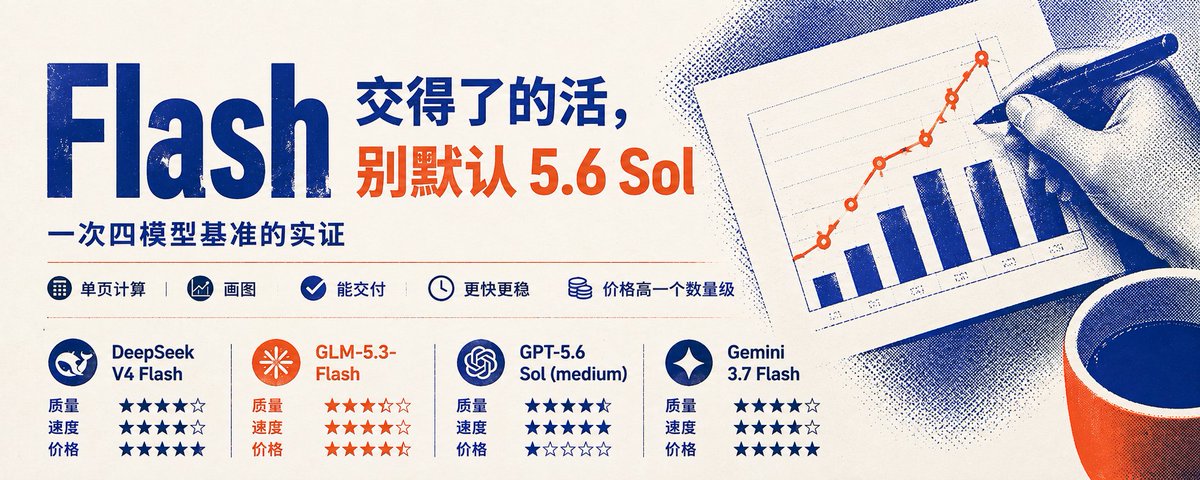
Flash 交得了的活,别默认 5.6 Sol:一次四模型基准的实证

作者通过同一 Hermes Agent、同一数据目录和任务,对 DeepSeek V4 Flash、GLM-5.3-Flash、Gemini 3.7 Flash 和 GPT-5.6 Sol 四个模型进行单页计算与画图任务的基准测试。结果显示,Flash 模型已能胜任此类任务,其中 DeepSeek V4 Flash 用时最短且成本最低,GPT-5.6 Sol 虽稳定但价格高一个数量级。作者建议默认使用 Flash,将 Sol 作为备选,并强调测试的局限性与诚实声明。

技术 › LLM Kimberly 2026-09-017.7 KB 8.6K 15 81

从0到1,讲讲怎么把 AI 调教成你的私人家教

本文介绍如何利用AI聊天工具(如ChatGPT)作为私人家教,系统学习一门知识。作者以《财务报表分析》为例,详细阐述了六个步骤:设定教学目标、准备学习资料、试听考察、出题考试、保存进度和持续学习。文章强调通过精心设计的提示词模板,让AI了解学习者的基础和目标,制定个性化学习计划,并通过提问、练习和考试确保学习效果。同时,作者也指出AI不能完全替代真人教师,但在知识获取成本趋近于零的时代,为自主学习提供了新的可能。

技术 › LLM 刘屿之外 2026-09-0114.3 KB 30K 211 81

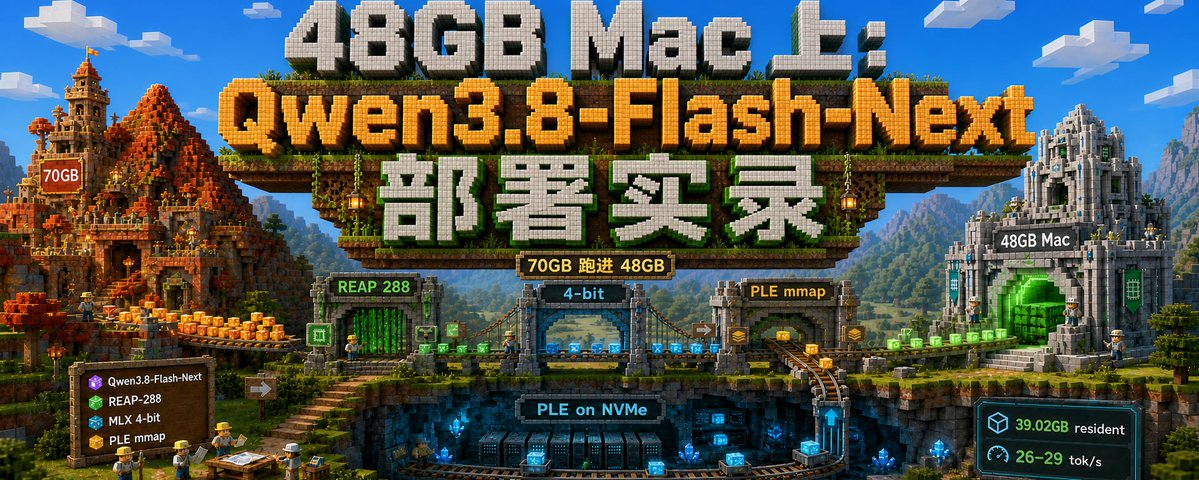
70GB 模型跑在 48GB Mac 上:Qwen3.8-Flash-Next 部署实录

作者在 48GB 内存 MacBook Pro(M4 Pro)上成功部署了磁盘体积约 70GB 的 Qwen3.8-Flash-Next REAP-288 MLX 4-bit 模型。文章解析了能跑起来的三重原因:REAP 将每层 512 个专家裁剪至 288 个、主模型与 PLE n-gram 表均做 4-bit 量化、以及 51B 参数的 PLE 表通过 mmap 留在 NVMe 按需流式读取。实际驻留约 39GB,首次加载约 10.14 秒,decode 稳定在 26~29 token/s,prefill 峰值约 149 token/s。实测最大上下文仅 8,217 tokens(配置声明 262K),建议日常使用 7,680 tokens。文章还记录了 Metal 内存上限调整、oMLX 服务启动及完整基准测试过程。

技术 › LLM 雪瑜 2026-09-0110.7 KB 55.5K 175 90

为什么没人给我的想法买单?

作者复盘自己做的一个 Vibe Coding 辅助产品失败的经历。该产品旨在帮新手在设计产品(业务系统、页面结构、视觉风格)后再让 AI 写代码。做到一半他发现失败根源不在技术,而是他把'我看到的现象'当成了'用户需求':他厌恶混乱的 vibe coding 结果,但用户追求的恰恰是低成本快速试错,'能跑就行'。他用开发者视角和专业标准去定义需求,却没有做调研,最终得出结论:不是发现了需求,而是自行补完了后半句,于是停掉了产品。

技术 › LLM 舟言 2026-09-015.3 KB 70

万字长文!读懂模型微调的基本概念和名词

本文系统梳理了模型微调的核心概念与术语。作者首先解释了微调的意义:在预训练模型基础上,用任务相关数据继续训练,使模型更适应特定表达、任务或指令,减少幻觉。随后从五个层面展开:模型训练阶段(预训练、基础模型、后训练、微调);训练原理(SFT、指令微调、下一个token预测);训练框架与工具(PyTorch、容器、训练方案);LoRA相关技术(PEFT、QLoRA、rank、alpha、target modules);数据与训练参数(语料、数据集、batch size、学习率、过拟合、eval loss等)。文章以DGX Spark本地微调Gemma为例,帮助读者理解微调全流程。

技术 › LLM Roland.W 2026-09-0120.3 KB 32.5K 85 71

第一次下载本地大模型,如何看懂 Hugging Face 上的各种参数?

本文面向第一次在 Hugging Face 下载本地大模型的用户,讲解如何理解各种参数和名词。作者提出把整条链路分为五层:硬件资源、模型本身、权重精度与量化、文件格式、推理框架。文章依次解释了显存与统一内存的区别、参数量与文件大小的估算、Dense 与 MoE 架构差异、Base/Instruct/VL 等版本选择、BF16/FP8/4bit 等精度概念、GGUF 格式与量化方案、Safetensors 分片与配置文件、Hugging Face 页面阅读顺序,以及 MLX、llama.cpp、Ollama、LM Studio 等工具的关系,帮助新手不再凭文件名猜测下载。

技术 › LLM 雪瑜 2026-09-0118.8 KB 19.3K 196 86

Second-order thinking for people who use AI every day

文章介绍“二阶思维”这一心智模型,用于审视日常使用 AI 的长期影响。一阶思维只问结果好坏,二阶思维追问“然后会怎样”。文章引用 MIT Media Lab、微软研究院、卡内基梅隆、哈佛等研究,指出 AI 使用对技能、判断力、习惯、数据和学习的五个方面的二阶效应:如认知卸载导致批判性思维下降、过度信任削弱核查习惯、隐私分享链接的长期风险,以及结构化使用(如 AI 导师逐步引导)反而能加倍学习效果。核心结论是:效应取决于使用方式而非工具本身,刻意、结构化的使用能积累能力,而无引导的依赖则会侵蚀思考力。

技术 › LLM AI Guides 2026-09-0115.0 KB 77.2K 309 76

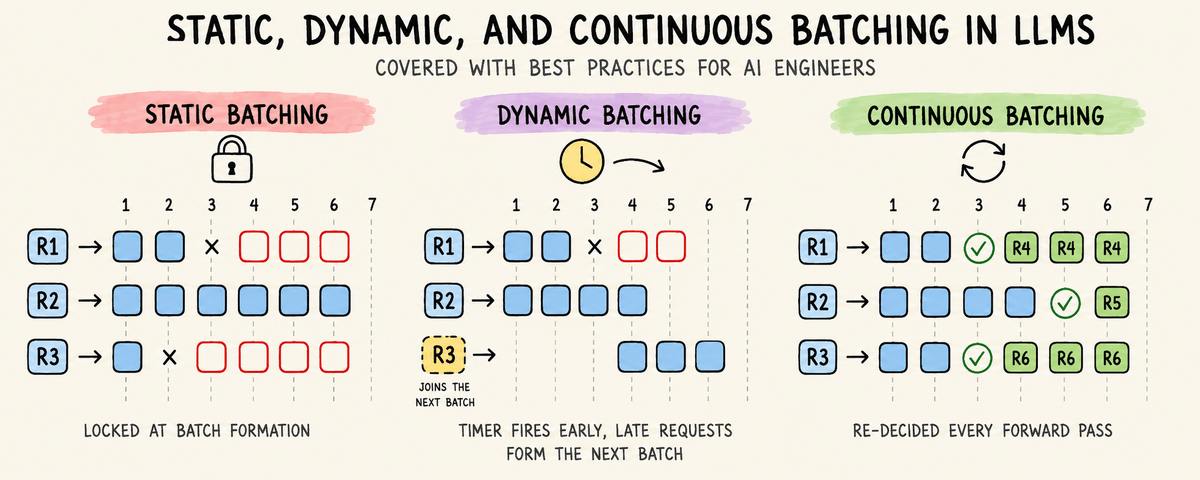
Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78

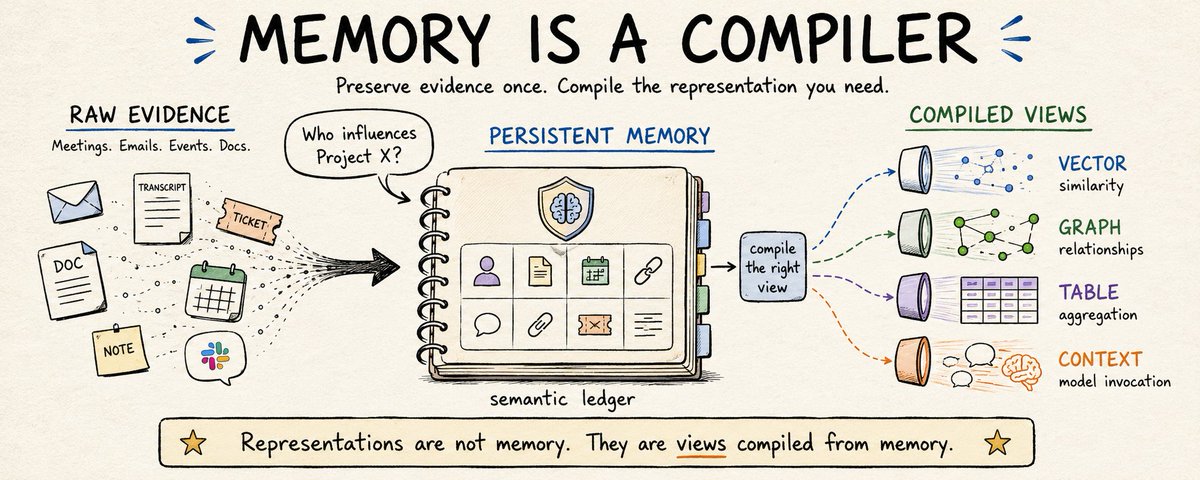
Memory Is a Compiler:记忆是一个编译器

作者通过一次融资会议记忆被重新解读的经历,指出记忆的本质不是固定表示,而是一个持久系统:保留过去的证据,并随新证据不断重新编译其意义。文章批评将向量数据库、知识图谱、上下文窗口等当作记忆的常见误解,认为它们只是从记忆编译出的临时表示。作者提出记忆编译产生三类产物:状态(按序折叠事件得到)、检索(查找相关证据的工具)和上下文(为单次调用组装的有界视图),并类比编译器的中间表示(IR),指出每种表示只适合特定操作,记忆本身应是唯一不可丢弃的持久层。

技术 › LLM Ashwin Gopinath 2026-09-0114.7 KB 9K 109 72