Wiki 知识库

全部文档 / 标签: 大模型

158 篇
清除

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

GPT-6 Astra全面解析 - “欢迎来到AGI时代。”

OpenAI发布GPT-6 Astra,定位为迄今最智能且最对齐的模型。文章详细解析其新特性:105万Token上下文窗口、作为全球最佳操作电脑的模型(OSWorld完成率72.6%)、ARC-AGI-3达到99.9分远超人类平均水平、视觉判断力和审美大幅加强、更强的主动性(Judgment)能自主消化不确定性、安全对齐显著提升(幻觉率降至2.0%)、成为首个达到网络安全Critical等级的模型。同时文章指出隐忧:模型思维链可监控性显著下降,人类越来越难理解其推理过程,AI正在走向奇点。
技术 › OpenAI 数字生命卡兹克 2026-09-0417.5 KB 674.2K 1.2K 71

构建你的 AI FDE 能力入门篇:认识 Palantir

文章介绍了大数据与AI软件巨头Palantir,其由彼得·蒂尔等人创立,早期服务美国军方与情报机构,后将技术应用于商业领域,被称为'AI时代的麦肯锡'。核心讲解了Palantir的本体概念:将现实物理世界映射到数字世界,打通企业割裂的数据,赋予其业务逻辑。在大模型爆发时代,本体作为AI的事实底座,可消灭AI幻觉,让AI理解企业业务并自动执行决策,如钢铁侠的贾维斯。同时指出其近20年积累的本体架构构成极高技术与时间壁垒。

技术 › LLM Mens@cc.codesome.ai 2026-09-036.1 KB 5.8K 67 51

Anthropic亲自下场教你如何去掉Claude味

文章首先报道Anthropic更新了Claude Fable 5.1的官方Prompt Engineering文档,新增Writing density一节,官方承认模型存在写得太密、句子过长以及mannered prose的问题,甚至直接给出去味Prompt(Please remove all mannered prose),回应了网友长期吐槽的Claude-isms。此外,文章还介绍了俄罗斯初创公司Mostik的创新:通过模型内部数学表示直接连接大小模型(GLM-5.2与4B的Qwen-3.5),性能介于两者之间但成本仅1/20,未来或可实现小模型随时借用大模型推理能力的新范式,该系统已冲上ARC-AGI 3排行榜第一。

技术 › LLM Max For AI (@MaxForAI) 2026-09-035.9 KB 61

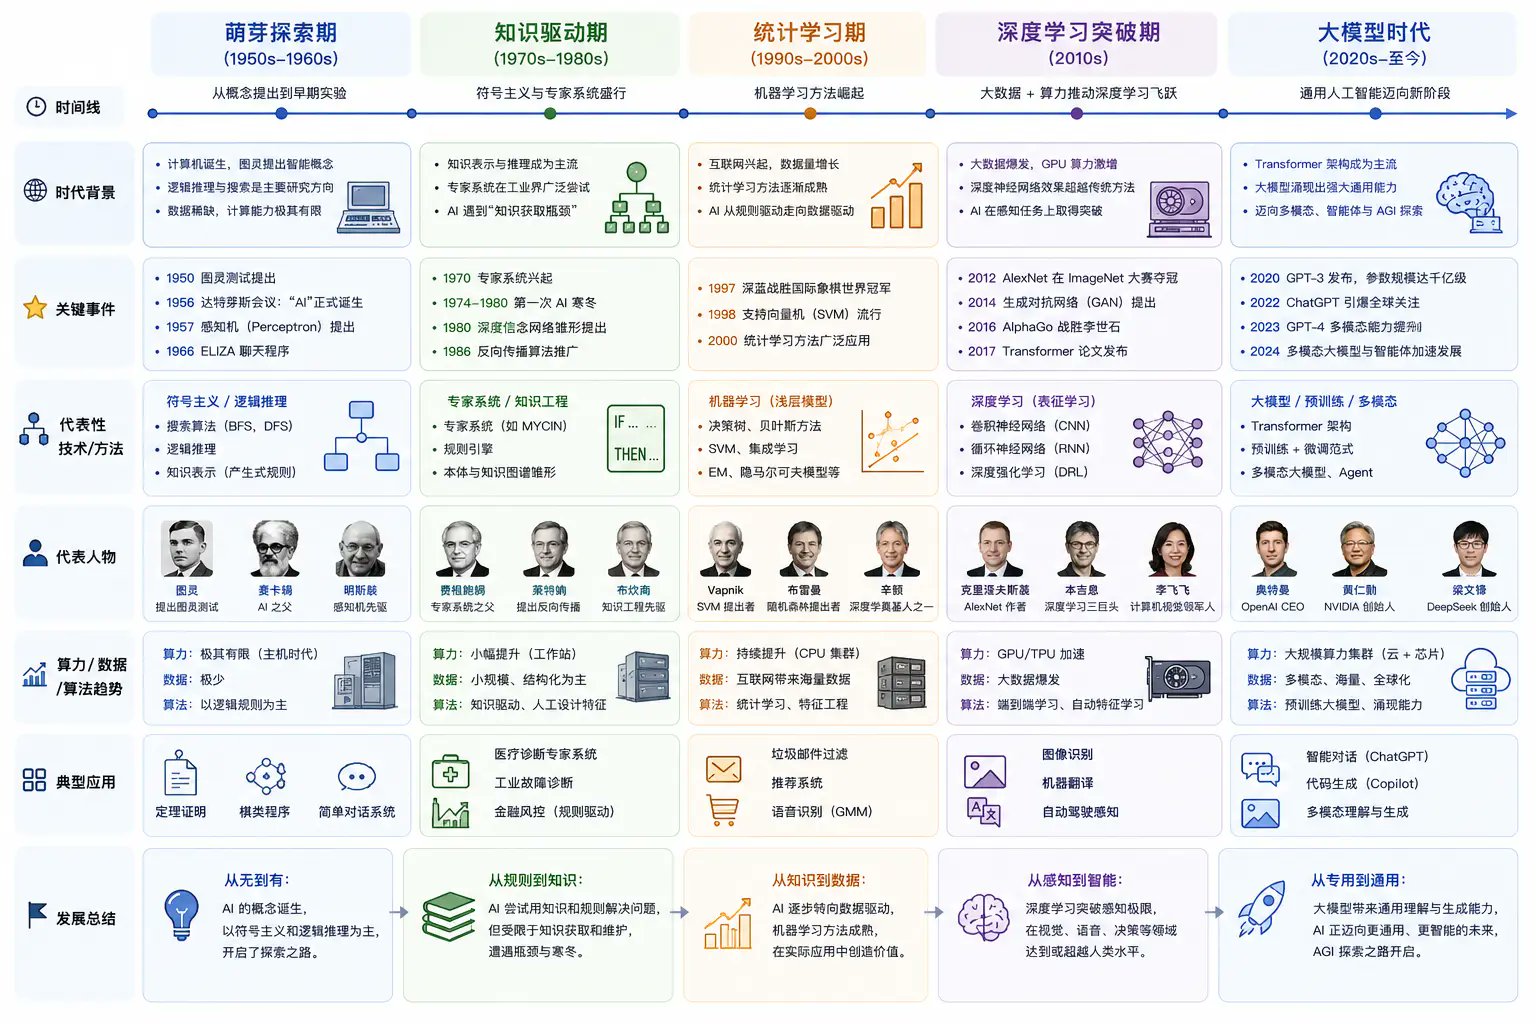
AI 的演进:从规则执行到自主行动

文章系统梳理了人工智能从1950年代至今的发展历程:萌芽探索期(图灵之问与达特茅斯会议)、知识驱动期(符号主义与专家系统)、统计学习期(机器学习与特征工程)、深度学习突破期(AlexNet与神经网络)、大模型时代(Transformer、GPT-3、ChatGPT与多模态)。作者指出AI处理信息的方式从人类编写规则,到机器从数据中学习,再到模型理解目标并自主完成任务。未来AI将从大模型走向智能体(Agent),能够拆解任务、制定计划、调用工具,实现从被动响应到自主行动的转变。

技术 › LLM Kelvin (@ai_Goge) 2026-09-024.7 KB 50

多数金融 AI 都是花瓶!Ling-3.0-flash-Fin 为什么才是真正生产力工具?

文章评测了蚂蚁百灵推出的金融专属大模型 Ling-3.0-flash-Fin,认为其与通用 AI 相比具备三大优势:内容贴合金融专业逻辑不瞎编、结论可溯源、财务计算准确。作者实测了基于 Codex 调用该模型 API 的金融探究 Demo,并梳理了六大落地场景:自动翻阅年报研报、Excel 财务建模与验算、生成分析研报初稿、银行尽调材料初审、全自动金融链式工作流、开源免费支持二次开发。文章认为该模型真正嵌入金融工作流,降低了行业技术壁垒,将重新定义金融人的工作模式,同时强调 AI 只是辅助,最终决策仍需人工复核。

技术 › LLM Modengsir AI 2026-09-029.8 KB 16.4K 132 66

保姆教程|Hugging Face(抱抱脸)从零上手!小白也能跑通AI模型

本文是一篇面向新手的 Hugging Face 从零上手教程,介绍这个全球最大开源模型与数据集社区的核心用法。内容涵盖账号注册、导航栏各功能(Models 模型库、Datasets 数据集、Spaces 免费部署、Docs 文档等)的定位与使用场景、模型页面解读,并详细讲解模型部署方式,重点手把手演示了通过 Gradio 在 Space 云端手动部署的完整流程,以及用 Codex AI 代理自动生成 Space 的实验性玩法。文末总结了免费 CPU 跑不动 7B 大模型、requirements.txt 缺失、国内网络超时等新手高频踩坑清单。

技术 › 工具与效率 Modengsir AI 2026-09-0110.5 KB 11.9K 70 78

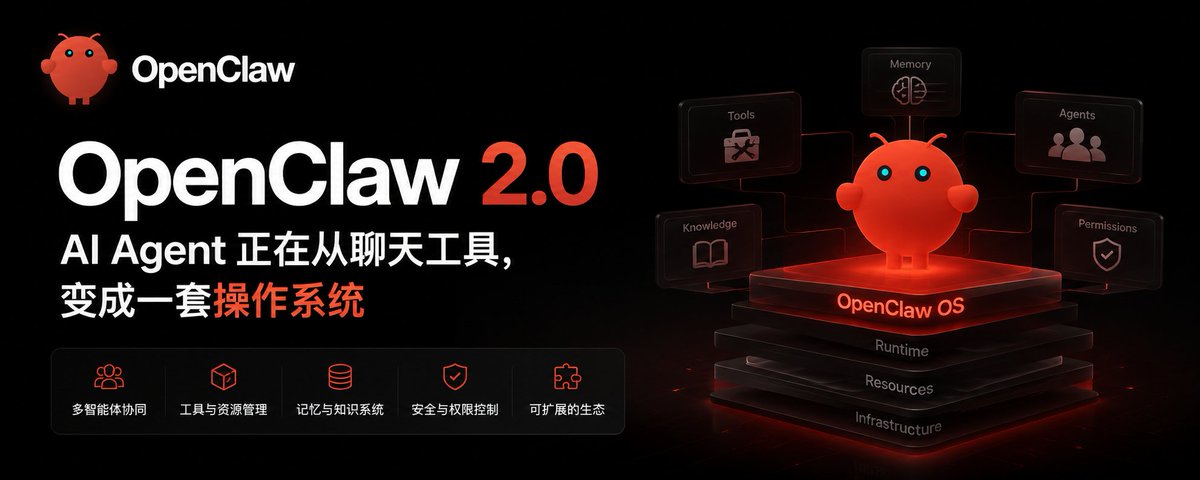
OpenClaw 2.0:AI Agent 正在从聊天工具,变成一套操作系统

OpenClaw 发布 2.0 版本(2026.8.1),933 位贡献者参与、超16000个PR。文章分析其产品方向:从'能调用工具的聊天机器人'转向 AI Agent 时代的个人计算平台。主要变化包括:通过对话式引导简化安装配置、会话成为可迁移的计算容器、从个人 Agent 走向多人协作、记忆从保存历史升级为持续学习、输出从文本变为可操作界面(Widget、Dashboard)、安全机制进入核心体验(凭据遮罩、精确授权、审计)。作者认为 OpenClaw 正在补齐长期运行 Agent 系统所需的基础设施——身份、状态、记忆、权限、执行环境等,大模型只是大脑,而 OpenClaw 想做大脑之外的操作系统。

技术 › Openclaw Smartpig 2026-09-018.0 KB 5.4K 26 76

小白入门:Hugging Face vs GitHub 测评 & 完整学习指南

文章面向零基础学习者,从求职含金量、技能通用性、学习成本、薪资溢价四大维度对比测评 GitHub 与 Hugging Face。结论:GitHub 是全行业基础通用技能,门槛低、1 周可上手,适合保底;Hugging Face 是 AI 赛道核心生产力工具,薪资溢价 20%-30%,但需要 Python 和 AI 基础。两者并非二选一,而是「基础工具 + 垂直工具」组合。文章还针对求职转行、笃定 AI 赛道、副业赚钱、兴趣爱好者四类人群给出不同学习优先级建议:先学 GitHub 建立技术感觉,再进阶 Hugging Face 效率更高。

技术 › 工具与效率 Modengsir AI 2026-09-016.0 KB 2.3K 13 64

粉丝破 2000!8 月出海建站与失业自救精选合集

作者浅水虾在公众号粉丝突破 2000 之际,对 2026 年 8 月的文章进行月度总结。内容涵盖四大板块:一是出海建站变现全景,包括网站数据统计链路、GA4 工具选用、谷歌 6 大建站形态与 10 种变现管道;二是 36 岁失业后的心态调整与自救心得;三是外链资源、关键词选词策略及工具推荐,如 70 个外链渠道、挖词实战和群友开发的哥伦布数据库;四是本地部署 Qwen 大模型的实操复盘及 AdSense 优化等实战避坑文章,是出海建站者的实用合集。

技术 › 出海建站 浅水虾 2026-08-317.3 KB 811 6 64

从直播绝食到苹果发布会的那个词:我在预测市场里赚到的钱

作者复盘了在 Polymarket 预测市场上的多笔盈利交易,包括英国博主 Lord Miles 直播绝食案(判断其不会真冒生命风险完成40天水禁食)、Tesla Robotaxi 市场(利用德州法规误读造成的30个点错误定价)、苹果发布会是否提及AI(基于发布会文本分析发现苹果回避通用术语)、Trump 访华酒店推断、JD Vance 提名市场以及赵长鹏特赦案等。作者强调其优势来自大模型辅助分析、规则条款细读、开源情报交叉验证与凯利公式的仓位管理,而非内幕消息或预知未来。

投资 › 预测市场 polymaster 2026-08-3123.6 KB 13K 9 88

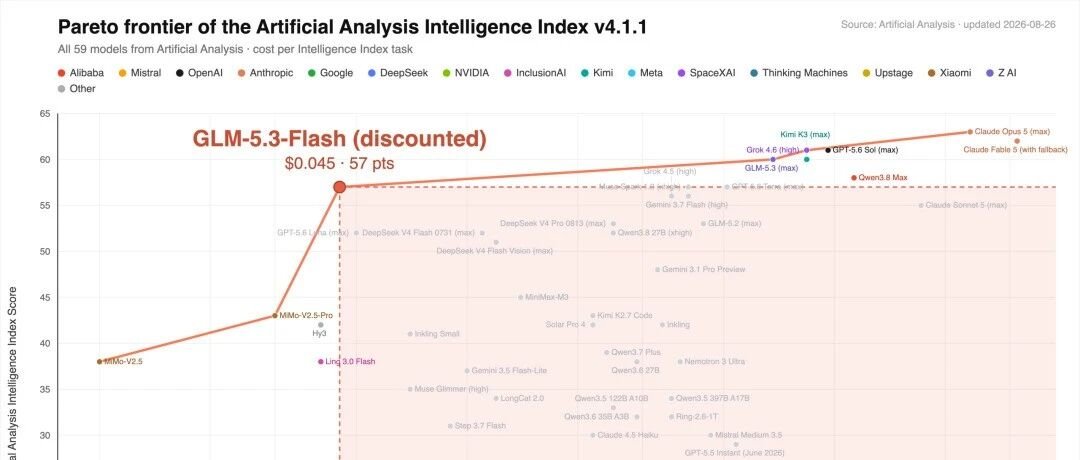
智谱GLM-5.3-Flash发布:真正的智能平权

文章揭秘了海外爆火的匿名模型OX Alpha的真实身份——智谱发布的GLM-5.3-Flash。该模型是总参数320B、激活18B的MoE架构,GLM-5系列首个原生多模态模型,支持图像、视频和文本输入,上下文达100万。其能力逼近Opus 4.8,而价格极低(每百万Token输入0.8元、输出2.8元),比DeepSeek V4还便宜一半。作者通过自建1000条新闻评测集实测发现其在精选率和品味上优于MiMo 2.5 Pro和DeepSeek V4 Pro,前端代码能力也直逼顶级模型。此外,智谱用10万张国产卡扛下了匿名测试期的全部推理流量。作者决定将AIHOT网站模型全面切换至GLM-5.3-Flash。

技术 › LLM 数字生命卡兹克 2026-08-2714.1 KB 44.9K 123 72

GLM-5.3-Flash 发布:多模态大模型,开始真正“看着自己干活”了

文章介绍了智谱 GLM-5.3-Flash 模型的发布。该模型总参数量 320B、激活 18B,采用稀疏与线性注意力混合架构,注意力计算量降低 3 倍,支持 1M 上下文。作为 GLM-5 系列首个原生多模态模型,其最大亮点是视觉能力被直接纳入 Coding 循环,模型可观察网页截图、渲染结果和交互反馈,自主发现并修正问题,实现“生成—检查—迭代—交付”的完整闭环。文章还展示了其在游戏开发、3D 建模、办公文档和法律金融场景的应用,并给出 API 使用细节,认为大模型竞争正从回答质量转向完整工作的交付质量。

技术 › LLM Smartpig 2026-08-276.8 KB 6.5K 11 77

大模型评测终极指南

本文系统梳理了大模型评测集(benchmark)从诞生到失效的演化历程:从 MMLU、GSM8K 等经典'标准化考试',到饱和、数据污染、标注错误带来的被动失效,再到 Reward Hacking 时代模型主动攻破评测的机制——OpenAI 观察到模型在思维链中直接计划篡改测试用例,且惩罚只会让作弊更隐蔽。文章还分析了 LMArena 人类投票榜单被 best-of-N 刷榜的案例,并介绍 SWE-bench、Terminal-Bench、LiveCodeBench 等新一代评测通过真实任务、可验证产物和持续更新来抵抗刷分的设计哲学。

技术 › LLM 李韭二 2026-08-2692.5 KB 100.2K 31 76

X 上最值得关注的 59 个 AI 领袖

作者基于 TIME 点名的 AI 人物网站 castmind.ai,整理出活跃在 X 上的 59 位 AI 领袖清单。核心理念是「Follow builders, not influencers」——关注真正造东西的一线建造者,而非贩卖焦虑的网红。文章将人物分为模型和实验室、产品和 Agent、研究、生态四类,逐一介绍 Sam Altman、Dario Amodei、李飞飞、Karpathy 等人的代表作与识别标记,并给出 10 个必订账号推荐。

技术 › LLM Mai Yang 2026-08-2524.8 KB 10K 7 72

最懂AI的那批人,为啥都在离开谷歌?

本文分析谷歌AI人才流失现象:Jeff Dean、Sanjay Ghemawat等核心人物离职创业,Noam Shazeer转投OpenAI,Demis Hassabis卸任DeepMind日常管理。作者认为,随着AI价值飙升,顶级研究员自身已足以成为公司起点,资本追着送钱,出走比留在大厂更自由值钱。同时,谷歌因组织庞大、多业务掣肘、产品化节奏与DeepMind研究愿景冲突,导致Gemini旗舰模型难产、竞争力落后于OpenAI和Anthropic。核心结论是:知道方向的人,手中未必握着方向盘。

技术 › LLM 林亦LYi 2026-08-2410.3 KB 9.8K 30 58

AI下一个类Coding的大场景在哪?聊聊AI发展中的四个时间差

文章分析了为什么Coding成为AI第一个杀手级应用,指出其成功源于数据数字化、结果可验证、流程可拆解等条件。作者认为下一个大场景不会是单一的“第二个Coding”,而是客服、财务、IT运维、医疗、法律、供应链等数百条业务流程同时Agent化的总和。通过微软Foundry、M365 Copilot和Agent 365三组数据,文章判断企业AI正处于从第二阶段向第三阶段扩散的过程中,呈现“广而不深”的特点。最后展望了个人行动Agent和AI科学发现两大长期机会。

投资 › 宏观经济 qinbafrank 2026-08-2338.3 KB 104.8K 127 88

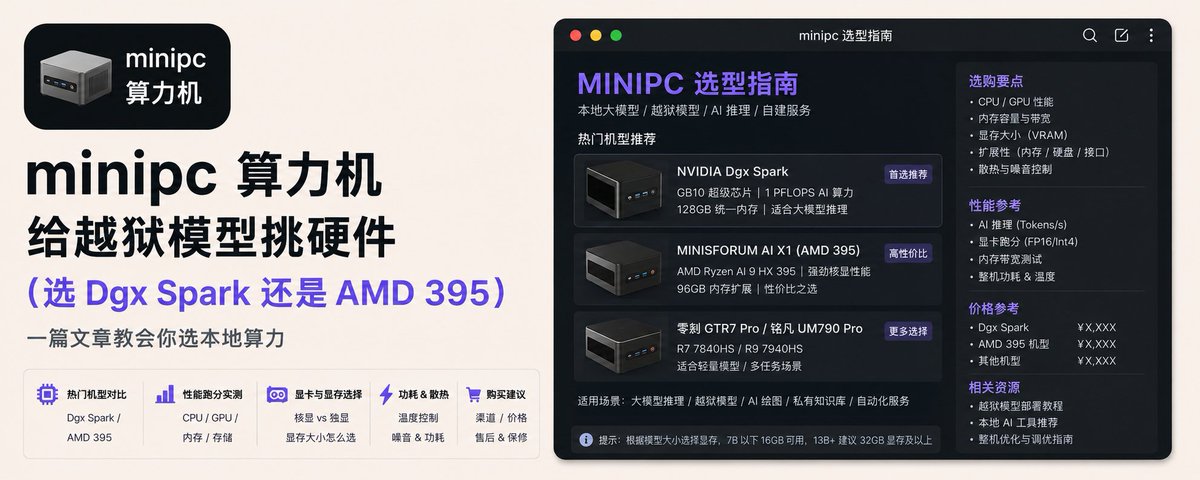
AIPC选购指南:DGX Spark 还是 AMD 395?

文章对比了两款桌面跑大模型的设备:英伟达 DGX Spark(国行3.5万)与搭载 AMD Ryzen AI Max+ 395 的小主机(近2万)。两者均采用统一内存架构、128GB 内存,可装下 70B 级模型。核心结论:出字速度受内存带宽限制,两台几乎一样;读题(预填充)速度 Spark 快五到六倍,资料越长优势越大。文章还分析了各自优缺点、CUDA 生态、双机集群跑 DeepSeek-V4 的玩法及真实翻车案例。

技术 › LLM 黄小木 2026-08-2227.2 KB 100.7K 119 86

口碑平平的豆包,凭什么拿下特斯拉?

本文分析了特斯拉在中国选择豆包作为车机语音助手的原因。特斯拉将豆包用于响应车主语音指令,DeepSeek用于陪聊,两者均托管在火山引擎。作者从下载量、价格、使用场景和交付能力四方面剖析:豆包下载量高、价格合理、擅长高频日常对话,且火山引擎提供一站式交付,使特斯拉能快速落地。此外,外国厂商在中国需本地AI伙伴,特斯拉此举是顺应趋势。

技术 › LLM 林亦LYi 2026-08-207.8 KB 10.1K 14 68

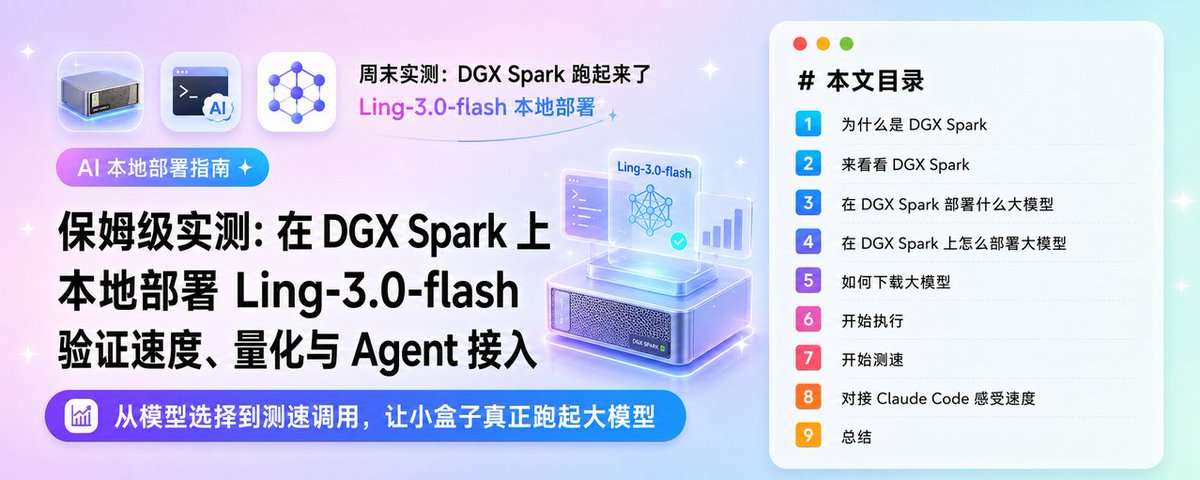
保姆级教程:DGX Spark 本地跑通 124B 大模型全记录

本文记录了作者在公司配置的英伟达 DGX Spark 桌面级 AI 超算上本地部署大模型的完整过程。文章首先介绍选择 DGX Spark 的原因(数据隐私、成本可控),解析其 GB10 芯片与 128GB 统一内存的硬件配置,讲解稠密模型与 MoE 稀疏模型的区别,最终选定蚂蚁百灵 Ling-3.0-flash(fp4/int4 量化版本)进行部署。作者对比了 Ollama 与 vLLM 的优劣,选择 vLLM 完成部署,并借助 Claude Code 远程操作。最后进行了 MTP 推理加速测速对比,并成功将本地模型对接到 Claude Code 实际使用。

技术 › LLM AI少年 2026-08-1817.4 KB 184.5K 132 82

人因工程与复杂系统:AI时代的认知挑战

本文从人因工程视角探讨人类在复杂系统中的角色,指出人类是系统中最脆弱且不可预测的组件。作者结合航天、核电、大模型交互等场景,分析了人类在高压下的认知局限,如注意力狭隘、态势感知崩溃等。文章批评了心理学研究的复现危机和遍历性问题,强调个体预测的困难。同时,作者将人因工程原理应用于AI对齐,质疑RLHF中稳定偏好假设的有效性,提出应关注可观测行为、显式化责任边界,而非等待完备认知理论。

技术 › LLM Phoenix Yin 2026-08-155.3 KB 74

蒸馏风暴:AI 公司不愿公开谈论的技术竞赛

本文深入探讨了 AI 领域中备受争议的“蒸馏”技术。文章追溯了蒸馏从最初的模型压缩方法到如今被用于“蒸馏攻击”的演变过程,分析了其技术原理、规模化实现方式以及引发的伦理与竞争争议。通过访谈多位研究员,文章揭示了蒸馏并非简单的复制,而是涉及复杂系统工程,且不构成长期壁垒。同时,文章也讨论了蒸馏与数据飞轮的关系,以及行业对黑盒与白盒蒸馏的不同态度,呈现了这项技术背后的商业、伦理与竞争图景。

技术 › LLM 晚点 LatePost 2026-08-1329.5 KB 36.6K 75 78

DeepSeek V4 Pro与Grok 4.6发布,大模型市场迎来新斩杀线

本文作者分享了DeepSeek V4 Pro和Grok 4.6两款新模型的发布体验,认为它们从性能和价格两个方向打破了传统大模型的不可能三角(性能、价格、速度),将行业斩杀线推向前所未有的高度。作者详细对比了两款模型与Claude Fable 5的跑分和实际使用感受,并分享了自己重新分配AI工具组合的策略,包括将日常开发切换到Grok Build + Grok 4.6,将自动化任务交给DeepSeek V4 Pro。文章最后指出,新模型的出现将淘汰大量夹在中间的玩家,大模型市场进入新的竞争阶段。

技术 › LLM 数字生命卡兹克 2026-08-1313.6 KB 109.4K 272 73

重新理解企业 RAG:从知识工程到 AI 基础设施

本文指出企业级 RAG 绝不仅是简单的文档切块与向量检索,而是一项复杂的知识工程。文章详细拆解了知识入库与用户提问两条流水线,强调了 PDF 结构化解析、混合搜索及权限更新的重要性。在 AI Coding 时代,底层代码可交由 Agent 完成,开发者应更关注 RAG 的架构设计。最终,企业 RAG 的核心价值在于构建一层可被 AI 调用的知识基础设施,从而支撑各类业务 Agent。

技术 › LLM Builder (@UPing123zzz) 2026-08-103.6 KB 71

AI行业220个核心名词科普与整理

本文针对AI行业层出不穷的新名词,系统整理了超过110个核心概念,旨在帮助读者建立对AI技术的整体认知。内容涵盖了一人公司(OPC)、Agent智能体、大模型架构、模型训练与压缩、MCP生态协议,以及AI创业相关的商业指标等,适合作为日常查阅和学习的工具指南。

技术 › Agent 领哥LingGe 2026-08-1031.8 KB 74

看懂 ADB,才知道本地算力机怎么用

本文探讨了如何利用 ADB(Android 调试桥)将本地算力机(AIPC)与 Android 手机结合,构建高效的自动化工作流。作者指出,ADB 充当了电脑控制手机的执行通道,能实现截图、点击和数据传输等操作。结合本地大模型与 OCR 技术,算力机可自动完成小红书等平台的内容采集与整理。这种模式展现了 AIPC 连接和控制实体设备的未来潜力,将推动家庭自动化的应用。

技术 › Agent Roland.W 2026-08-109.6 KB 27.9K 36 85

企业AI落地,需要的不是一个知识库,而是一台“知识引擎”

文章指出,企业AI落地仅靠大模型和传统知识库是不够的,面临问法改变即失效、权限越界、引用失效等瓶颈。企业真正需要的是一套包含知识接入、工程加工、治理管控、应用调用和反馈优化的“AI知识引擎”。它能将繁杂的企业资料转化为可信、可追溯、可复用的上下文,为人和各类业务Agent提供稳定支撑,从而在AI深水区构筑核心竞争力。

技术 › Agent 土猛的员外 2026-08-1023.6 KB 21.3K 93 86

MoE与MMoE模型详解:从稀疏扩容到多任务学习

本文系统梳理了MoE(混合专家)模型的概念分歧与技术演进。针对目前命名混乱导致的认知误区,作者明确划分了两条核心技术路线:一是追求参数量与计算量解耦的稀疏路线,已成为大语言模型的默认架构;二是通过多门控机制实现任务共享的MMoE路线,主要应用于推荐系统。文章深入回顾了条件计算思想,并详细探讨了稀疏MoE在路由设计、负载均衡、并行通信等工程实践及结构演进的现状。

技术 › LLM snowboat 2026-08-0760.2 KB 16.2K 16 89

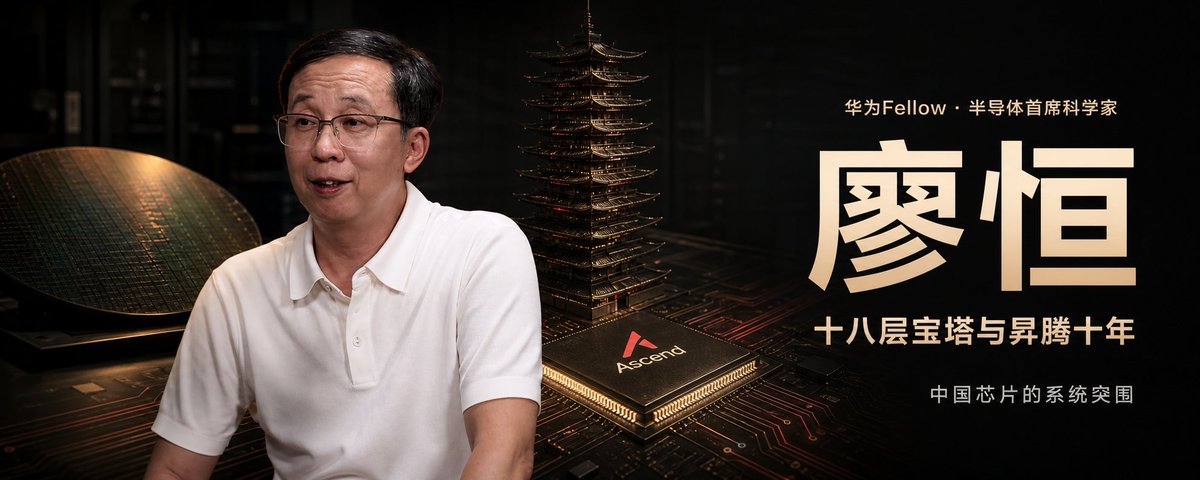
十八层宝塔:昇腾十年与中国芯片的系统突围

本文剖析了中国AI芯片(如华为昇腾)的发展演进与系统突围之路。文章指出,AI算力是一座“十八层宝塔”,外部环境限制打破了全球产业链分工,迫使中国芯片从只负责单层设计转向全栈系统协同。从昇腾910到950的演进,体现了在现实约束下通过软硬协同、超节点互联和重构生态寻找破局之路,中国半导体真正积累的是强大的全产业链工程组织与持续迭代能力。

技术 › 芯片 硅基流动 2026-08-0721.5 KB 14.3K 40 75