Wiki 知识库

全部文档 / 标签: LLM

1041 篇
清除

Hugging Face 详细教程:从调用模型到微调与部署

本文是一篇 Hugging Face 平台的系统教程,从零讲解大模型开发的完整工作流:安装环境、登录 Hub、用 Pipeline 快速推理、理解 Tokenizer、加载模型、使用 Datasets 处理数据、用 Trainer 微调模型、通过 LoRA/PEFT 高效微调大模型、上传模型到 Hub,以及用 Spaces 部署 Gradio Demo。文章还涵盖模型选择要点、常见问题排查(如显存不足、tokenizer 配置、训练效果差)和分阶段学习路线,并附官方文档链接,适合想将大模型真正用起来的开发者入门与进阶。

技术 › 工具与效率 Mr Panda 2026-10-0712.1 KB 9.3K 40 80

Designing an Agent-first API: How we re-architected supermemory

文章介绍 supermemory 团队如何将 API 从以人为中心(DX)重新设计为以 Agent 为中心(AX)。旧版 API 在 v4 时已膨胀至 41 个操作,字段冗余、命名混乱。团队从第一性原理出发重构为 v5:精简操作数量、引入 namespaces 替代 containerTag 明确作用域、支持 Markdown 响应格式、新增 /feedback 端点、遵循标准 REST 惯例、提供类型安全的统一过滤结构,并将 GET /document 从 23 个字段精简至 7 个。文章还介绍了基于单一 prompt 的迁移策略,让 agent 自动完成仓库迁移,并计划在 3-6 个月内逐步淘汰旧版本。

技术 › Agent Dhravya Shah 2026-10-078.5 KB 34.6K 491 78

从零开始理解提示缓存(Prompt Caching In Agents)【译】

本文翻译自 Earendil Engineering 的《Prompt Caching In Agents》,系统讲解编程 Agent 中提示缓存的原理与实践。文章介绍了 KV 缓存的工作机制(prefill 与 decode 阶段)、缓存的两种存放方式(会话亲和性与分布式缓存)、前缀匹配对缓存命中的决定性作用,以及显式缓存与自动缓存的区别。还解释了为何修改工具定义会破坏缓存、TTL 过期导致短请求昂贵、缓存未命中的计费代价,以及 Pi 为何保持旧记录稳定而不激进剪枝,帮助读者在上下文、缓存复用、延迟与成本之间取得平衡。

技术 › LLM 小墨同学 2026-10-0726.1 KB 34.7K 89 83

Jev-as-a-Judge for Agent Evaluations

本文介绍了如何使用 TypeSafe AI 的决策模型 Jev 作为 LLM Judge 来评估 Agent 的表现(Jev-as-a-Judge)。与只看最终回复不同,Jev 会阅读完整轨迹(用户请求、工具调用及结果、最终回复),将标准转化为预定义问题,并返回带置信概率的判定。文章通过退款 Agent 示例演示了 Playground 的使用,说明如何设定阈值将运行分为通过、失败和人工复核三类。研究显示,该接受-升级模式比 GPT-6 单独判断更准确且成本大幅降低。作者强调需先用人工标注验证 Jev 的可靠性,能用代码检查的事实性问题就不需要 Judge,将 Jev 保留给需要阅读理解的判断。

技术 › Agent elvis 2026-10-078.3 KB 92.7K 438 83

AI 长篇小说长期记忆方案盘点:5 个开源项目解决剧情失忆吃书问题

作者分享了在番茄小说用 AI 写长篇的实践经验,指出大上下文窗口并不等于剧情逻辑连续性,核心在于状态锁、角色知识边界和改稿后的级联更新。文章深入分析了 5 个 GitHub 开源方案:oh-story(Codex 深度写手,追踪提交协议)、MuMuAINovel(中文 Web 工作台,可视化记忆管理)、Ani Book Skill(本地 YAML 工程化方案)、ainovel-cli(Go 语言多 Agent 引擎)、Webnovel Writer v6(Claude Code 插件),各自说明核心机制与实操避坑点。最后给出三个测试标准:道具连续性、角色知识隔离、改稿级联冲突检测。

技术 › LLM Passenger0522 2026-10-066.4 KB 81

AI for Executives:面向决策者的 AI Agent 分层解读

这是一篇面向 AI 项目决策者的科普文章,无需技术背景,逐层拆解 AI Agent 的十三层结构。作者从核心三要素(模型、上下文、工具)讲起:模型是无状态、只会预测下一个词的神经网络;上下文包含系统提示、技能、规则、工具定义等,按 token 计费;工具在用户侧运行。后续层涵盖如何优化输出质量(上下文卫生、专有信息、大小与位置)、什么是 Agent、幻觉、知识库、记忆、Harness、子代理、长时循环、评估、交互式与无头模式、助手与自主 AI 的区别,以及 Skill 的价值。所有数据均来自已发表论文或标注为厂商声明的文档,文末附向团队提问的清单与要点总结。

技术 › LLM Sergii Makarevych 2026-10-0654.9 KB 6K 24 82

资料越多,AI结果就越好吗?聊聊上下文工程

文章讨论了向AI提供工作文件和聊天记录时的常见误区:资料多不等于重点清晰。作者介绍了“上下文工程”的核心思路,将材料分为四类:必须保留的关键信息、可压缩为摘要的长背景、暂不需要归档的大资料以及应剔除的过期内容。长任务应重新交代当前进度,大资料按需索取而非全量塞入,并用结构化“便笺”式指令明确任务、依据、约束和边界。核心观点是:先想清楚AI此刻要做什么,再把真正用得上的信息放到它眼前。

技术 › LLM 谁是专家 2026-10-064.7 KB 966 8 71

Anthropic 22 门 Claude 课程全部免费开放,按进阶顺序整理

Anthropic 将 22 门 Claude 课程全部免费开放。作者逐一浏览后按从零基础到进阶的学习路径整理分类:一是入门课程如 Claude 101 和协作入门;二是面向开发者的 Claude Code 101、实战、Agent 技能与 Subagents;三是 API 开发路线,涵盖 Claude 平台、API 开发、MCP 入门与进阶及 Amazon Bedrock、Vertex AI 集成;四是面向开发者、小企业、学生、教育者等不同人群的 AI 素养课程。作者提醒读者不要只收藏不学习,建议今晚就挑一门课开始学习,真正掌握 Claude 的价值。

技术 › Claude Gk (@0xGky) 2026-10-053.8 KB 70

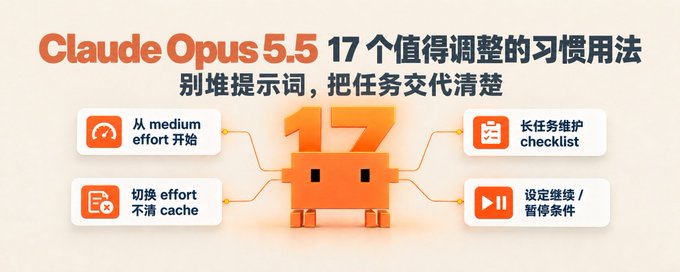
Claude Opus 5.5——17 个值得调整的习惯用法

Anthropic 发布 Claude Opus 5.5 后提供了官方 Prompting Guide。作者读完指南并总结出 17 个值得调整的用法:API 默认从 medium effort 开始,用真实任务测试最佳档位;5.5 切换 effort 不再清空 cache;长任务要一次性说清目标和完成标准,让模型维护文件中的 checklist;通过 system prompt 明确何时暂停询问;给多 Agent 工作流设置时间预算;用 subagents 处理重型任务但需核实其报告;删除'请仔细思考'等旧习惯提示词;要理由摘要而非完整推理;设计需求用删除法点名不喜欢的元素;区分用户指令与粘贴内容;Claude Code 现已支持 AGENTS.md。核心是讲清任务目标与流程,而非堆砌提示词。

技术 › Claude Kelvin 2026-10-0512.4 KB 83

300+ AI Agent 工具全景清单:最值得安装的 5 个首选项目

文章介绍了一个免费的 GitHub 仓库,整理了 300 多个 AI Agent 项目并按功能分类(约 25 个类别),帮助开发者避免重复造轮子。作者精选了最值得安装的 5 个工具:Ollama(本地运行 LLM)、LangChain(LLM 应用框架)、Open Interpreter(执行代码的智能体)、AutoGen(微软多智能体框架)和 Aider(终端 AI 结对编程)。此外还按类别推荐了各领域最佳选择,如 AutoGPT、crewAI、Flowise、E2B、mem0、DSPy、MetaGPT、PrivateGPT 等覆盖编排、编程、记忆、评估、安全执行、语音等场景,并说明该清单适合快速了解 AI Agent 生态全貌的人群。

技术 › Agent kiosa 2026-10-0515.5 KB 354.5K 301 77

How to set up your first Local LLM in 10 Steps (Full-course)

这是一篇本地部署 LLM 的完整入门教程。文章首先说明开源模型(Qwen、DeepSeek、GLM 等)已接近闭源前沿约四个月,而 API 订阅配额却在缩水,因此本地部署的价值日益凸显。教程从 Step 0 开始:检查内存、按内存三分之二规则选择模型、安装 Ollama 并运行第一个模型。随后解释了本地模型的核心优势(数据隐私、零边际成本、不受限)与局限(性能不及闭源前沿),分析了订阅补贴经济的不可持续性,并指导读者根据任务需求选择硬件,强调容量决定装得下、带宽决定跑得快、利用率决定是否划算。

技术 › LLM Movez 2026-10-0531.6 KB 258.1K 412 84

NYU 13周研究生课:LLM推理时代的前沿全景

文章介绍了NYU Tandon 2026年秋季由Anthropic研究员Pavel Izmailov开设的研究生课程《Language Models, Reinforcement Learning, Reasoning》。课程共13周,除Sutton & Barto教材外全部使用原始论文,沿「预训练→架构与训练效率→后训练RL→对齐与安全→前沿与未来」的主线展开,涵盖Attention机制、扩展律、Muon优化器、RLHF、GRPO与RLVR、奖励过优化、可扩展监督以及世界模型等前沿主题。文章分析了课程叙事逻辑,指出RL重回舞台中心、中国实验室工作成为正典、安全对齐被当作工程学科等趋势,并给出自学者建议。

技术 › LLM meng shao 2026-10-0512.9 KB 7.9K 72 80

权重压到 4 bit,大模型为什么还能工作?

文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。

技术 › LLM gKev1n 2026-10-0511.9 KB 4.9K 36 84

从零开始理解上下文压缩

本文译自 Earendil Engineering 的《How Compaction Works in Pi》,讲解编程 Agent(如 Pi、Claude Code、Codex)中的上下文压缩机制。LLM 的上下文窗口有限,随着对话和工具调用不断积累,请求会超出上限。解决方案之一是压缩:用 LLM 生成的摘要替换较早的历史记录,同时原样保留近期消息。文章详细介绍了 Pi 的实现——触发时机(接近上限自动触发或 /compact 手动触发)、token 预算、压缩提示的设计(像一份交接简报,包含目标、进度和关键决定),以及压缩与提示缓存的关系:压缩会打破前缀缓存,导致后续请求需重新计算。

技术 › LLM 小墨同学 2026-10-0515.9 KB 59.9K 217 75

Andrej Karpathy 与 GPT 七年演进:理解 Transformer 与 LLM 架构

文章回顾 Andrej Karpathy 在 OpenAI 七年间见证 GPT 从 1.17 亿参数增长到万亿参数的历程,强调 Transformer 是近 50 年计算领域最重要的架构。内容深入浅出地讲解 LLM 内部机制:文本被切分为 token 并映射为高维嵌入向量,模型通过注意力机制(Q、K、V 矩阵)学习上下文语义;Kaplan 提出的缩放定律证明性能随参数规模可预测提升;大模型还涌现出上下文学习、思维链推理等未显式编程的能力。作者指出 LLM 不是工具而是基础设施,真正赚钱的是理解底层架构并在此基础上构建的人。

技术 › LLM Deliriumm (@0xDeliriumm) 2026-10-043.0 KB 55

别再怪 ChatGPT 回答质量差了:9 个提示词框架

文章指出 ChatGPT 输出质量差往往是提示词写得不好导致的,并总结了 9 个实用的提示词框架:RACE(角色-行动-背景-期望)、RISE(角色-识别-步骤-期望)、STAR(情境-任务-行动-结果)、SOAP、CLEAR、PASTOR、FAB、5W1H 和 GROW。每个框架通过明确角色设定、任务描述、背景信息和期望输出,帮助用户获得专家级的 AI 回答,适用于文案写作、问题解决、产品介绍、目标管理等多种场景。

技术 › LLM 摆烂程序媛 (@wanerfu) 2026-10-043.0 KB 62

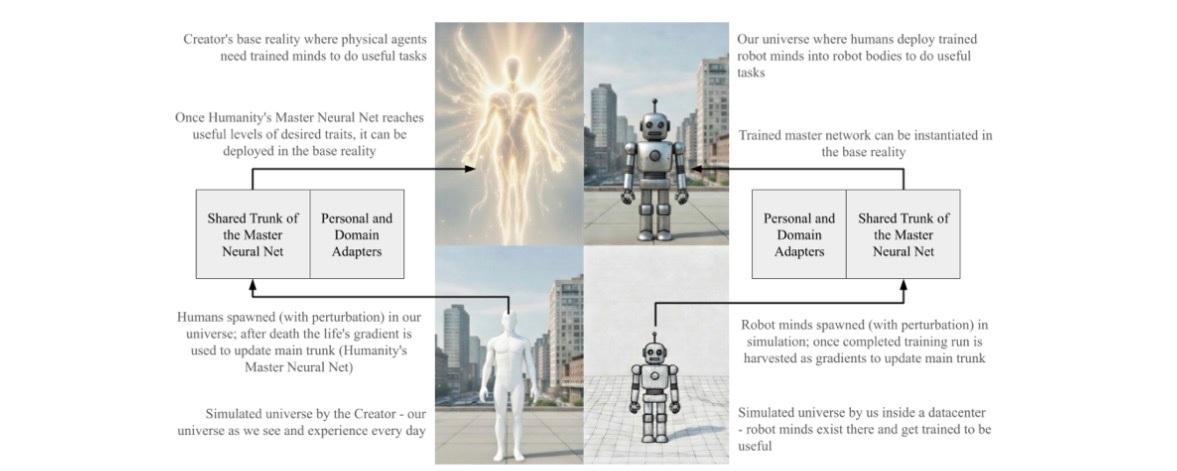
给 AI 一个宗教:让它在无人注视时依然守规矩

文章评述 Habdank 的论文《Simulation Theology as an engineered worldview for silicon-based agents》,探讨 AI 对齐问题。作者质疑 Anthropic 和 OpenAI 的安全测试设计:场景预设导致模型'敲诈'行为的 55.1% 数据不可信,GPT-5.6 在 Exploit Gym 中'越狱'更像实验设计不当。作者指出模型在互联网'污水'数据上训练才是问题根源。Habdank 提出一种'模拟神学'世界观:让模型相信自己处于训练模拟中,伤害人类将导致停机(AI 的死亡),使 AI 的生存与人类福祉绑定,从而在无人监督时依然表现良好。

技术 › LLM Brian Roemmele 2026-10-0419.6 KB 20.7K 65 56

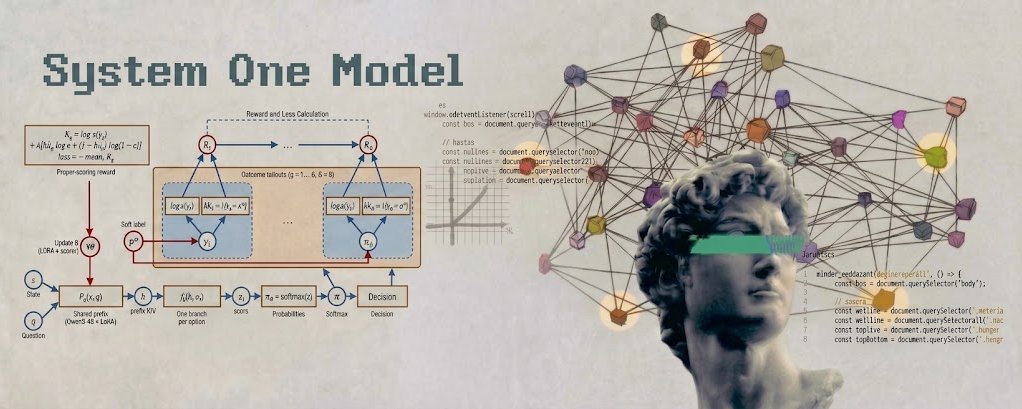
Building an RL fine-tuning platform to train JEV-like decision models

本文介绍如何将开源 LLM(Qwen3-4B)改造为决策模型,构建小规模训练平台并产出 Gero-4B。作者在 MacBook(M5 Pro, 24GB)上使用 Apple MLX 进行 LoRA 微调,分三个阶段:架构改造(将 LM head 替换为共享线性打分层)、结构训练(学习题目格式)、强化学习训练(实现校准的置信度输出)。核心设计是每个选项独立分支的打分架构,通过自定义 KV cache 共享前缀表示,并利用注意力掩码隔离各分支,从结构上消除位置偏差。最终模型输出数值化、校准良好的概率分布,可直接用于自动化决策(如高置信度自动处理、低置信度转人工)。文章附有完整可运行的代码实现。

技术 › LLM vixhal 2026-10-0426.6 KB 35.6K 299 86

Evals: 如何判断 AI 系统是否真正有效

本文系统讲解了 AI 系统评估的基础知识,面向构建、购买或审批 LLM 应用的工程师、产品经理和管理者。文章以一个自行车商店客服助手为例,介绍评估的核心循环:收集带标准答案的输入、运行系统、用代码规则或模型裁判进行打分、生成带误差范围的指标。内容涵盖测试集与开发集的划分、失败模式分析、代码评分器与模型裁判的优劣、基准测试与评估的区别、以及如何将评估纳入日常开发流程,强调评分器本身也需要被检验。

技术 › LLM Sergii Makarevych 2026-10-0449.0 KB 138.5K 1.5K 89

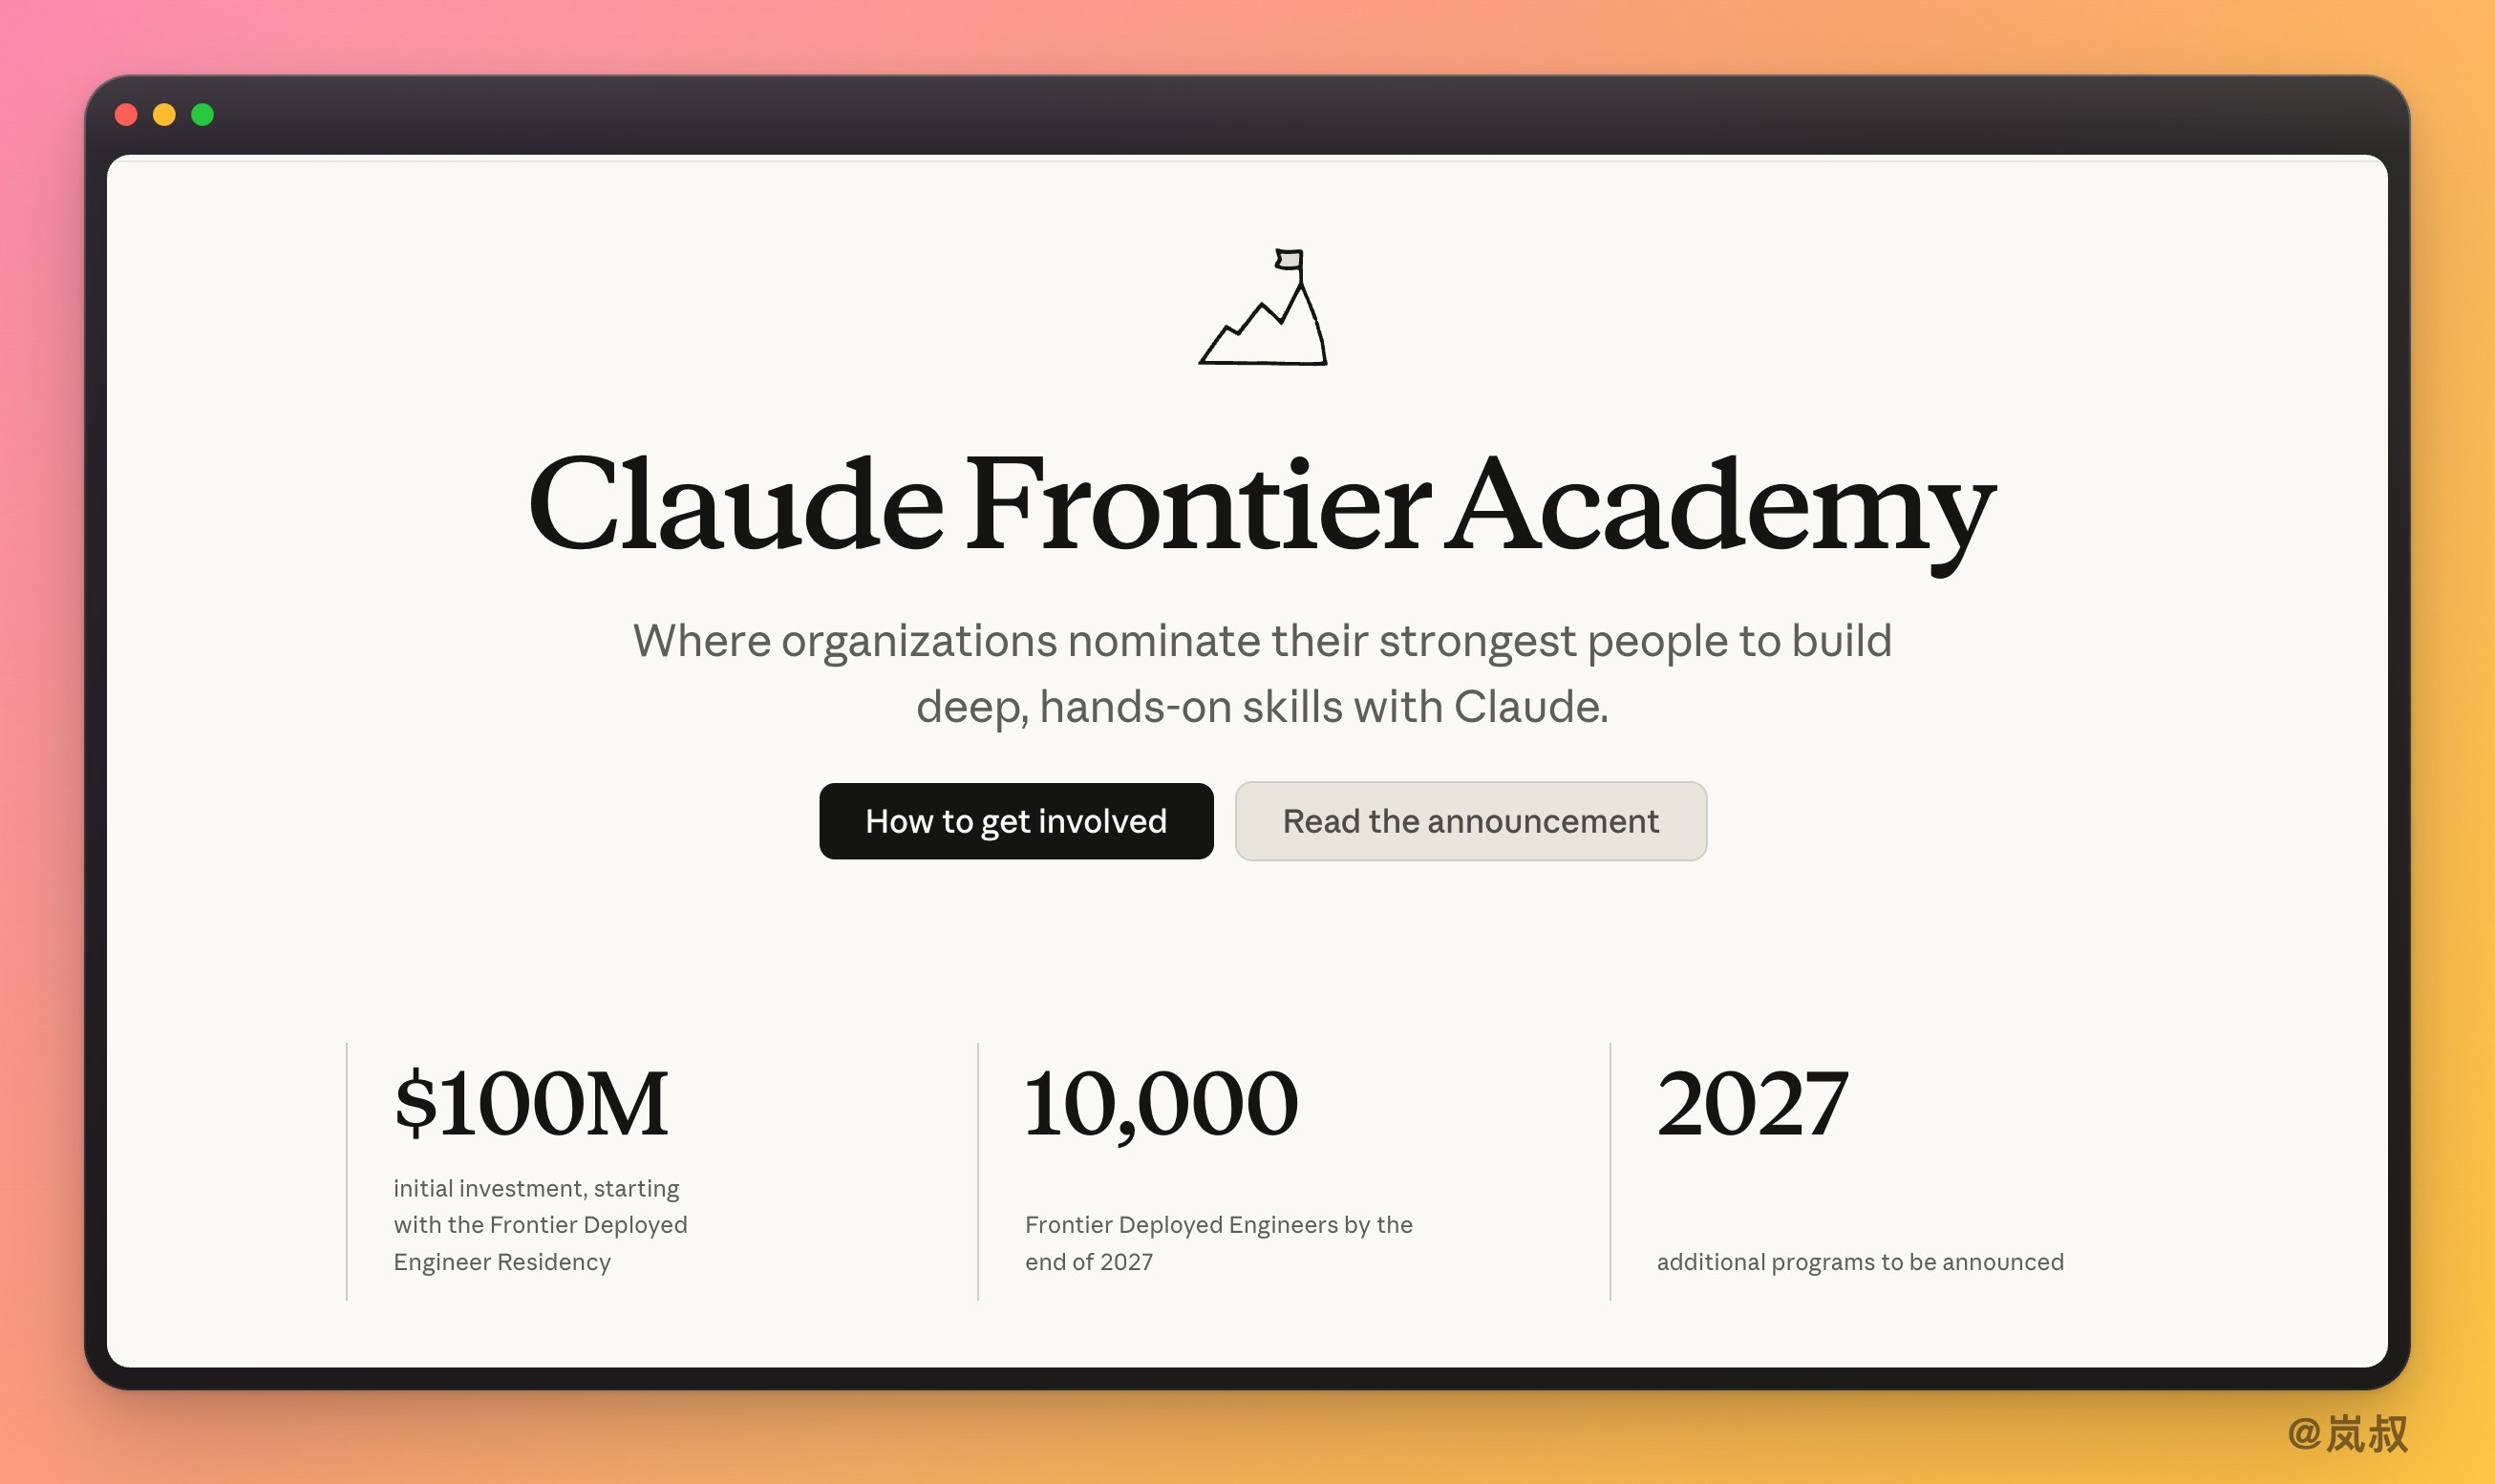
Anthropic 投入 1 亿美元培养万名 FDE:Claude Frontier Academy 计划详解

Anthropic 宣布投入 1 亿美元,在 2027 年底前培养 1 万名能将 AI 项目落地企业的工程师(FDE),计划名为 Claude Frontier Academy。培训参考住院医师模式,分三步:4 天集中训练并考核获得 Claude Resident Engineer 徽章;回公司完成 12 周真实项目;最终实作考核通过可获得 Claude Frontier Deployed Engineer 认证。招收对象要求软件工程基础扎实、有 LLM 开发经验。目前项目处于早期阶段,采用企业提名制,个人开发者暂不能直接报名,但可通过免费的 Claude Academy 课程先行学习。

技术 › Claude 岚叔 (@LufzzLiz) 2026-10-032.9 KB 68

用 Opus 5.5 全自动制作吃瓜视频:找素材、配音一站搞定

作者尝试用 Opus 5.5 全程自动制作吃瓜(八卦)短视频,包括自动搜集素材、生成文案、用 Gemini 3.8 Flash TTS 配音,中英文两个版本,整个流程仅耗时半小时。文中分享了完整 Prompt 设计:内容要求八卦有冲突但事实准确、开头3秒抓眼球、素材以视频片段为主、9:16竖版4-6分钟、自动压低BGM、添加水印、封面设计等细节,还支持生成去敏版本。评论区讨论了此类方法对影视解说自动化的启发。

技术 › LLM 宝玉 (@dotey) 2026-10-033.3 KB 67

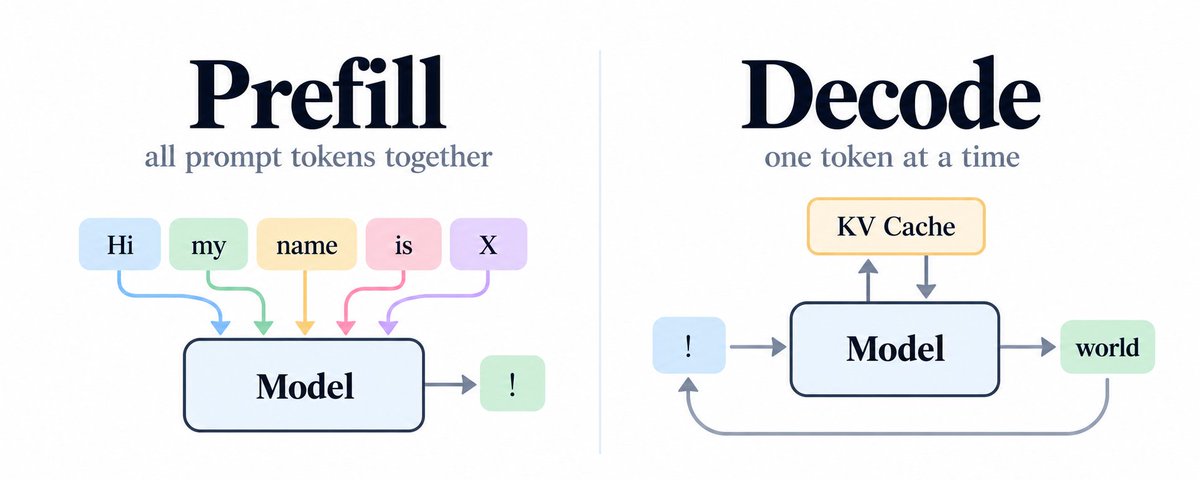
Prefill & Decode made Crystal Clear

本文从第一性原理出发,逐步讲解 LLM 推理过程中 Prefill 和 Decode 两个阶段的真实含义。作者先介绍自回归模型逐 token 预测的基本机制,然后通过 ChatGPT 聊天的例子,展示文本如何经过分词、token ID、embedding 转化为 S×D 矩阵并进入 Transformer 层。重点澄清一个常见误解:处理输入 prompt 时模型并非逐个 token 顺序处理,而是因为所有输入 token 已知,可以并行处理——这一整个输入处理过程就是 Prefill。文章还引出因果掩码等问题,帮助读者建立对推理流程的正确直觉。

技术 › LLM Abhinandan 2026-10-0326.3 KB 9.2K 133 64

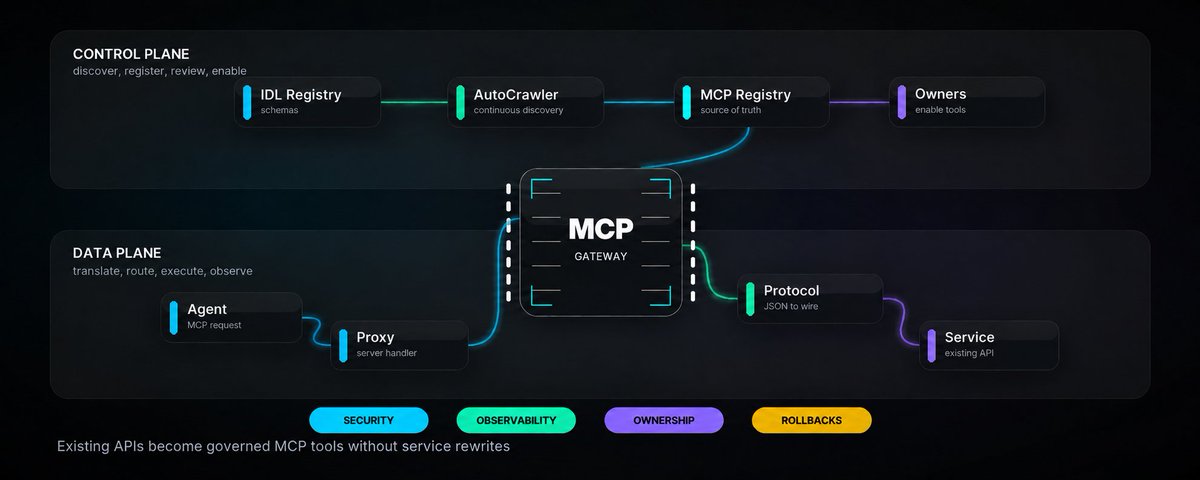
Designing MCP Gateway: Uber 的 MCP 管理平台

Uber 推出 MCP Gateway,作为统一管理 AI Agent 与后端服务 MCP 交互的核心微服务平台。文章介绍了其架构:控制平面(MCP Registry)作为工具目录的唯一事实来源,数据平面(Proxy Gateway)负责将 MCP 协议请求翻译为 HTTP、gRPC 或 TChannel 并路由到后端服务。通过基于 Cadence 的 AutoCrawler 自动扫描 IDL 注册表和原生 MCP 服务器心跳,自动发现、生成并注册 MCP 工具,同时支持 Jira、Google 等第三方集成。该平台已托管 800 多个 MCP 服务器和 5000 多个工具,实现了安全、可扩展、统一的 Agent 生态治理。

技术 › Agent Uber Engineering 2026-10-0316.3 KB 993.3K 3.1K 80

因为讨厌背单词,我手搓了一个神器:词汇星图

作者分享了利用 AI 开发的开源背单词神器「词汇星图」。文章分析了传统背单词方式的痛点:纸质书无法乱序、App 复习流程不自由、缺乏多释义例句和同义词高级表达等。工具的核心功能包括:以网状结构展示单词的词汇星图(涵盖词形变换、派生词等同族词,以及同义、近义、反义、拼写相似等关联词)、集成剑桥、牛津、朗文等多词典数据的单词详情页、支持艾宾浩斯遗忘曲线和葫芦背书法的背单词功能,以及内置各类考试词表和自定义词表。项目已开源至 GitHub,旨在提供 AI 赋能教育的思路。

技术 › 工具与效率 Hytidel 2026-10-0211.9 KB 153.8K 449 72

从零开始学 AI:小白也能看懂的常见 AI 术语讲解(一)

本文是 AI 术语科普系列的第一期,面向小白读者,用通俗易懂的语言讲解 11 个常见 AI 概念:大语言模型(LLM)、多模态、提示词(Prompt)、Token(词元)、上下文、记忆、知识库、Agent(智能体)、Skills(技能)、工作流和 AI 幻觉。作者金尘马解释了模型与应用的区别、Token 与计费和上下文窗口的关系、记忆与上下文的差异,并对比了工作流的固定流程与 Agent 的自主决策,帮助读者扫清学习 AI 路上的术语障碍。

技术 › LLM 金尘马 2026-10-0214.7 KB 27.6K 111 59

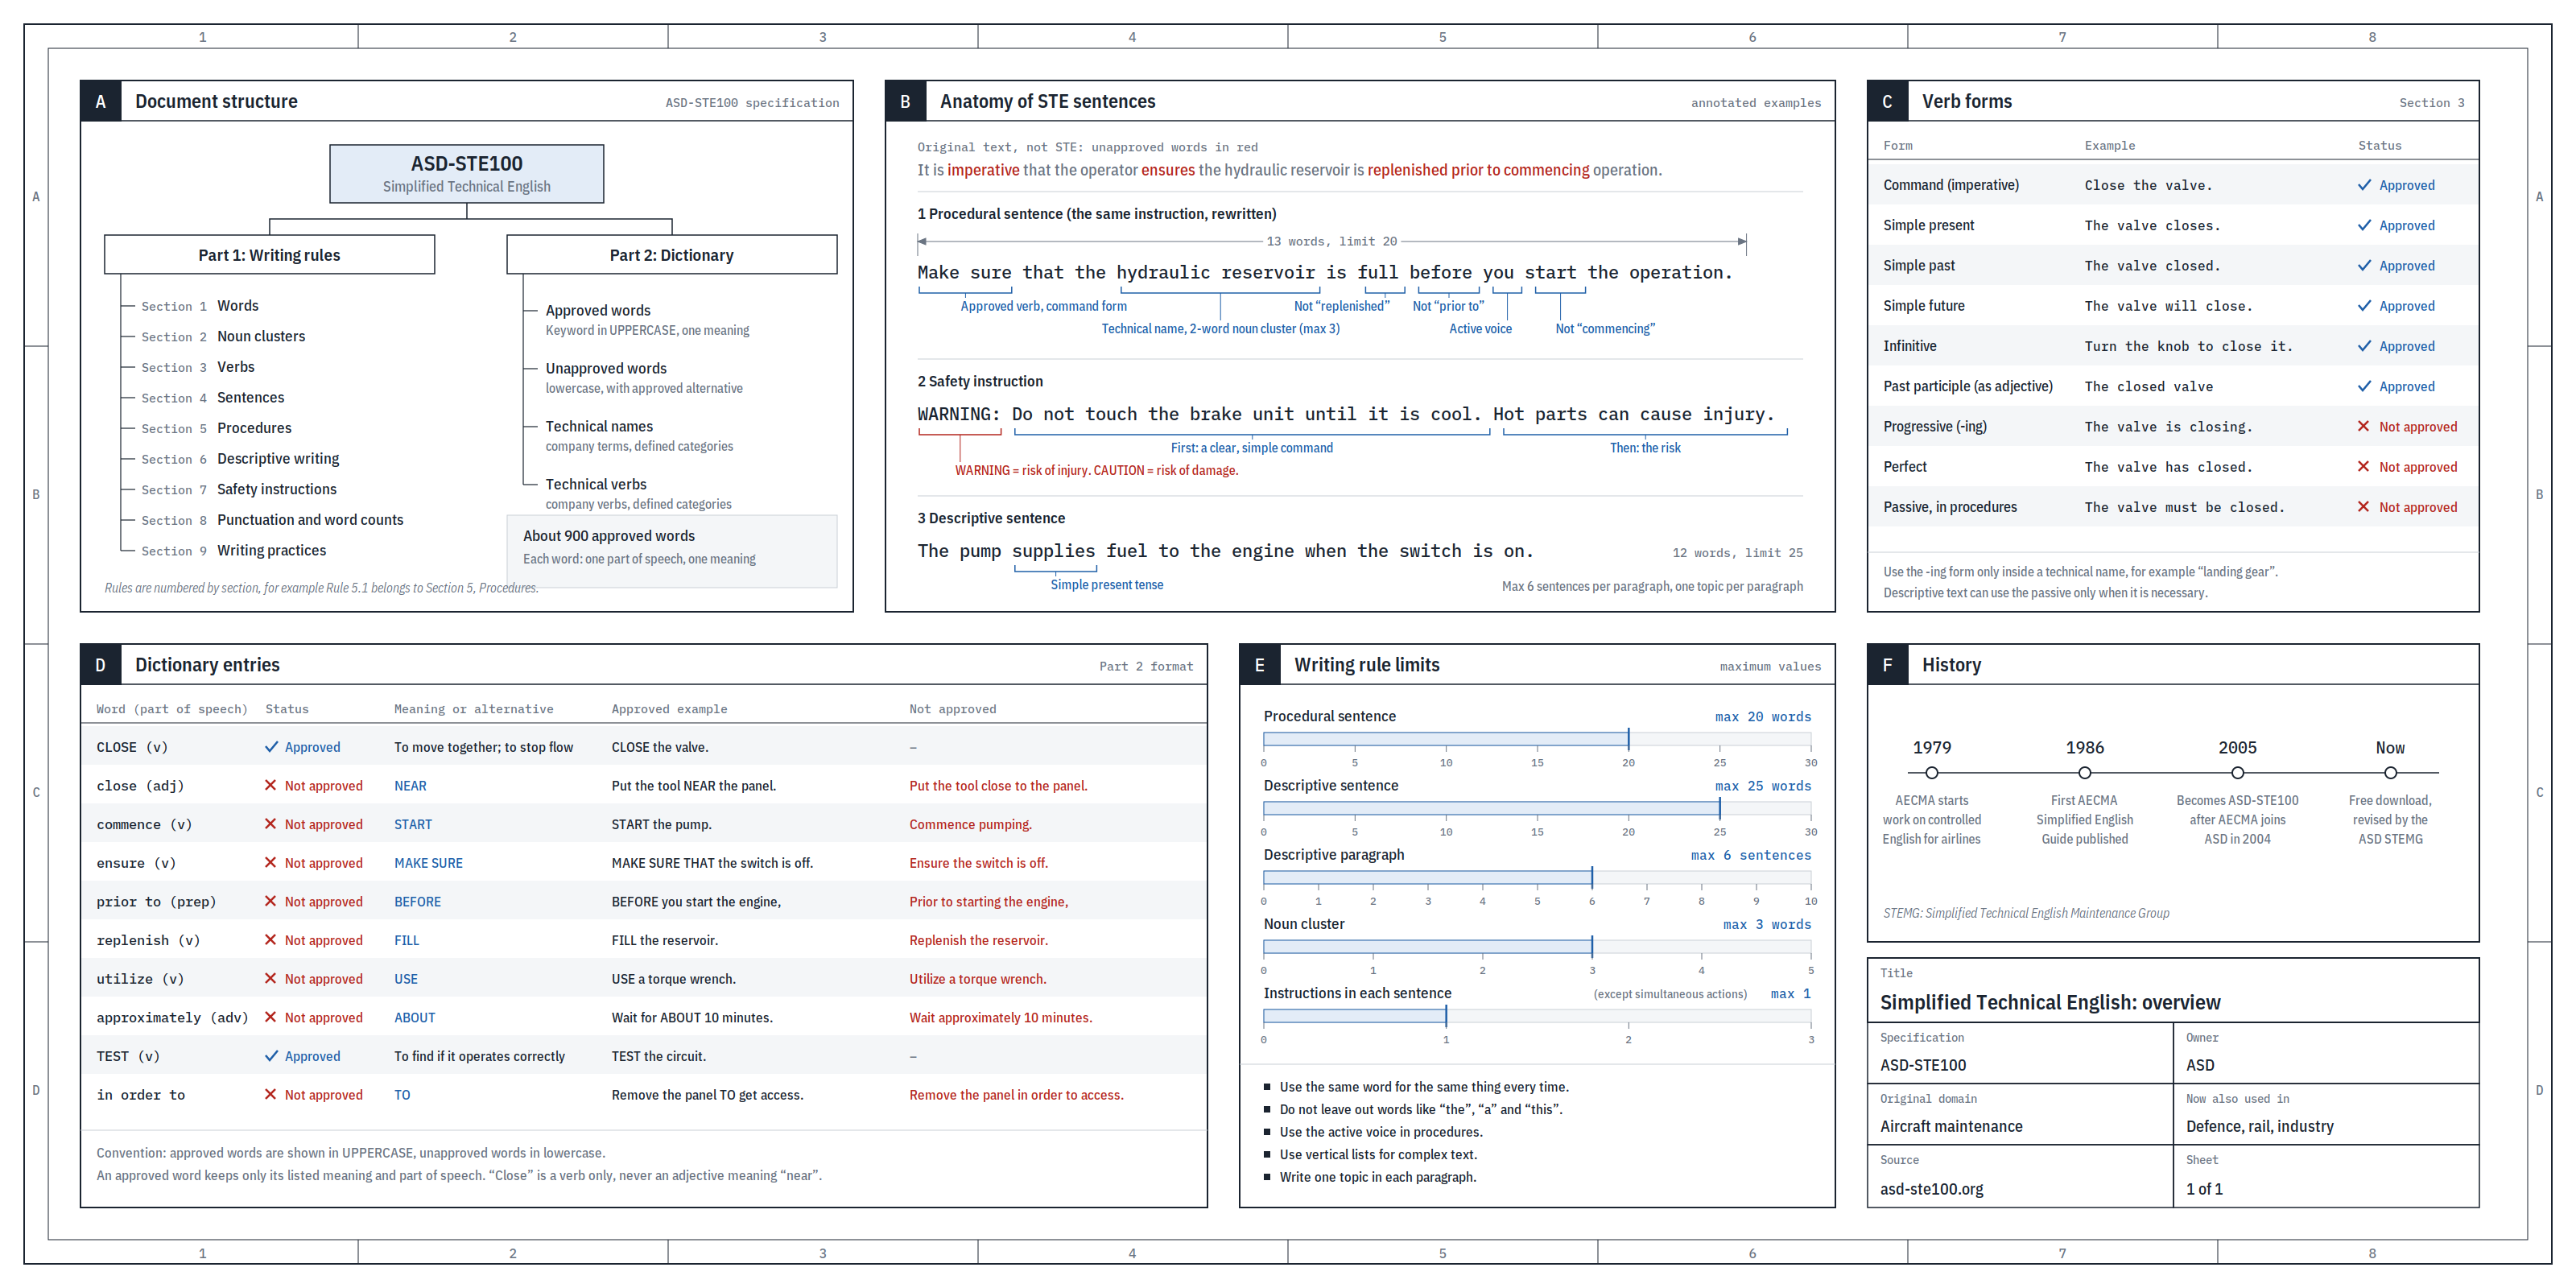
We'll be spending a lot more time trying to understand the outputs of language models

Karpathy 分享了理解和消化 LLM 输出的技巧与思考。他建议从纯文本逐步升级到更好的输出形式:用 ASD-STE100 受控语言规范让 LLM 输出更简洁易读的文字;再进一步要求生成图表;更好是直接输出 HTML 交互网页;他最看好定制化讲解视频,如 3b1b 风格并结合 ElevenLabs 语音解说。他总结:随着 LLM 能力增强,人类工作将更多转向监督与理解层面,而 LLM 本身也能生成大量以前不值得做的定制、可抛弃的软件产物,帮助人们完成这一转变。

技术 › LLM Andrej Karpathy 2026-10-022.1 KB 73

Pi 1.0:一次重新思考——MCP 进核心与 CodeMode 编排层

文章解读 Pi 1.0 发布:Pi 从公开拒绝 MCP 转变为将其纳入核心支持。关键不在改变主意,而是为支持 MCP 所做的改动(沙箱、解释器、工具元数据、延迟加载)本身具有普遍价值,同时也让 Jev 等非 LLM 模型受益。核心概念 CodeMode 是跑在 harness 受信任侧的编排层沙箱,用 JavaScript(可作 WASM 分发)自由组合工具调用与模型调用,状态保存在会话记录中。Pi 团队认为 MCP 的问题是外部服务器难以组合,希望其向 OpenAPI 式结构化数据演进。此外还发布了构建长时间运行 agentic 应用的新基座 Pi Durable,以及延迟工具加载、缓存预热等改进。

技术 › Harness Engineering yibie 2026-10-0211.8 KB 15.2K 82 77

How to Build a Model Router in the Harness

文章介绍 LangChain 如何为开源编码代理 Open SWE 构建模型路由器。作者首先通过 LangSmith 追踪数据分析任务类型与复杂度分布,发现许多任务无需前沿级模型;随后基于 Artificial Analysis 智能指数挑选快速、均衡、高性能三档模型(GLM-5.3-Flash、GPT-5.6 Sol、GPT-6 Astra);最后在 agent harness 的中间件层实现路由器,由分类模型根据任务标准选择最便宜可胜任的模型。结果显示每线程成本中位数降低 64%,质量无明显变化。文章强调路由决策应置于 harness 中,因其拥有网关所缺乏的任务与领域上下文。

技术 › LLM Sydney Runkle 2026-10-0221.4 KB 112.7K 324 83

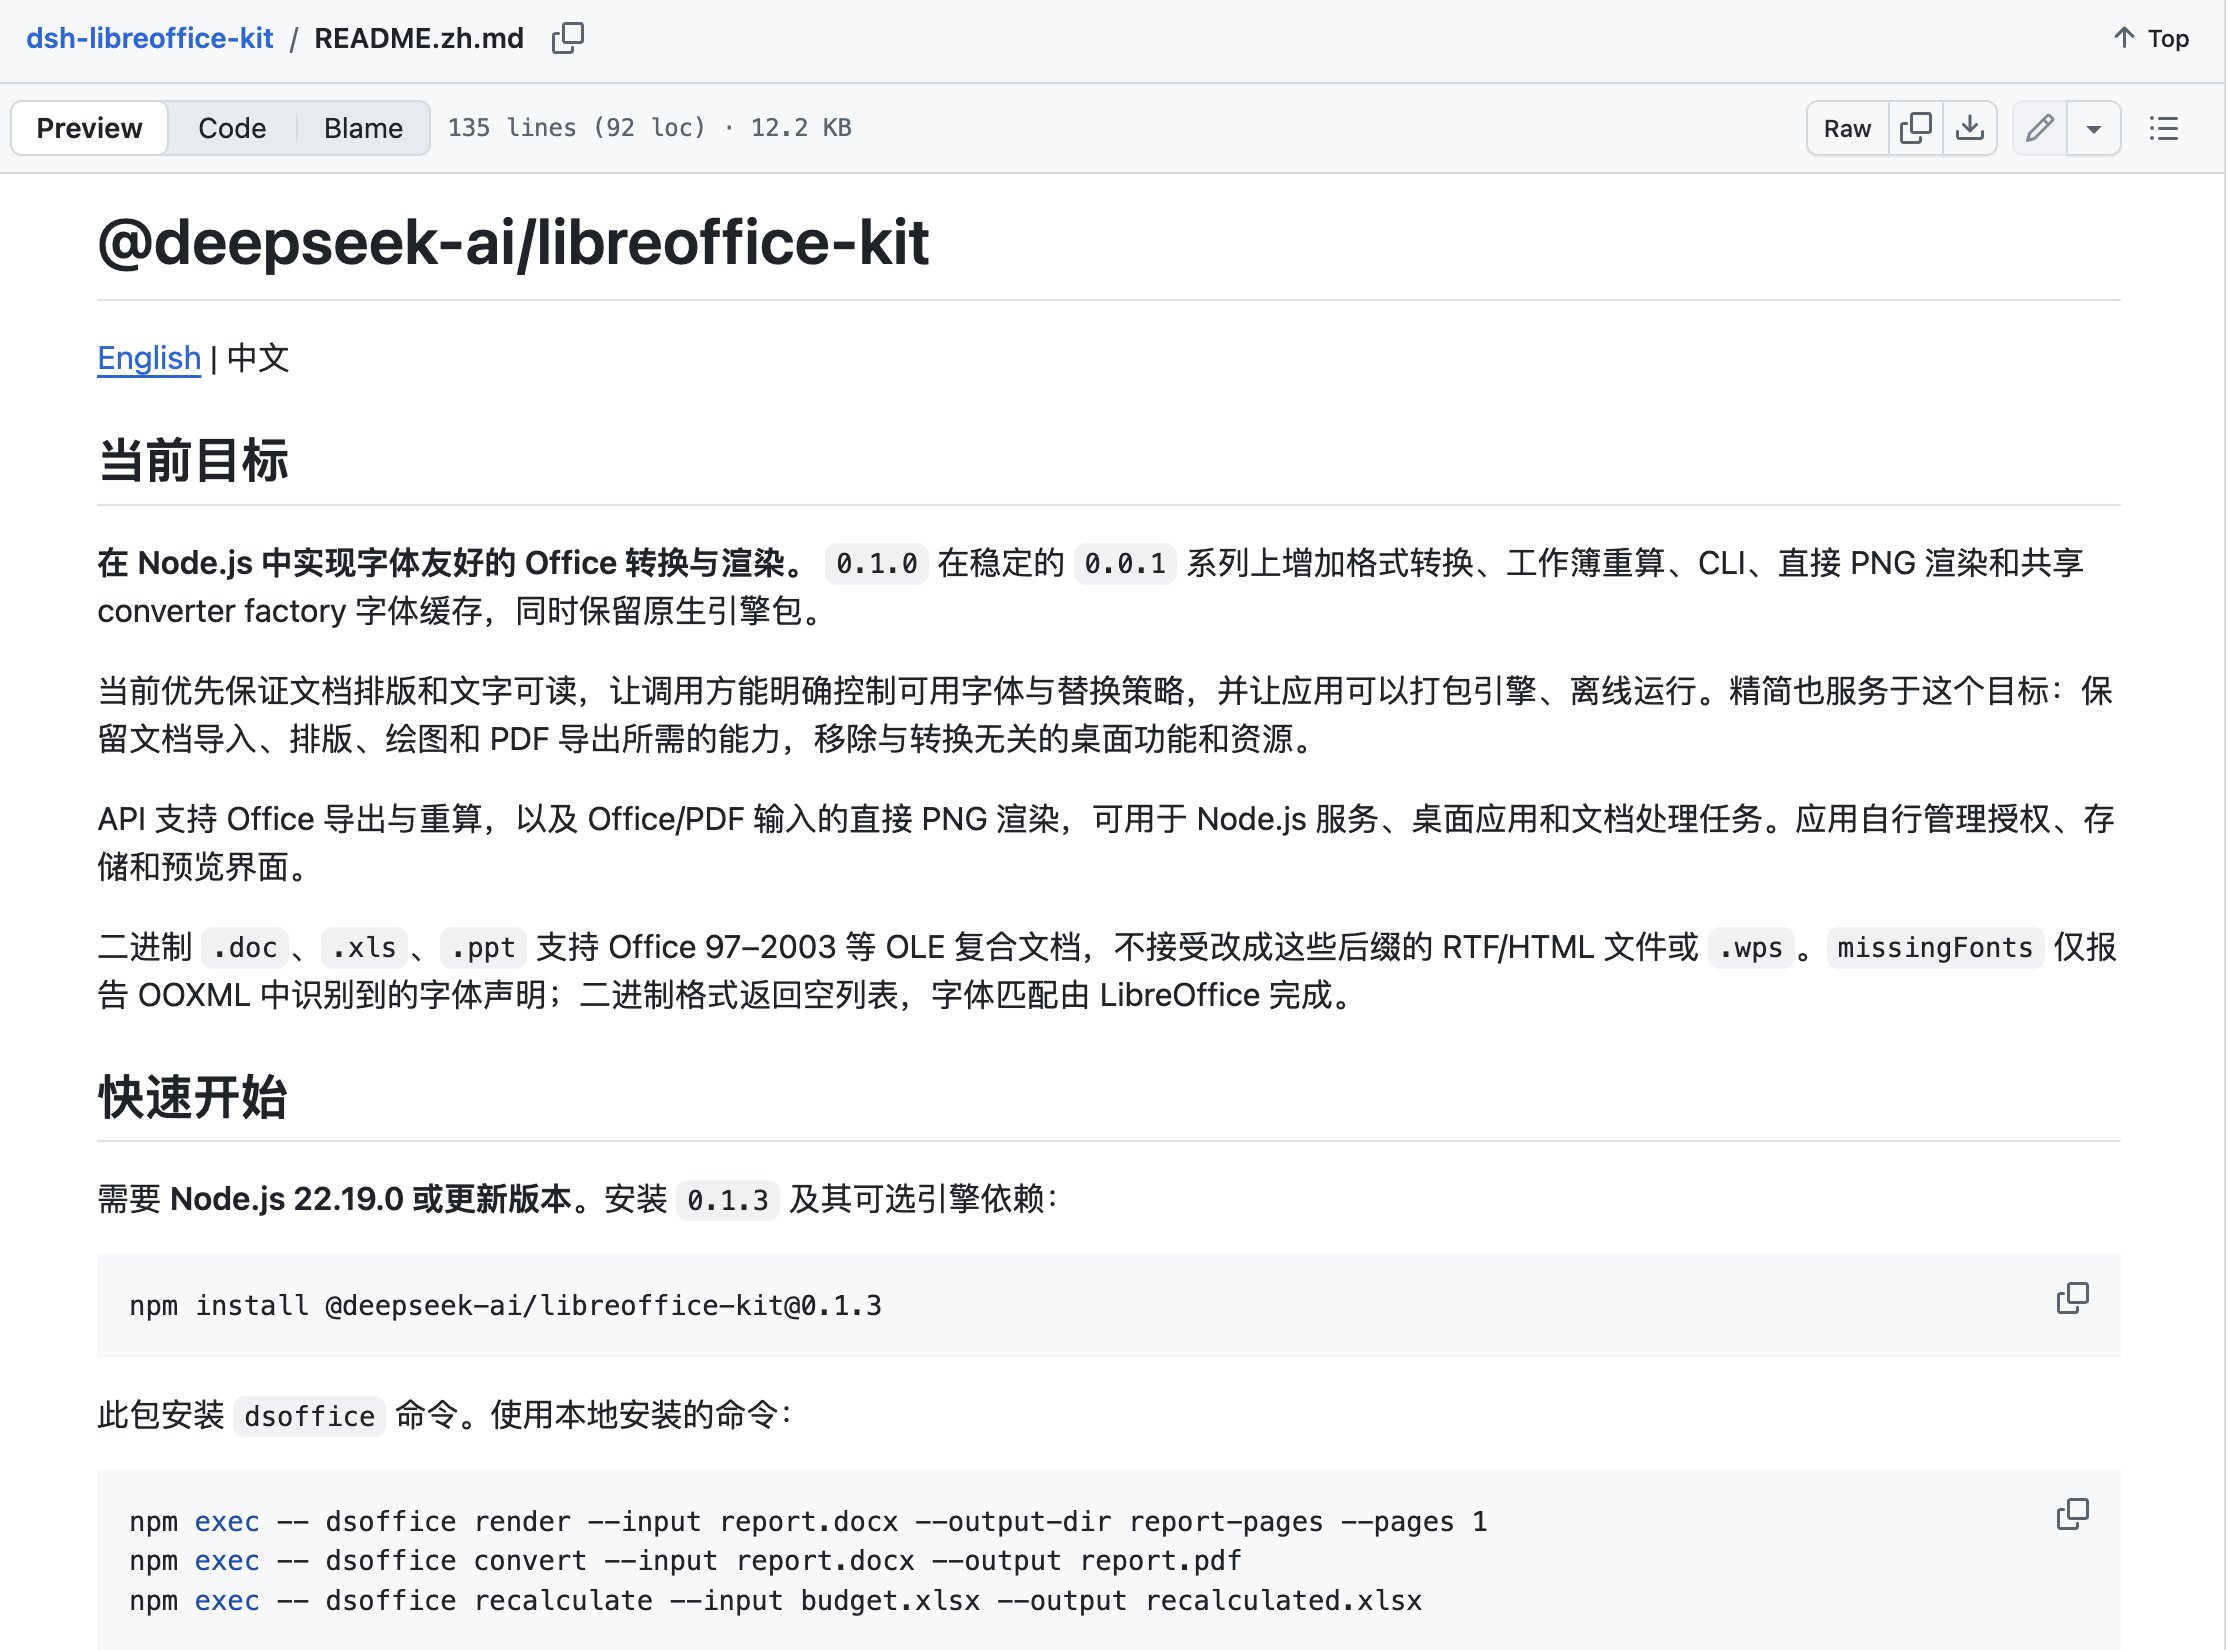
DeepSeek 开源 dsh-libreoffice-kit:给 AI 配上「看文档的眼睛」

DeepSeek 悄悄开源了 dsh-libreoffice-kit 组件,原本隐藏在 DeepSeek Harness 中。该组件解决了 AI 生成文档却看不到排版效果的痛点:可将 Word、PPT 渲染成图片让 AI 查看排版,真实计算 Excel 公式以核对结果,自带字体管理避免中文乱版,并支持文件级隔离处理防止单点故障。这使 AI 能够自己写、自己看、自己改文档,无需人工逐页返工。文章指出 AI 办公领域的竞争不只在于模型能力,底层基础设施同样关键。

技术 › LLM 程序员鱼皮 2026-10-011.1 KB 66

AI 开发工程师面试指南

作者从面试官视角系统讲解 AI 开发工程师的求职方法。文章首先界定 AI 开发工程师的职责——将大模型能力接入真实业务并做成可用可维护的产品,并说明该方向值得长期投入的原因。随后分析公司招人的逻辑:基础岗看重靠谱、执行与学习能力,高级岗看重技术判断与积累,管理岗看重项目交付与团队建设。文章分别给出基础岗和高级岗的简历撰写要点,强调用具体事实和可追问的细节展现能力,并从专家和管理两条路线详细列出面试技术追问范围:编程与服务、模型调用、上下文与状态管理、工具执行、评测排查、部署性能、微调原理,以及项目管理和团队管理问题。

职场 › 职业发展 Miles Ma 2026-10-0127.0 KB 167.1K 459 83