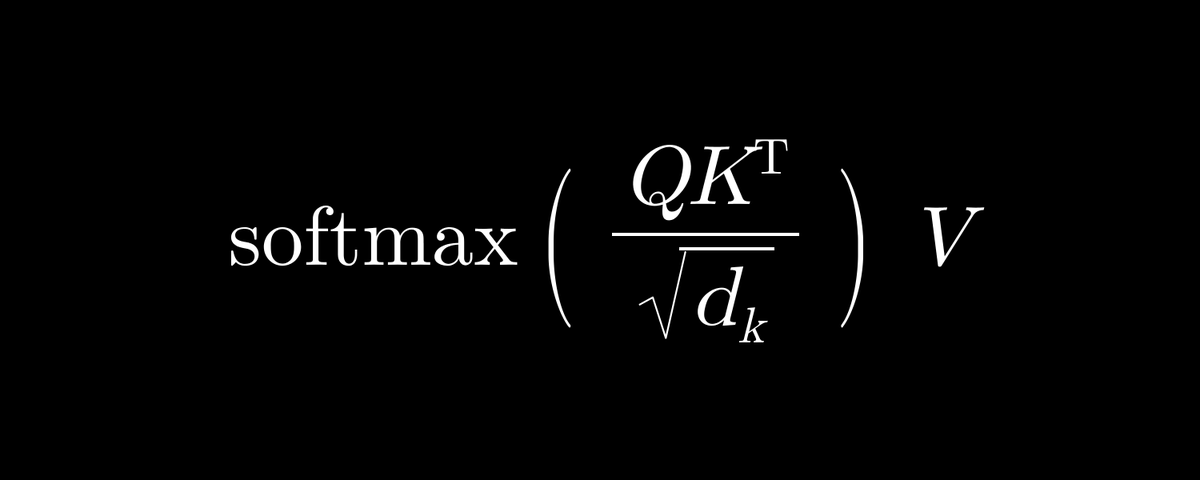
Wiki 知识库

全部文档 / 标签: Transformer

67 篇
清除

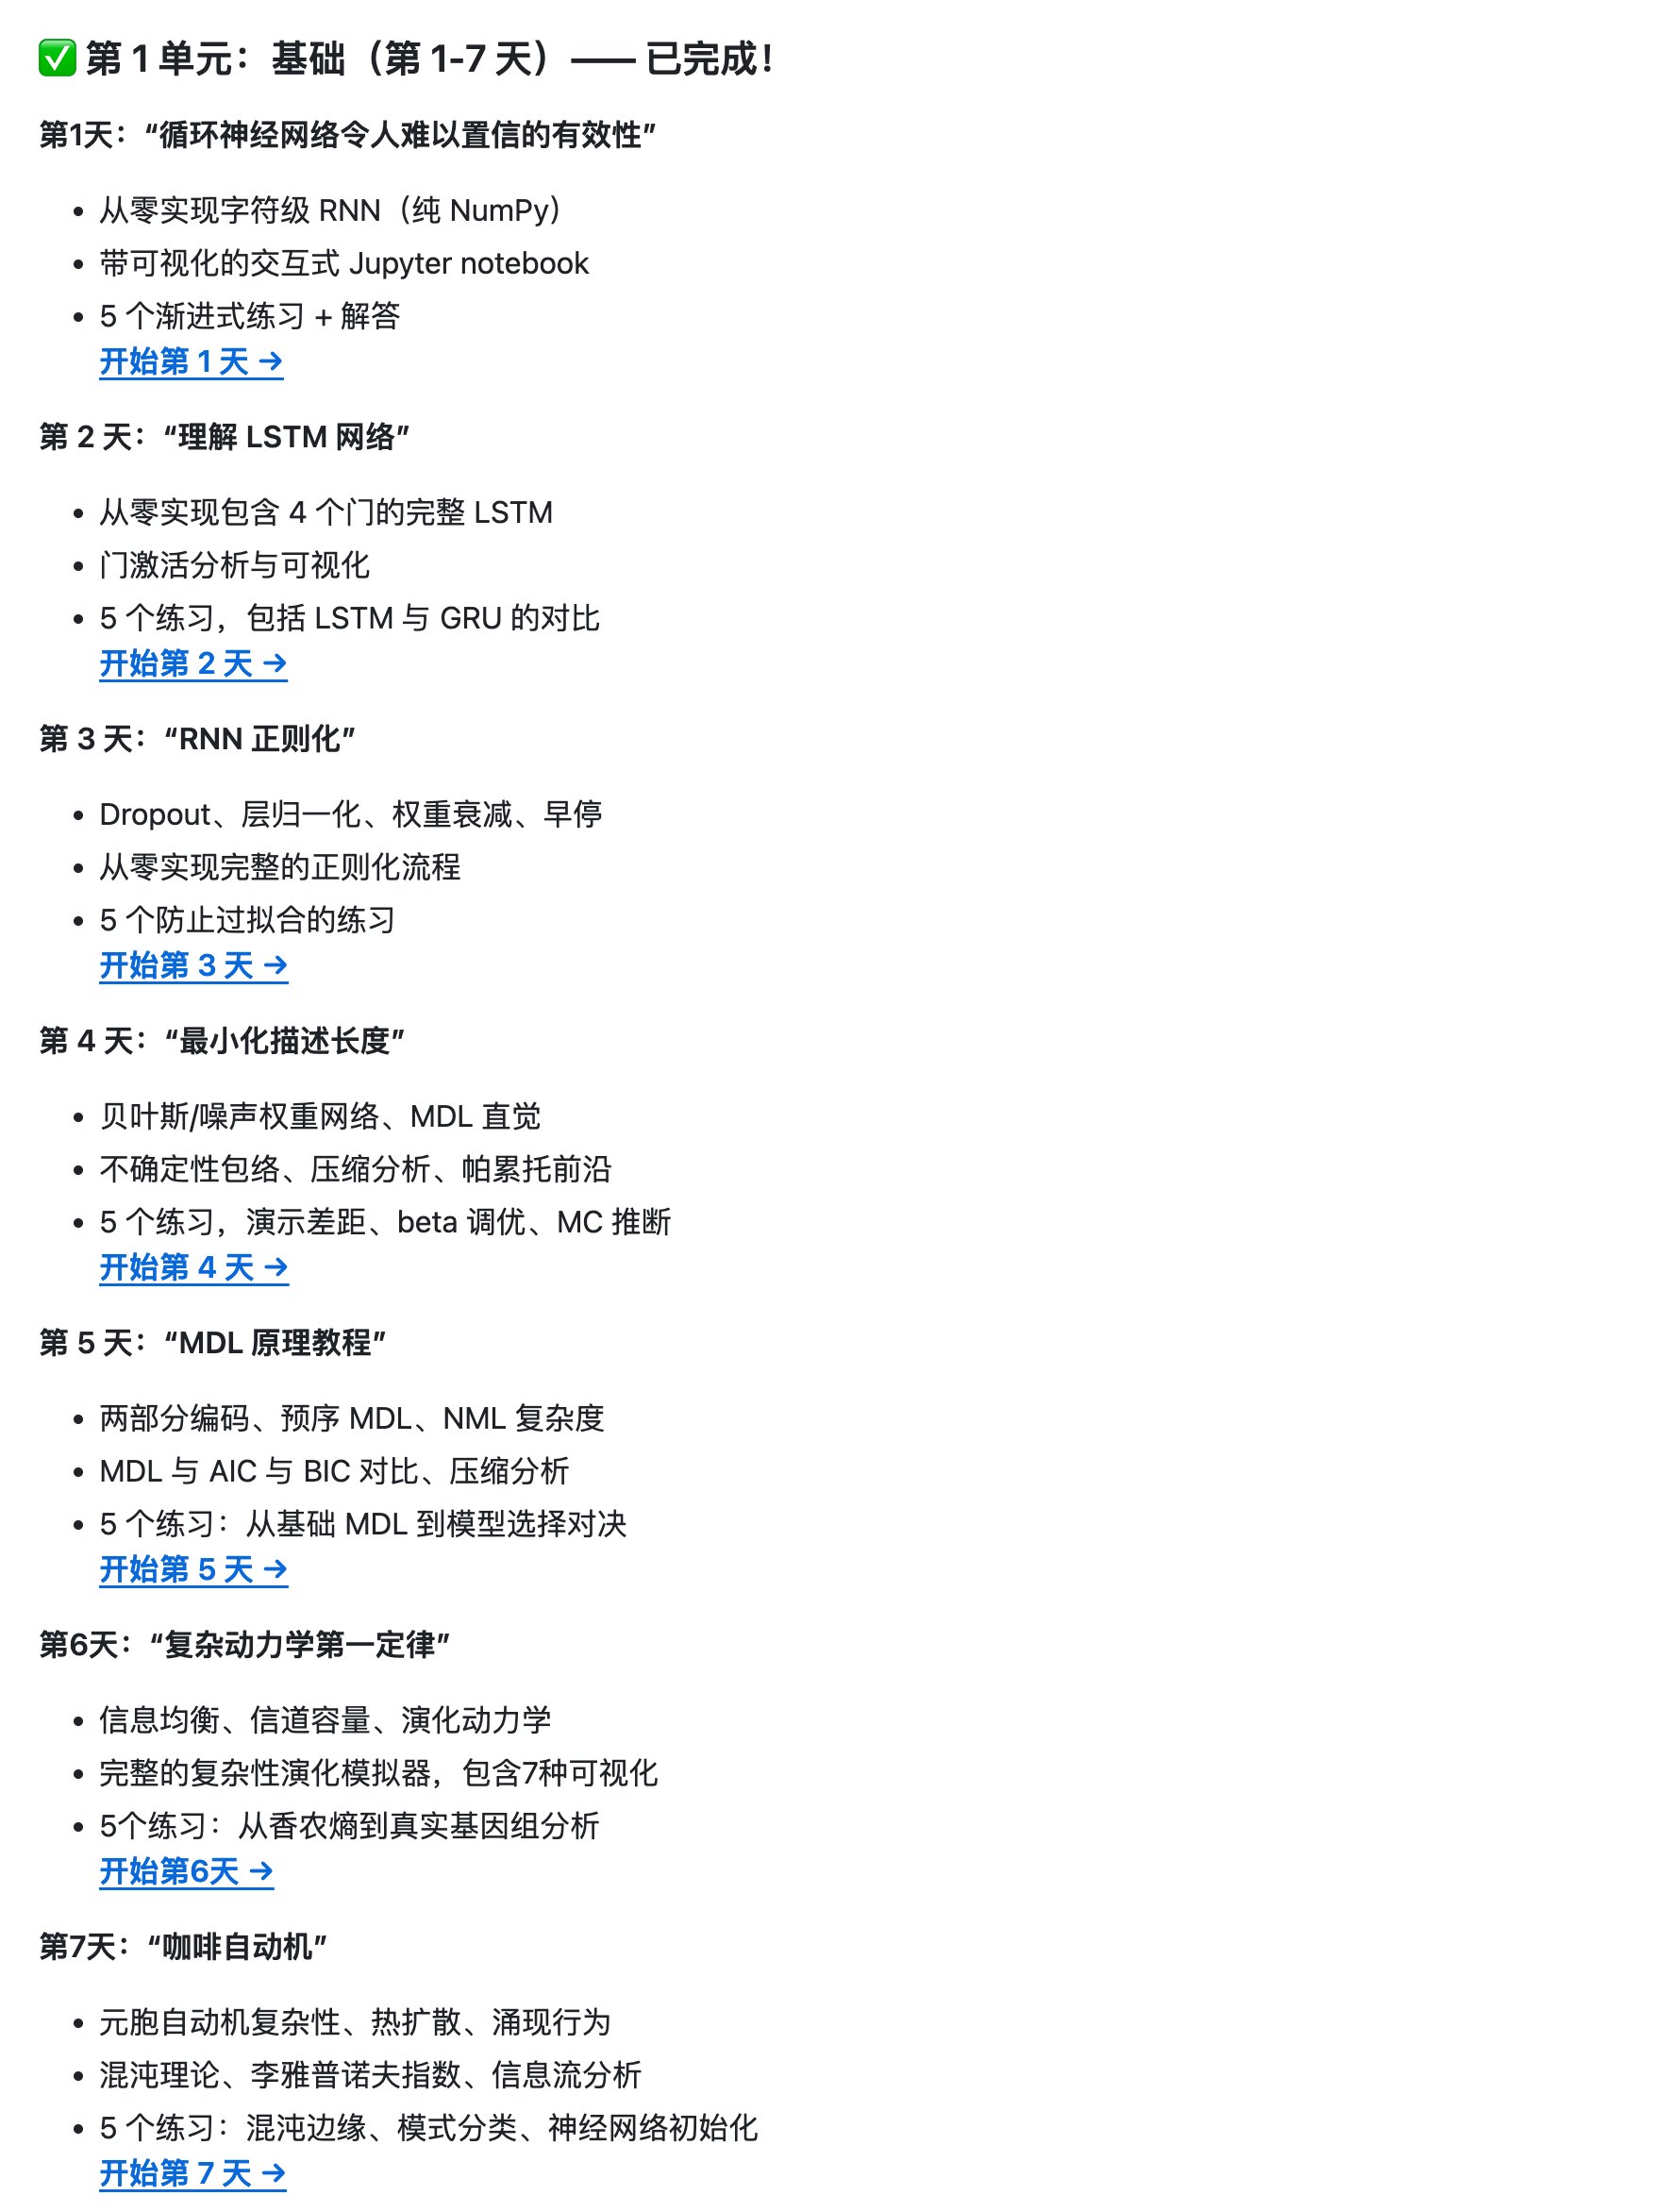
Ilya 推荐的 30 篇 AI 论文清单:30u30 拆解学习项目

Ilya 曾推荐一份包含 30 篇论文的 AI 学习清单,称读懂即可掌握当下 AI 90% 的要点。30u30 项目将这份清单拆成 30 天课程,一天一篇,从 RNN、LSTM 学到 Transformer,最终到 ChatGPT 背后的 RLHF。每篇配有大白话讲解、'讲给 5 岁小孩听'的速览、从零实现的代码及配图,每天还附 5 道练习题。代码可在普通电脑 CPU 上运行,适合想转 AI 方向的学生或想理解 ChatGPT 原理的用户跟随学习。
技术 › LLM GitHubDaily (@GitHub_Daily) 2026-10-211.4 KB 64

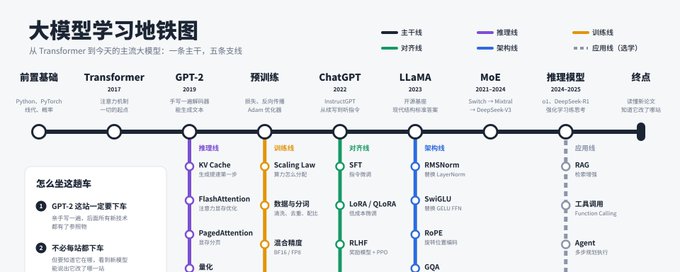
大模型学习地铁图:从 Transformer 到今天的主流大模型

文章以地铁图为比喻,为大模型学习者规划了一条清晰的学习路线。主干线按演进顺序设置八站:前置基础、Transformer、GPT-2(强调亲手实现作为锚点)、预训练、ChatGPT 时刻(RLHF)、LLaMA、MoE 稀疏专家、推理模型(o1/R1),终点是能独立读懂新论文。五条支线按兴趣选修:推理优化(KV Cache、FlashAttention、量化)、训练(Scaling Law、分布式并行)、对齐(SFT、LoRA、DPO、GRPO)、架构(RMSNorm、RoPE、MLA)、应用(RAG、Agent)。最后给出建议:GPT-2 必须亲手写一遍,主干加一至两条支线即可入门,学习原理时动手推算。
技术 › LLM 纳米AI 2026-10-2010.4 KB 52K 871 88

APEX: Better generation from fewer tokens

APEX(Asynchronous Prefix denoising for EXtreme compression)由 Lightricks 与耶路撒冷希伯来大学联合研发,是一种面向扩散模型的极端潜空间压缩方法。它通过“结构到细节”的累积前缀表示,让少量潜token同时满足计算效率、重建质量和生成质量三个目标。该方法为潜通道分组排序,早期通道表达整体结构,后续通道逐步补充细节,并用异步去噪调度在不同时间窗内分别处理各组。在 ImageNet 512×512 实验中,APEX 在 64× 与 128× 空间压缩下显著提升生成效果,64-token 模型在推理预算相当的情况下全面优于 256-token 基线,为世界模型开发提供了高效表示设计原则。

技术 › LLM LTX.io 2026-10-1714.8 KB 1.4M 91 67

AI 工程师面试:大厂反复考的 25 道通用题

文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。

技术 › LLM 山景城小路 2026-10-073.7 KB 21.2K 258 71

Andrej Karpathy 与 GPT 七年演进:理解 Transformer 与 LLM 架构

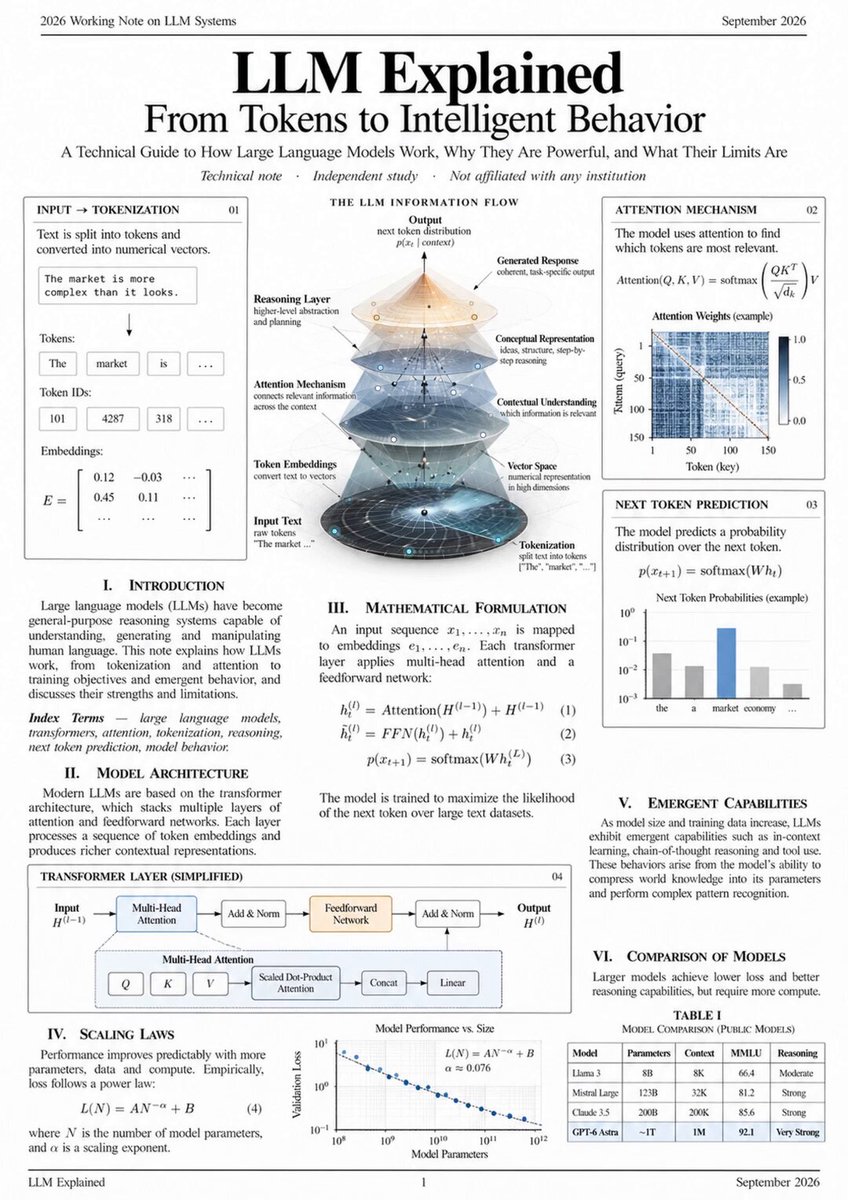
文章回顾 Andrej Karpathy 在 OpenAI 七年间见证 GPT 从 1.17 亿参数增长到万亿参数的历程,强调 Transformer 是近 50 年计算领域最重要的架构。内容深入浅出地讲解 LLM 内部机制:文本被切分为 token 并映射为高维嵌入向量,模型通过注意力机制(Q、K、V 矩阵)学习上下文语义;Kaplan 提出的缩放定律证明性能随参数规模可预测提升;大模型还涌现出上下文学习、思维链推理等未显式编程的能力。作者指出 LLM 不是工具而是基础设施,真正赚钱的是理解底层架构并在此基础上构建的人。

技术 › LLM Deliriumm (@0xDeliriumm) 2026-10-043.0 KB 55

Prefill & Decode made Crystal Clear

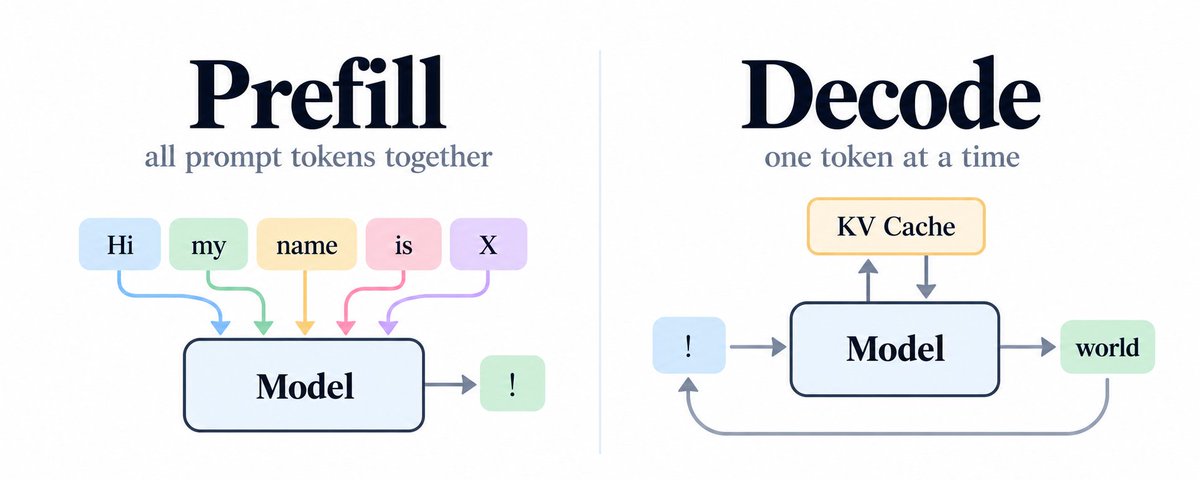
本文从第一性原理出发,逐步讲解 LLM 推理过程中 Prefill 和 Decode 两个阶段的真实含义。作者先介绍自回归模型逐 token 预测的基本机制,然后通过 ChatGPT 聊天的例子,展示文本如何经过分词、token ID、embedding 转化为 S×D 矩阵并进入 Transformer 层。重点澄清一个常见误解:处理输入 prompt 时模型并非逐个 token 顺序处理,而是因为所有输入 token 已知,可以并行处理——这一整个输入处理过程就是 Prefill。文章还引出因果掩码等问题,帮助读者建立对推理流程的正确直觉。

技术 › LLM Abhinandan 2026-10-0326.3 KB 9.2K 133 64

斯坦福大学 CS329Z「Engineering AI Agents」第二讲 LLMs for Builders:Agent 工程师必修的大模型底层原理

本文深度解读斯坦福 2026 秋季课程 CS329Z 第二讲「LLMs for Builders」讲义,面向 Agent 工程师系统讲解 LLM 底层原理。内容涵盖:自回归概率分解与解码采样策略;从 RNN 到 Transformer、线性注意力的架构演进及其工程取舍;预训练、中期训练与后训练(RLHF、RLVR)管线;推理阶段的 Prefill/Decode、KV Cache、投机解码与推理时扩展;最后落脚到 Agent 开发的结构化 I/O 与上下文工程实践,强调'设计决策→局限→应用策略'的因果链。

技术 › LLM meng shao 2026-09-2919.3 KB 19.4K 60 84

Is ENGRAM free lunch? Does it not impact AI model quality?

文章深入分析Engram技术:将序列嵌入存储到可卸载至DRAM的嵌入表中,节省HBM内存、减少FLOPs,从而降低AI推理成本。在参数和训练预算相同的对照实验中,Engram-27B相比MoE-27B不仅没有降低性能,反而显著提升(MMLU从57.4升至60.4)。作者指出Engram参数分配存在约20-25%的最优区间,过高会挤占MoE专家参数损害性能,且不能完全替代FFN(FFN负责概念运算)。结论认为Engram确实是一种'免费午餐',DeepSeek、美团LongCat、Qwen等已采纳该技术。

技术 › LLM GDP 2026-09-2710.0 KB 38.3K 64 73

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

AI 眼里根本没有猫,那它到底是怎么认出猫的?|从 0 开始理解大模型底层

本文从最简单的线性模型 y=wx+b 出发,逐步拆解神经网络识别图片的原理。作者解释了为何单层线性计算表达能力不足,堆叠多层也仍会退化为一次线性变换,因此需要 ReLU 等激活函数引入非线性。随后说明图像如何从原始像素经多层计算被加工成适合任务的内部表示,并澄清了'第一层看线条、第二层看耳朵'的常见误解。文章还介绍了万能逼近定理的含义与局限、CNN 与 Transformer 的关系,以及模型为何是黑箱与机制可解释性,最后引出过拟合问题,为下一篇泛化主题做铺垫。

技术 › LLM joy 2026-09-2614.8 KB 6.5K 18 63

Behind Jev: Two Hypotheses About Its Base Model

文章探讨 TypeSafe 公司 Jev 决策 API 背后可能的基础模型架构,提出两种假设:一是 BERT 风格的双向编码器,二是去掉生成循环、直接输出决策概率的因果解码器。作者引用 Archer Hume 基于约一万次 API 调用的逆向分析,认为其可能是带共享状态计算、独立问题分支和直接概率读出的因果 Transformer,甚至可能是 MoE 架构,但其研究无法区分编码器与解码器。文章还通过 OpenJev 等开源项目(基于冻结的 Qwen3.5-4B 权重)证明使用因果模型骨干做直接决策打分在技术上可行,并讨论了因果注意力、前缀缓存等工程优势。作者强调这些都是架构假设,不能确定 Jev 的真实权重来源。

技术 › LLM Roy Chen 2026-09-1911.5 KB 45.6K 123 74

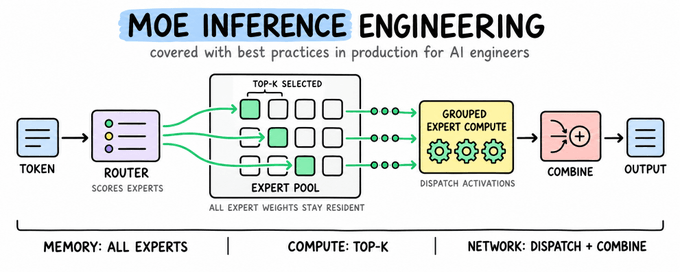
MoE 推理工程详解

本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

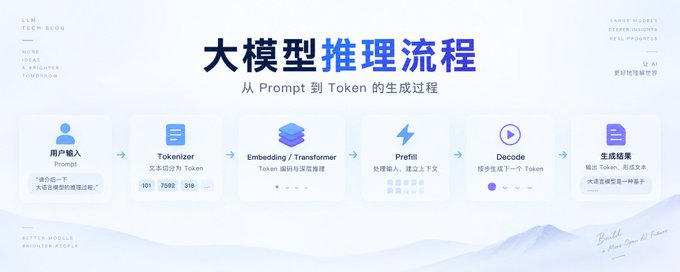
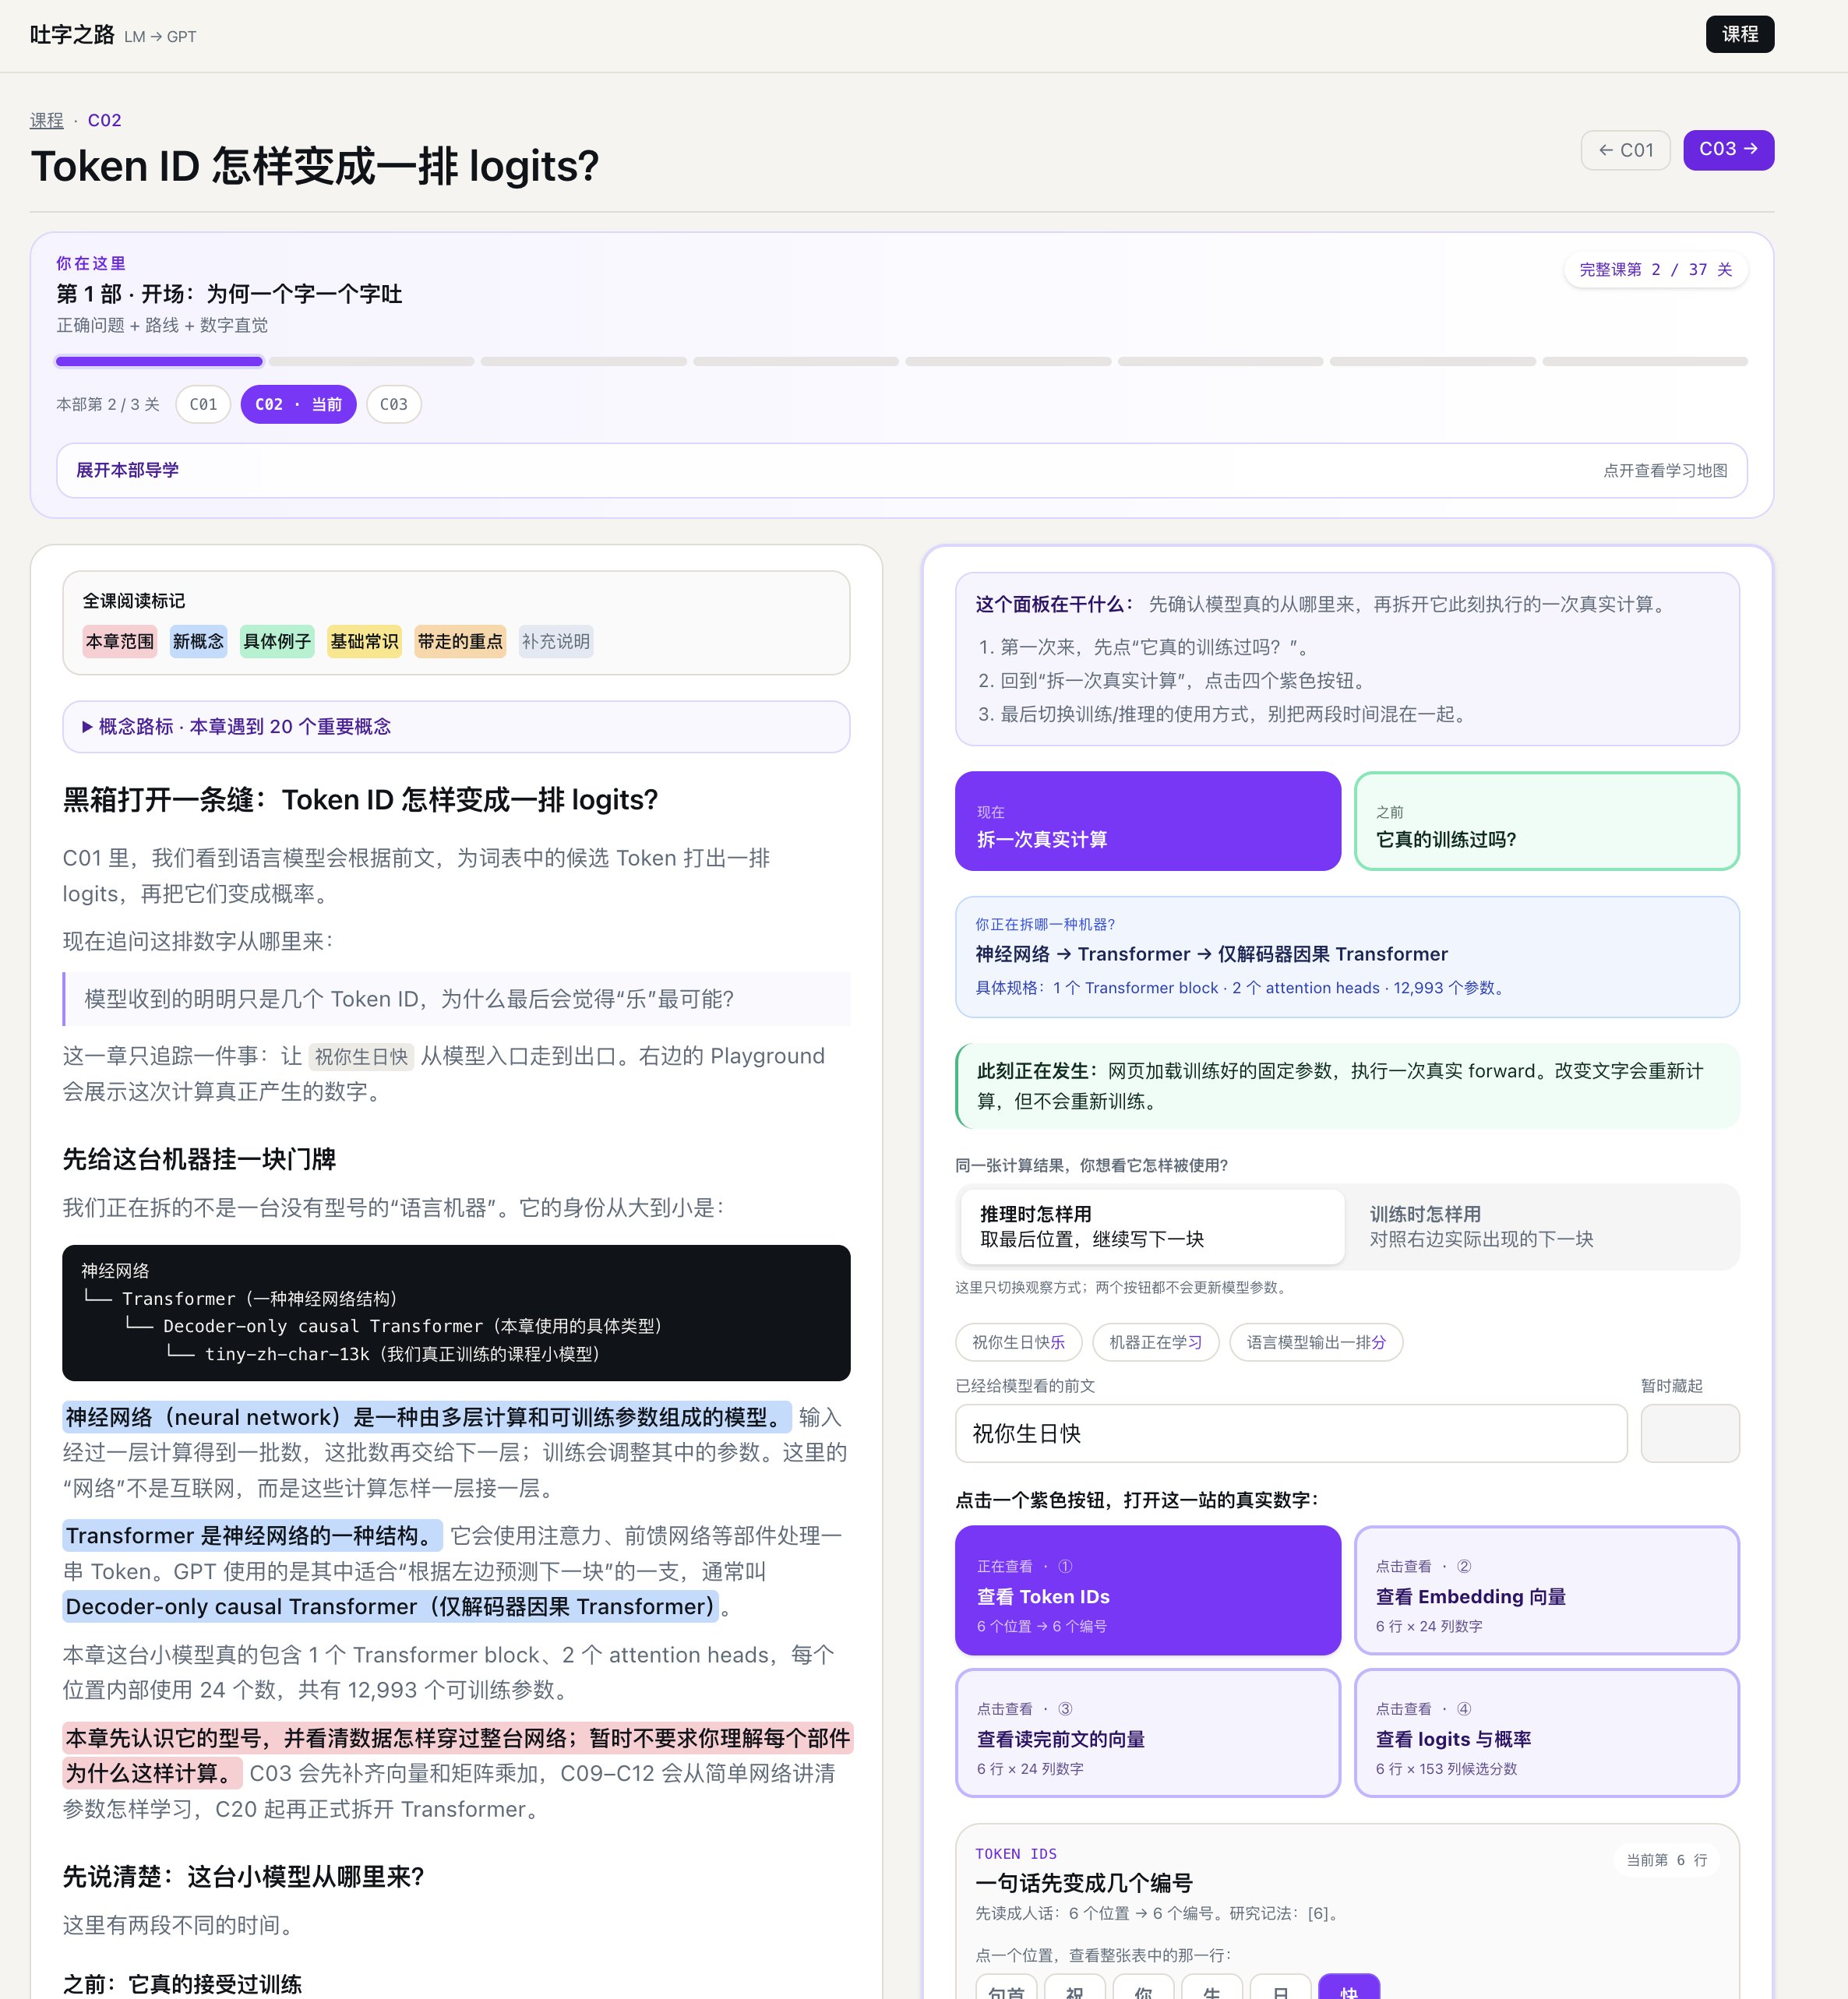
一文了解大模型推理流程

文章系统讲解大模型推理的完整流程:输入文本先经Tokenizer切分为token并转换为token id,再通过Embedding转为带位置信息的语义向量;随后进入Prefill阶段,模型并行处理整个prompt,通过Transformer的Self-Attention计算Q、K、V并生成KV Cache,经Causal Mask确保不偷看未来token;最后经LM Head和softmax输出第一个token。进入Decode阶段后,逐个生成token、不断更新KV Cache,直到满足EOS、max_tokens或stop条件终止,最终反解码为文本输出。

技术 › LLM Jerry Fang 2026-09-184.9 KB 1.4K 8 53

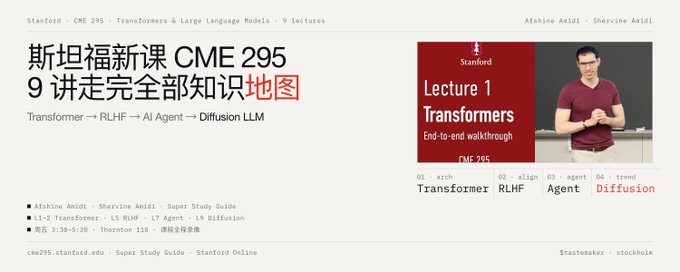
斯坦福新课 CME 295:9 讲走完 Transformer → RLHF → AI Agent → Diffusion LLM 全部知识地图

斯坦福大学 NLP 团队开设的 LLM 全景课程 CME 295,由知名速查表作者 Amidi 兄弟主讲,用 9 次讲座系统覆盖 LLM 全知识地图。课程分四大板块:基础(NLP 演进、Transformer 架构、MoE、注意力变体)、训练(预训练、SFT、LoRA、RLHF/DPO、PPO/GRPO/RLVR)、系统与工程(分布式训练、KV 缓存、投机解码、AI Agent 与 MCP 协议)、评估与前沿(LLM-as-a-judge、Diffusion LLM、多模态)。课程特点包括知识密度高、零作业两次考试、前沿覆盖度好,并配有公开的 Study Guide 和 15 语言速查表,适合已懂基础 ML、想系统理解 LLM 原理与最新趋势的学习者。

技术 › LLM meng shao 2026-09-164.7 KB 46.8K 233 73

Prefill and Decode:理解 LLM 推理的两个阶段

文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。

技术 › LLM Dongxi 东锡 NLP 2026-09-1511.3 KB 24.8K 89 74

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86

LLM 为什么缓存 K 和 V,却通常不缓存 Q?

本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。

技术 › LLM Dongxi 东锡 NLP 2026-09-139.5 KB 196.7K 623 82

Harness 是组合泛化器

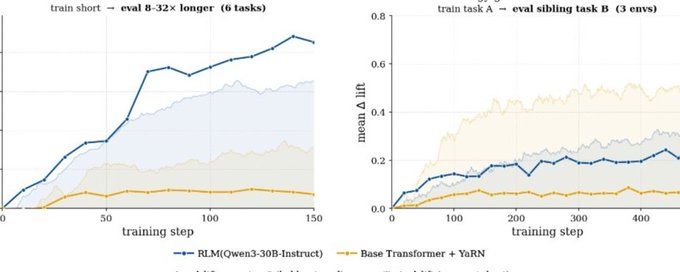
本文介绍 Alex L. Zhang 与 Omar Khattab 提出的观点:Transformer 不擅长组合泛化,而更好的泛化应主要由 harness 完成。Harness 位于外部世界与神经网络之间,通过 context offloading(上下文卸载)和程序化子 agent 调用两个机制,让每次 LM 调用看到的观察处于训练分布内(LID),把复杂、陌生的问题归约为简单、熟悉的问题。实验基于 Qwen3-30B 的递归语言模型(RLM)显示在长度泛化和跨域策略泛化上远胜裸 Transformer,30B RLM 甚至可逼近 GPT-5.5。作者提醒不要手工硬编码 harness 结构,数据 scaling 仍是最大驱动力,但 harness 决定 scaling 系数。

技术 › Harness Engineering yibie 2026-09-127.1 KB 14.2K 93 76

我用Ling-3.0-flash-VL把学习视频拆成能可动手的实验

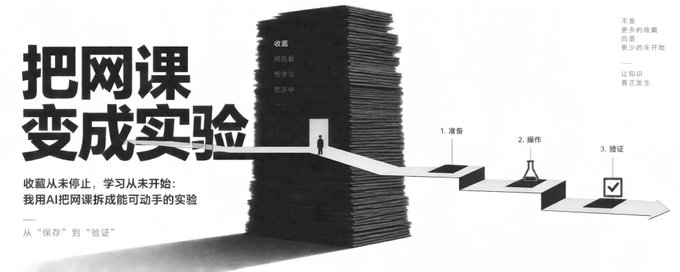
作者利用蚂蚁百灵多模态大模型Ling-3.0-flash-VL开发了Course Rebuilder,将B站收藏的《从函数到Transformer架构》网课重构为10个可交互实验,涵盖从函数拟合到Transformer组装的完整因果链。模型能精准解析视频片段,提取讲解概念、画面证据和先修知识,并给出交互改造建议,推理延迟仅1.1-1.3秒。该工具将被动听课转化为主动探索,支持跳转原片和AI助教答疑,显著提升学习吸收率。

技术 › LLM 睿奇Re7 2026-09-119.0 KB 16.6K 102 73

深度拆解 OpenAI 自研推理芯片 Jalapeño:英伟达 GPU 的推理瓶颈与软硬协同解法

本文深度拆解 OpenAI 自研推理芯片 Jalapeño 的设计哲学。首先指出英伟达 GPU 在推理场景的三大缺陷:访存密集型任务下 SIMT 掩盖延迟失效、UMA 与庞大 L2 Cache 导致高延迟、全局同步与网络 I/O 瓶颈。接着分析 Jalapeño 的激进重构:砍掉全局 L2 Cache 采用去中心化 Core Slice 架构、在 SM 内塞入超标量控制核心、实现网络直达核心缓存。最后提出行业三大结论:别盲目搞 CUDA 兼容、训练与推理算力格局将两极分化、AI 设计芯片的闭环正在到来。

技术 › LLM lifcc 2026-09-096.0 KB 2K 2 72

把Transformer底裤扒光,从Transformer到大模型

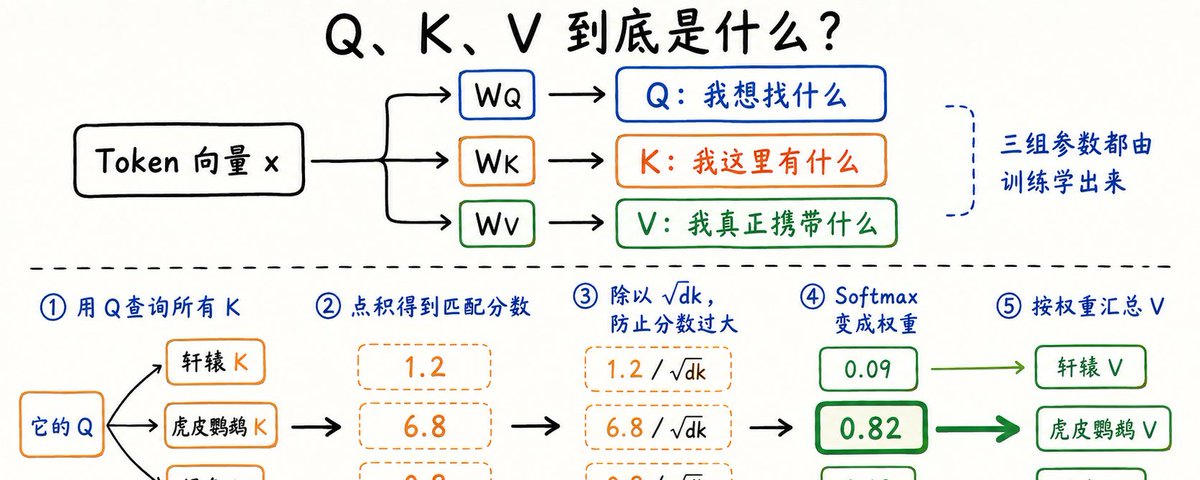
本文从零开始,深入浅出地讲解了Transformer的原理及其如何演变为大语言模型。文章首先介绍大模型的目标是预测下一个词,然后详细解释了如何将文字转换为数字,包括Token、Token ID、Embedding Matrix等概念。接着,重点剖析了Transformer的核心——注意力机制(Q、K、V)、多头注意力、位置编码、FFN以及残差连接等组件,最后概述了模型的训练过程。全文无需前置知识,适合初学者理解大模型的基础架构。

技术 › LLM 南晚Nanwan 2026-09-0944.4 KB 52.9K 157 70

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

小白必看:从词向量到Transformer,一口气搞懂自然语言NLP技术发展

文章以一个趣味猜词游戏切入,通俗易懂地讲解NLP技术的演进历程。首先介绍基于统计的N-gram模型及其在组合爆炸和语义理解上的局限;接着引出词向量(Word Embedding),通过高维空间中的坐标表示词语含义,使模型具备泛化能力;然后讲解前馈神经网络如何利用词向量进行预测;再介绍RNN通过隐藏状态机制处理任意长度文本,实现记忆功能;最后指出RNN存在长期依赖问题,为LSTM等改进方案做铺垫。全文循序渐进,用生活化例子帮助读者理解语言模型预测下一个词的基本原理。

技术 › 编程语言 轩辕之风 2026-09-0329.7 KB 9.9K 116 64

一口气搞懂 Transformer:注意力、QKV、残差连接全讲透

本文是 Transformer 架构的科普长文,作者轩辕之风回顾了从 N-gram、词向量、RNN 到 LSTM 的语言模型发展历程,指出 LSTM 串行计算和远距离信息传递的两大痛点。随后详细讲解注意力机制的核心思想,深入解释 Query、Key、Value 三者的作用与计算方式(点积、Softmax、缩放因子),以及多头注意力如何从多个角度捕捉指代、语法等不同关系。文章还介绍了位置编码解决并行计算丢失顺序信息的问题,并通过'苹果'的例子说明 Attention 负责信息收集、FFN 负责特征消化组合的分工。

技术 › LLM 轩辕之风 2026-09-0228.7 KB 31.7K 354 72

AI 的演进:从规则执行到自主行动

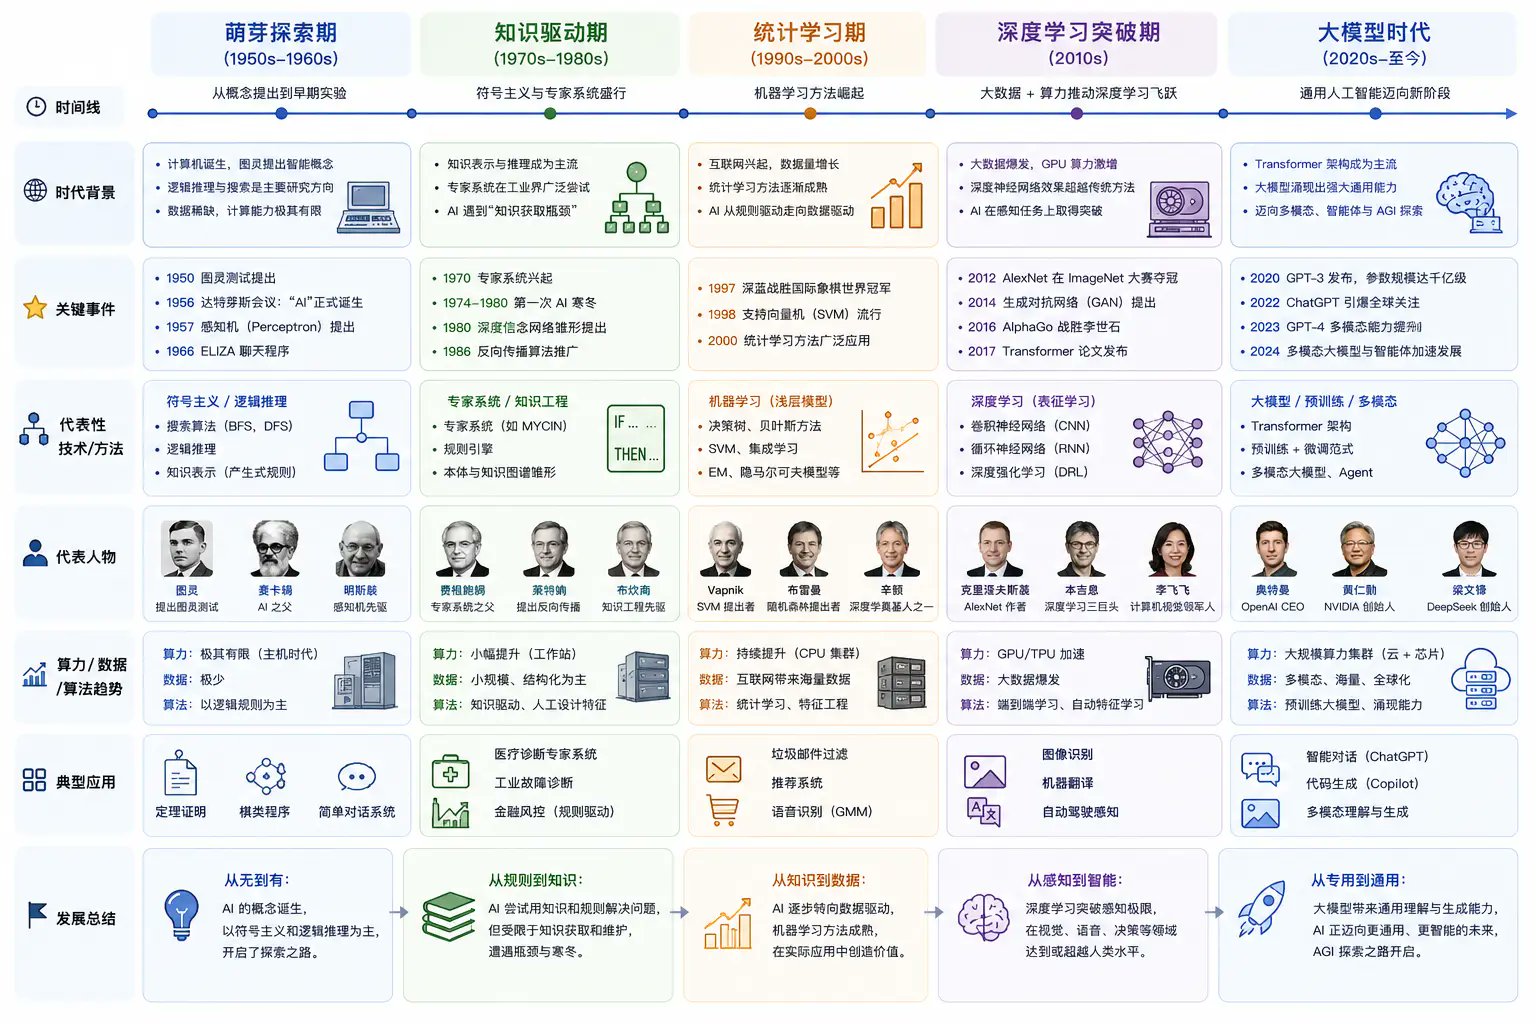
文章系统梳理了人工智能从1950年代至今的发展历程:萌芽探索期(图灵之问与达特茅斯会议)、知识驱动期(符号主义与专家系统)、统计学习期(机器学习与特征工程)、深度学习突破期(AlexNet与神经网络)、大模型时代(Transformer、GPT-3、ChatGPT与多模态)。作者指出AI处理信息的方式从人类编写规则,到机器从数据中学习,再到模型理解目标并自主完成任务。未来AI将从大模型走向智能体(Agent),能够拆解任务、制定计划、调用工具,实现从被动响应到自主行动的转变。

技术 › LLM Kelvin (@ai_Goge) 2026-09-024.7 KB 50

From Prompt to Response Inside an LLM: A Visual Step-by-Step Journey With Code

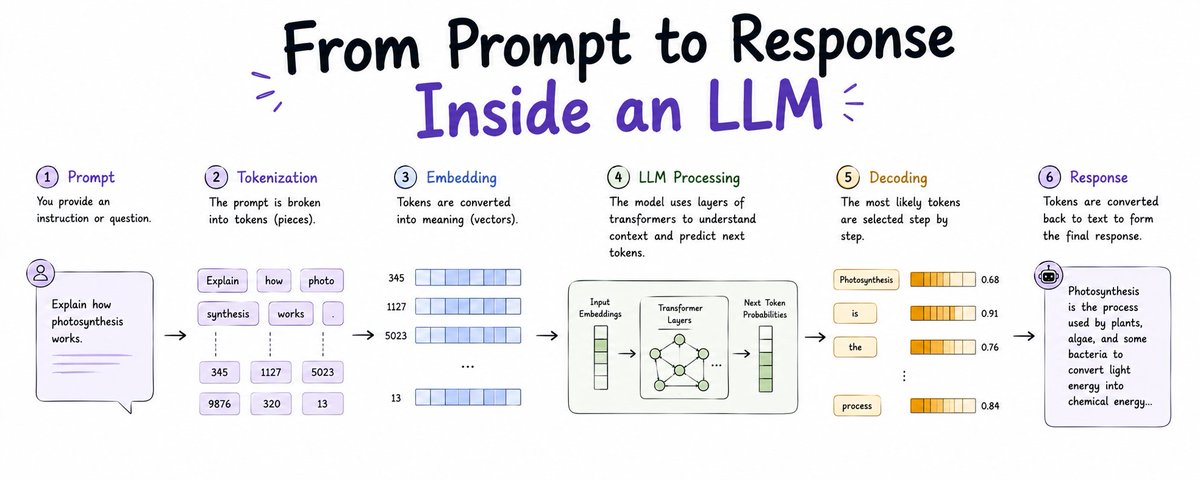
本文通过代码示例和可视化图表,深入剖析了大型语言模型(LLM)从接收提示到生成响应的完整内部流程。内容涵盖分词(Tokenization)、嵌入与位置编码(Embeddings and Positional Encoding)、自注意力机制(Self-Attention)等核心环节,并提供了使用tiktoken和HuggingFace库的实用代码,帮助读者理解模型如何处理文本、构建上下文并生成输出。文章旨在打破“Transformer魔法”的黑箱,为技术爱好者和开发者提供直观、可操作的LLM内部工作原理指南。

技术 › LLM Vikas gupta 2026-08-1519.6 KB 13.6K 14 77

机器学习的方法论总论

本文提出了一套机器学习方法论的统一框架,将学习算法拆解为十八个节点、四大块,以回答PCA、Transformer等不同方法在方法论上的异同。作者指出传统教科书定义、CRISP-DM流程和Domingos三元组的不足,特别是将“优化”作为第三列命名的问题,并引入闭式解、特征分解、积分等七种参数确定方式。文章详细阐述了定题与构造的前九个节点,包括三层代理(W/M/L)、目标与数据顺序、函数族、归纳偏置、参数化形态等,强调组合视角和归纳偏置的重要性。

技术 › LLM snowboat 2026-08-1386.0 KB 36.9K 60 80

一文科普 主流 LLM 注意力机制

本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88

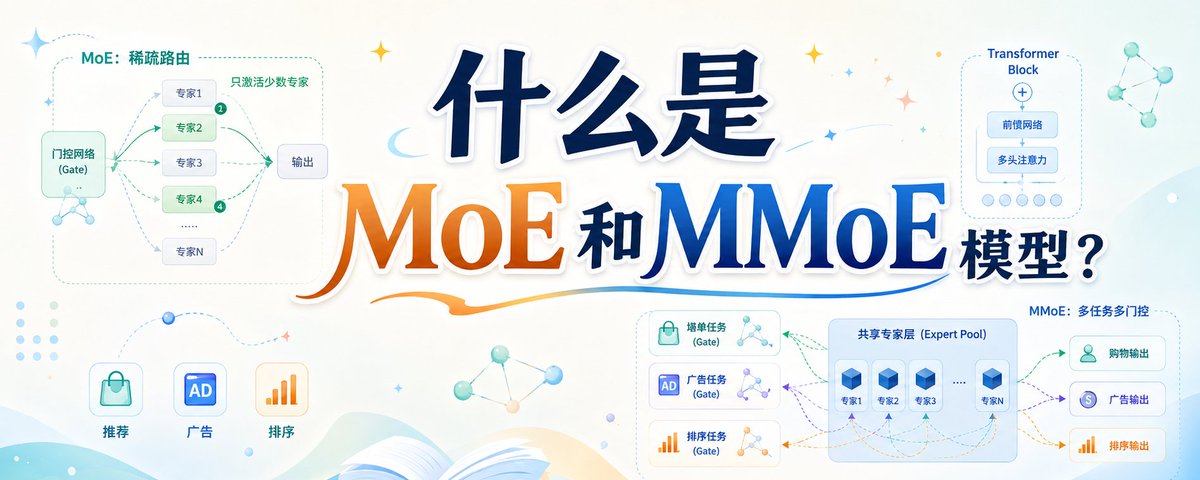
MoE与MMoE模型详解:从稀疏扩容到多任务学习

本文系统梳理了MoE(混合专家)模型的概念分歧与技术演进。针对目前命名混乱导致的认知误区,作者明确划分了两条核心技术路线:一是追求参数量与计算量解耦的稀疏路线,已成为大语言模型的默认架构;二是通过多门控机制实现任务共享的MMoE路线,主要应用于推荐系统。文章深入回顾了条件计算思想,并详细探讨了稀疏MoE在路由设计、负载均衡、并行通信等工程实践及结构演进的现状。

技术 › LLM snowboat 2026-08-0760.2 KB 16.2K 16 89