Wiki 知识库

全部文档 / 标签: LLM

1042 篇
清除

vLLM x AgentX: Optimizing for Real-World Agentic Serving

本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。
技术 › LLM vLLM 2026-09-0931.2 KB 41.2K 328 78

Developers Guide to using fewer Gemini Tokens with your Agents

本文介绍如何通过上下文压缩代理 headroom 减少 Agent 调用 Gemini 模型时的 token 消耗。作者指出 agent 上下文中大部分 token 来自工具输出的冗余 JSON、日志和搜索结果,而非精心设计的提示词。通过在 Gemini 3.8 Flash 前部署 headroom 代理,在四种生产级 agent 工作负载测试中,prompt token 减少 76%,任务准确率保持 100%,首 token 时间有所改善,建模成本下降约 70%。文章同时诚实探讨了压缩的有损性:压缩器保留模式、分布和异常值,但会丢弃普通记录,模型在数据缺失时会拒绝编造。项目开源且可复现。
技术 › Agent Alan Blount 2026-09-0912.1 KB 43.8K 391 87

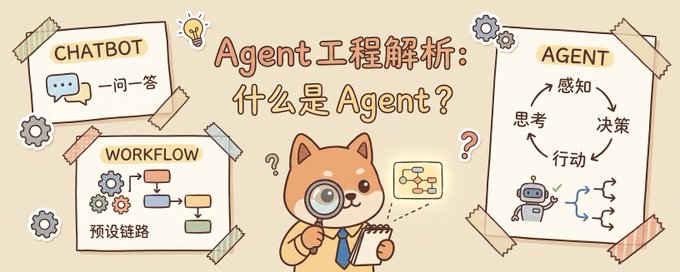
Agent 工程解析(零):什么是 Agent?

文章从工程视角系统讲解 Agent 概念:首先对比 AI 应用的三种形态——Chatbot(对话驱动)、Workflow(预设流程)与 Agent(ReAct 自主循环),分析各自优缺点及区分方法;随后给出最小 Agent 的循环伪代码,演示思考-决策-行动-感知的闭环机制;再梳理生产级 Agent 所需的八大能力模块,包括上下文管理、任务管理、记忆、连接器、Trace、容灾、编排与安全;最后探讨实际工程中三者混合使用的架构策略,如 Agentic Workflow、Workflow 包装为工具、前置路由分发等。

技术 › Agent 程序员Left 2026-09-088.7 KB 8.9K 61 70

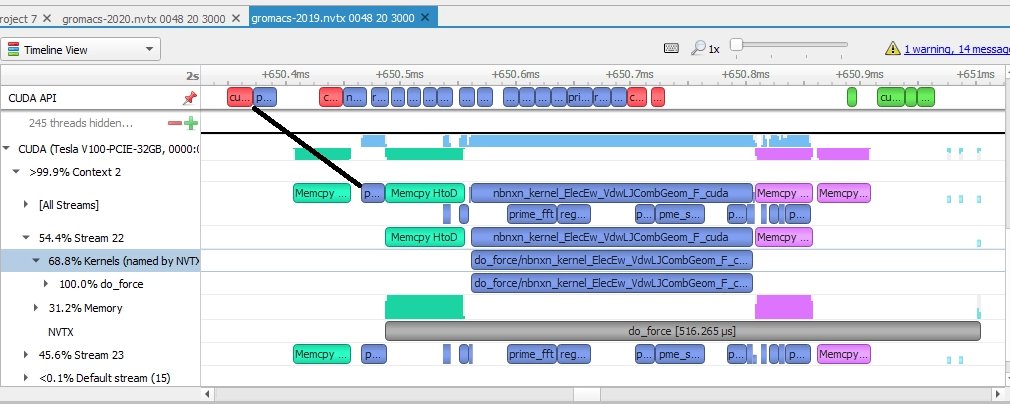
什么是 GPU Kernel?

文章介绍了 GPU kernel 的概念及其在模型推理优化中的作用。Kernel 是运行在数千个 GPU 线程上的并行函数,区别于操作系统内核。作者解释了 kernel 的调用流程(如 torch.matmul 经由 cuBLAS 等库启动 kernel),以及编写自定义 kernel 的价值,重点介绍了 kernel 融合(fused kernels)技术,如 FlashAttention 通过在 SRAM 中完成多步计算减少对慢速 HBM 的读写。同时强调自定义 kernel 虽然炫酷但应放在最后考虑,Batching、量化、投机解码、编译器优化等上层手段收益更大。最后推荐从 Triton 入手,并介绍了 ThunderKittens、TileLang、CuTe、Mojo 等新兴 kernel DSL。

技术 › 工具与效率 lucas liao 2026-09-087.0 KB 45K 627 71

The Math Needed for AI Inference Engineering (Complete Roadmap)

本文系统梳理了AI推理工程所需的核心数学知识路线图。内容涵盖:浮点数表示(FP32/FP16/BF16/FP8/INT8等格式的位分配与精度/范围权衡)、舍入误差累积、溢出与下溢、机器epsilon、灾难性消除及稳定softmax与log-sum-exp技巧;量化数学,包括scale与zero-point线性映射、对称/非对称量化、粒度选择、范围裁剪、激活离群值处理及基于Hessian的曲率方法;以及线性代数计算成本分析,如矩阵乘法的浮点运算量与内存读写开销估算。作者强调在性能分析前能手算层耗时是推理工程中最有价值的习惯。

技术 › LLM vixhaℓ 2026-09-0827.9 KB 93.1K 870 85

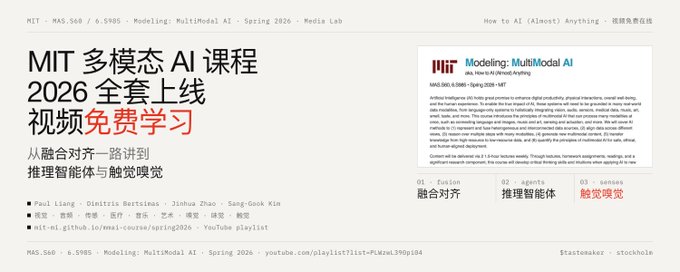
MIT 多模态 AI 课程 2026 版全套上线:视频免费在线学

MIT 由 Paul Liang 主讲的《How to AI (Almost) Anything / Multimodal AI》2026 春季课程全套视频免费上线。课程涵盖多模态学习完整技术栈:异构数据表示与融合、跨模态对齐、多模态生成、推理(RLHF、DeepSeek-R1、DPO)、智能体、跨模态迁移,以及触觉、嗅觉等新模态与自进化 AI 等前沿方向。相比 2025 版,新增多模态推理、智能体、自进化 AI 模块及制造、城市、交通等应用课。适合有机器学习基础的学习者系统建立多模态 AI 知识框架,课程网站与 YouTube 播放列表均可免费访问。

技术 › LLM meng shao 2026-09-089.9 KB 63.9K 32 82

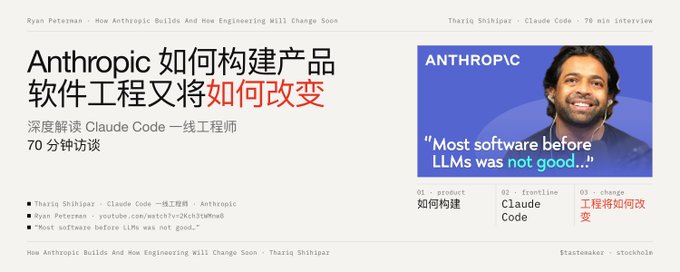
Anthropic 如何构建产品,软件工程又将如何改变 | 深度解读 Claude Code 一线工程师 70 分钟访谈

本文深度解读 Claude Code 开发者 Thariq Shihipar 的 70 分钟访谈,揭示 Anthropic 内部如何用 AI 做工程。核心观点包括:工程师抽象层级必须上移,把 Claude 当思考伙伴;知识工作皆可代码化;模型越强 harness 越复杂;自主性取决于 ticket 质量;提示工程被重新定义为注入上下文的一切;品味成为稀缺资源;验证能力重要性暴涨(测试代码需多 100 倍);写作与信任文化规范;以及 loop engineering、生成式界面等将扩散到全行业的转变。

技术 › Claude Code meng shao 2026-09-079.6 KB 9.1K 54 85

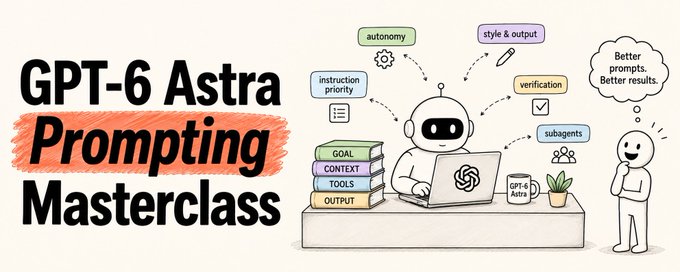
GPT-6 Astra Prompting Masterclass

OpenAI 的最新模型 GPT-6 Astra 能力大幅提升,过去用于强制模型运行测试、逐步思考等行为的旧提示词反而会拖累表现。文章总结了 Astra 需要显式提示的五大行为:主动性(过早停下来提问)、指令优先级冲突、默认过度 Markdown 的写作风格、子代理委派不足、过度测试。作者提出一个 8 块提示框架(目标、上下文、优先级、自主性、工具、输出、验证、停止条件),并强调按需选用。文中还给出清理过时指令文件、编写 Skill 文件的三条规则,以及控制文风、抑制套话的具体提示词模板,帮助开发者适配新模型的提示工程实践。

技术 › OpenAI Rahul 2026-09-0722.1 KB 870.6K 510 84

上下文压缩和记忆(nanobot)

作者介绍了 nanobot 的上下文压缩机制与长期记忆设计。上下文由 system prompt、历史消息和当前消息构成,当输入达到上下文窗口的 input budget 时,nanobot 压缩历史消息为新 summary,保留未发送的增量消息。生成摘要时通过模拟用户指令请求模型总结,并保持 system prompt 和工具定义一致以复用 KV cache 降低成本。对 OpenAI 原生压缩 API,nanobot 在加密 compaction item 之外额外生成文本 summary 供长期记忆使用。长期记忆通过 consolidator_archive 和 dream 两份提示词模板定制,用户可调整记忆筛选与整理规则,甚至整理成 skill。

技术 › Agent chengyongru 2026-09-074.9 KB 27.1K 109 74

OpenAI 官方的 GPT-6 Astra 提示词

本文整理了 OpenAI 官方针对 GPT-6 Astra 模型发布的提示词建议。Astra 比 GPT-5.6 Sol 更爱提问,官方给出提示词让其直接执行任务;针对 Skill 过多导致指令冲突的问题,建议定期检查上下文文件并明确优先级,可让模型指出受哪条规则影响;此外 Astra 在代码任务上容易过度测试,官方建议只在发现新失败或风险时扩大测试范围。作者认为 Astra 是相对完善的模型,但与 fable5.1 相比仍有差距。

技术 › OpenAI Aron厚玉 2026-09-073.3 KB 12.8K 96 79

万字长文|Skill 从入门到精通 - 入门一句话,精通一张词表

文章系统讲解如何编写 AI Skill:从用一句话加 SOP 封装出第一个 60 分的 skill,到通过把目标改写为动作、补充约束、设计自由度和提高词表颗粒度来提升到 90 分。作者拆解了摄影 skill 和封面 skill 两个开源案例,指出高手的秘诀在于将模糊概念拆成可执行的词表和明确的「不要」清单。还介绍了如何让 AI 递出陌生领域的行话词表,并澄清了 skill 与提示词、智能体的区别。全文强调约束和颗粒度决定 skill 的专业程度。

技术 › Skill Wattter 2026-09-0726.6 KB 18.9K 62 84

LLM 路由可能比不路由成本更高

文章探讨 LLM 路由(LLM Routing)的成本悖论:理论上将简单任务分配给廉价模型可节省大量成本(如 RouteLLM 实现约 85% 降本),Uber 因给 5000 名工程师统一部署 Claude Code 导致年度 AI 预算提前耗尽的案例也说明单一模型定价的问题。但传统路由方案在生产中会因四大失败模式而失效:分类调用额外计费、通用模型意图识别能力差、路由逻辑缺乏评估易腐化、以及模型切换破坏 KV 缓存导致全价重算。文章随后介绍 DigitalOcean 基于开源代理 Plano 的基础设施级路由方案:使用 1.5B 参数的专用路由模型(Arch-Router / Plano-Orchestrator)在代理内完成意图解析,准确率超越前沿大模型且更快,再结合成本与延迟数据对候选模型池按策略排序,实现成本与质量兼顾的动态路由。

技术 › LLM Akshay 2026-09-0715.7 KB 49.9K 475 75

斯坦福课程推荐:CS329A Self-Improving AI Agents

本文推荐斯坦福研究生研讨课 CS329A,课程以'一线经验+论文精读'形式讲授如何构建自我改进的智能体,共 9 讲并全部收录于 YouTube。课程主线为:生成→验证→筛选→训练→更强模型的循环。内容涵盖 test-time compute scaling、稳健验证(ORM/PRM/Math-Shepherd/Weaver)、反馈学习(ReAct/RLEF/CAI)、规划与多步推理、RL scaling(STaR/GRPO/DAPO)、Deep Research Agents 及长期任务评估。核心结论:瓶颈在于验证而非生成,可验证领域(数学、代码)飞轮转得快,当前 RL 提升的是一致性而非根本能力。

技术 › Agent meng shao 2026-09-0610.9 KB 254.5K 669 85

月入百万的电商全流程(北大研发)是如何搭建的(完全开源)

作者分享了其搭建的AI跨境电商指挥中心系统的完整架构与实践。系统涵盖客户发现、调研、SEO、客服、报价、订单分析等模块,通过统一的AI网关接入多个AI项目,实现成本、Token、延迟、错误率的统一监控,并提供预算预警、Prompt版本管理和API Key安全等能力。文章还讲解了电商财务模型(毛利、获客成本、复购)和业务流程拆解方法,强调把AI项目从黑盒变成可管理、可复盘的经营数据,最终形成一套每天自动运转的电商业务机器。

技术 › Agent Dean 2026-09-0670.2 KB 75

暴论:Skill 将死,方法论永生

作者参加 B 站 Build in Public 大会,记录卡比老师关于「Skill 将死,方法论永生」的分享。随着模型训练进步,通用知识和标准流程逐渐被模型内化,长篇 Skill 说明将变得多余,重点转向方法论。文章总结了 8 个可加入日常 Prompt 的方法论:第一性原理、对抗式审查、消融实验、奥卡姆剃刀、列出不确定点、保持独立思考、批判性思维、高内聚低耦合。作者认为 Skill 中的视觉参考和工具调用仍有存在价值,但重复性通用说明已可被精简的提示词替代。

技术 › Skill 七仔 (@Yangtze_Seventh) 2026-09-067.2 KB 74

我把四份宇树科技申报材料交给金融模型跑了三次,第三次它没输给数字,输给了 JSON

作者用四份宇树科技公开申报材料构建了10万字符的证据包,对蚂蚁百灵金融模型 Ling-3.0-flash-Fin 进行三轮相同条件实测。前两轮均达 32/33 字段正确、19/20 整项正确,且对无答案问题不硬编;第三轮内容大体正确,却因 JSON 结构错误导致程序无法解析,形成'API 返回 3/3,严格结构化交付 2/3'的结果。文章指出模型进入真实金融工作流后,关键不再是答对问题,而是稳定交付下游可用的结构化结果,建议采用 JSON Schema 校验、失败重试与人工复核的生产路径,认为该模型适合作为金融 Agent 的中间推理层,但尚不能无人值守接管工作流。

技术 › LLM 波妞PONYO 2026-09-068.2 KB 26.1K 146 79

小白入门:Hugging Face vs GitHub 测评与零基础学习路径

本文为零基础学习者提供 GitHub 和 Hugging Face 两套可执行的学习路线。GitHub 路线分 3 阶段:第 1 周入门(核心概念与图形化工具操作)、第 2-3 周进阶(Git 命令、团队工作流、Pull Request 与开源参与)、第 4 周实战(搭建个人作品集)。Hugging Face 路线也分 3 阶段:第 1 周平台认知与在线体验、第 2-4 周本地调用 Transformers 库与简单微调、第 5-6 周开发并部署 AI 应用。文章还给出不同基础学习者的时间分配建议,所有推荐资源均免费,每天学习 1-1.5 小时即可从 0 到 1 完成入门。

技术 › 工具与效率 Modengsir AI 2026-09-068.0 KB 2K 16 72

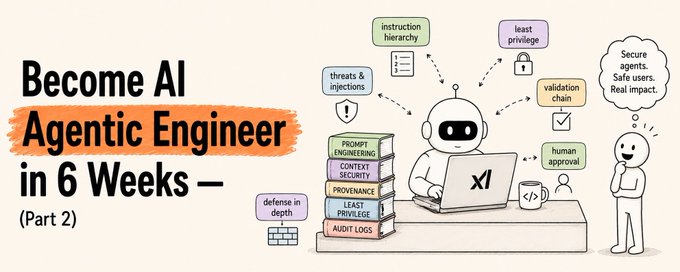
Become AI Agentic Engineer in 6 Weeks (Full Course) - Part 2

这是 AI Agentic Engineer 系列课程的第二部分,深入讲解提示词工程与上下文安全。文章首先介绍 LLM 的指令层级(系统提示、用户消息、工具结果),强调层级只是辅助而非安全模型。随后详细分析直接提示注入与间接提示注入两类攻击:间接注入尤其危险,因为恶意指令藏在外部内容(网页、邮件、GitHub issue 等)中,用户毫不知情。核心防御是来源标记,即区分内容的可信级别,同时强调授权必须在模型之外的后端以确定性方式实现,防止智能体成为权限绕过的工具。

技术 › 网络安全 Rahul 2026-09-0624.8 KB 344.2K 320 75

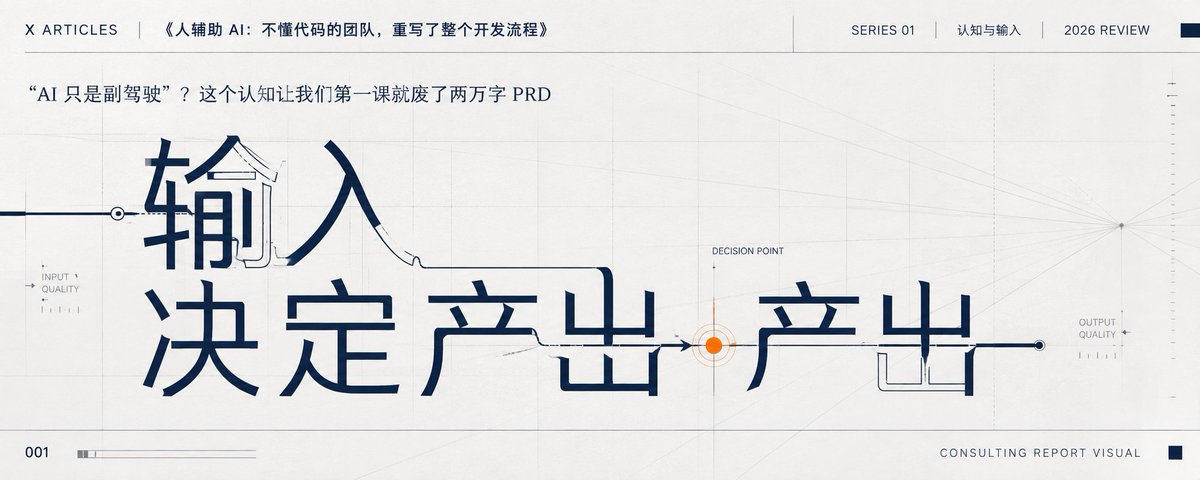
万字长文|大型复杂工程实战:人辅助 AI:不懂代码的团队,重写了整个开发流程(上篇)

文章复盘了一个不懂传统编程的团队转向 AI 编码的企业级实践。作者提出与主流 Copilot 叙事相反的范式——不是 AI 辅助人,而是人辅助 AI:AI 是执行者,人是决策者,由产品总监负责定义需求、设定边界和裁决。团队踩过两万字 PRD 翻车的坑,总结出传统 PRD 对 AI 的三大致命伤(模糊词、流程图依赖、文档脱节),并沉淀出情景化开发路径(UI First / Data First)、AI 友好型 PRD 四特征(全局术语表、EAR 表、逻辑真值表、UI 绑定)以及用 AI 质检 PRD 的方法。核心结论:输入质量决定 AI 产出质量,把话说清楚从软技能变成硬工程。

技术 › Harness Engineering 谁是专家 2026-09-0510.7 KB 3.2K 12 84

The Missing Pieces in Recursive Self-Improvement

文章探讨递归自我改进(RSI)的瓶颈:当前 AI 智能体虽能迭代优化结果,却很少重新审视改进背后的策略。基于清华大学等机构的实证研究,分析显示智能体在 5,111 次训练运行中能显著提升模型性能,但仅有约 2% 的情况会切换训练策略,多停留在执行层面的微调。增加经验、人工指导或推理算力均无法根本解决该问题。研究指出,迭代不等于重新思考,Metaⁿ 和 Recuris 等新方法尝试通过递归分层改进策略、演化记忆机制来弥补这一缺失。

技术 › Agent Turing Post 2026-09-058.3 KB 8.2K 109 71

My prediction on AI in the next 5 years

作者预测未来2-5年AI的发展:模型层将趋于商品化并从用户视野中消失,人们将为结果而非token付费。理想模型应是内置无知识、可搜索推理的小型模型。Agent经济将成为比人类经济更大的体系,掌控agent者掌控价值链。人人对人的工作(如销售)和艺术创作将受保护,普通人通过AI也能创造财富。作者建议:每天使用AI保持熟练度、深入研究AI在项目中的应用、保持知识更新、规划好分发渠道。

技术 › LLM Ben Cera 2026-09-054.9 KB 85.7K 456 53

一个AI连续创业者的半年独白

97年心理学硕士、前字节美团员工大雷复盘半年AI创业历程:先后尝试无货源电商、多模型问答应用Synthora、多Agent框架Donetrace等项目,写下十几万行代码却零收入,一度挫败焦虑。后转向Upwork兼职和自媒体教程分享,一篇播客视频教程帖爆火,48小时涨粉6000多。他总结三点思考:AI创业本质是换工具满足已有需求,AI只是执行工具,分享Building in Public至关重要,并提出长期沉淀、高效变现、可复用性三条创业项目选择标准。

技术 › Agent 大雷 2026-09-058.1 KB 17.7K 64 71

AI Engineering Skills Map: Using coding agents

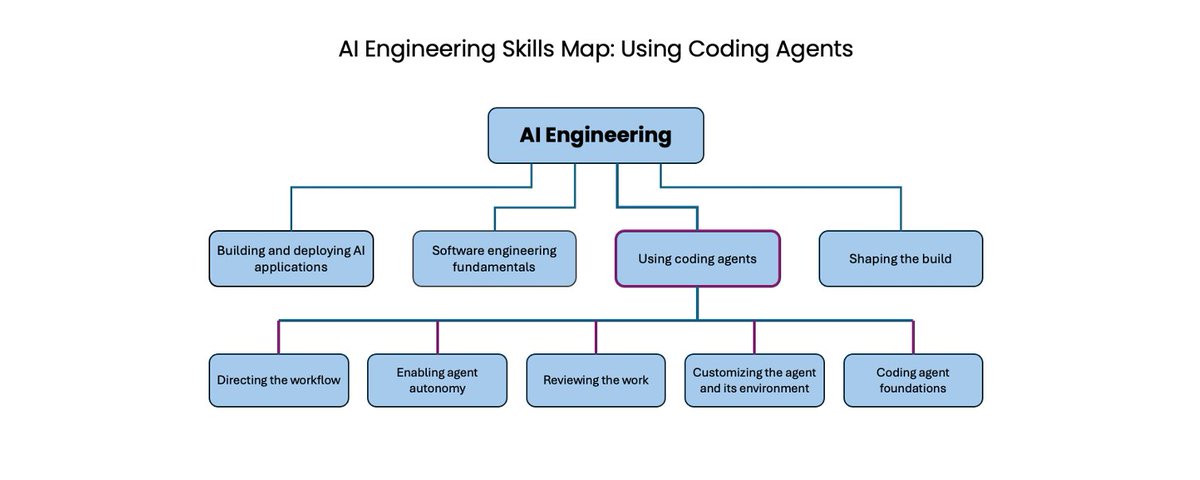
吴恩达撰文阐述AI工程师的核心技能之一——使用编码智能体。文章总结了与顶级AI工程师访谈得出的工作流程:规划(头脑风暴、撰写规格)、执行(构建、测试、验证)以及部署与监控(CI/CD门控、日志监控)。作者指出,有效使用编码智能体需要五大关键技能:掌控工作流程、赋予智能体自主性、审查工作成果、定制智能体及其环境,以及理解编码智能体的底层原理。文章强调,随着Claude Code、Codex、OpenCode等工具快速演进,这项技能也需要通过持续的实验、构建和学习来不断更新。

技术 › Harness Engineering Andrew Ng 2026-09-059.3 KB 751.8K 7.3K 83

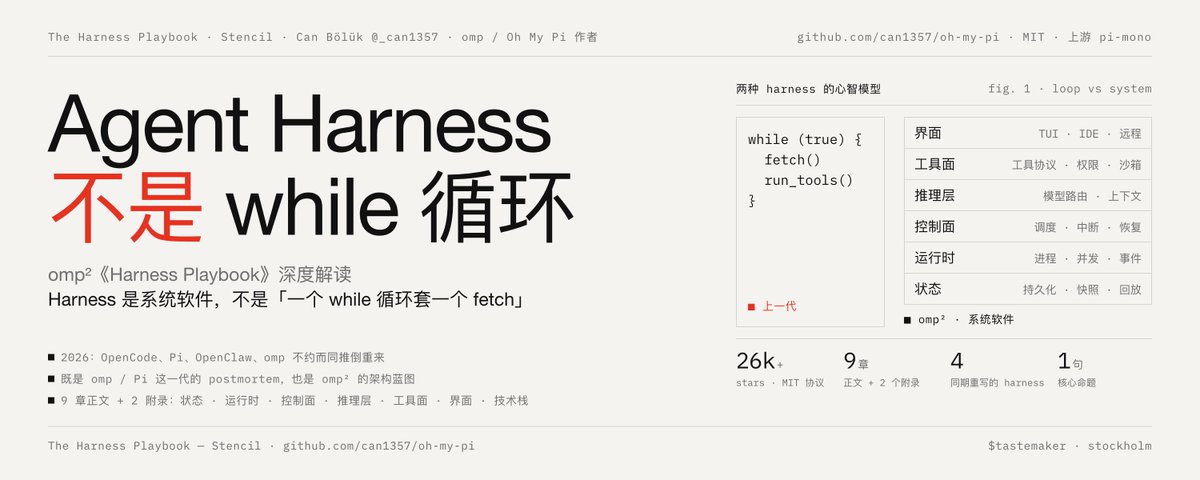
Agent Harness 不是 while 循环:omp²《Harness Playbook》深度解读

本文深度解读 omp 作者 Can Bölük 的《Harness Playbook》,提出 Agent Harness 是系统软件而非简单循环的核心命题。文章系统阐述 omp² 的架构蓝图:以唯一权威会话(DOM 树)解决 rewind/fork/resume 的状态一致性;沙箱只执行不决策;Convar 管值、Director 栈管行为的控制面设计;将模型兼容性作为结构化知识的推理层;精简工具名册以提升性能的深度内建工具;基于 RichText 流原语与 TLA+ 验证的渲染层;以及 Rust 核心 + Python 扩展的技术栈选择。文章认为该文将 Harness 工程提升为可推理的学科,同时指出其激进设计尚待落地验证。

技术 › Harness Engineering meng shao 2026-09-0517.1 KB 44.5K 248 86

AI中转站检测器CheckFakeAPI发布会:如何看穿AI中转站

作者发布免费工具CheckFakeAPI(checkfakeapi.net),帮助用户检测AI中转站的真实性与安全性。文章首先通过案例说明不良中转站的风险:隐私泄露、API Key被盗、模型偷换、虚假额度、平台跑路等九大隐患。随后介绍该工具的核心功能:基于协议字段、流式响应、工具调用、Token统计等多维度检测模型真伪;提供红黑榜公开排名中转站表现;每日GPT智商指数追踪模型状态变化;以及浏览器优先、Key不落本站的API余额查询。使用流程简单,检测后自动生成报告并进入榜单。

技术 › LLM Dean 2026-09-0411.9 KB 11.1K 9 73

2026 我的 Obsidian 完整分享

作者 Jackywine 基于六年重度使用经验,全面分享 Obsidian 知识管理体系的万字长文。文章回顾了自己从疯狂装 47 个插件、反复删库重建的「工具崇拜」弯路,到形成成熟使用方法的历程;汇总并点评了多篇入门教程与论坛精华;介绍了 Obsidian 的创始人故事、本地 Markdown 数据持久性理念、双链优先于分类的核心思想、2500+ 插件生态,以及与 Notion、Logseq、Roam 的对比;最后结合 Karpathy 用 LLM 构建知识库的实践,探讨了 AI Agent 时代 LLM-Wiki 的知识管理新范式。

技术 › 工具与效率 Jackywine 2026-09-0450.5 KB 467.3K 1.1K 77

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

万字长文|AI Agent 从入门到精通,通俗易懂讲解

本文是一篇通俗易懂的 AI Agent 入门到进阶教程,讲解了 Agent 的核心原理与工程实践。作者用公式'Agent = 模型 + 目标 + 工具 + 记忆 + 运行循环 + 安全边界'拆解 Agent 构成,对比聊天机器人、自动化流程与 Agent 的差异。文章详细介绍三种经典模式(ReAct、Plan-and-Solve、Reflection)、工具设计的六条硬规则、提示词注入攻击防范、记忆/RAG/上下文工程的区别与用法,以及工作流、低代码、框架、自研四条实现路线的选择建议,并涉及 MCP、多智能体和 A2A 等概念。

技术 › Agent govin.eth | G哥 2026-09-0429.2 KB 126.9K 320 77

AI 使用实战复盘——怎么写SKILL

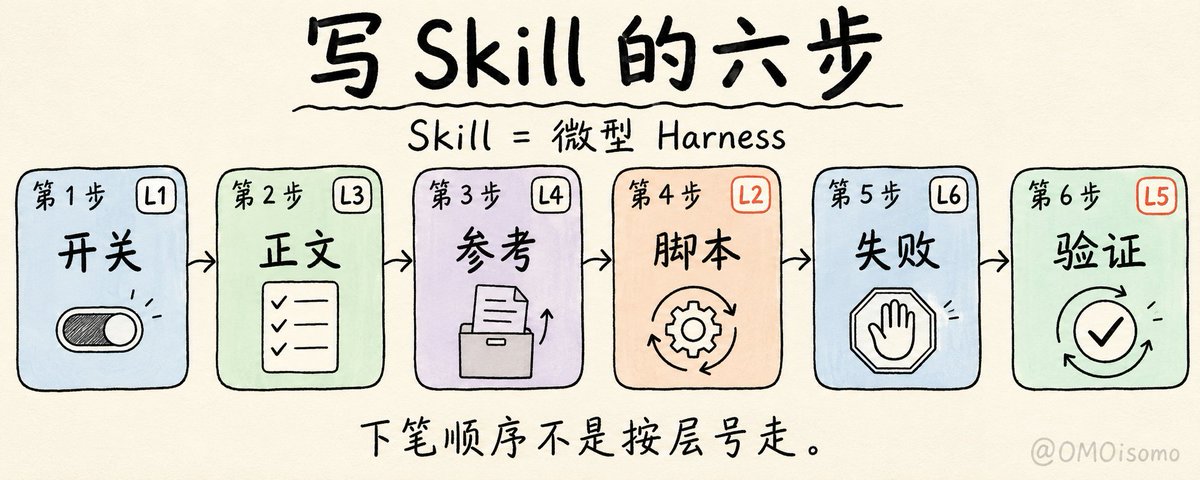
文章提出 Skill 本质是一个微型 Harness,一个完整 AI 工作系统包含六层:信息边界、执行编排、记忆与状态、工具系统、约束恢复、评估观测。作者给出六步写作法:先写 description 作为触发开关,再按任务脆弱程度定正文松紧,超过 500 行的资料拆成参考文件,重复操作固化为脚本,写明失败时的默认行为,最后用真实任务验证迭代。文章强调 description 是主要触发机制、模型天生欠触发、上下文窗口是公共资源、卡的下限由失败处理决定等实战经验,并提供最小可用卡模板和发布前检查清单。

技术 › Skill O MO 2026-09-0411.6 KB 58.9K 121 91

我们如何将 Playbook 审查重建为多智能体系统

Harvey 团队将合同 Playbook 审查引擎从基于固定提示词流水线的旧系统重构为多智能体系统。文章分析了合同审查的难点:复杂的条件逻辑、规则间的交叉依赖、交易情境影响判断、最小编辑原则以及需人工升级的决策。旧流水线架构存在上下文丢失、按条款孤立编辑、建议互相冲突等问题。团队与内部法律团队共建了评估基准,将法律判断量化,并据此设计了新的多智能体架构,以分析文档、标记风险并提出律师可信赖的精准修订建议。

技术 › Agent Pablo Felgueres 2026-09-0318.3 KB 27.9K 74 76