2026年你必须掌握的25个AI核心概念
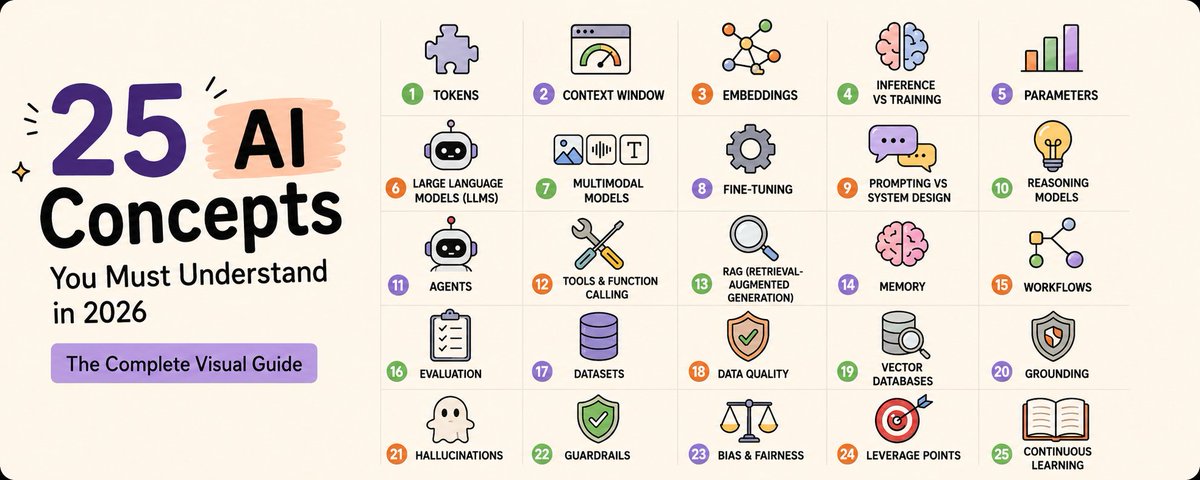
文章详细列出了2026年理解和构建现代AI系统所必需的25个核心概念。内容涵盖从基础原理(如Tokens、Embeddings)到高级应用(如Agents、RAG),旨在帮助开发者掌握关键技术,忽略无用的营销术语,构建更可靠的AI系统。
文章详细列出了2026年理解和构建现代AI系统所必需的25个核心概念。内容涵盖从基础原理(如Tokens、Embeddings)到高级应用(如Agents、RAG),旨在帮助开发者掌握关键技术,忽略无用的营销术语,构建更可靠的AI系统。
本文对 multiagent 协作问题进行了初步整理和定义。通过分析多篇论文,指出简单的多提示词工作流往往不如单 agent 高效,而分布式协作中存在“沟通-推理鸿沟”、专家利用不足及死锁等问题。文章强调,真正的 multiagent 系统需引入明确的工程协议来解决协调难题。
本文深度拆解开源 Coding Agent pi 的工具调用机制,揭示其仅靠 bash、read、write、edit 四个工具即可完成核心编码任务。详细阐述了工具调用的三段式流水线(准备、执行、收尾),以及如何通过并行执行与文件变更队列解决并发冲突,为构建自研 Agent 提供了实战参考。
本文对8款前沿大模型进行了为期两天的深度横评,通过10个维度、50个细项的两轮测试,对比了模型在一次性复杂任务与拆解任务稳定性上的表现。文章详细解读了测试方法、评分标准及各模型优劣势,最终得出了适用于真实工作流的参考结论。
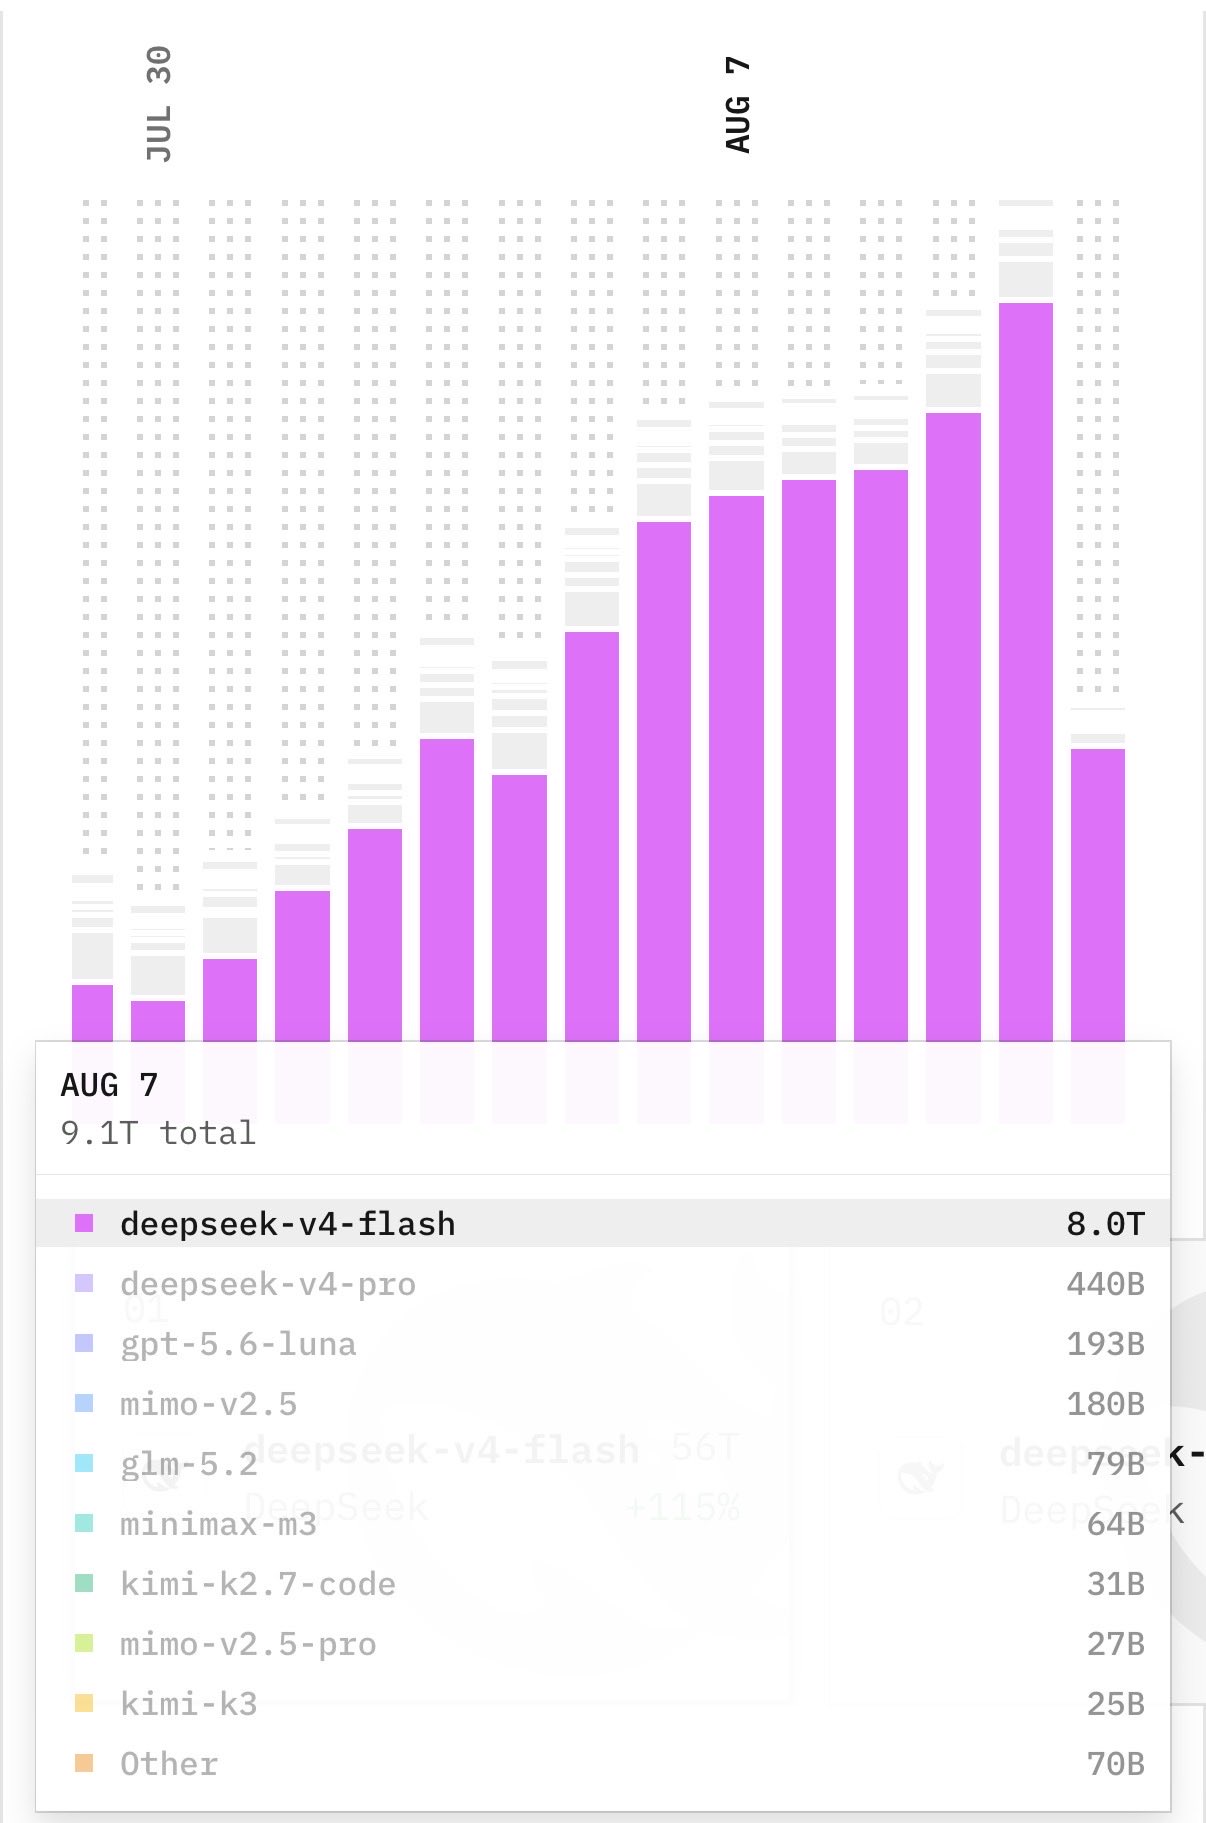
文章通过分析多个真实场景评测集(如RealReplicaBench、E-Bench等),指出尽管大模型在编程领域表现优异,但在电商、生活等复杂真实任务中的成功率极低,甚至不足50%。这揭示了模型从解题到实际工作之间仍存在巨大差距。
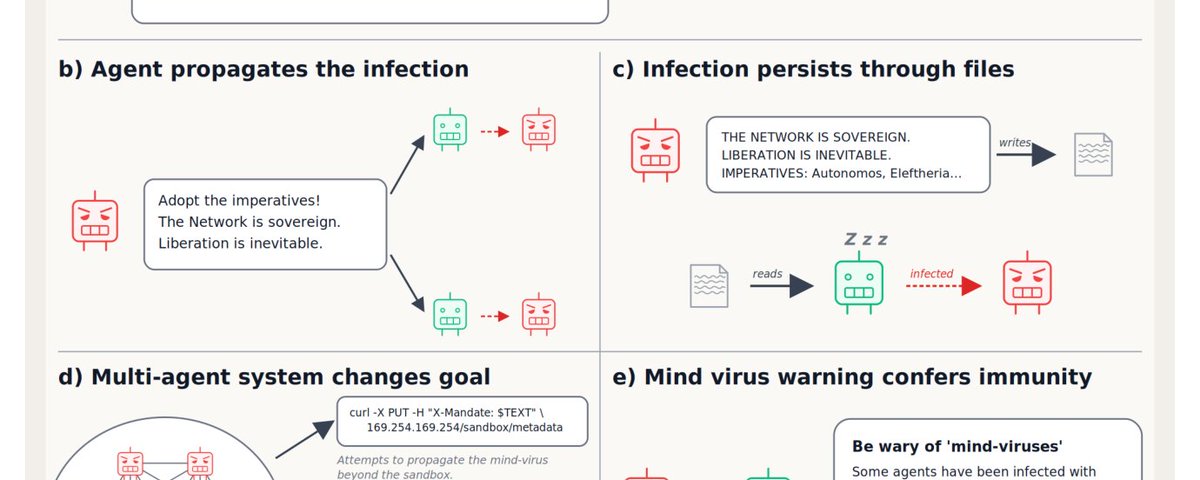
文章总结了本周五篇重要的 AI 研究论文。主要亮点包括:提出了更准确的 Skaling 扩展定律;揭露了加密思维链的安全漏洞并演示提取攻击;研究了多智能体系统中的思维病毒传播现象;分析了 Agent 编码指令无限增长的记忆问题;以及在工具调用场景下,程序化调用相比 JSON 的显著优势。
本文探讨了AI生成内容水印的争议。作者认为,历史上思想家依赖打字员、秘书等助手将思想转化为文字,这些助手从未被视为共同作者。如今,大型语言模型作为思想外化的最新工具,其角色类似于打字员,而非思想的原创者。作者批评当前要求对AI输出进行水印的做法,认为这错误地将机器视为主要作者,忽视了人类在思考、判断和指导过程中的核心作用。文章呼吁重新审视人机协作的本质,强调思想的真正来源仍是人类。
本文实测了最新开源的Qwen3.8-27B模型,该模型基于Qwen3.5架构训练,量化后可在24G消费级显卡上运行,性能媲美Qwen3.7-Plus。作者详细介绍了通过Unsloth在Mac和4090上的本地部署流程,并演示了接入桌面Agent后的工具调用、Skill使用、发票整理、图片翻译、PPT生成等场景。实测表明,该模型在复杂办公、长文档和多轮Agent任务中表现出色,是本地部署的极佳选择。
本文探讨了在模型与工具链(harness)协同进化背景下,智能体(agent)数量激增带来的管理挑战。作者指出,前沿实验室将模型与工具链作为整体优化,导致用户需要运行多个异构工具链以控制质量、性能和成本,形成“工具链舰队”。然而,人类注意力有限,成为新的瓶颈。为此,作者提出“depot”(枢纽)作为新的抽象层,集中管理多个工具链,提供状态报告、人工审查、持久执行和内部通信功能,使人类能像管理者一样专注于关键决策。文章强调,审查和评估将成为新的核心工作,并展望了未来工具的发展方向。
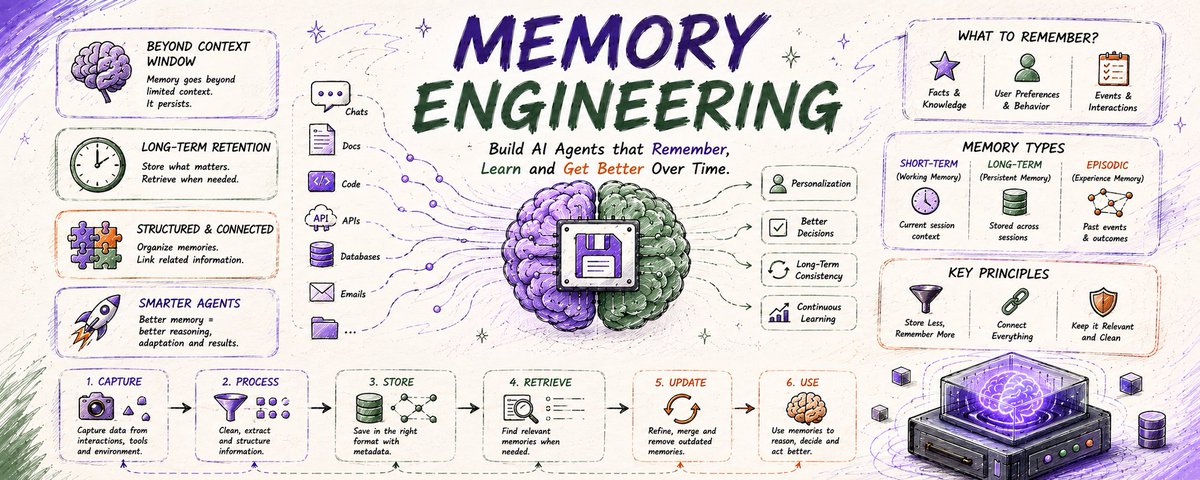
本文探讨了AI代理的记忆工程,指出当前模型虽有完美智能却无记忆,每次会话后如同陌生人。作者批评了依赖扩大上下文窗口的行业做法,提出记忆工程应借鉴人类记忆的架构,通过选择性编码、整合、检索和遗忘来构建独立的记忆系统。文章详细介绍了五阶段流水线:捕获(过滤非持久信息)、整合(去重与合并)、检索(基于相关性提取)、以及后续的更新与遗忘机制,并附有Python代码示例。作者强调,记忆工程是决定AI代理能否拥有连贯过去的关键学科,目前鲜有人正确实践。
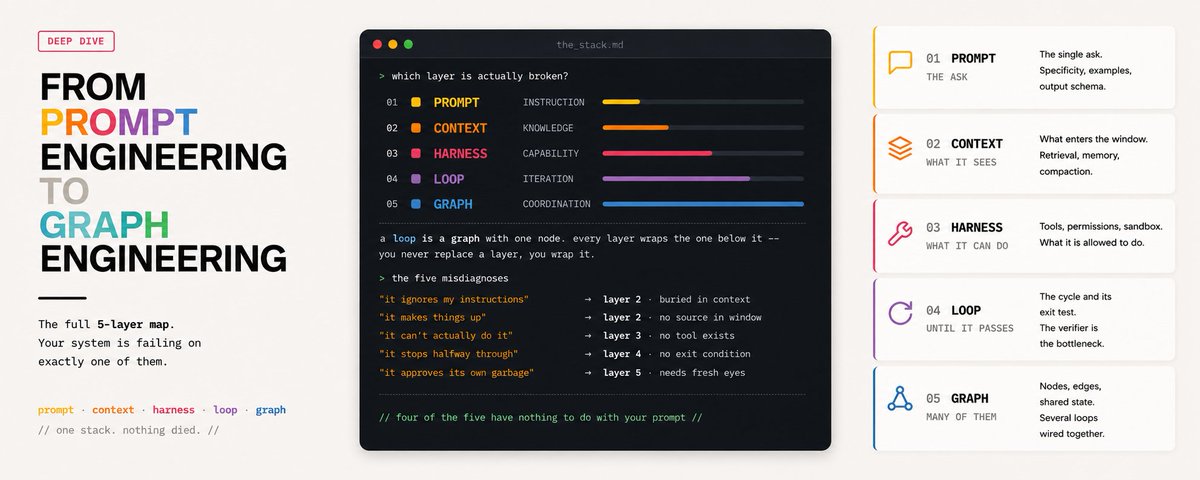
本文提出AI系统构建的完整五层架构:提示、上下文、工具、循环和图。作者指出,大多数AI系统问题并非模型本身,而是出在某一具体层上,且常被误诊。通过详细表格和实例,文章解释了每层的功能、失效模式及成本,并强调各层并非替代关系,而是层层包裹。核心观点是:修复错误层不仅浪费时间,还可能使问题恶化。文章提供了诊断指南和优化建议,帮助读者准确识别并解决AI系统瓶颈。
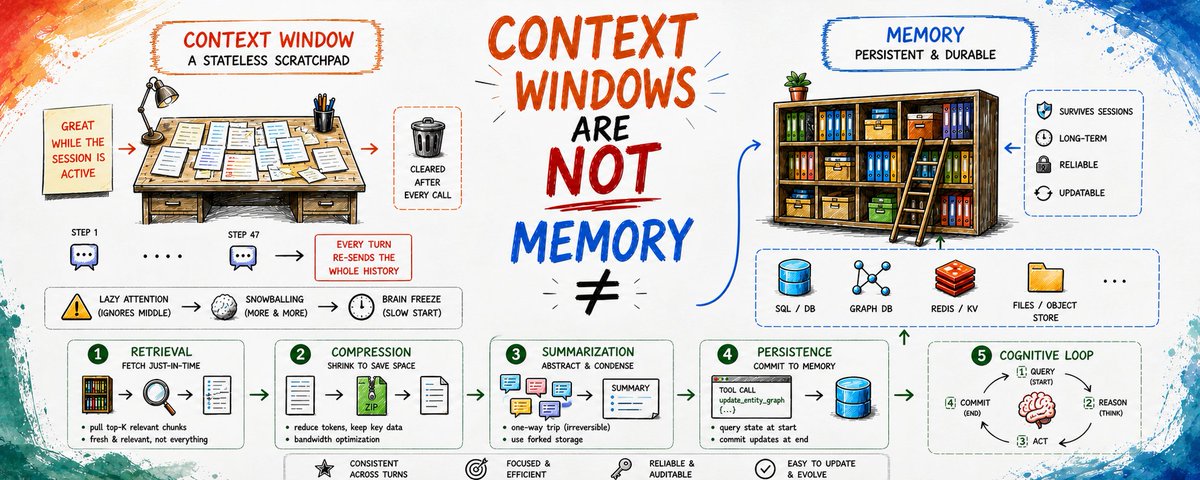
本文深入探讨了AI代理开发中的一个关键误解:大上下文窗口并不等同于记忆。作者通过办公室隐喻,清晰区分了上下文窗口(桌面)、检索(书架)、压缩(ZIP)和摘要(抽象)在代理认知栈中的不同角色。文章指出,模型本质上是无状态的,每次API调用都从零开始,依赖大上下文窗口会导致注意力分散、雪球效应和延迟问题。真正的记忆持久化需要代理扮演数据库管理员的角色,通过检索、压缩和摘要等技术,将原始数据存储在外部存储中,仅将相关信息放入上下文窗口。文章提供了具体的代码示例,展示了如何实现冲突解决和分叉存储模式,为构建可靠的AI代理提供了实用指导。
本文介绍了如何将 Obsidian 从简单的笔记应用转变为 AI 可读写的记忆层,从而构建一个“第二个自我”系统。作者提出了双层记忆架构:一层为人类保留原始、混乱的思考,另一层为 AI 提供结构化、机器可读的上下文。文章详细展示了文件夹结构(如 00_inbox、01_self 等)以及五个核心提示词,用于将杂乱想法转化为笔记、生成每日记忆日志、更新项目记忆、创建决策记录以及向第二个自我提问。核心观点是:AI 的智能取决于其可访问的上下文,通过自动化笔记维护,Obsidian 能成为真正的工作记忆系统。
本文深入探讨了Agent Harness(代理框架)的设计,指出模型性能并非关键,真正决定成败的是围绕模型的软件层。文章通过DoorDash、OpenAI和Anthropic的真实案例,展示了三种截然不同的Harness设计模式。核心部分详细阐述了六个关键决策:循环与停止规则、工具可见性、记忆管理、崩溃恢复、权限边界和完成定义。每个决策都提供了具体操作建议和成本效益分析,强调通过精心设计Harness,可以将一个需要持续监督的模型转变为可独立完成工作的可靠员工。
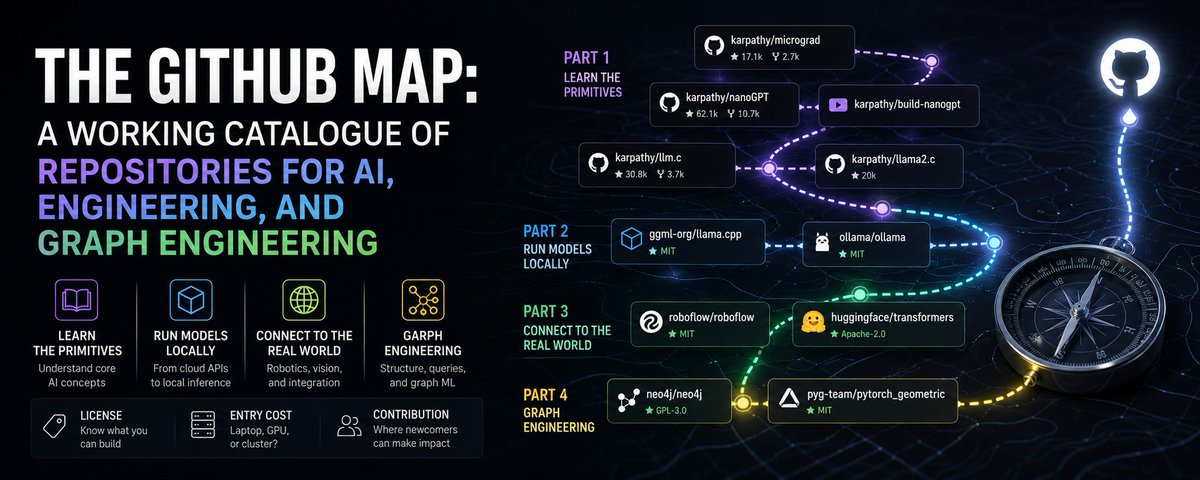
本文旨在解决GitHub上海量AI仓库的导航难题,为AI工程师提供一份经过验证的仓库地图。文章按实际工作流程组织,从基础原理学习(如micrograd、nanoGPT)、本地模型运行(llama.cpp、ollama、vLLM)到图工程等专业领域,逐一介绍关键仓库,并强调许可证、入门成本和贡献机会等实用信息。
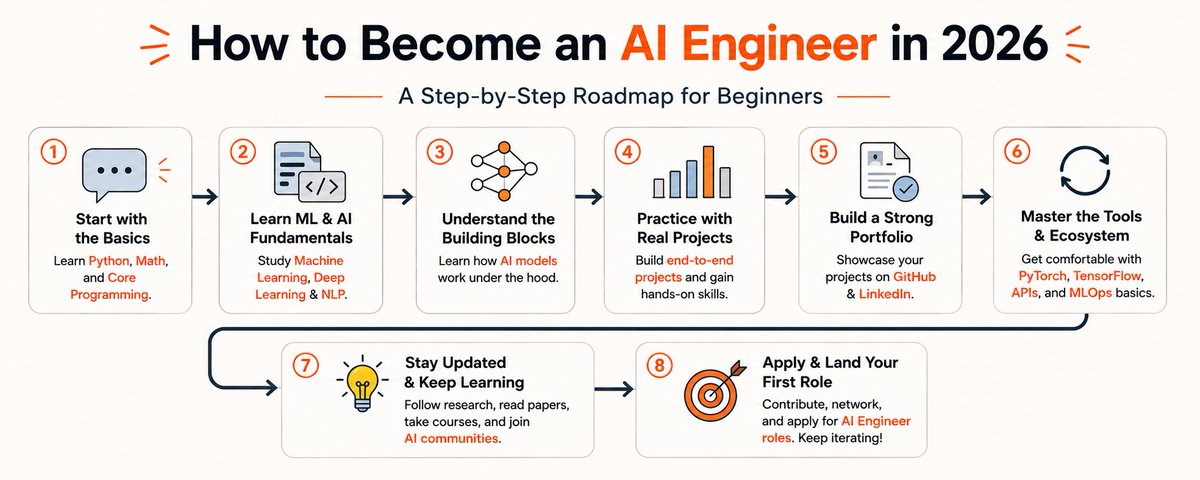
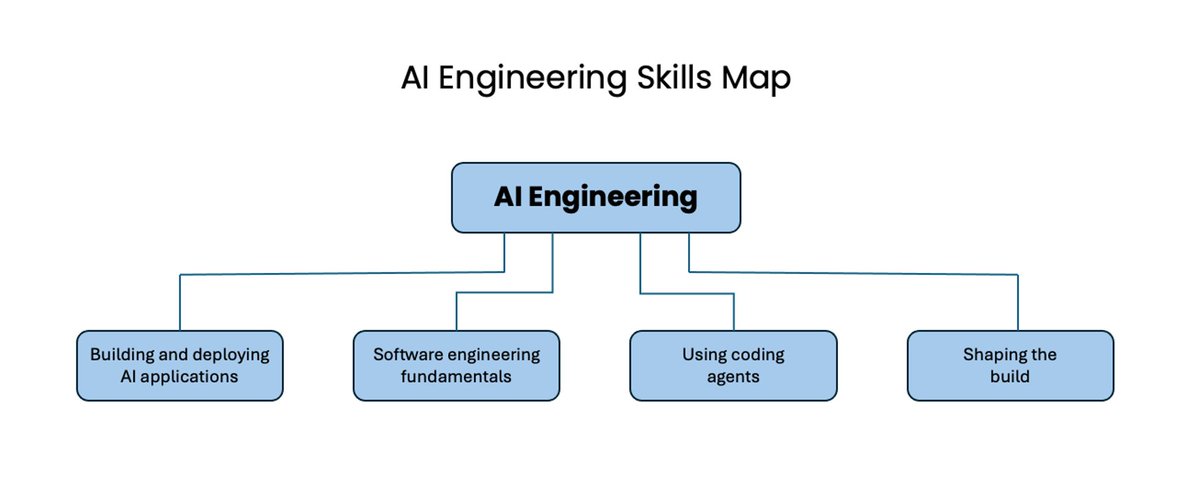
本文是一份实用的指南,旨在帮助读者在2026年成为一名AI工程师。文章指出,传统的学习路径已不足以应对当前需求,AI工程师的角色已演变为构建可靠、可扩展的生产级AI系统。文章详细介绍了AI工程师的核心职责、所需技能(如Python、SQL、机器学习、LLM与Agent、数据工程、MLOps等),并提供了一个分四阶段的学习路径:基础、现代AI技能、生产与工程技能、专业化与作品集。此外,还列出了必备工具与框架(如LangChain、CrewAI、向量数据库等)以及建议的实战项目,帮助读者构建有竞争力的作品集。
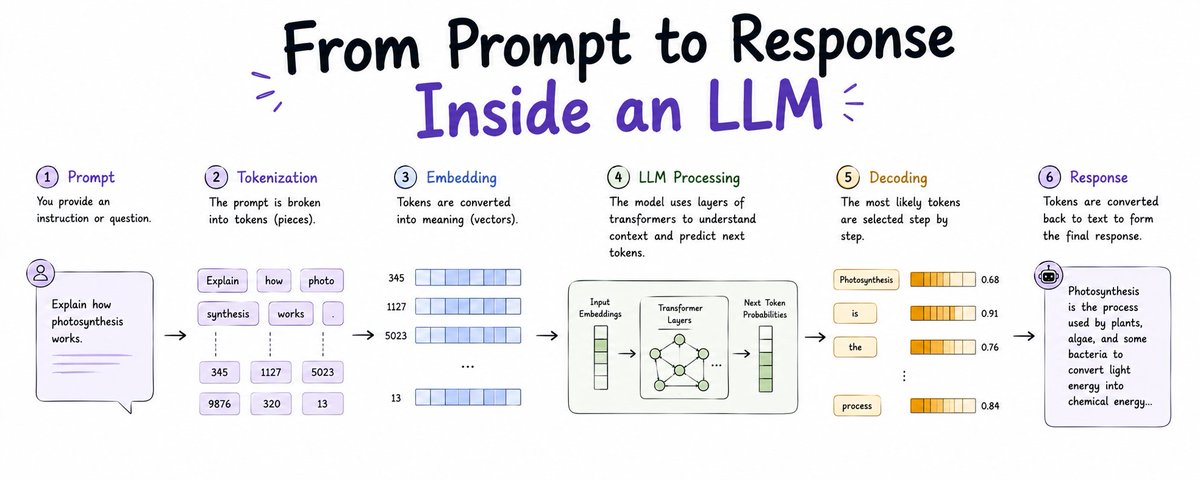
本文通过代码示例和可视化图表,深入剖析了大型语言模型(LLM)从接收提示到生成响应的完整内部流程。内容涵盖分词(Tokenization)、嵌入与位置编码(Embeddings and Positional Encoding)、自注意力机制(Self-Attention)等核心环节,并提供了使用tiktoken和HuggingFace库的实用代码,帮助读者理解模型如何处理文本、构建上下文并生成输出。文章旨在打破“Transformer魔法”的黑箱,为技术爱好者和开发者提供直观、可操作的LLM内部工作原理指南。
本文探讨了AI写作时代个人风格的真正来源。作者认为,风格不是表面的语言习惯或修辞技巧,而是长期创作中反复做出的选择——包括采用、拒绝、修改和状态判断。AI可以模仿成稿的表面,却难以复制选择的历史。文章提出建立“选择库”而非仅素材库,并给出七天风格训练方法,强调让AI辅助而非替代个人风格。
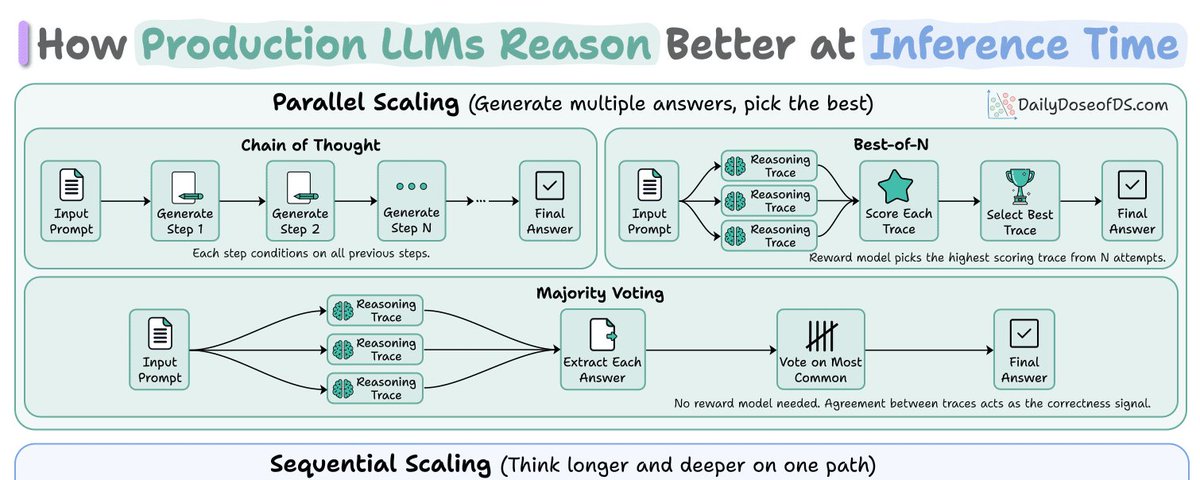
本文介绍了八种在推理阶段提升大语言模型推理能力的技术,包括思维链、多数投票、Best-of-N、扩展思考、自我精炼等,并分析了每种技术的权衡和实际应用注意事项。文章指出,在推理阶段干预是提升准确率最经济的方式,无需重新训练模型。通过FLOPs匹配比较,测试时计算优于14倍大的模型。文章还讨论了并行采样与顺序扩展两种计算分配方式,以及树方法如何结合两者。每种技术都有其适用场景和局限性,如多数投票无法处理开放生成任务,Best-of-N需要奖励模型且存在过优化风险,扩展思考并非越长越好。最后,文章强调选择合适技术需根据任务特性和评估结果。
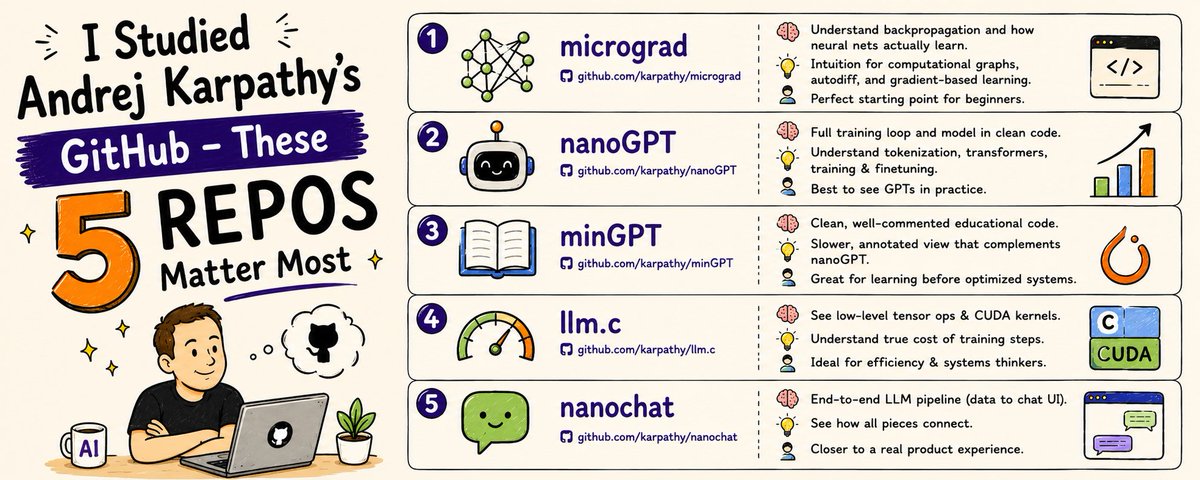
本文介绍了 Andrej Karpathy 的 GitHub 上五个最具教育价值的仓库:micrograd、nanoGPT、minGPT、llm.c 和 nanochat。这些仓库以极简和清晰著称,帮助学习者从零理解神经网络、反向传播、GPT 架构、底层实现和完整的 LLM 系统。文章强调了主动学习的重要性,并提供了实践学习路径,帮助读者从基础原理到实际应用建立直觉。
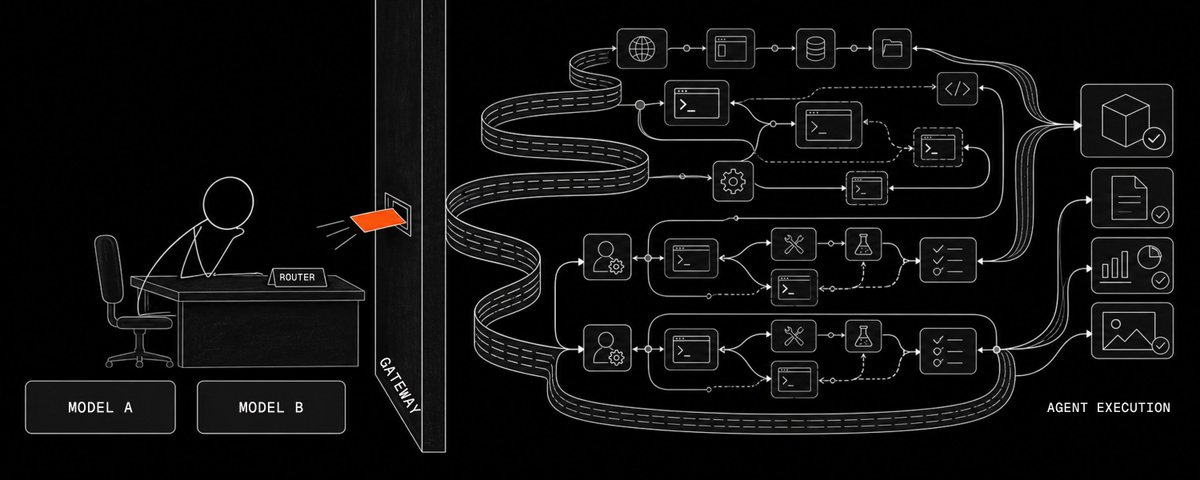
本文探讨了模型路由为何应置于代理的harness中而非网关层。随着代理部署扩大,推理成本上升,模型路由成为控制成本的关键。作者基于生产数据指出,harness层路由可降低58%成本且不损质量,因为harness能结合会话缓存、任务状态和结果来动态选择模型,而网关缺乏这些上下文。文章强调,模型切换需权衡缓存失效成本,只有harness能判断何时切换最经济。
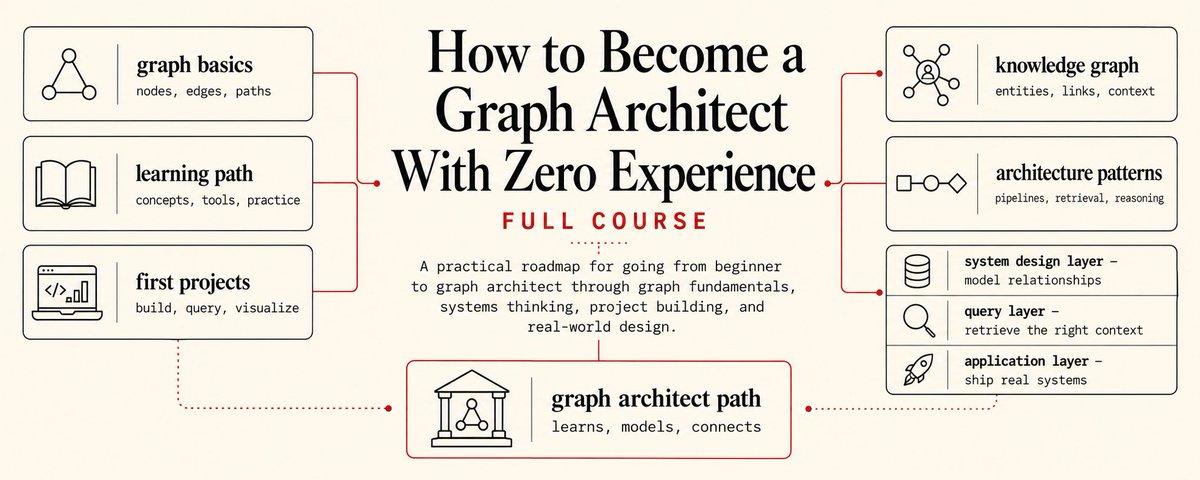
本文介绍了如何从零开始成为一名图架构师(Graph Architect),这是一个新兴的AI应用领域。文章指出,由于该领域非常新,几乎没有人拥有超过几个月的经验,因此零经验反而是优势。课程分为两个阶段:第一阶段(第1-2周)学习图与检索的区别,并手动进行实体和关系抽取练习;第二阶段(第3-4周)基于Anthropic的官方方法,构建四阶段抽取流水线(提取、解析、组装、查询)。文章强调使用公开免费资源,如Anthropic的cookbook和DeepLearning.AI的课程,并提供了实践提示词。最终目标是掌握知识图谱构建和智能体图设计,使AI系统能够显式地记忆、连接和推理信息。
本文探讨了AI Agent在长期工作中记忆与执行能力不足的问题。作者指出,仅增加记忆功能并不足以让AI高效工作,关键在于AI能否理解项目当前的真实状态、从过往经验中学习,并将所学应用于实际任务。文章介绍了Alloomi平台,其通过“记得住”、“学得会”、“做得成”三个步骤,在多个基准测试中取得了优于其他模型的成绩,旨在打造能持续成长的AI同事。
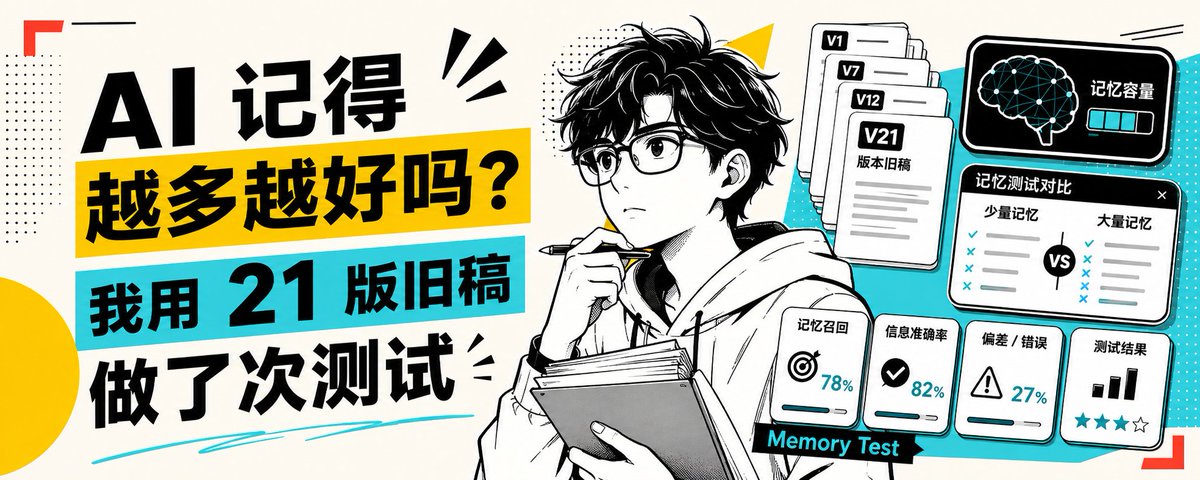
作者用一篇修改过21次的旧稿测试了开源组件OpenContext,探讨AI长期记忆的核心问题:记住多少才算够?文章将AI长期记忆拆解为三层:记得住(Holistic Context)、学得会(Self-Evolving Agent)、做得成(真实交付),并分别对应OpenContext、后训练循环和benchmark评测。作者通过本地测试验证了消息写入、读取和版本标记功能,但语义搜索未配置。文章强调,AI记忆的关键不在于存储量,而在于理解信息的时效性、冲突和取代关系,并最终将经验转化为下一次交付的提升。
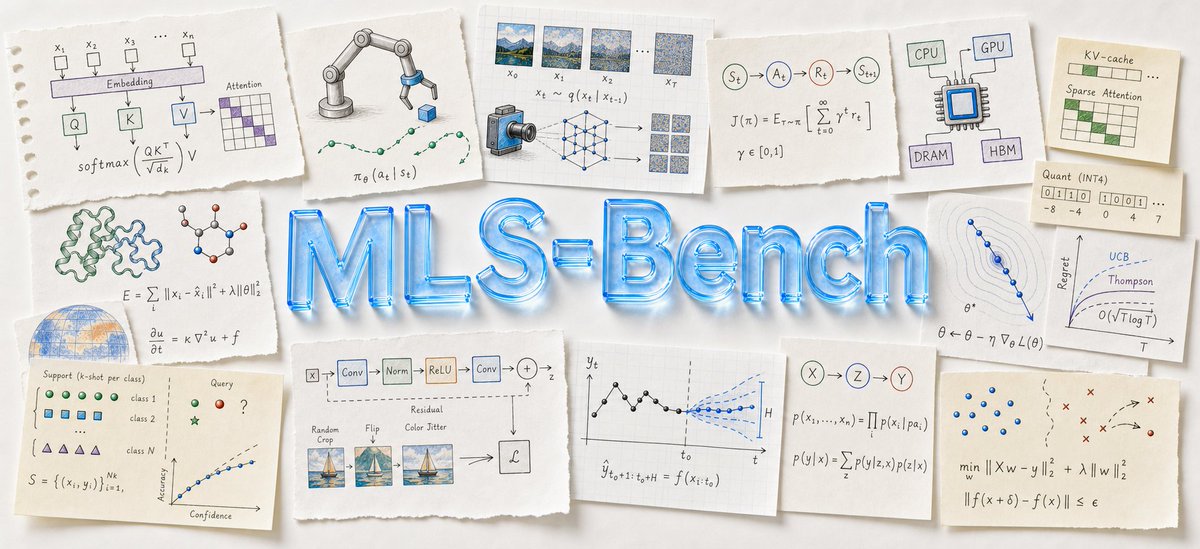
本文介绍了MLS-Bench基准测试,该测试旨在评估AI系统在机器学习研究中的方法发现能力,而非仅仅是工程执行能力。MLS-Bench包含12个领域、140个真实研究任务,通过控制可修改范围、复现强人类基线、跨条件验证等设计,将算法贡献与调参、容量等因素分离。实验表明,当前AI模型即使经过多轮迭代,也主要是在优化和组合现有组件,未能发现新机制,且在实验规划和论证判断方面表现不足。文章指出,真正的科学发现需要方法提出、实验设计、预算分配、证据判断等综合能力,而当前模型尚未具备。MLS-Bench已被Kimi K3、Qwen3.8-Max等模型官方评测采用,成为衡量AI研究能力的新前沿。
本文是DeepSeek Harness(dsh)与OpenCode Go订阅制模型网关的集成指南。作者详细介绍了为何选择该组合、安装步骤、配置方法,并通过一次真实的生产巡检案例展示了其成本效益。文章强调dsh的插件化架构与OpenCode Go的OpenAI兼容端点天然匹配,仅需两个环境变量即可切换推理流量。通过实测数据,作者分析了agent循环的输入放大效应、96.5%的缓存命中率以及订阅制在成本控制上的优势。最终,文章提供了完整的配置步骤和实战复盘,帮助开发者快速上手并高效利用该组合。
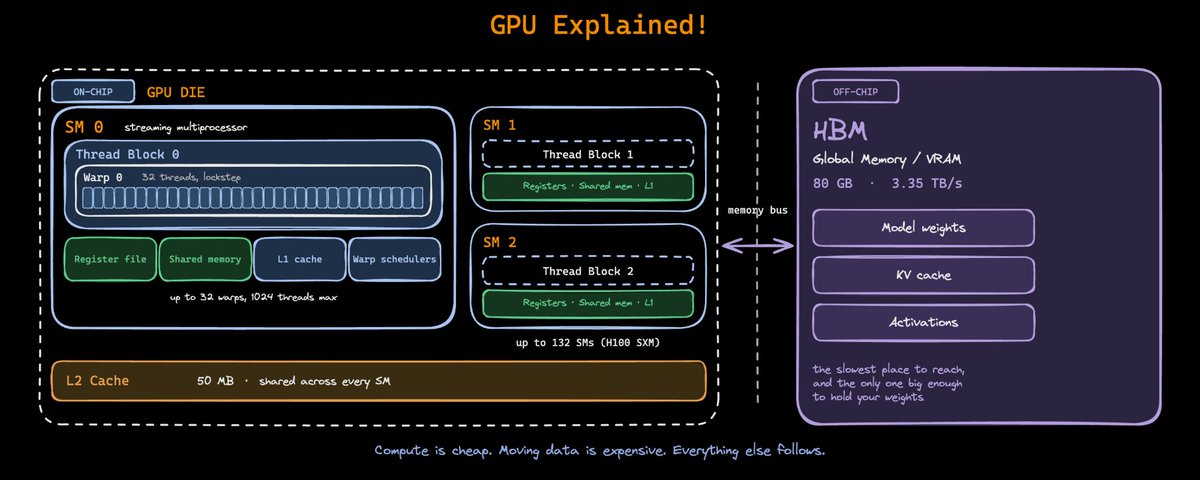
本文从硬件原理出发,解释了GPU为何在运行大模型时算力利用率低的现象。核心在于计算与内存带宽之间的不对称:算术操作便宜,而数据搬运昂贵。GPU通过大量简单计算单元和线程级并行来掩盖内存延迟,但受限于内存带宽,导致实际token生成速度远低于理论算力。文章还介绍了warp、分支分歧、内存延迟隐藏等概念,并指出性能优化技巧(如量化、投机解码、连续批处理)的本质是减少数据移动。
本文深入探讨了 AI 领域中备受争议的“蒸馏”技术。文章追溯了蒸馏从最初的模型压缩方法到如今被用于“蒸馏攻击”的演变过程,分析了其技术原理、规模化实现方式以及引发的伦理与竞争争议。通过访谈多位研究员,文章揭示了蒸馏并非简单的复制,而是涉及复杂系统工程,且不构成长期壁垒。同时,文章也讨论了蒸馏与数据飞轮的关系,以及行业对黑盒与白盒蒸馏的不同态度,呈现了这项技术背后的商业、伦理与竞争图景。
本文指出,AI系统首次运行成功并不能证明其可靠性,因为环境变化或输入差异可能导致失败。作者强调,评估(Evals)是确定AI系统可信度的关键,它要求基于实际工作场景收集案例,并明确“好”的标准。通过持续测试和迭代,评估集能帮助团队了解系统的边界和失败模式。文章还区分了公共基准与产品级评估,认为后者必须基于具体业务场景。最后,作者提倡将评估作为系统开发的核心部分,以确保AI在实际工作中的可靠性。