什么是信息论?它和AI是什么关系?
文章深入浅出地讲解了信息论的起源、核心概念及其与人工智能的关系。内容涵盖香农在1948年奠定的信息论基础(如熵、比特、信道容量定理),回顾了奈奎斯特、哈特利及玻尔兹曼等前人的贡献,并探讨了交叉熵、KL散度等概念如何成为衡量AI模型误差的关键工具。文章指出,尽管信息论为AI提供了度量语言,但在解释智能本质上仍有局限。
文章深入浅出地讲解了信息论的起源、核心概念及其与人工智能的关系。内容涵盖香农在1948年奠定的信息论基础(如熵、比特、信道容量定理),回顾了奈奎斯特、哈特利及玻尔兹曼等前人的贡献,并探讨了交叉熵、KL散度等概念如何成为衡量AI模型误差的关键工具。文章指出,尽管信息论为AI提供了度量语言,但在解释智能本质上仍有局限。
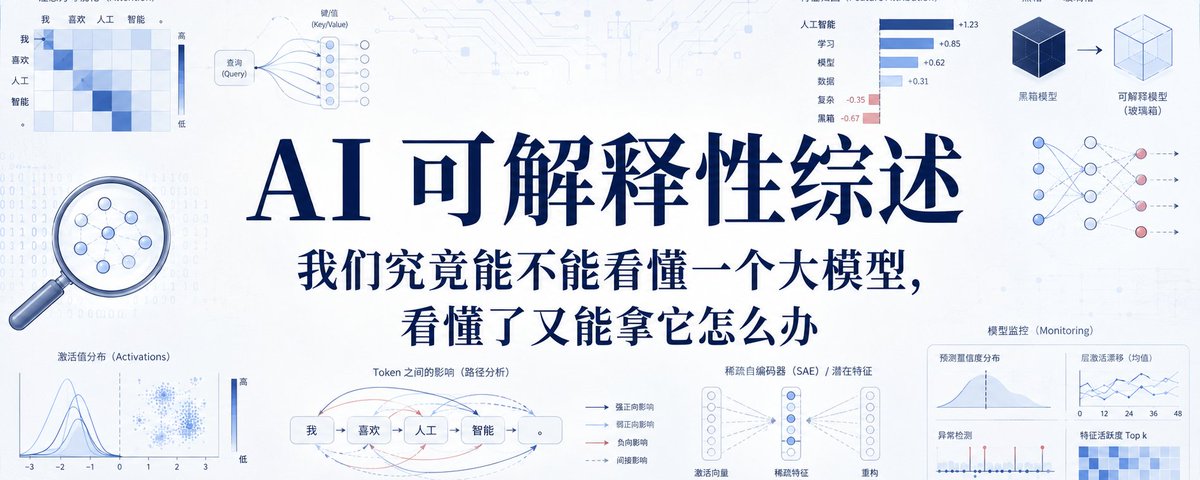
本文深入探讨了AI可解释性的必要性、定义及核心方法。文章区分了调试、合规与安全三种不同需求,辨析了事前与事后、局部与全局解释的差异,重点介绍了从LIME/SHAP等经典归因法到大模型时代的机制可解释性(如SAE和电路分析)的演进,并强调“忠实性”优于“可读性”的核心原则。
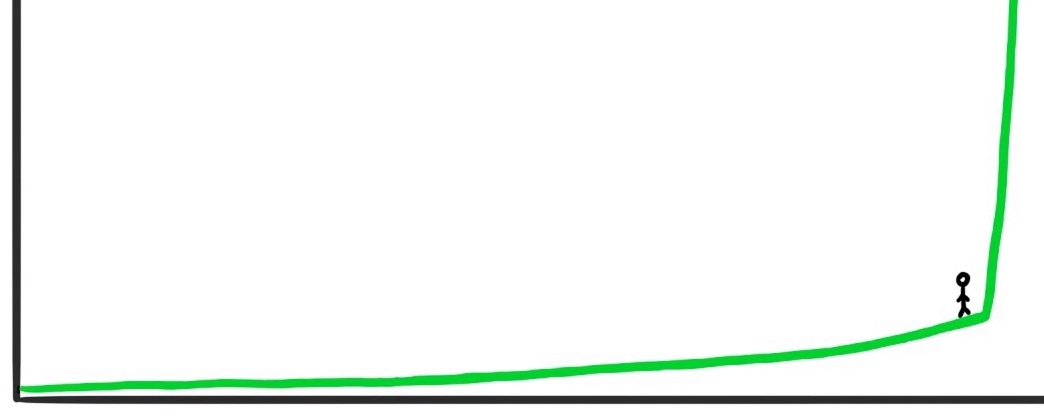
作者从智能发展的角度,深入探讨了算法进步、AI自我迭代(RSI)、算力瓶颈与摩尔定律、以及开源与闭源实验室的竞争态势。文章认为,我们正处于早期起飞阶段,算法效率的提升空间巨大,AI将自动化科研,导致技术奇点来得比预期更快。
这是一份按主题编排的AI领域人物小传(上篇),涵盖了从深度学习奠基者、大模型实验室领袖、Transformer论文作者到顶尖学术研究者的75位关键人物。文章详细介绍了每个人的背景、核心贡献及当前动态,包括Hinton、LeCun、Altman等业界巨擘。
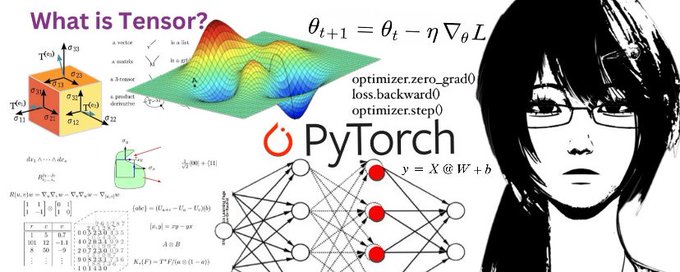
这是一份关于 PyTorch 训练流程的单页速查表。文章通过代码示例和原理解析,深入浅出地讲解了张量的核心概念、矩阵乘法、自动求导机制、反向传播以及梯度下降优化过程。同时涵盖了 `nn.Module` 常用组件如 Linear、ReLU 和 GELU 的使用,旨在帮助开发者快速理解深度学习引擎的运作原理。
本文探讨了黄碧薇教授创立 Aether AI 的深层原因。她深耕因果 AI 领域 12 年,致力于解决下一代 AI 从“相关性”走向“因果性”的问题。文章指出,Physical AI 的发展瓶颈在于模型需要理解物理世界的干预机制而非仅预测像素,Aether AI 试图通过因果世界模型填补感知与控制之间的空白,实现可靠的物理推理。
本文反对直接使用 AI 总结全书,指出这会导致理解外包和记忆流失。作者提出以“章”为单位的陪读方法,利用 Codex 生成读前问题、评估复述盲点、设计应用场景并生成章节卡片。该方法强调主动回忆与自我解释,将 AI 作为反馈工具而非替身,旨在通过最小闭环实现深度阅读。
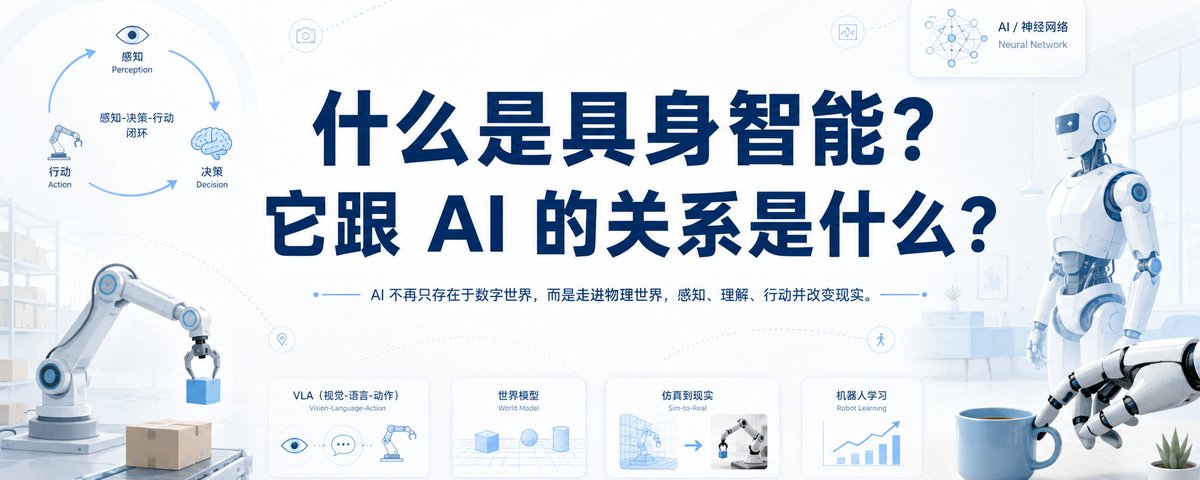
文章深入解析了具身智能的定义、历史渊源及发展现状。作者区分了具身智能与传统机器人,指出其核心在于感知-行动闭环与物理世界的实时交互。文章回顾了从符号主义、行为主义到深度学习、Transformer时代的技术演进,分析了VLA模型如何继承大模型能力来突破泛化难题,探讨其与AI的本质关系及未来前景。
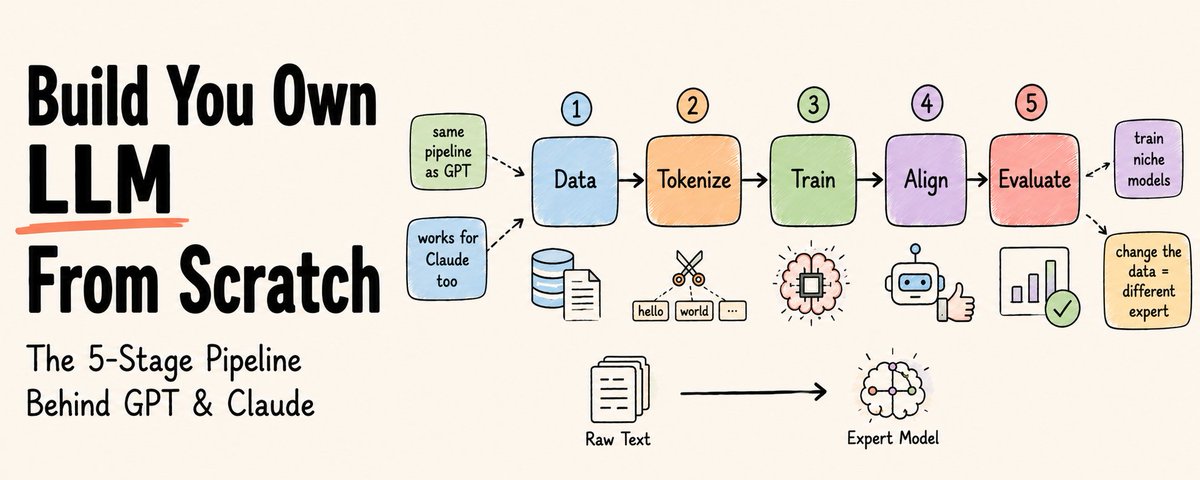
文章揭秘了 GPT、Claude 等 LLM 背后通用的五阶段构建流程,指出数据质量而非架构才是核心。作者详细阐述了数据清洗、分词、训练目标(预测下一个 Token)及 Transformer 架构实现,并提供了包含 Tokenizer 和 PyTorch 模型的代码示例。
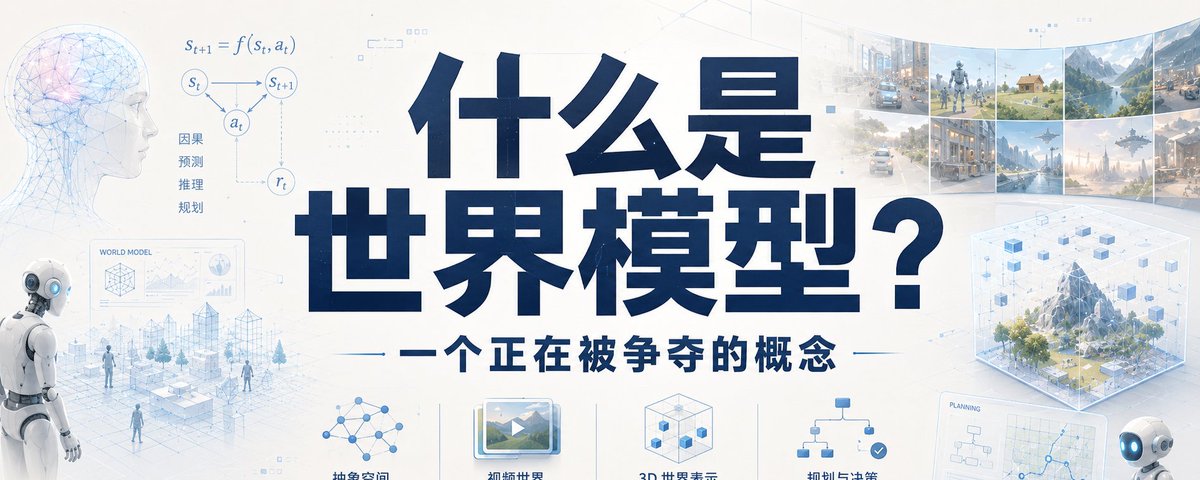
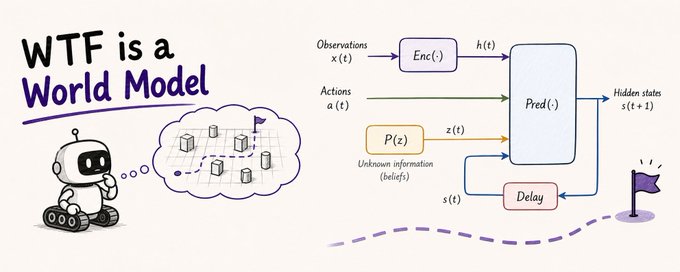
本文深入探讨了当前AI领域的热门概念“世界模型”。文章梳理了该概念从1943年心理学起源到2024年爆发式发展的历史脉络,详细区分了两大核心阵营:用于行动的模型(如DreamerV3和JEPA)与用于呈现的模型(如Sora和视频生成)。文中分析了杨立昆、李飞飞及OpenAI等不同派别的技术路径与定义之争,揭示了世界模型如何成为超越大语言模型的下一代AI竞争焦点。
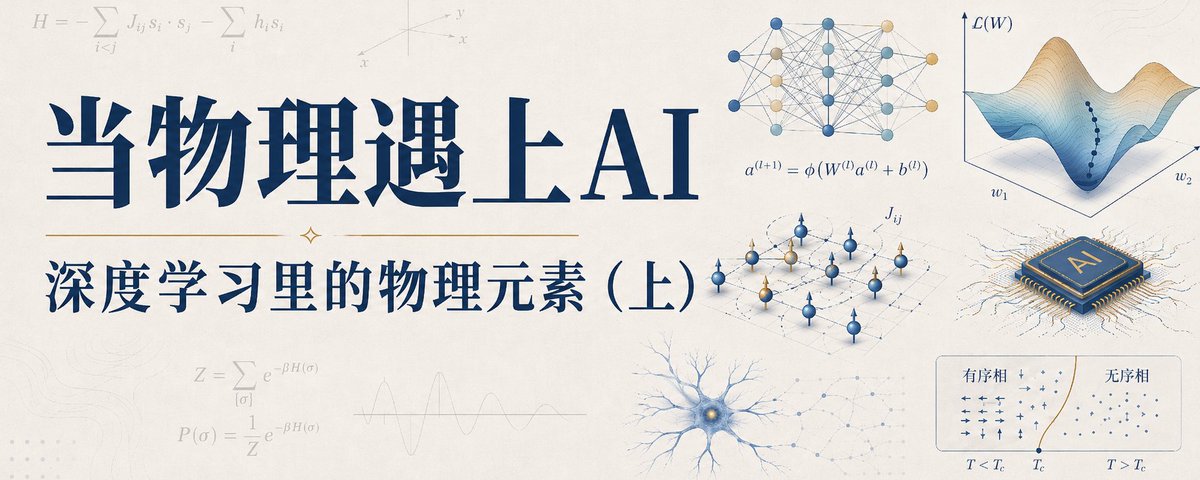
文章探讨了物理学与人工智能(特别是深度学习)之间的深刻联系。作者指出,神经网络本质上是一个类似于物理学中的“多体系统”,因此统计力学的语言天然适用于描述AI。文章详细拆解了能量最小化、Softmax(玻尔兹曼分布)、交叉熵(信息熵)、VAE(自由能)以及最大熵原理等核心AI概念背后的物理学渊源,揭示了从蒸汽机到神经网络的知识传承。
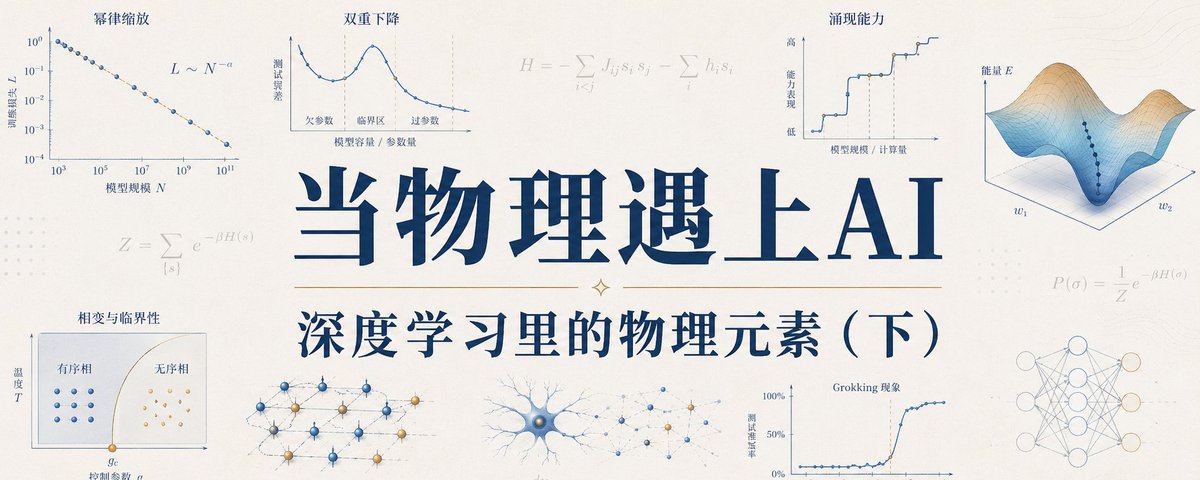
本文是《当物理遇上AI》的下篇,探讨了深度学习中的未解难题与物理学现象的同构关系。作者详细分析了Scaling Law与临界标度律、模型涌现与相变、双下降曲线与随机矩阵理论之间的深层联系。文章评估了这些类比证据的强弱,指出部分物理数学工具已能精确推导AI行为,同时也讨论了争议与未解之谜。
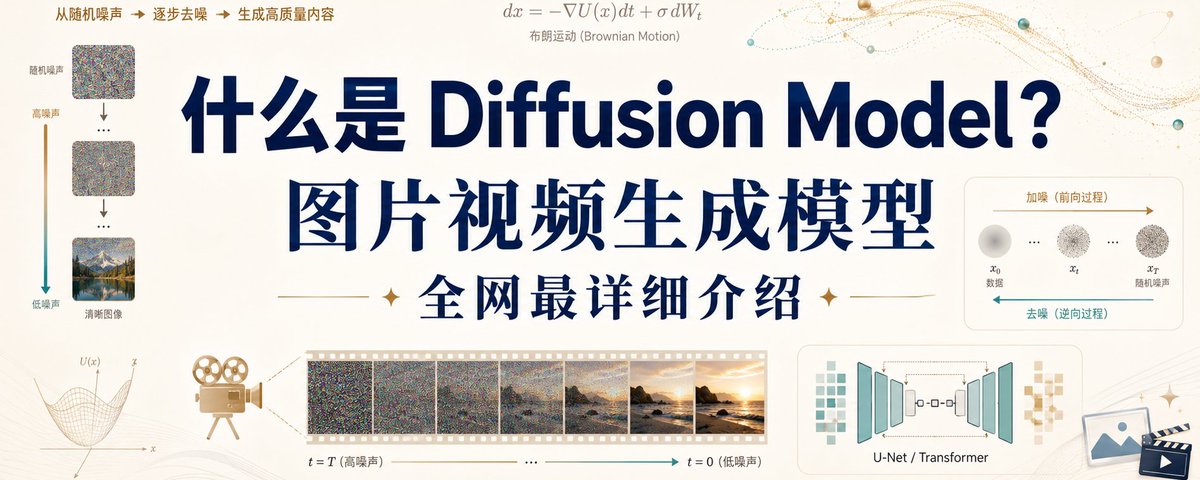
本文详细介绍了AI图像与视频生成背后的核心技术——扩散模型(Diffusion Model)。文章通过通俗易懂的语言,解释了其物理起源、从加噪到去噪的运作原理,以及它如何凭借稳定性优势逐渐取代GAN成为生成式AI的主流范式。
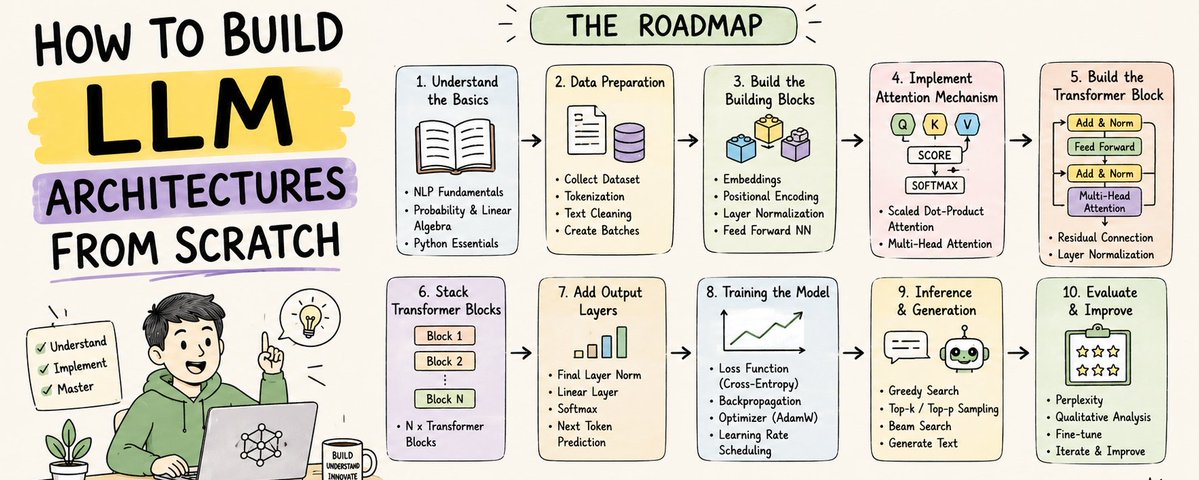
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
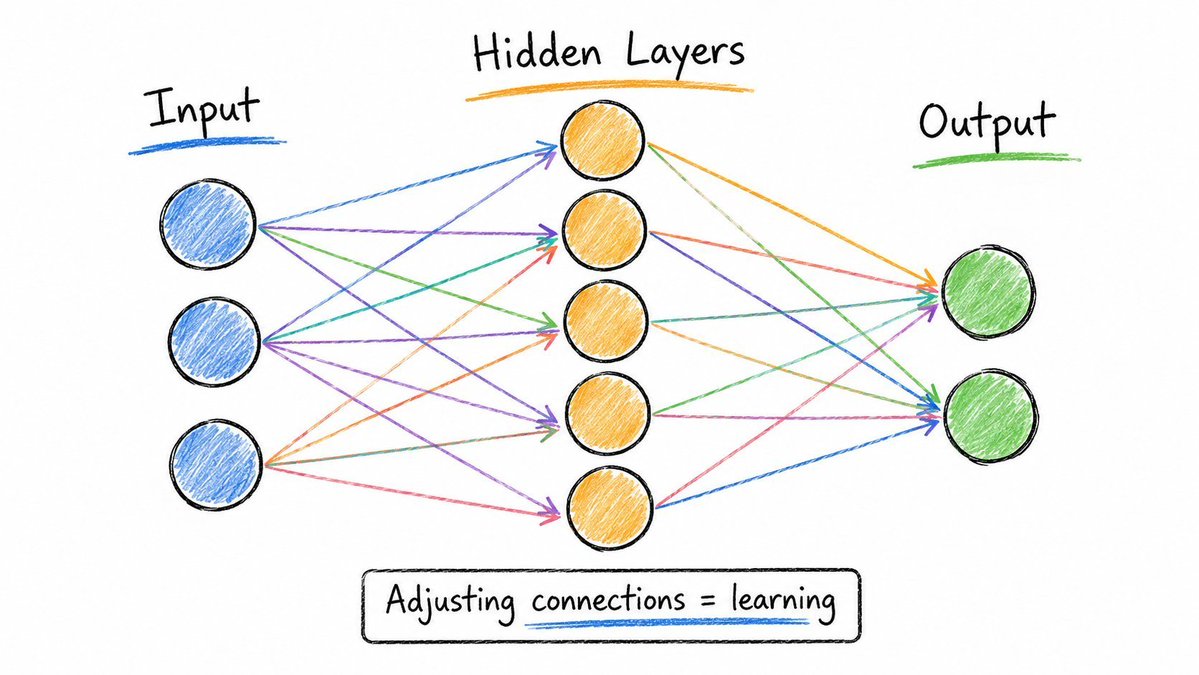
本文翻译整理了一组在 X 上广为流传的 AI 科普手绘图,涵盖从神经网络、Transformer 架构到大语言模型(LLM)的 20 个核心概念。作者不仅解释了 AI 底层运作原理(如分词、注意力机制),还介绍了模型优化手段(如微调、RLHF)及前沿应用架构(如 RAG、Agent、思维链),是一份简洁全面的 AI 技术入门指南。
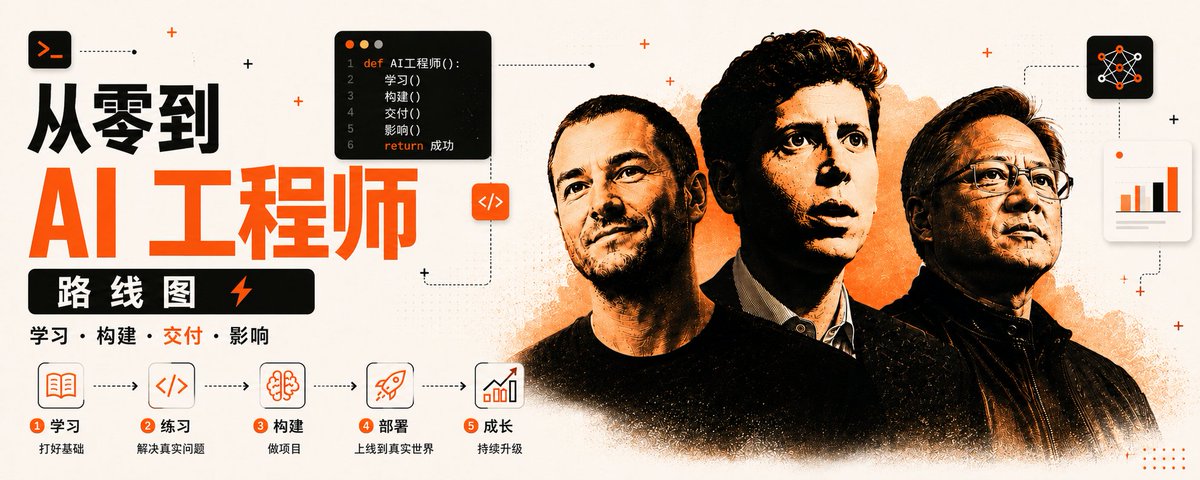
本文为 AI 初学者提供了一份为期 14 周的实战路线图,旨在通过免费资源将新手培养成具备构建生产级 AI 系统能力的工程师。路线图包含六个阶段:环境搭建、AI 基础、机器学习基础、深度学习、现代 LLM 工程以及 Agent 与部署。文章强调动手实践,推荐了 OpenAI、Anthropic 官方教程及 GitHub 优质开源仓库,帮助学习者避开盲目刷证书的误区,真正掌握 AI 开发技能。
本文提供了一个为期14周的实战型AI工程师学习路线图,旨在解决初学者“只学不做”的困境。文章从环境搭建开始,详细列出了从AI基础、机器学习、深度学习到现代LLM工程及Agent开发的最佳免费资源(如OpenAI/Anthropic官方课程、Karpathy的教程等)。路线强调通过GitHub项目实践来理解原理,最终掌握部署与评估技能,真正从零开始构建可用的AI系统。
文章详细介绍了 LoRA (Low-Rank Adaptation) 技术,这是一种用于高效微调大型语言模型的方法。通过冻结原始权重并学习两个极小的低秩矩阵,LoRA 能够在保持模型性能的同时,大幅降低显存占用、训练成本和存储空间。文章还解释了 LoRA 的核心数学原理、具体实施步骤以及为何全量微调成本高昂的原因。
文章深入探讨了混合专家模型(MoE),这是一种通过激活特定子网络来高效扩展 AI 模型的架构策略。文章回顾了 MoE 的历史背景,详细解释了其由门控网络和专家组成的结构及稀疏路由机制,并分析了其在 Transformer 中的应用、优势(如高效计算、参数扩展)以及面临的负载平衡和通信开销等挑战。
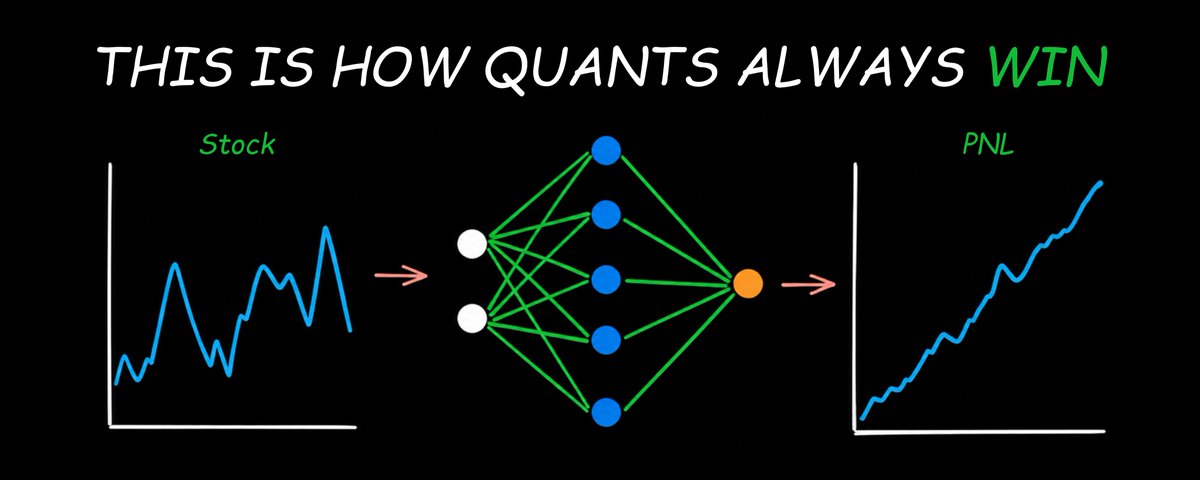
文章深入探讨了如何利用神经网络构建量化交易系统。作者解释了对冲基金如何利用机器学习提取交易优势,揭示了神经网络计算条件期望的数学本质,而非直接预测未来。文中分析了为何直接预测价格会失败,并提出了正确的数据处理方法和架构选择,旨在为交易者提供一个从数据准备到信号部署的完整实施框架。
Andrew Ng 在 The Batch 第 350 期中分享了 AI 编码代理对软件开发各环节的加速效应排序:前端>后端>基础设施>研究。前端因闭环反馈和模型熟悉的语言框架加速最快;后端因边界情况处理和数据迁移风险次之;基础设施因依赖工程经验和大规模测试加速有限;研究则因核心在于创意而非代码,几乎未受影响。
文章介绍了 OpenAI 的 VPT(Video PreTraining)论文,该研究通过训练反向动力学模型(IDM)为海量无标注互联网视频打上伪标签,成功让 AI 智能体在 Minecraft 中学会了制作钻石镐等复杂任务。文章详细阐述了 VPT 的“少量标注撬动海量数据”的技术路线、三阶段训练过程以及其带来的数据杠杆效应,并探讨了该方法从游戏向机器人控制迁移的潜力和局限性。
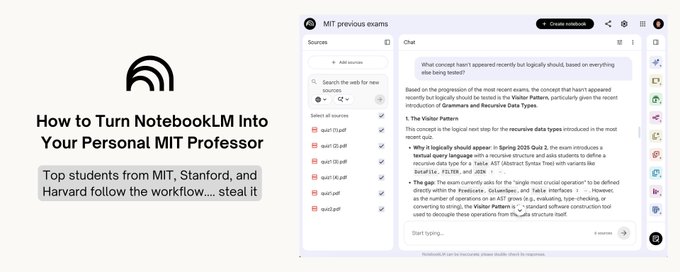
文章介绍了一种高效使用 NotebookLM 的方法。不同于传统的总结或做卡片,这种方法将其视为苏格拉底导师和研究顾问。核心流程包括:上传 20 个跨领域的源资料以构建课程;利用费曼技巧通过对话修正理解;寻找源资料中的矛盾点以培养批判性思维;以及通过模拟教学和每周综合来巩固知识,最终实现跨学科的通才思考。
本文深入探讨了人工智能领域热门概念“世界模型”。文章指出世界模型是一个问题陈述而非特定架构,类似于SLAM。文章通过自动驾驶案例阐述了Yann LeCun的形式化定义(状态预测与渲染分离),并对比了当前三种主流范式:生成式模型(如Sora)、潜在动力学模型(如Dreamer)以及JEPA架构,分析了它们在压缩策略和预测目标上的差异。
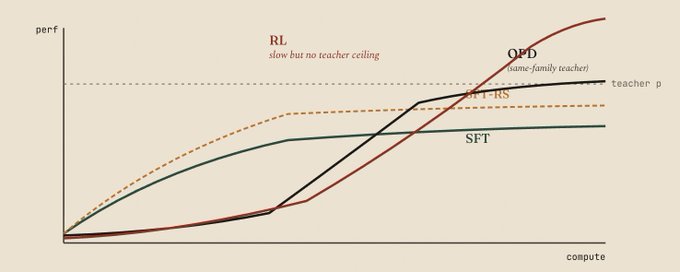
本文深入探讨了模型后训练中的 SFT 与 RL 流程,重点分析了基于同族模型(Same-family)的 On-Policy 蒸馏(OPD)技术。文章解释了 SFT 存在性能天花板的原因,以及 RL 如何通过复利效应突破这一限制。作者指出 OPD 结合了 SFT 的低成本和 RL 的复合优势,能高效利用教师模型的反向 KL 散度信号,是实现高性能模型微调的关键手段。
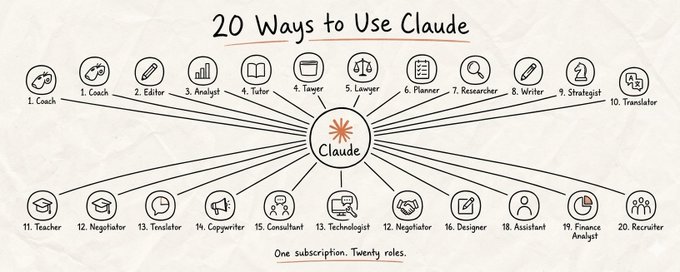
文章指出大多数人仅使用了 Claude 10% 的功能,仅停留在问答和摘要层面。作者分享了 20 个提示词,旨在将 Claude 转变为私人健身教练、谈判专家、财务分析师等角色。文中详细介绍了深度研究(如多源综合、魔鬼代言人模式)和写作辅助(如风格模仿、残酷编辑)等具体场景的 Prompt,通过高质量指令挖掘 AI 潜能,将其提升为真正的生活与工作助手。
文章从OpenAI关停Sora切入,深入探讨了Sora核心架构DiT创造者谢赛宁对大语言模型(LLM)的根本性质疑。谢赛宁认为LLM只是在模仿语言的统计规律,而非理解世界,语言是“鸦片”。文章详细阐述了基于抽象表征空间的预测架构(JEPA)和世界模型才是通往通用智能的正确路径,并指出未来的AI架构中,LLM将退化为仅用于交流的界面,而表征层才是真正的基石。
本文旨在消除从事 AI/ML 工作对数学博士学位的恐惧,提供了一份精准的线性代数学习路线图。文章分为五个阶段:从标量、向量、矩阵等基础概念,到特征值、SVD(奇异值分解)等核心机器学习数学工具,再到连接微积分的梯度与雅可比矩阵。作者强调了掌握这些概念对于理解神经网络、PCA、推荐系统及 LoRA 微调等技术的重要性。
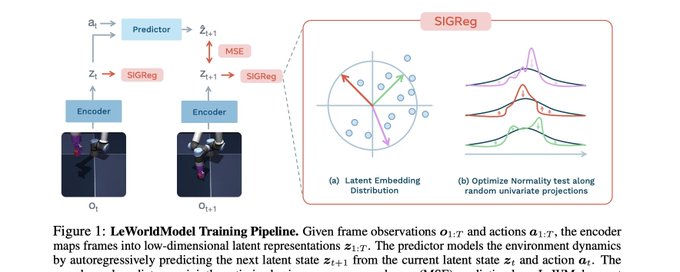
文章介绍了 LeWorldModel (LeWM),一种新的世界模型架构。它解决了当前世界模型(如 DINO-WM 和 PLDM)的局限,仅通过两个损失项(Next-embedding 预测损失和 SIGReg)实现了从原始像素开始的稳定端到端训练。实验表明,LeWM 能在潜在空间中自发涌现出时间直线性和物理约束,有效避免了表示偏差和模型崩塌问题。
文章基于作者在 ByteDance Seed 的研究经历,探讨了 Looped LLM 架构的起源与演进。作者通过分析 Anthropic 发布的 Claude Mythos 在 GraphWalk BFS 基准上的异常表现,指出 Looped 架构在多跳推理和状态追踪上的优势。文章进一步深入讨论了 Looped LLM 在扩展至 10T/100T 规模时面临的深度稳定性、推理效率和 FLOPs 有效性的三大挑战,并对比了 RNN 视角与 Parallel Looped Transformer 等解决方案。