Wiki 知识库

全部文档

8932 篇

Joy & Curiosity #101:Agent 时代的编程语言与框架思考

Thorsten Ball 分享了他对 AI Agent 时代编程语言与框架未来的思考。他认为手写代码时代正在终结,框架不再是最大的生产力杠杆,语法和工具易用性变得不再重要,但共享抽象仍有价值。未来重要的是性能、可观测性、可调试性等对 Agent 透明的特性。语言偏好将从'我喜欢'转向'我的 Agent 能用好'。他还探讨了生态系统的变化、测试框架的命运、静态类型的未来等话题,认为 token 成本下降是最强的技术驱动力。

技术 › LLM Thorsten Ball 2026-09-2619.3 KB 9K 98 70

本地无 GPU 微调实战:基于 HUD 与 Fireworks 训练 API 的 LoRA 强化学习指南

本文解读 Fireworks AI 官方 Training API Cookbook 中一篇实战教程,讲解如何结合 HUD 框架与 Fireworks Serverless Training API,在无本地 GPU 条件下用 GRPO 风格强化学习微调 LoRA 适配器。文章详细拆解了四步工作流程:环境配置、任务校准、单步训练和长跑训练,重点阐释了快照隔离、trace 记录、loss masking、组内优势归一化等核心训练机制。实验结果显示四位数乘法任务准确率从 78.1% 提升至 98.4%,但作者指出收益主要来自输出格式和自我节制的优化,而非深层算术能力的提升。文章还提醒了 checkpoint 语义区分等实操要点,并对教程的严谨设计给予高度评价。

技术 › LLM meng shao 2026-09-2610.7 KB 4.7K 36 86

虚拟卡被拒、代充封号之后,我终于找到了订阅 Claude 最省心的办法

作者分享订阅 Claude 和 ChatGPT 的完整踩坑经验:虚拟卡费用高且常被拒,代充存在封号风险,最终推荐最稳妥的方案——外区 Apple ID + Apple 礼品卡 + App 内订阅。文章详细讲解了美区/台区选择、注册或改区外区 Apple ID 的步骤、外区号绝不能登录 iCloud 的重要警告、礼品卡的官方与支付宝购买渠道、App 内订阅流程、关闭自动续费的建议,以及遇到“无法完成购买”时联系苹果客服的排查方法。核心原则是:钱走干净渠道、账号自己注册、按月付手动续、重要内容自行备份。

技术 › 工具与效率 蔚蓝WEILANX 2026-09-2614.3 KB 92.5K 214 86

CUDA from zero to hero #1

这是一篇 CUDA 学习系列的第一篇笔记式文章,作者旨在从零基础带领读者掌握 CUDA 编程。文章首先解释 GPU 存在的原因:CPU 擅长串行计算,而矩阵乘法等 AI 核心操作天然可并行,因此 GPU 拥有大量 ALU 以实现高吞吐并行计算。随后介绍了 CPU 与 GPU 的架构差异,以及 GPU 的关键概念:全局内存(VRAM)、流式多处理器(SM)、块、线程和 32 线程的 warp,并指出全局内存到 SM 的数据传输效率极低。最后讲解了 CUDA 的网格-块-线程层级结构,并通过矩阵乘法示例演示如何编写 CUDA kernel。

技术 › 编程语言 Pramod Goyal 2026-09-2612.5 KB 284.4K 1.4K 68

Agent traces are the new oil(Agent 轨迹是新石油)

文章提出 Agent 轨迹(traces)正成为 AI 公司间的核心交易资产,甚至出现蒸馏攻击等争夺行为。作者指出 RL 训练、长程任务代理普及使 traces 价值激增,但多数企业仍未善用这一资产。文章分析了 traces 对数据厂商、前沿实验室和应用层的价值,以及在运营优化、安全护栏、持续改进三方面的用途。作者还剖析了从 traces 中提取价值的难点:数据非结构化、体量巨大、反馈混乱、长程信用分配困难等,并类比 2010 年代的大数据浪潮,认为 traces 将成为企业专有智能层和战略资产,唯有通过提炼与使用才能释放价值。

技术 › Agent Sam Z Liu 2026-09-268.9 KB 164.1K 405 69

We built a 20x faster Grok bot

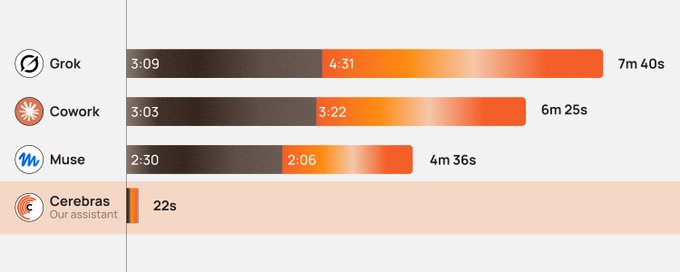
Cerebras 团队测试了主流 AI 个人助理完成订餐任务的表现,发现现有助理耗时过长(如 Grok Bot 需 7 分 40 秒)。团队使用 Qwen 3.8 27B 模型运行在 Cerebras 硬件上,以 Pi 作为 Agent Harness,通过三项优化将任务压缩至 22 秒:1) 并行执行独立的检查操作;2) 借助 Cerebras 快速推理加速模型调用;3) 将探索网站的经验固化为 Skill 复用,减少 80% 以上的工具调用。文章展示了 Harness Engineering、快速推理和经验沉淀对 Agent 效率的巨大提升潜力。
技术 › Agent Cerebras (Sarah Chieng, @0xSero) 2026-09-267.4 KB 685.5K 1.9K 70

How Silicon Valley Knows Its People

文章探讨了硅谷如何通过公开的信任信号与关联网络来识别人才。作者提出,'早期相信'比'非共识'更重要,因为早期背书会成为他人跟进的信号,形成一种对'人'的实时递归式价格发现。Twitter 成为这种关联图谱的核心舞台——关注、回复、播客互访、线下晚宴都是各种形式的'背书'(co-sign)。传统学历、名校等身份标签的作用减弱,公开展示作品成为新的'暖介绍'。在 AI 让产出过剩、注意力稀缺的时代,人的层面(谁相信你、谁注意你)变得更加重要,成功的关键是持续证明潜力并保持上升势头。

其他 › 杂谈 anu 2026-09-2611.3 KB 99.6K 165 73

开源 Company Brain:多玩家 Agent Harness 的架构设计

Supermemory 团队宣布开源其 Company Brain 产品,并详细介绍了背后的多玩家 Agent Harness 设计。该系统构建于 Cloudflare Agents SDK 之上,核心是一个以组织 ID 为键的 Durable Object,负责回合生命周期、状态管理、权限策略、记忆边界和工具调用。文章重点阐述了如何设计一个'像队友而非机器人'的 Agent:包括 Slack 事件的分类路由、基于置信度模型而非二元判断的主动性决策、审批流程、steering 处理、运行时恢复等。作者还解释了停止该产品的原因——团队希望专注于构建世界领先的 Agent 记忆 API。

技术 › Agent Dhravya Shah 2026-09-2627.9 KB 521.5K 1.6K 78

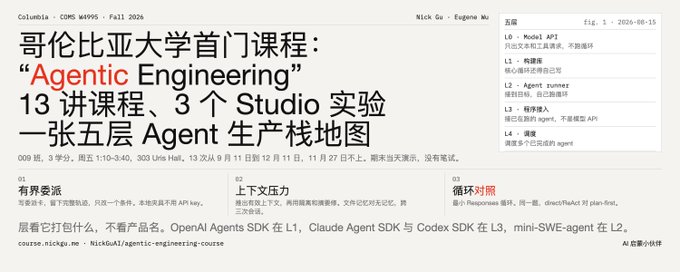
哥伦比亚大学首门 Agentic Engineering 课程解读

文章介绍哥伦比亚大学 2026 秋季首门 Agentic Engineering 课程(COMS W4995-009),其核心立场是:Agent 本质是包裹模型的软件工程(harness),而非模型本身。课程分基础、架构、设计与生产化、期末项目四个模块共 13 讲,配备三个重实践的 Studio 实验:委托与可观测运行、长上下文压力测试与记忆架构、Agent 循环受控对比。文章还解读了课程的五层 Agent 生产栈分类法(L0 模型 API 到 L4 协调系统)与六大学习目标,认为该课将喧闹的 AI Agent 话题还原为可严肃讲授的工程学科,其课程网站和 Studio 设计即使不选课也值得从业者研读。

技术 › Agent meng shao 2026-09-2613.5 KB 13K 133 85

Seedance 2.5 咖啡品牌视频生成示例

文章展示了使用 Seedance 2.5 视频生成模型创建咖啡品牌商业视频的案例。作者提供了一个详细的英文提示词,描述了从研磨咖啡豆、浓缩咖啡萃取、拉花,到多样生活方式场景(咖啡馆办公、街头滑板、户外早餐、欧式城市漫步)的完整画面。视频呈现暖色调、现代都市美学和高质感商业广告风格,展示了 AI 视频生成在品牌营销内容创作中的应用潜力。

技术 › TTS lumiAI (@aiwithlumi) 2026-09-26947 B 35

我是如何使用 AI 创作长视频脚本的?

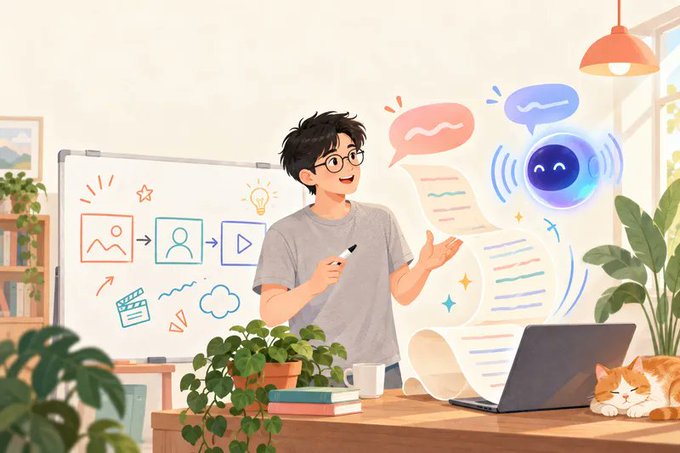
作者分享了一套用 AI 创作长视频脚本的四步工作流,核心理念是'别让 AI 写,跟 AI 聊'。第一步在 YouMind 建项目,倒出观点和收集素材;第二步站在白板前用 Codex 语音对话共创'钩子—论证—升华'三段式大纲;第三步通过 Codex 实时语音把逐字稿'聊'出来,保证口语化;第四步用 YouMind 文字转语音倍速听稿、边听边改并精准控制时长。这套方法使作者 B 站视频从几千播放提升到期期破万,脚本创作时间从一整天缩短到两三小时。文章强调先把自己的观点喂给 AI,再通过对话输出,成稿才能保留个人风格而非 AI 腔调。

技术 › 工具与效率 Yihui 2026-09-269.9 KB 5.6K 32 81

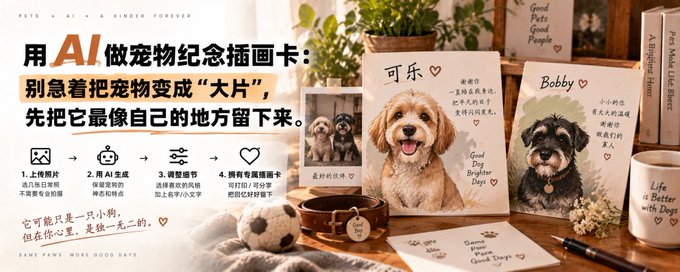
用 AI 做宠物纪念插画卡:先保留宠物最像自己的地方

文章介绍如何用 AI 制作宠物纪念插画卡这一小型数字交付服务。作者强调不要急于把宠物照片变成“大片”,而应保留歪耳朵、斑点等最易识别的特征。建议新手从单只宠物、单一画风的基础款做起,定价 19.9 元测试市场。核心流程包括:先写特征卡再让 AI 绘图、一次出 4 张预览择优、人工核对眼睛耳朵等细节、用 Canva 完成排版并手动输入文字、分四步交付(低清确认、限制修改、导出多版本文件、交付说明)。最后建议先用自己的宠物做样品,通过前 5 单记录数据沉淀为固定流程,实现稳定交付。

技术 › 工具与效率 Christal.Z 2026-09-265.2 KB 9K 42 83

Muse 新手终极保姆级教程,一次学会全部概念与使用方法

本文是 Meta 于 2026 年 9 月发布的个人 AI 代理 Muse 的新手教程。作者梳理了 Muse 的核心概念:底层模型 Muse Spark、默认形象 Jolly、云端虚拟机 Muse Secure VM 及安全审批层 Sentinel。文章涵盖注册候补入口、地区开放情况、年龄验证、各平台支持(网页、iOS、Mac、WhatsApp、眼镜)、首次使用五步法、邀请码兑换规则,以及找联系人、账单谈判等真实案例,并强调小白应先只连邮箱和日历、谨慎开放权限。

技术 › Agent 超级峰 2026-09-2616.8 KB 18K 38 79

当我开始思考,让波普艺术尝试去做减法

作者分享了一套用于生成「当代极简波普艺术」图像的提示词。该风格继承了波普艺术对大众文化符号的重新编码(放大、重复、裁切、错位),同时用极简主义做减法:一个概念、一个主体、少量颜色、大胆留白。提示词详细规定了视觉隐喻的构建、非对称构图、2-4色色板、文字作为视觉元素参与版式、材质控制,以及针对小红书封面、公众号、推特、海报、专辑封面等不同场景的适配策略,并附有生成前自检清单与最终设计原则。

技术 › 工具与效率 Lucidity 2026-09-2618.0 KB 3.4K 37 78

斯坦福机器人学免费课程:6个月成为机器人学习工程师的学习路径

作者整理了一份利用斯坦福免费公开课程资源、历时6个月成为机器人学习工程师的自学路径。斯坦福将大量机器人学课程发布在YouTube上,讲师包括NVIDIA自动驾驶研究高级总监、Physical Intelligence联合创始人及Tesla Optimus AI负责人。该路径包含7门课程共119讲、约95小时视频、2本免费教材、6个可在家用笔记本上完成的练习项目,以及可选的122美元机械臂。学习顺序遵循斯坦福正式课程体系:先数学基础(线性代数),再机器人物理结构、感知、规划,最后是学习方法,避免了自学时无序观看导致的低效问题。

技术 › 编程语言 Martin 2026-09-2633.6 KB 190.3K 650 82

Using Claude Code: Spending your effort

本文深入探讨了 Claude 模型中 effort(努力程度)参数的作用与使用策略。作者通过实验和 Terminal Bench 3.0 基准测试分析发现:effort 本质上是控制模型在任务上投入的算力与自主判断程度。高 effort 在验证和边界测试重要的场景(如硬件、代码审查、安全)表现更佳;低/中 effort 则适合快速迭代、保持人类在环。作者还比较了不同规格化程度任务在各级 effort 下的输出差异,并总结出一套高效工作流:先让模型访谈自己补全规格,用低 effort 实现,人工审查后,再用高 effort 做验证和测试。

技术 › Claude Thariq 2026-09-2612.5 KB 1.5M 6.2K 83

小红书矩阵获客指南-让你的活动或课程爆满

作者分享通过小红书为线下AI分享活动获客的实战经验。包括:失败的薯条投放教训;向专业获客者请教后的方法论:选择周一早上、周三中午、周六中午等流量高峰发布;笔记不放二维码和价格、标注上海相关话题和定位;用小号引流到微信私域;用5个账号矩阵发布相同内容占领搜索流量;以及100粉即可开通个人售卖功能挂小黄车变现。最终活动爆满,方法均为亲身实践总结。

其他 › 运营推广 Serena 木瓜 2026-09-269.4 KB 338.9K 1.1K 76

「闪电.skill」发布!Anthropic两周提速3倍的方法,拿来给自己用

作者介绍Anthropic用两周时间将claude.ai核心体验提速3倍的方法论:先量化指标、用指令数稳定测量、设置棘轮防止性能回退,并在150多个并行线程中由Claude找问题、人做取舍。作者照此方法让agent优化自己的4个网站并整理成「闪电.skill」,其中公众号排版器打开到能打字的耗时从2238毫秒降至209毫秒,减少90.7%。文章还分享了优化过程中的踩坑经验,如旧草稿覆盖风险、测量干扰等,并提供skill的安装方式供读者使用。

技术 › Skill 花叔 2026-09-269.1 KB 50K 84 88

2026 年最全免费 AI 资源盘点

作者花费 20 天实测了各类免费或近免费的 AI 模型获取渠道,包括免费 API、促销额度、创始人和学生计划、开源维护者资助等。文章指出多数“免费 AI”汇总信息过时且不准确,并从三个维度评估:永久配额与限时额度的区别、实验用途与生产用途的区别、以及隐藏的数据隐私代价。详细分析了 Google AI Studio、Groq、Cerebras、Mistral、Cloudflare Workers AI、OpenRouter、Cohere、OpenAI 等平台的免费额度与限制,还涵盖初创企业资助、学生福利、开源维护者计划以及地理限制,最后强调本地部署模型是唯一不可撤销的保底方案。

技术 › LLM Innopro 2026-09-2610.8 KB 381.6K 156 85

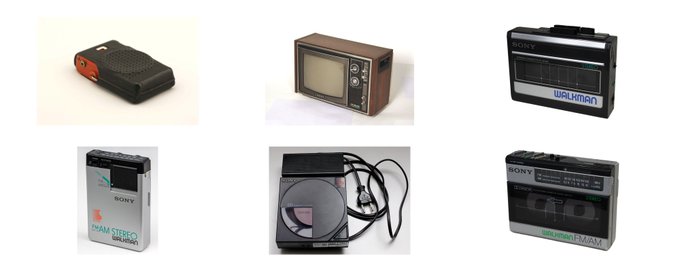
索尼为什么能做出 Walkman?|AI 时代重看 SONY(上)

文章回顾索尼从 1946 年创立到 1979 年推出 Walkman 的历程,指出 Walkman 并非天才式发明,而是磁带、便携录音机、轻量耳机等既有技术的组合与取舍:删去录音功能、明确“随身听音乐”的使用场景。文章还原了 Walkman 上市初期遇冷、靠街头体验和广告扭转局面的过程,并梳理索尼后续在 Discman、Handycam、PlayStation、VAIO、AIBO、α7 等产品中延续的产品判断。作者借此反思 AI 时代的启示:技术是底子,真正稀缺的是判断哪些东西能进入人的生活的能力。

其他 › 商业案例 Jaden 抽象日志 2026-09-2619.5 KB 10.5K 17 73

AI 都快把大学教育打成夕阳产业了:31 岁读完 12 个顶级学位的 Jamie Beaton

文章讲述了 Jamie Beaton 的故事:31 岁已获得哈佛、斯坦福、牛津、清华等 12 个顶级大学学位,同时创立并经营估值超 6 亿美元的教育公司 Crimson Education。作者借此探讨 AI 时代大学教育的价值变迁:知识因 AI 变得越来越便宜,但名校的文凭、筛选机制和圈层认证反而更贵。Jamie 把学校当作基础设施,看重的是教授、同学、研究环境和跨学科训练,而非单纯的知识获取,揭示了教育与认证的分离趋势。

其他 › 杂谈 sleepy.md (@sleepy0x13) 2026-09-263.7 KB 69

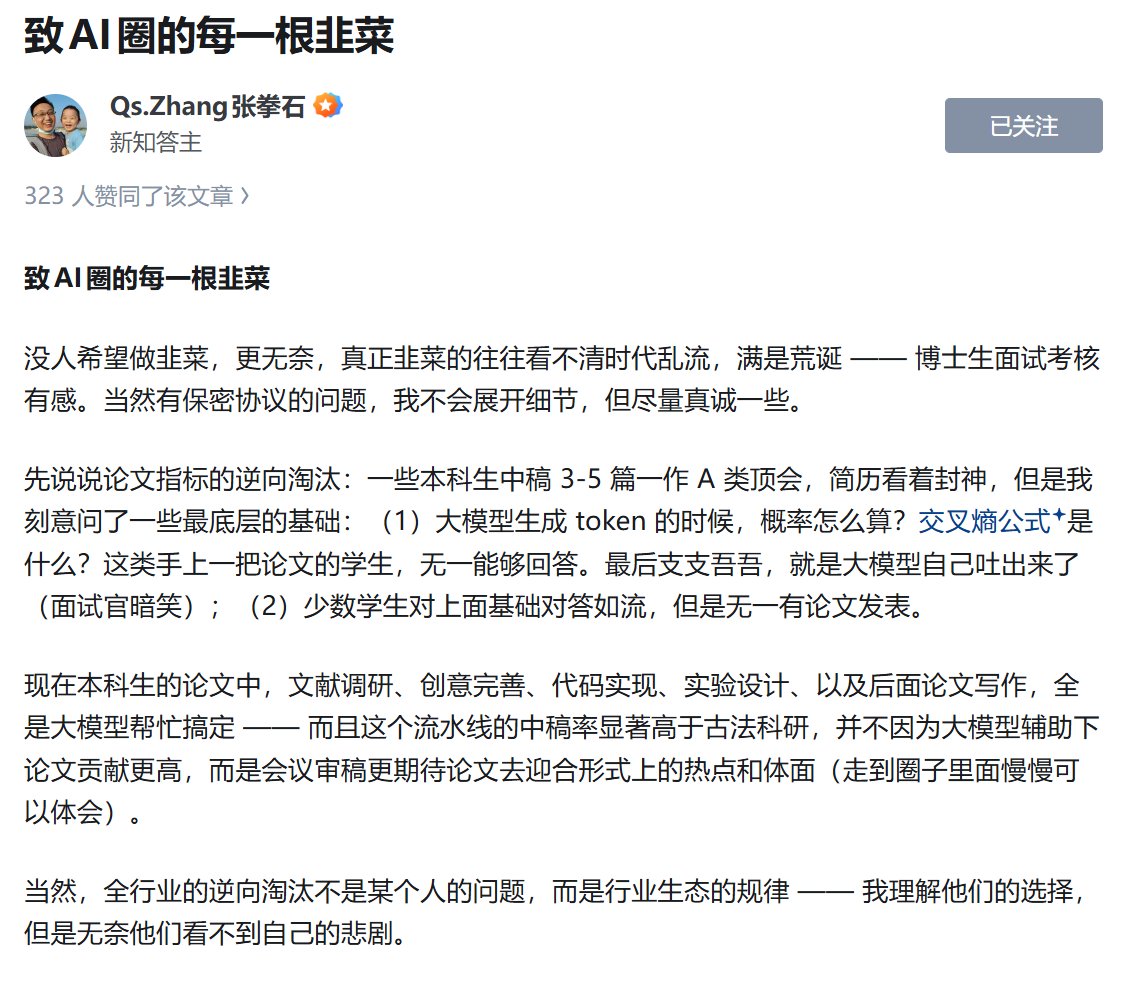
读张拳石《致 AI 圈的每一根韭菜》有感

作者分享张拳石老师《致 AI 圈的每一根韭菜》一文的读后感。文章指出一些本科生虽有3-5篇顶会论文,却答不上大模型生成token概率、交叉熵等基础问题,因为文献调研、代码、写作等环节都可由大模型代劳。论文越来越容易生产,数量加速贬值,真正难替代的是底层理解、问题判断与研究动机。作者结合读博经历感慨:读博需五六年,而AI研究范式一年数变,追热点风险极高。文章适合做AI研究和准备读博的人阅读,促使思考:当写论文变容易后,如何判断研究者真正的能力。

技术 › LLM Xudong Han 2026-09-261.5 KB 51

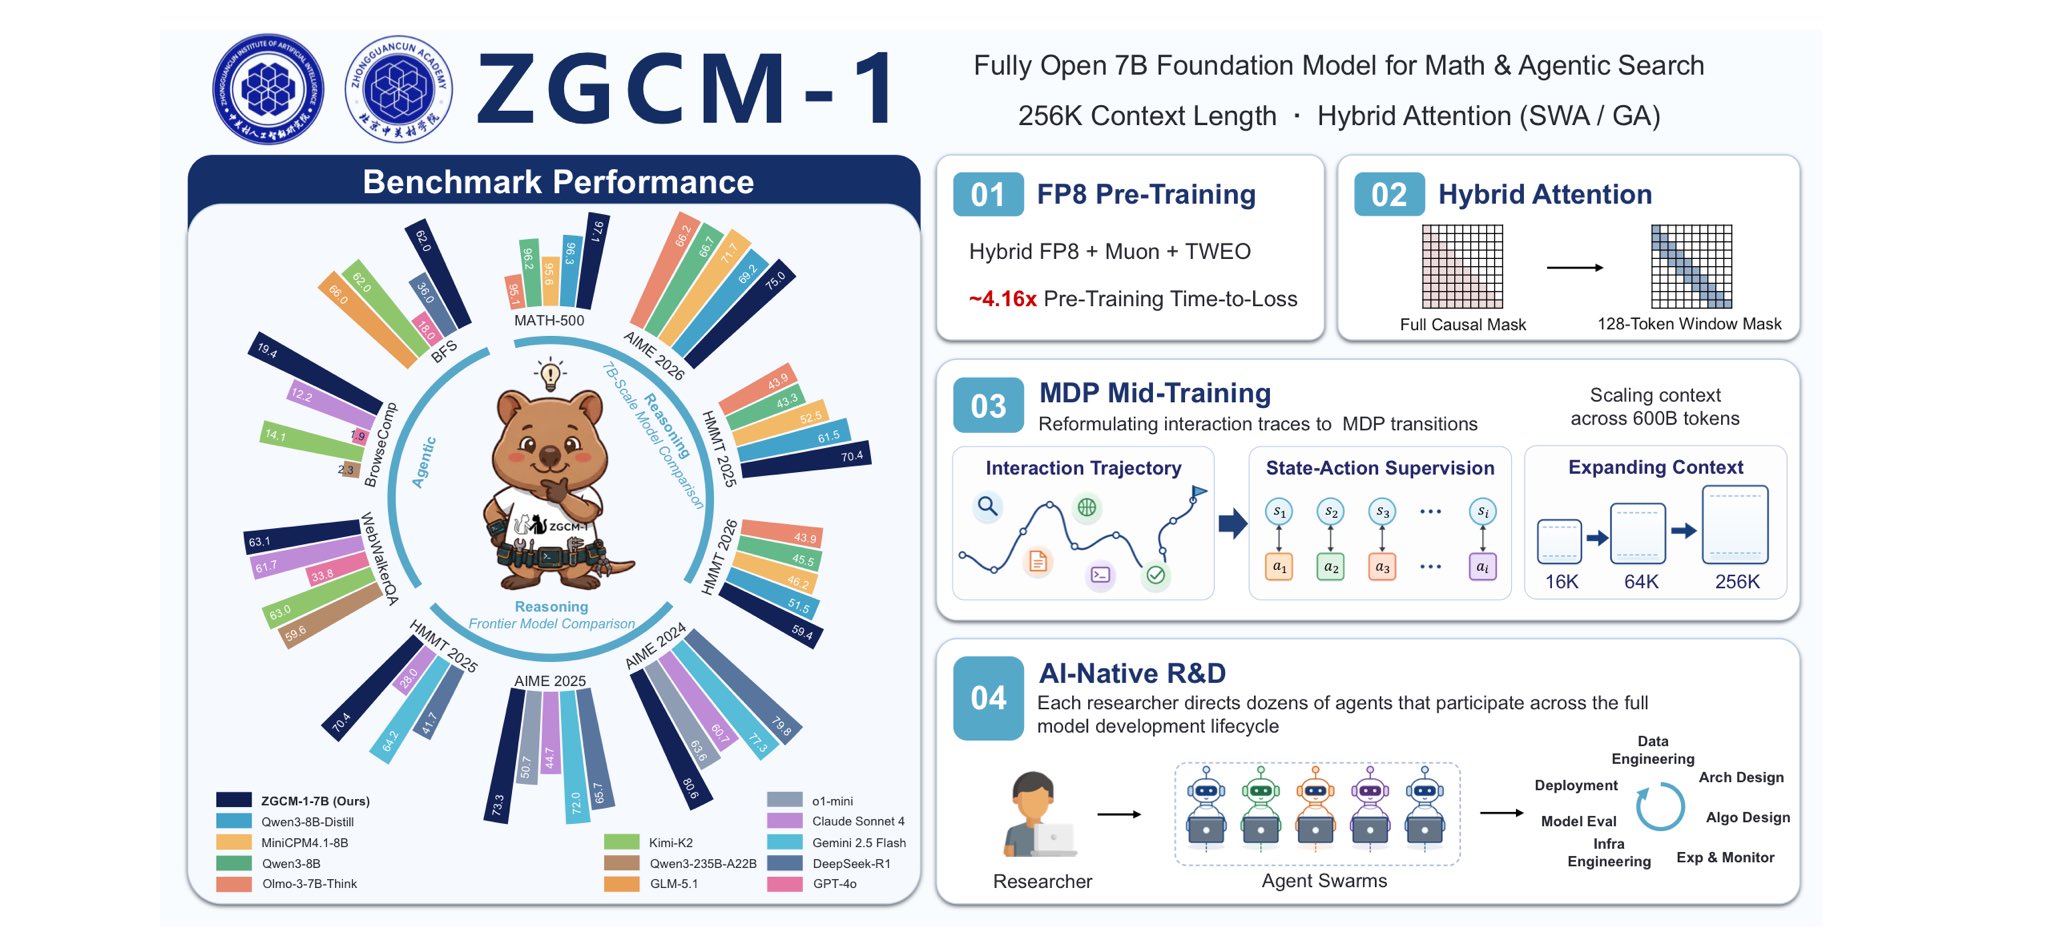
中关村学院 3 个月从零训练 7B SOTA 模型的启示

作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。

技术 › LLM Bojie Li (@bojie_li) 2026-09-262.6 KB 63

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

Muse 终极玩法:全自动撸 Claude 账号完整教程

本文是 Meta 新发布的个人 AI Agent「Muse」的新手实操教程,演示如何让 Muse 全自动完成 Claude 账号注册。作者介绍了 Muse 的能力(自带文件系统、终端和浏览器,可自主浏览网页、填表提交、生成文档、后台多任务处理),并详细讲解四步流程:登录 Muse、一句话下任务、回答它提出的问题(邮箱、验证码、人机验证、套餐选择等)、最后验证注册成功。文中还包含常见问题解答、升级 Pro/Max 的充值方法,以及账号安全提醒,强调不要批量注册以免触发风控。

技术 › Agent Lonely 2026-09-2612.3 KB 1.6M 1.5K 68

Coding is dead, long live Coding

作者以个人编程经历为引,回应对 AI 导致编程手艺消亡的哀悼。引用 Thorsten Ball 的观点:手写代码的工艺将像意大利手工鞋匠一样成为小众。作者认为编程虽'死',却以模型权重、框架和语言的形式延续。作为自学成才的程序员,他乐观地认为 AI 编程是新的开始——新一代程序员用自然语言表达意图,能更快、更高质量地构建产品。过去受限于个人能力,如今可以通过正确的提示词和上下文驱动 Agent 实现心中构想。作者对更多人体验创造的乐趣充满期待。

技术 › LLM lauren 2026-09-263.9 KB 174.2K 2.6K 45

美业这样用WorkBuddy就对了

作者马佳彬分享WorkBuddy这款AI Agent工具在美业的落地应用方法,针对美业获客转向内容和信任的趋势,选取四个高频场景:活动方案与门店SOP、营销文案批量产出与广告法合规审查、会员话术库沉淀、巡检与合规记录归档。每个场景给出痛点分析、提示词模板、推荐Skill及小工具开发方法,并强调AI产出需人工复核,结合自身需求独立判断,才能真正落地。

技术 › Agent 马佳彬 2026-09-2618.0 KB 4.5K 48 77

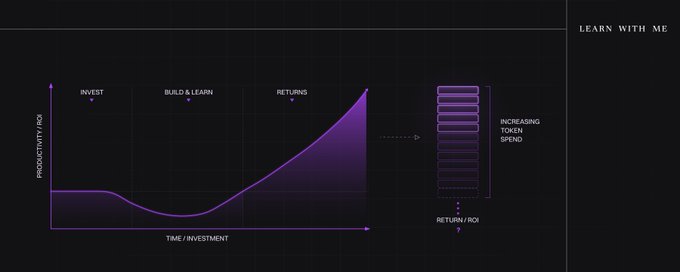
为什么 AI 繁荣但生产力却没有提升

Chamath 探讨了 AI 投资回报率(ROI)难以在生产力数据中体现的原因。AI 成本极低——企业中位数每月每位员工仅花费 12.50 美元,只需提升约 0.15% 的效率即可回本。但价值端难以衡量:企业员工大部分时间花在协调、会议和流程审批上,而非产出工作,人成为 AI ROI 的瓶颈。2026 年一项 515 家初创公司的实验显示,几乎所有收益都来自最顶尖的 10% 企业——关键在于围绕 AI 重组工作流程,而非工具本身。作者引用 Solow 的生产力悖论和 Musk 的五步自动化流程,指出企业应先简化流程再自动化,生产力提升将取决于大企业采纳的速度。

技术 › LLM Chamath Palihapitiya 2026-09-265.1 KB 812.4K 2.2K 78

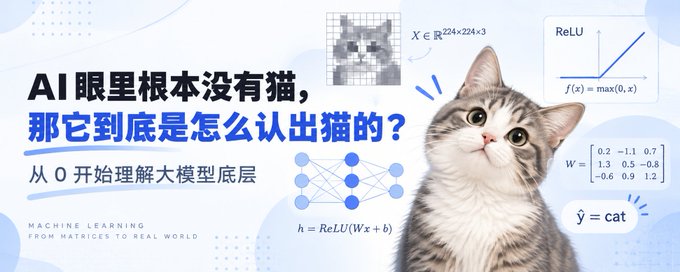
AI 眼里根本没有猫,那它到底是怎么认出猫的?|从 0 开始理解大模型底层

本文从最简单的线性模型 y=wx+b 出发,逐步拆解神经网络识别图片的原理。作者解释了为何单层线性计算表达能力不足,堆叠多层也仍会退化为一次线性变换,因此需要 ReLU 等激活函数引入非线性。随后说明图像如何从原始像素经多层计算被加工成适合任务的内部表示,并澄清了'第一层看线条、第二层看耳朵'的常见误解。文章还介绍了万能逼近定理的含义与局限、CNN 与 Transformer 的关系,以及模型为何是黑箱与机制可解释性,最后引出过拟合问题,为下一篇泛化主题做铺垫。

技术 › LLM joy 2026-09-2614.8 KB 6.5K 18 63

在安全边界内运行私有本地 AI 的四种架构

文章指出企业 AI 部署并非只有'公有 API 或自建推理平台'的二选一,私有 AI 实际是一个从客户端设备到完全物理隔离的连续谱系。作者提出四种隔离层级:1) 使用 LiteRT、Gemini Nano 等在移动 NPU 和浏览器上进行零外泄客户端推理;2) 通过 Confidential Computing(机密虚拟机与 NVIDIA H100 TEE)对云端 CPU/GPU 内存硬件级加密;3) 在私有 VPC 内用 GKE + vLLM/JetStream 自托管开源模型权重,实现权重与日志的完全掌控;4) 使用 Google Distributed Cloud Air-Gapped 为主权工作负载提供物理断网部署。工程关键在于按威胁模型和延迟预算匹配硬件边界。

技术 › 网络安全 Sergio Villani 2026-09-2612.8 KB 30.4K 208 84