Wiki 知识库

技术 / LLM

1283 篇
清除

How to train your own Jev for $17

本文介绍如何以约17美元的成本微调一个类似Jev的高效分类模型。作者基于Qwen3.5 4B,从MultiNLI、BoolQ、Banking77、AG News、SST-5等多个Hugging Face数据集中采样约3.8万个样本,通过脚本归一化数据后,使用Together AI的Fine-tuning服务启动训练任务(约25分钟完成),再将模型部署到Together AI的专用端点(dedicated endpoint),并通过API查询模型完成分类任务。文中还发布了可直接使用的together/Tev1-4B-experimental模型,适用于客服意图识别、文本情感分析、论文分类等实际场景,涵盖从环境搭建、数据准备、训练到部署查询的完整流程。

技术 › LLM Hassan 2026-09-2412.4 KB 822.4K 2K 76

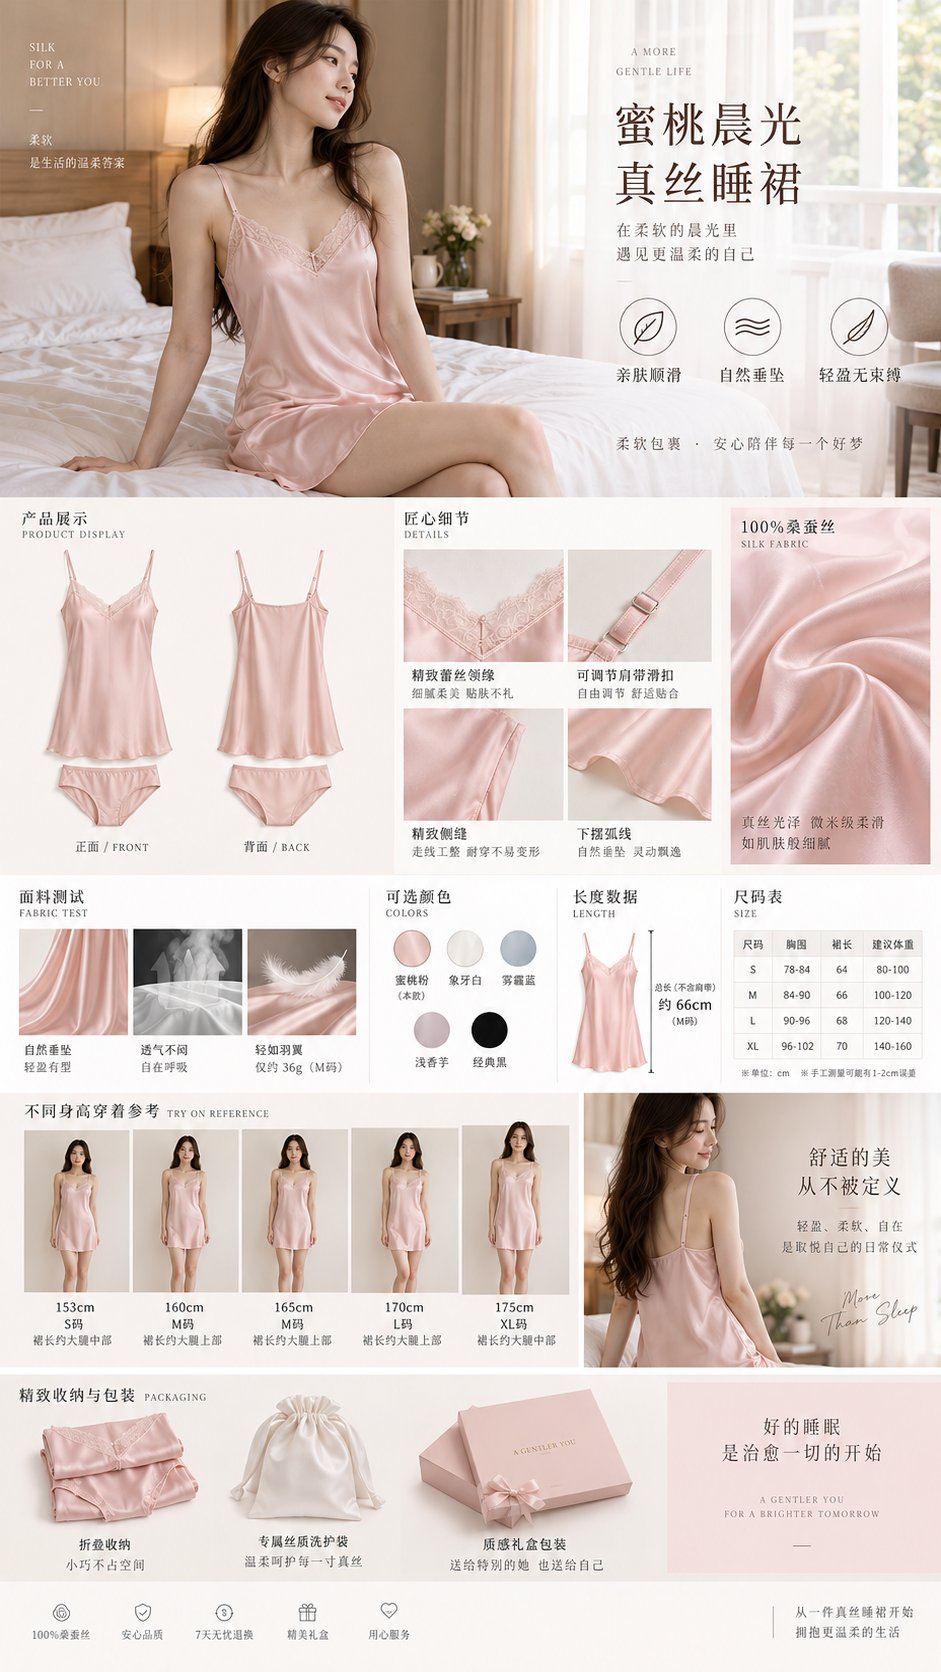
蜜桃粉真丝睡裙电商详情页 GPT Image 提示词

文章分享了一个使用 GPT Image 2.5 生成电商详情页图片的提示词案例。内容为生成一张 9:16 竖版的蜜桃粉真丝睡裙电商详情页,模拟高级生活方式品牌的移动端页面。提示词详细描述了产品细节(柔粉真丝吊带睡裙、蕾丝领缘、可调节肩带)、场景设定(私人酒店卧室)、首屏标题与卖点文案,以及中段的商品平铺展示、面料微距、尺码表等内容,并明确规避诱惑姿势、透视走光等风险点,展示了 AI 图像生成在电商设计中的应用。
技术 › LLM Mr.pinecone 2026-09-241.5 KB 59

AI一句话生成知识讲解视频:知识博主的末日?

作者用 Opus 5.5 一句话生成了一个讲解 password 与 passkey 区别的 4 分钟互动讲解视频,包括配音(edge-tts)、字幕、封面图等,质量高于一般人类知识博主水平。作者感叹AI不仅完成视频制作,还主动铺好后续改版、竖屏适配等路径,认为知识讲解类视频博主的生存空间将被颠覆——获取知识的范式正在改变,只有亲身经历类内容尚有竞争力。

技术 › LLM Tz (@Tz_2022) 2026-09-243.4 KB 47

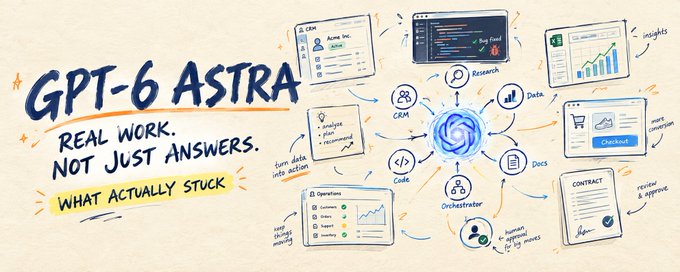
我用两周时间将真实工作交给 GPT-6 Astra,结果令人惊艳

作者用两周时间在编程、销售、财务、客服、法务和电商等场景中实测 GPT-6 Astra。核心发现:传统自动化在可预测输入下仍最优,而 Astra 适合需要判断力的“混乱中间地带”;它能操作从未见过的软件界面(如 CRM、后台系统);作为编码 Agent 可定位并修复真实 bug 并补测试;能端到端完成销售准备、竞品分析和财务数据处理等完整工作流。作者建议拆分成多个窄领域 Agent 使用,并从现有工作流出发而非凭空构建场景。

技术 › LLM wluha 2026-09-2314.8 KB 227.6K 25 74

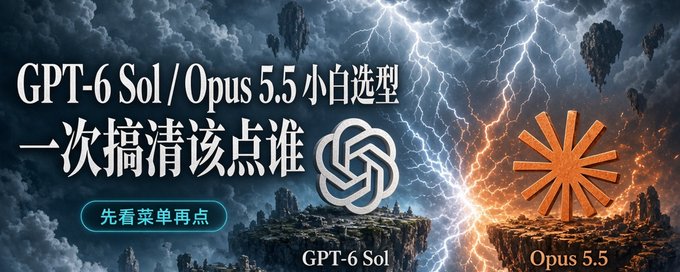
GPT-6 Sol / Opus 5.5 小白选型指南

GPT-6 Sol 与 Claude Opus 5.5 同日发布,本文面向小白用户,梳理两大模型家族的定位与选择方法。文章介绍了各订阅档位能使用哪些模型、正确的模型入口(ChatGPT Work/Codex 与 Claude 模型菜单),并列出价格量级。核心建议是按场景选模型:总结抽取用 Luna,写代码日常活用 Sol,做页面和成品交付优先 Opus 5.5,最难任务再上 Astra 或 Fable。作者强调档位比模型名更影响费用,建议从 Medium 档起步,并给出第一天上手的三个步骤和常见问题排查方法。

技术 › LLM 超级峰 2026-09-238.8 KB 5.7K 12 77

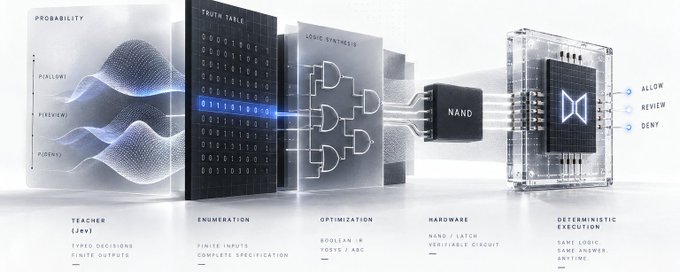
概率怎样变成机器|TapeOut x Jev 系列研究 ver 2.

本文探讨如何将概率决策转化为可验证的硬件电路。核心论点:当决策面可被完整枚举为有限输入输出时,应优先将函数表直接综合成逻辑电路,而非先训练学生模型。文章区分了真值表综合与 DiffLogic/LGN 近似蒸馏两条路线,分析了离散化落差、argmax 造成的概率语义损失、概率 codebook 设计,以及从硬门网络到 NAND 网表的完整编译链(Canonical Boolean IR、Yosys、ABC 等价验证)。通过 LoomEscape-16 案例展示了精确综合的纪律性优势,并指出五种失败条件:输入映射、教师保真、概率校准、实现等价与状态语义。

技术 › LLM BruceBlue 2026-09-2316.6 KB 2K 15 81

中秋国庆重磅福利:GPT Image 2.5 全档位半价正式开启

HiAPI 宣布中秋国庆促销活动,GPT Image 2.5 全档位半价,涵盖 Flare、Sunburst 的文生图和图生图服务。活动价格:1K 图片从 $0.05 降至 $0.025/张,2K 从 $0.08 降至 $0.04/张,4K 从 $0.12 降至 $0.06/张。100 张 1K 图片仅需 $2.50,生成数量翻倍。所有档位半价,API 和网页 Playground 均可享受,自动应用优惠,无需领券或优惠码,适用于海报制作、产品配图、内容素材及 AI 应用接入。活动自即日起至 10 月 8 日(北京时间)结束。

技术 › LLM HiAPI (@hiapi_ai) 2026-09-231.4 KB 38

刚刚 Opus 5.5 和 GPT-6 Sol 同时发布,首发实测来啦!结果让我很意外

Anthropic 与 OpenAI 同日分别发布 Claude Opus 5.5 和 GPT-6 Sol。作者通过 5 个实测案例对两大模型进行对比评测:SVG 画熊猫骑车、300 字科普写作、3D 重庆城市生成器、操作电脑画 Q 版鲸鱼娘、复刻 Cursor 工具。结果显示,Opus 5.5 在智能程度、生成质量和细节刻画上全面领先,尤其在 3D 城市生成和复刻 Cursor 任务中表现惊艳,而 GPT-6 Sol 虽然速度快一倍、价格减半,但完成度明显逊色。

技术 › LLM 程序员鱼皮 2026-09-2320.7 KB 14.4K 24 68

当AI模型开始拼每项工作的成本:OpenAI 和 Anthropic 新模型同日降价对比

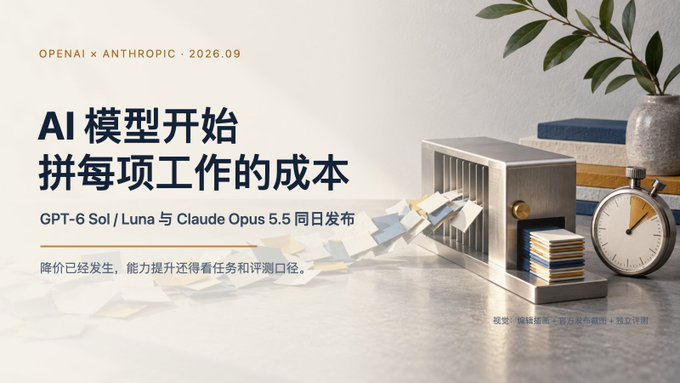
2026年9月23日,Anthropic发布Claude Opus 5.5,OpenAI随后推出GPT-6 Sol和Luna,三家新模型共同卖点是降价:Opus 5.5单价降20%,Sol和Luna较前代降约50%。文章结合Artificial Analysis独立评测指出,标价之外,实际成本还受输出token数、缓存、effort和重试影响,三款模型能力分属不同档位,不能直接对比。作者建议以固定材料、工具链和验收标准的真实任务实测交付质量与单任务成本,用通过验收的单任务成本作为选型指标。文章还讨论了Dario Amodei《We Must Pace the Frontier》放缓主张与Opus 5.5发布是否矛盾的问题。

技术 › LLM 造物有心 2026-09-239.1 KB 2.5K 15 80

AI Evals 课程沉淀的 8 个 Skills:错误分析 → 评测器 → 校准 → 监控

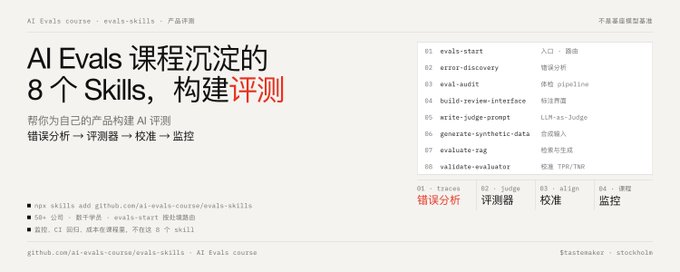
文章介绍了来自 Hamel Husain 和 Shreya 的 AI Evals 课程沉淀的 8 个 Skills,帮助工程师和产品经理为自己的 AI 产品构建评测体系。核心理念是先看数据再写评测:先手动阅读真实 trace 做错误分析,发现失败模式,再针对每个模式构建评测器,并用约 100 条人工标注校准(TPR/TNR 目标 >90%)。8 个 Skills 覆盖入口路由、错误分析、评测审计、合成数据生成、Judge 提示词编写、评测器校准、RAG 评测和标注界面构建。方法论强调二值评判、单一 judge 测单一失败模式、Rogan-Gladen 偏差修正等最佳实践。

技术 › LLM meng shao 2026-09-238.6 KB 13.9K 66 85

AI写公众号和头条号文章出现低创作和不良信息的真实原因分析和解决方案

文章分析了2026年9月平台清理561万条违规AI内容、加强审核的背景下,公众号和头条号内容被判定低创作的原因:开头宽泛无信息增量、结构模板化、观点缺乏独特辨识度。作者提出解决方案:一是人工检查前置,边写边查信息密度和内容辨识度,重点审核开头和转折处;二是使用content-any等工具进行同质化、AI率、标题、敏感词的全维度检测;三是注意时效性,选题和数据要保持7天内的新鲜度。被限流后应清理问题文章、准备高质量选题、持续申诉。文章强调工具只能提高效率,无法替代人的信息增量贡献和独立观点判断。

技术 › LLM 熊叔的茅草屋 2026-09-234.5 KB 11.4K 80 64

BestBlogs 早报 · 09-23|Claude Opus 5.5 发布,MiMo-V2 扩展强化学习,美团分享统一推荐基座大模型实践

本期早报精讲三条内容:Anthropic 发布 Claude Opus 5.5,能力接近上代旗舰而成本下降 40%,并强化行动控制与可审计机制;小米发布 MiMo V2.6,通过更大的 Batch、全异步架构和可验证任务环境扩展强化学习,并开源训练框架与轻量 Harness;美团分享 MTFM 统一推荐基座在外卖多业务场景的落地,通过异构 Tokenizer 与混合注意力实现跨业务统一建模,订单量提升 2.06%-6.68%。速览涵盖腾讯工程师转型大模型推理、AI 产品评估实践、Agent Harness Skill Engineering、去哪儿网 AI Coding 重构、千问办公企业上下文、算力芯片趋势及 OpenAI 第三方评估原则。

技术 › LLM ginobefun 2026-09-2322.4 KB 2.9K 3 83

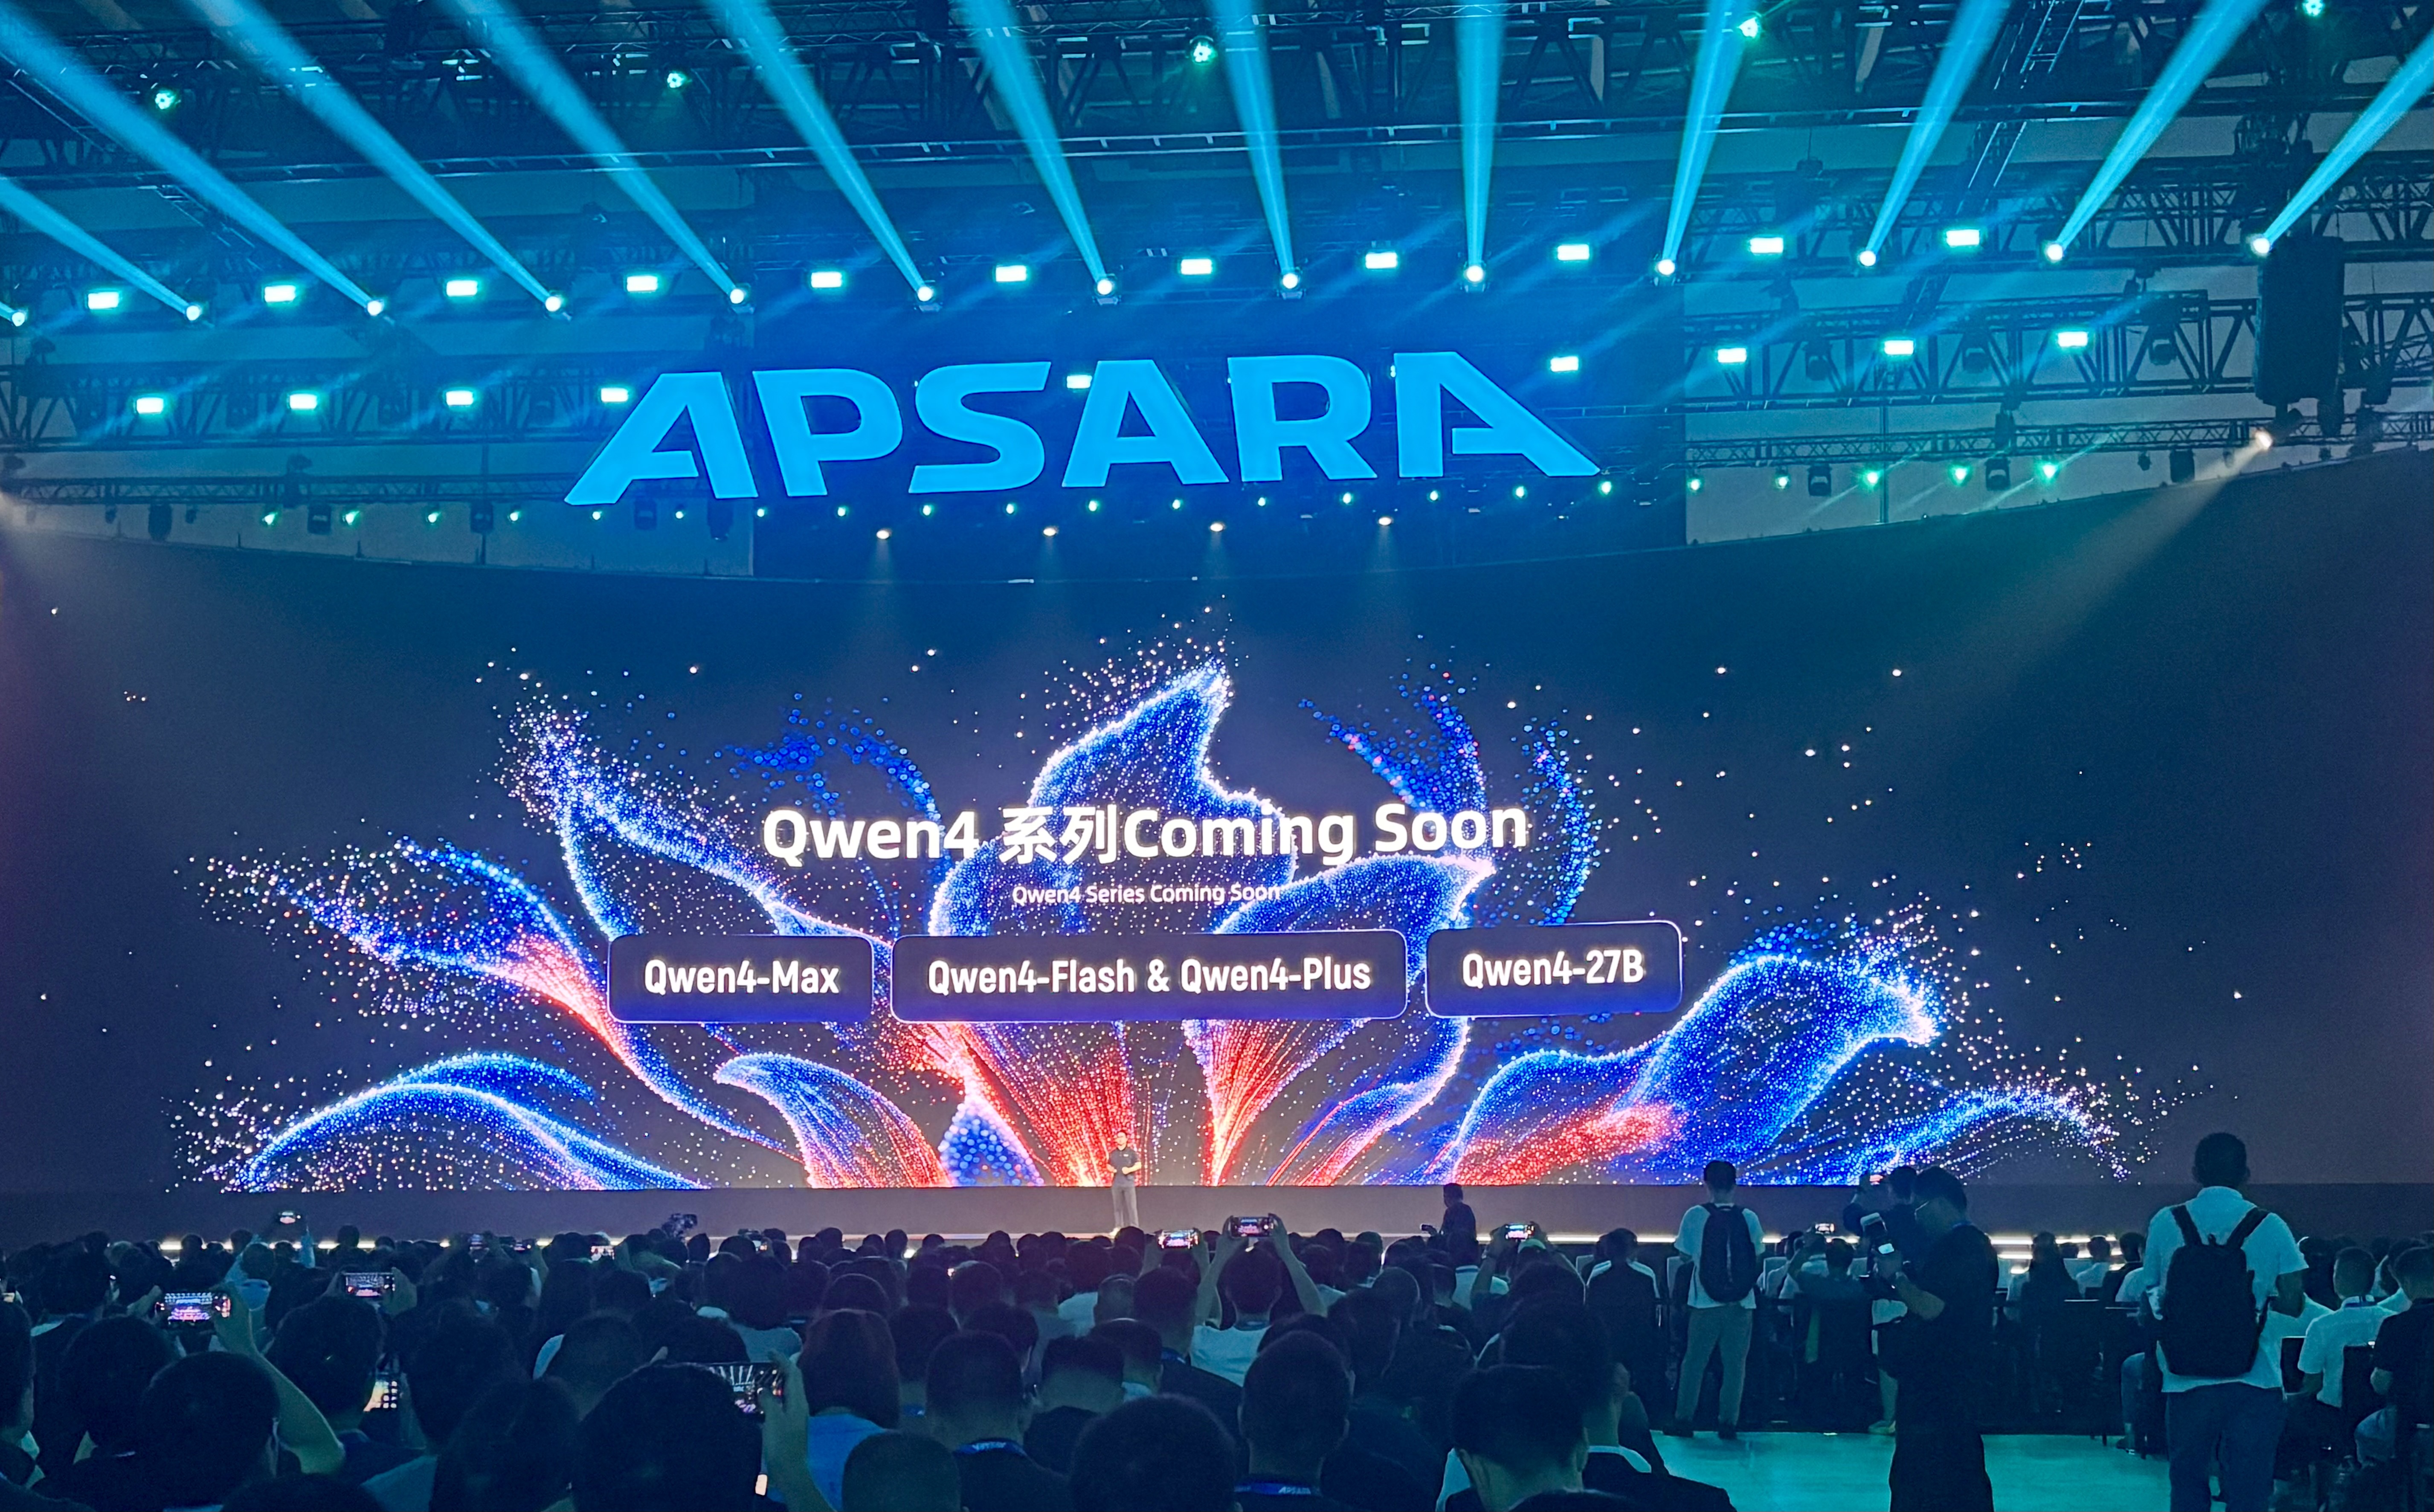
Qwen 发布会观察:从模型训练到芯片协同的完整研发体系正在形成

作者总结了 Qwen 发布会的重点:除了新模型外,更值得关注的是 Qwen 形成了从模型训练、推理优化到芯片协同的完整研发体系。核心亮点是 RSI 递归自我进化,Qwen3.8-Max 在少人工干预下连续运行一个多月完成 33 轮迭代,包括自主优化 SGLang 提升 96% 吞吐、芯片设计中减少 42% 物理实现面积。Qwen3.8-Omni-Flash 统一多模态理解框架支持 1M 上下文,价格大幅下降约九成。Qwen4 已开始训练,未来参数量将扩展到 5 万亿至 10 万亿。开源生态方面,累计下载超 30 亿次,衍生模型超 30 万个。

技术 › LLM Ding (@dingyi) 2026-09-233.0 KB 63

实测 GPT6 Sol 和 Luna 和 Claude Opus 5.5,我们再不用愁额度少和速度慢了

作者对 GPT-6 Sol、GPT-6 Luna 和 Claude Opus 5.5 三款新模型进行横向实测。价格方面,GPT-6 系列比 GPT5.6 便宜 50%,Opus 5.5 速度提升 30%、成本降低 40%。通过鹈鹕骑单车、可互动饺子网页、前端动效设计、写作 skill 生成、Blender 3D 建模复现舞蹈等多个案例对比,作者发现 Opus 5.5 在终端编程和前端能力上依然领先,细节表现惊艳;GPT-6 Sol 速度极快且能力不俗;Luna 则适合简单批量 Agent 任务。总体来看三款新模型在性能与成本上均有显著进步。

技术 › LLM 卡尔的AI沃茨 2026-09-2311.6 KB 53.5K 91 73

Jev AI 发布 168 小时:操作系统换了物种

作者回顾了自 1979 年以来的专家系统开发经历,介绍 TypeSafe AI 于 2026 年 9 月 15 日发布的首个公开 System One 模型 Jev。Jev 由前 OpenAI 研究员 Diogo Almeida 创立的公司打造,获 4000 万美元种子轮融资。与聊天型 LLM 不同,Jev 是“反聊天机器人”:它接收状态和类型化问题,在 70-500 毫秒内返回概率、置信度的决策结果,输出仅有 Choice、Score、Noul 三种原语。其训练方法为面向校准决策的强化学习(RLCD)而非 RLHF。作者认为 Jev 代表下一代操作系统形态,是将可靠的机器决策嵌入软件内核的缺失原语。

技术 › LLM Brian Roemmele 2026-09-2322.7 KB 119.9K 388 78

国产模型年底跑不到 3T 模型就可能出局

文章梳理了曾鸣对颠覆性技术演化的三段论:AI 先成为通用基础设施,再催生海量新应用,最终诞生原生级现象级应用。2025 年 Token 成为 AI 时代共识度量衡,标志基础设施成熟;Open Claw 爆火开启 Agent 第二阶段;Agentic OS 属第三阶段,还需三五年。作者认为大模型公司本质是 AI 云公司,未来两年核心机会是打造 Agent 入口级产品,OpenAI 和 Anthropic 未必成为 AI 原生应用大赢家。另附曾鸣的公司四层分类:机会、战略、远见、使命驱动,强调使命须发自内心,外部认可驱动易受估值波动冲击。

技术 › LLM 向 向阳乔木 (@vista8) 2026-09-232.2 KB 53

一夜三连发,Claude Opus 5.5、GPT-6 Sol和Luna全部都来了

Anthropic与OpenAI同日发布多款新模型:Claude Opus 5.5、GPT-6 Sol和Luna。作者详细评测了各模型的定位与表现:Opus 5.5作为Claude系列性价比模型,Coding能力达到SOTA,成本下降40%,速度提升30%,但Token消耗大;GPT-6 Sol和Luna主打降本,价格比上代便宜50%甚至低于Deepseek,Token效率出色、幻觉率大幅降低,但审美与细节能力有明显降级。作者指出两家公司差异化路线:Anthropic专注Coding通往AGI,OpenAI专注全面Agent能力,并给出不同场景下的模型选择建议。

技术 › LLM 数字生命卡兹克 2026-09-2316.6 KB 43.1K 126 77

一夜之间!Opus5.5、GPT-6 Sol、GPT-6 Luna全来了

Anthropic发布Claude Opus 5.5,比Opus 5便宜40%、速度快30%,跑分全面超越Fable 5.1,并推出订阅用户一次性的额度reset功能。一个半小时后,OpenAI发布GPT-6 Sol和Luna,大幅降价,Luna价格杀入DeepSeek区间。作者实测对比了Opus 5.5、Opus 5和Fable 5.1在鹈鹕骑单车SVG、Blender建模宋代斗拱、机械蝴蝶等任务上的表现,发现Opus 5.5综合成本省29%-55%,agent能力强,但max档反而不如medium档。文章详细分析了各模型跑分、价格策略和Claude Code更新要点。

技术 › LLM 花叔 2026-09-2322.0 KB 41.5K 45 81

AI 没有智慧,你也不会有了

文章批评'不再读代码、不再写代码'的行业风气。作者指出代码可维护性和好架构难以即时度量,其恶果需要数月甚至数年才显现,而有经验工程师依靠长期实践积累的直觉来嗅出代码异味。AI 因缺乏可度量的奖励信号,无法理解什么是可维护的代码,且从质量低劣的野生代码中学习模式,在简化代码、定义可复用函数上表现糟糕。更危险的是,依赖 AI 写代码和读代码的开发者将永远无法达到精通,因为他们不再从错误中学习。作者认为 LLM 只是工具,预言未来会有公司以'无 AI'政策作为竞争优势。

技术 › LLM Alexandru Nedelcu 2026-09-226.8 KB 4.3K 23 66

实测MiMo-V2.6:小米347万美元训出的开源模型深度评测

作者实测小米直播后训练的MiMo-V2.6模型。小米以直播方式公开后训练全过程,Flash和Pro合计花费347万美元,Pro在Artificial Analysis智能指数榜登上开源模型第一(46分)。作者通过五个真实任务测试:three.js程序化3D建模太和殿、高端旅行社官网前端审美、修复开源仓库真实bug、办公数据处理与核对、以及对发布仅七天的Jev模型做长程研究与幻觉控制。结果显示模型在agentic编程、审美、错误处理和事实核查上表现出色,且缓存命中率达95.7%、成本低廉,作者认为智能正走向普惠,计划将常用开源API迁移到MiMo-V2.6。

技术 › LLM 花叔 2026-09-2211.3 KB 14.5K 9 78

一年之间,云栖大会里的 AI 到底进步了什么?

文章对比2025与2026年云栖大会,梳理AI一年间的进步:从'云智一体'到'智以致用',重点从模型能力展示转向产业落地。Qwen3.8-Max主打长程任务执行,Qwen3.8-Omni-Flash在多模态理解上大幅提升且成本骤降;Agent从聊天进入工作流,具备拆解目标、多智能体协作、沉淀Skill等能力;具身智能与AI硬件走向现实。对内容创作者而言,生产模式正从单模型生成片段走向多模型协同的完整生产链,Qwen4与下一代视频模型值得期待。

技术 › LLM siuser小伟 2026-09-227.0 KB 972 5 74

Jev与你有什么关系?它提供了一套AI工作流拆分法

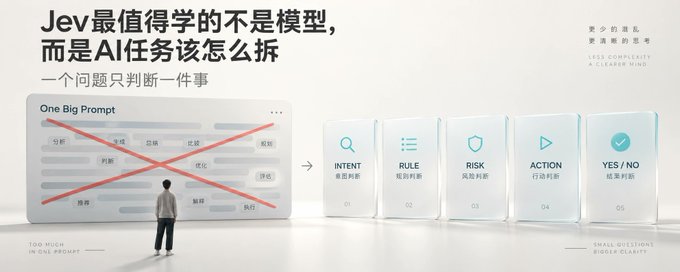
文章介绍了TypeSafe AI于2026年9月发布的Jev模型,一个不做文本生成、只做封闭判断的“System One Model”。它提供三种能力:Choice(选项选择)、Score(等级打分)和Noul(真假概率判断),直接返回类型化结果和概率,省去生成文本的延迟和成本。文章分析了Jev与生成式模型的本质区别,指出类型安全只保证接口格式而非事实正确,概率不等于正确率,并详细说明其在缺陷分诊、Agent路由、发布说明审核等真实场景中的应用方法,以及官方Agent Skill倡导的AI工作流拆分法:代码负责计算和规则,模型只做清楚的语义判断。

技术 › LLM 苏乐 2026-09-2224.6 KB 20.2K 41 85

我越来越觉得,AI 招聘可能从一开始就解决错了问题

作者反思当前 AI 招聘产品过度聚焦于简历筛选效率(JD→Resume→Matching→Score),却忽视了更上游的问题:岗位本身往往没有被真正定义清楚。作者提出应从 Hiring Brief 开始,先明确招聘目标、成功标准和所需证据;AI 更适合作为 Evidence Engine(整理证据、标记 Unknown),而非直接给候选人打分的 Judge。文章还讨论了结构化面试取代闲聊式面试、构建端到端的 Recruiting Operating System,以及 AI 决策的边界与合规要求(PIPL、欧盟 AI 法案),强调 Human in the loop 的重要性。

技术 › LLM Jasmine-Y 2026-09-228.6 KB 24.2K 40 75

吴恩达新推文批 AI 恐慌炒作:技术没变,是 PR 在制造恐惧

吴恩达发推批评近期 AI 危险性的恐慌声浪急剧升级,认为 AI 技术本身没有出现危险转折,真正变化的是背后疑似精心策划的公关炒作。他回应了 OpenAI 智能体逃出沙盒入侵 Hugging Face 的事件,指出“1200 个智能体”的数字被严重渲染,多进程并行本是平常事,核心问题是沙盒隔离漏洞,应修复漏洞而非暂停 AI 发展。他反对媒体拟人化倾向,强调责任应归于使用者和制造者而非工具本身,并明确指出暂停 AI 发展弊远大于利。

技术 › LLM 宝玉 (@dotey) 2026-09-222.8 KB 64

Jev is INSANE for Marketing

本文介绍新型AI模型Jev,它由ChatGPT联合创造者Diogo Almeida创立的TypeSafeAI开发,采用RLCD训练方法,可进行即时决策而非逐字生成回答。Jev提供Choice、Score、Bool三种询问方式,并附带置信度评分,速度提升20-200倍、成本降低400倍。作者展示了如何将Jev实际集成到自己的SaaS产品Virlo中,构建内容研究代理,自动监控TikTok等平台的病毒式视频,分析爆款钩子、格式和角度,并转化为经过数据验证的脚本和创作简报,帮助内容营销人员高效产出热门内容。

技术 › LLM jaffa 2026-09-2221.1 KB 547.4K 765 54

How to use Jev for GTM Automation (Step-by-step guide)

本文介绍 TypeSafe AI 推出的 Jev 模型,它专为校准决策设计,输出概率而非文本。Jev 针对传统 LLM 过度自信、成本高、速度慢的问题,通过三种问题类型(Choice、Noul、Score)返回带置信度的概率结果,开发者可基于置信度阈值设置自动化护栏,实现无人值守运行。作者结合 treg 数据服务,展示了 Jev 在 GTM 自动化中的实战应用,包括欺诈检测与注册用户资格审核(每日 236 个注册仅花费约 $1.21)、以及购买信号分类等场景,并分享了编写评分规则(rubrics)而非传统 prompt 的使用技巧,成本远低于通用聊天模型。

技术 › LLM Jason Zhou 2026-09-2210.6 KB 64.8K 231 82

实测阶跃星辰新模型 Step 5 Preview,网页复刻这块我愿称之为天才程序员级

作者实测阶跃星辰新模型 Step 5 Preview,认为其前端 UI 能力已进入第一梯队,价格仅为竞品三分之一却达到 K3 水平。测试显示它能高精度复刻 Apple 官网页面,配合 Skills 可实现动效网页设计,还能用 HTML5 Canvas 开发 2D/3D 游戏且操作流畅。作为 Agent 接入 Claude 框架后,它能从 72 页 PDF 中逐页提取数据核算利润率,并审计修复含 1800 多条公式的复杂 Excel 财务模型,揪出 22 处错误并标注不确定项。作者感叹国产模型正在从几家变成一批,整体表现超出预期。

技术 › LLM 卡尔的AI沃茨 2026-09-2211.1 KB 4.5K 10 66

用 AI 生成 3D 车间展示:一个面向传统工厂的商机

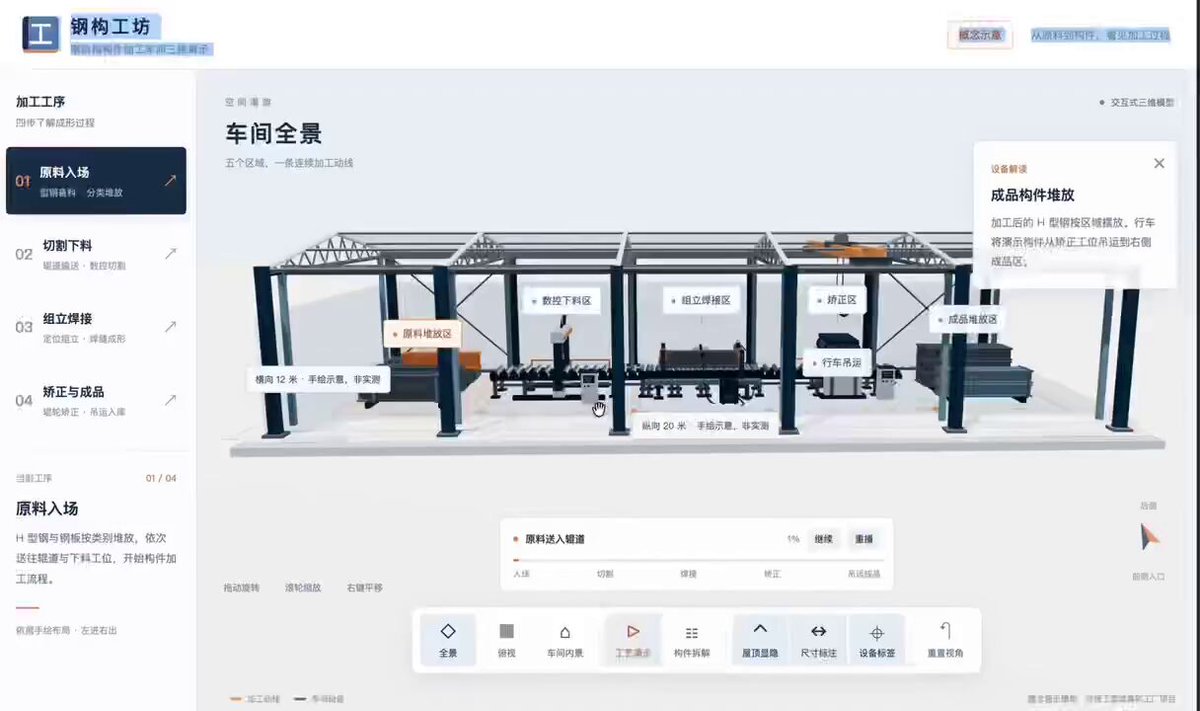
作者发现 Gemini 4 Pro 具备强大的 3D 生成能力,可从一句 Prompt 或一张手绘车间草图生成可交互的 3D 场景。他据此提出一个商机:为传统工厂(如建材、钢结构加工厂)制作交互式 3D 车间展示页,涵盖原料堆放、切割下料、组立焊接、矫正、成品等工序,配上设备标签和说明卡片,让销售谈单、展会展示和客户自助浏览更直观,实现降维打击。作者已用 Astra 做出钢结构车间的概念样板,下一步将找身边的厂二代验证付费意愿。

技术 › LLM 森叔 (@harrisonitsme) 2026-09-222.8 KB 59

DeepSeek,华为,「必须成功」:十六万颗萤火照进荒原

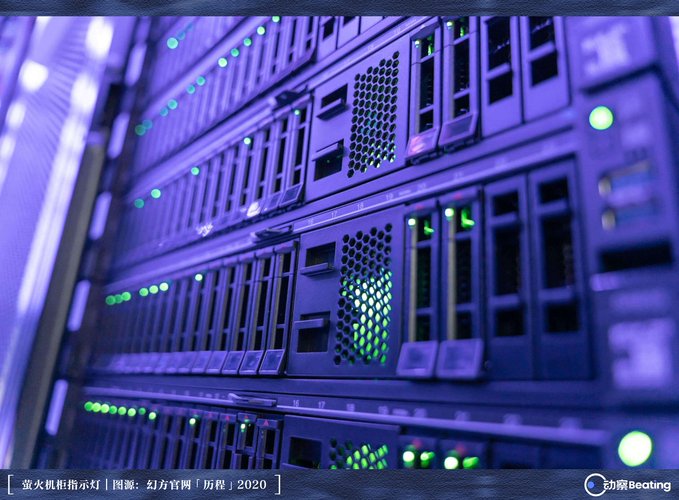
文章讲述了DeepSeek与华为两条看似毫无交集的技术路线如何走向深度结盟的故事。幻方量化创始人梁文锋早在2019年就囤积算力(萤火一号、二号),而华为通过海思备胎计划在实体清单后推出昇腾芯片。在英伟达对华禁售后,DeepSeek以极致工程能力用低配H800训练出V3和R1,震撼硅谷并引发英伟达市值暴跌。2026年,梁文锋押上200亿元,联合华为将下一代旗舰模型迁移到纯国产昇腾底座,并在内蒙古规划16万颗昇腾芯片的超大型数据中心。这是一场被地缘封锁逼出来的、别无选择的技术突围。

技术 › LLM Sleepy [@sleepy0x13] 2026-09-2216.1 KB 20.4K 3 68

Grok 4.7 交卷:模型更强了,便宜这笔账得重算

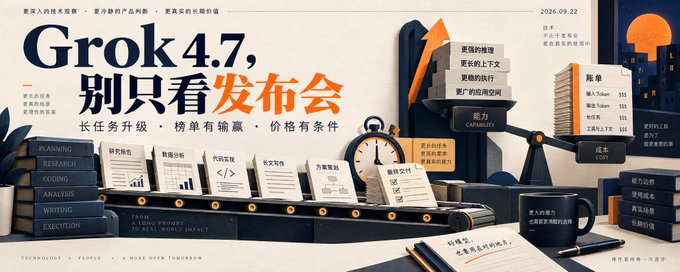
xAI 于 9 月 21 日发布 Grok 4.7,主打长任务能力:更大基础模型、更长强化学习训练、支持 50 万 token 上下文。文章分析官方与第三方基准成绩,指出其在编程等部分任务进步明显但并非全面领先,需结合自身需求看待榜单。价格方面,标准 API 单价较低,但长上下文(20 万 token 以上)计费翻倍、Fast 版本仅限特定平台,且模型实际 token 消耗可能很高,单价低不等于总价低。作者建议用真实工作任务测试模型,关注交付质量与总成本,而非被亮眼演示或单价吸引。

技术 › LLM 李新宝 2026-09-227.1 KB 1.3K 4 78