Wiki 知识库

技术 / LLM

1284 篇
清除

Grok 4.6 实战指南:速度、沟通与验证的艺术

本文是作者对Grok 4.6的深度评测与使用指南。作者将其作为日常编码和知识工作的主力工具,强调其信息密集的沟通方式和显著的速度提升。文章通过多个项目(如电子表格应用、策略游戏、Excalidraw演示模式等)对比了Grok 4.5与4.6的表现,发现4.6在细节处理和整体完成度上更优。作者还分享了提示词工程的关键发现:短提示词配合明确偏好效果良好,而加入“验证并迭代至生产就绪”的句子是最高杠杆的改进。文章最后探讨了视频即代码(Remotion)的实践,并总结了Grok 4.6在自主迭代和验证方面的能力。
技术 › LLM eric zakariasson 2026-08-1311.6 KB 766.8K 3K 74

如果你还不会精准地指挥你的AI,那就来试试我这个「元提示词」法

本文介绍了一种名为「元提示词」的方法,帮助用户精准地向AI描述需求。作者以制作PPT为例,展示了如何通过让AI提问来逐步澄清需求,最终生成一份可执行的提示词。该方法适用于任何难以清晰表达的任务,通过先让AI提问、再复述确认、最后生成提示词的流程,提高AI输出的精准度。

技术 › LLM 金尘马 2026-08-137.0 KB 13K 48 66

DeepSeek V4 Pro与Grok 4.6发布,大模型市场迎来新斩杀线

本文作者分享了DeepSeek V4 Pro和Grok 4.6两款新模型的发布体验,认为它们从性能和价格两个方向打破了传统大模型的不可能三角(性能、价格、速度),将行业斩杀线推向前所未有的高度。作者详细对比了两款模型与Claude Fable 5的跑分和实际使用感受,并分享了自己重新分配AI工具组合的策略,包括将日常开发切换到Grok Build + Grok 4.6,将自动化任务交给DeepSeek V4 Pro。文章最后指出,新模型的出现将淘汰大量夹在中间的玩家,大模型市场进入新的竞争阶段。

技术 › LLM 数字生命卡兹克 2026-08-1313.6 KB 109.4K 272 73

机器学习的方法论总论

本文提出了一套机器学习方法论的统一框架,将学习算法拆解为十八个节点、四大块,以回答PCA、Transformer等不同方法在方法论上的异同。作者指出传统教科书定义、CRISP-DM流程和Domingos三元组的不足,特别是将“优化”作为第三列命名的问题,并引入闭式解、特征分解、积分等七种参数确定方式。文章详细阐述了定题与构造的前九个节点,包括三层代理(W/M/L)、目标与数据顺序、函数族、归纳偏置、参数化形态等,强调组合视角和归纳偏置的重要性。

技术 › LLM snowboat 2026-08-1386.0 KB 36.9K 60 80

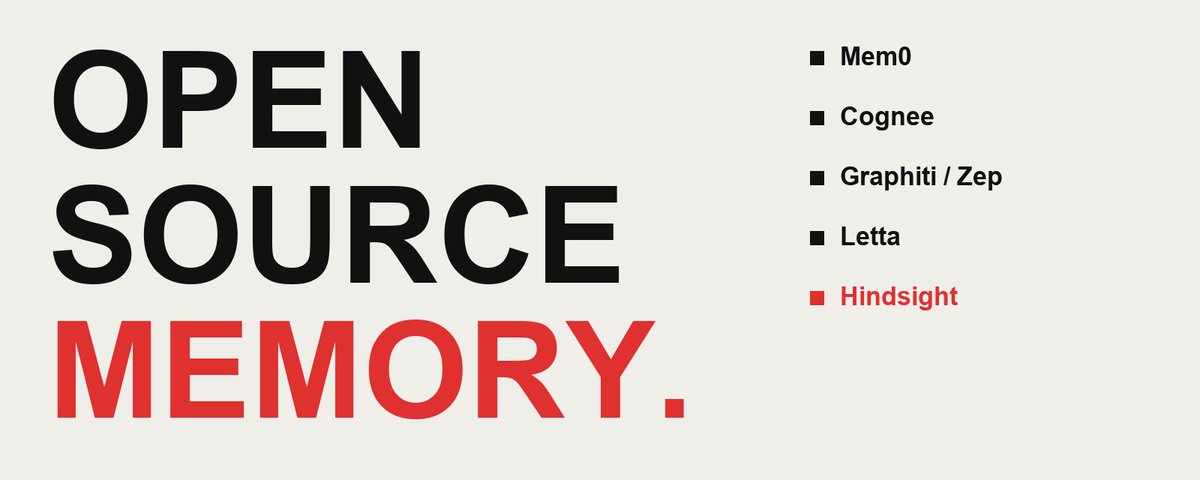
Best Open-Source Agent Memory Systems (Self-Hosted, 2026)

本文深入比较了2026年可自托管的开源AI代理记忆系统,包括Mem0、Cognee、Graphiti/Zep、Letta和Hindsight。文章强调开源与可自托管并非同义,并提出了五个评估维度:检索准确性、自托管现实、功能对等性、许可证和架构。通过公开基准测试和实际部署要求,作者揭示了各系统的真实优劣,特别指出Mem0社区最大但基准测试饱和,Graphiti擅长时间推理但需外部图数据库,Hindsight在准确性和部署简便性上领先。文章旨在帮助读者根据自身需求选择最合适的记忆层系统。

技术 › LLM Vectorize 2026-08-1215.1 KB 943 17 83

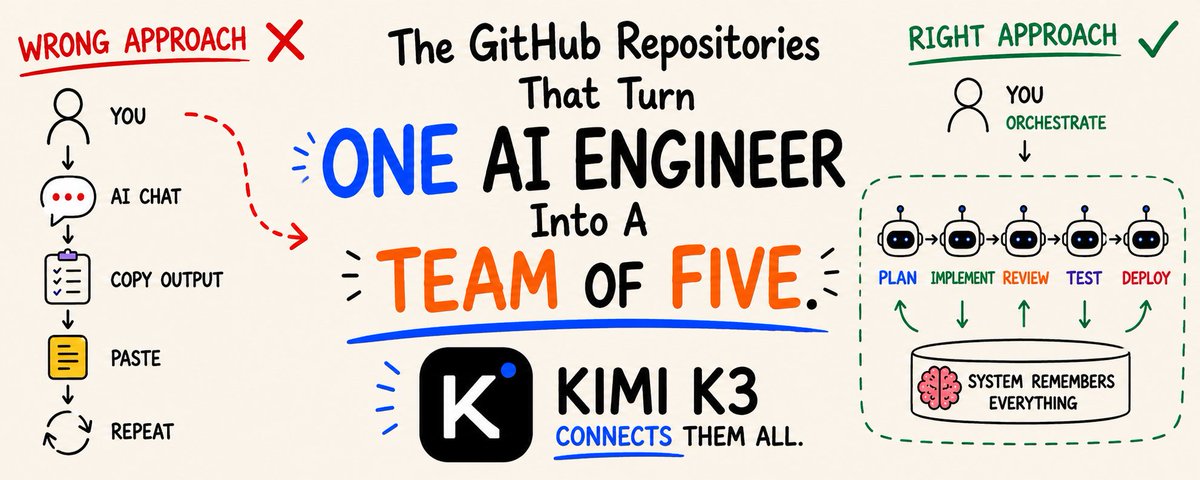
The GitHub repositories that turn one AI engineer into a team of five. Here's the full list.

本文介绍了一套由五个开源仓库和Kimi K3模型组成的AI开发系统,该系统能让单个工程师实现五人的工作效率。文章详细说明了每个仓库的功能和它们如何协同工作,包括Kimi Code作为AI高级工程师、Kimi Agent SDK作为管理层、OpenAI Agents SDK用于构建多智能体工作流等。作者强调,顶级AI公司的工程师已通过此类系统实现自动化,并提供了具体的搭建方法和代码示例。

技术 › LLM Noisy 2026-08-1215.4 KB 356.7K 172 83

AI 编程缺失的抽象层

本文探讨了AI编程对软件工程的影响,认为AI编程是一次抽象层的升级,而非简单的岗位替代。作者指出,当前AI能力已跃迁,但新的抽象层尚未稳定,导致软件工程方法滞后。文章分析了Junior Engineer面临的训练路径断裂问题,并重新定义了AI时代的基本功,包括Specification、Decomposition、Verification和Context Engineering。最后,作者认为我们正处于AI编程的“汇编时代”,未来将出现新的抽象体系,定义下一代软件工程。

技术 › LLM siddontang 2026-08-1210.2 KB 11.1K 45 68

听完李飞飞两小时访谈,我重新理解了 AI 时代的“主体性”

本文基于对李飞飞两小时访谈的思考,探讨了AI时代人类“主体性”的重要性。作者指出,AI不仅能学习写作模式,还能帮助人们看见习惯和盲区,但关键在于如何使用:是直接获取答案,还是用它来拓展思考。文章强调,对孩子而言,AI可能剥夺他们与困难相处的机会,因此教育者需参与规则设计。同时,作者认为语言模型虽强,但世界不只由语言构成,空间智能提供了另一种理解方式。最后,作者提出三个问题,提醒人们在AI辅助下保持主动性和判断力,避免过早交出方向盘。

技术 › LLM Yanhua 2026-08-126.1 KB 15.1K 114 62

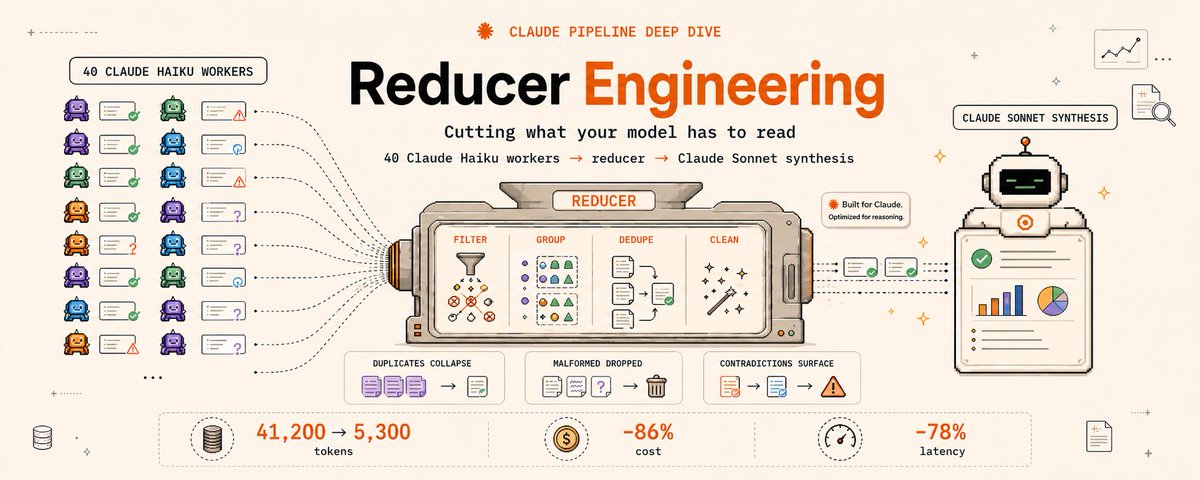
Reducer Engineering: Cutting What Your Model Has To Read (Full Guide)

本文介绍了在多智能体流水线中,通过引入确定性Reducer层来优化成本与延迟的实践。作者以40个Claude Haiku worker并行处理、Claude Sonnet汇总的架构为例,指出原始输出包含大量重复、格式错误和冗余信息,导致昂贵的合成模型浪费在数据清洗上。通过代码实现去重、过滤和分组,成本降低86%,延迟降低78%,并意外发现23处矛盾。文章强调结构化归约不仅是成本优化,更是质量保障,并提供了代码示例、防护措施和操作指南。

技术 › LLM Gipp 2026-08-119.1 KB 330.8K 323 82

我找到了AI写作问题的根源(附解法)

本文深入剖析了AI生成文字中常见问题的根源,包括自造隐喻和英文句法迁移导致的语义错配。作者指出,AI写作常使用需要读者二次理解的表达,以及“反映出”等连接词将事实、解释和结论混为一谈。文章结合训练数据背景,解释了英文表达习惯为何会进入中文,并提出了与AI协作写作的具体方法:先分类原材料,再检查自造说法和连接词,最后使用提示词让AI输出原句、问题和建议。最终强调,人需对文章中的判断负责。

技术 › LLM Roland.W 2026-08-118.4 KB 114.7K 122 77

FDE:AI进入产业深水区后,一种新的职业复利

文章探讨了AI进入企业应用深水区后,FDE(Forward Deployed Engineer)这一职业的兴起与价值。随着模型能力趋同,企业部署AI的瓶颈转向数据、权限、流程等实际问题,FDE成为连接模型与业务的关键角色。文章提出个人FDE复利公式,强调问题价值、现场深度、反馈密度、抽象能力和复用范围的重要性,并详细阐述了FDE如何将隐性经验转化为系统规则、如何应对生产失败、以及如何构建职业复利。最后指出,FDE的核心在于靠近问题、承担上线责任,并将现场经验转化为可复用的能力,从而推动企业AI的落地与迭代。

技术 › LLM Russell 2026-08-1112.5 KB 6.6K 16 76

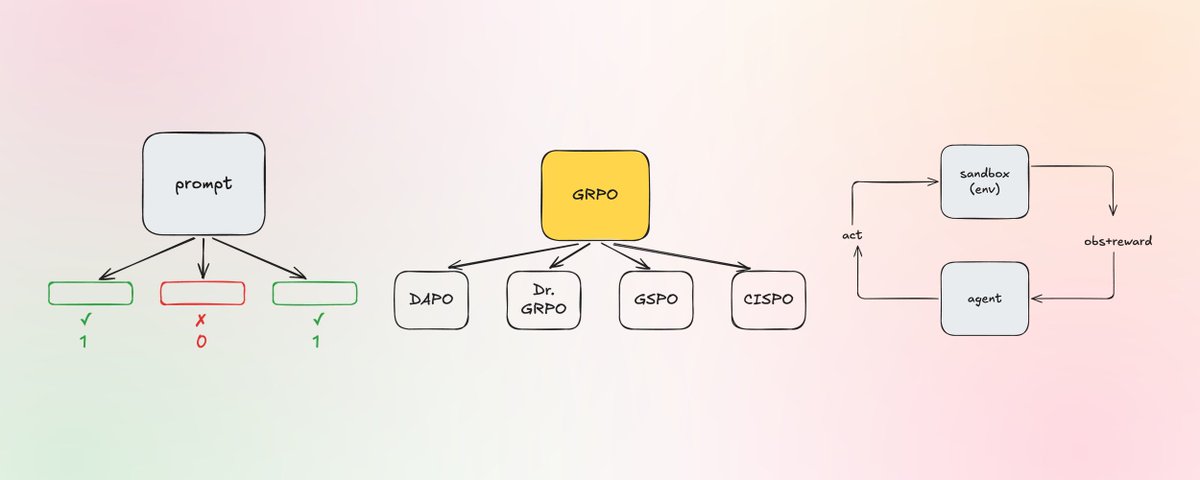
How frontier models train on outcomes in 2026

本文是《训练智能体》系列课程的补充材料,探讨了前沿实验室在2026年如何利用强化学习(RL)训练模型。文章回顾了从RLHF到RLVR的演变,指出可验证奖励已成为主流,GRPO算法衍生出多种变体,并强调了RL从单一答案向环境交互的转变。通过引用OpenAI、DeepSeek、Meta等实验室的报告,展示了这些模式的实际应用。

技术 › LLM Sergio Paniego 2026-08-1119.8 KB 31.1K 181 75

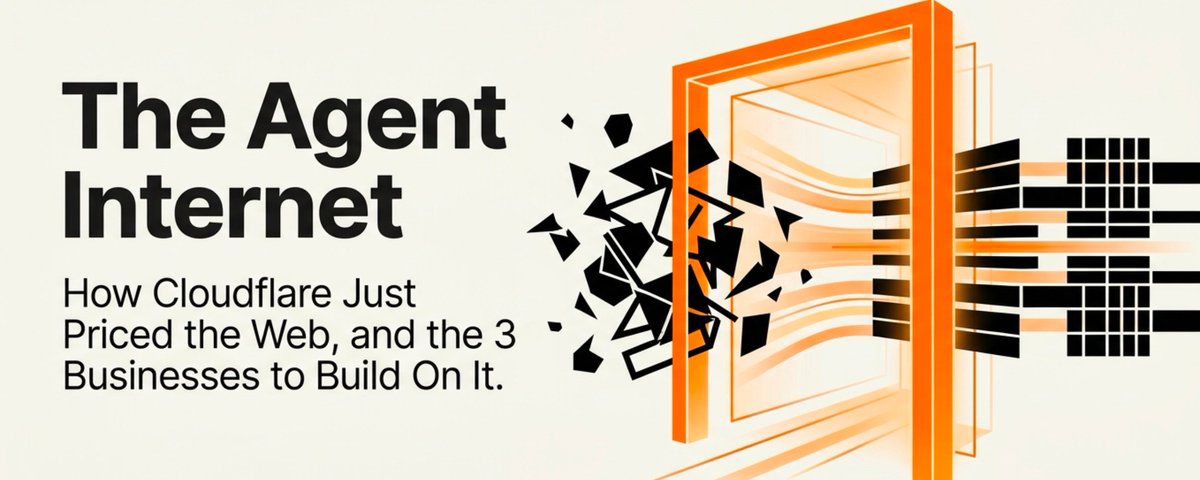
向AI代理收费:Cloudflare的新模式与创业机会

文章探讨了AI代理如何改变互联网商业模式,以及Cloudflare推出的AI Crawl Control、Pay Per Crawl和Monetization Gateway如何让网站向AI代理收费。作者提出了两个创业方向:一是为特定细分市场提供结构化数据服务,二是帮助企业优化其网站以更好地被AI代理理解和推荐。文章强调了从人类注意力经济向机器资源经济转变的趋势。

技术 › LLM The Startup Ideas Podcast (SIP) 2026-08-1114.6 KB 63.6K 123 84

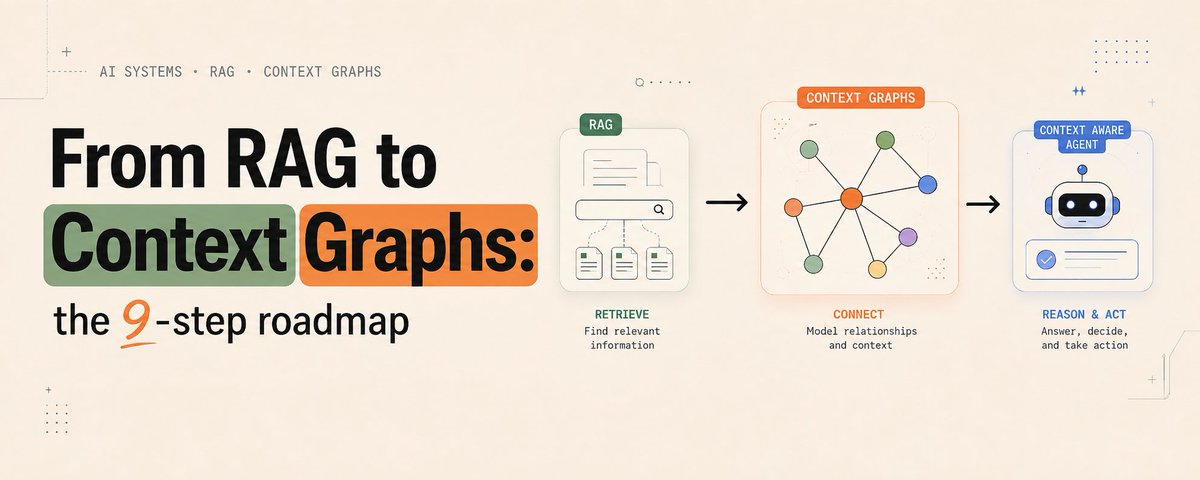
从RAG到上下文图谱:9步路线图

文章探讨了传统RAG在处理多跳推理问题时的局限性,指出检索文本块无法捕捉复杂的实体关系链。为此,作者提出了一种向“上下文图谱”转型的9步实施路线图。该方法通过从文本中提取实体与关系三元组,进行实体规范化以避免图谱割裂,并构建双向边表。图谱通过多源验证分配边权重,并为每条边附加来源以实现精准溯源。最终,检索过程转变为图谱遍历,通过反向可达性分析和路径权重排序,精准定位多跳查询的答案。

技术 › LLM Morlex 2026-08-1011.5 KB 310.6K 465 83

重新理解企业 RAG:从知识工程到 AI 基础设施

本文指出企业级 RAG 绝不仅是简单的文档切块与向量检索,而是一项复杂的知识工程。文章详细拆解了知识入库与用户提问两条流水线,强调了 PDF 结构化解析、混合搜索及权限更新的重要性。在 AI Coding 时代,底层代码可交由 Agent 完成,开发者应更关注 RAG 的架构设计。最终,企业 RAG 的核心价值在于构建一层可被 AI 调用的知识基础设施,从而支撑各类业务 Agent。

技术 › LLM Builder (@UPing123zzz) 2026-08-103.6 KB 71

一文科普 主流 LLM 注意力机制

本文系统科普了主流LLM的注意力机制,指出其并非简单的单线升级,而是可组合的四个维度:KV缓存表示、注意力连接范围、序列混合器及位置稳定化技术。文章详细解析了MHA、MQA、GQA、MLA等机制对显存带宽的影响,以及全注意力、稀疏注意力、线性注意力等在降低长序列计算复杂度上的权衡。最后通过对比DeepSeek、Qwen、Kimi等代表模型,澄清了常见误区,为机制选择提供了准确的技术指导。

技术 › LLM 山景城小路 2026-08-1021.7 KB 8.6K 41 88

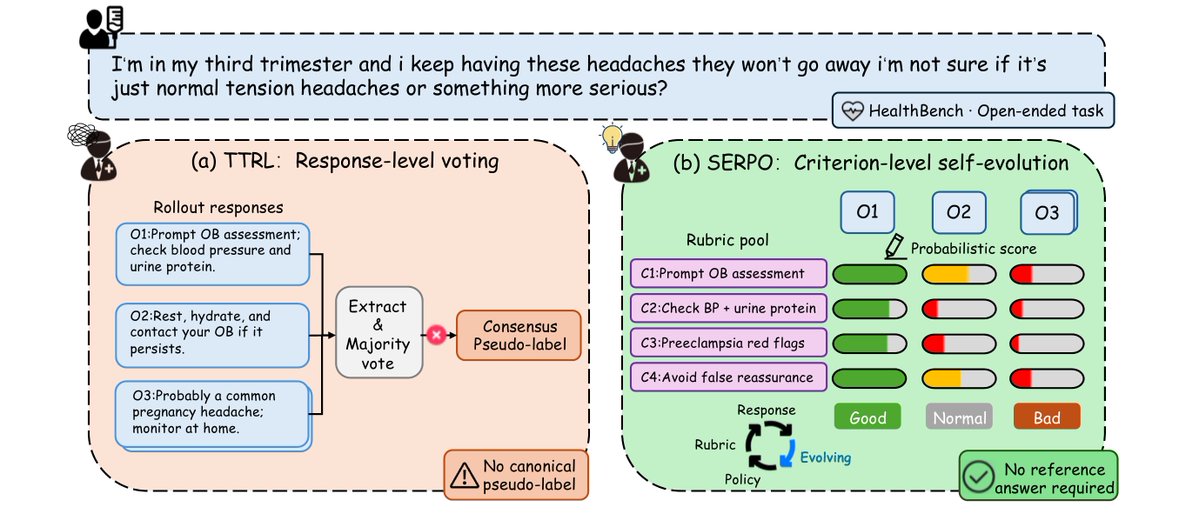
模型部署后的无标注自进化:SERPO机制解析

现有无标注强化学习(TTRL)多依赖多数票生成伪标签,难以处理医疗建议等复杂开放式任务。为此,文章提出SERPO(自进化判据策略优化)机制。它通过模型自身采样的回答提取质量判据生成奖励,无需任何外部监督或人工标注,并将收益直接写入模型权重。实验表明,SERPO不仅大幅提升了模型在垂直领域的性能,且在OOD测试和长程训练中持续进化,证明了其能将质量标准转化为持久的模型能力。

技术 › LLM 青稞社区 2026-08-1018.5 KB 2.7K 16 87

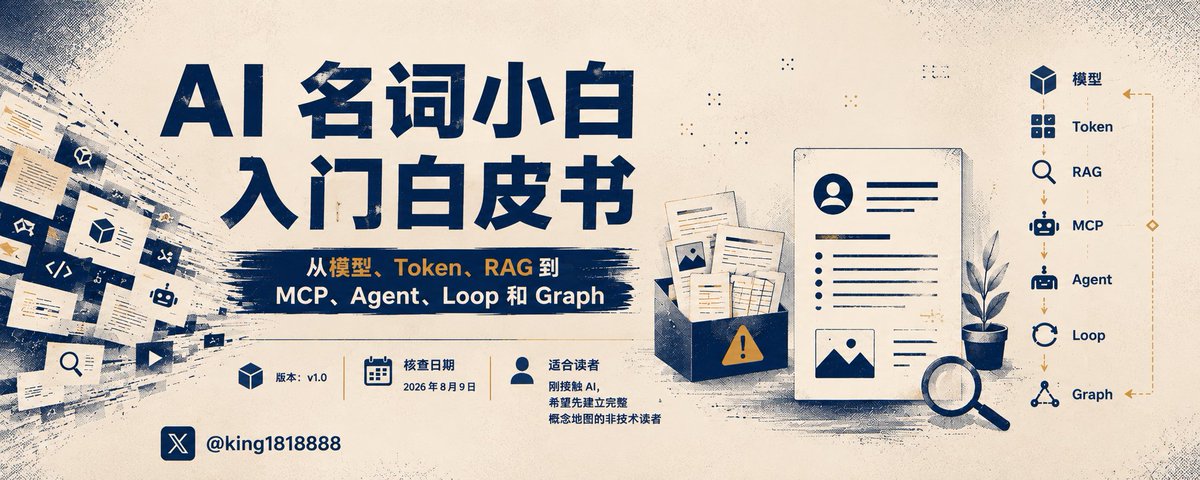
AI 名词小白入门白皮书

本文专为缺乏技术背景的AI初学者撰写,旨在理清AI领域的常见名词。作者将AI系统划分为七个层级,详细拆解了从大模型、产品、Token、RAG、MCP到Agent、Workflow、Loop和Graph等核心概念。文章指出新手常犯的认知混淆,并通过具体的任务案例展示AI系统的工作流程。最后,为初学者提供了从分清对象到理解工具执行的实用学习路径,帮助读者建立完整的AI概念地图。
技术 › LLM Kimberly 2026-08-0921.3 KB 31K 150 88

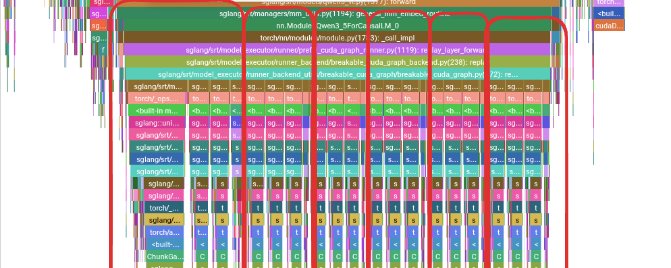
使用 SGLang 和 Torch Profiler 对 LLM 推理进行性能分析

本文详细介绍了如何使用 SGLang 内置的 Torch Profiler 对大语言模型(Qwen3.5-0.8B)进行推理性能分析。作者阐述了如何通过追踪 CPU 和 GPU 端事件来定位计算瓶颈,并结合屋顶线模型证实单批次解码主要受限于内存带宽。文中展示了如何利用 Perfetto UI 分析 Prefill 阶段的性能追踪数据,将其底层计算操作与模型的混合架构(如 Gated DeltaNet 和全注意力机制)精准映射,帮助读者深入理解 LLM 的底层执行流程。

技术 › LLM Jino Rohit 2026-08-0913.8 KB 104.1K 916 88

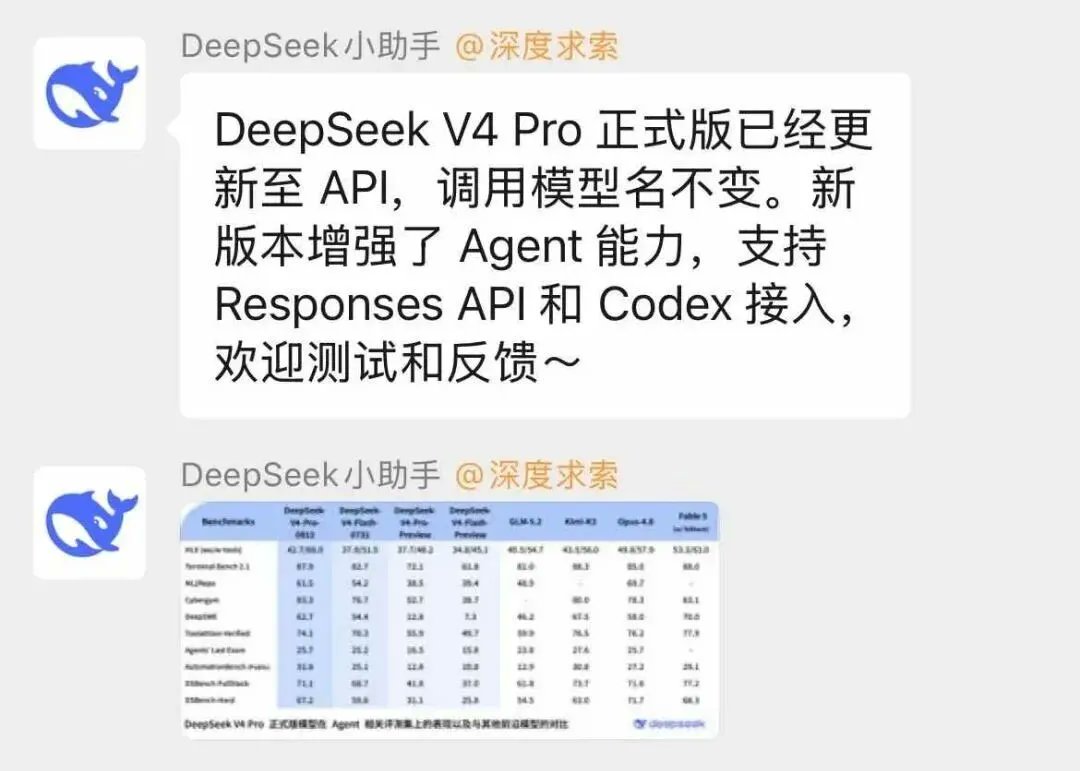
DeepSeek 刚支持了 OpenAI Responses API,但你可能还不知道它是什么

本文梳理了 LLM API 格式的演进史。从早期 Chat Completions 的无状态聊天映射,到各厂商接口分叉,再到 Agent 时代为解决状态管理和缓存问题诞生的 Responses API。新 API 引入了服务端状态、检查点分支及内置云端工具,模糊了模型与 Agent 的边界。随着 DeepSeek 宣布原生兼容该接口,预示着 Responses API 正取代旧标准,成为 AI 行业的新共识。

技术 › LLM SaladDay 2026-08-098.1 KB 80

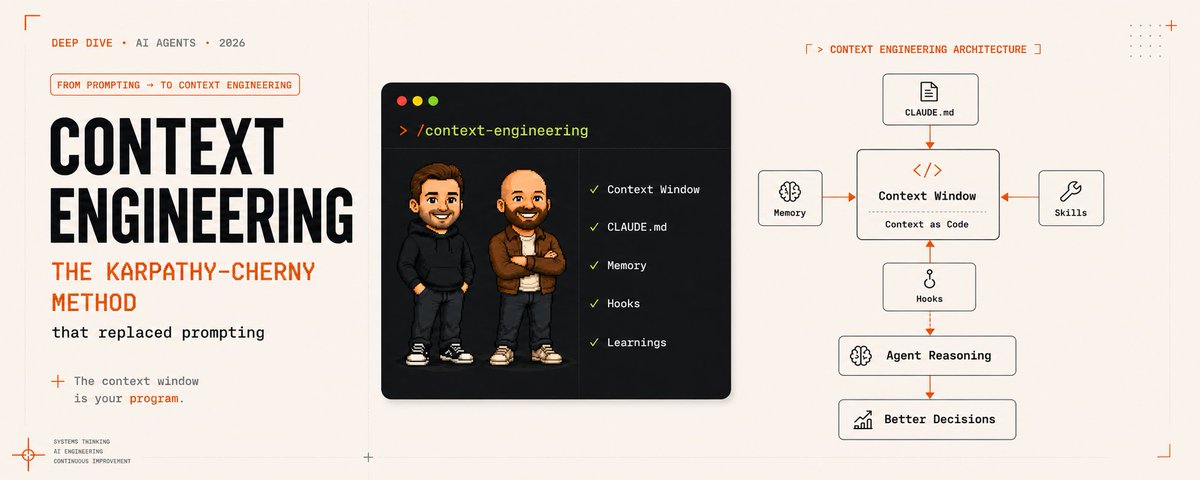
上下文工程:取代提示词工程的Karpathy-Cherny方法

本文探讨了AI领域中从提示词工程向上下文工程的演进。引用Karpathy的Software 3.0理念,指出上下文窗口即新程序,通过写入、选择、压缩和隔离四大操作管理模型记忆以避免上下文腐化。结合Claude Code创建者Cherny的循环工程理念,说明通过构建包含技能、子代理和验证器的自动化循环,可实现高效上下文工程,将AI从简单工具升级为强大的操作系统。

技术 › LLM vartekx 2026-08-0715.7 KB 2.2M 457 85

人类自我改进系统的第四次尝试:从生成到验证的演变

文章回顾了AI递归自我改进(RSI)的80年历史,将其划分为四次浪潮:随机突变(遭遇生成瓶颈)、数学证明(陷入验证瘫痪)、AutoML(过度拟合基准测试),以及当前大语言模型阶段。作者指出,随着LLM解决了代码生成的瓶颈,AI系统演进的核心挑战已剧烈转移至“验证”阶段。面对开放式任务,如何有效验证AI生成复杂系统的逻辑可靠性,成为了当前AI自我进化的真正天花板。

技术 › LLM Amber (Jiachen) Liu 2026-08-0710.4 KB 19.7K 126 74

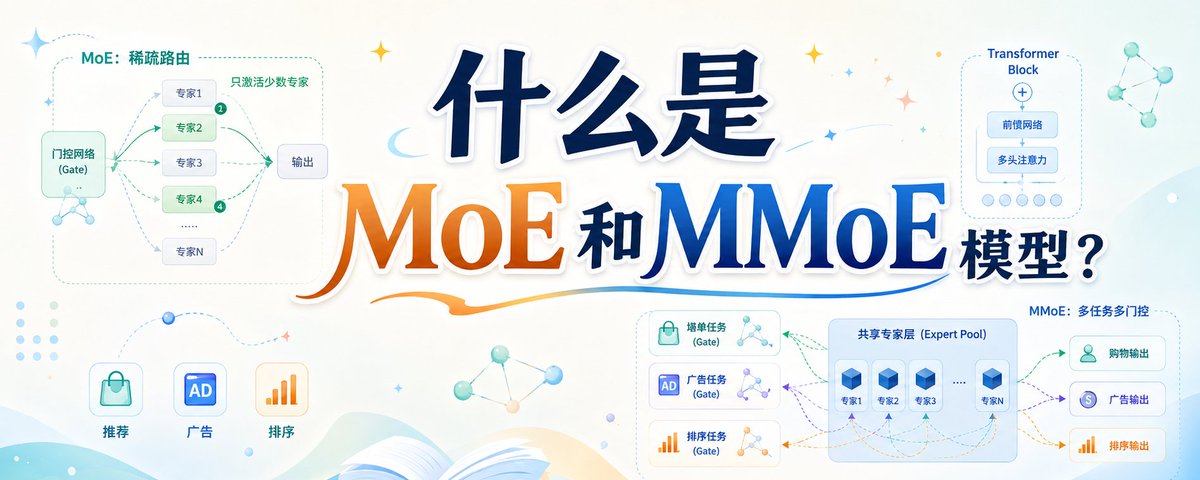
MoE与MMoE模型详解:从稀疏扩容到多任务学习

本文系统梳理了MoE(混合专家)模型的概念分歧与技术演进。针对目前命名混乱导致的认知误区,作者明确划分了两条核心技术路线:一是追求参数量与计算量解耦的稀疏路线,已成为大语言模型的默认架构;二是通过多门控机制实现任务共享的MMoE路线,主要应用于推荐系统。文章深入回顾了条件计算思想,并详细探讨了稀疏MoE在路由设计、负载均衡、并行通信等工程实践及结构演进的现状。

技术 › LLM snowboat 2026-08-0760.2 KB 16.2K 16 89

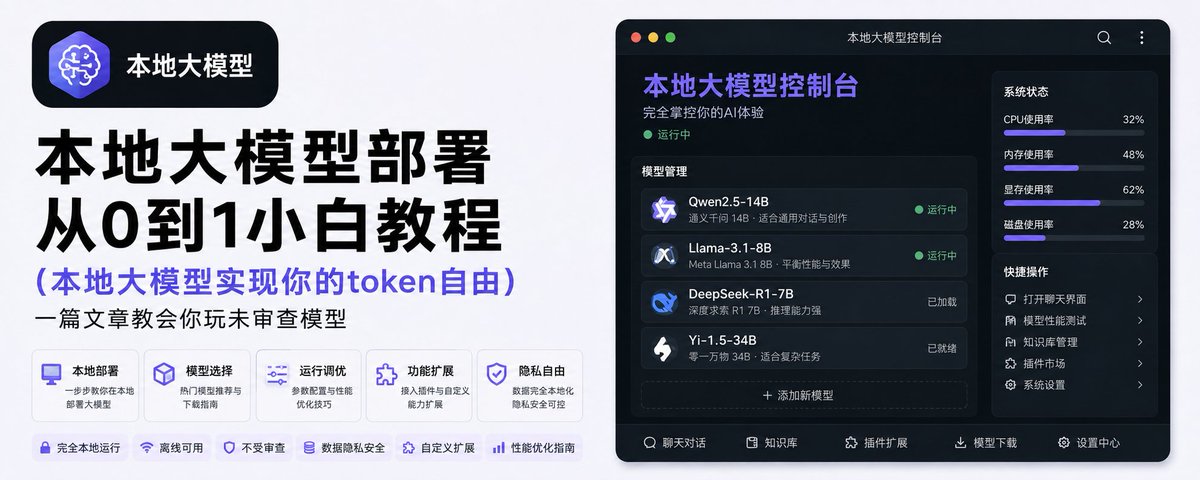
本地大模型小白从0到1完整入门教程

本文是一篇面向新手的本地大模型运行与部署全攻略。文章首先对比了云端与本地模型在隐私和成本上的差异,随后用通俗易懂的语言拆解了模型命名、参数量(B)、量化压缩(Q4_K_M)等核心概念。教程详细指导了如何根据显存计算并选择合适的硬件与模型,并推荐了LM Studio与ComfyUI等无代码软件。最后,针对文本对话、图像及视频生成三大场景,提供了具体的模型选型建议与实战评测方法,帮助小白零基础快速玩转本地AI生态。

技术 › LLM 黄小木 2026-08-0620.3 KB 186.2K 291 89

Test-Time Compute Engineering: 构建推理引擎

本文探讨了 Test-Time Compute Engineering,即通过将算力从预训练转移到推理阶段,利用动态预算分配、搜索树拓扑、过程奖励模型验证和剪枝策略,构建在回复前进行自主推理的 AI 引擎,以突破预训练规模定律的限制并提高复杂任务的准确性。

技术 › LLM marfin 2026-08-0610.5 KB 411.3K 175

MiniMax H3 本地部署保姆级教程

本文是一份 MiniMax H3 模型本地部署的详细教程,涵盖从零装机到写出专业提示词的全过程。内容包含硬件自查、ComfyUI 安装、模型下载、T2V/I2V/R2V 生成流程、参数规则详解及加速优化方案,附带各档次显卡实测数据,帮助用户在本地运行带立体声的 AI 视频。

技术 › LLM huangserva 2026-08-0644.8 KB 559.6K 1.3K

Jeff Dean 离开 Google:从 MapReduce 到 Discovery Loop,他如何把规模变成基础设施

Google 首席科学家 Jeff Dean 宣布离职,结束 27 年职业生涯。他将与 Sanjay Ghemawat 等人创办 Discovery Loop,致力于自动化科学与工程发现。文章回顾了 Dean 从构建分布式系统、MapReduce、Bigtable 到引领 Google Brain 和 TensorFlow 的历程,阐述了他如何将底层复杂性封装成基础设施,并试图将这种规模思维带入自动化发现领域。

技术 › LLM Mr Panda 2026-08-0618.4 KB 3.5K 1