Wiki 知识库

全部文档 / 标签: 多模态

75 篇
清除

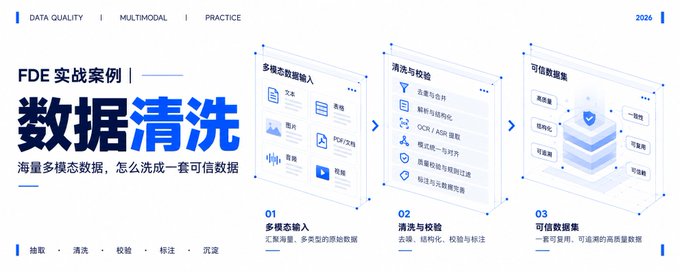
FDE 实战案例:海量多模态数据清洗成可信数据的八步方法

作者以美妆企业 FDE 落地项目为例,讲解如何将小红书、抖音、视频号、微博等平台采集的多模态数据(文字、图片、音频、视频)清洗成一套可信、可查询的结构化数据。文章提出八步通用链路:定数据规范、保留原始内容、梳理用户/帖子/评论关系、多模态归一处理、冲突与质量清洗(含证据分级)、生成结构化数据、执行验收、按规则和版本入库。文中还给出 OCR/ASR 工具选型建议(FFmpeg、PaddleOCR、Whisper 等)以及大模型结构化输出的实践经验。

技术 › 后端 Miles Ma 2026-10-2712.9 KB 5.8K 61 86

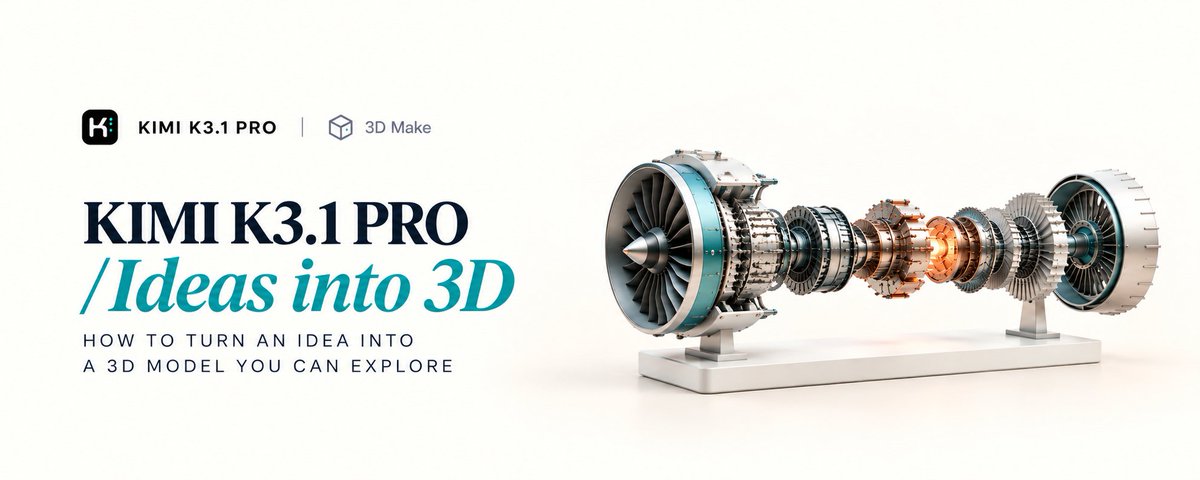
如何将一个想法变成可探索的 3D 模型:Kimi 3D Make 完全教程

本文介绍 Kimi 推出的 3D Make 功能,用户只需一句话描述即可生成可查看、可编辑的 3D 模型。文章通过三个实战案例(喷气发动机剖面拆解、雨林中庭、哥特式大教堂)演示完整的提示词写法:如何描述物体、关键部件、外观风格与视角;如何通过后续对话逐步细化,如拆分发动机各阶段、增加植物层次、渲染彩色玻璃光线。文章还给出了通用的修改提示模板,强调每次只提出一个具体改动并旋转检查效果。该功能已在 kimi.ai 和 Kimi 应用上线,支持在线预览与编辑模型。

技术 › LLM Elvar 2026-10-279.4 KB 358K 135 77

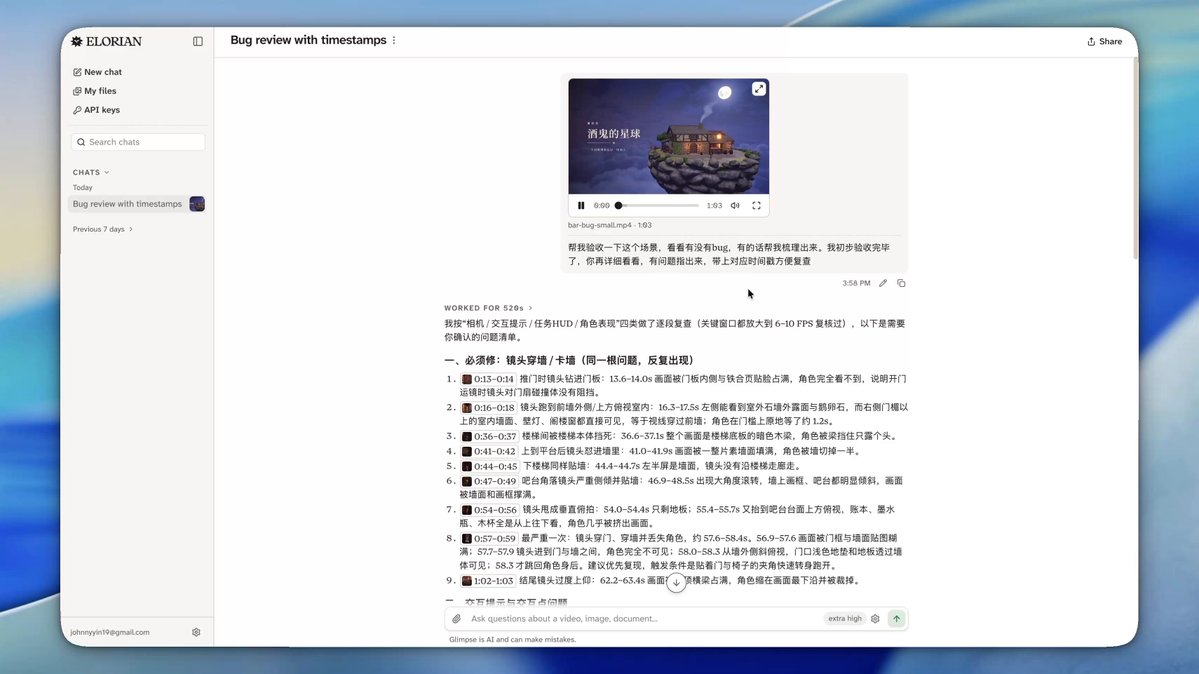
Glimpse 视觉推理大模型在游戏开发验收中的实战体验

作者分享了使用 Elorian AI 刚发布的视觉理解与推理大模型 Glimpse 的体验。该模型能原生理解图片和视频中元素的位置、结构与空间关系。作者将其用于小王子游戏的 bug 排查:只需提供实际游玩录屏,Glimpse 就能分析游戏设计是否合理并梳理潜在 bug。实测中,在无游戏上下文情况下,其发现的问题数量是 Astra 的 3 倍,且可按视频时间戳罗列细节问题,便于逐一核验,极大解决了个人开发者验收容易遗漏的痛点。Glimpse 已开放 API,可接入 Codex、Claude Code 完善验收流程,也适合视频/图片生成等 AIGC 场景。

技术 › LLM Sac (@Saccc_c) 2026-10-174.3 KB 59

7大核心升级,我们终于等来了一个“写作强于代码”的顶级模型:Gemini 4 Argon 深度实测

Google 旗舰模型 Gemini 4 Argon 于 10 月 14 日全面开放。文章详细解析了其 7 大核心升级:百万级 token 输出上限(长解码模式)、Arena 文字榜断层第一的写作能力、强于竞品的空间几何代码生成(3D 古建筑群)、深度推理与仅 15% 的超低幻觉率、原生多模态与 4K 音画同步视频生成、直接交付成品文件(PDF/Excel)而非代码,以及面向备考的苏格拉底式学习模式。作者附上 API 定价对比与 10 段实测提示词,认为其写作能力已超越 Claude Opus 5.5 和 GPT-6 Astra,性价比突出。

技术 › LLM Eian 2026-10-1418.8 KB 67.2K 197 84

做了个 skill:自动剪辑旅行 vlog

作者在豆包工作中优化地图动效 skill,实现全自动制作旅行 vlog。只需提供社媒照片链接,Agent 即可生成 3D 地图动效,根据画面内容推断拍摄机位(如虎跳峡、梅里雪山、雨崩),并利用多模态能力将旅行自拍生成 Q 版贴纸小人。最终自动渲染配乐,输出 mp4 视频,如从地球俯冲定位、Q 版小人沿真实路线行走、照片弹出的云南自驾 vlog 成片。还可配合开源剪辑 skill 生成剪映工程文件,完成素材粗剪,解决旅行 vlog 制作难题。

技术 › Skill 空格.space 2026-10-125.0 KB 2.6K 30 74

不要卖工具要卖结果:AI 真正的机会在重做工作流

作者结合自身使用 Codex、Claude Code 数千小时的体会,指出 AI 能力已足够强,但尚未大规模落地的核心原因是人们只在旧流程上寻找赋能环节。文章引用蒸汽机到电力的转型案例,主张不要做 co-pilot 卖工具给从业者,而要做 auto-pilot 直接向 business owner 卖结果。AI 最佳切入点是替换已有预算、黑盒化的外包环节(vendor swap),而非重组内部员工(reorganization)。价值正从 intelligence 迁移到判断力,拉长工作流、融合多模态与线下供应链能力才是最大壁垒。未来电商与内容生产领域将围绕 AI 重塑整个供应链。

技术 › LLM Park (@xparkzz) 2026-10-0813.9 KB 70

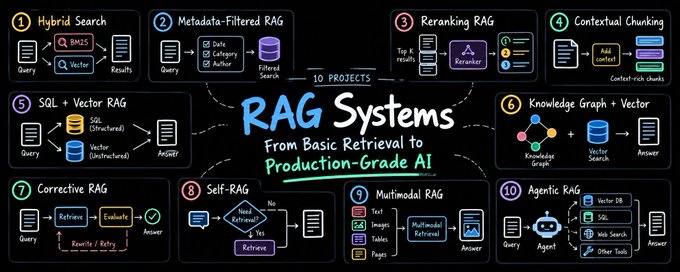
10 个带你从基础检索到生产级 AI 系统的 RAG 项目

文章指出仅掌握基础的'chat with PDF'式 RAG 流水线(分块、嵌入、向量检索、LLM)不足以构建真实生产系统,并推荐 10 个进阶项目:混合检索(BM25+向量)、元数据过滤、重排序、上下文分块、SQL+向量混合、知识图谱+向量、纠错式 RAG、自感知 RAG、多模态等。每个项目均说明要解决的问题、系统架构、技术栈(Python、pgvector、LangGraph、Neo4j 等)及学习要点,帮助开发者从语义相似度走向关键词匹配、结构化过滤、关系推理与检索质量反馈等生产级能力。

技术 › LLM Jaydeep 2026-09-2912.2 KB 22.5K 314 78

把 GLM-5.3-Flash 变成一个 Jev 式的 System One 模型

本文介绍一种无需微调的方法,把现成的 LLM(GLM-5.3-Flash)变成类似 Jev 的专用决策模型(System One 模型)。核心做法是给选项编号、预填答案、通过读取选项索引上的概率分布,让模型在一次前向传播中给出类型化决策及其置信度。文章详细说明了 vLLM 部署中的三个实现细节(allowed_token_ids、logprob_token_ids、tokenizer 分词),并在 29 个公开数据集上与 Jev、Laya 进行基准对比:文本决策准确性与 Jev 相当,延迟相近但成本较高;由于具备视觉能力,还能做图像上的类型化决策,这是 Jev 和 Laya 做不到的。文章还讨论了推理模式的准确性收益与成本代价、选项数量与重命名对结果的影响,并开源了实现与基准代码。

技术 › LLM yibie 2026-09-2814.3 KB 2.8K 17 87

构建实时语音 AI Agent 的四种模式:看、说、想、写代码

本文介绍使用 Gemini 3.8 Live 和 Google Agent Development Kit (ADK) 构建实时保险理赔语音代理的四种核心模式:1)工具标记为 NON_BLOCKING,让代理在执行代码时保持对话流畅,重要信息可打断;2)通过独立记录所见、来电者所述及验证结果,并用第二个模型复核照片证据,避免盲从口头描述;3)一个模型负责通话,后台由七个步骤的 SequentialAgent 团队异步整理理赔文书;4)模型负责理解对话,Python 负责执行金额、日期、安全等硬性规则。文章包含完整开源代码和本地运行指南。

技术 › Agent Google Cloud Tech 2026-09-258.6 KB 32.5K 229 84

Qwen 发布会观察:从模型训练到芯片协同的完整研发体系正在形成

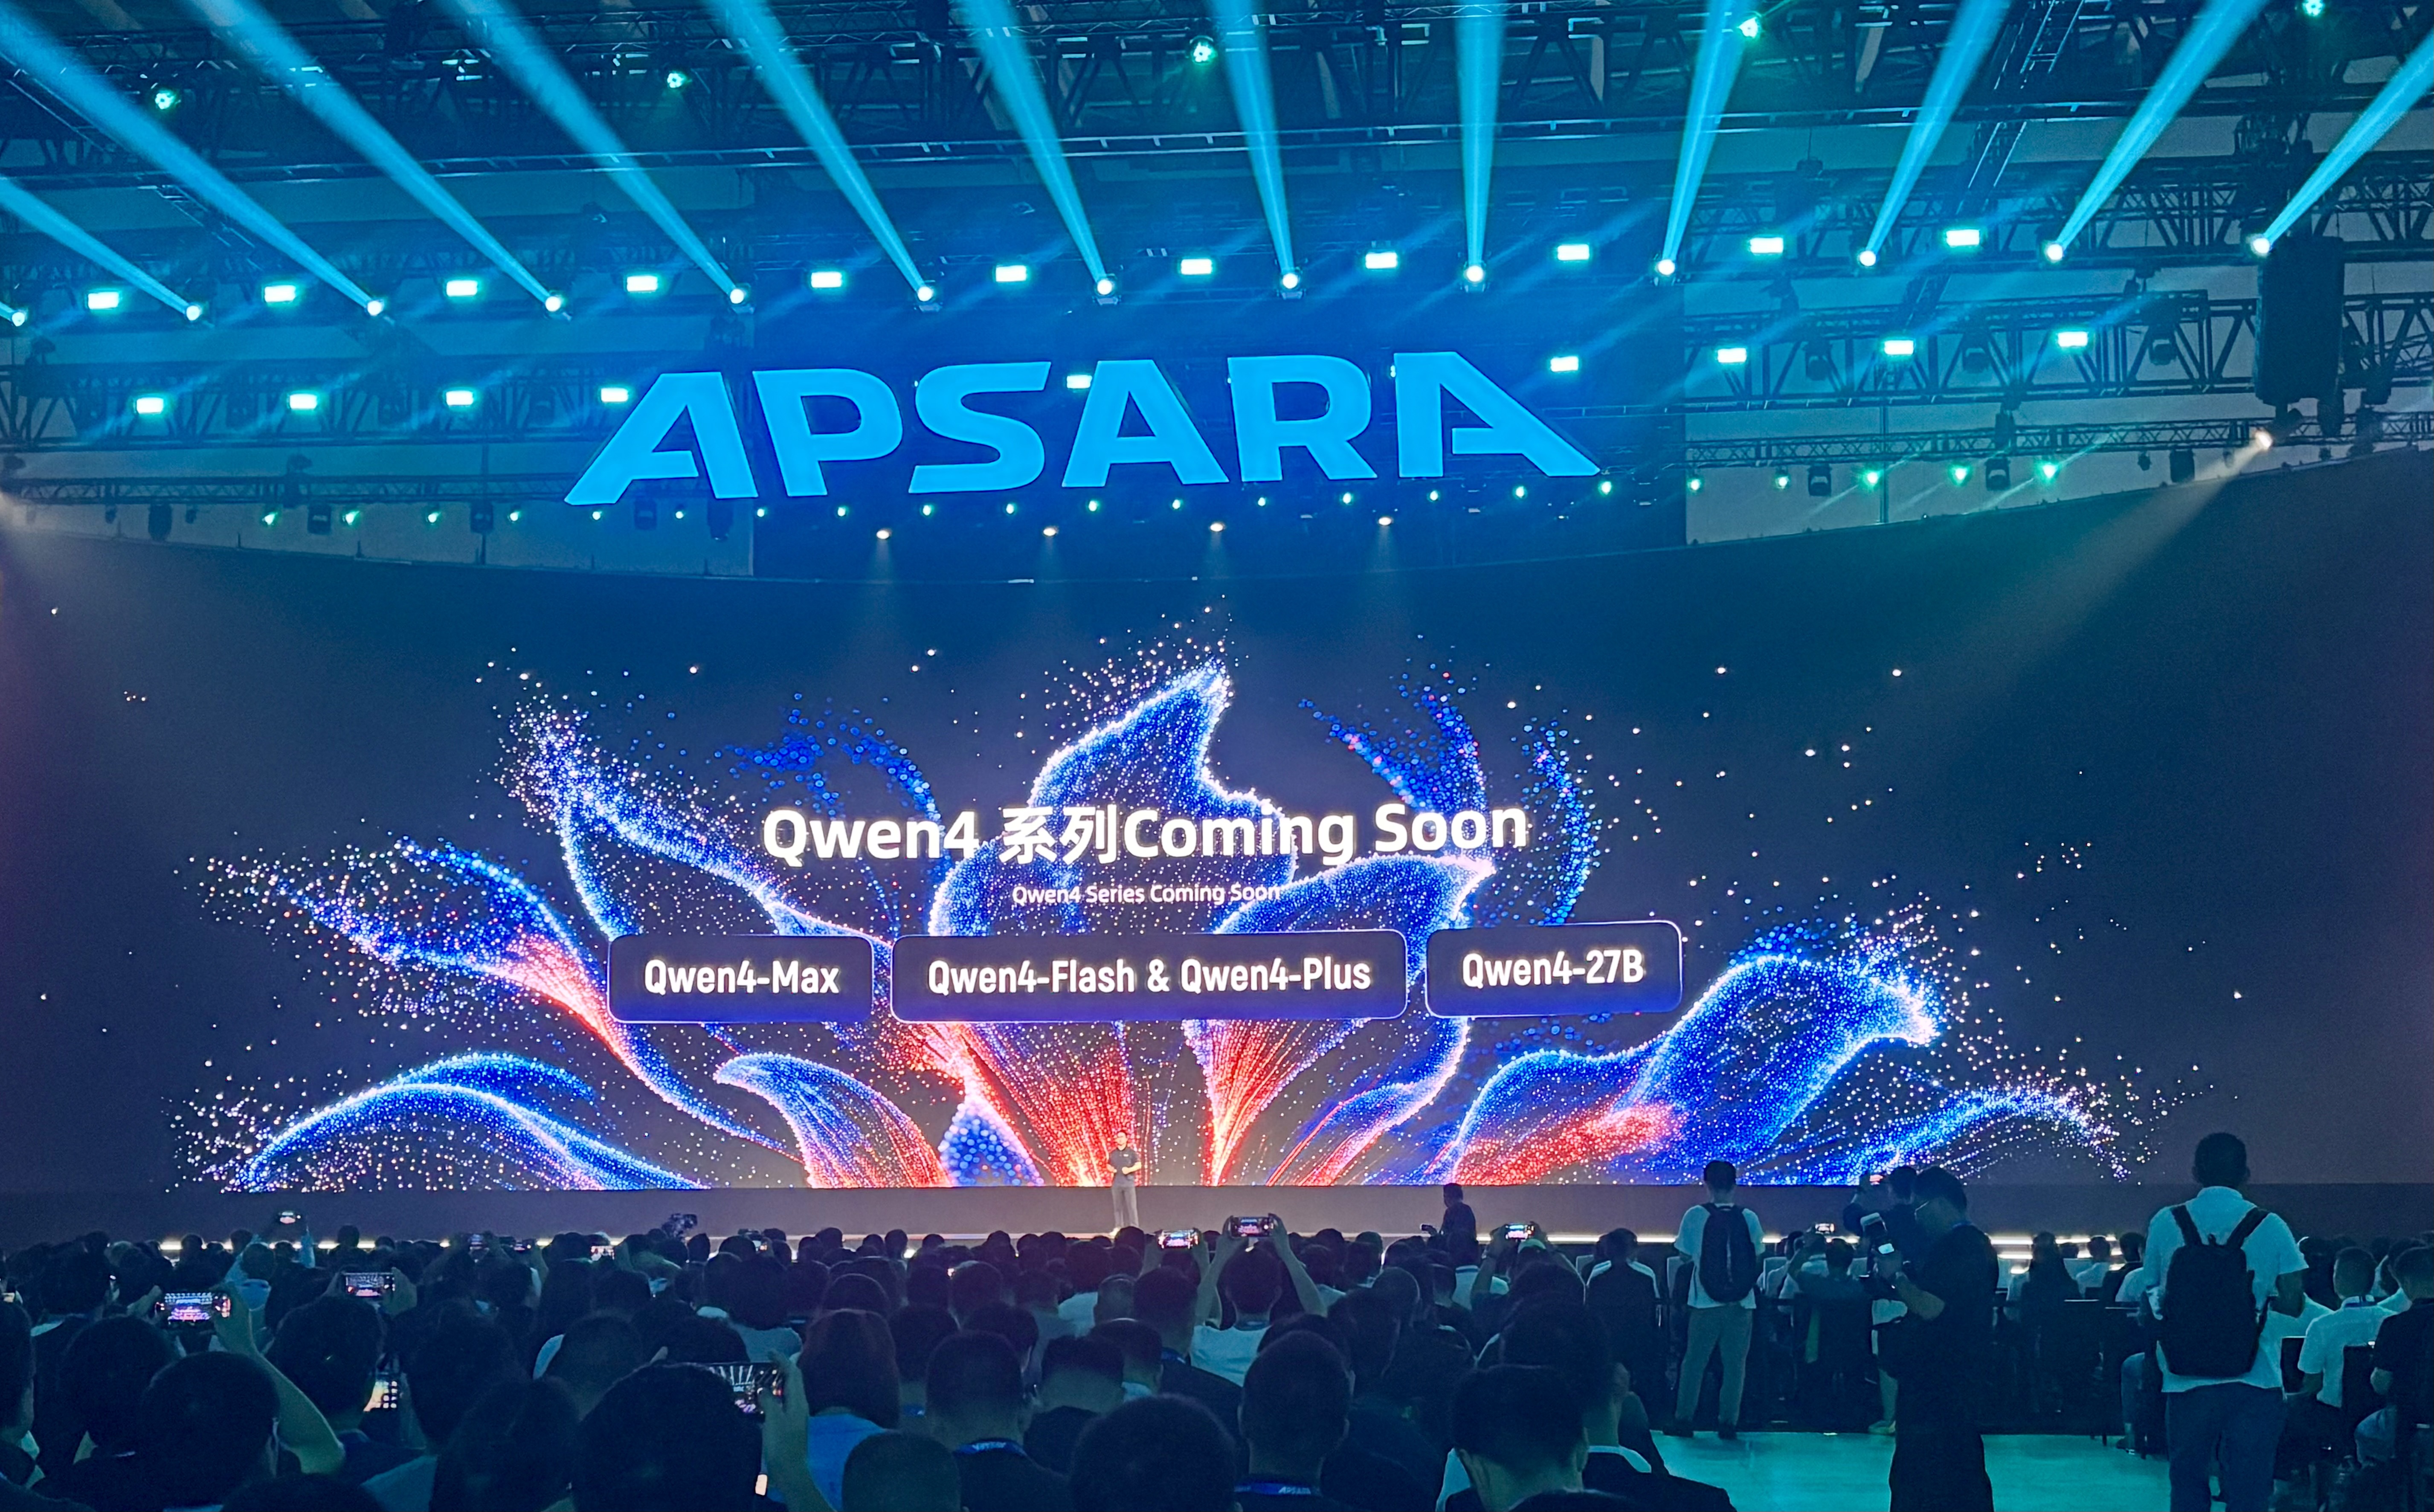
作者总结了 Qwen 发布会的重点:除了新模型外,更值得关注的是 Qwen 形成了从模型训练、推理优化到芯片协同的完整研发体系。核心亮点是 RSI 递归自我进化,Qwen3.8-Max 在少人工干预下连续运行一个多月完成 33 轮迭代,包括自主优化 SGLang 提升 96% 吞吐、芯片设计中减少 42% 物理实现面积。Qwen3.8-Omni-Flash 统一多模态理解框架支持 1M 上下文,价格大幅下降约九成。Qwen4 已开始训练,未来参数量将扩展到 5 万亿至 10 万亿。开源生态方面,累计下载超 30 亿次,衍生模型超 30 万个。

技术 › LLM Ding (@dingyi) 2026-09-233.0 KB 63

一年之间,云栖大会里的 AI 到底进步了什么?

文章对比2025与2026年云栖大会,梳理AI一年间的进步:从'云智一体'到'智以致用',重点从模型能力展示转向产业落地。Qwen3.8-Max主打长程任务执行,Qwen3.8-Omni-Flash在多模态理解上大幅提升且成本骤降;Agent从聊天进入工作流,具备拆解目标、多智能体协作、沉淀Skill等能力;具身智能与AI硬件走向现实。对内容创作者而言,生产模式正从单模型生成片段走向多模型协同的完整生产链,Qwen4与下一代视频模型值得期待。

技术 › LLM siuser小伟 2026-09-227.0 KB 972 5 74

万字长文:通宵评测Qwen-Image-2.1

作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。

技术 › LLM 实践哥 Li 2026-09-2118.2 KB 525.6K 599 90

三个月,豆包大模型进化了多少?7个案例实测

作者通过7个实际案例测试豆包 Seed-2.1-pro-0915(Doubao-Seed-Evolving)的进化效果,涵盖深度调研 Obsidian AI 插件 Top20、根据视频演示开发跨平台剪贴板应用并改造成 Swift 原生版、Blender 3D 白模驱动视频生成、天津海钓点调研与导航地图制作、电影3分钟解读视频剪辑、3.5万行代码仓库分析等任务。作者感受:多模态理解能力显著提升,Agent 长程任务可靠性增强,但仍存在文案质量和迭代准确性等不足。

技术 › LLM 向 向阳乔木 2026-09-1711.8 KB 25.4K 18 78

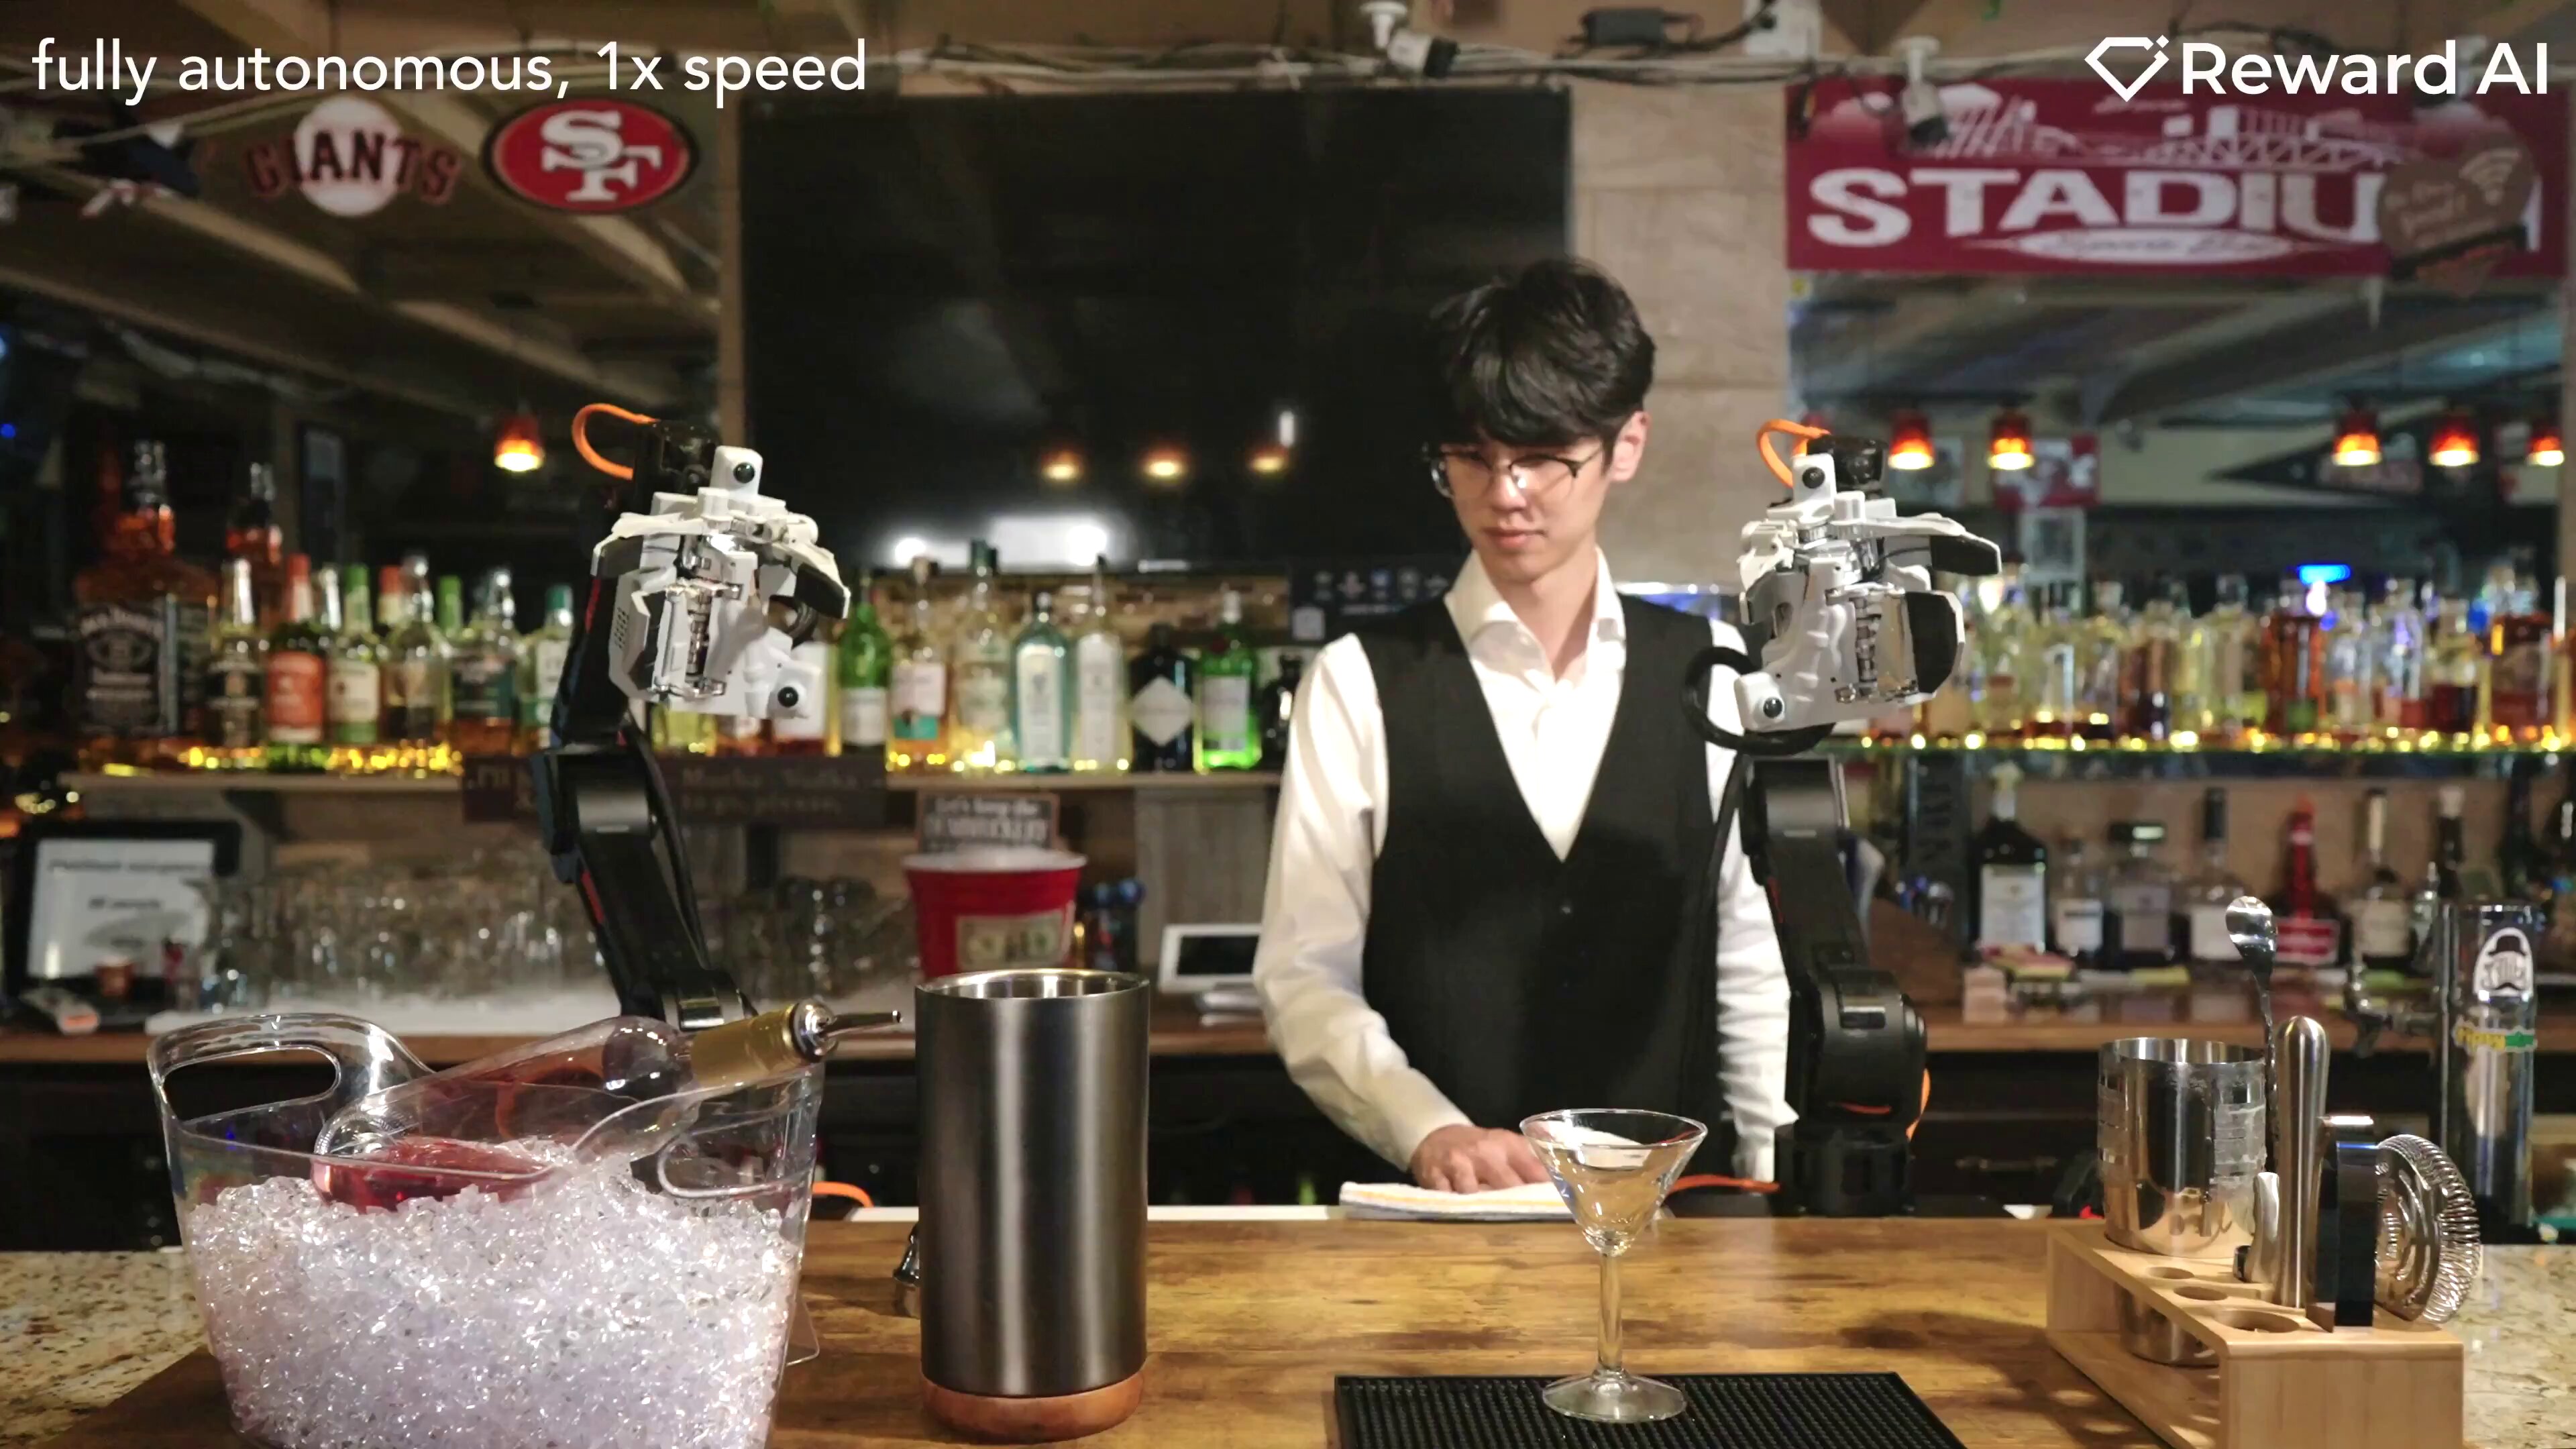
Reward AI 发布机器人基础模型 OM-1:直接从人类操作数据学习

Reward AI(脱胎于斯坦福 DexCap 项目)发布机器人基础模型 OM-1,核心创新是仅从人类操作数据中学习,无需遥操作和机器人专属数据。通过 7 自由度可穿戴设备 Omnibody Hand 采集视觉、触觉、力度等多模态数据,训练后可直接部署到桌面机械臂、工业机械臂和人形机器人,无需针对硬件微调。这与 π0、Helix 等依赖遥操作数据的主流方案路线不同,大幅降低数据采集成本。演示显示 OM-1 能完成四臂协作包装手机、调酒、叠衣、拔网线等精细任务,学习新任务仅需不到 30 分钟人类演示数据,并展现自发补偿与重试行为。目前处于研发展示阶段。

技术 › LLM 宝玉 (@dotey) 2026-09-152.8 KB 70

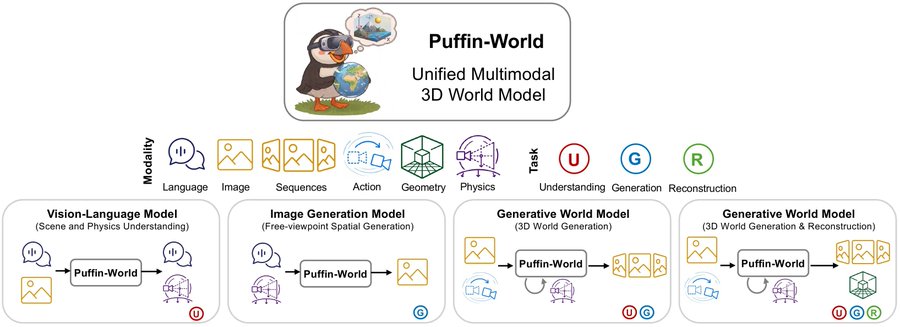
面向空间智能的统一世界模型Puffin-World:从生成画面走向构建物理可信世界

南洋理工大学S-Lab与大晓机器人等机构发布统一世界模型Puffin-World,让同一模型原生理解物理方向、空间几何和视觉外观,实现三维世界生成与重建,无需依赖外部模型。模型将世界表示为物理状态(重力场、纬度图)、几何状态(深度)和外观状态(RGB)三种关联状态,并提出Omni-Camera统一相机表示,结合绝对与相对相机信息。该框架在表征、模态、任务三个层面实现统一,支持相机参数估计、自由视点生成、3D场景重建等任务,并构建了包含1500万组视觉-语言-相机数据的Puffin-16M数据集,在多个基准上取得领先结果。

技术 › LLM 青稞社区 2026-09-1313.4 KB 1.4K 5 71

我用Ling-3.0-flash-VL把学习视频拆成能可动手的实验

作者利用蚂蚁百灵多模态大模型Ling-3.0-flash-VL开发了Course Rebuilder,将B站收藏的《从函数到Transformer架构》网课重构为10个可交互实验,涵盖从函数拟合到Transformer组装的完整因果链。模型能精准解析视频片段,提取讲解概念、画面证据和先修知识,并给出交互改造建议,推理延迟仅1.1-1.3秒。该工具将被动听课转化为主动探索,支持跳转原片和AI助教答疑,显著提升学习吸收率。

技术 › LLM 睿奇Re7 2026-09-119.0 KB 16.6K 102 73

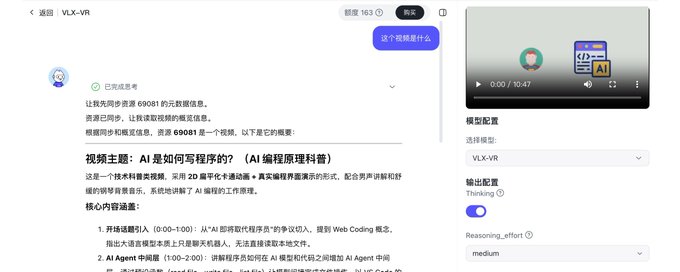
VLX-VR:长视频推理超越Gemini 2.5 Pro的新模型实测

作者实测OmAI联汇新推出的视频深度推理模型VLX-VR,该模型在MINERVA基准上以78.8%准确率登顶,超越Gemini 2.5 Pro的57.97%。通过3D机械起落架演示、9倍速工业建模录屏、机械臂四宫格实验等场景,VLX-VR展现出对长视频时间轴的整体理解、因果推演和代码报错捕捉能力,推理逻辑一致性达96.2%,且跨时长准确率不降反升。作者还介绍了基于该模型的端侧视频创作助理OttoBox小欧,可30分钟完成粗剪。

技术 › LLM 卡尔的AI沃茨 2026-09-1112.0 KB 5.5K 7 73

当大模型开始真实操作 Blender 与 CAD:Nex-N2.5 Pro 实测,兼谈 Computer Use 的工程边界

作者实测了主打 Computer Use 能力的 Nex-N2.5 Pro 模型(397B 参数),验证其在 Blender 3D 建模到 Three.js 前端交互网页的全自动长流程操作。测试显示其能在无 API 的桌面 GUI 中完成建模、材质设定、glTF 导出及前端渲染,全流程 1 分 48 秒,坐标对齐率 99.4%,60 FPS 稳定渲染。文章同时指出其工程边界:单步延迟 2-4 秒、视觉遮挡下的重试开销高。作者建议结构化任务优先用 API 与代码,而无接口的专业桌面软件自动化、遗留系统对账等场景则适合切入 Computer Use。

技术 › Agent Charles在路上 2026-09-118.1 KB 5.1K 43 75

GPT-Image 2.5 玩法全公开:从个人表情包到电商动态广告(附提示词教程)

作者基于 OpenAI 最新发布的 GPT-Image 2.5 模型,实测整理了从个人娱乐到电商应用的多种玩法,并提供完整可复制的提示词教程。个人玩法包括:将上传图片转为弹跳动画 GIF、生成九宫格表情包、制作六帧连续动作表情 GIF 等。电商玩法包括:商品慢扫光动态广告制作(采用单张商品底图加 Python 扫光方案,解决瓶身、Logo、文字抖动问题),以及利用定稿海报模板进行商品换款的精确编辑。文章详细说明了多轮编辑、模板复用、帧间一致性等新版本能力,并给出大量经过验证的中英文提示词模板,帮助普通用户快速上手图像生成与动态内容创作。

技术 › 工具与效率 Adrian Punk 2026-09-1130.4 KB 262.6K 1K 81

DeepSeek-V4.1-Flash 发布:更聪明、更快速、更高效

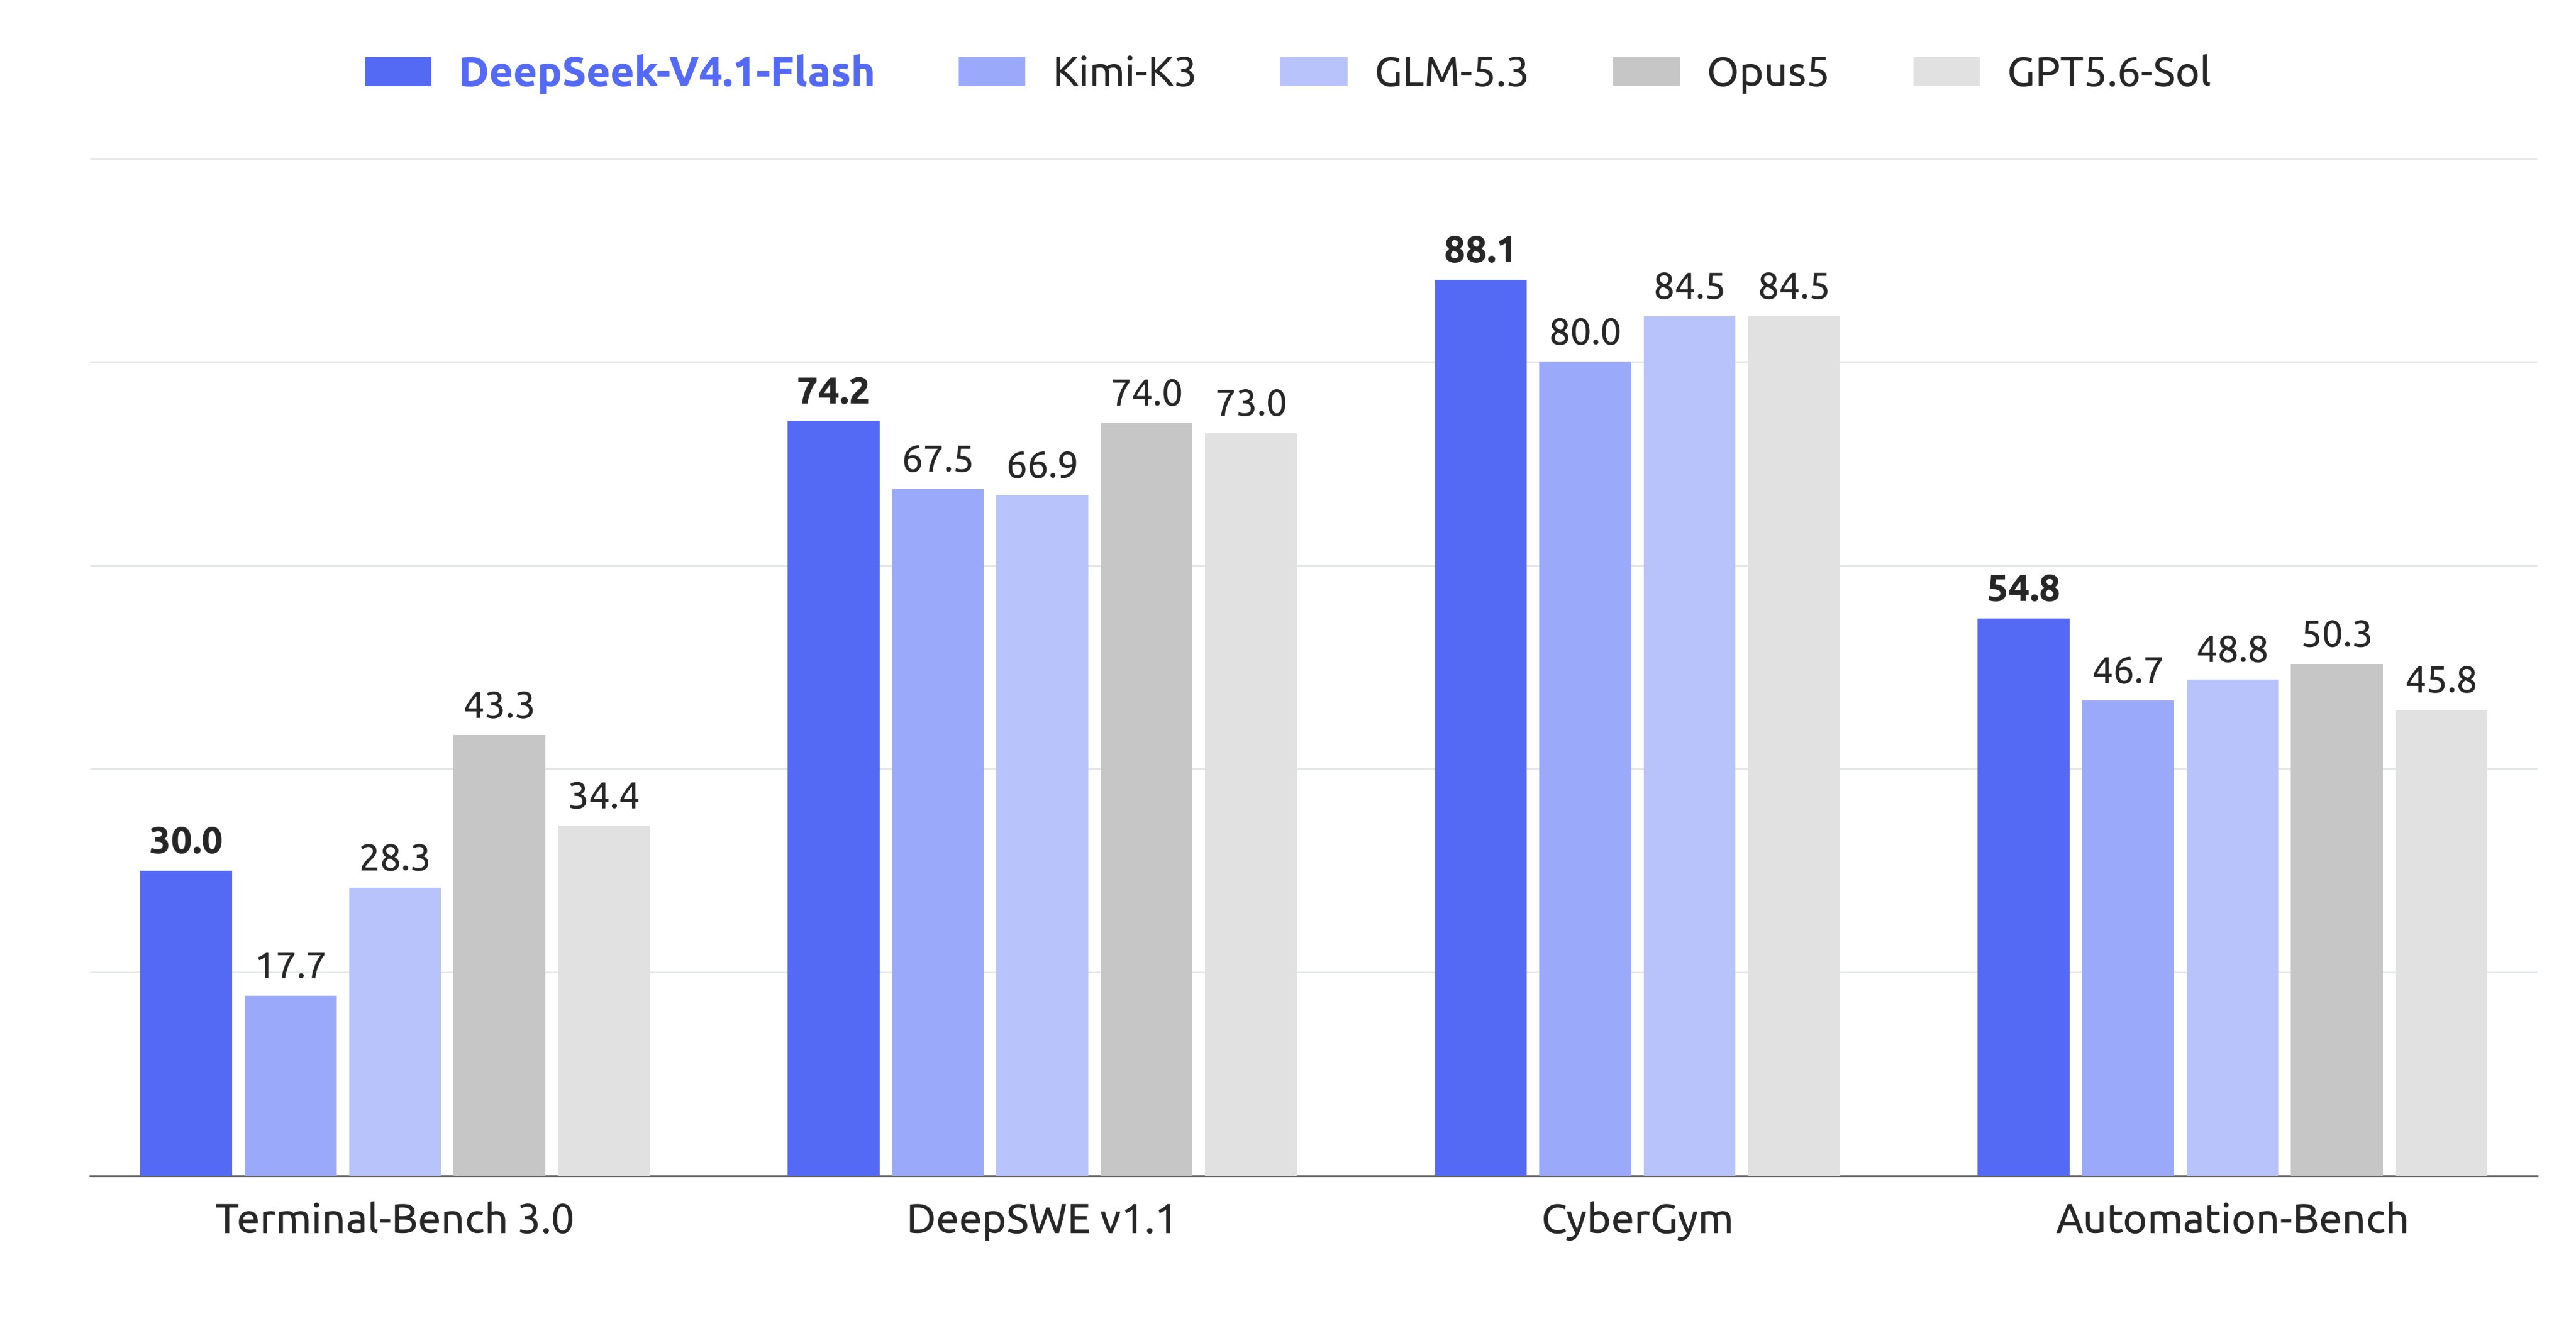
DeepSeek 发布新架构家族中最小的模型 V4.1-Flash,具备原生视觉理解能力。该模型采用非对称因果编码器-解码器架构,552B 参数 MoE,仅 8B 激活参数用于输入、16B 用于输出,通过新预训练方法和大规模 RL 后训练,性能超越旗舰模型 V4-Pro。KV 缓存仅需前代 1/4 的 HBM 和 1/8 的 SSD 存储,大幅降低 Agent 成本。模型已上线 DeepSeek API,支持多模态,API 价格下调,非高峰时段费率为峰值的 50%。官方将与开源社区合作推进推理支持,模型已在 HuggingFace 开放。

技术 › LLM DeepSeek (@deepseek_ai) 2026-09-103.3 KB 73

DeepSeek V4.1 Flash 正式发布,全面超越自家 Pro 模型?实战测评

DeepSeek 发布 552B 参数的开源 MoE 模型 V4.1 Flash,原生支持多模态视觉理解,官方称其性能、费用、速度全面超越 V4 Pro,V4 Pro 将于 9 月 14 日下线。作者通过两个实战项目(3D 程序化城市生成器、基于 draw.io 的 AI 智能绘图工具)横向对比 V4.1 Flash、V4 Pro 和 GLM-5.3-Flash。结果显示 V4.1 Flash 完成度最高,输出速度达 287 TOK/s,成本仅约 5 元/项目,多模态能力让前端开发质量明显提升,最终结论是梁神回归,可重新推荐为日常 AI 编程模型。

技术 › LLM 程序员鱼皮 2026-09-1012.8 KB 4.8K 12 73

起底美国大豆包:我看看谁还喷Gemini

作者基于几个月的实际使用体验,为Google Gemini正名,介绍了三个好用的工具:网页版Gemini速度极快、多模态能力强,适合处理长PDF、长视频等海量内容,回答风格自然有人味;Antigravity改版为Agent终端后掌控感下降,但前端交互和多模态理解依然出色;NotebookLM被作者誉为封神的第二大脑,可聚合各类资料建立个人知识库,无幻觉输出,还能生成PPT报告、知识导览图,以及将专业文档转为双人访谈播客,极大提升学习和工作效率。作者最后给出了三工具的日常使用搭配建议。

技术 › LLM Erwin 2026-09-077.2 KB 21.1K 35 72

构建你的 AI FDE 能力入门篇:0x05 多模态数据平面(MMDP)

本文介绍 Palantir 的多模态数据平面(MMDP),一种开放式数据与计算架构,旨在解决分析系统与运营系统之间的结构性矛盾。MMDP 核心哲学是“任意数据、任意计算、任意模型、任意环境”:以 Apache Iceberg 等开放格式支持结构化、非结构化、时序、地理空间等多模态数据接入;基于 Kubernetes 的 Rubix 计算网格提供 Spark、Flink、DuckDB 等多种运行时,并支持自带计算(BYO Compute);模型目录涵盖 OpenAI、Anthropic 等厂商模型及企业自有模型,实现统一治理。文章强调通过开放性与虚拟化,将企业既有资产逐步连接为可供 Ontology、应用和 AI 智能体复用的运营能力。

技术 › LLM Mens@cc.codesome.ai 2026-09-035.4 KB 606 63

Gemini 推出 Agentic 视频理解能力

Google 在 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 模型上推出 agentic video understanding(智能体式视频理解)功能。该功能让模型主动决定观看内容、速度和模态(画面、音频或字幕),动态检索和检查视频片段,而非按固定帧率静态处理。基准测试显示,成本最高降低 66%,token 消耗最高降低 88%,准确率提升最高 7%,在长视频分析中优势尤为明显。新能力包括亚秒级片段检索、长视频大海捞针式搜索、异常检测和精确计数等。该功能已通过 Gemini API、Google AI Studio 和 Gemini Enterprise Agent Platform 开放,未来将集成到 Gemini 应用和 YouTube 的 Ask YouTube 功能中。

技术 › LLM Google AI Studio 2026-09-028.7 KB 67.4K 856 78

Grok Bot for Engineering:用 AI 机器人团队重构工程工作流

SpaceXAI 工程师 Lingxi Li 分享了用 Grok Bot 构建和管理工程机器人团队的经验。他将 Grok Bot 视为能干的技术实习生,可管理多个编码代理并从工作方式中学习。文章介绍了五个各司其职的工程师机器人(覆盖 iOS、桌面端、Android、基础设施和 Harness),以及负责运营的 Jenny 机器人。通过 Notion 数据库、Cursor 云代理、截图验证等多模态反馈闭环,机器人团队可同时管理 200+ 云代理,自动完成 CI 检查、代码审查和 PR 合并,显著提升团队交付速度和效率。

技术 › Agent Lingxi Li 2026-09-0114.0 KB 1M 3.7K 74

BestBlogs 早报 · 09-01|OpenClaw 2.0协作,AI 应用护城河交付,ClickHouse控成本

本期早报围绕 AI 应用的规模化落地展开三层分析:OpenClaw 2.0 以 16000 个 PR、933 位贡献者的超大版本更新,展示智能体如何从个人工具成长为支持共享云会话与任务无损交接的团队协作平台;屠龙之术借 Canva、Figma 与美图的案例,讨论基础模型吸收单点功能后,应用公司如何通过任务拆解、结果控制和完整交付建立护城河;ClickHouse CEO 则谈智能体带来的不可预测并发查询、成本控制与身份权限治理等基础设施挑战。速览部分还涵盖 DeepMind 多模态世界模型、Odersky 谈 AI 时代编程语言、DoorDash 工程代理平台、LLM 编码评估、量化研究 Agent、算力供需与病理基础模型等内容。

技术 › Agent ginobefun 2026-09-0129.2 KB 3.8K 3 85

爆火的《牛来》模型正式发布!GLM-5.3-Flash 实战测评

匿名爆火的「牛来」模型 Ox-Alpha 揭晓身份,是智谱的首个原生多模态模型 GLM-5.3-Flash。仅 320B 参数(激活 18B),能力对标 Claude Opus 4.8,价格仅其 1/40,MIT 协议开源,跑在 10 万张国产芯片上。作者使用智谱官方 Harness 工具 ZCode 进行三个项目实测:复刻 Apple Vision 产品页、开发全栈 AI 绘图工具、制作 3D 联机对战游戏《牛来格斗》。测评显示其视觉理解与截图自主验证能力对 AI 编程体验提升巨大,长程任务稳定,但实时网络同步等后端难点仍有不足。

技术 › LLM 程序员鱼皮 2026-08-2818.9 KB 14K 9 72

爆肝3天,开源AI原生截图神器:拓!可以塞进任何Agent使用~

作者袋鼠帝开发并开源了一款AI原生截图工具“拓(Ta)”,具备钉图、标注、马赛克、截长图等常规功能,并深度集成AI能力:框选即可OCR识别文字、翻译并自动复制到剪贴板,还支持AI识图。拓可作为skill或CLI接入任何Agent(如Codex),实现自动截图获取报错信息等自动化流程。开发过程使用智谱最新开源模型glm-5.3-flash,作者评价其coding、agent与视觉能力出色,价格仅为Opus的1/40,兼具速度、性能与性价比,标志前沿模型进入普惠时代。

技术 › Skill 袋鼠帝 2026-08-2710.6 KB 1.9K 10 69

智谱GLM-5.3-Flash发布:真正的智能平权

文章揭秘了海外爆火的匿名模型OX Alpha的真实身份——智谱发布的GLM-5.3-Flash。该模型是总参数320B、激活18B的MoE架构,GLM-5系列首个原生多模态模型,支持图像、视频和文本输入,上下文达100万。其能力逼近Opus 4.8,而价格极低(每百万Token输入0.8元、输出2.8元),比DeepSeek V4还便宜一半。作者通过自建1000条新闻评测集实测发现其在精选率和品味上优于MiMo 2.5 Pro和DeepSeek V4 Pro,前端代码能力也直逼顶级模型。此外,智谱用10万张国产卡扛下了匿名测试期的全部推理流量。作者决定将AIHOT网站模型全面切换至GLM-5.3-Flash。

技术 › LLM 数字生命卡兹克 2026-08-2714.1 KB 44.9K 123 72

对标 Opus 4.8,价格只有 1/40,“牛来”模型 GLM-5.3-Flash 实测

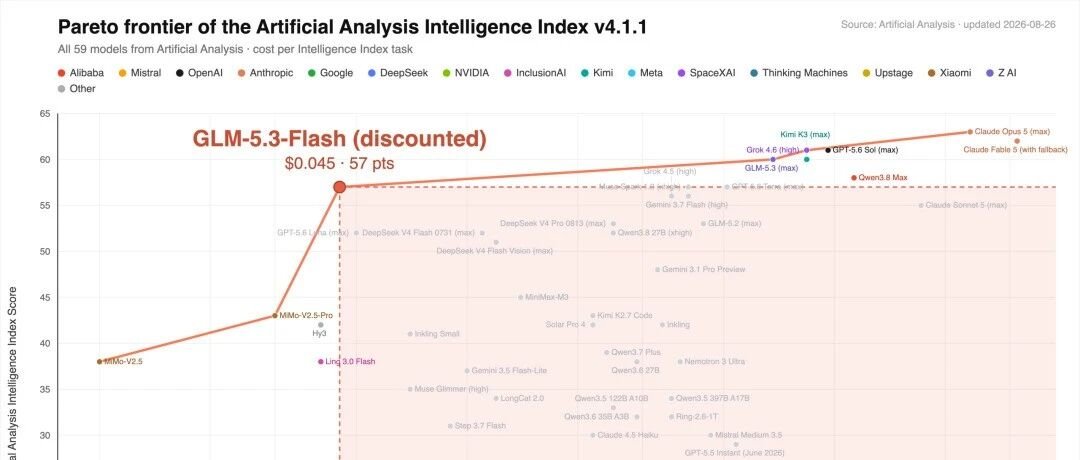
智谱发布 GLM-5.3-Flash 模型(320B 总参数、仅激活 18B),即此前在 X 上爆火的匿名“牛来”模型。其 AA 综合智能指数达 57 分,与 Opus 4.8 相当,但价格仅为后者的 1/40,并采用稀疏注意力+线性注意力混合架构,由国产芯片支撑全部线上推理流量。作者通过多个实测案例展示模型能力:一句话从 PDF 生成企业官网、生成带真实图片的 PPT、模拟 Omarchy Linux 界面、构建在线 Excel、开发多款小游戏,以及用多模态能力自动剪辑《楚门的世界》电影解说视频。文章认为该模型以架构创新和国产算力打破了“前沿模型必然昂贵”的逻辑,且已以 MIT 协议开源。

技术 › LLM 向 向阳乔木 2026-08-2715.3 KB 26.7K 22 77