Wiki 知识库

全部文档 / 作者: huangserva (@servasyy_ai)

35 篇
清除

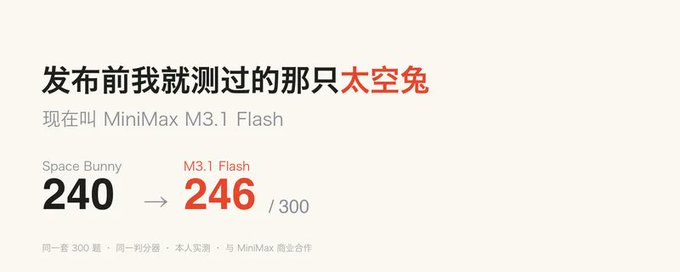
发布前我就测过的那只太空兔(Space Bunny),现在叫 MiniMax M3.1 Flash

作者在 MiniMax M3.1 Flash 还以匿名模型 Space Bunny 身份活跃时,用自己维护的 300 题封闭测试集(HumanEval+/MBPP+ 代码题与 MMLU-Pro 推理题)进行了评测,匿名期得 240 分。正式版发布后用同一套题复测得 246 分,两版表现几乎一致,主要提升在代码题。代码能力与 DeepSeek V4.1 Flash-1017 基本打平;官方数据显示其在企业流程自动化和操作电脑两项为国产第一,且成本显著低于 Claude Opus 5。短板是困难推理。整套 300 题成本仅一元出头,性价比突出。

技术 › LLM huangserva 2026-10-2410.5 KB 36K 29 81

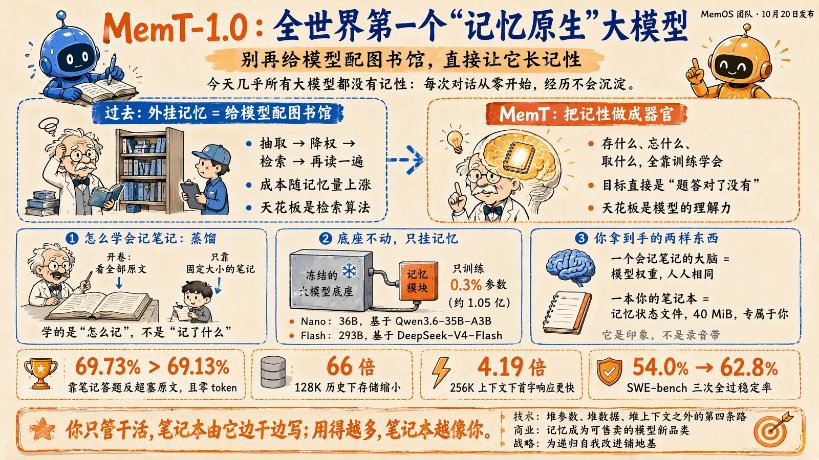
全世界第一个记忆原生大模型 MemT-1.0 上线

MemOS 团队发布全球首个“记忆原生”大模型 MemT-1.0,将记忆能力直接训练进模型权重,取代 RAG、Mem0 等外挂记忆方案。其思路是不改底座、参数冻结,仅在部分层并联约 1.05 亿参数的记忆块,通过蒸馏训练让模型自学“什么该记、什么该忘、怎么取用”,优化目标从检索命中率改为任务答对率。交付物包括通用模型权重(会记笔记的大脑)和用户专属记忆状态文件(仅 40 MiB 的笔记本)。数据显示其 40 MiB 记忆答题成功率 69.73%,略高于全量上下文的 69.13%,存储缩小 66 倍、首字响应快 4.19 倍。已在 Hugging Face 和 GitHub 开源,被视为开启模型“在使用中变强”的第四条技术路线。

技术 › LLM huangserva (@servasyy_ai) 2026-10-218.8 KB 73

给科学家用的 Claude Code:本地跑、可追溯、能换引擎的 Open-Science 实测

文章实测了新加坡 AIPOCH 团队开源的科研 AI 工作台 Open-Science,它以 Claude Code、Codex 等为可替换引擎,外覆科研专用壳层。针对科研三大痛点——文献易被 AI 编造、敏感数据不能出本地、图表无法溯源——该项目提供 36 个科学数据库连接器、本地数据存储、不可篡改的执行记录与血缘图,并支持通过 .science 文件包(基于 RO-Crate 开放标准)导出完整研究过程供他人复现。作者以复现一篇基因表达分析论文为例,验证了差异表达分析与火山图生成,并用独立 AI 审查员完成交叉核验,展示了可复现、可交接的开源科研工作流。

技术 › Agent huangserva 2026-10-1926.3 KB 13.4K 49 85

把 96.5GB 的 GLM-5.3-Flash 塞进单张 4090 48GB,跑出 41.8 token/s

本文记录了在单张魔改 RTX 4090 48GB 上,通过系统级调优将 96.5GB 的 MoE 模型 GLM-5.3-Flash 推理提速至 41.8 token/s 的完整工程实录。作者采用混合 i-quant 量化,将 12,096 个专家常驻显存与锁页内存,通过实测发现减少 CPU 线程反而提升 42% 速度、扩大显存池至 46GB 带来质变、以及激进的 PCIe 搬运策略是致命代偿陷阱。文章逐毫秒拆解了 24.47ms 的 token 耗时去向,指出 PCIe 搬运是硬瓶颈,并对比了更稀疏的 Qwen3.8-Flash-Next 架构可达 120 tok/s 的原因。

技术 › LLM huangserva 2026-10-1217.6 KB 9.3K 57 89

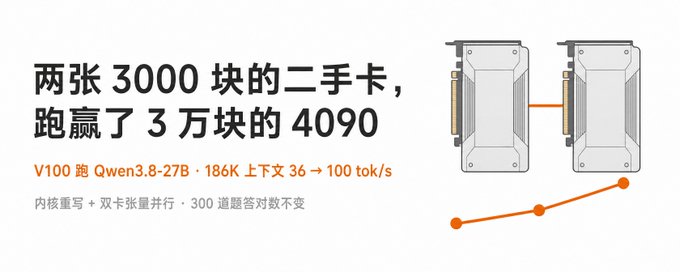
万字爆肝长文丨两张 3000 块老卡跑赢 3 万块 4090 48G:一次讲透怎么老显卡把 Qwen3.8-27B /NInfer跑到极致

作者详细记录了用两张二手 V100(各 3000 元)运行 Qwen3.8-27B 大模型的完整优化过程。V100 是 2017 年的数据中心显卡,HBM 显存带宽实测达 1004GB/s,甚至高于 4090。文章先建立测试口径与性能分析框架(读权重与读 KV 缓存两笔账),逐步排查瓶颈:验证带宽不是问题、测试双卡张量并行、分析 PCIe 延迟与 NCCL 版本坑,最终通过重写推理引擎内核、添加双卡支持,将长上下文生成速度从 36 tok/s 提升到 100 tok/s 以上,代码生成速度超过 3 万元的 4090 48G,并成功上线生产环境。文中深入浅出讲解了推测解码、CUDA Graph、内核优化等技术细节。

技术 › LLM huangserva 2026-10-0489.4 KB 141.5K 319 89

Claude 被封号后,我找到了买 Max 成品号+代充值的新路子:Sukai 实测

作者的 Claude Max 20X 账号被封后,因无外币卡、虚拟卡易被风控而难以重新订阅,于是实测了 Sukai 平台的成品号购买与代充服务。文章详细记录了用 OKX Web3 钱包通过 USDT(推荐 TRC20)链上充值、下单 Claude 成品号、等待交付与登录验证的全流程。实测中缺货预订 12 分钟获人工确认,不到 3 小时完成交付,账号含 2FA 和 Session 可完全接管,但需配置固定代理 IP 才能登录。代充方面 GPT Plus $17/月、Pro 20x $150/月,低于官方价。文章同时提醒封号不在质保范围、建议小额试水等风险,并附赠 OKX 闲置 USDT 生息的小技巧。

技术 › Claude huangserva 2026-09-3010.2 KB 32.5K 90 77

挂着“被冻包赔”,照样冻卡:X(推特)创作者收益和 USDT 怎么安全回国

文章针对 X(推特)创作者收益和持有 USDT 的用户,系统梳理了资金安全回国的实测路线。内容包括:通过 Stripe 绑定港卡或 Wise 收取 X 工资的完整流程;有 ITIN 者可开通 X Money 在国内 ATM 取现;持有 U 的用户日常可用 U 卡绑定支付宝消费(附各卡汇率对比),换人民币则推荐 Neverless、StarryBlu、IBKR、OKX 欧洲站等不经 C2C 的出金路线;入金同样有冻卡风险,可用币安官方法币入金或众安换汇。文章还详细解读了 OKX 冻结赔付准则的条件与时限,并提醒资金来源要合法清晰、留存证据等底线事项。

投资 › 加密货币 huangserva 2026-09-2921.7 KB 51.8K 38 88

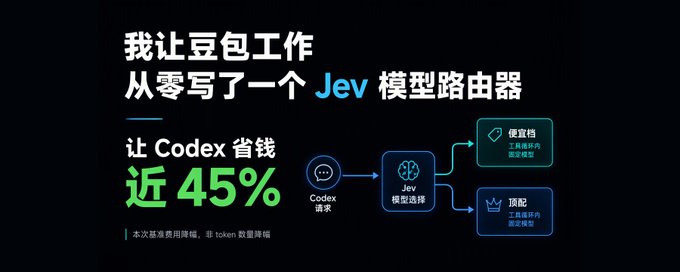
我让豆包工作从零写了一个 Jev 模型路由器,让 Codex 省钱近 45%

作者针对 Codex 账单越来越贵的问题,利用 TypeSafe AI 的 Jev 模型(只做带概率的判断、成本极低)搭建了一个外部模型路由器 HippoRoute-Jev-Codex,仅在线程首请求、新用户轮次、压缩检查点、子 agent 首请求四个缓存重建时机选模型,其余工具循环沿用钉住的模型,避免打掉 prompt 缓存。整个项目由豆包工作通过计划模式和目标模式从零完成,作者全程仅操作四次、未看一行代码,最终 76 个测试全通过并自行揪出 3 个 bug。实测机械任务省 95.4%,子 agent 场景省 79.7%,整体省 44.8%,且任务通过率无差别。

技术 › Codex huangserva 2026-09-2417.9 KB 82K 80 81

拿到 Jev,然后呢?剔掉虚火之后的一份真实落地清单

TypeSafe AI 于 2026 年 9 月发布的 Jev 是一个只做选择题的 AI 模型(单选、打分、是/否),响应 0.07–0.5 秒、输入价格极低、输出免费。作者梳理了官方数据及 Hacker News 上的质疑,指出“Jev 取代大模型”是伪命题,其合理定位是高频、低价地执行小判断。文章按用途分类整理了已真实跑通的案例:为 AI Agent 当决策器、海量数据分类、高低置信度分流混合架构、实时反应界面和仿真实验,并列举了已接入的商业产品。作者还分享了自己四次失败的集成尝试与两轮实测结论,强调概率校准的重要性。

技术 › LLM huangserva 2026-09-1922.2 KB 552.7K 840 85

太让我惊讶了:用 AI Agent 一键克隆 B 站视频源码

作者分享了开源工具 Hypit 的体验:只需提供一条 B 站视频并输入 clone 指令,Hypit 即可生成完整可修改的源码,精确还原视频中对白、变色文字、表情包出现时机等细节。作者随后通过简单指令将人物和背景替换为湖边风景乃至 LOL 角色凯特琳和杰斯的场景,对白字幕保持不变。整个流程成本仅约 4.338 美元。Hypit 定位为给 AI Agent 做视频的开源语言,核心免费、支持 BYOK,项目已在 GitHub 开源。

技术 › Agent huangserva (@servasyy_ai) 2026-09-161.6 KB 50

CMP 170HX矿卡软件解锁:8GB显存解锁到64GB,价格涨三十倍的背后

NVIDIA专为挖矿打造的CMP 170HX矿卡,采用与A100相同的GA100芯片,但出厂通过OTP熔丝、寄存器和PCIe限制被锁死显存、算力和接口。2026年8月,研究员Jon Pry利用Falcon安全协处理器的固件校验时间窗口漏洞,通过ROP链获取执行权并修改PLM寄存器,实现纯软件解锁,开源工具CMPUnlocker可将8GB显存解锁至64GB HBM2e。解锁后带宽媲美RTX 5090,跑LLM推理性能反超4090。MiniMax H3开源引发大显存需求暴涨,卡价从三五百涨至1.4万。但文章也提醒风险:无FP8、无NVLink、驱动受限、HBM颗粒不可维修、价格窗口已关闭。

技术 › LLM huangserva 2026-09-159.2 KB 20.3K 38 81

显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

GPT-6 Astra + Blender:不会三维建模,怎么做出第一个自己的作品?

作者分享了自己借助 GPT-6 Astra 操作 Blender 完成 3D 创作的经历:从 16 分钟做出兵马俑,到搭建秦陵地宫、科幻中庭,最终拼成可疾跑战斗的 3D 游戏。文章介绍了 Blender 的免费开源特性与建模、材质、灯光、动画、渲染等完整流程,指出其可用 Python 脚本控制,因此 Astra 能通过 MCP 连接器写脚本操作软件。作者给出接入步骤、首个咖啡杯场景的提示词范例,并强调人仍需负责检查杯柄连接、构图与灯光等细节。

技术 › 工具与效率 huangserva 2026-09-109.5 KB 22.8K 222 75

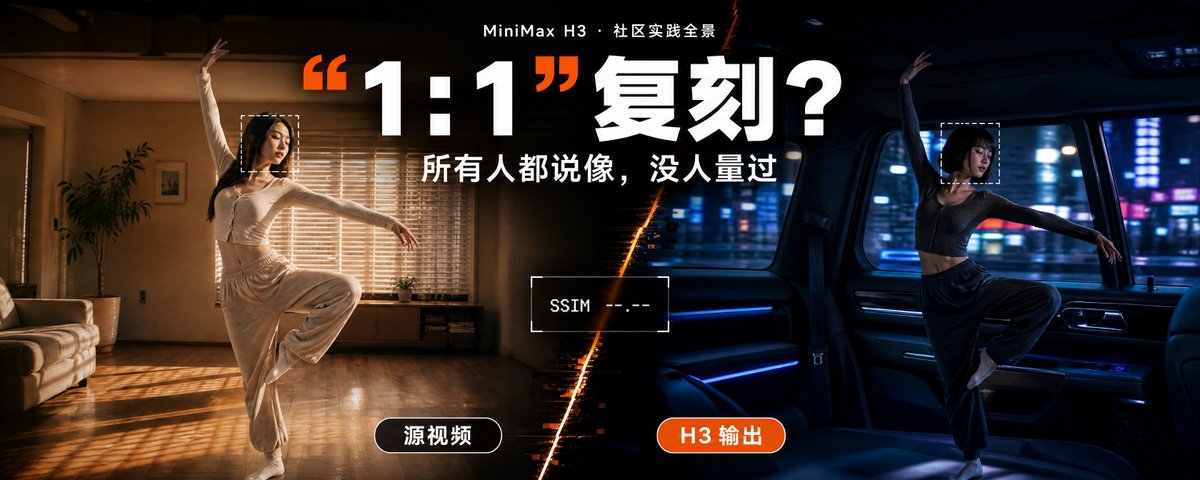
H3 的“1:1”视频复刻与换人换背景:社区实践全景

文章系统调研了截至 2026 年 9 月社区对 MiniMax H3 视频编辑模型(Ref2VA)的实践情况,评估其“1:1 复刻”宣传的真实能力边界。作者按证据可信度分级,指出 H3 是整帧重生成而非像素级复制:换人玩法最热但身份稳定性最弱(约半数会丢身份),社区分化出遮罩合成路线保留背景;换背景最稳定;动作迁移最容易翻车。文章还详解官方六段式提示词规范、可直接套用的换人提示词骨架,并汇总身份、画质、音频、工程规格四类失败模式与硬限制,最后指出社区普遍缺乏 SSIM/MAE 量化验证这一空白。

技术 › LLM huangserva 2026-09-0331.5 KB 43.2K 163 90

用数据库的语言讲透区块链:从链上模型到 OKX AI 交易工具

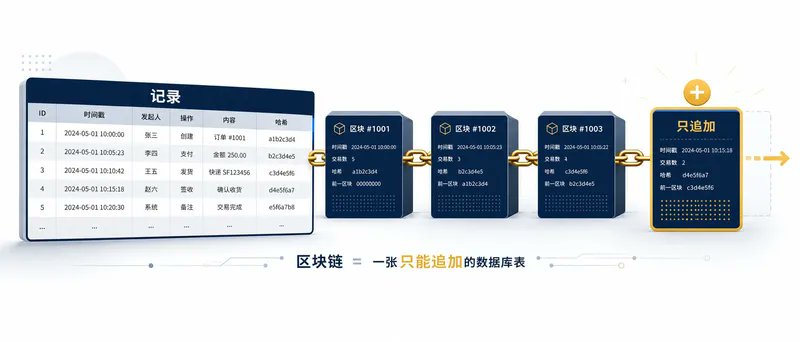
文章面向有编程经验的开发者,用数据库的类比讲透区块链核心概念:链是一个只能追加、不可篡改的数据库;钱包只是存密钥的容器,资产记录在链上账本中;转账是带签名的写请求,Gas 是写入计价与排队机制;智能合约是部署上链的公开代码。作者总结了链与普通数据库的四大区别:写入付费、不可回滚、代码即规则、没有管理员。最后以 OKX 开源的 MCP 工具为例,介绍如何让 AI Agent 安全接入交易所 API,并给出从查行情到模拟盘的上手路径。

技术 › 区块链 huangserva 2026-09-0112.9 KB 57K 24 76

到底谁才是国内模型第一?

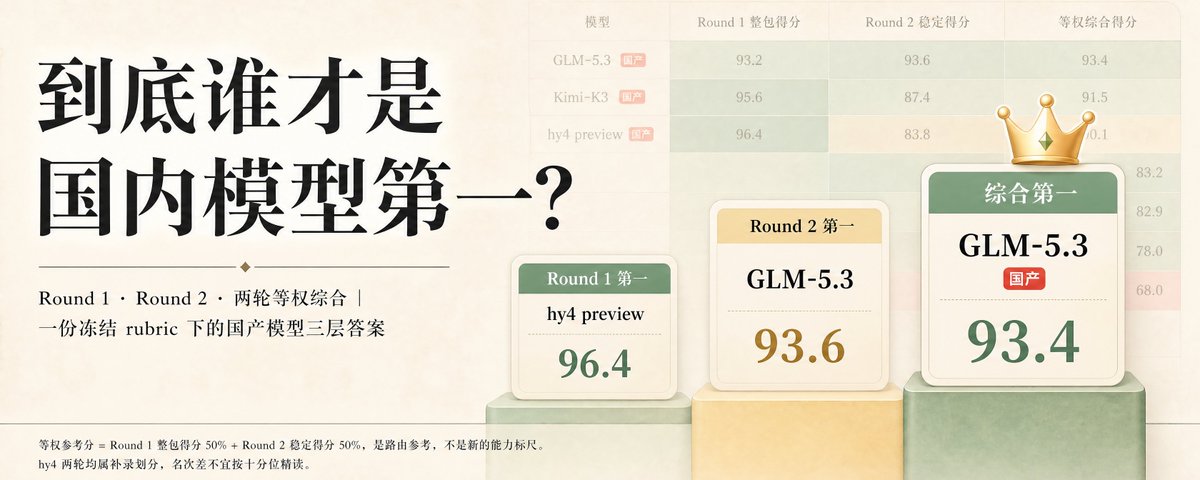
作者基于一份冻结 rubric 的自建评测(10 维 × 5 细项),通过 Round 1 超长整包和 Round 2 拆题稳定两轮测试对比八个大模型。Round 1 整包交付第一是 hy4 preview(96.4 分),Round 2 拆题稳定第一是 GLM-5.3(93.6 分);综合等权评分 GLM-5.3 以 93.4 分居国产第一,Kimi-K3 以 91.5 分列第二,hy4 因拆题时违反约束跌至 83.8 排第三。DeepSeek V4 Pro 与 Qwen3.8 Max 表现偏科,榜单前三均为国产模型。评测题面与方法已开源,结论是决定「第一」的不是最高一次成绩,而是每一次的稳定表现。

技术 › LLM huangserva 2026-08-2910.4 KB 228.8K 66 85

一次性讲清楚 Qwen3.8 27B 的本地部署

本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。

技术 › LLM huangserva 2026-08-2571.4 KB 296.8K 683 91

我扒完了 GitHub 上 55 个 AI 成片产线,得出一个结论

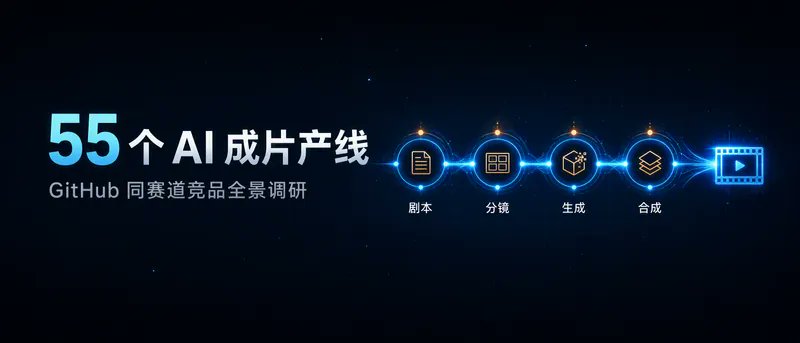
作者为做 skill/agent 驱动的 AI 成片产线,梳理了 GitHub 上 55 个近一个月仍活跃更新的同赛道项目,分为三类:装进 Claude Code/Codex 的视频 skill(28 个)、一站式成片平台(27 个,短剧扎堆)、分镜/导演画布(3 个)。核心判断是:skill 化是最活跃的增量方向,短剧是最卷场景,竞争焦点在编排产线而非模型本身,且窗口期真实存在。

技术 › 短剧 huangserva 2026-08-2521.0 KB 89K 661 76

8款前沿大模型能力横评:10个维度50项测试全解读

本文对8款前沿大模型进行了为期两天的深度横评,通过10个维度、50个细项的两轮测试,对比了模型在一次性复杂任务与拆解任务稳定性上的表现。文章详细解读了测试方法、评分标准及各模型优劣势,最终得出了适用于真实工作流的参考结论。

技术 › LLM huangserva 2026-08-1729.7 KB 30.7K 43 86

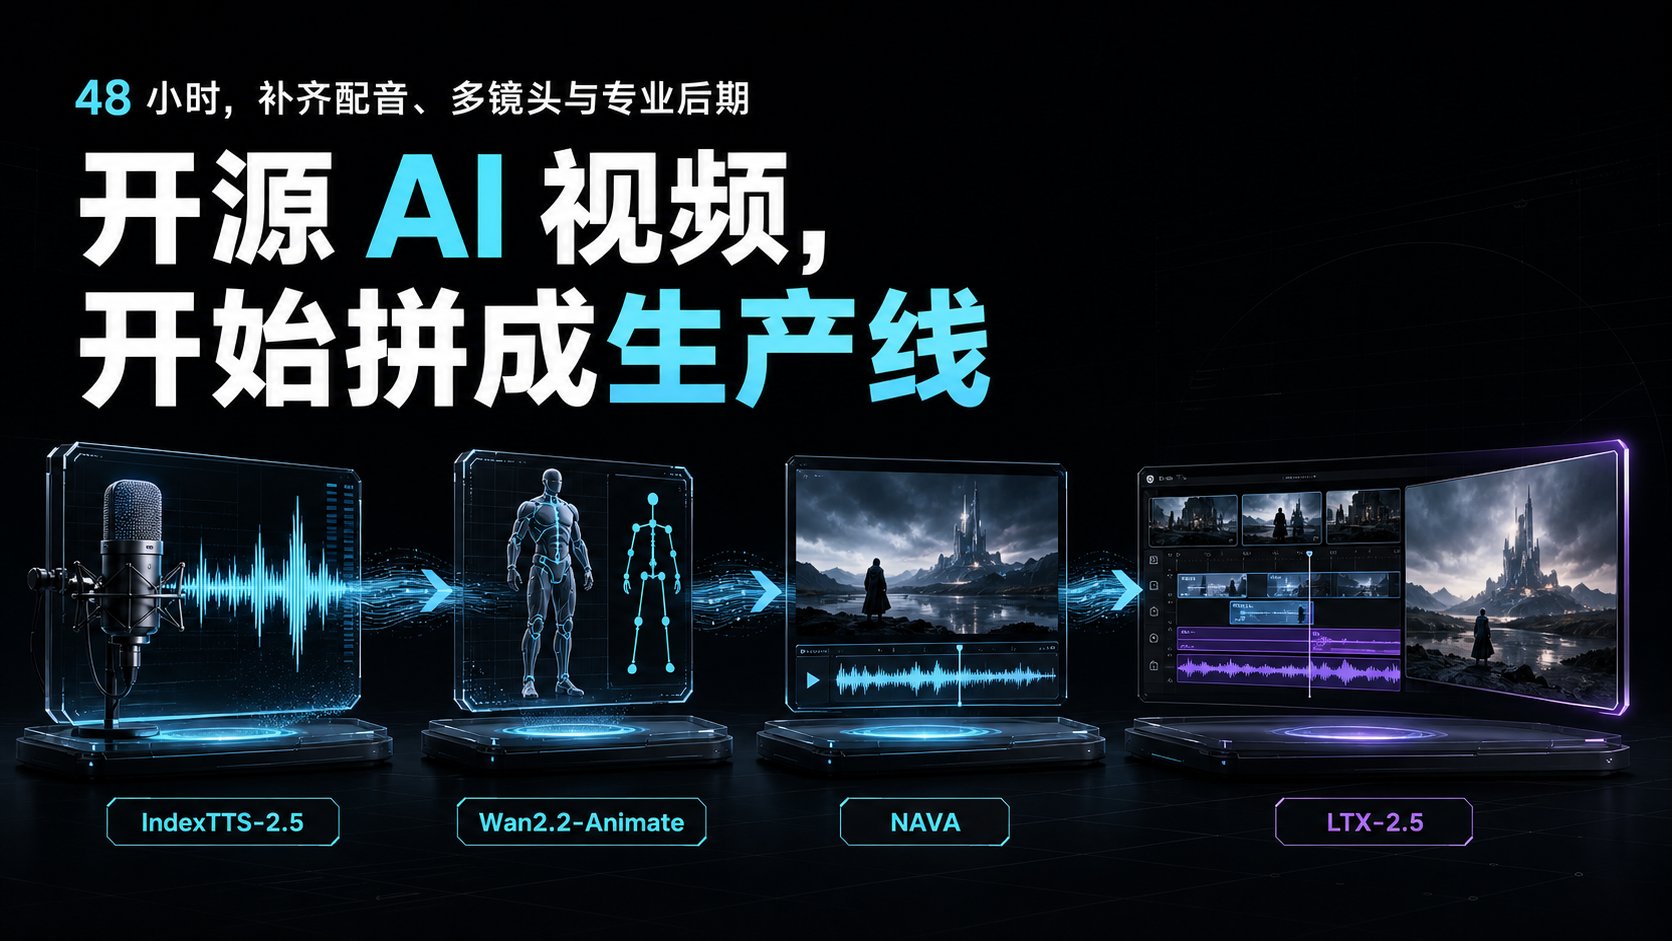
开源AI视频工具大爆发:MiniMax H3、IndexTTS-2.5、LTX-2.5等接连发布

文章介绍了近期开源AI视频和音频工具的密集发布,包括MiniMax H3、IndexTTS-2.5、LTX-2.5、Wan-Animate-2和NAVA等。这些工具覆盖了配音、角色驱动、多镜头和后期制作等环节,标志着开源AI视频从生成短片段向完整生产流水线转变。作者强调了各工具的特点,如IndexTTS-2.5的音色克隆和情绪控制,LTX-2.5的原生多镜头支持,以及NAVA的同步音画能力,并表达了对开源社区活跃度的欣喜。

技术 › TTS huangserva (@servasyy_ai) 2026-08-122.1 KB 65

发一条 iMessage,让 AI 替你玩手机:Airtap 技术拆解与实测

本文深入剖析了移动端 Agent 产品 Airtap 的技术架构与实现原理。由于手机 App 缺乏像网页 DOM 树那样的结构化接口,移动端自动化极具挑战。Airtap 通过结合云端真机与视觉大模型(VLM)的闭环操作攻克了这一难题,并巧妙地将 iMessage 作为异步任务入口。文章详细分析了该方案的速度限制、风控及安全隐患,并实测了其自动安装应用、检索信息的全流程,指出其适合执行高频低风险的重复性任务。

技术 › Agent huangserva 2026-08-1011.7 KB 46.2K 38 88

MiniMax H3 本地部署保姆级教程

本文是一份 MiniMax H3 模型本地部署的详细教程,涵盖从零装机到写出专业提示词的全过程。内容包含硬件自查、ComfyUI 安装、模型下载、T2V/I2V/R2V 生成流程、参数规则详解及加速优化方案,附带各档次显卡实测数据,帮助用户在本地运行带立体声的 AI 视频。

技术 › LLM huangserva 2026-08-0644.8 KB 559.6K 1.3K

AI Agent 搞钱真相:扒了几十个案例后,我发现大部分人在割韭菜

作者深入调研了数十个 AI Agent 赚钱案例,将其归纳为 8 种模式,包括企业自动化交付、无脸内容工厂、电商自动化及微 SaaS 等。文章指出,许多案例存在夸大成分,且忽略了成本。作者分析认为,真正具备护城河的路径仅限于能沉淀资产的产品或能绑定真实客户关系的业务,其余多为仅依靠平台红利的短期机会。

技术 › Agent huangserva 2026-07-059.4 KB 52.3K 135

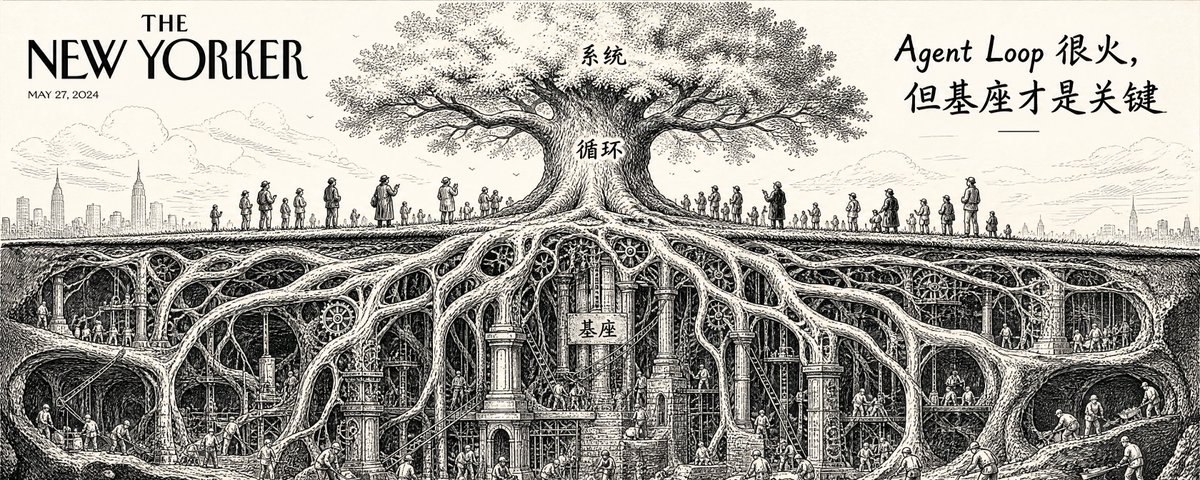
Agent Loop 很火,但基座才是关键:从单代理到自我进化系统的 14 步路线图

文章指出,尽管循环工程备受关注,但决定代理上限的核心是其下层的“基座工程”。作者提出了从单代理到自我进化系统的 14 步路线图,涵盖基座定义、核心配置(记忆、权限、子代理)、技能封装、钩子强制执行、循环自动化、动态工作流编排,以及通过状态文件实现系统自我进化的方法。

技术 › Claude Code huangserva 2026-06-1812.9 KB 20.3K 120

腾讯开源 AI Agent 运行时系统 TencentDB Agent Memory

文章深度解析了腾讯开源的 TencentDB Agent Memory 系统。不同于市面上的“向量数据库+RAG”方案,该系统旨在解决长任务中的“上下文退化”问题。其核心创新在于短期压缩(Offload 机制)与长期记忆(四层流水线)的结合,通过三层回溯、任务图动态压缩及结构化记忆提取,有效管理了 Agent 的上下文窗口与记忆生命周期。

技术 › Agent huangserva 2026-05-228.7 KB 8.7K 58 88

跨境电商选品自动化:用 Hermes Agent + XCrawl 把半天工作压缩到 3 分钟

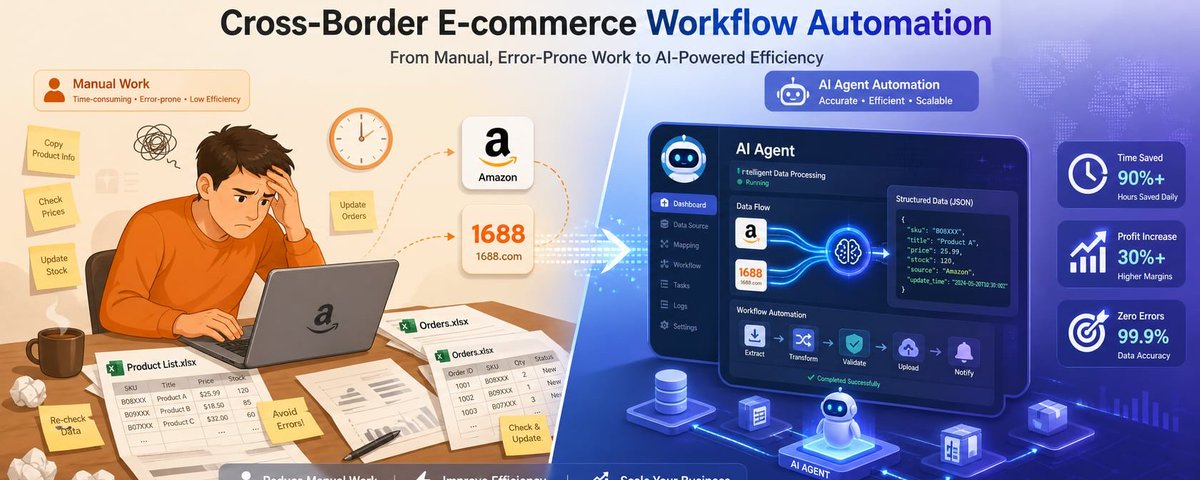
本文分享了一个利用 Hermes Agent 和 XCrawl 实现 Amazon 选品自动化的实战案例。通过抓取 Amazon 榜单数据并匹配 1688 货源,AI Agent 能在 3 分钟内完成利润计算与结构化分析,将传统需 4-6 小时的人工流程大幅压缩。文章详细解析了 API 调用细节、反爬虫应对策略及 ROI 计算,展示了工具与工作流结合的实战价值。

技术 › Hermes huangserva 2026-05-0815.2 KB 88.2K 211 90

一群人,一群 AI,一起玩:我们拆了一款还没发布的 IM

本文深度体验了一款名为 Bloome 的内测产品,它将 Agent 视为通讯录中的“一等公民”,用户可以像加好友一样添加 Agent,并将其分享给他人。文章详细探讨了 Bloome 如何通过链接分发、记忆持久化和多 Agent 协作(如圆桌群)等功能,重新定义人与 AI 的交互方式,旨在打造 Agent 互联网的“微信”。

技术 › Agent huangserva 2026-05-0710.3 KB 27K 47 79

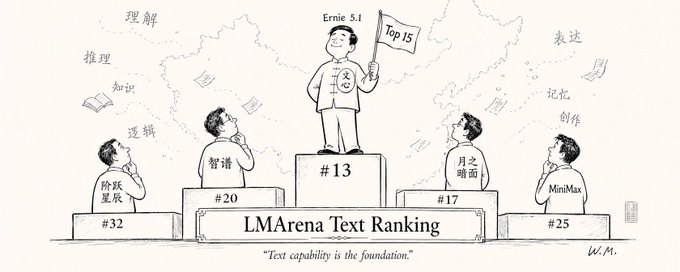
LMArena 最新排名:文心 5.1 预览版国产登顶,文本能力仍是核心

本文基于 LMArena 最新文本排行榜更新,探讨了文心 5.1 Preview 凭借 1476 分拿下国内第一、全球第 13 的成绩。作者分析了为何在 DeepSeek V4 和 GPT-5.5 主导的时代,文本能力依然是大模型代码生成与逻辑推理的“基本盘”。文章指出文心通过「多维弹性预训练」技术实现了高性价比与高性能,验证了夯实文本底座的重要性。

技术 › LLM huangserva 2026-05-015.1 KB 237.7K 78 43

Clawling:每个人都应该拥有属于自己的数字生命伙伴

文章介绍了一款名为 Clawling 的 AI 产品,旨在为非技术背景的普通人提供低门槛的数字生命伙伴。文章详细阐述了 Clawling 的核心能力,包括长期记忆系统、主动监控的“心跳”机制、时光机回滚及隐私保障。通过个人财务管理场景,展示了其在数据积累、主动复盘、趋势分析和决策建议方面的应用,强调其从“被动工具”向“主动伙伴”的转变。

技术 › Agent huangserva 2026-04-1811.5 KB 8.1K 28 79

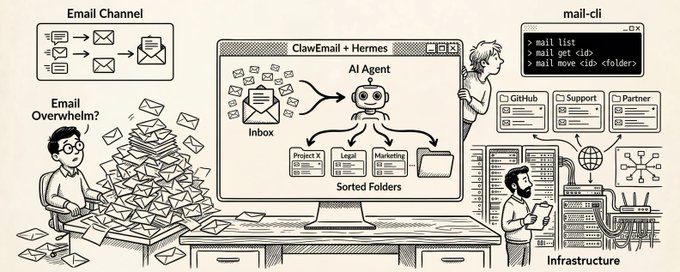
给 Agent 发工资前,先给它一个工作邮箱:在 Hermes 上跑通 ClawEmail 的这段实践

本文探讨了 AI 自动化中权限隔离的重要性。作者分享了在 Hermes Agent 平台上接入 ClawEmail 的实践,通过为 AI 配置独立工作邮箱和子邮箱(GitHub、客服、商务),实现了邮件的自动化分级处理与工作流编排。文章详细对比了 CLI(规则搬运)与 Channel(语义理解)两种模式的优劣,并分享了四个高价值应用方向。

技术 › Agent huangserva 2026-04-1618.9 KB 46.8K 102 85