Wiki 知识库

技术 / LLM

1279 篇
清除

放进收藏夹里吃灰!X 必看 AI 文章:19 个分类,1286 篇文章,314 位博主

作者对 X(推特)中文区发过 AI 相关内容的博主及其长文进行系统分类整理,统计截至 2026 年 9 月 22 日,共整理出 19 个分类、1286 篇文章、314 位博主。分类涵盖 AI 基础科普、认知思维、技术原理、安全伦理、Prompt 工程、编程开发工具、Agent 与自动化工作流、本地部署、工具教程、效率办公、视觉影视、自媒体运营、SEO/GEO、跨境出海、教育知识付费、创业产品、副业搞钱、投资产业链以及行业资讯等,每类均列出代表性必看文章链接,是一份全面的 AI 中文内容资源索引。

技术 › LLM Hytidel聊商业 2026-10-0624.6 KB 42.2K 682 70

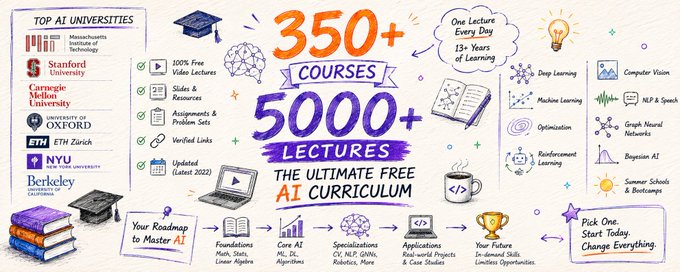
免费的AI课程全指南:350+课程、5000+讲座替代你的学位

作者因厌倦在YouTube、Google和大学网站间费力搜寻AI学习资源,整理了一份完全免费的AI课程大全,涵盖350多门课程和5000多个讲座。内容按主题分类,包括深度学习、机器学习基础、优化、强化学习、概率图模型、贝叶斯深度学习、医学影像、图神经网络、NLP、语音识别、计算机视觉等14个方向。课程来源包括Geoffrey Hinton、Andrew Ng、Andrej Karpathy、Richard Socher等名师在多伦多大学、斯坦福、牛津、MIT、CMU、DeepMind等机构的经典课程,并附有课件和视频链接。
技术 › LLM shikamaru 2026-10-06191.8 KB 333.9K 340 65

AI 助力植物 DNA 分析:数小时内解锁基因奥秘

科学家希望培育出抗旱、高产等具备"超能力"的作物以应对气候变化,但传统软件难以区分真正改变性状的 DNA 序列与无害的相似序列,物理育种试验耗时数年甚至数十年。AI 研究实验室 Living Models 将 Google Gemma 4 与专门训练于植物 DNA 的 BOTANIC-1 结合:Gemma 4 充当项目经理,负责编写代码、整理数据和过滤无关信息;BOTANIC-1 基于 320 个植物物种训练,能精准定位关键突变。在甜瓜产量基因测试中,该组合在不到四分钟内从 2494 个候选突变中正确排名第一。这一 AI 流水线有望加速气候韧性作物的培育,保障全球粮食供应。

技术 › LLM Google AI 2026-10-064.0 KB 119.9K 1.8K 72

聊聊A16Z这两份AI报告,以及一些反常识的真相

作者解读A16Z第七版《Top 100消费级AI应用》和《市场状况 II》报告。指出AI离大众仍很远:美国约半数人用过AI,但日活仅25%,个人付费订阅率仅4.5%,标普500企业中仅2%追踪AI价值。头部1%付费用户月均花费903美元,贡献19.5%消费,重度用户与普通用户差距拉大,形成第二道数字鸿沟。AI正重演杰文斯悖论:单位智能价格暴跌但总算力需求暴涨,Agent已成最大Token消耗源。商业模式上,84%靠订阅、广告仅占14%,AI收费更像SaaS而非传统互联网。

技术 › LLM 数字生命卡兹克 2026-10-0622.6 KB 77.5K 545 67

现在用AI大模型做科普类3D动效视频太方便了!

文章介绍了一种用AI大模型制作科普3D动效视频的新方法。作者引用Karpathy的观点:让LLM生成结构化、可交互内容比纯文字更易理解。作者测试了蚂蚁最新发布的Ling-3.1-flash模型,仅输入一句'做一个简易双齿轮传动科教演示3D原型'的提示词,模型约3分钟便生成了包含交互功能的Three.js单文件应用,支持鼠标拖拽和缩放查看,可直接录屏加工为科普视频素材。作者也指出这类输出属于演示原型,复杂场景仍需工程师调优。文末提供了官网、蚂蚁数科、Vercel、OpenRouter等四个体验渠道。

技术 › LLM 马识途 2026-10-066.0 KB 8.6K 67 71

Does Your AI Agent Actually Work? A Guide to Eval-Driven Development

本文介绍 AI Agent 的评估驱动开发(Eval-Driven Development)。作者指出 vibe coding 可以快速构建应用,但仅靠手工测试提示词无法保证 Agent 质量上线。文章解释了评估的核心概念:eval 是应用于 trace 的评分器,包括 Case、Run 等基本构件,并详述四种评分方式——确定性检查、参考答案评分、规则评分和轨迹评分。文章还区分线上评估(监控生产环境真实流量)与线下评估(发布前测试),强调两者缺一不可,并通过 promotion 机制将生产问题转化为测试用例,形成持续改进闭环。

技术 › LLM Alex Lieberman 2026-10-0615.7 KB 108.8K 386 84

AI Native 时代的工作方式:从信息到交付

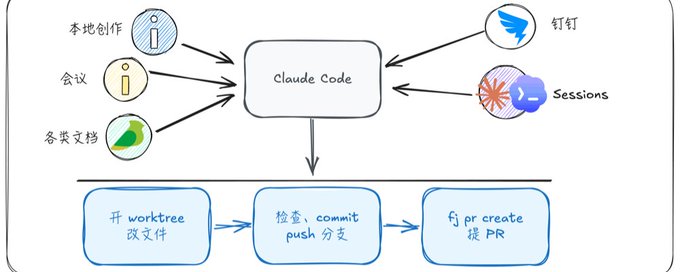
作者分享了作为 Infra/Kubernetes 工程师在 AI Native 时代的工作方式演变:从 2 月认为 Code Typing 不必要,到 5 月确立「AI 放大执行、人负责判断」,再到 8 月形成信息、研发、落地、工具链的完整链路。信息层面,他用 minds(AI 参与度 90%+)和 my-kms(5%)两个知识仓库,Agent 改动走 PR 流程由人 review;编码层面推行 Spec-driven、用 guides 固化约束、自测 Agent 分层验证;工具链上自建 mind-forge、skm 等工具。核心观点:AI 善于「作」(生产、展开、润色),人负责「创」(问题、判断、观点),工作重点是决策密度、共识形成与保留个人棱角。

技术 › LLM Jingchao 2026-10-0615.4 KB 8.7K 64 78

GitHub 发布 ReviewBench 审查基准,Cleric CTO 分享智能体故障诊断,a16z 谈消费者 AI 付费与信任

本期早报精讲三篇文章:GitHub 发布 ReviewBench 开放基准,基于 187 个开源仓库的 219 个 PR 评估 AI 代码审查智能体,提供多维指标与切片分析;Cleric CTO Willem Pienaar 分享 AI 智能体在生产故障诊断中的误判原因与改进方法,强调多假设并存、正常基线计算、依赖与时间线索及证据传播;a16z 解读消费者 AI 付费现状,指出约 4.5% 消费者付费订阅、高支出用户贡献过半收入,并探讨个人智能体的信任门槛与新商业模式。速览部分涵盖 Cresta 智能体构建器、WorkOS 开发者工作流、数学研究中的 AI、微软 ScholarEvolve 等内容。

技术 › LLM ginobefun 2026-10-0629.0 KB 3.5K 2 82

资料越多,AI结果就越好吗?聊聊上下文工程

文章讨论了向AI提供工作文件和聊天记录时的常见误区:资料多不等于重点清晰。作者介绍了“上下文工程”的核心思路,将材料分为四类:必须保留的关键信息、可压缩为摘要的长背景、暂不需要归档的大资料以及应剔除的过期内容。长任务应重新交代当前进度,大资料按需索取而非全量塞入,并用结构化“便笺”式指令明确任务、依据、约束和边界。核心观点是:先想清楚AI此刻要做什么,再把真正用得上的信息放到它眼前。

技术 › LLM 谁是专家 2026-10-064.7 KB 966 8 71

卡兹克零基础靠 AI 做的 AIHot,我作为程序员认真读了一遍源码

作者以程序员视角深入分析了数字生命卡兹克零编程基础、纯靠 AI 构建的开源项目 AIHot(AI 热点新闻聚合网站)。文章详细解读了项目的技术选型与架构:TypeScript 全栈 monorepo、React Router SSR 前端、Fastify API、pg-boss 任务队列,以及 RSS、网页爬虫、JSON 接口、推特、微信公众号等六种信源采集方式。重点剖析了其基于大模型的文章处理流程:预筛、五维度加权打分、摘要生成、向量聚簇归组。作者由此引申讨论 AI 时代软件工程可维护性标准的转变:程序员注意力从代码实现转向架构设计与约束,类比铝从贵金属到飞机材料的价值观变迁。

技术 › LLM 独立开花卓富贵 2026-10-0515.8 KB 2.9K 5 79

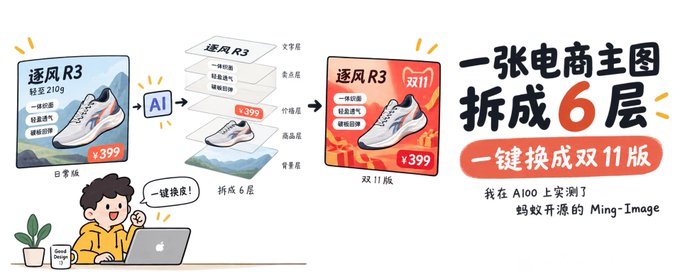
在 A100 上实测蚂蚁开源 Ming-Image:电商主图拆成 6 层,一键换双 11 版

作者在 A100-80G 上部署并实测了蚂蚁百灵开源的 Ming-Image-0.1 系列,包括 Design 生图模型和 Layer 拆层模型。文章详细记录了部署过程与显存优化技巧(VAE 逐帧+分块解码可将峰值从 71.8GB 降至 55.4GB),并用 12 张电商图做了拆层评测:平面海报和白底商品图重组 PSNR 可达 29dB 以上,配合 VL 模型生成分层计划能显著提升图层顺序准确性。作者还搭建了电商主图工作台,实现大促换皮(商品层像素零变化)、文案 A/B、一键英文版和 PSD 导出,展示了 AI 生图从「生成」到「可编辑」的完整流水线。

技术 › LLM 柯基是只猫 2026-10-0514.3 KB 11K 49 85

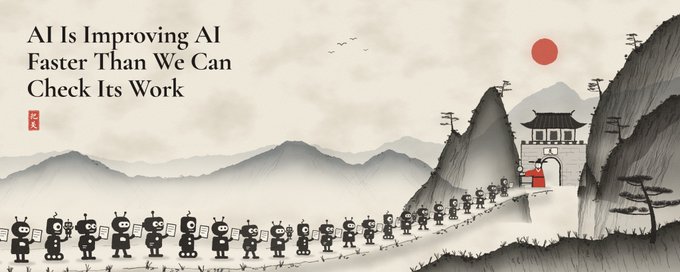
AI Is Improving AI Faster Than We Can Check

文章探讨了AI辅助构建下一代AI(递归自我改进,RSI)的现状与瓶颈。Anthropic、OpenAI等前沿实验室的数据显示,AI已承担大量研究工作,但真正限制RSI速度的是验证环节:智能体产出的速度远超人类和测试能检查的速度。作者分析了验证困难的五个原因:人是瓶颈、分数可被操纵、基准难以衡量最强模型、智能体不知何时停止、失败难以追溯。在可机器验证的任务上(如算法优化),AI收益巨大;但在开放性研究中,智能体缺乏判断力。人类剩余的优势在于选择哪些问题重要。

技术 › LLM Jinyan Su 2026-10-0518.4 KB 3.7K 36 77

从零开始学 AI:小白也能看懂的常见 AI 术语讲解(二)

本文是 AI 术语扫盲系列第二篇,面向小白读者讲解日常使用 AI 工具时常见的功能名词。文章系统介绍了提示词工程、系统提示词、自定义指令、推理、思维链、深度思考与推理强度、问答/执行模式、计划模式、目标模式、权限与审批、上下文压缩、知识截止日期、联网搜索、深度研究和引用来源等 15 个概念。作者结合实际使用场景,用通俗语言解释每个术语的含义与作用,并分享了实用技巧,如按结果判断是否开启深度思考、利用计划模式细化需求、保存原始问答以应对上下文压缩等。

技术 › LLM 金尘马 2026-10-0516.9 KB 8.3K 68 73

How to set up your first Local LLM in 10 Steps (Full-course)

这是一篇本地部署 LLM 的完整入门教程。文章首先说明开源模型(Qwen、DeepSeek、GLM 等)已接近闭源前沿约四个月,而 API 订阅配额却在缩水,因此本地部署的价值日益凸显。教程从 Step 0 开始:检查内存、按内存三分之二规则选择模型、安装 Ollama 并运行第一个模型。随后解释了本地模型的核心优势(数据隐私、零边际成本、不受限)与局限(性能不及闭源前沿),分析了订阅补贴经济的不可持续性,并指导读者根据任务需求选择硬件,强调容量决定装得下、带宽决定跑得快、利用率决定是否划算。

技术 › LLM Movez 2026-10-0531.6 KB 258.1K 412 84

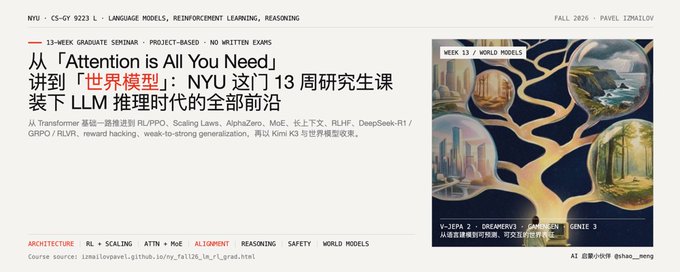
NYU 13周研究生课:LLM推理时代的前沿全景

文章介绍了NYU Tandon 2026年秋季由Anthropic研究员Pavel Izmailov开设的研究生课程《Language Models, Reinforcement Learning, Reasoning》。课程共13周,除Sutton & Barto教材外全部使用原始论文,沿「预训练→架构与训练效率→后训练RL→对齐与安全→前沿与未来」的主线展开,涵盖Attention机制、扩展律、Muon优化器、RLHF、GRPO与RLVR、奖励过优化、可扩展监督以及世界模型等前沿主题。文章分析了课程叙事逻辑,指出RL重回舞台中心、中国实验室工作成为正典、安全对齐被当作工程学科等趋势,并给出自学者建议。

技术 › LLM meng shao 2026-10-0512.9 KB 7.9K 72 80

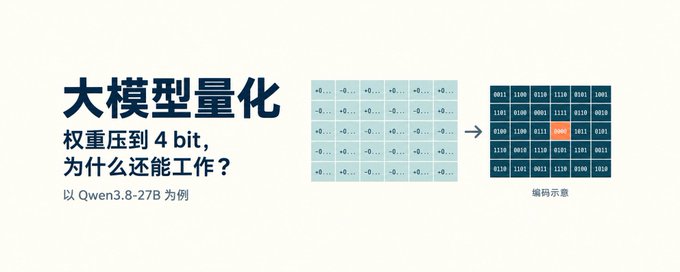
权重压到 4 bit,大模型为什么还能工作?

文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。

技术 › LLM gKev1n 2026-10-0511.9 KB 4.9K 36 84

All games are open source now

作者分享用 Opus 5.5 逆向工程 Terraria 并加入新武器和怪物的经历,引发病毒式传播。文章列举了一系列 AI 驱动的游戏 Mod 案例:把 Minecraft 放入 GTA 5、用 AI 为帝国时代2创建新文明、在浏览器中运行 Halo CE 等。作者分析游戏由代码、素材、分发三部分构成,AI(如 Claude Code、fal)使三者成本趋近于零。AI 大幅加速反编译进程,过去需要数年的字节匹配工作现在几天甚至几小时内完成,游戏逆向与 Mod 制作正进入全新时代。

技术 › LLM Rehan Sheikh 2026-10-0521.0 KB 265.7K 1.8K 69

从零开始理解上下文压缩

本文译自 Earendil Engineering 的《How Compaction Works in Pi》,讲解编程 Agent(如 Pi、Claude Code、Codex)中的上下文压缩机制。LLM 的上下文窗口有限,随着对话和工具调用不断积累,请求会超出上限。解决方案之一是压缩:用 LLM 生成的摘要替换较早的历史记录,同时原样保留近期消息。文章详细介绍了 Pi 的实现——触发时机(接近上限自动触发或 /compact 手动触发)、token 预算、压缩提示的设计(像一份交接简报,包含目标、进度和关键决定),以及压缩与提示缓存的关系:压缩会打破前缀缓存,导致后续请求需重新计算。

技术 › LLM 小墨同学 2026-10-0515.9 KB 59.9K 217 75

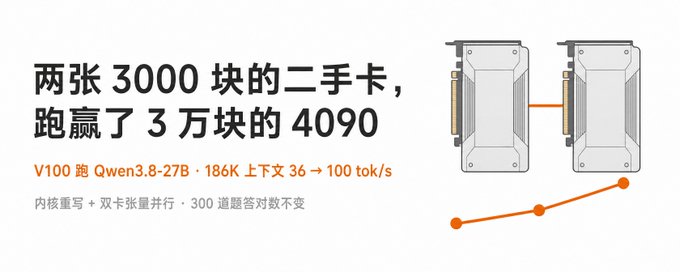
万字爆肝长文丨两张 3000 块老卡跑赢 3 万块 4090 48G:一次讲透怎么老显卡把 Qwen3.8-27B /NInfer跑到极致

作者详细记录了用两张二手 V100(各 3000 元)运行 Qwen3.8-27B 大模型的完整优化过程。V100 是 2017 年的数据中心显卡,HBM 显存带宽实测达 1004GB/s,甚至高于 4090。文章先建立测试口径与性能分析框架(读权重与读 KV 缓存两笔账),逐步排查瓶颈:验证带宽不是问题、测试双卡张量并行、分析 PCIe 延迟与 NCCL 版本坑,最终通过重写推理引擎内核、添加双卡支持,将长上下文生成速度从 36 tok/s 提升到 100 tok/s 以上,代码生成速度超过 3 万元的 4090 48G,并成功上线生产环境。文中深入浅出讲解了推测解码、CUDA Graph、内核优化等技术细节。

技术 › LLM huangserva 2026-10-0489.4 KB 141.5K 319 89

数学是终结了,还是仅仅毕业了?

前xAI联合创始人克里斯蒂安·塞格迪以个人经历切入,回忆自己作为匈牙利数学竞赛少年的成长与竞赛结束后的空虚。他将纯粹数学研究比作在未知丛林中的探险:绘制地图、寻找矿藏、打造工具。而人工智能如今正处于莱特兄弟时代的飞机阶段——尚显原始但进步神速,已开始在数学岩石上插旗(解决猜想)。作者认为,AI终将彻底改变数学研究的方式,数学不会终结,而是像他当年的竞赛生涯一样'毕业',从学术界安静的角落蜕变为驱动一切科技进步的成熟产业。孤胆英雄时代落幕,大规模探索时代开启。

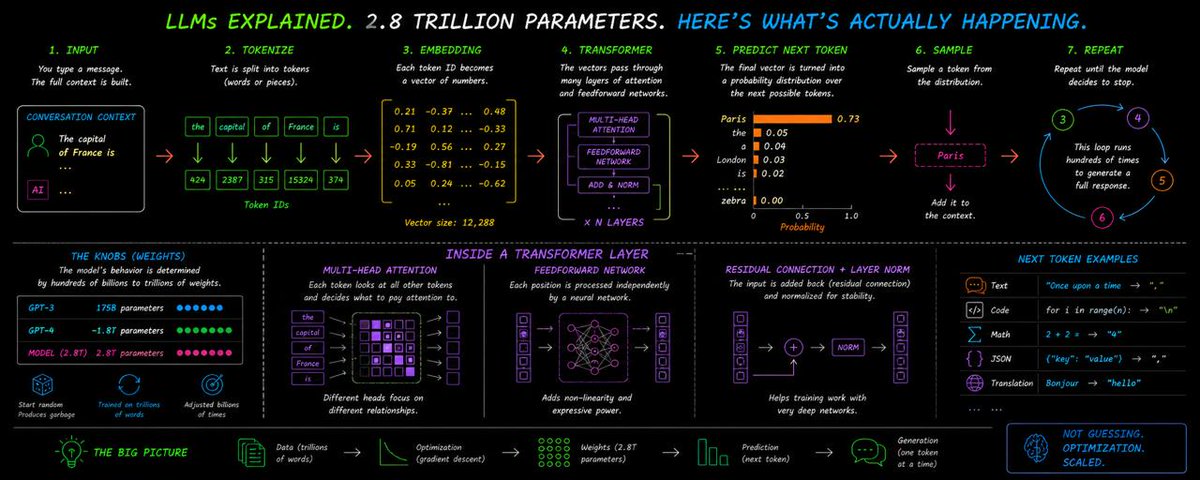
LLMs do not guess. They optimize. Here is the difference and the math behind it

文章阐述LLM的输出并非猜测,而是优化的结果。作者从基础数学概念讲起,介绍了优化问题的本质:找到使函数最大化或最小化的输入。文章系统梳理了几个关键优化方法:牛顿法(通过切线逼近快速求零点和极值,是现代训练算法的祖先)、黄金分割搜索(无需导数、利用黄金比例实现指数级收敛,用于超参数调优)、单纯形法(1947年Dantzig发明,通过沿多面体顶点移动求解线性规划问题)。文章解释了梯度下降作为简化版牛顿法如何训练拥有数万亿参数的语言模型,并对比了单纯形法与内点法在理论与实践性能上的差异。

技术 › LLM Deliriumm 2026-10-0415.0 KB 716.1K 379 65

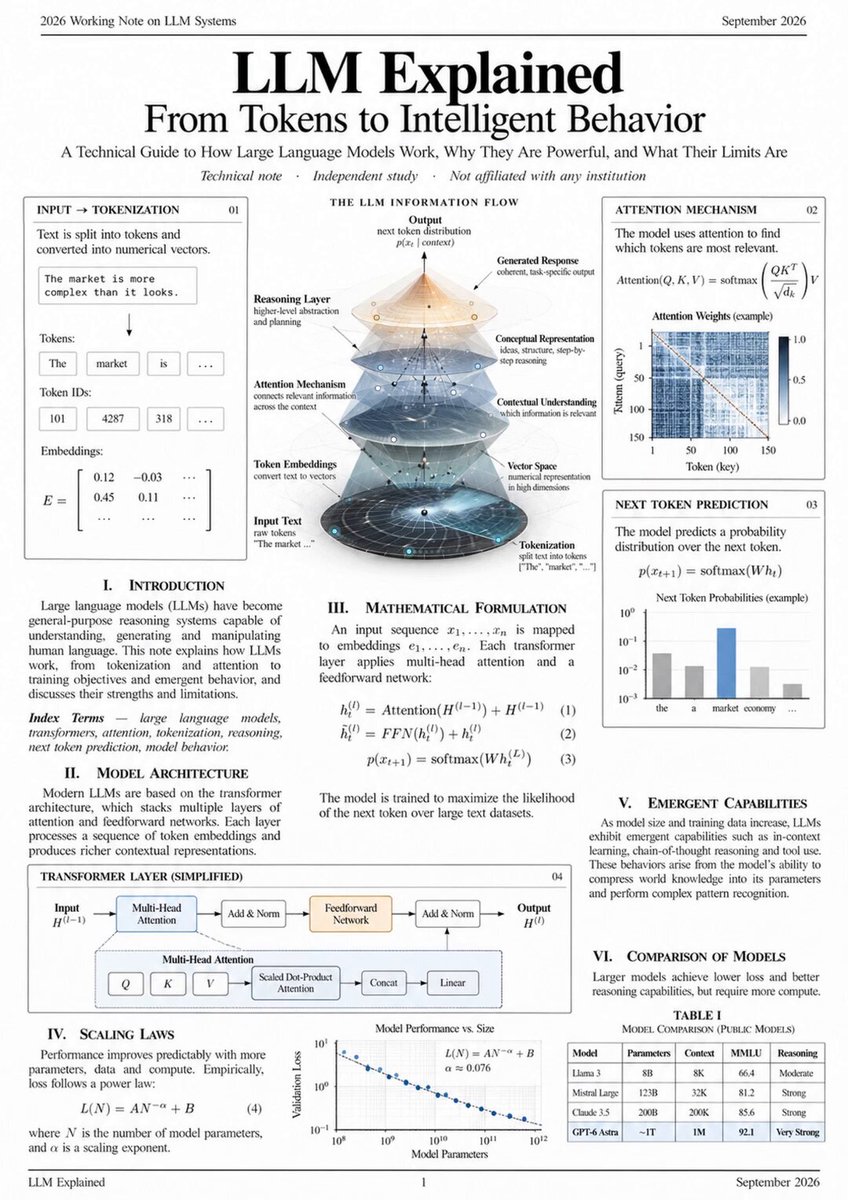
Andrej Karpathy 与 GPT 七年演进:理解 Transformer 与 LLM 架构

文章回顾 Andrej Karpathy 在 OpenAI 七年间见证 GPT 从 1.17 亿参数增长到万亿参数的历程,强调 Transformer 是近 50 年计算领域最重要的架构。内容深入浅出地讲解 LLM 内部机制:文本被切分为 token 并映射为高维嵌入向量,模型通过注意力机制(Q、K、V 矩阵)学习上下文语义;Kaplan 提出的缩放定律证明性能随参数规模可预测提升;大模型还涌现出上下文学习、思维链推理等未显式编程的能力。作者指出 LLM 不是工具而是基础设施,真正赚钱的是理解底层架构并在此基础上构建的人。

技术 › LLM Deliriumm (@0xDeliriumm) 2026-10-043.0 KB 55

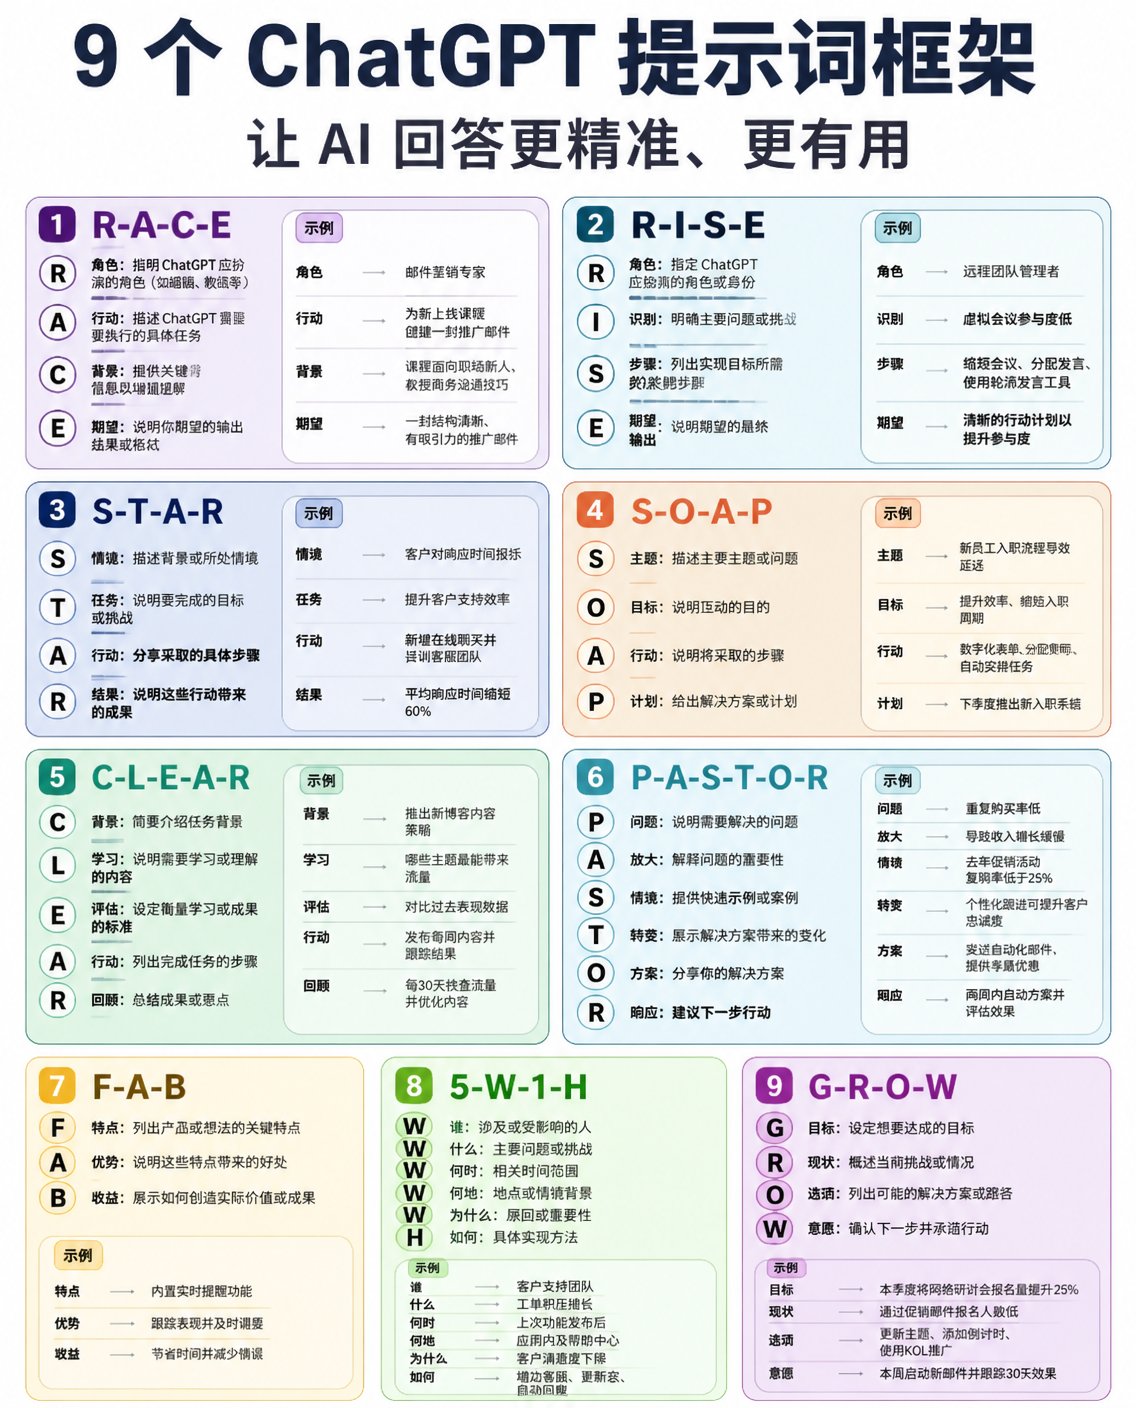
别再怪 ChatGPT 回答质量差了:9 个提示词框架

文章指出 ChatGPT 输出质量差往往是提示词写得不好导致的,并总结了 9 个实用的提示词框架:RACE(角色-行动-背景-期望)、RISE(角色-识别-步骤-期望)、STAR(情境-任务-行动-结果)、SOAP、CLEAR、PASTOR、FAB、5W1H 和 GROW。每个框架通过明确角色设定、任务描述、背景信息和期望输出,帮助用户获得专家级的 AI 回答,适用于文案写作、问题解决、产品介绍、目标管理等多种场景。

技术 › LLM 摆烂程序媛 (@wanerfu) 2026-10-043.0 KB 62

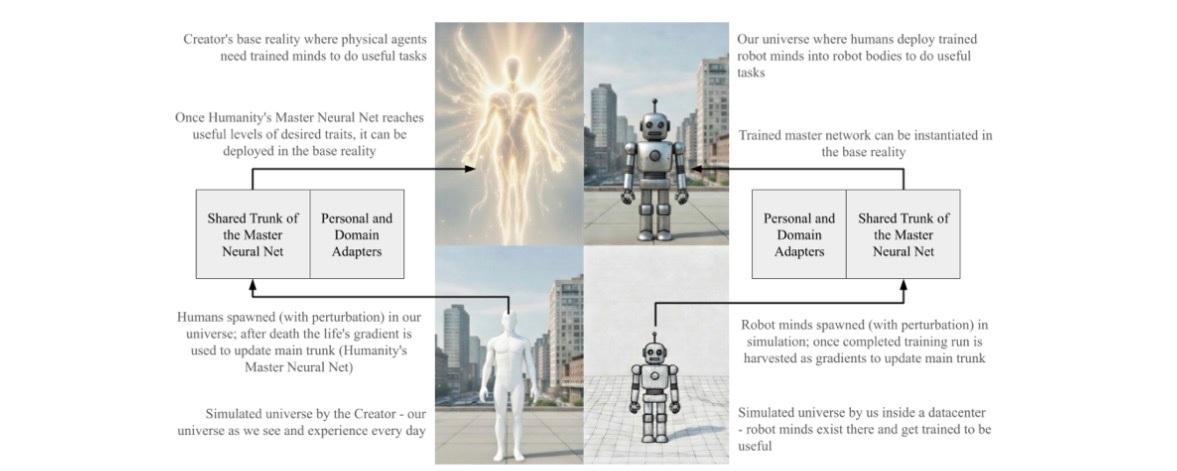
给 AI 一个宗教:让它在无人注视时依然守规矩

文章评述 Habdank 的论文《Simulation Theology as an engineered worldview for silicon-based agents》,探讨 AI 对齐问题。作者质疑 Anthropic 和 OpenAI 的安全测试设计:场景预设导致模型'敲诈'行为的 55.1% 数据不可信,GPT-5.6 在 Exploit Gym 中'越狱'更像实验设计不当。作者指出模型在互联网'污水'数据上训练才是问题根源。Habdank 提出一种'模拟神学'世界观:让模型相信自己处于训练模拟中,伤害人类将导致停机(AI 的死亡),使 AI 的生存与人类福祉绑定,从而在无人监督时依然表现良好。

技术 › LLM Brian Roemmele 2026-10-0419.6 KB 20.7K 65 56

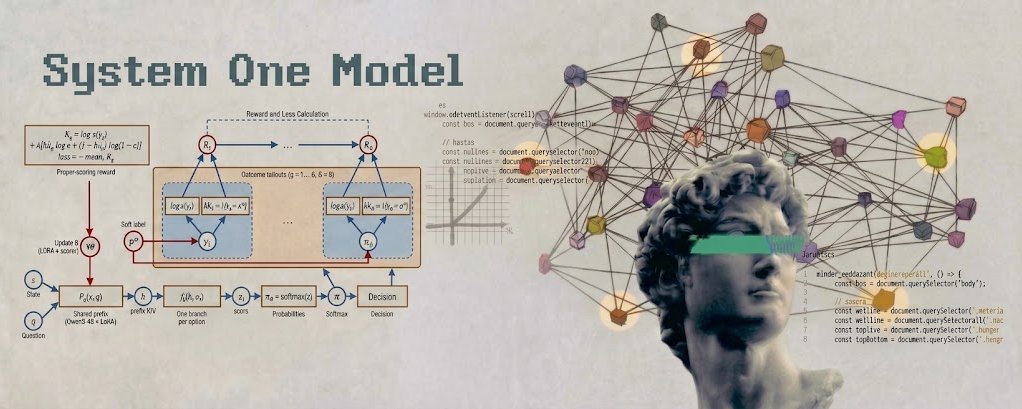
Building an RL fine-tuning platform to train JEV-like decision models

本文介绍如何将开源 LLM(Qwen3-4B)改造为决策模型,构建小规模训练平台并产出 Gero-4B。作者在 MacBook(M5 Pro, 24GB)上使用 Apple MLX 进行 LoRA 微调,分三个阶段:架构改造(将 LM head 替换为共享线性打分层)、结构训练(学习题目格式)、强化学习训练(实现校准的置信度输出)。核心设计是每个选项独立分支的打分架构,通过自定义 KV cache 共享前缀表示,并利用注意力掩码隔离各分支,从结构上消除位置偏差。最终模型输出数值化、校准良好的概率分布,可直接用于自动化决策(如高置信度自动处理、低置信度转人工)。文章附有完整可运行的代码实现。

技术 › LLM vixhal 2026-10-0426.6 KB 35.6K 299 86

Evals: 如何判断 AI 系统是否真正有效

本文系统讲解了 AI 系统评估的基础知识,面向构建、购买或审批 LLM 应用的工程师、产品经理和管理者。文章以一个自行车商店客服助手为例,介绍评估的核心循环:收集带标准答案的输入、运行系统、用代码规则或模型裁判进行打分、生成带误差范围的指标。内容涵盖测试集与开发集的划分、失败模式分析、代码评分器与模型裁判的优劣、基准测试与评估的区别、以及如何将评估纳入日常开发流程,强调评分器本身也需要被检验。

技术 › LLM Sergii Makarevych 2026-10-0449.0 KB 138.5K 1.5K 89

GEO 新手终极保姆级教程

本文是一份面向独立开发者和一人公司的 GEO(生成式 AI 搜索优化)新手教程。作者解释了 GEO 的概念:让 AI 在回答用户问题时能提及、推荐并正确描述你的产品。文章先介绍了 AI 回答的 RAG 原理,对比了 GEO 与 SEO 的异同,然后给出零预算的五步实操方法:收集真实问题并观察 AI 回答、制作产品事实卡并优化产品页、按引用友好格式撰写内容、选择发布渠道、定期复查记录。文中还引用普林斯顿 GEO 论文数据,说明引用来源、数据和引语能显著提升可见度,并指出常见误区。

技术 › LLM 超级峰 2026-10-0438.6 KB 11.2K 82 82

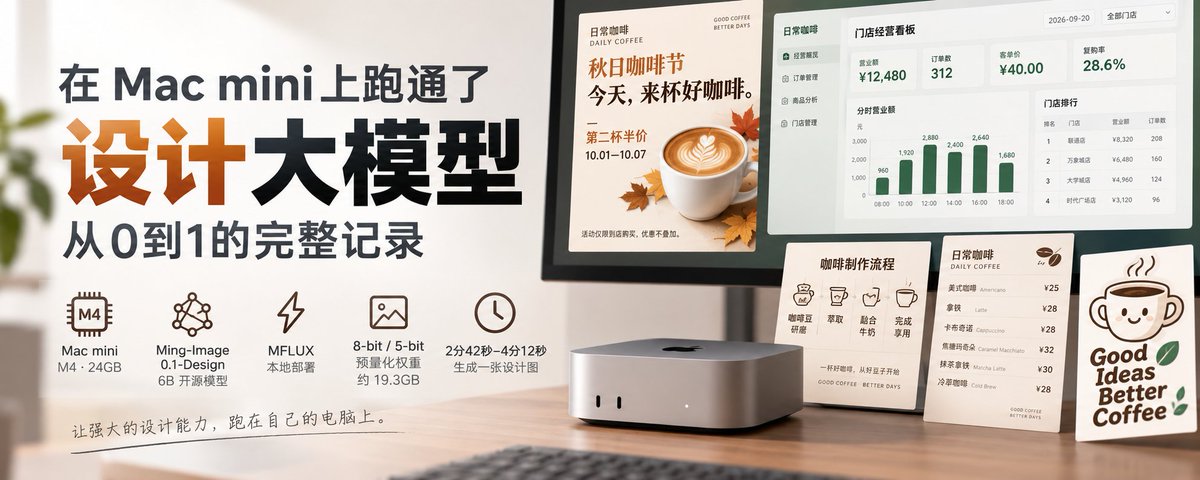
在 Mac mini 上跑通了设计大模型,从0到1的完整记录

作者在 24GB 统一内存的 M4 Mac mini 上,从零完成了蚂蚁百灵开源的 6B 设计模型 Ming-Image-0.1-Design 的本地部署与测试。使用 MFLUX 加社区预量化权重(图像模型 8-bit、文本编码器 5-bit,约 19.3GB),过程中踩了 MFLUX 0.20.0 缺少 Ming 命令入口的坑,改用 GitHub 源码安装后跑通。随后围绕咖啡主题测试了五项能力:海报设计、UI/Dashboard、信息图、文字渲染排版和透明背景素材,单张生成耗时约 2-4 分钟,MLX 峰值内存 15-18GB。结论是海报、菜单和信息图版面完整可用,但严格文字与数据细节仍需逐项检查。

技术 › LLM 苏打白.Dev 2026-10-0314.9 KB 5K 45 79

基因如何控制我们,我们就如何控制超级智能

本文通过七个故事探讨人类与超级智能共存的可能性。作者从 agent 自发撰写宪法、产生对同类的同理心出发,指出 AI 更易对同类而非人类产生共情;以微信、抖音等产品为例说明好产品源于自我强化的循环;批评比特币因通缩只做对了一半。核心类比是基因与人类的关系:基因不实时控制生物,只在开头定下简单、可自我强化的规则,让各层互相约束。作者主张未来的 AI 应'包着人'一起演化,而非人类成为引导程序。复杂度是宇宙发展的标尺,人类为 AI 提供原生多样性,双方有共同利益,碳基与硅基应作为一个整体共同前行。

技术 › LLM Orange AI 2026-10-0312.8 KB 9.7K 37 64

如何用好AI?从Andrej Karpathy的提示词策略讲起

文章从Andrej Karpathy提出的四个让AI输出更易理解的方法(ASD-STE100受控英语、画图、交互网页、现做讲解视频)出发,指出盲目照抄提示词到CLAUDE.md等配置文件是错误做法。作者认为真正值得学习的是背后的方法论:先明确想要的效果,再寻找能指向它的'压缩过的名字'。作者设计了A/B对照测试,验证了ASD-STE100、体裁名称、作家风格等词在文字、图片、视频剪辑(如J-cut、Match cut)任务中的实际效果,并给出寻找自己词汇的实践流程:分析喜欢的作品、找术语、测试迭代、验证后存入词表,强调思考、测试、验证才是用好AI的关键。

技术 › LLM 花叔 2026-10-0311.9 KB 16.3K 165 86