一个产品经理读完200篇AI论文后,看见了别人看不见的边界
文章讲述了前豆瓣产品经理谢青池通过阅读200多篇AI论文,梳理出理解大模型发展的历史视角。他通过分析从GPU、AlexNet到Transformer等关键技术节点的演进逻辑,指出产品经理需在边界变化中寻找最优解。读论文不仅消除了他对AI发展的焦虑,也让他能更精准地预判技术趋势。
文章讲述了前豆瓣产品经理谢青池通过阅读200多篇AI论文,梳理出理解大模型发展的历史视角。他通过分析从GPU、AlexNet到Transformer等关键技术节点的演进逻辑,指出产品经理需在边界变化中寻找最优解。读论文不仅消除了他对AI发展的焦虑,也让他能更精准地预判技术趋势。
MiniMax 发布通用多模态生成模型 H3,支持文本、图像、视频和音频的统一理解与生成。H3 可生成原生立体声的 2K 分辨率视频,具备优异的指令遵循和精准编辑能力,并计划近期开源模型权重,旨在打破任务边界,降低成本,加速商业化内容创作。
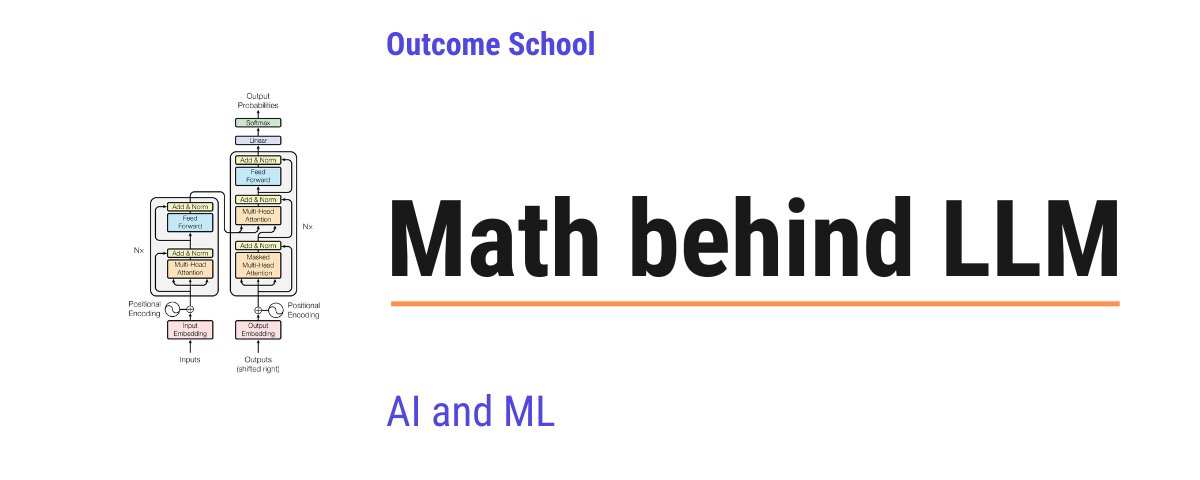
本文介绍了大语言模型背后的数学原理,涵盖Attention机制、缩放因子、反向传播、梯度下降、交叉熵损失、RoPE位置编码和RMSNorm归一化等核心概念。
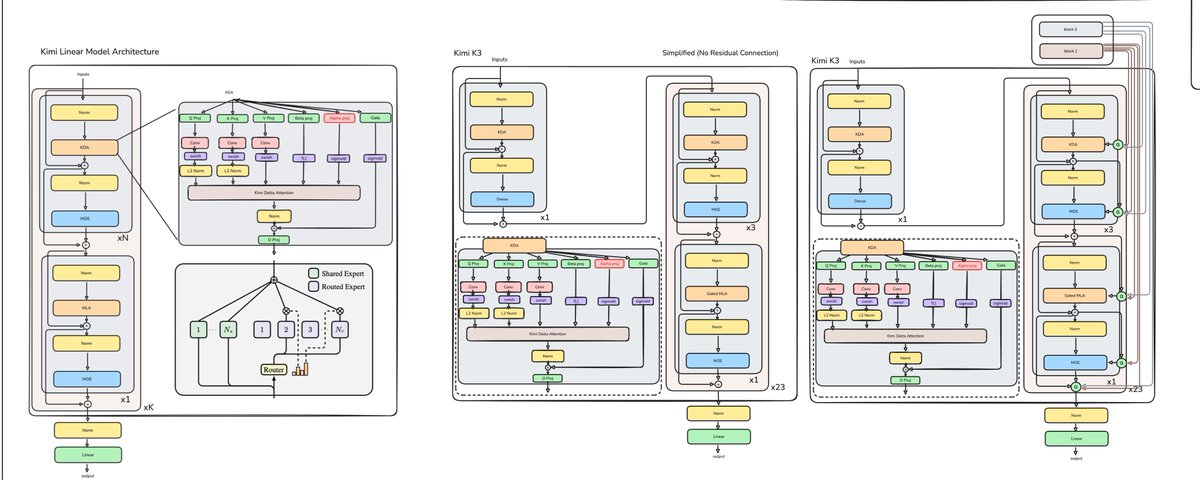
文章回顾了从 GPT-2 (2019) 到 KimiK3 (2026) 的大语言模型架构演进,重点对比了参数规模从 1.24 亿到 2.8 万亿的巨大跨越。深入解析了 GPT-2 的 Transformer 解码器结构、KV 缓存机制,并探讨了线性注意力机制在降低计算复杂度方面的原理与权衡。
本文从深度流形视角分析 Thinking Machines 的多模态模型 Inkling。探讨了模态早期耦合、放弃 RoPE 的几何意义、Muon 的归一化作用以及大规模强化学习对流形同调的影响,提出了关于数据耦合和训练稳定性的开放问题。
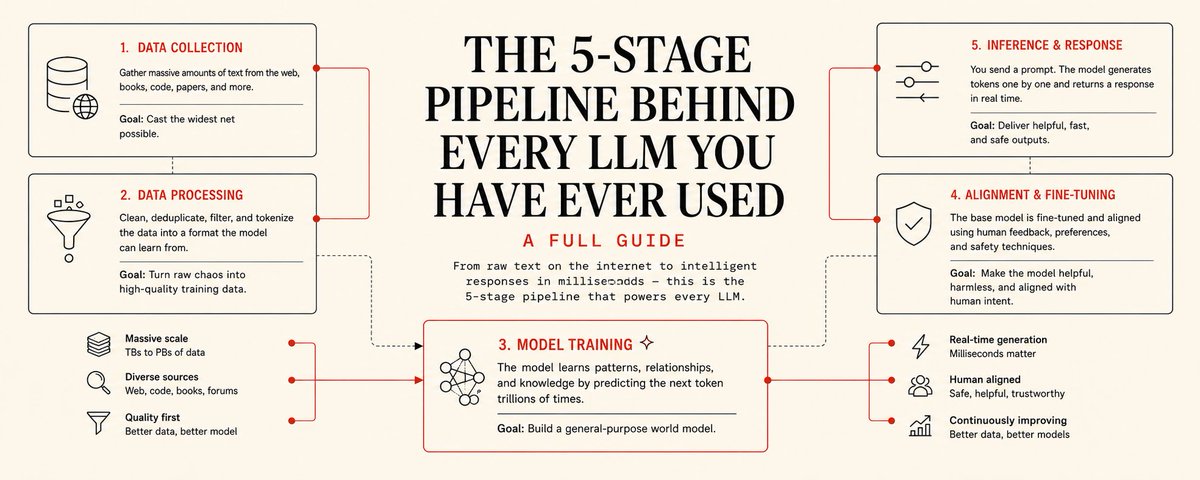
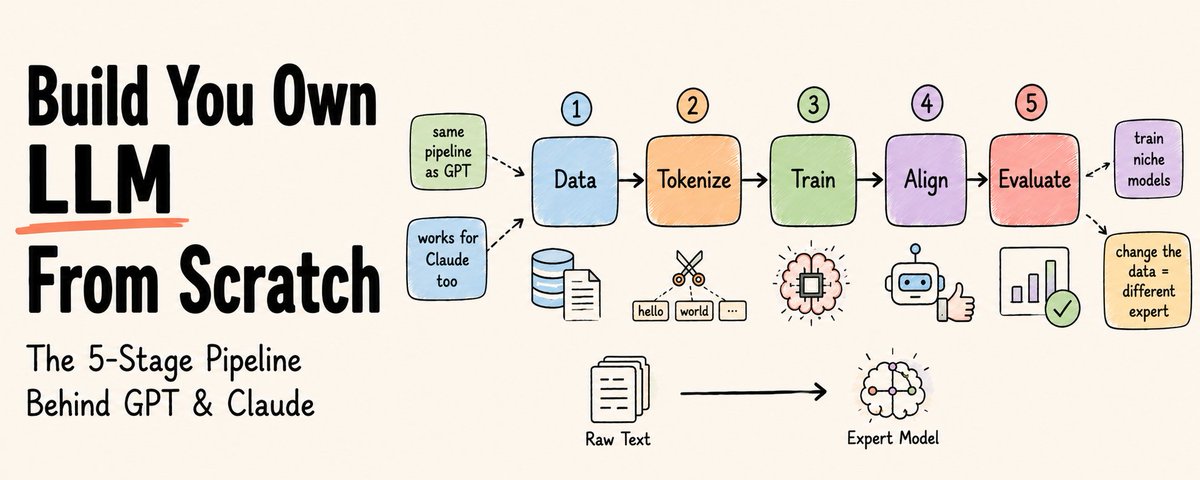
文章详细解析了构建大型语言模型的五个关键阶段:数据收集与预处理、预训练、及后续阶段。作者指出,大多数误解源于将“训练”视为单一步骤,实际上每个阶段解决不同问题。理解这一流程有助于识别模型行为根源及局限性,如幻觉或拒绝回答,并指导优化策略。
这是一份按主题编排的AI领域人物小传(上篇),涵盖了从深度学习奠基者、大模型实验室领袖、Transformer论文作者到顶尖学术研究者的75位关键人物。文章详细介绍了每个人的背景、核心贡献及当前动态,包括Hinton、LeCun、Altman等业界巨擘。
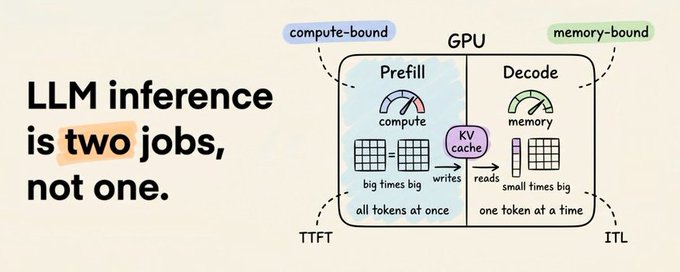
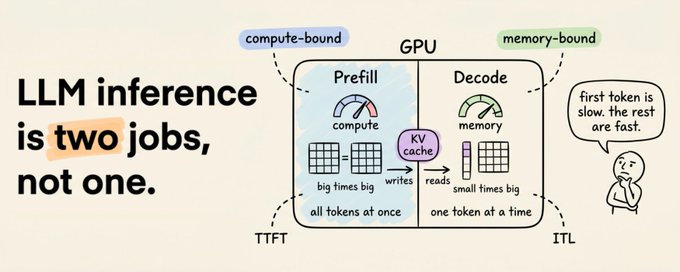
本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。
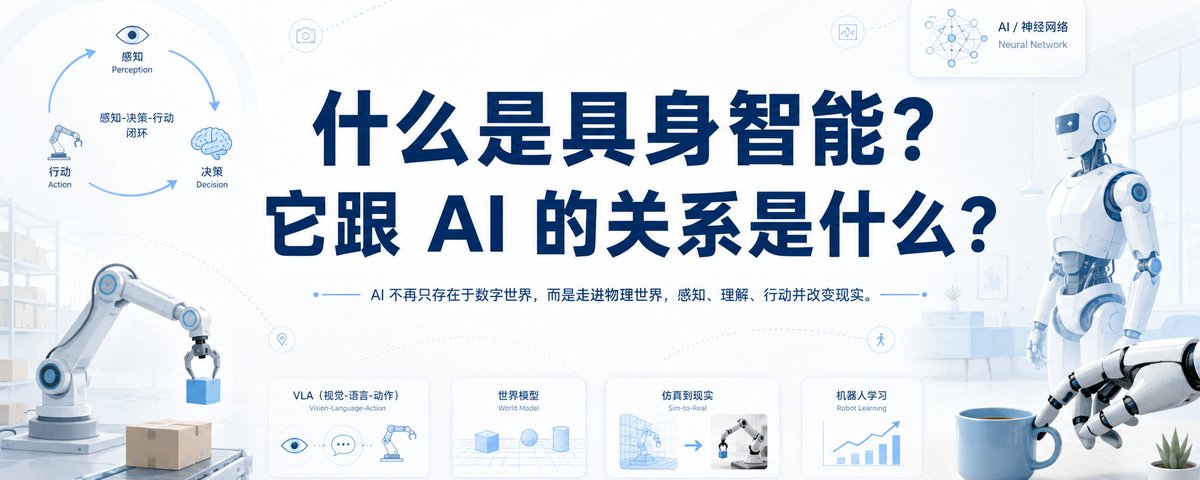
文章深入解析了具身智能的定义、历史渊源及发展现状。作者区分了具身智能与传统机器人,指出其核心在于感知-行动闭环与物理世界的实时交互。文章回顾了从符号主义、行为主义到深度学习、Transformer时代的技术演进,分析了VLA模型如何继承大模型能力来突破泛化难题,探讨其与AI的本质关系及未来前景。
文章揭秘了 GPT、Claude 等 LLM 背后通用的五阶段构建流程,指出数据质量而非架构才是核心。作者详细阐述了数据清洗、分词、训练目标(预测下一个 Token)及 Transformer 架构实现,并提供了包含 Tokenizer 和 PyTorch 模型的代码示例。
文章深入解析了构建大型语言模型的完整五个阶段,指出架构并非关键,数据、评估和系统才是核心。内容涵盖预训练、数据处理、扩展定律、后训练(SFT与RLHF)以及评估系统,揭示了从原始文本到智能助手的技术路径。
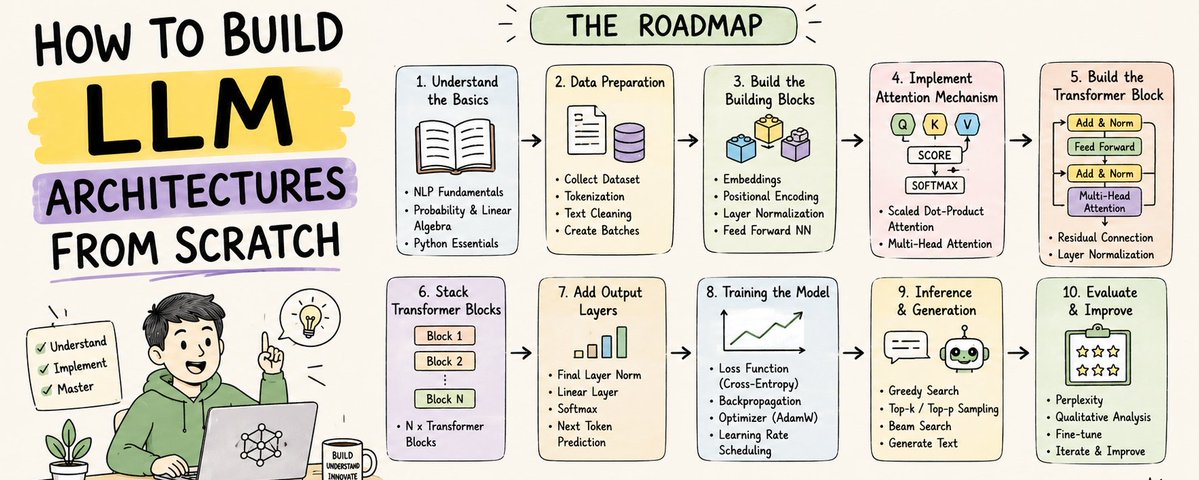
文章提出了一个基于项目的 2026 年 LLM 工程学习路线图。作者主张通过从零构建系统来掌握技术栈,路径涵盖从基础的 Tokenizer、Embedding、Positional Encoding、Attention 机制,到 Transformer 模块构建、训练循环、KV Cache、MoE、量化、服务部署、RAG 及 Agent 等高级系统。该指南强调“实现、绘制、破坏、解释”的学习闭环,旨在帮助读者深入理解大模型原理并具备工程构建能力。
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
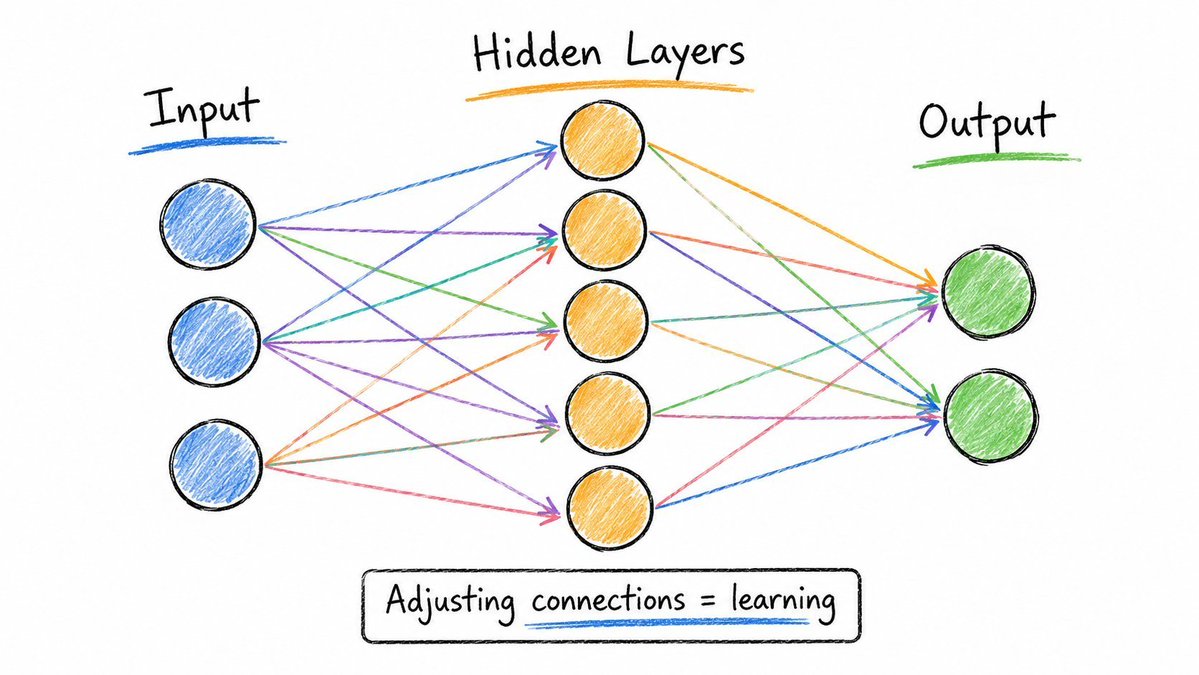
本文翻译整理了一组在 X 上广为流传的 AI 科普手绘图,涵盖从神经网络、Transformer 架构到大语言模型(LLM)的 20 个核心概念。作者不仅解释了 AI 底层运作原理(如分词、注意力机制),还介绍了模型优化手段(如微调、RLHF)及前沿应用架构(如 RAG、Agent、思维链),是一份简洁全面的 AI 技术入门指南。
这是一份关于大语言模型(LLM)的实践指南。文章从基础循环机制出发,详细解释了文本如何转化为 Token,以及 Transformer、注意力机制、KV Cache 和 RoPE 等核心概念的工作原理。作者强调理解模型内部的推理机制(如 Prefill 和 Decode 阶段)对于硬件选型、显存估算和本地部署的重要性。文章涵盖了 Token 化、上下文窗口、量化、模型服务及本地 AI 硬件数学计算等关键主题,旨在为深入理解 LLM 提供直观的基础。
本期 Indigo Talk 邀请 Bill Sun 探讨 AI 对投资、组织形态及人类存在的深刻影响。Bill 拥有 Google Brain 与量化对冲基金的双重背景,他指出 GPT-3.5 曾让其 20 人团队的工作被 AI 替代。对谈核心观点认为 AI 是“极端放大器”,而非平等工具,它会让顶级人才效能倍增,同时加速组织“U 型坍塌”——中部消失,分化为超级资源体与“一人公司”。此外,文章还深入探讨了如何造出像索罗斯一样思考的 AI,以及在 AI 时代人类如何寻找存在意义。
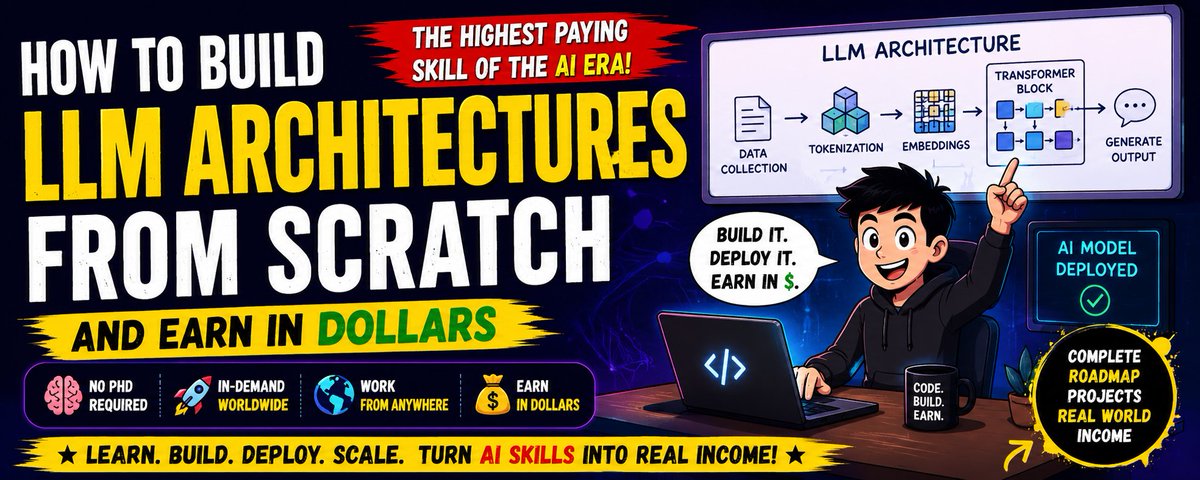
本文详细介绍了如何从零开始学习大语言模型(LLM)架构。内容涵盖了从掌握 Python 基础、理解神经网络和 Transformer 原理,到深入掌握 Tokenization、Embedding、Attention 机制及 RAG 技术等核心概念。文章还提供了具体的学习路线图,并探讨了通过自由职业、构建 SaaS 产品、远程工作及自动化代理等方式将 LLM 技能转化为高美元收入的职业路径。
本文深入剖析了 AI 领域核心的注意力机制。文章回顾了 Attention 从早期神经机器翻译到 Transformer 架构的演变历史,详细解析了其解决固定长度向量瓶颈的原理。同时,通过图文并茂的方式,逐步拆解了从 Embedding 到上下文表示的过程,重点阐述了 Queries、Keys、Values (QKV) 机制的运作逻辑及其在现代大模型中的关键作用。
文章详细介绍了 LoRA (Low-Rank Adaptation) 技术,这是一种用于高效微调大型语言模型的方法。通过冻结原始权重并学习两个极小的低秩矩阵,LoRA 能够在保持模型性能的同时,大幅降低显存占用、训练成本和存储空间。文章还解释了 LoRA 的核心数学原理、具体实施步骤以及为何全量微调成本高昂的原因。
文章深入探讨了混合专家模型(MoE),这是一种通过激活特定子网络来高效扩展 AI 模型的架构策略。文章回顾了 MoE 的历史背景,详细解释了其由门控网络和专家组成的结构及稀疏路由机制,并分析了其在 Transformer 中的应用、优势(如高效计算、参数扩展)以及面临的负载平衡和通信开销等挑战。
文章探讨了顶级科技公司正在秘密研发的架构转变——状态空间模型(SSM)。旨在解决 Transformer 架构在长序列处理中的计算成本高和内存消耗大的问题。文章详细解析了 SSM 的工作原理、相比 LLM 的优势(线性时间复杂度、恒定内存),并展示了 NVIDIA、IBM 和 Microsoft 等公司在 Nemotron、Bamba 和 SambaY 等混合架构上的实际应用进展。
这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。
文章深入剖析了大语言模型(LLM)的推理过程。首先介绍了文本如何通过分词和嵌入转换为向量,接着详细解释了 Transformer 层中的自注意力机制与前馈网络如何协同工作。文章重点揭示了推理过程的两个不同阶段:处理输入时的“预填充”阶段受算力限制,而生成输出时的“解码”阶段受内存带宽限制,这种性能差异导致了首个token与后续token生成速度的不同。
DeepSeek发布新论文,提出一种名为“视觉原语”的多模态推理框架。不同于业界卷分辨率的趋势,该模型通过在思维链中嵌入边界框和坐标点,模拟人类用手指着图片思考的过程,有效解决了语言在空间指代上的局限。DeepSeek-ViT配合LLM将视觉Token压缩至竞品的十分之一,但在空间推理、计数和迷宫导航等任务上性能超越GPT-5.4等顶尖模型。
本文基于 Reiner Pope 的播客内容,深入剖析了大模型在集群中的运行机制。文章通过 Roofline 分析和 KV Cache 等核心概念,解释了推理延迟、Batch Size、API 定价策略及 MoE 架构背后的物理与经济逻辑,揭示了硬件限制如何塑造 AI 进展。
文章深入剖析了 NVIDIA 在机器人领域构建的隐秘且强大的操作系统,这是一个由 Cosmos(想象力/仿真)、GR00T(大脑/推理)和 Newton(物理引擎/身体)组成的全栈技术体系。文章指出,虽然大众关注机器人的硬件动态,但 NVIDIA 通过开源 Cosmos Cookbook 等工具,已经为开发者解决了物理世界 AI 中数据稀缺和仿真模拟等核心难题,标志着机器人开发范式的根本性转变。
本文深入探讨了 LLM 中的 Prompt Caching 技术,解释了其背后的 KV Cache 机制及静态/动态上下文分离原理。文章通过 Claude Code 的案例分析,展示了如何通过保持 92% 的缓存命中率来将计算成本降低 81%,并总结了哈希敏感性和工程化落地的关键约束。
本文通过本地实验与源码分析,深入解析了大模型的 KV 缓存机制。作者从 Transformer 注意力机制讲起,解释了为何多轮对话会出现 100 倍的加速差异。通过逆向 Claude Code,揭示了 Anthropic 精密的缓存工程策略(前缀匹配、TTL 机制)。最后,给出了具体的 Claude Code 使用姿势(如保护缓存前缀、避免切换模型),帮助用户将 Token 消耗降低 80%,实现同样的套餐多干 3-5 倍的活。
这是一份针对计算机科学和数学专业大二学生的机器学习(ML)与强化学习(RL)入门阅读清单。清单分为四个部分:基础(如ResNet、Attention)、AI基础设施(如VAE、BERT、LoRA、Agent)、推理加速(如Linear Attention、Speculative Decoding)以及强化学习(如PPO、DPO、RLHF)。该列表由导师 Mingyang Yi 推荐,旨在帮助本科生构建系统的 AI 知识体系。
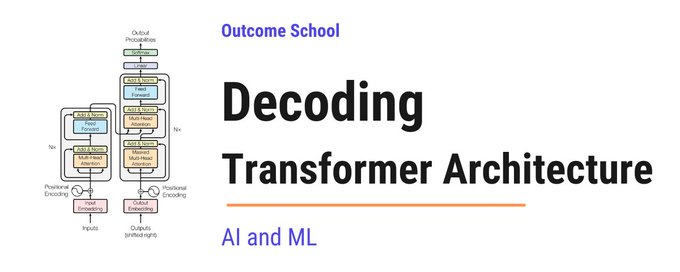
本文深入浅出地解析了 Transformer 架构,它是现代大语言模型(LLM)的核心。文章从宏观视角出发,通过解码的方式,逐一拆解了 Transformer 的关键组件,包括编码器与解码器、分词与嵌入、位置编码、注意力机制(Attention)以及多头注意力等。作者详细解释了该架构如何解决传统模型的“遗忘”和“慢速”问题,实现了并行处理和长距离依赖捕捉,并最后阐述了其强大的原因。