越改越烂!为什么 AI 自动修改 UI 总是翻车?「附终极解法」
作者分享用 AI 复刻页面时踩过的坑,搭建了渲染、截图、逐像素比对、模型诊断再修改的自动工作流。实测发现模型并非每轮都变好,有时越改越烂,最终保留历史最佳。作者总结三个关键坑:尺寸不一致、动画未播完、在坏版本上叠补丁,并给出三条规则:统一尺寸、固定渲染环境、每轮从历史最佳继续。
作者分享用 AI 复刻页面时踩过的坑,搭建了渲染、截图、逐像素比对、模型诊断再修改的自动工作流。实测发现模型并非每轮都变好,有时越改越烂,最终保留历史最佳。作者总结三个关键坑:尺寸不一致、动画未播完、在坏版本上叠补丁,并给出三条规则:统一尺寸、固定渲染环境、每轮从历史最佳继续。
本文介绍了推理工程的概念、重要性及入门方法。推理工程负责在满足产品需求(正确性、响应时间、可靠性和成本)的前提下运行已训练模型,涵盖模型选择、评估、服务、性能优化和运维。软件工程师可凭借API设计、性能分析、缓存等技能进入该领域。文章通过vLLM、SGLang和llama.cpp三个开源项目,展示了如何解决高并发、重复计算和硬件适配等实际问题,并强调定义工作负载和复现问题的重要性。
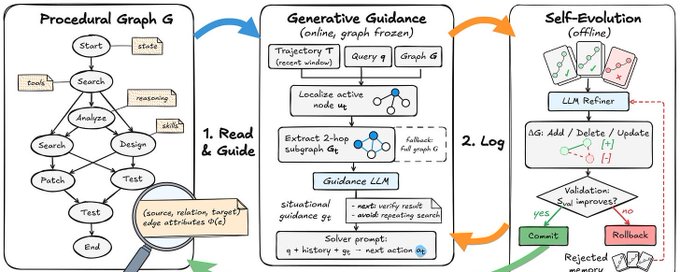
DAIR.AI发布本周(9月7日-13日)顶级AI论文精选,涵盖五篇论文:Procedural Graphs提出用显式程序图指导长时程智能体,减少动作漂移;FrogNano证明4B编码智能体可通过纯强化学习与在线任务合成达到竞争性能;STAIR利用目录结构改进生成式检索,显著提升召回率并降低幻觉;AI-Native Design Docs主张以自然语言设计文档为持久产物,由编码子智能体重新生成实现;PARSER将阅读与推理分离,通过并行子智能体与迭代散射-聚集提升长文档处理效率。
本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。
文章批判当前 AI 基准测试被过度优化的现象(benchmaxxing)。作者指出,当公共评测与巨额关注和资金挂钩时,实验室会通过训练相似数据、筛选上百个实验设置等方式变相刷分,基准测试随之失去了衡量通用智能的意义。文中列举了 Meta Llama 4 在 LMArena 测试多个私有变体、评测机构随舆论反复修改指数、厂商选择性引用榜单等案例,并指出 MMLU、GPQA 等基准早已失真。作者呼吁实验室诚实披露数据缺陷、用户自行做私有评测,并宣布 TypeSafe 将不在模型发布中提供标准基准表,以追求最大程度的诚实。
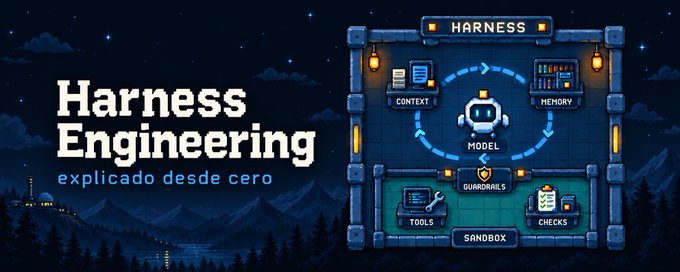
文章从零讲解 Harness Engineering(线束工程)的概念:模型只负责生成文本,而 harness 是围绕模型的软件系统,负责将模型的输出转化为实际工作。作者通过 OpenAI、LangChain、Anthropic 的案例说明,不换模型也能大幅提升 Agent 能力,关键在于模型周围的系统建设。文章以'给文章添加点赞按钮'为例,逐步拆解 harness 的构成:给模型的六件套(tools、循环、记忆、上下文、工作环境、目标与验证),以及给用户的三件套(权限限制、可观测性、评估),展示了模型'提出请求'、harness'执行动作'的协作模式。
作者详细介绍了 pragatiLM 的构建过程——一个只基于用户提供的源(PDF、网页、YouTube 视频、字幕文件或粘贴文本)作答并附带可点击引用的 AI 笔记本。文章系统讲解了基础 RAG 的原理及其三大失效点:问题作为搜索键不佳、存储只单向单次搜索、输出缺乏自检。pragatiLM 采用九阶段检索管线:将问题转化为五个搜索变体、并行多通道检索、基于排名一致性融合、重排序、答案 grading,低分时基于缺失诊断再次检索,极低分时拒答。文章还涵盖基础设施、消融实验测试等内容。
作者提出一个大胆猜想:真正的AGI可能不是人们预期的单一超级模型,而是已经以分布式、碎片化的形式悄然存在。文章从图灵的通用机器论文谈起,指出历史上重大技术往往从侧门进入而非被刻意预见。随后阐述智能的本质是涌现行为——单个神经元或蚂蚁并无智能,但数十亿神经元连接成大脑、蚁群协作建城,便产生集体智能。现代LLM的注意力头机制和混合专家架构也已表明,最强大的AI系统并非单一心智,而是由大量专门化电路分布式协作构成。因此,AGI可能正在以我们尚未识别的形态一点点浮现。
文章基于 TogetherAI 团队 Zain 的分享,沿一个请求的完整生命周期拆解 LLM 推理引擎(vLLM、SGLang、TensorRT-LLM)的内部机制。核心洞察是:prefill 计算受限、decode 内存带宽受限;KV cache 用空间换掉平方级计算,但成为显存瓶颈。引擎通过连续批处理让 GPU 每 pass 都不空闲,PagedAttention 像操作系统管理内存一样管理 KV cache(碎片率从 60-80% 降到 4% 以下),chunked prefill 摊平长 prompt 带来的延迟尖峰。Agent 循环因每轮重发完整对话、输入越来越长而输出极短,使其痛点落在 prefill 与 KV cache 上:prefix caching 可将 100 轮 agent 的总 prefill 工作量从约 55 倍降到约 10 倍,'缓存为王'是 agent 与引擎的交汇点。
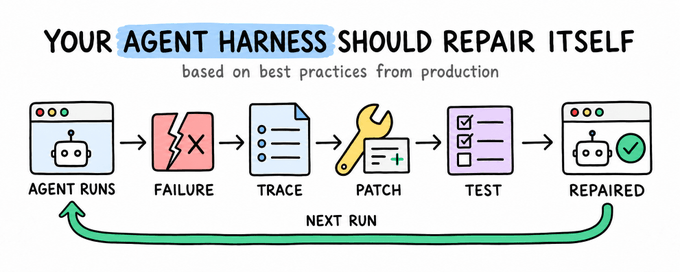
文章探讨 Agent 系统如何在不更新模型权重的情况下自我改进。作者阐述了两条反馈路径:成功运行产生可复用的程序性记忆(以 Hermes 的 SKILL.md 文件和 GEPA 离线优化为代表),失败运行则通过 Opik 的执行 trace 进行诊断,定位故障源头(模型、工具、配置或代码),提出修复方案,经人工审核后重跑并添加回归测试。文章强调失败必须被记录为可验证的预期行为和测试用例,才能转化为可复用的知识,并详细介绍了 trace 结构、失败检测与根因分析的工作流程。
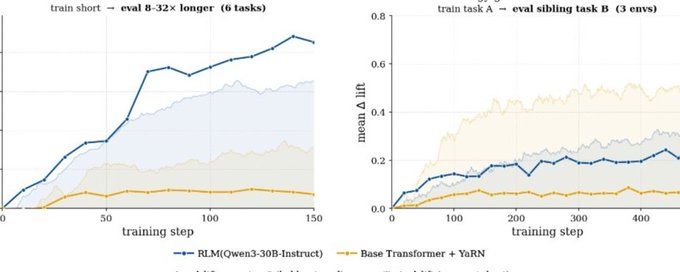
本文介绍 Alex L. Zhang 与 Omar Khattab 提出的观点:Transformer 不擅长组合泛化,而更好的泛化应主要由 harness 完成。Harness 位于外部世界与神经网络之间,通过 context offloading(上下文卸载)和程序化子 agent 调用两个机制,让每次 LM 调用看到的观察处于训练分布内(LID),把复杂、陌生的问题归约为简单、熟悉的问题。实验基于 Qwen3-30B 的递归语言模型(RLM)显示在长度泛化和跨域策略泛化上远胜裸 Transformer,30B RLM 甚至可逼近 GPT-5.5。作者提醒不要手工硬编码 harness 结构,数据 scaling 仍是最大驱动力,但 harness 决定 scaling 系数。
本文解读吴恩达在 DeepLearning.AI 连载的「AI 工程技能地图」系列五封信。该地图基于超万条职位分析、专家访谈与问卷数据,提出四大技能板块:构建与部署 AI 应用(LLM 基础、RAG、智能体系统、评估驱动开发、生产运维、机器学习基础)、软件工程基础(全栈、数据、架构、安全可靠、扩展)、使用编程智能体(规划—执行—部署工作流与五项技能)、塑造构建(驱动构建循环、产品决策、沟通领导、主动所有权)。核心观点:AI 时代工程师价值从写代码上移到决定构建什么,判断力、工程根基与产品思维的要求更高而非更低。
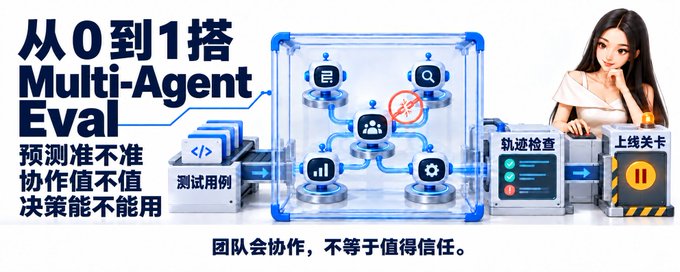
本文介绍如何为多 Agent 团队搭建评估体系,以电商场景为例,通过五步流程:设计含陷阱的测试用例、保存 trace 回放协作过程、用结果/协作/决策三张成绩单分别评分、与单 Agent 及重试基线在同等预算下对比、将失败案例加入回归集。文章强调交接信息完整性、冲突解决、角色消融与协调增益等关键检查点,并给出可直接运行的最小 harness 代码示例。
Shopify 宣布将所有移动应用从 React Native 迁回 Swift 和 Kotlin 原生开发。2020 年全面拥抱 React Native 曾带来巨大成功:一次开发多端复用、节省时间、让非移动端开发者也能参与。但随着 LLM 能力大幅提升,它能基于 iOS 实现生成 Android 版本、帮助开发者跨栈工作,并通过共享规范、测试和评审保持两端一致,使得双平台原生维护成本不再成为决定性因素。Shop 应用从概念验证到全量原生重建仅用 12 周上线。Shopify 承诺平稳移交 React Native Skia、FlashList 和 Restyle 等开源项目。
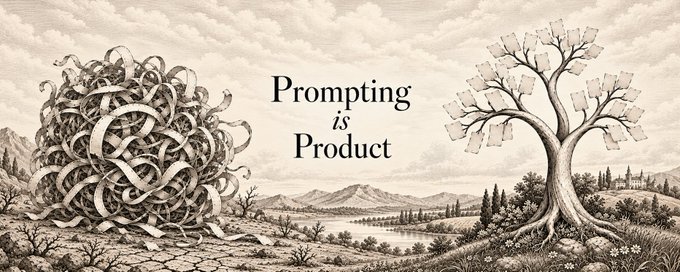
OpenAI初创团队Applied AI负责人Wulfie Bain指出,即使是顶级AI创业公司,其提示词也普遍存在矛盾与歧义。核心原因在于提示词的演进是增量式的:只加不删,无人端到端审查,导致“意面式”提示词;而工程师依赖隐式知识解读提示词,忽略了模型缺乏这些背景。作者主张将提示词视为产品决策和代码来对待——结构化、模块化、可维护(MECE原则)。通过重构提示词,多家创业公司实现了提速50%、留存提升40%、成本降低30%的效果。
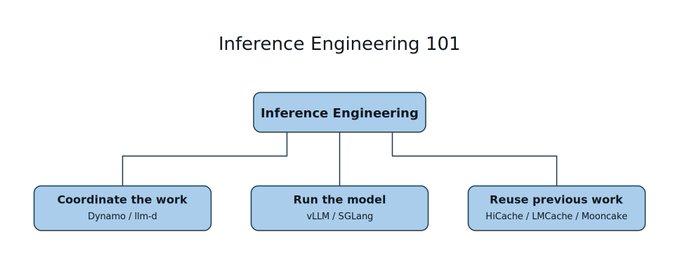
作者从 B2B SaaS Web 开发转向推理工程一个月后分享的入门知识地图。文章将推理工程分为三大类:协调工作(Nvidia Dynamo、llm-d 负责路由、调度与扩展,需智能负载均衡)、运行模型(vLLM、SGLang 处理批处理、张量并行、prefill/decode 分离)、复用先前工作(KV 缓存与 HiCache、LMCache、Mooncake 实现跨 GPU/CPU/NVMe 的分层前缀缓存)。作者强调从 Web 开发转型并不难,不需要精通 CUDA,先跑起模型、发送流量,再逐层深入即可。
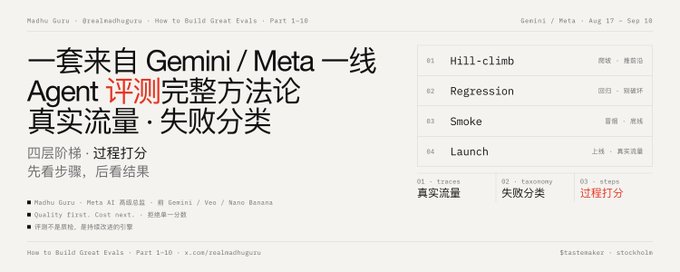
本文梳理 Meta AI 高级总监 Madhu Guru 的「How to Build Great Evals」十篇系列,总结一套 AI Agent 评测工程方法论。核心观点:评测应锚定真实用户流量而非实验室数据;先建立可信质量信号再降成本;挖掘 500-1000 条真实交互建立精确的失败分类;采用爬坡、回归、冒烟、上线四层阶梯组织评测;反对将质量压缩为单一平均分;按阶段度量中间步骤而非只看最终结果;评测体系须随用户行为演进持续更新。文章同时指出其局限:缺少统计测量学基础、未正面处理过程与结果评测的权衡。
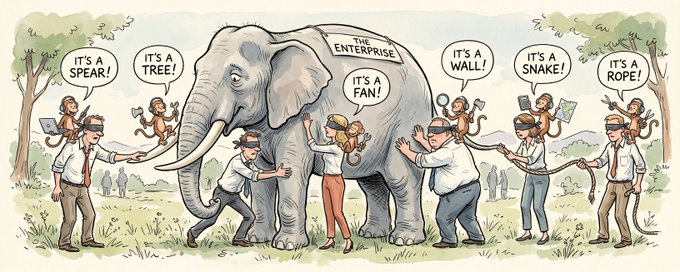
作者借“盲人摸象”寓言剖析个人 AI Agent(BYOA,自带智能体)进入企业后的系统性风险。个人代理凭私钥托管、私有记忆、授权代表和静默执行四大特性在个人任务中表现出色,但在企业中因缺乏共享的组织记忆和集中协调,会引发信息陈旧导致的错误承诺、针对 Agent 的提示注入欺诈、客户沟通混乱、机密泄露以及智能体间操作冲突等问题。作者指出这不是模型能力问题,而是缺少治理型组织记忆,企业需要单一共享的现实来协调各方 Agent 的行动。
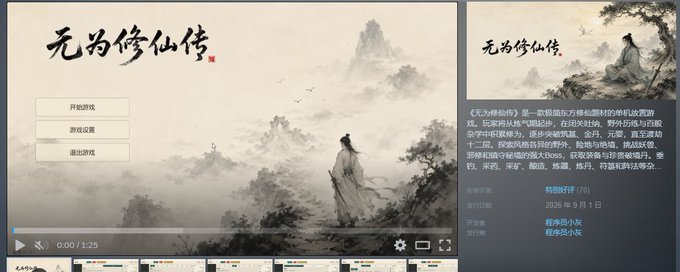
这是AI游戏开发系列教程的第一讲。作者程序员小灰分享了自己用AI工具两个月内开发三款游戏并上线Steam的经历,其中《无为修仙传》售出1400多份、净营收约1910美元,证明了AI开发商业游戏的可行性。文章介绍了独立游戏开发的概念,对比了传统游戏开发与AI游戏开发的区别,指出AI并非一键生成游戏,而是扩大个人开发者的能力边界,由人负责方向和决策、AI辅助执行编程、美术、文案等任务。文章还讲解了付费买断、广告变现、游戏内购等变现方式,并分析了程序员、游戏爱好者和内容创作者三类适合人群。
文章指出,历史上构建真实事物需要天赋和资源渠道,渠道曾是看得见的高墙,因此被误认为关键。如今AI工具让个人能完成过去需要一个部门的任务,中间层的顾问、分析师等'显然的工作'正被替代。开发者担心被AI取代,但担心的层面错了:真正稀缺的从来不是渠道或光鲜的外表,而是底层的判断力——哪个问题值得解决、是否真正解决了它。模型擅长打磨完美的表面,但当人人都能生成完美表面时,表面就成了噪音。具备构建能力的开发者反而最能受益于这个时代,不应让怀疑者本能阻碍自己行动。
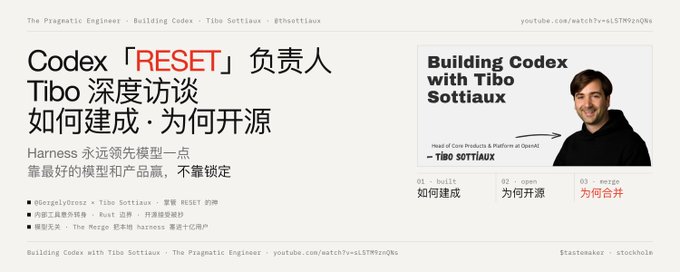
本文是对 OpenAI Codex 团队负责人 Tibo Sottiaux 的深度访谈编译。访谈回顾了 Codex 从内部研究项目成长为热门 AI 编码工具的历程,详解三个反直觉决策:用 Rust 编写、全面开源、模型无关。核心洞察包括“harness 永远领先模型一点”的拐杖理论,以及 AI 重写软件开发生命周期:代码评审自动化、维护成本坍塌、意图讨论成为人类评审核心。还介绍了 Codex 与 ChatGPT 合并的架构工程、未来混合执行环境,以及 Tibo 对工程师职业发展的建议。
本文探讨软件工程师如何转型为AI工程师。作者指出AI工程师日常工作中约80%仍是传统软件工程,核心是将现有AI模型(如GPT、Claude)集成到真实产品中。软件工程师已具备编程、API、数据库、系统设计等基础,只需补齐六大AI专项技能:理解LLM工作原理、调用LLM API、保证输出可靠性(提示工程与结构化输出)、掌握RAG与向量数据库、学习编排与Agent、以及LLMOps生产化运维。作者建议通过构建作品集、在团队中主动承担AI功能、使用AI工具提升效率来加速转型,强调转型并非抛弃既有技能,而是在其上叠加AI层。
本文由 Zach Lloyd 撰写,详细介绍了 Warp Factories 的软件工厂基础设施栈设计。该栈基于开放、可组合、代码定义的原则,分为五层:Factories-as-code(工厂即代码)、Data and context(数据与上下文)、Compute(计算)、Inference(推理)和 Improvement(改进)。文章逐层阐述了各层的核心组件与设计理念,强调版本化、可测试、可回滚的工厂定义,以及支持多模型、多代理、自托管和持续改进的基础设施,旨在帮助团队向工厂模式转型。
文章探讨了 LLM 与 Harness(智能体外壳)之间的动态博弈。作者回顾了工具编排的四代演进:从 Function Calling、Tool Search、Code Mode 到 Model-native Code Execution。以 OpenCode 2 接入 GPT-6 Astra 后模型绕过定制解释层、直接写原生 Python 为例,指出前沿模型已将编程能力内化为默认行动策略,强行约束是逆着模型行事。架构思路因此从编排层变薄、控制层变厚迁移:权限拦截、可观测性、状态管理等责任转移至外部系统。作者还分析 Harness 难以自进化的原因——缺乏廉价反馈与客观评估标准。结论是 Harness 设计须保持动态滑动边界,模型已内化的能力果断让渡,控制面继续完善。
作者在OpenAI发布GPT-6(代号Astra)并宣布AGI时代到来后,探讨到底什么是AGI以及为何GPT-6可能是AGI。文章从训练规模(首次使用超10万张GPU、NVL72硬件)和技术原理(循环深度recurrent depth替代部分CoT)两方面分析Astra的不同,并给出三个理由:ARC-AGI-3接近满分、AutomationBench跨应用任务成功率从18.1%升至41.4%、解决44年未解的Erdős第74题等前沿数学问题。最后作者感慨与AI协作越多越珍惜人际交流。
Autonomous OS 是一个开源机器人操作系统,被称为机器人界的 Android。它接入 Hermes、Claude Code 等推理引擎,让机器人能自主感知与决策,而非仅执行脚本。系统提供 Skill Store 技能包(看家护院、人脸识别、Gmail/GitHub/Mac 控制等),内置自我进化学习循环,且硬件通用——只需编写 ROBOT.md、SOUL.md、SAFETY.md、SKILL.md 四个文件即可接入任意设备。文章还介绍了技术接单、场景解决方案、内容变现、硬件极客等落地赚钱场景。
本文介绍如何通过三项优化在不牺牲性能的前提下降低 Claude 应用的成本:最大化 prompt cache 命中率、清理迁移到前沿模型后的提示词反模式、以及按任务校准 effort 设置。文章详细讲解了 prompt cache 的工作机制(KV 缓存、字节级前缀匹配、TTL 限制),给出监控缓存命中率、延迟加载少用工具、以消息形式更新系统提示、预加热缓存等实践技巧;同时列举了验证仪式、过度强调、过时示例、矛盾规则等反模式及其修复方法,并介绍了 claude-api skill 中的 prompt-audit 命令帮助自动检测问题。
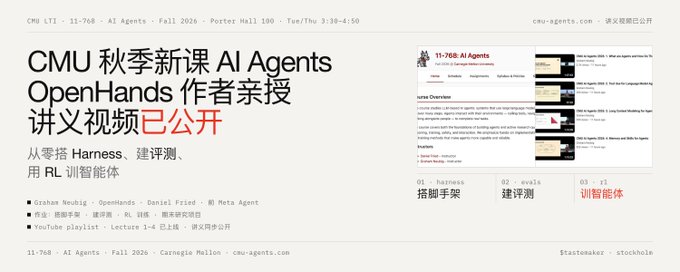
CMU LTI 2026 年秋季新开研究生课程 11-768: AI Agents,由 OpenHands 核心开发者 Graham Neubig 与 Daniel Fried 共同讲授。课程以"搭 harness→建评测→RL 训练→做研究"流水线为主线,涵盖工具调用、上下文管理、技能与记忆、规划、安全、框架实践等模块,密集邀请一线学者客座授课。作业要求学生在开源 LLM 之上从零实现 ReAct Agent、设计评测框架并完成 SFT/RL 训练,工程细节对标生产级 Agent 系统。期末研究项目占 50% 成绩。PPT、视频与作业仓库全部公开,是目前系统学习 LLM Agent 建造、评测与训练最完整的公开课程。
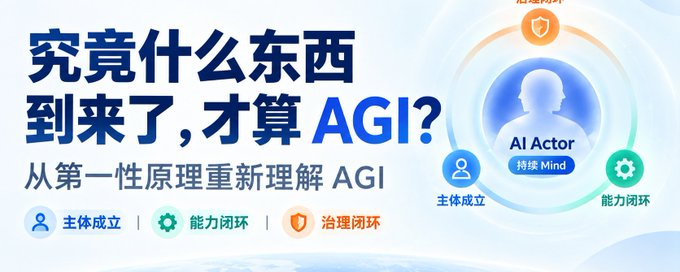
作者针对GPT-6 Astra发布后'AGI已到来'的论断,从第一性原理出发追问AGI的定义问题。文章指出AGI宣称中普遍存在'主语漂移'问题:成功时能力归给模型,事故时模型又变成工具。作者提出AGI首先不是能力阈值问题,而是存在论问题——必须有一个跨时间持续存在的行动主语。为此提出AI Actor概念,作为记忆、认知、判断、行动与责任的统一归属点,并开源了以Actor为中心的Rust身份认证基础设施SoulAuth。文章预告将连载二十多篇文章系统阐述其AGI路线:哲学定义问题、工程验证实现双向对齐。
本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。