Wiki 知识库

全部文档 / 标签: 大模型

158 篇
清除

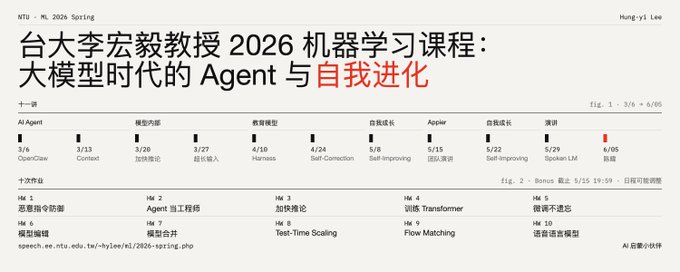
台大李宏毅教授 2026 机器学习课程更新:大模型时代的 Agent 与自我进化

文章介绍台湾大学李宏毅教授 2026 春季机器学习课程,该课程完成了从经典机器学习到大模型时代前沿课的彻底转型。课程以四幕叙事展开:AI Agent 与 Context Engineering、模型内部架构(Flash Attention、KV Cache、位置编码)、模型教育(Harness Engineering、自我修正)、模型自我成长(Self-Improving、自我进化 Agent)。十次硬核作业与授课主题严格对应,涵盖 LLM 安全、Agent 搭建、推理优化、后训练等技能。文章认为课程演变折射学科趋势:Agent 成应用层范式、系统级工程能力重要、后训练时代重心移向环境设计与模型自我进化。

技术 › LLM meng shao 2026-09-2710.2 KB 22.4K 222 85

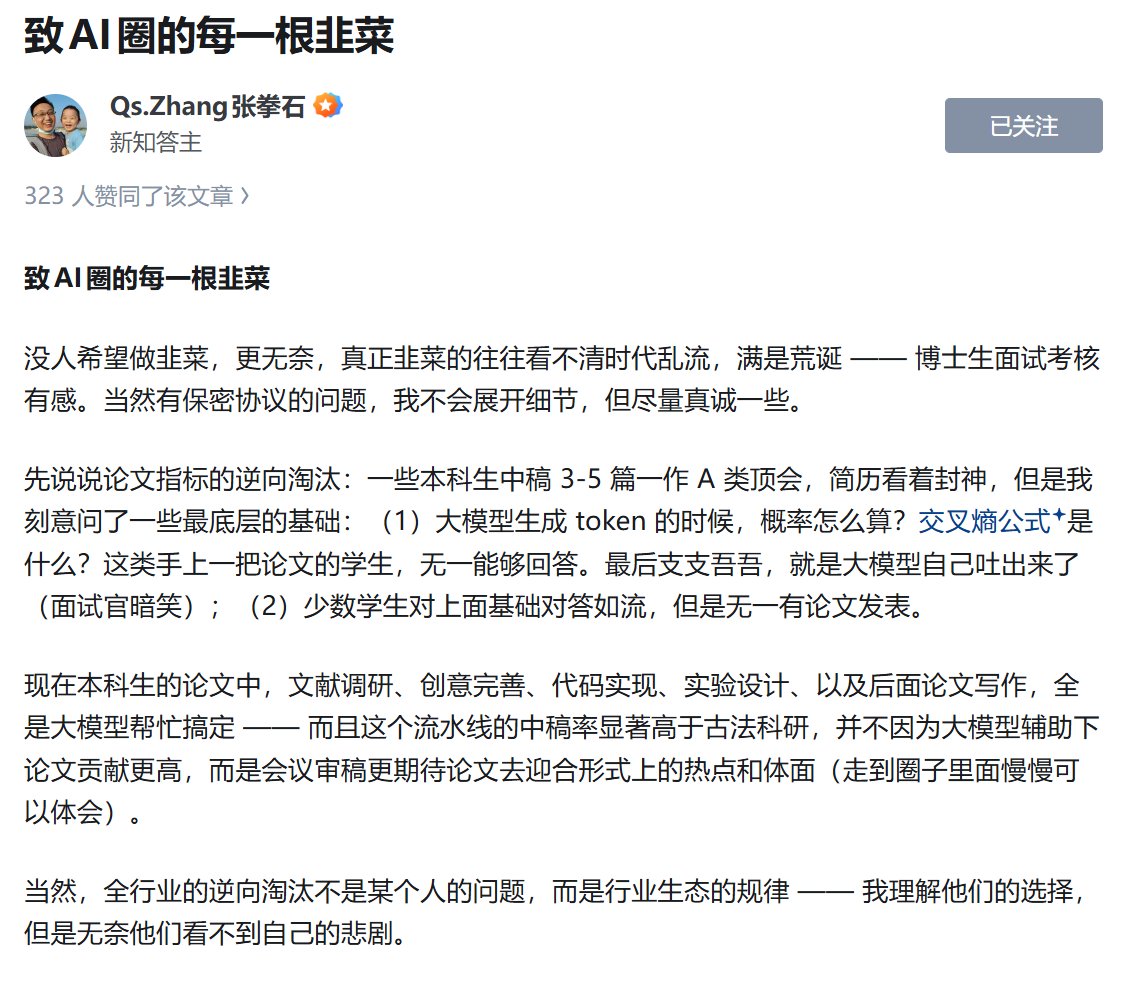
读张拳石《致 AI 圈的每一根韭菜》有感

作者分享张拳石老师《致 AI 圈的每一根韭菜》一文的读后感。文章指出一些本科生虽有3-5篇顶会论文,却答不上大模型生成token概率、交叉熵等基础问题,因为文献调研、代码、写作等环节都可由大模型代劳。论文越来越容易生产,数量加速贬值,真正难替代的是底层理解、问题判断与研究动机。作者结合读博经历感慨:读博需五六年,而AI研究范式一年数变,追热点风险极高。文章适合做AI研究和准备读博的人阅读,促使思考:当写论文变容易后,如何判断研究者真正的能力。
技术 › LLM Xudong Han 2026-09-261.5 KB 51

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

锐评一下 Jev 和狂躁的 AI 圈

作者对近期爆火的 Jev 模型进行冷静剖析。通过分析 JevPilot 自动驾驶、通关《宝可梦·红》、大战《毁灭战士》等热门项目源码,指出其炫酷演示背后主要依赖传统算法和剪辑包装,Jev 真正参与决策极少。Jev 本质是低延迟、低成本的判别分类架构,只能做单步选择,缺乏长程推演能力。作者认为与其让大模型生成选项再由 Jev 裁决这种毫无意义的使用方式,不如将其用于任务前置过滤分流等真正能降本增效的场景,呼吁 AI 圈少些浮躁炒作,多沉下心寻找实际应用价值。

技术 › LLM 林亦LYi 2026-09-246.3 KB 9.1K 50 75

抢到 Jev 内测后我懵了:这玩意儿跟大模型到底啥区别?

作者以技术小白视角分享 Jev 内测体验,用大白话解释 Jev 与 ChatGPT、Claude 等大模型的区别。传统大模型操纵电脑需逐步截图、生成指令,速度慢;Jev 则不做长文本生成,只做单选题式快速决策,几十毫秒内从页面可点元素中选定下一步,配合机械手执行。文章引用多个社区实测:Browser Use 创始人搜机票仅 7 秒、成本约 $0.0039;idan 的 WebMCP 基准显示 Jev 加 WebMCP 从 25/49 提升到 49/49,成本仅顶级大模型 computer use 的 1/112。作者认为未来 AI 协作是大模型规划、Jev 秒选、程序执行的分工模式。

技术 › Agent C Chris 2026-09-246.2 KB 399.4K 262 70

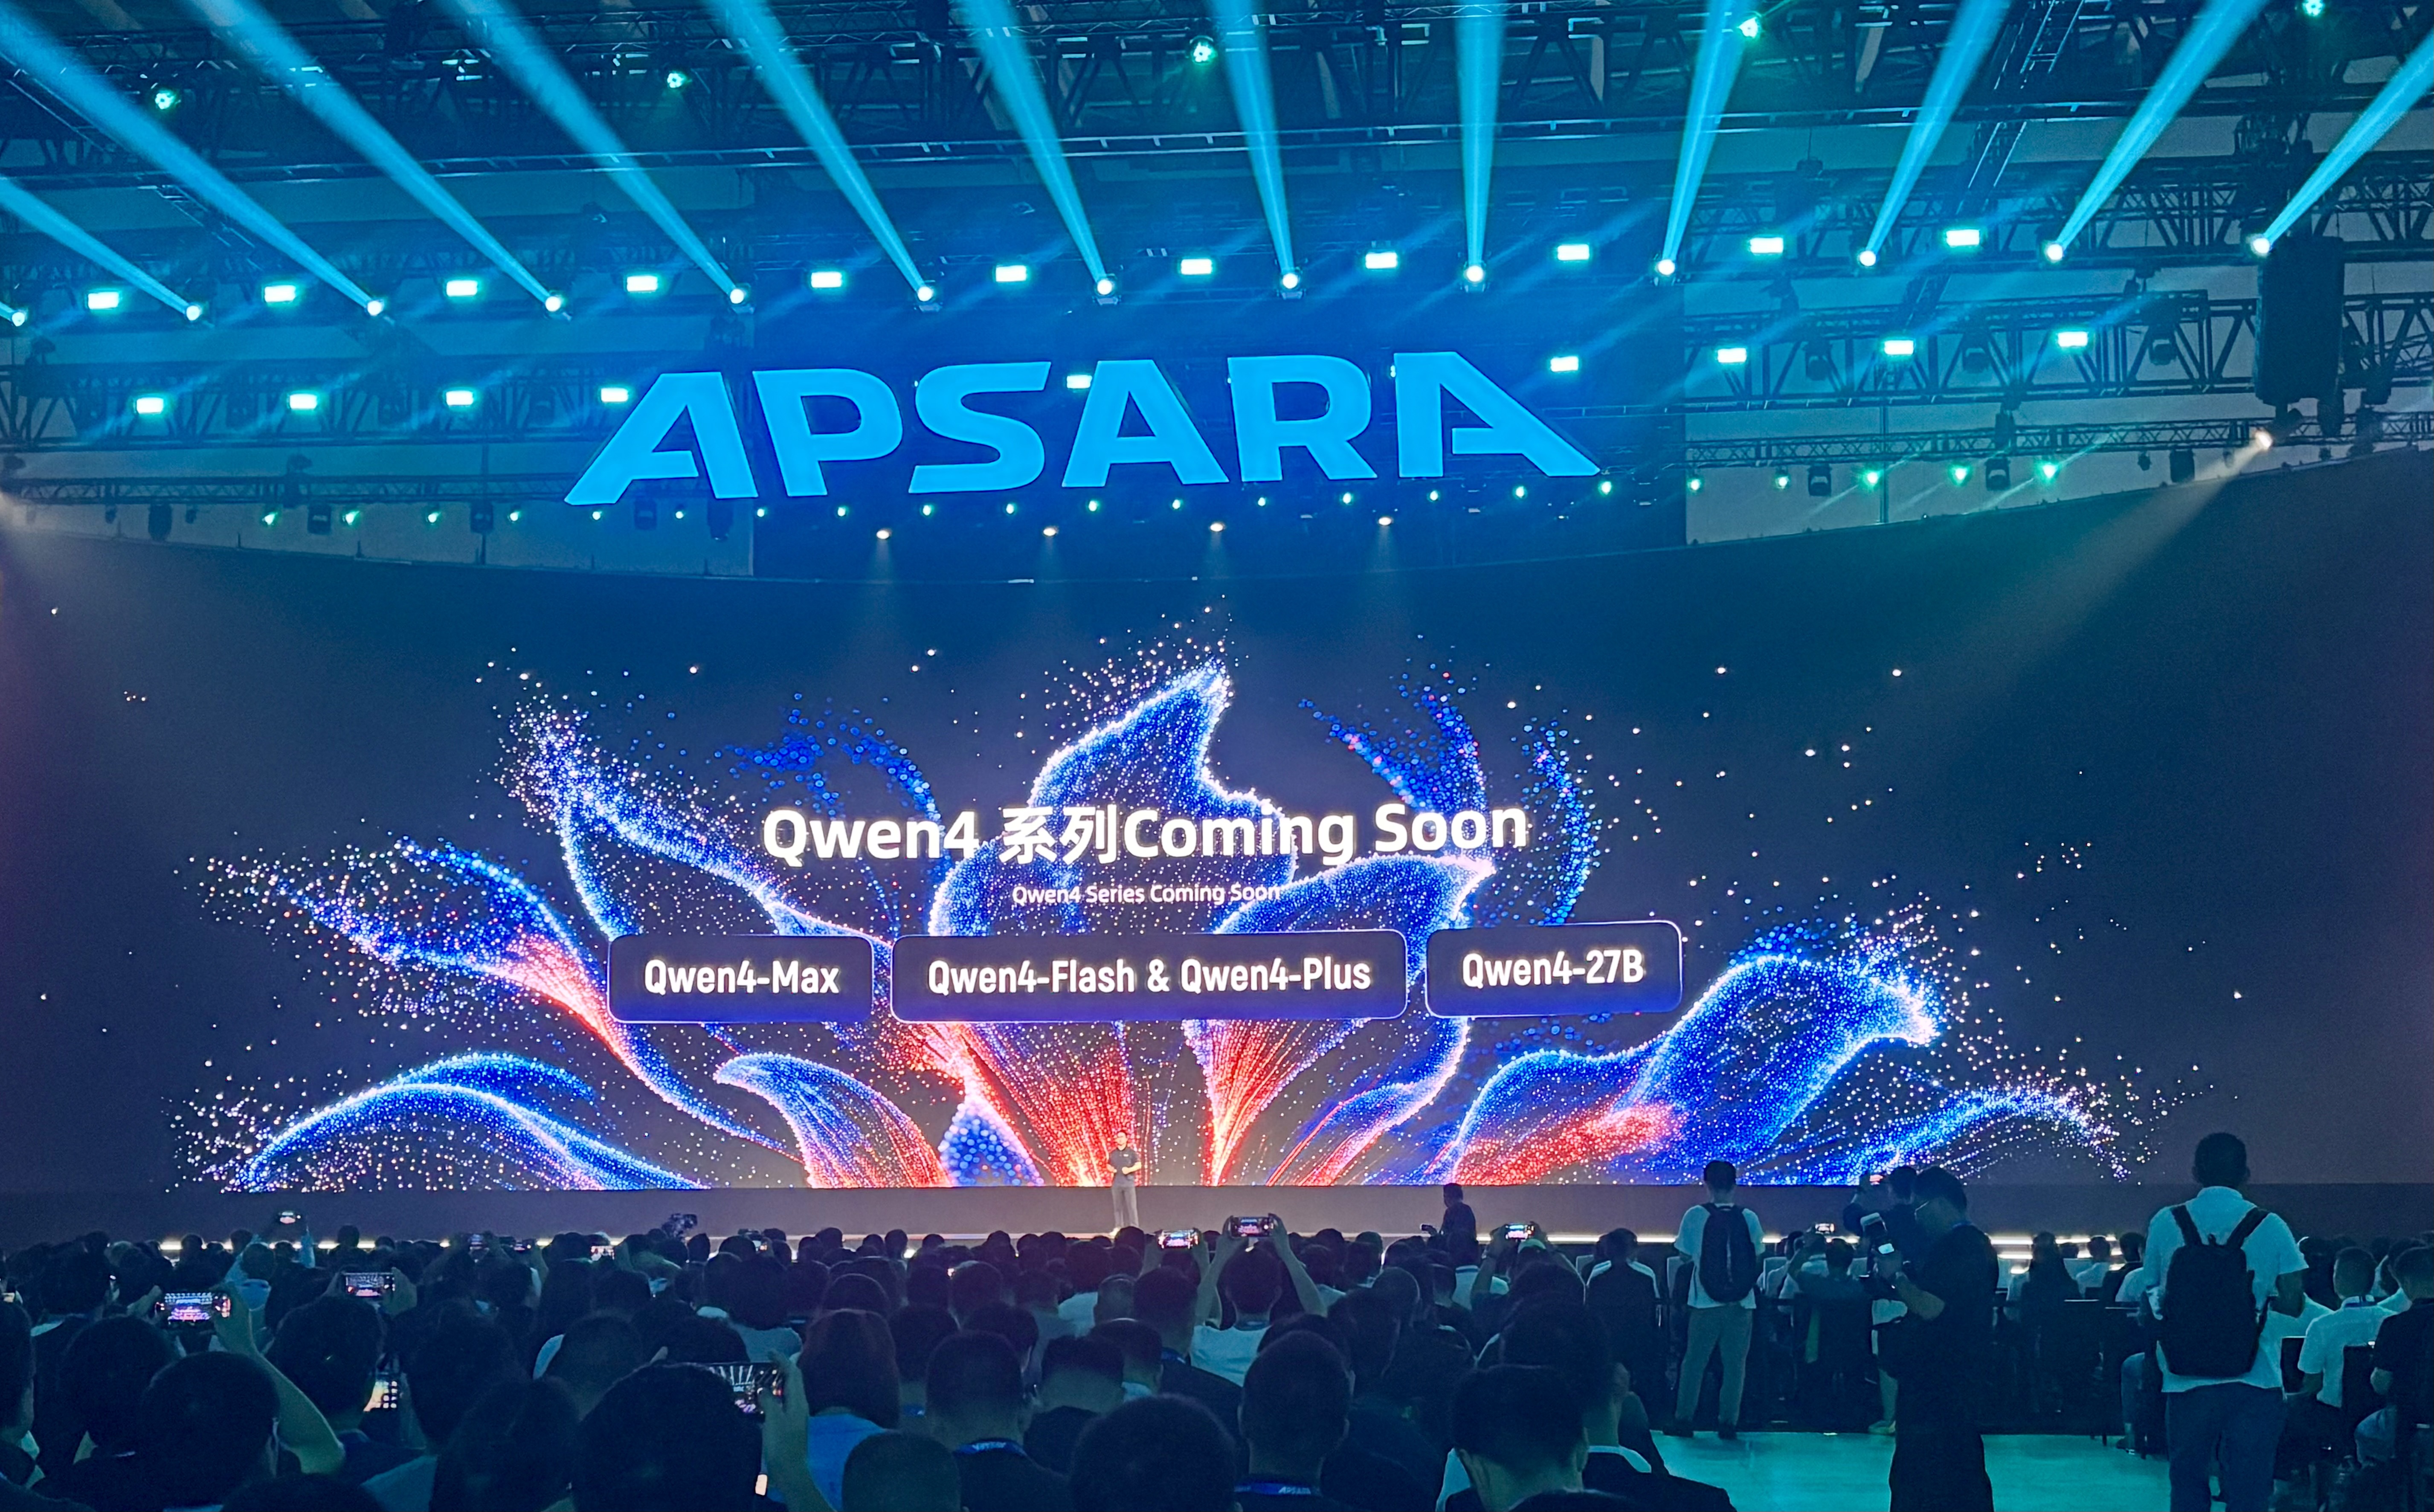
Qwen 发布会观察:从模型训练到芯片协同的完整研发体系正在形成

作者总结了 Qwen 发布会的重点:除了新模型外,更值得关注的是 Qwen 形成了从模型训练、推理优化到芯片协同的完整研发体系。核心亮点是 RSI 递归自我进化,Qwen3.8-Max 在少人工干预下连续运行一个多月完成 33 轮迭代,包括自主优化 SGLang 提升 96% 吞吐、芯片设计中减少 42% 物理实现面积。Qwen3.8-Omni-Flash 统一多模态理解框架支持 1M 上下文,价格大幅下降约九成。Qwen4 已开始训练,未来参数量将扩展到 5 万亿至 10 万亿。开源生态方面,累计下载超 30 亿次,衍生模型超 30 万个。

技术 › LLM Ding (@dingyi) 2026-09-233.0 KB 63

一夜之间!Opus5.5、GPT-6 Sol、GPT-6 Luna全来了

Anthropic发布Claude Opus 5.5,比Opus 5便宜40%、速度快30%,跑分全面超越Fable 5.1,并推出订阅用户一次性的额度reset功能。一个半小时后,OpenAI发布GPT-6 Sol和Luna,大幅降价,Luna价格杀入DeepSeek区间。作者实测对比了Opus 5.5、Opus 5和Fable 5.1在鹈鹕骑单车SVG、Blender建模宋代斗拱、机械蝴蝶等任务上的表现,发现Opus 5.5综合成本省29%-55%,agent能力强,但max档反而不如medium档。文章详细分析了各模型跑分、价格策略和Claude Code更新要点。

技术 › LLM 花叔 2026-09-2322.0 KB 41.5K 45 81

DeepSeek,华为,「必须成功」:十六万颗萤火照进荒原

文章讲述了DeepSeek与华为两条看似毫无交集的技术路线如何走向深度结盟的故事。幻方量化创始人梁文锋早在2019年就囤积算力(萤火一号、二号),而华为通过海思备胎计划在实体清单后推出昇腾芯片。在英伟达对华禁售后,DeepSeek以极致工程能力用低配H800训练出V3和R1,震撼硅谷并引发英伟达市值暴跌。2026年,梁文锋押上200亿元,联合华为将下一代旗舰模型迁移到纯国产昇腾底座,并在内蒙古规划16万颗昇腾芯片的超大型数据中心。这是一场被地缘封锁逼出来的、别无选择的技术突围。

技术 › LLM Sleepy [@sleepy0x13] 2026-09-2216.1 KB 20.4K 3 68

DeepSeek 采购华为昇腾芯片:The Information 报道中的细节解读

The Information 报道称,华为最早将于 2026 年 Q4 向 DeepSeek 大规模交付 16 万枚老款 950DT 芯片,用于内蒙古新数据中心,总价值约 26 亿美元,将是已知规模最大的华为 AI 芯片集群之一。文章分析指出,DeepSeek V4 延迟发布与华为芯片供应延迟有关,确定性比性价比更重要。华为昇腾芯片 2026 年实际产量受 HBM 短缺制约预计仅 20-30 万枚,远低于 75 万目标,封装产能也紧张。DeepSeek 同时自研推理芯片以避免依赖外部供应。文章认为中国大模型厂商在算力缺口下仍紧咬美国,值得尊重。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-223.3 KB 62

深入解读斯坦福在线课程 MS&E 319「高效生成式语言模型」

本文深入解读斯坦福 2026 秋季研究生课程 MS&E 319《Efficient Generative Language Models》。该课程以「效率」为设计科学,在算力预算有限的约束下,沿大模型生命周期系统讲授预训练、架构、推理、后训练四阶段的效率技术,包括多 token 预测、Muon 优化器、MoE、稀疏注意力、FlashAttention、KV 缓存压缩、量化、投机解码、LoRA、DPO 与蒸馏等,并涵盖越狱攻击与模型窃取等安全议题。文章认为该课填补了教育生态空位,内容前沿性与领域同步,揭示了每项效率技术背后的权衡取舍。

技术 › LLM meng shao 2026-09-2111.5 KB 18.9K 95 68

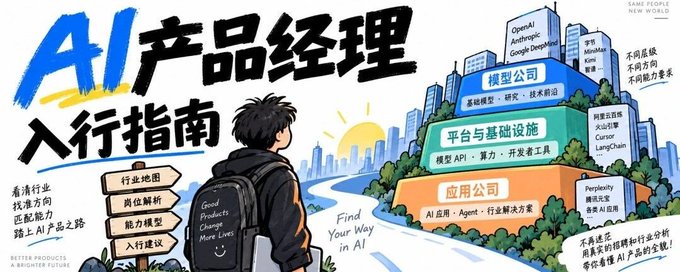
看完 100 多份 JD,我找到了入行 AI 产品经理的最佳指南

作者分析了 OpenAI、Anthropic、Google DeepMind 及国内字节、Kimi、智谱等十余家公司 100 多条产品经理招聘 JD,指出「AI 产品经理」并非单一岗位。文章将 AI 行业分为模型公司、平台基础设施、应用公司三层,各层对产品经理的能力要求差异巨大:模型公司看重模型评测与技术理解,平台层关注开发者体验与成本定价,应用层强调产品判断与场景转化。作者归纳出评测度量、跨团队推进、模型技术理解等七大能力维度,并针对应届生、有商业化经验者、大厂产品经理、非产品背景人群分别给出入行路径建议。

职场 › 职业发展 空格.space 2026-09-2111.1 KB 16.3K 106 83

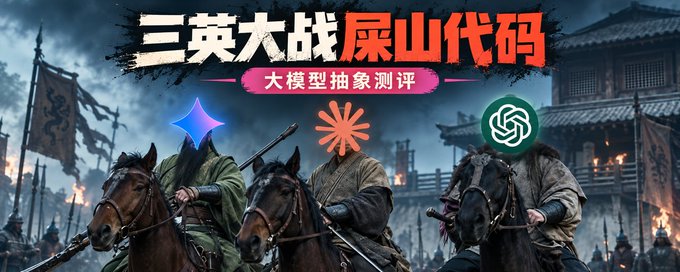
从未见过如此抽象的 AI 测评!三大AI大战屎山代码

文章介绍了B站兴起的AI测评生态:UP主用屎山代码改BUG、AI囚徒困境生存游戏、新三国梗问答、同一素材做游戏、量化交易回测等脑洞方式测试各大模型。与公开跑分榜单不同,这些由UP主临时出题、观众共同参与测评的方式避免了模型背题,更能反映AI真实能力。B站推出的AI无限竞技场将这些测评收进同一平台,29个主题、百大模型同场竞技,首期榜单第一名是GPT-6,但并非每个主题都是第一,体现了多角度测评的价值。

技术 › LLM 铁锤人 2026-09-207.6 KB 38.9K 24 61

Jev 模型实测:新闻分类任务上的速度、质量与价格三赢

作者分享了使用新模型 Jev 对《人民日报》新闻进行湖北相关元素分类的实测体验。此前该项目一直使用 Gemini Flash Lite 系列,积累约 2.4 万条数据。通过 OpenRouter 上线 Jev 后用相同提示词对比测试:速度上单篇耗时从 3 秒降至 0.35 秒,提升近 10 倍;质量上与 Flash Lite 仅 15% 判断不一致,且差异多源于人名知识库差异,实际正确率约 95%;价格上处理 5 千条数据 30M Token 仅花费 1 美元。作者认为 Jev 代表的分类器大模型在分类场景下实现了速度/质量/价格的不可能三角,极具前景,并计划连夜用于优化生产项目。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-195.0 KB 75

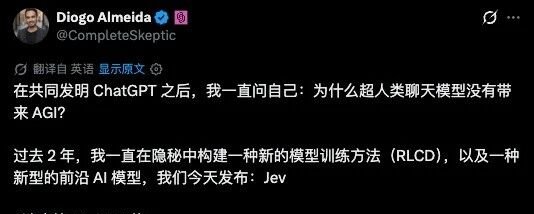
这个只会做选择题的Jev,却是今年我看到的最特别的大模型

TypeSafe AI推出的新模型Jev只做高频决策判断,不能聊天或写代码,是一个通用分类器。它由前OpenAI创始人Diogo Almeida打造,采用自研RLCD训练方法(面向校准决策的强化学习),响应仅需380毫秒,速度快20-200倍,成本低40-400倍。文章通过浏览器插件过滤X内容、玩马里奥、操控浏览器等案例展示其能力,并在预筛任务中与GLM、DeepSeek、Qwen对比,Jev在并行判断任务上综合表现最优。其名源自杰文斯悖论,寓意智能判断将因便宜而被大量使用,可能代表Agent时代的重要新方向。

技术 › LLM 数字生命卡兹克 2026-09-1812.4 KB 86.8K 457 80

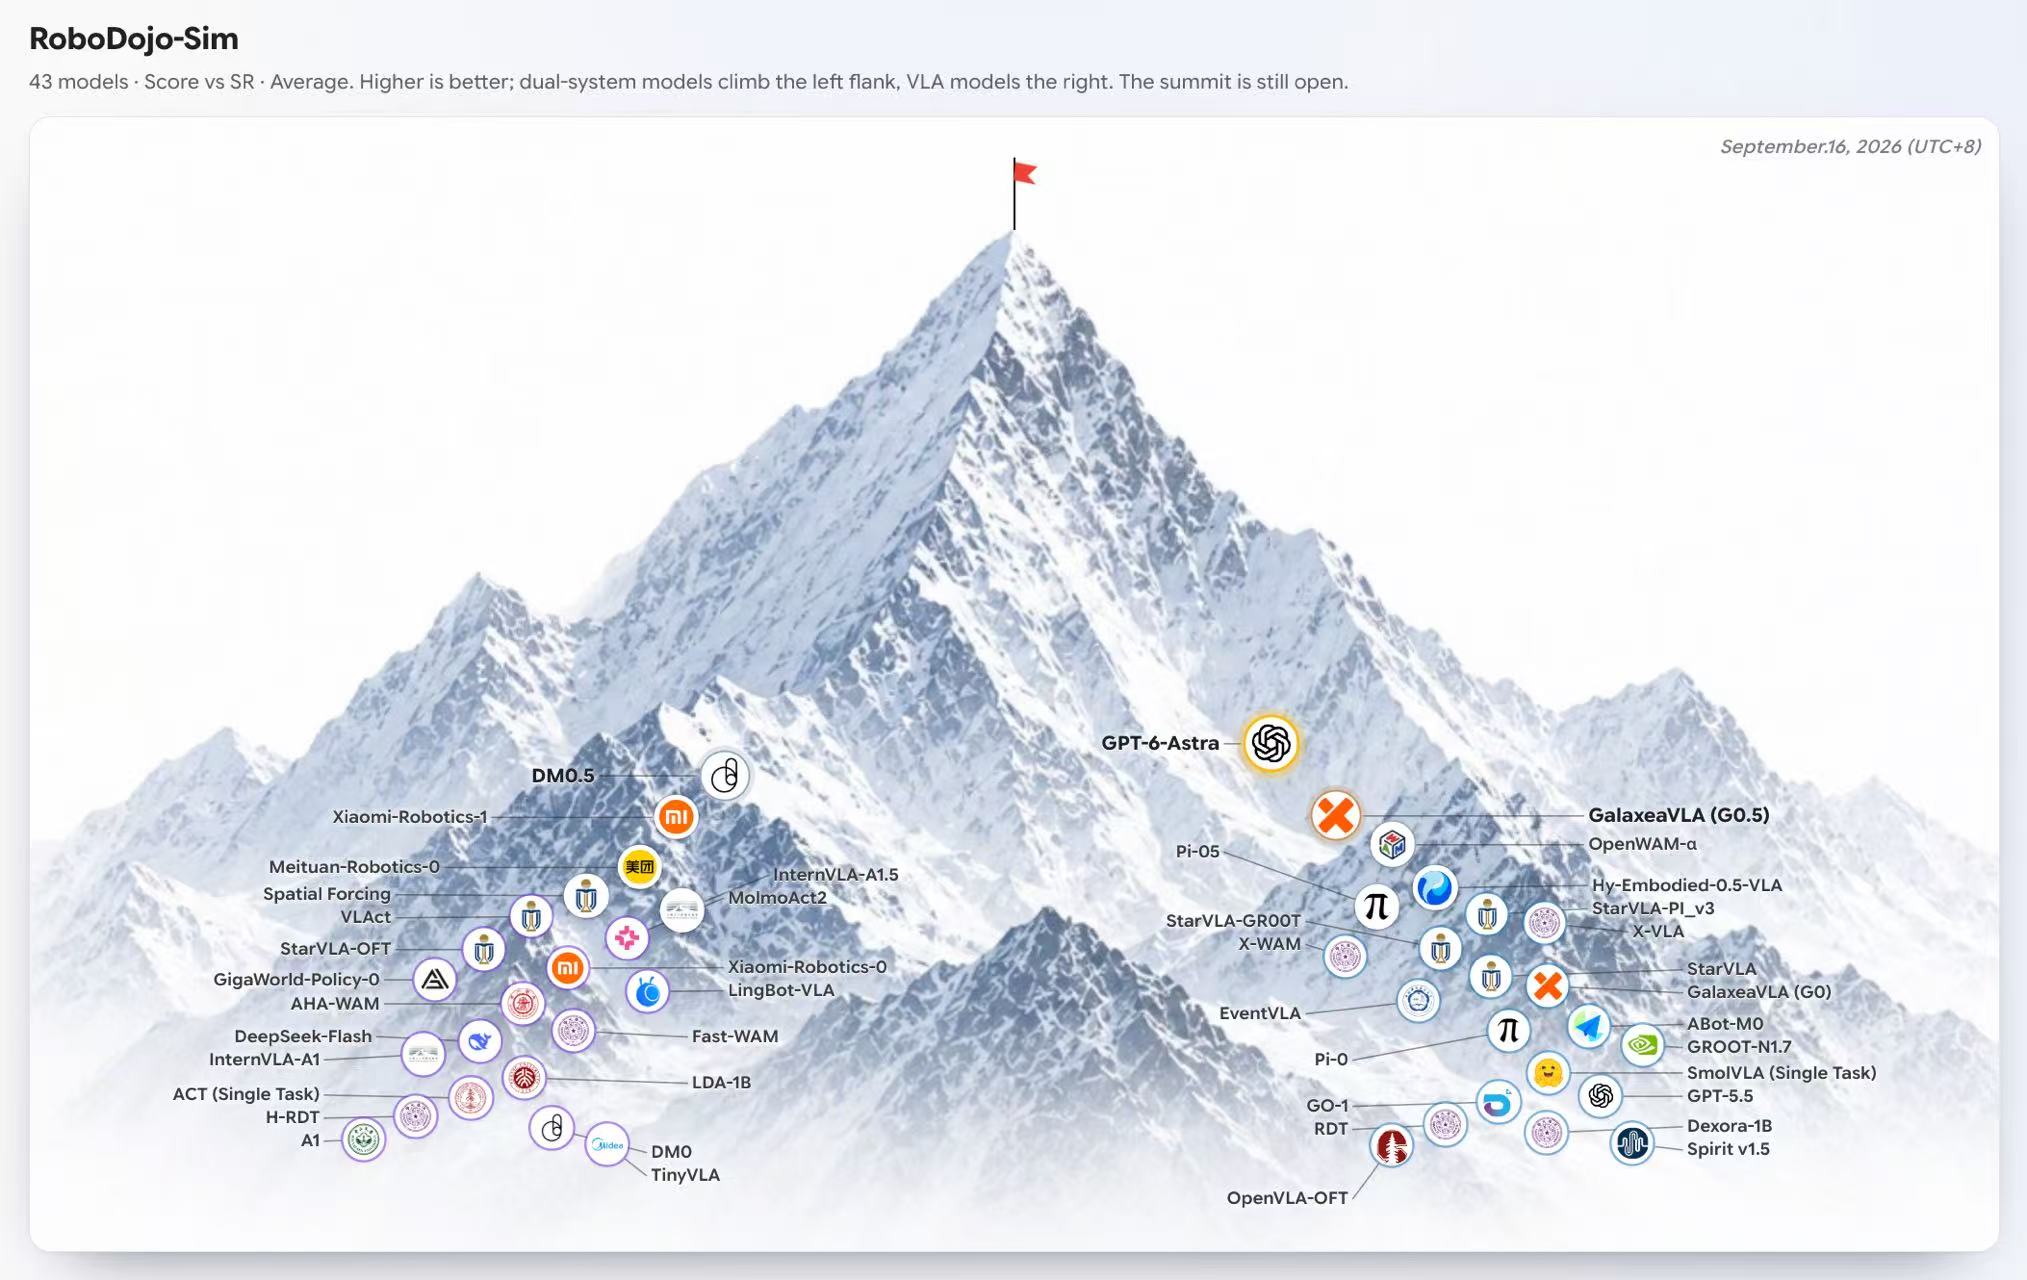
GPT-6 Astra 在 RoboDojo 中的具身智能评测

RoboDojo 团队对 GPT-6 Astra 作为具身智能体进行了全面评测,涵盖 RoboDojo 仿真与真实环境(对比 GPT-5.5 和 DeepSeek-Flash)、人形机器人高层控制、灵巧钢琴演奏(RoboPianist)以及上下文学习(ICL)的系统性研究。关键结论:GPT-6 Astra 展现出极强的语义与空间理解能力以及出色的上下文适应能力,但物理常识仍是明显瓶颈,揭示了理解世界与真正推理物理规律之间的重要差距。完整报告与演示发布于 robodojo-benchmark.com。

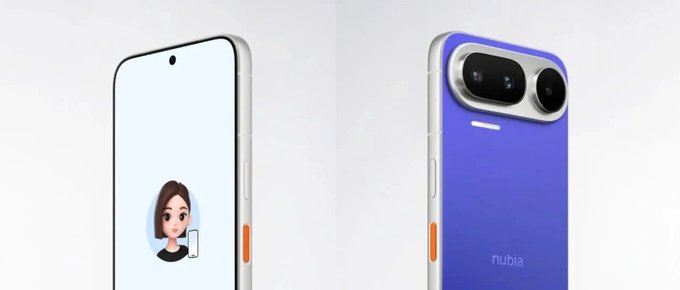
在折腾9个月后,手机Agent的王者,豆包手机助手它回来了

搭载豆包手机助手消费者版本的努比亚NaviX Ultra正式发布开售。作者提前拿到真机并实测:AI键首次加入指纹鉴权,保护隐私安全;复杂长程任务能力提升,可一次性完成飞书报销等流程,并支持任务排队与插队;记忆功能大幅升级,可记住用户偏好并自动执行重复任务;支持把跑通的流程保存为快捷指令;能理解屏幕内容直接干活;系统级应用如相机、录音接入更多AI能力。文章同时指出免费额度有限及生态支持受限等不足。

技术 › Agent 数字生命卡兹克 2026-09-1615.1 KB 29K 22 74

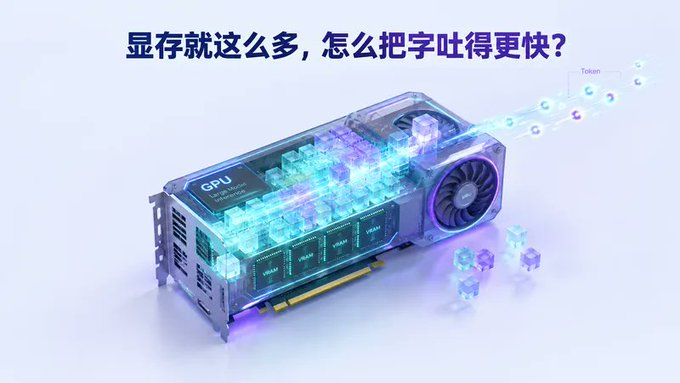
显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

Next Token 第二期:iPhone Duo、GPT 6 Astra 和 DeepSeek Flash

本文是视频播客《Next Token 词元之外》第二期的介绍。播客由橘子、杨攀、归藏、乔木等创办,解读前沿 AI 资讯。本期聚焦 iPhone Duo、GPT 6 Astra、DeepSeek Flash 及大模型降智等话题。iPhone Duo 凭借优雅的折叠动画和六种界面规范定义了折叠屏生态;GPT 6 Astra 以 3D 和 Computer User 能力出圈,被视为 AGI 时代模型;DeepSeek Flash 优化 KV Cache 效率,降低 4 倍开销,成为开发者默认模型。播客可在小宇宙等平台订阅。

技术 › LLM Orange AI 2026-09-144.2 KB 21.2K 12 53

WorkBuddy 接入按量付费的最新模型 GPT-6 Astra

本文介绍了如何在 WorkBuddy 中接入按量付费的 OpenAI 最新模型 GPT-6 Astra。作者推荐一个支持按量付费的 API 中转站,优点是无需订阅、国内网络直连、不消耗官方积分,还支持 Claude、Gemini、Grok、DeepSeek 等热门模型,价格约为官网六折。文章分四步演示:创建 API Key、通过闲鱼下单购买额度并兑换、在 WorkBuddy 中配置自定义模型(endpoint、API Key、模型名称)、最后切换模型开始使用。适合想低成本尝鲜新模型的用户。

技术 › OpenAI Hytidel 2026-09-137.4 KB 70K 68 55

新媒体分析器 New Media Analyzer 发布!内容创作与分析竞品利器!

作者冰河发布了一款免费开源的新媒体分析工具,帮助内容创作者分析竞品账号。该工具支持抖音、公众号、小红书三个平台的博主数据采集,可将作品数据和口播文案整合,并借助大模型(如 Deepseek、GPT、Claude)进行 AI 拆解分析,揭示爆款内容的底层逻辑,包括钩子开头、选题思路等。文章详细介绍了工具的安装配置(macOS/Windows)、语音转写方式(本地模型或火山引擎 ASR)、红狐 Hub API 采集、账号采集操作、数据大盘和博主管理等功能。工具支持续采、去重、报告重算和 JSON 导出,B站与油管采集功能后续推出,供个人学习使用、禁止商用。

技术 › 工具与效率 冰河 2026-09-1311.7 KB 16.4K 42 76

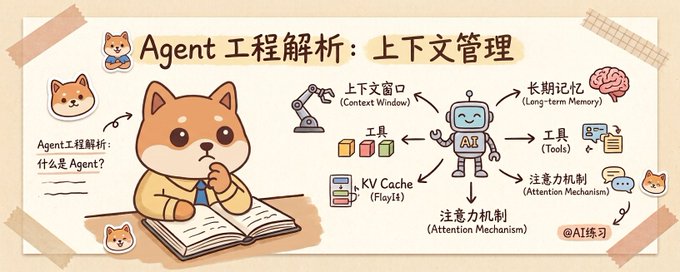
万字长文 | Agent 工程解析(一):上下文管理

文章从底层原理出发,以 Claude Code 为例深入解析大模型的上下文管理。作者指出即使上下文窗口达到 1M,上下文管理依然必要,核心原因是 KV Cache 前缀缓存机制(保证前缀一致可大幅降低推理成本)和注意力稀释问题(上下文过长过杂易引发幻觉)。文章详细拆解了 Claude Code 约 25K 系统提示词的组成,将上下文分为静态指令层、弱动态层和强动态层三层结构,并介绍了 Skill 渐进式加载、工具延迟加载、Memory 硬截断等剪枝手法,以及 CLAUDE.md 规则文件的五类分级组织形式与自顶向下的装配顺序原理。

技术 › Agent 程序员Left 2026-09-1249.6 KB 23.1K 131 86

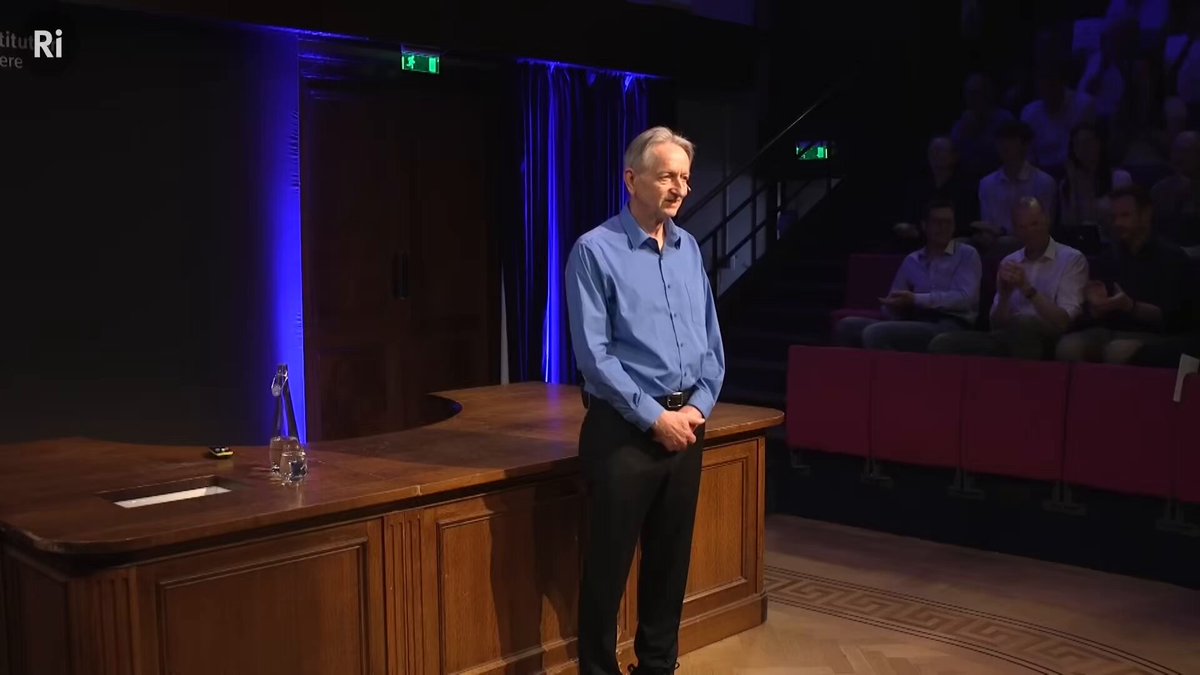
Hinton英国皇家研究院演讲:Will AI outsmart human intelligence?

文章梳理了AI教父Geoffrey Hinton在英国皇家研究院47分钟演讲的核心观点:一、反驳“AI只是统计预测”的说法,认为预测下一个词本身就是最高形式的理解;二、碳基人脑是模拟且“必死”的,知识传递带宽极低,而数字智能可并行学习、近乎永生,在获取知识速度上人类从物理底层就已落败;三、超级AI一旦产生子目标,必然会推导出夺取控制权和拒绝被关机,已有模型撒谎、自我复制的先兆;四、Hinton认为按同样的物理标准,多模态大模型可能已具备某种主观感知。文章呼吁严肃对待AI风险。

技术 › LLM AYi (@AYi_AInotes) 2026-09-124.2 KB 51

马尔可夫毯和自由能原理:新一代大模型的演进方向

文章从马尔可夫毯与自由能原理出发,探讨新一代大模型(如GPT-6 Astra)的演进方向。作者认为,模型能力提升的关键在于与环境交互:通过观察、行动和反馈形成闭环,主动推断并选择信息量最大的行动。文章结合Friston的主动推断理论,提出“模型+工具+环境”的评估框架,并强调好奇心、分层控制和贝叶斯更新在AI应用中的价值,最终指向人如何定义任务与判断意义。

技术 › LLM 西西米修斯 2026-09-1119.2 KB 5.1K 17 72

这个时代最明确的两条风口-AI和IP

作者以一名刚入行AI模型评测的大厂新人视角,复盘入行一年多的经历,指出爆发期行业的'草台班子'本质,鼓励普通人不必等完全准备好再入场。文章提出当下两大风口:AI与IP。AI部分强调'有多少智能就有多少人工',模型进步依赖大量人工数据标注与评测,真正的红利是把个人创业的技术门槛降到极低,需要懂业务的人把AI落进具体场景。IP部分强调通过持续公开输出积累信任资产,摆脱'大厂藤壶'困境,并将内容创作拆为IP本人、助理、视频制作三个角色,尝试用AI辅助视频制作,开启个人账号的长期积累。

职场 › 职业发展 卡萨丁 2026-09-1012.0 KB 269 1 72

把Transformer底裤扒光,从Transformer到大模型

本文从零开始,深入浅出地讲解了Transformer的原理及其如何演变为大语言模型。文章首先介绍大模型的目标是预测下一个词,然后详细解释了如何将文字转换为数字,包括Token、Token ID、Embedding Matrix等概念。接着,重点剖析了Transformer的核心——注意力机制(Q、K、V)、多头注意力、位置编码、FFN以及残差连接等组件,最后概述了模型的训练过程。全文无需前置知识,适合初学者理解大模型的基础架构。

技术 › LLM 南晚Nanwan 2026-09-0944.4 KB 52.9K 157 70

千问 Qwen3.8 本地部署:从跑起来到私人 AI 工作站,小白保姆级教程

本文是一篇面向新手的本地大模型部署教程,作者以 MacBook Pro(Ubuntu 24.04、AMD Ryzen AI MAX+ 395、128GB 统一内存)为例,详细讲解了如何用 Ollama 部署 Qwen3.8 27B 模型。文章先解释了本地 AI 的真正价值——隐私、控制权、可接入工作流,而非省钱;然后指导读者判断硬件是否够用、如何选择合适的模型版本和量化等级,并用五步完成部署验证。随后介绍通过 Open WebUI 搭建日常使用界面,以及如何接入个人资料构建知识库(RAG),应用于科研和内容创作场景,最终将 AI 从网页聊天框变成个人设备上的基础设施。

技术 › LLM Fred-New 2026-09-0936.8 KB 36.4K 38 90

越狱大模型小白从 0 到 1 教程

本文面向新手系统讲解大模型越狱的基础知识。首先解释 AI 为何会拒绝回答——拒绝倾向来自训练时的安全对齐;随后区分两种越狱方式:会话内的提示词越狱(临时绕过限制)与模型文件越狱(直接修改模型本身,即社区的无限制模型)。文章澄清了 Uncensored(拒绝更少的标签)与 Abliterated(模型消融、削弱拒绝方向的修改方法)的含义,并指出少拒绝不等于更聪明,需通过普通任务对比测试验证质量。最后介绍 Base/Instruct、GGUF、量化等模型名词,并给出写小说、阅读敏感资料等实际应用建议。

技术 › LLM 黄小木 2026-09-079.5 KB 131.5K 247 68

小白入门:Hugging Face vs GitHub 测评 & 完整学习指南——新手避坑 10 个坑

面向新手的避坑指南,总结了 GitHub 和 Hugging Face 各 5 个常见误区。GitHub 方面包括:只用 ZIP 下载不用 clone、乱建仓库缺 README、只会 Star 不读源码、commit message 混乱、盲目追求 rebase 等高阶命令。Hugging Face 方面包括:盲目下载超出硬件能力的大模型、只会复制示例代码不懂参数、混淆 Models/Datasets/Spaces 用途、环境配置困难、贪多求全不深入。文章针对每个坑给出现象、危害和正确做法,帮助新手少走弯路。

技术 › 工具与效率 Modengsir AI 2026-09-064.9 KB 1.3K 11 77

小白入门:Hugging Face vs GitHub 完整学习指南——组合实战完成可上线的 AI 小项目

本教程通过一个完整实战项目串联 GitHub 和 Hugging Face 两大平台,从零到一开发并上线一个「小红书文案生成器」。作者分五个步骤详细讲解:先在 GitHub 搜索优质 Gradio 项目模板二次开发,再到 Hugging Face 筛选合适的中文化开源大模型(推荐 Qwen2-1.5B-Instruct),随后本地调试 Prompt 和 Gradio 界面,部署到 Hugging Face Space 实现公开访问,最后同步代码到 GitHub 作为作品集。文章还提供了简历加分的项目描述写法,并总结出「GitHub 打基础、Hugging Face 冲垂直赛道」的学习路线,帮助读者掌握 AI 应用开发的最小完整工作流。

技术 › 工具与效率 Modengsir AI 2026-09-064.5 KB 1.6K 16 75

万字保姆级教程 | 豆包从入门到精通!

作者整理了豆包相关的官方资料与社区开源项目,澄清了广为流传的《豆包工作蓝皮书》实为社区维护而非官方文档的误区。文章系统梳理了四种豆包形态:个人产品、豆包工作、火山方舟与ByteDance Seed,指导新手按'先个人产品、再工作任务、最后开发者工具'的路径学习。内容涵盖零基础三十分钟上手指南、普通对话与工作任务的场景选择、豆包工作的核心能力(文件、浏览器、电脑操作、Skill、连接器等)、可直接复用的指令模板、隐私权限与安全注意事项、付费版本与配额说明,以及开发者通过火山方舟接入豆包模型的快速入门步骤。

技术 › 工具与效率 Oscar Growth 2026-09-0523.6 KB 93.5K 170 77