Wiki 知识库

全部文档 / 标签: MoE

59 篇
清除

我把 Moderna 癌症疫苗论文丢给 Apodex 的 Deep Discover(附 RTX 5090 本地部署)

作者以 Moderna/Merck 个体化 mRNA 癌症疫苗 Phase 3 进展为案例,体验了 Apodex 的 Deep Discover 多 Agent 研究产品。产品通过 Task Board、分工的 Sub-agent(临床数据读取、肿瘤研究、估值分析)与 Verifier 复核,实现可视、可中途干预的研究流程,并在测试中自行纠正了药物实体混淆。文章后半部分详细记录在单张 RTX 5090 上用 SGLang 部署 Apodex 1.1 mini(36B MoE GPTQ Int4)及开源 FrontierAgent 的过程,包括网络代理与 SSRF 防护冲突的排查、Agent Team 宏观研究实测,以及单卡下并行的本质是任务与上下文并行而非吞吐并行的性能分析。
技术 › Agent 九尾狐-FoxFairy 2026-08-2820.4 KB 25.5K 115 82

混元 Hy4 preview 8个项目实测,我想买腾讯股票了!

腾讯发布混元 Hy4 preview 模型(770B 总参数、49B 激活、1M 上下文的 MoE 模型),作者通过 Workbuddy 实测 8 个项目:声音驱动动效画布、在线 808 鼓机、吉他调音器、复刻《沙罗曼蛇》游戏、极端金属 PPT、PDF 生成企业官网、Three.js 太阳系演示等。评测发现其前端审美显著提升,长程 Agent 任务稳定,能精准拆分任务、调用工具和 Skill,且行为守规矩(只引用 CC 版权图、不确定时主动询问)。作者对模型表现大为赞赏,认为腾讯迭代速度快,甚至萌生买腾讯股票的想法。
技术 › LLM 向 向阳乔木 2026-08-2812.0 KB 27.5K 55 78

2026 开源模型全网最全盘点:从入门到榨干(含双机实测)

文章系统盘点了 2026 年值得关注的开源 AI 模型,涵盖语言、图片、视频三大类别,包括 Qwen、DeepSeek、Kimi、GLM、MiniMax、混元等国产阵营及海外模型。作者拆解了模型命名规则(参数量、MoE、量化、许可证等),提出五步选型筛选法,并比较各硬件平台(Mac 统一内存、NPU AI PC、大内存 APU 等)的适配能力。文章还讲解了本地部署的适用场景与许可注意事项,最后通过 Mac 和 Windows 双机实测检验模型在文字、看图、分镜和视频任务上的真实表现,帮助读者判断自己需要哪类模型以及电脑能否带动。

技术 › LLM 诺鸭船长3 2026-08-2735.5 KB 44.1K 51 87

智谱GLM-5.3-Flash发布:真正的智能平权

文章揭秘了海外爆火的匿名模型OX Alpha的真实身份——智谱发布的GLM-5.3-Flash。该模型是总参数320B、激活18B的MoE架构,GLM-5系列首个原生多模态模型,支持图像、视频和文本输入,上下文达100万。其能力逼近Opus 4.8,而价格极低(每百万Token输入0.8元、输出2.8元),比DeepSeek V4还便宜一半。作者通过自建1000条新闻评测集实测发现其在精选率和品味上优于MiMo 2.5 Pro和DeepSeek V4 Pro,前端代码能力也直逼顶级模型。此外,智谱用10万张国产卡扛下了匿名测试期的全部推理流量。作者决定将AIHOT网站模型全面切换至GLM-5.3-Flash。

技术 › LLM 数字生命卡兹克 2026-08-2714.1 KB 44.9K 123 72

我把我的“AI白月光”装进 MacBook:一个装修人四个月的 AI 学习路线

作者回顾了自己四个月学习 AI 的历程,从最初用蚂蚁百灵大模型 Ling-3.0-tiny 整理装修业务流程、拆解游戏开发任务、到设计四轮装修改稿测试验证模型规则意识,共经历三个阶段。最终在 M5、24GB 内存的 MacBook 上完成 Ling-3.0-Tiny INT4 本地部署,构建 Ollama/MLX 运行路径,并搭建基于 Obsidian 的只读检索层,让模型担任“本地项目情报员”。作者强调普通人学 AI 应先解决一件真实的小事。

技术 › LLM Main CaseZ·美學 2026-08-249.9 KB 7.2K 54 66

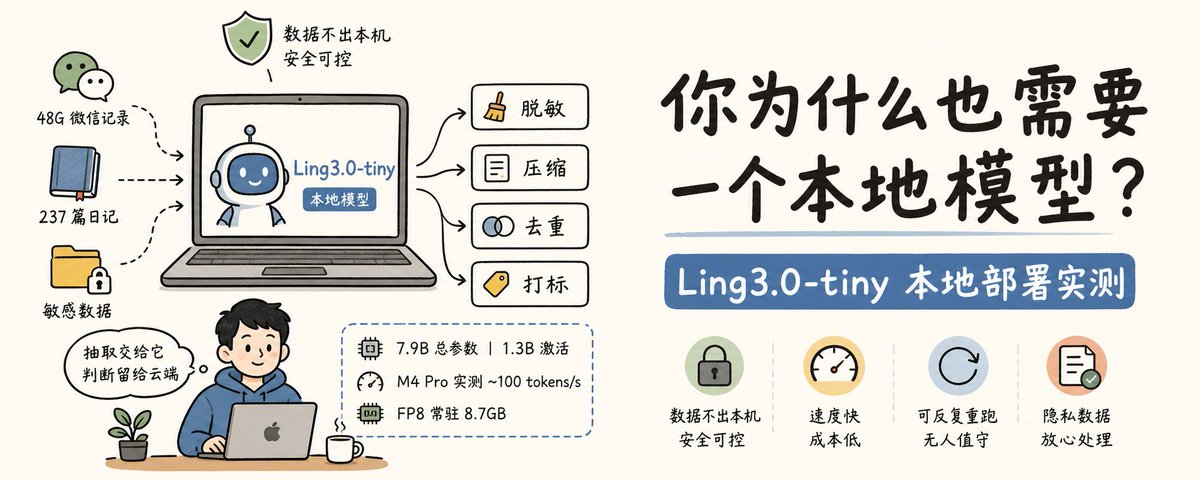
你为什么也需要一个本地模型?Ling3.0-tiny 本地部署实测

作者介绍了在 MacBook M4 Pro 上部署蚂蚁百灵开源的 Ling-3.0-tiny 稀疏 MoE 模型的完整过程,用于处理 48G 微信记录和 237 篇日记等隐私数据。文章详述了 FP8 权重选择、编译 MLX 后端 ollama、避坑指南等实操细节,实测生成速度约 78-99 tokens/s。在脱敏、命名实体识别、长文压缩、去重四个场景中表现优异,并总结分工原则:抽取任务交给本地模型,语义判断留给云端模型。

技术 › LLM 柯基是只猫 2026-08-2412.2 KB 20.2K 102 92

从单机到双机:小白靠 AI 助手跑通 124B 大模型的完整记录

本文记录了一位非计算机出身的普通用户,借助 AI 助手,成功在双节点 NVIDIA DGX Spark 上部署蚂蚁百灵 124B 参数的 Ling-3.0-flash 模型,并完成单机 FP4 与双机 FP8 的对比评测。文章详细介绍了从模型下载、SGLang 编译、单机部署到双机配置、公网 API 开放的全过程,并提供了性能数据、踩坑清单和 AI 协作方法论。核心结论是:双机在长输入预填充上优势明显(2.2倍),但解码速度提升有限;上下文长度是硬约束,单机 FP4 适合日常任务,双机 FP8 适合长文档处理。

技术 › LLM Xiangyu 香鱼 2026-08-1916.2 KB 172.2K 163 86

保姆级教程:DGX Spark 本地跑通 124B 大模型全记录

本文记录了作者在公司配置的英伟达 DGX Spark 桌面级 AI 超算上本地部署大模型的完整过程。文章首先介绍选择 DGX Spark 的原因(数据隐私、成本可控),解析其 GB10 芯片与 128GB 统一内存的硬件配置,讲解稠密模型与 MoE 稀疏模型的区别,最终选定蚂蚁百灵 Ling-3.0-flash(fp4/int4 量化版本)进行部署。作者对比了 Ollama 与 vLLM 的优劣,选择 vLLM 完成部署,并借助 Claude Code 远程操作。最后进行了 MTP 推理加速测速对比,并成功将本地模型对接到 Claude Code 实际使用。

技术 › LLM AI少年 2026-08-1817.4 KB 184.5K 132 82

大模型本地部署完整指南:用 Ling-3.0-flash 搭建自己的 Agent 工作流

本文是一篇面向新手的本地大模型部署教程。作者在 NVIDIA DGX Spark(GB10 芯片、121.6GB 统一内存)上,使用官方适配的 vLLM 分支部署了蚂蚁百灵开源的 124B MoE 模型 Ling-3.0-flash INT4 版本。文章先科普了模型精度、Dense 与 MoE、推理引擎等概念,再详解下载权重、环境准备、启动服务与验证的完整流程,并开启 MTP 投机解码。性能测试显示 8 并发聚合吞吐达 141.38 tok/s,远超本机 Qwen3.8-27B;随后通过逻辑推理、安全边界、长文本三方向测试验证真实能力,最后介绍用 Python 脚本搭建终端 TUI 聊天界面,逐步走向 Agent 工作流与 Token 自由。

技术 › LLM Lonely 2026-08-1823.9 KB 278.4K 485 81

最强的矛与盾:本地部署大模型到底该买什么

本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。

技术 › LLM 实践哥MinLi 2026-08-1830.4 KB 298.1K 264 89

MoE与MMoE模型详解:从稀疏扩容到多任务学习

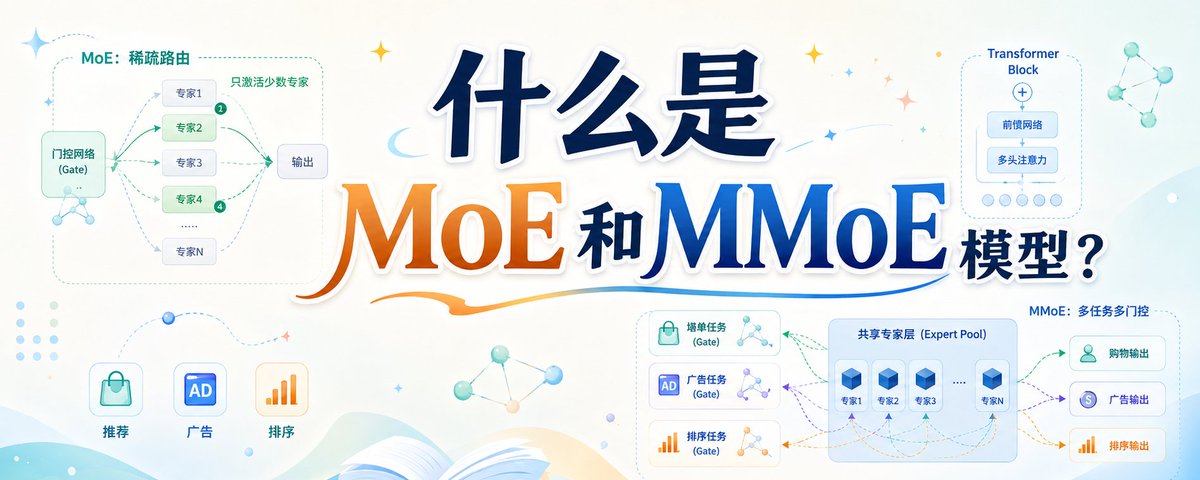
本文系统梳理了MoE(混合专家)模型的概念分歧与技术演进。针对目前命名混乱导致的认知误区,作者明确划分了两条核心技术路线:一是追求参数量与计算量解耦的稀疏路线,已成为大语言模型的默认架构;二是通过多门控机制实现任务共享的MMoE路线,主要应用于推荐系统。文章深入回顾了条件计算思想,并详细探讨了稀疏MoE在路由设计、负载均衡、并行通信等工程实践及结构演进的现状。

技术 › LLM snowboat 2026-08-0760.2 KB 16.2K 16 89

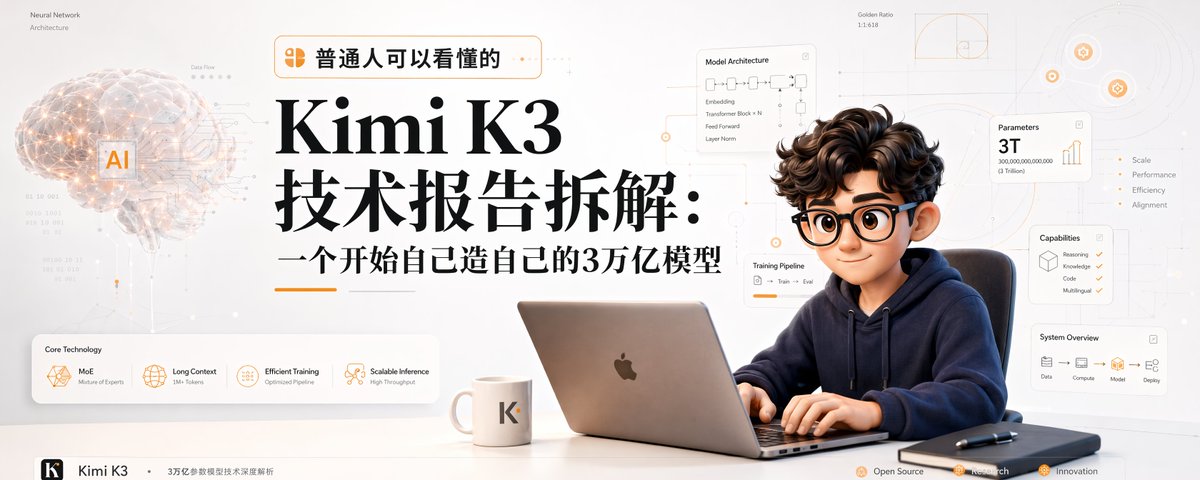
Kimi K3 技术报告拆解:全球首个开源 3T 级模型

本文拆解了 Kimi K3 的技术报告,这是一个全球首个开源的 2.8 万亿参数模型。文章详细解析了其混合注意力架构、注意力残差机制、MoE 设计以及在长文本训练和推理优化上的创新。报告指出 K3 性能虽略逊于顶级闭源模型,但在多项任务中表现优异,且具有极高的成本效率,甚至已能辅助团队进行内核优化和芯片设计。

技术 › LLM Berryxia.AI 2026-07-2920.0 KB 393.1K 186

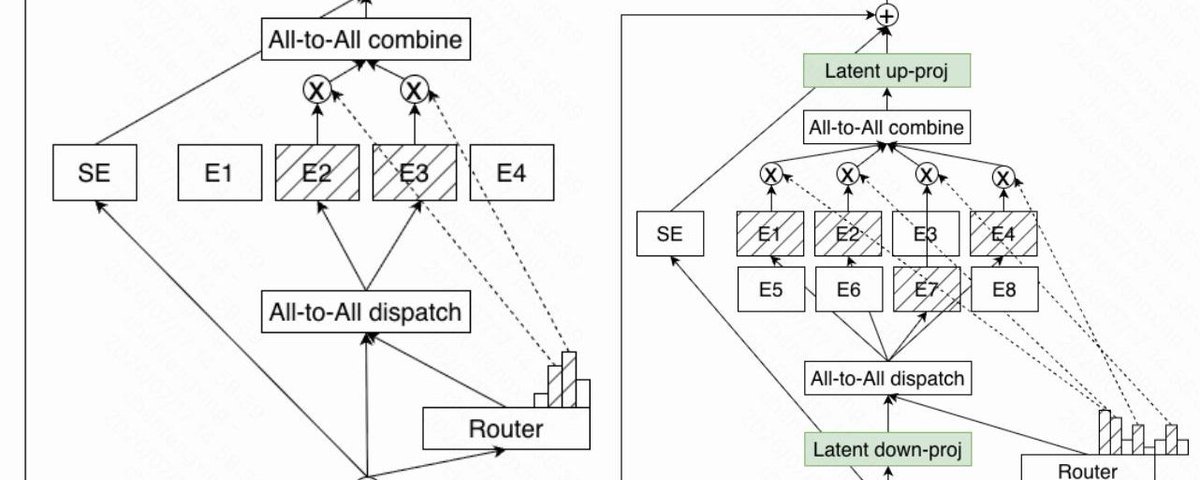
从 Kimi K3 看下一代 MoE 架构的转折点:LatentMoE

文章分析了 2026 年大模型架构的新趋势 LatentMoE。通过对比 NVIDIA Nemotron 3 Super 和 Moonshot AI Kimi K3,揭示了 LatentMoE 如何通过将 token 投影到低维潜在空间,大幅降低内存和通信开销,从而在同等推理成本下激活更多专家,提升模型性能与效率。

技术 › LLM 青稞社区 2026-07-208.2 KB 21.8K 189

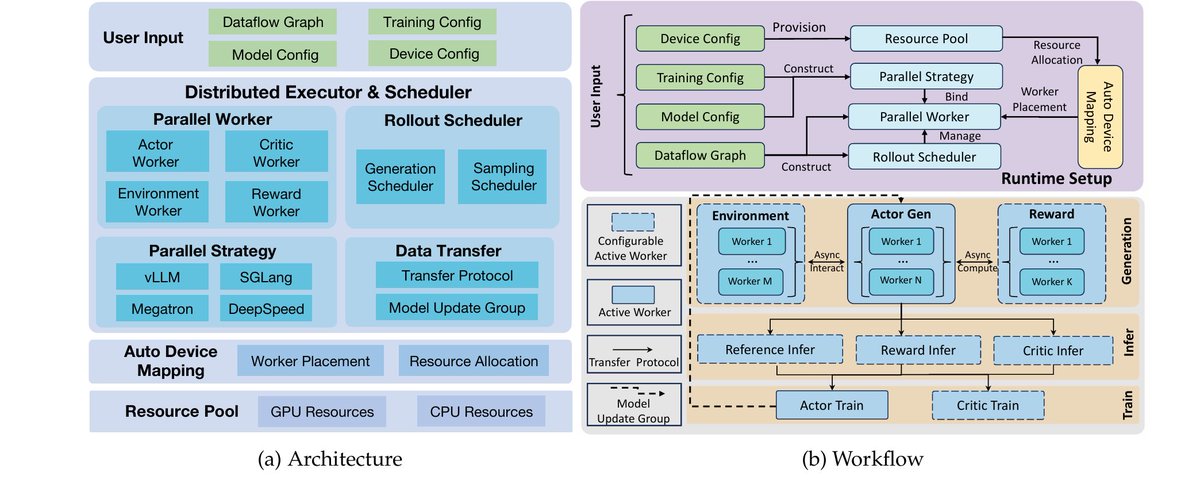
OpenRLHF 作者发布 Agentic RL 框架 Molt:9K 行核心代码支持超大规模 MoE 训练

OpenRLHF 作者发布了新的强化学习框架 Molt。该框架采用纯 PyTorch 栈,核心代码仅约 9000 行,专注于 Agentic RL 研究。它支持 Qwen3.5-397B 到 GLM-5.2 753B 等超大规模 MoE 模型训练,无需依赖 Megatron,具备高度的代码可读性和可修改性。

技术 › LLM 青稞社区 2026-07-1610.2 KB 9.5K 81

人工智能的工程全景(中):推理,后训练,对齐和安全

本文是AI工程全景的中篇,深入探讨了模型训练完成后的工程化路径。首先详述了推理优化的核心手段,包括模型瘦身(量化、蒸馏、剪枝、MoE)、投机解码以及主流推理引擎(vLLM, TensorRT-LLM, SGLang)的生态格局。文章分析了成本、延迟与吞吐的“不可能三角”,并重点介绍了“测试时计算”这一范式转变,即通过在推理阶段增加计算量来动态提升模型智能。

技术 › LLM snowboat 2026-07-0372.0 KB 19.2K 43

实测美团 LongCat-2.0:国产芯片万亿模型的实用价值

本文实测了美团发布的基于 5 万张国产算力芯片训练的万亿参数大模型 LongCat-2.0。文章指出,该模型在预训练到大规模部署的全流程中实现了国产算力闭环,具有里程碑意义。虽然通用推理能力与顶级闭源模型仍有差距,但在 Terminal-Bench 和 SWE-bench Pro 等 Agent 与编程任务中表现强劲。作者实测了将其接入 Claude Code 和 Codex 进行工作流处理,结果显示其在长上下文处理和任务拆解上表现稳定,为开发者提供了一个可行的非国产替代方案。

技术 › LLM 卡尔的AI沃茨 2026-07-027.8 KB 2.9K 3

2026年强化学习面试题库:算法与基础设施

本文汇总了35道2026年强化学习(RL)领域的面试核心问题。内容涵盖算法与基础设施两大方向,既包括PPO、GRPO等训练机制的原理探讨,也涉及分布式推理、显存优化等工程落地细节。作者强调现代RL岗位需要具备全栈理解能力,建议面试者不仅要熟记问题,更需深究背后的技术逻辑。

技术 › LLM Xiuyu Li 2026-06-085.6 KB 381.8K 2K

DeepSeek 的 10 万亿美元大战略:技术、算力与国产芯片的未来

本文深入分析了 DeepSeek 如何通过 MLA、MoE、mHC 等一系列底层技术创新,极大幅度降低大模型对 HBM(高带宽内存)和先进 GPU 制程的依赖。文章指出,DeepSeek 的战略并非局限于软件订阅,而是旨在通过算法优化盘活中国产能充足的 NAND 闪存和 LPDDR 产业,以此构建一套独立于西方之外的 AI 硬件生态,最终撬动价值 10 万亿美元的产业巨兽。

技术 › LLM 宝玉 2026-05-2426.0 KB 207.1K 387 82

Mixture of Experts (MoE): Scaling AI with Specialized Models

文章深入探讨了混合专家模型(MoE),这是一种通过激活特定子网络来高效扩展 AI 模型的架构策略。文章回顾了 MoE 的历史背景,详细解释了其由门控网络和专家组成的结构及稀疏路由机制,并分析了其在 Transformer 中的应用、优势(如高效计算、参数扩展)以及面临的负载平衡和通信开销等挑战。

技术 › LLM J Jayanth 2026-05-079.6 KB 64

别再迷信参数量:中国开源模型在硅谷踢馆成功

文章记录了作者利用中国开源模型 MiniMax M2.5(仅 10B 激活参数),通过行为工程和 Goose 运行时的优化,在 Databricks OfficeQA 基准测试中以 71.5% 的准确率击败了 Claude Opus 4.5 的实战经历。文章指出,企业级 AI 的竞争已从单纯的模型参数量转向行为工程与驾驭层能力,并揭示了中美 AI 生态(中国执行引擎+美国编排方法论)结合所产生的高效低成本优势。

技术 › LLM 柳文浩 2026-05-0614.3 KB 2.2K 9 86

DeepSeek V4 开源发布:行业威胁与地缘政治博弈

文章分析了 DeepSeek V4 的发布及其对美国 AI 主导地位的挑战。作为一款性能逼近 GPT-5.5 和 Opus 4.7 但价格极低的 MoE 开源模型,它打破了现有的商业逻辑。作者认为,虽然该模型并非完全超越前沿水平,但其极致性价比可能导致美国企业大规模转向采用,从而引发严重的地缘政治安全风险。同时,文章讨论了出口管制、蒸馏指控及文化叙事控制等深层影响,呼吁美国加强开源策略并降低模型成本。

技术 › LLM Matthew Berman 2026-04-2510.1 KB 756K 969 62

DeepSeek V4是怎么训练出来的?58页论文深入解读

文章深入解读了DeepSeek V4论文,指出其核心价值在于将百万上下文、Agent原生能力与低价格结合,抬高了AI应用的地板。技术层面,V4通过mHC稳定残差连接,采用CSA+HCA混合注意力机制解决长上下文算力难题,并用Muon优化器替代AdamW。此外,文章还详细介绍了其1.6T参数量的训练稳定性技巧、反AI坍缩的数据构建以及基于“Specialist + OPD”的后训练范式转变。

技术 › LLM 花叔 2026-04-2527.6 KB 28K 155 83

GLM-5.1、Qwen 3.6 Max 与 Kimi 2.6 国产大模型横向评测与选型指南

文章对 2026 年上半年三款国产旗舰大模型(智谱 GLM-5.1、阿里 Qwen 3.6 Max、月之暗面 Kimi 2.6)进行了深度横向对比。分析涵盖核心技术参数、能力评测及商业定价,指出各模型分别在自主编程、通用全能与长文本协作领域的优势,并针对不同业务场景提供了具体的技术选型建议。

技术 › LLM yishan 2026-04-224.3 KB 63

Gemma4 选型指南:8个模型该选哪个?

Google 发布 Gemma4 系列开放权重模型,本文为本地部署选型指南。文章解析了 '-it' 指令微调版与基版的区别,以及 E4B/E2B 移动端优化技术(Per-Layer Embeddings)的原理。针对不同场景推荐模型:本地对话选 26B-A4B(MoE 激活 4B);写代码选 31B;语音助手选 E4B;树莓派尝鲜选 E2B。

技术 › LLM karminski-牙医 2026-04-033.6 KB 112.5K 714 80

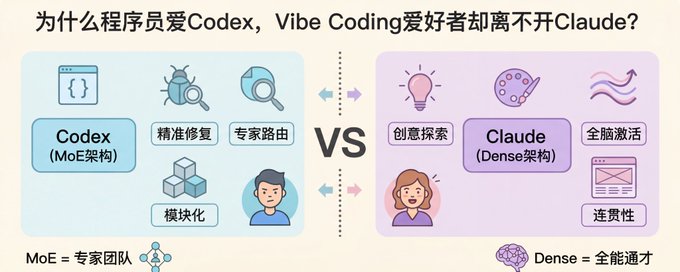
为什么程序员钟爱Codex,Vibe Coding的人却离不开Claude?一文弄懂它!

文章深入探讨了 AI 辅助编程领域中 Codex 与 Claude 的差异化定位。Codex 采用 MoE 架构,以模块化和高精准度成为传统程序员修复 Bug 和重构代码的利器;而 Claude 基于 Dense 架构,凭借全脑激活的细腻逻辑和对自然语言的深度理解,成为“Vibe Coding”用户进行创意原型开发的首选。文章最后建议在实际工作流中混合使用,取长补短。

技术 › LLM Berryxia.AI 2026-03-318.8 KB 512.2K 802 79